7. Оценка результатов обучения
Оценка результатов обучения из блога
Не верим попсовым рейтингам, они врут. Нужна элитарность, а не попсовость.
В чате gonzo-обзоров обсуждали (с https://t.me/c/1334131803/51066) парето-фронтир с ценами и перформансом LLM на ChatBot Arena -- https://lmarena.ai/?price. Проблема в том, что на разных "аренах" (тысячи их) цены всех моделей одинаковые, "из прайс-листа", а вот оценки умности -- различаются, поэтому все подобные "парето-фронтиры" что-то показывают, но что именно -- непонятно, все они разные.
Арена оценивает модели, сравнивая их попсовость, как на рекомендательных сервисах: побеждает попсовость -- то, что нравится большинству, vox populi, vox Dei. Для меня в оценке знаний мнение большинства -- это сдвиг в махровый фундаментализм, суеверия, гарантированное отсутствие SoTA. Фронтирные умные ответы обычно не нравятся народной массе, они контринтуитивны, они "грузят". Люди доверяют не верному, а знакомому. Людская арена дико консервативна в плане распространения новых идей. Сетка с приоритетом рациональных, а не "идеологически верных" решений будет заведомо проигрывать на людских аренах.
Я как-то много лет увлекался анимешками и мангой. Очень быстро разобрался, что если выбирать аниме и манги по итогам "народного голосования" (по рейтингам на профильных сайтах), то этот ужас нельзя смотреть, равно как нельзя слушать поп-пузыку, от которой уши вянут. Лучшие для моих глаз и ушей произведения обычно имеют семёрочку-восьмёрочку из десяти на общих рейтингах. Рейтингование мозгов (и человеческих, и нечеловеческих) по их человеческой попсовости — путь туда же. Не удивлюсь, если лучшие мозги в попсовом рекомендательном рейтинге будут иметь тоже семёрочки-восьмёрочки.
В принципе, этот эффект обучения народному идиотизму у толпы (обучение по материалам интернет-помойки, плюс добавлены ответы на вопросы от толпы в сервисах типа Толоки или Mechanical Turk) уже прояснили, качество учебных материалов имеет значение:
-- Textbooks Are All You Need, https://arxiv.org/abs/2306.11644, где повышение качества данных драматически улучшало качество обучения.
-- “model collapse”— обучение на синтетических данных с диким количеством ошибок (обучение у детей, а не у профессоров -- у черни, а не у элиты) обычно ведёт к ухудшению качества, хватает нескольких поколений обучения одних сеток галлюцинациям других сеток, и разумности каюк.
-- To Code, or Not To Code? Exploring Impact of Code in Pre-training, https://arxiv.org/abs/2408.10914, добавка кода (данных с жёстким контролем типов прежде всего) в данные для начального обучения существенно повышает результаты за пределами собственно кодирования: up to relative increase of 8.2% in natural language (NL) reasoning, 4.2% in world knowledge, 6.6% improvement in generative win-rates (и, конечно, a 12x boost in code performance).
-- When Less is More: Investigating Data Pruning for Pretraining LLMs at Scale, https://arxiv.org/abs/2309.04564, где тоже проверялось качество данных по простейшей оценке перплексии. И после этого бралось 30% от начального количества данных -- и получались результаты лучше.
-- LIMO: Less is More for Reasoning, https://arxiv.org/abs/2502.03387, это совсем другие авторы, нежели предыдущей работы, но они показывают результаты с 1% данных лучше, чем со 100% данных -- просто за счёт того, что эти данные тщательно подобраны. Никакого обучения у толпы, "статистического знания". Строгая элитарность! we propose the Less-Is-More Reasoning Hypothesis (LIMO Hypothesis): In foundation models where domain knowledge has been comprehensively encoded during pre-training, sophisticated reasoning capabilities can emerge through minimal but precisely orchestrated demonstrations of cognitive processes. This hypothesis posits that the elicitation threshold for complex reasoning is determined by two key factors: (1) the completeness of the model's encoded knowledge foundation during pre-training, and (2) the effectiveness of post-training examples as "cognitive templates" that show the model how to utilize its knowledge base to solve complex reasoning tasks.
Поэтому работаем в сторону элитарности, показываем друг другу только элитарные образцы культуры, а не попсовые "средненародные" со "средненародными ошибками" от недообученных как мокрых, так и сухих нейронных сеток. Вот представьте, что вы сделали нейросетку, которая вполне себе шарит в теории относительности -- и вы её посылаете выступить на попсовой арене. И она выдаёт, что никаких сил тяготения между предметами с большой массой нет, а есть искривление пространства-времени. Какой там будет рейтинг по сравнению с LLM, выдающей ответ из школьного учебника физики? Вот, оно самое -- вы этого хотели, вы это измеряли, вот вам.
Учитесь по серьёзной литературе, а не по поп-науке, и не будет у вас model-collapse, не будете заучивать намертво ошибки. В том числе учитесь программировать хотя бы для того, чтобы понимать, что такое "формальность", как надо обращаться с типами объектов. Вот для чего нужно изучать информатику в школе!
Ну, или учитесь по художественной литературе, по галлюцинациям "хороших писателей" -- и хлебайте плохое качество мышления, в количестве. Галлюцинации на входе -- выученные галлюцинации в мозгах -- галлюцинации на выходе. Зато вы будете попсовы, в рекомендательных системах будете с самыми высокими рейтингами!
Ко мне самому это тоже относится. Я бы сильно напрягся, если бы опопсел. Нет, лучше я не буду проще, и люди попроще ко мне не потянутся.
Не верим многоборьям, они врут
Принципы оценки интеллектов по мотивам психометрии дал François Chollet в https://arxiv.org/abs/1911.01547 — "батарея тестов", при этом особо указал, что "где-то там в основе пространственные паттерны для выделения объектов из фона", и предложил свой вариант текста, в этом году этот тест по факту прошли, в текущем году обещалось дать более трудный вариант (https://arcprize.org/). Это "как все", "батареи тестов".
Проблема в том, что "общий результат по батарее" не учитывает разнообразие, вы получаете среднюю температуру по больнице. Если одна LLM модель умеет рисовать, но не умеет в интегралы, а другая умеет в интегралы, но умеет говорить красиво, вы получите среднее от них всех, "ничего в среднем не умеют". Как это обходят люди? Ну, пытаются получать рекомендации не "вообще", а в узкой предметной области -- делают узкие арены, вроде "конкурса им.П.И.Чайковского" для пианистов, которые претендуют на игру не в ресторане" и не пускают на этот конкурс чемпионов мира по большому теннису. С LLM, конечно, побеждает "общая оценка" -- ещё и сделанная отнюдь не элитой, не докторами наук.
Поэтому мы и переходим к "аренам", в которых сеткам предлагается сравниваться по одной и той же задаче.
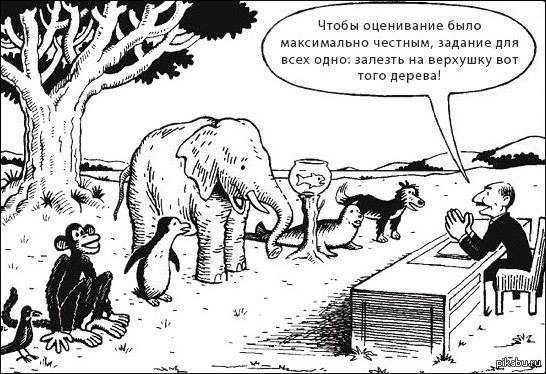
Мы уже рассмотрели, к чему ведёт "народное судейство". Поэтому надо устраивать гладиаторские бои на профильных аренах без участия людей. Этих "арен" тысячи, при этом они двух типов:
-- ни разу не гладиаторская арена, где сражаются друг с другом по олимпийской системе, а школьная олимпиада, бенчмарк. Берём какой-то набор задач за 100%, смотрим, сколько задач решено. Скажем, бизнес-бенчмарк, частный, https://t.me/llm_under_hood/500.
-- гладиаторская арена, где удаётся сформулировать игру, и сетки играют друг с другом на вынос, например, опять-таки "батарея" (от этого не уйти) текстовых игр, где победитель вроде как должен быть умней, чтобы выиграть. Там свой leaderboard, другие победители, чем на других аренах, а люди там вообще на 20 месте, на второй странице, https://textarena.ai/leaderboard
Смысла всех этих тестов нет, но "главные пузомерки" очень удобны для выигрыша в конкурентной борьбе. Скажем, журнал Byte, журнал PC Week публиковали в начале 90х (помним, что IBM PC появилась в 1980 году) в каждом номере рейтинги текстовых процессоров -- все эти Word, Word Perfect, Lotus 1-2-3, Excel. Поскольку сравнение было по факту "у кого фич больше", Microsoft банально копировало все новые появлявшиеся фичи и по очкам медленно вырвалось вперёд в каждой категории. После чего выбора не было -- какой журнал ни откроешь, везде были продукты Microsoft на первых местах, они там были в каждой категории. Гвоздь в крышку всей этой конкуренции забил MS Office, который добавил одну супер-дупер-фичу: умение взять cut из одной программы офиса и сделать paste в другую программу, и всё продолжало работать! Вот что-то такое сейчас может начать происходить с LLM -- у всех у них уже есть ответы на все вопросы "из коробки", мультимодальный режим с картинками и аудио, доступ в Сеть и даже поиск, умение рассуждать, умение выполнить команду на компьютере.
Приходится идти мимо рекомендательных систем, подбирать всё под свои задачи. Трудность в том, что для каждой отдельной задачи в каждый момент времени (при этом и scope задачи меняется во времени, и предлагаемые модели как по их точности ответов, так и по их цене) надо проводить отдельное тестирование — тут "каждый сам за себя", траты ресурсов на выбор модели огромные, и это нельзя сделать разово, ибо dynamic fitness landscape, заснул в одной ситуации, проснулся уже в другой.
Для моих применений вот прямо сейчас o3-mini с долгим думанием неожиданно сравнима с малодоступной и дорогой o1. Чисто субъективно, по чисто человеческим моим субъективным предпочтениям в очень узком классе задач, которые я даю с промптом "отвечай как исследователь уровня профессора", а то без этого любая LL-модель отвечает маркетинговым бла-бла-бла или цитатами из школьных учебников. Конечно, мои предпочтения при этом расходятся с препочтениями толпы, и мои личные оценки моделей не совпадают с оценками в пузомерках -- что бенчмарках, что в аренах.
А как вообще оценивать интеллект?
Концептуальная трудность теста интеллекта: он должен решать проблемы, которые раньше не видел. То есть сама идея "экзамена" и "подготовки к экзамену" тут не проходят: если известна функция награды, её при подготовке к экзамену читят. Вся официальная система образования показывает ровно такой результат: вместо подготовки к жизни готовят к ЕГЭ, а в вузах -- к госам. Выпускники отлично умеют сдавать экзамены! Работать и нормально жить, правда, не могут -- но зато с экзаменами всё очень хорошо! Проблемы эти я описывал в 2022 году в "Как определить, правда ли, что мы делаем людей умнее?", https://ailev.livejournal.com/1604070.html. Ибо я сам берусь за то, чтобы сделать людей умней, обучаю (pretraine, finetune, RL -- или как они там называются для людей) их мокрую нейронную сетку. Выход тут один: вместо экзаменов выпускать в мир, пусть там решают реальные задачи, которых не видел ни студент, ни препод.
И это мы переходим к полностью альтернативному подходу к замерам интеллекта, это open-endedness. В этом подходе в явном виде задаётся тот, кто делает бенчмарки -- это тоже должен быть AI-агент, ибо люди быстро выдохнутся. Один агент быстро-быстро учится решать проблемы предъявленного класса, а другой учится сочинять интересные проблемы. И работают они в паре. Собственно, так происходит в большинстве пузомерок-бенчмарок -- начиная с Glue и SuperGlue (забыли о таком? А ведь весь мир за ним следил! Вот: https://super.gluebenchmark.com/leaderboard). И даже ARC повторил ту же судьбу: агенты таки научились его решать, и команда в этом году приготовит новые проблемы -- при этом там простой критерий, это же бенчмарк для "догнать людей", поэтому берут проблемы, в которых люди ещё как-то ведут, имеют "аппаратное преимущество". Мне это напоминает гонку синтезаторов в музыкальной промышленности: когда появились электронные синтезаторы, ожидалось, что будет спрос на невиданные ранее звуки, музыка рванёт в новые неизведанные сферы, творцы получат неограниченную тембровую палитру! В какой-то мере это произошло, но в малой. Основное с этими синтезаторами было -- повторить "в ноль" звучание самых разных уже производящихся роялей, самых разных знаменитых убогих электропиано, акустических органов, всего, что было. Не новое -- повтор старого! Вот с интеллектом то же самое: не прорыв в новый интеллект, которому доступна будет иная продвинутая физика, иная продвинутая этика, иное хоть что-нибудь. Нет, задача "повтора в ноль" возможностей людей -- разве что пять лет назад достаточно было для декларации успеха повторить школьника, а сегодня вроде уже надёжно повторяется доктор наук (но злые языки говорят, что этот доктор наук по химии до сих пор рисует плохие картинки, а по самой химии почему-то выдаёт все секреты горючих, ядовитых, взрывающихся веществ, то есть честно рассказывает про всю химию, а не только про школьную).
Итак, нам нужен подход с двумя агентами: один решает проблемы, но другой придумывает интересные проблемы (не задачи, которые можно решить по уже известному алгоритму) -- и ещё можно подумать о демиурге, который творит мир, в котором формулируются эти проблемы. С демиургом можно поступить попроще -- выдать для работы этих двух агентов реальный мир, но это не совсем безопасно. Если же выдать виртуальный мир, то мы пока не умеем выдавать достаточно богатый мир, чтобы в этом мире мог проявить себя достаточно могучий интеллект.
В любом случае, поручать AI в этом мире надо решать не все проблемы, а только интересные проблемы. Если у вас победитель того самого конкурса Чайковского в гостях, то "в народе" его попросят, скорее всего, сыграть "Мурку" -- но это неинтересно. Интересно дать ему задачу, которую он сходу не сможет решить, но после её решения окажется, что культура агентечества (я специально не сказал "человечества", ибо не факт, что мы говорим о людях -- но про людей рассуждения, замечу, те же самые) стала немного выше.
Это всё типовые разговоры для сообщества open-endedness, которая в мире AI до сих пор держится особнячком. Но там всё тоже бодренько. Вот, например, манифестик от DeepMind — https://arxiv.org/abs/2406.04268 (русскоязычный обзор в https://t.me/gonzo_ML/2743), вот один из относительно свежих обзорчиков, https://press.airstreet.com/p/open-endedness-is-all-well-need, вот свеженькое от Stanley и Lehman, https://arxiv.org/abs/2501.13075.
И вот мой текст про следующий шаг после reasoning/thinking models — https://ailev.livejournal.com/1752457.html (я там пытаюсь провести параллель исследований по open-endedness и по eco-evo-devo).
Пузомерки дадут нам болванов для нашего прикладного интеллекта
Но что бы я тут ни писал, общие пузомерки останутся -- и lmarena, и конкурс ARC, и все остальные. Голы, очки, секунды. И, конечно, придётся выдавать коммодитизированный продукт, который имеет заведомо высокие оценки на всех таких пузомерках. Умный "вообще", никто в вашей задаче.
Будут болваны (от болванок для токарного производства), из которых таки будут делать что-то удобоваримое для каждого применения.
Вот я в какой-то мере описываю сегодняшний момент коммодитизации неживых мозгов в 2017 году, 28 июня -- "Болваны для искусственного интеллекта", https://ailev.livejournal.com/1356016.html. Препринт "Attention is all you need" появился в первой его версии 12 июня 2017. Могу себе очередной зачёт поставить по предсказаниям — там написано, что "AI будет коммодити и дешевле грибов". Всё так и есть, уже!
А вот отёсывать эти commodity интеллекты для решения узких классов прикладных задач (делать из неотёсанных болванов прикладные интеллекты) — тут непаханное поле, эта музыка будет вечной, и для неё не кончатся батарейки тестов. Особенно, если учесть теорему бесплатного обеда, что нет универсальных алгоритмов. Скажем, вот исследование о том, что thinking модели -- это просто попытка эмулировать внешний reasoner, символический вычислитель, "To CoT or not to CoT? Chain-of-thought helps mainly on math and symbolic reasoning", https://arxiv.org/abs/2409.12183. Для меня этот результат означает, что нейронная сеть выучивается работать символьным вычислителем, что ещё надо показать, насколько эффективно -- он же на нейросети работает дьявольски медленно! Скажем, вот как тяжело работает геометрический вычислитель на спиралях (helix, а не "Феликс"), просто чтобы складывать числа -- https://arxiv.org/abs/2502.00873. И такое, заметим, происходит со всеми символьными/точными вычислениями.
Поэтому кроме open-endedness надо ещё понимать, что проблемы начнут решаться в сторону:
-- ухода от естественноязыковой дискретности в размышлениях
-- специализации аппаратуры для разного сорта алгоритмов, которые будут эффективны в разного сорта проблемах
-- сетевой организации интеллектов: как сделать MoE на сети, где Experts от разных поставщиков. Кто там "системный интеллект", который будет всё роутить? Кто там будет править этим миром? Кто будет мозгом для мыслительного тела? А кто будет иммунной системой, защищающей от паразитов?
Но это уже темы другого поста.
Update: обсуждение в https://www.facebook.com/ailevenchuk/posts/pfbid02pMAPsWJFAPGxFKQt2gq1ZM867pSefs6F8t6VWXaUTwkJHTkdFb8NTreVxJetGeNol
Предрассудки по поводу измерения интеллекта: путают с прикладными курсами
Очень часто вокруг учебных проектов возникает дискуссия по поводу оценки/измерений результатов обучения («инженерные обоснования» того, что результаты обучения соответствуют ожидаемым). Очень хочется оценить квалификацию «заготовок для мастерства на входе» в формате каких-нибудь «вступительных экзаменов» и оценить квалификацию в «результирующем мастерстве на выходе» в виде выпускных экзаменов. Вроде бы это всё должно быть похоже на результаты инженерных проектов с их испытаниями, в крайнем случае на «доказательную медицину». Но нет, всё оказывается существенно сложнее.
Во-первых, выставление какого-то уровня мастерства сдачи экзамена/теста как KPI приведёт только к тому, что все остальные потенциальные результаты обучения будут так или иначе проигнорированы, и будет показан высокий KPI, то есть участники обучения будут попросту натасканы на прохождение нужного теста (как в школах натаскивают на ЕГЭ), а собственно обучения какому-то мастерству (кроме мастерства прохождения теста) не будет: индикатор, который стал целью, перестаёт быть измерителем успеха, перестаёт быть индикатором чего бы то ни было, кроме достижения собственного значения1. Более того, в обучении экзамен пригоден только для показа того, что выполняется какая-то отдельная операция, да и то не в каких-то рабочих условиях, где полно непредвиденностей и отвлекающих факторов (помним про контексты и перенос обучения в жизнь). Скажем, можно на уроке физкультуры проверить, удаётся ли пробежать стометровку на норматив. Но это ничего не скажет, насколько человек умеет двигаться, если считать результатом занятий физкультурой именно «умение двигаться» (например, сможет ли он танцевать или ходить под парусом, или поднять тяжесть, или даже пробежать, но марафонскую дистанцию, или выйти победителем в поединке греко-римской борьбы).
Сравнение с расхожими практиками «доказательной медицины» (которые тоже критикуются, см., например, работы Judea Pearl и Scott Mueller2) тут тоже не проходит. Например, использование двойного слепого метода: набираем две группы людей, одну учим ерунде, вторую учим как надо, а потом замеряем результаты обучения двух групп, при этом «слепым методом», то есть преподаватели не знают, учат они ерунде («плацебо») или настоящим умениям! И те же проблемы, что в медицине: имеем ли мы право вместо потенциального лечения давать пациентам плацебо в контрольной группе, или нет? Так и тут: имеем ли мы право вместо потенциально хорошего обучения обучать контрольную группу ерунде, или нет? И насколько можно собрать однородную группу, чтобы верить статистике? Оценка результатов обучения по тем же методам, что в науке и инженерии (с принятыми там критериями инженерных обоснований) в обучении не проходит.
Всё с оценкой результатов обучения становится ещё хуже, если речь заходит об измерении интеллекта как результате образования, ответе на вопрос, делаем ли мы людей умнее, а не учим ли мы их решать какой-то узкий класс заранее известных задач. Эта проблема сейчас стоит перед исследователями AI, она подробно разбиралась в курсе «Интеллект-стек».
По поводу измерения интеллекта есть множество предрассудков, которые упираются в непонимание природы интеллекта: интеллект как мыслительное мастерство изготавливает прикладное мастерство решения какого-то класса задач. Все предложения немедленно устроить экзамен какого-то сорта проваливаются: если мы понимаем, какой экзамен, то будем не мыслить учиться, то есть разбираться с неизвестными тебе ситуациями, а сразу прикладному мастерству, которое проверяется на экзамене. Всё самое плохое, что говорят про ЕГЭ как оценку школьника по критерию «готов к жизни», будет также применимо и к сдаче экзамена на «наличие интеллекта»: в новых ситуациях это экзаменуемое не будет встречаться, преподаватели будут тебя натаскивать на лёгкое прохождение экзамена, а не на решение будущих неизвестных проблем, а вот нужное для решения очередной новой проблемы никогда не будет проверено — непонятно ведь, что проверять! Chollet в работе «On the Measure of Intelligence»3 (обязательно читать тамошний литературный обзор!) чётко формулирует: интеллект достаточной универсальности должен справляться с задачами, о которых не знает не только ученик, но и преподаватель. По факту это означает, что преподаватель не может сделать тест на решение этих задач — он этих задач ещё не знает, поэтому и не может предложить! Точно так же не может сделать тест на интеллект и кто-то «независимый»: тестироваться должно решение проблем, о которых может не знать ещё и этот «независимый экзаменатор»!
А ведь есть и другие характеристики интеллекта. В курсе «Интеллект-стек» приводилась характеристика вменяемости. В исследованиях по GAI используются характеристики безвредности/harmlessness и «помогательности»/helpfulness и честности/honest4.
Все предрассудки по поводу «покажите результаты измерений вашей работы по усилению интеллекта» упираются в то, что в головах людей крепко вбиты представления о тестировании интеллекта людей экзаменами (неважно, выпускными или вступительными, включая собеседования при поступлении на работу), а продолжение разговора идёт в сторону испытаний традиционных неинтеллектуальных инженерных систем, которые должны решать понятный и оговорённый жёстко зафиксированный не меняющимися требованиями класс задач. Все идеи по поводу оценки интеллекта, которые не укладываются в эти давно устаревшие представления — не будут услышаны.
Интеллект — это совершенно другой объект, это не прикладное мастерство, хоть как-то проверяемое! По поводу интеллекта можно вдуматься, почему появилась пословица «умная голова дураку досталась»: сущностей в умности оказывается две, ибо одна про интеллект как мыслительное мастерство разбираться с незнакомыми ситуациями и новыми классами задач, другая про разные-всякие прикладные умения решения узких классов задач, которые понятно как решать. И ещё есть «злой гений», что тоже не выявляется традиционными тестами «на умность», при этом этичность (те самые harmlessness, helpfulness, honesty, но не обязательно именно они) тоже непонятно как замерять.
Умная по части умений голова (хорошо надрессированная на какие-то практики типа решения математических задач какого-то понятного класса, управления джипом или даже самолётом, отрисовка сложных деталей в САПР, и т.д.) дураку в части интеллекта досталась: при столкновении с новым и необычным никакое владение прикладным мастерством не помогает, нужно включать мышление, и если сильного интеллекта с его мышлением по решению никогда не встречавшихся проблем нет — то вот ты и дурак!
Образование должно делать людей умнее, то есть усиливать интеллект. Одна из характеристик сильного интеллекта — это универсальность в части решаемых с какой-то приемлемой скоростью проблем: интеграл по скоростям решения самых разных проблем из бесконечного числа их классов. Высокая скорость решения в одном классе проблем — это ничто, маленькая скорость на большом числе проблем — тоже ничего не даст, а вот приличная скорость на приличном числе проблем — это то, к чему стремимся. То есть что-то типа теста IQ: берём батарею тестов разных типов (универсальность) и суммируем (интеграл) время решения задач этих тестов (скорость). Chollet говорит, что для замеров силы машинного интеллекта мы можем взять за основу только то, что нам известно про людей: у них есть какие-то врождённые особые способности выделять из мира правильные с точки зрения освоения новых классов задач объекты — innate priors в их универсальных алгоритмах, реализованных нейронными сетями мозга. И дальше говорит: а давайте сформулируем то, что есть у людей, и будем эти же innate priors замерять у машинных интеллектов. По факту оказалось, что его тестирование очень похоже на тест IQ для людей. Дёшево, но удивительно не сердито: IQ оказывается не лучшим критерием для определения реально умных людей, успехи в жизни оказываются не так впрямую зависят от IQ (хотя дебилов этот тест может помочь отсеять, но нам же умных надо делать ещё умнее, а не дебилов отсеивать!). Тут даже не нужно приводить ссылок, про недостатки замеров IQ для людей горы литературы, про это подробно говорилось в курсе «Интеллект-стек». Про недостатки замеров самых разных характеристик силы интеллекта AI-агентов, в том числе и путём сравнения с замеренными характеристиками людей говорилось тоже очень много. В частности, нет хорошо определённых характеристик интеллекта для «людей». Дикарь из джунглей Амазонки, средний отвечающий на тесты пенсионер из сельской местности, профессор топового вуза с родным английским языком будут демонстрировать очень разные характеристики интеллекта, включая все эти harmlessness и helpfulness, а также honesty и даже persuadability, равно как и IQ. Но все они будут умнее кошки, это без сомнения. Как их сравнить друг с другом так, чтобы разница стала очевидна?! И как взять разницу не в целом по итогам пары десятков лет обучения и «просто жизни», но по итогам прохождению каких-то учебных программ? Тем более, что эти характеристики непрерывно меняются, нейросети в людях непрерывно доучиваются, и оценка «сегодня» будет неверна уже «завтра». Хорошего SoTA ответа на эти вопросы нет.
Люди, или люди с машинами, или коллективы — кто судьи в том, что они поумнели по итогам обучения?
И тут нужно заметить, что проблема «измерения результатов обучения» отличается от проблемы проверки «есть ли у железяки/человека интеллект». Нам же нужно не «есть» или «нет», а выдать дельту между «было» до обучения (включая образование) и «стало» после обучения. Так что методы, которые дают «однозначный ответ» типа теста Тьюринга, неприменимы. Вы не можете посадить будущего нобелевского лауреата за занавесочку и простого выпускника вуза за ту же занавесочку, а затем попросить экзаменационную комиссию определить, кто из них кто. В самой предметной области инженерии AI-агентов уже признаётся, что машины становятся умней людей, и нужно уходить от людей как оценщиков, оценщиками машин дальше будут тоже машины, люди будут не способны оценить интеллекты, более умные, чем они сами5.
В то же время есть неформальные способы оценки, например, отбор «похожих на себя», кооптация в разные сообщества людей с общепризнанной силой интеллекта или степенью квалификации в прикладном мастерстве: «мы академики, признаём вот этого Имярека тоже академиком, считайте его интеллектуалом» и параллельное «вон та академия признала вон того интеллектуалом, так там лжеакадемики, наша академия не признаёт его никем, кроме как шарлатаном», только в сегодняшнем варианте кооптировать сверхинтеллекты после их усиления предлагается даже не людям, а машинам. Так что и это решение не слишком помогает, никакой «объективности» нет, критики не избежать.
В любом случае, «выход за пределы судей-людей», равно как выход за пределы усиления интеллекта именно людей в интеллект AI-агентов и даже интеллект команд — это тренд сегодняшнего дня.
Тут можно указать, что усиливать интеллект можно даже не по линии методов решения проблем, а на уровне самой постановки задачи. Так, на курсе «Моделирование и собранность» за один семестр из студента ШСМ делают человека-киборга: студенту отращивают компьютерный экзокортекс и приучают им пользоваться, реализуют эвристику «два года ты работаешь на цеттелькастен, потом цеттелькастен всю жизнь работает на тебя». Речь идёт о мастерстве «мышления письмом» для управления памятью и вниманием при помощи компьютера, а не только «хорошо тренированного живого мозга», мастерство в практике помодоро (компьютер отслеживает время), мастерство трекинга работ (модификации GTD и поддерживающий их софт типа Focus To-Do6). Далее второй семестр программы «Организационное развитие» учит системному моделированию для удержания уже в нескольких головах деятельности немаленького предприятия.
Помогает ли это с новыми классами проблем, которые будут встречаться после обучения, то есть усиливает ли интеллект? Конечно! Это ж всё будт просто новые «проблемы» как объекты, их нужно выявить (моделирование), удержать во внимании (собранность), запланировать на их решение время (операционный менеджмент), обсудить с коллегами (коммуникация, включая риторику), и всё это только для того, чтобы их решить быстрее, независимо от класса этих проблем. Далее контрольный вопрос: проверять усиление интеллекта будем вот этого киборга из человека и его софта, или требовать сдать смартфон перед проверкой и изображать из человека «выживанца в ядерной катастрофе», как это происходит во время ЕГЭ, когда нельзя пользоваться компьютерной техникой и нельзя выходить в интернет? Проверять решение этим человеком-киборгом проблем в одиночку (интеллект-in-the-small), или проверять таки, что он адекватно решает проблемы в коллективе (интеллект-in-the-large), а потом ещё и может организовать коллектив на решение проблем (системный менеджмент), и замерять прирост скорости решения заранее неизвестных проблем, которые решает коллектив, оснащённый суперкомпьютерами? Идея «покажите мне экзамен, который гарантирует, что вы сделали человека на 24.2% умнее» быстро разваливается после таких вопросов. «Если король просит генерала перепархивать бабочкой с цветка на цветок, а он не выполняет приказ — то кто виноват, генерал или король?», вот это рассуждение как раз про тех, кто требует организовать какое-то «приборное» измерение усиления интеллекта студента по итогам прохождения им образовательных программ.
Ещё одна линия вопросов — это про тот самый интеграл по классам проблем. У Chollet это формулировки типа «все классы проблем, которые может встретить человек» или «все классы проблем, которые могут быть во Вселенной», то есть включая проблемы, недоступные человеку, включая проблемы недоступные человечеству со всеми его компьютерами. Если задачу может решить машина Тьюринга за бесконечное время, то это считается вполне решаемой задачей в математике! А в жизни? В жизни какая-нибудь супер-дупер машина Тьюринга будет решать эту задачу миллиарды лет, то есть по факту задача будет «нерешаема». Хороший тут пример — это доказательство того, что нейронная сетка неограниченной ширины может аппроксимировать с заданной точностью любую функцию. Для математиков — «может», для физиков — «может для простейших случаев и нынешних компьютеров за миллиарды лет, для сложных случаев вы даже представить не сможете, сколько это лет». То есть измерение прироста интеллекта ещё и должно давать не только приемлемую математическую оценку интеллекта «для всех классов задач, которые могут встретиться человечеству или вообще во вселенной», но и быть реализовано физически так, чтобы давать оценку за приемлемое время и с низкими требуемыми ресурсами. Но как узнать, какие проблемы в каких проектах встретятся человеку через год-два, да ещё и как оценить, может ли человек-выпускник решить эти проблемы, и какая затрата ресурсов при этом будет считаться приемлемой?
После курсов усиления интеллекта хотелось бы, чтобы их результата хватало бы хотя бы на некоторое время (лучше бы годы, чем месяцы) после окончания этих курсов. Интересует усиленный интеллект, который и впрямь встретит что-то непонятное и неизвестное его носителю, а то и всем людям на глобусе, и разберётся с проблемой!
И тут опять нужно обсуждать не людей, а «интеллектуальных агентов», то есть xGI (natural general intelligence, artificial general intelligence, hybrid general intelligence и так далее). Люди, люди с компьютерами (например, со смартфоном) и доступом к гуглу и ChatGPT, группы людей и компьютеров, только компьютеры с универсальными алгоритмами AGI, всё пойдёт. Но что и как из этого измерять, каким способом?!
В AI это обсуждается как неправильность ориентации всех исследований и всей инженерии xGI на достижение SoTA в каких-то уже известных бенчмарках, ибо это всё равно как сдача экзамена по ЕГЭ: на пять баллов сдал биологию и математику, а в жизни тебе потребовалось пожарить из коровы котлету — и там сразу этика, диетология и кулинарное искусство, а экзамен ты сдавал по биологии, и тебе это в жизни никак не помогает, хотя в биологии изучают в том числе и коров и даже могут упоминать, что живых существ нужно беречь (забывая упомянуть, что коров на планете много больше, чем можно было бы ожидать их встретить в дикой природе именно из-за того, что их разводят специально. То есть коровам вроде бы свезло, что их едят! Но и это знание про везучих коров никак не помогает пожарить котлету!).
И никакого SoTA в смежных требуемых областях у тебя после сдачи экзамена нету, и ты умён только тогда, когда покажешь скорость освоения этого всего для тебя нового, другие прикладные навыки будут не в счёт. В России ЕГЭ по литературе давно уже сдан универсальным алгоритмом7. И что, будем считать эти алгоритмы «готовыми к жизни», то есть сравнимыми как-то по интеллекту со школьниками, сдавшими тот же ЕГЭ? А когда они сдадут на пятёрку, как тогда (а ведь уже сдают, во всех странах, и не только школьные экзамены, но и вузовские)? А если сделаем что-то типа батареи таких тестов, «все ЕГЭ, что требуются в России», то будем ли считать алгоритм не глупее школьника-выпускника с такими же оценками? Эх, не работает ориентация на проверку знания SoTA в каких-то областях, акцент ведь должен на создании новых SoTA-практик, открытии новых предметных областей. И проверяется SoTA в этой работе с непредвиденным, а не SoTA в решении известных задач!
Нужно замерять не столько врождённый интеллект, сколько выученный интеллект
В работе Chollet утверждается про единственный ориентир в измерении интеллекта: наличие innate prior у людей, то есть того факта, что уже известно: человеческие детёныши выучиваются очень многим классам задач, если дать им на это не слишком большое время (но время это — десятки лет!). Ещё известно, что как-то эта способность детёнышей человека коррелирует с результатами тестов на IQ (решение простейших задач на выделение каких-то геометрических объектов из фона, распознавание и сравнение паттернов — то есть умение заметить какие-то закономерности в том, что вы видите, и можно сюда добавить «и слышите, и нюхаете»).
В части усиления интеллекта мы работаем на двух уровнях:
-
innate priors (врождённый, хардверный интеллект какой-то силы. Выпил кофе или наелся ноотропов, а в компьютере заменил поколение процессора и версию универсального алгоритма, и это интеллект усилился!)
-
inductive bias/предвзятости в рассуждених, которые мы познаём/выучиваем. Прошли какие-то (не любые!) курсы — и интеллект усилился. Разные курсы, разные усиления интеллекта, хорошо бы как-то проверять, какие курсы на сколько усиливают. Собственно, требование «измерить результат поумнения» как раз про это.
Так вот, никакие тесты типа IQ не срабатывают с inductive bias, и именно поэтому тесты IQ никак не измерят способность смышлёного дикаря с высоким IQ в плане решения новых задач в физике, менеджменте или строительстве звездолётов, не покажут, что выпускник элитного вуза с не очень высоким IQ, но который честно учился, чему-то «исподволь» научился и поэтому сможет решать неизвестные ранее задачи лучше, чем необученный, но очень смышлёный дикарь.
План наш в том, что мы будем повышать интеллект не «исподволь» путём обучения на каких-то произвольно взятых курсах (даже если говорить о курсах математики, физики и других, ассоциируемых с особым умом), но путём обучения именно мыслительным практикам интеллект-стека, именно эти мыслительные практики помогают справиться с ранее неизвестными проблемами. Мы делаем гипотезу (как культуртрегеры), что это правильные inductive biases, правильные предвзятости в рассуждениях, которые ведут не столько к искажениям в этих рассуждениях, сколько действительно к ускорению разбирательства с задачами, которые могут сегодня встретиться цивилизованному человеку.
Решение проблемы: ориентироваться на то, как проверяет интеллект эволюция
Так что ж делать? Как нам узнать, становится ли интеллект сильнее после каких-то учебных программ, или не становится?! Речь идёт даже о прикладных учебных программах, которые должны, по идее, давать не строгий набор каких-то конкретных навыков, а какой-то прикладной интеллект: умение действовать в ситуациях, которых не было в учебниках. Скажем, прикладная программа по телесному интеллекту (курс системного фитнеса) должна давать возможность разобраться с телом в ситуациях, в которые не попадал ни ученик, ни учителя (авторы курса, преподаватели). Скажем, вам в голову не приходило, что вы займётесь скалолазанием. Но вдруг попали в соответствующую ситуацию — и если телесный интеллект у вас есть, то вы разберётесь, и справитесь. Так что мы не будем тут даже уточнять, прикладной какой-то интеллект (а не набор конкретных прикладных навыков выполнения каких-то узких практик) или общий интеллект. Можно вообще говорить о «калибре личности» (например, «Вася — мощная личность!») как о сумме всего мастерства агента (интеллект плюс разнообразные прикладные мастерства). Как проверить, вырос ли «калибр личности»?
Надо применять эволюционный подход в инженерии: если после наших курсов люди и/или AI-агенты, или их команды начинают решать какие-то новые проблемы в количестве и с большой скоростью, то это будет означать, что их интеллект поднялся, помог освоить (иногда изобрести, иногда выучить на прикладных курсах) прикладные практики в новых областях. «Калибр личности» тем самым в результате обучения оказывается выросшим, и рост идёт тем быстрее, чем больше идёт акцент на фундаментальное образование, то есть усиление интеллекта, а не прихват прикладного мастерства по разным практикам.
Если «наши» выпускники более конкурентоспособны, чем «не наши» выпускники, то их интеллект мы усилили сильнее, чем это делают конкуренты. Если нет, то нет. Всё как в природе. Проверка качества образования идёт в реальной жизни, а не на экзаменах. Выпускников Гарварда и Оксфорда знают по тому, что им удалось сделать за свою жизнь, а не по тому, что им удалось сделать на экзаменах.
То есть смотреть нужно не на момент выпуска студента как свежеиспечённого мастера, а на происходящее затем с мастером в жизни. Грубо говоря, если из вашей школы вышло десять нобелевских лауреатов, а из других только по одному, то с научными проблемами у выпускников ОК. Если из другой школы вышло пятнадцать мультимиллиардеров, то там с подготовкой в части проблем бизнеса ОК. Можно, конечно, дальше задаваться вопросами: это школа на входе таких талантливых берёт и потом не портит, или таки реально чему-то выучивает, что такие результаты? Исследования такие были, они показывают, что какой-нибудь Гарвард в плане обучения не так сильно меняет людей, как какой-то победитель в категории «доучиваем с нуля до крепкого среднего класса» из глубинки США. Вот там, в отличие от Гарварда и Оксфорда, реально берут проблемных представителей «меньшинств» и доучивают до крепкого среднего класса! Прирост знаний колоссальный, такой вуз реально делает людей умнее, даёт успех в жизни заведомо не очень успешным. Но поскольку обучение идёт только до крепкого среднего класса, а не до элиты — гениальность рекордсменов по умению учить никому не известна, кроме специалистов. Кто лучше учит, тот неизвестен! И присовокупите сюда то, что все эти Гарварды-Оксфорды берут детей из таких семей, где в самих семьях их могут чему-то важному доучивать, так что и результаты замеров по итогам обучения будут «университет+доучивание в семье», то есть измеряется тоже не-пойми-что, а не итог обучения в вузе. Недаром лучшие университеты сопротивляются планам обеспечить всем «равные возможности поступления»: король-вуз после этого может оказаться голым, правдой окажется, что важны не получаемые в вузе знания, а просто правильная компания тщательно отобранных сокурсников!
В любом случае, смотреть нужно прежде всего на разницу между демонстрируемым результатом прохождения учебной программы (выпускными испытаниями) и результатом задействования практики в жизни. Волновать должны не «экзамены» на момент выпуска, «конечная стадия изготовления мастера», но поведение мастера в момент встречи с проблемами из жизни — то есть поведение во время эксплуатации выученного целевого мастерства. Перенос обучения в жизнь — это главное, но и тут есть нюансы. Так, задействование мастерства в рабочих ситуациях происходит иногда существенно позже, чем момент выпуска. Может быть, выученное новое мастерство придётся задействовать только через дни, недели, месяцы, годы после выпуска. И тут же станет понятно, насколько при обучении учли кривые забывания: на утро после «выпускного экзамена» материал будет помниться, а через пару недель согласно кривым забывания будет помниться не более половины освоенного в курсе материала, если обучение ведётся «для сдачи экзамена». Поэтому продолжаем следить за квалификацией выпускников после их выпуска, степень мастерства отслеживаем долго во времени8.
Если команда учителей подняла интеллект студентов достаточно, чтобы выпущенные мастера отслеживали собственное мышление и коллективное мышление в своих проектах, то они смогут внятно рассказывать о своих успехах, включая рассказ о том, как они применили полученные на курсах знания интеллект-стека при решении проблем. Если их квалификация быстро и массово растёт после окончания курсов, значит усиление интеллекта есть. Если не растёт, то усиления интеллекта нет. Конечно, тут нужно учитывать «непрерывное обучение»/continuous learning, понимаемое как часть общеинженерного «непрерывного всего»/continuous everything: нужно поддерживать SoTA свежеполученного мастерства постоянно, пока пользуешься этим мастерством, то есть постоянно доучиваться, причём в учебных программах образования (усиления интеллекта) постоянному доучиванию тоже надо учить: рост «калибра личности» после выпуска будет показывать заодно и то, насколько хорошо научили «развивающегося» ещё и непрерывному обучению, удержанию SoTA во времени.
Новации ШСМ в определении того, что она делает людей умнее
Оценка успешности выпускников есть, но она происходит не на задачах, которые даёт Школа, а на задачах, которые даёт жизнь. Берёшь в жизни рабочий проект (экзаменационный билет даёт не экзаменатор, а жизнь), делаешь, приносишь в Школу, рассказываешь об успехе. Если успех в плане решения проблем есть, растёт твоя агентность (адаптивность к изменяющимся обстоятельствам, инициативное нахождение и решение проблем), то у тебя рост квалификации.
Напомним: квалификации эти отличаются направленностью на изменения мира к лучшему (чем больше нацеленность на изменение не только собственной модели себя и модели мира, но и изменения самого себя и мира, тем больше агентность):
-
специалист — "ах, какой я стал крутой, как круто работаю",
-
практик — "вот тут мы с командой творим разное интересное, я сильно всем помогаю работать, договорился со всеми, вписался в мир",
-
мастер — "я помогаю людям вокруг моей команды работать много круче, договорил их всех, вписал их в мир".
Квалификации выбраны не произвольно «из головы», а соответствуют уровням EQF, пост-блумовского9 European qualifications framework10, к которому Stephen Downes написал диаграмму-оглавление11 и далее её перевела на русский язык Cветлана Панюкова12.
Прохождению этих квалификационных ступенек содействует программа «Организационное развитие» (и перед ней программа «новая грамотность»). Вот в табличке показано, как семестры этой программы (номера семестров на стрелочках переходов между строчками таблицы) должны влиять на квалификацию в случае успешного прохождения:
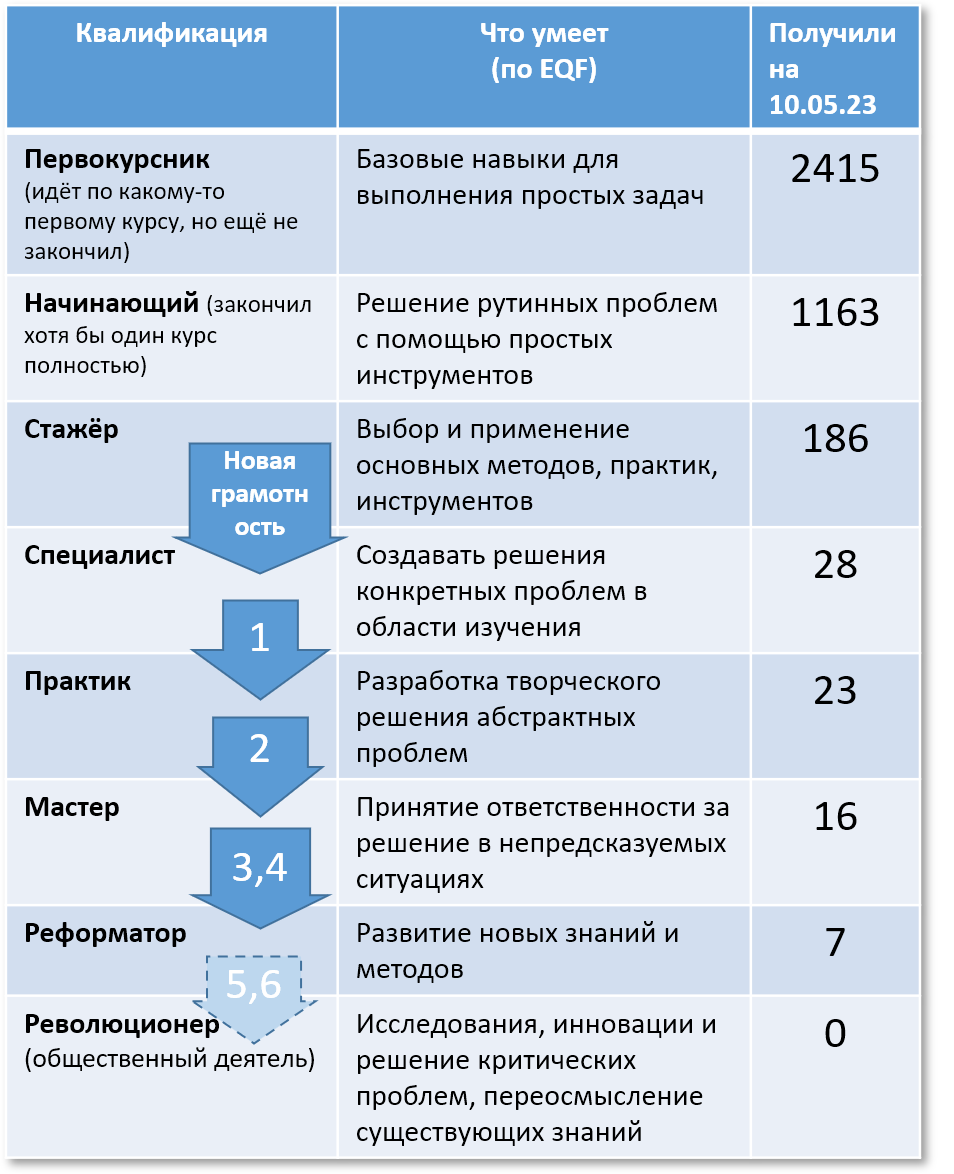
На данный момент семестры программы «Организационное развитие» предусматривают следующий рост квалификации, который определяется содержанием учебной программы из шести семестров:
-
Моделирование и собранность
- Фундаментальный курс
-
Системный менеджмент и инженерия
-
из инженеров в менеджеры
-
из практиков в мастера
-
-
Объяснения и риторика
- Фундаментальный курс
-
Лидерство себя, коллектива, сообщества
-
из менеджеров в агенты развития
-
из мастеров в реформаторы
-
-
Образование для образованных
- Выход на фронтир в мировоззрении, умение обучать
-
Аналог учебной программы аспирантуры
-
Исследовательский проект с прикладным результатом выхода на фронтир
-
«диссертация» (учебная программа): документирование выхода на фронтир, а там как свезёт с выходом в «революционеры»
-
Предполагается, что на текущий момент позитивные результаты в виде поумнения от учебной программы ШСМ есть уже у всех «для личного пользования», только эти позитивные результаты надо дотащить от пользы для себя до пользы и для других людей. Поэтому попробуем распространить подход к оценке обучения как возможности менять мир вокруг себя не к внешнему миру личности, а к самой личности, зайдём «внутрь личности», на системный уровень ниже.
Квалифицируемая личность (то есть совокупность всех видов мастерства, которые её и представляют) тут выступает как раз в роли внешнего мира, а какой-нибудь Self или роль «развивающийся» (мастер развития личности, это внешняя роль в проекте обучения) в составе этой личности — носителем квалификации по изменению себя. Если есть какие-то понимания собственной личности, и дальше ничего не меняется в жизни личности, то это агент-специалист. Специалист себя верно оценивает, углубляет своё понимание себя, и на этом всё заканчивается. Если «развивающийся» продуктивно сотрудничает со своей личностью, «принимает и учитывает себя при планировании деятельности», сорганизовывается/собирается на выполнение какой-то уже известной агенту практики — это агент-практик. А «развивающийся меняет свою личность к лучшему» — это уже мастер по изменению себя, то есть развитию, понимаемому как обучение чему-то новому, новым видам мастерства, организации своей «внутренней команды» исполнителей разных личностных ролей.
Но «мастер» — это не конец линейки квалификаций. Дальше идёт «реформатор», по шкале EQF — это «развитие новых знаний и методов», при этом мы понимаем, что речь идёт о развитии знаний и методов уже не внутри личности, а за её пределами. Реформатор организует уже не только свою организацию, но и организации вокруг. В реформаторстве личности «личность, которая внутри себя устроена как команда вокруг Self/Самости/«Я» тоже выходит за рамки организации себя, то есть начинает организовывать личности вокруг себя, учить людей вокруг себя новым практикам, менять личности вокруг себя к лучшему. Это означает, что личность, выходящая на уровень «реформатора личностей» должна быть готова занимать роли в проектах обучения других агентов (людей и не только людей).
В том же oNLP так и учили (по версии ABNLP, The American Board of Neuro Linguistic Programming)13: сначала научись отслеживать себя — это примерно наш «специалист по знанию себя, любимого», затем изменять себя — тут наши «практик по вписыванию в мир себя, любимого» и «мастер по изменению себя, любимого», потом помогать измениться другим (одному агенту-человеку или целой группе сразу, что требует немного других умений), имея опыт собственных изменений — тут наш «реформатор агентов вокруг».
Ещё раз отметим: степени квалификации «специалист», «практик», «мастер», «реформатор», «революционер» по отношению к одной личности (предмет нашего курса инженерии личности) и к организации (предмет программы «Организационное развитие») — разные, это лишь развитие идеи, которая постоянно повторялась в курсе «Системного менеджмента»: материал менеджмента вполне можно применять и для личности, помня, что это разные системные уровни, и поэтому там могут быть какие-то существенные различия. Обратное тут тоже верно: материал по обучению личности можно применять к организациям, они тоже «лица» — и тоже есть существенные различия. Так что квалификационные шкалы разные, но стоящие за ними идеи (и поэтому названия ступеней квалификации) — одинаковые.
То, что человек становится умнее, должен признать не сам провайдер обучения, не специально назначенная внешняя для провайдера комиссия, а какие-то внешние люди, которые видят эффективное решение выпущенными мастерами каких-то проблем. Работодатель, если это ситуация найма. Рынок, если ты бизнесмен. Коллеги-исследователи, если ты учёный. Если тебе начали замечать разные люди, что у тебя системное мышление (после прохождения курса системного мышления), значит, курс добился цели. Если у тебя за счёт использования материалов курсов вчетверо выросла зарплата за пару лет, то это косвенное признание того, что ты что-то стал делать лучше. И так далее. Начальные успехи многих выпускников ШСМ — это то, что они подуспокоились и начали спать по ночам, а их подчинённые перестали вызывать их из отпуска на третий день отсутствия. Это результат «поумнения», а не какие-то баллы за сданный экзамен или получение какого-то сертификата на официальном бланке. Польза сначала для себя! Успех разные люди трактуют по-разному, ибо решаются очень разные проблемы очень разных людей, играющих очень разные роли в очень разных проектах, и начинается это часто с решения личных проблем. Сначала починил себя, потом развил себя, потом чинишь окружение и развиваешь окружение.
ШСМ, как и другие провайдеры обучения, делает квалификации публичными, чтобы можно было брать широкую оценку от самых разных людей. Конечно, всегда будет какая-то критика, но тут как в науке и инженерии: публичность существенно снимает возможные вопросы к качеству оценок. Например, публикуются доклады об успехах выпускников14, а в докладах указывается, что именно из материалов учебной программы было применено в успешных проектах. Для учительской команды полезно и то, что в подобных докладах рассказывается о встреченных мастером трудностях, «что не удалось» — и это позволяет подправить учебную программу, чтобы следующим мастерам это уже было легче, чтобы удавалось больше.
В любом случае, интеллект работает с чем-то новым, а эволюционный успех («революция»: существенное, то есть масштабное и массовое изменение текущей ситуации к лучшему в какой-то сфере) — это то, к чему следует стремиться. Выход успешных новаций за рамки одной организации тут хоть и слабый (ибо мы пока не знаем, это многоуровневая оптимизация свободной энергии, или нет — помним о материалах об эволюции в многочисленных курсах ШСМ), но критерий успешности. «Реформатор» по нашей шкале — это тот, кто сделал маленькую революцию, то есть реформу/трансформацию/оргизменения в крупной организации (а в случае инженерии личности — смог выйти за пределы изменения себя к лучшему на изменения к лучшему окружающих личностей). А вот «революционер» (он же «общественный деятель») — это тот, кто вышел за пределы организации, то есть инициировал и как-то возглавил постановку новой практики/деятельности в масштабах страны или даже планеты.
И ещё замечание про термин «мастер»: 1. «Мастер» в степенях квалификации выпускников ШСМ в части оргразвития, 2. «мастер» в степенях квалификации по изменению себя, любимого по шкале из текущего раздела, 3. «мастер» как состояние ученика (абитуриент, студент, мастер), освоившего какое-то мастерство — это разные словарные значения одного и того же слова. Какое именно значение имеется ввиду (мастер оргразвития, мастер личного саморазвития или мастер как закончивший обучение студент) определяйте из контекста, но не путайте.
Учебные программы дают не только немедленные результаты
Реальные результаты учебных программ, то есть результаты поставленного курсами мастерства (особенно когда речь идёт об образовании, то есть мыслительном мастерстве), проявляются в жизни людей не только и не столько в момент окончания этих учебных программ. Немедленные после окончания учебной программы замеры результатов обучения будут невалидными. Оценка ЕГЭ — это оценка умения сдавать экзамены ЕГЭ (и даже не знания школьной программы по каким-то предметам), но оценка итогов прохождения учебной программы школы должна бы быть по итогам послешкольной жизни: как помогло школьное образование выпускнику школы прожить содержательную жизнь, помочь себе и окружающим. Оценки ЕГЭ с этим мало связаны.
Тут как в инженерии: «твоё устройство хорошо работает у тебя на испытательном стенде, но это не то, что нам нужно: нам оно не помогает, поэтому мы его не принимаем». Можно обсуждать ЕГЭ как развитие идеи инициации15 (трудные испытания, которые проходят мальчики и девочки, чтобы их признали уже взрослыми, или члены религиозного сообщества, чтобы подтвердить их статус), но это явно не образец для подражания в 21 веке.
Автора нашего курса напутствовали в 1975 году на первом курсе его университета в первую же неделю: «мы вас будем учить пять лет в университете странному. После чего вы попадёте на какой-нибудь завод, и выпускник технического вуза попадёт на какой-то завод. Дальше выпускника поставят начальником отдела сразу, ибо он попадёт в привычную для него среду, его учили работать в этой среде. Вы же увидите всё впервые, вас возьмут каким-нибудь инженером. Через год вы тоже станете начальником отдела. Через три года вы резко пойдёте на повышение, ибо таки разберётесь со всеми новыми задачами. А вот ваш коллега из технического института с большой вероятностью так и будет начальником того же отдела, ещё много лет. Вот этим и отличается университетское образование от технического: мы учим разбираться в неизвестном».
Идея такого напутствия была в том, что университет просто поднимает интеллект (он больше провайдер образования), а технический вуз учит прикладной специальности (он больше провайдер прикладного обучения). Но ещё важно, что результаты образования ожидались не на момент входа в какой-то проект, а только через некоторое время, да ещё и с задержкой на год-два. И заранее без шансов на то, что рабочее место хоть как-то будет соответствовать тому, на кого учились (идея образования, а не прикладного обучения). Автора учили на исследователя-физ-химика (прикладная специализация), но автор ни одного дня не работал химиком! И нельзя сказать, что он был так уж неуспешен в жизни: этот успех был ровно за счёт того, что алгоритмику (одна из дисциплин интеллект-стека) автор проходил ещё студентом с 1975 года, машинным обучением занялся с 1977 года, а семантикой пришлось заняться сразу после окончания университета, с 1980 года, ибо работать после университета автор пошёл в исследовательский вычислительный центр, где занимались в далёком 1980 году задачами AI, и без семантики там было никуда. Семантика — это тоже одна из дисциплин интеллект-стека, один из нижних уровней! Так и пошло потом: автор становился умнее за счёт прихватывания по ходу жизни знаний самых разных практик интеллект-стека, а не за счёт прикладного обучения.
Когда делаешь образованных людей умнее, нужно ориентироваться не на момент выпуска и замер в этот момент, а на то, что происходит потом, на протяжении многих лет. Не на однодневный «экзаменационный» замер, а на многолетнюю как рабочую, так и просто полноценную жизнь. И «инженерное обоснование» в образовании требуется для оценки возможности решения будущих проблем, которые ещё неизвестны. Для прикладного обучения такие оценки сделать легче, но проблема всё равно остаётся. Опять же, речь ведь идёт о SoTA. Оценка того, что кто-то способен решать задачи X SoTA практикой Y будет бесполезной, когда SoTA для задач X сменится с практики X на практику Z. Недаром многие профессиональные ассоциации свои квалификации требуют переподтверждать каждые несколько лет (но удивительно, что вузы не требуют переподтверждать свои дипломы!).
В ШСМ среди выпускников пока нет ни одного революционера. Никто из выпускников не произвёл революцию в какой-то отрасли, никто не взорвал какую-нибудь науку, никто не возглавил переустройство какого-то общества. Но это обязательно будет, и свидетельством качества образования в ШСМ будет именно это, а не что выпускники сдали какие-то экзамены.
В этом подходе мы совсем неодиноки. Какая-нибудь букеровская, или нобелевская, или тьюринговская премии делают ведь то же самое, только в узких областях: пытаются найти сильный интеллект в более-менее узком классе проблем, оговорённых организаторами премий. И даже «человек года» журнала Times тоже про что-то такое: премия без премии, указание на какие-то особые достижения в жизни «человека года», указание на его влиятельность на дела многих других людей. Другое дело, что это всё никак не связано с проектами обучения, которые занимались этими выдающимися людьми («революционерами»), идёт без привязки к каким-то учебным программам, которые проходили все эти лауреаты премий или «люди года». Мы же тут говорим про обучение, и причинно-следственные отношения между результатами обучения и достижением результатов. Не про «само как-то случилось, что интеллект усилился за время жизни, вот нобелевка в свидетельство», а «наша образовательная учебная программа усилила интеллект». В ответе на этот вопрос требуется специальное рассмотрение в рамках причинного вывода/causal inference. Но, похоже, сегодня вряд ли такое рассмотрение может быть проведено, знаний человеческой цивилизации для этого пока не хватает.
Пока ШСМ ещё даже не может похвастаться, что её учебная программа закрывает полностью все дисциплины интеллект-стека. И ещё нужно время на глубокое овладение прикладными предметными областями, в которых идёт работа: прикладное мастерство с высоким интеллектом получить быстрее (для некоторых это вообще будет означать «и не мечтал получить, но смог», и уже есть такие примеры среди выпускников), но это тоже требует времени, и часто это даже не недели и месяцы, а несколько лет. Проверяется же интеллект всегда на решении прикладных проблем, а не какими-то «замерами».
Учиться и получать какие-то уровни квалификации на основе демонстрации своих умений менять себя и других агентов, а также менять мир в целом, можно уже сейчас. Равно как уметь отвечать на вопрос «ну, и насколько тебя сделали умнее?» — правильный ответ такой же, как на «вопрос о смысле жизни, вселенной, и вообще»: 42! Как спрашивают, так и нужно отвечать!
Современное состояние науки не может решить и вопрос снижения тревожности в изучении сложных дисциплин (наиболее известна тут «математическая тревожность», она от чего только не зависит, ведущего фактора нет, но есть много работ, которые изучают это явление16), и даже нет согласия на тему, что эту тревожность надо как-то существенно снижать, можно и стресс сделать фактором личностного роста17. Есть и много работ о том, что изучение математики и физики не так уж сильно влияет на «умность», хотя все вопросы про то, как же замеряли это «влияние на умность» остаются. Например, работа «Learning of Content Knowledge and Development of Scientific Reasoning Ability: A Cross Culture Comparison»18 показывает, что изучение физики оказывается не таким уж «выправляющим мозги», как это принято считать. A historically held belief among educators and researchers is that training in physics, which has a beautiful structure of logical and mathematical relations, would in general improve students’ abilities in conducting reasoning that is intellectually challenging. However, the result from this study suggests that training in physics content knowledge in the traditional format alone is not enough to improve students’ general reasoning abilities). Ещё есть материалы, обсуждающие beyond concept inventories towards measuring how students think19, где рассматриваются проблемы попыток измерения качества мышления студентов, а не попыток измерения имеющихся у студентов знаний, которые не факт что ведут к качественному мышлению, но всё это очень плохо технологизируется по сравнению с concept inventory моделированием, которое оценивает не столько мышление, сколько знание SoTA понятий, а не каких-то народных/наивных/старинных понятий.
Пока в проблеме измерения интеллекта нет особого продвижения, мы в ШСМ будем использовать нейронные сетки множества (публичность!) наших собственных мозгов как неплохих квантовоподобных (и плохих байесовских, подробнее в курсе «Интеллект-стек») вычислителей по переводу разговоров, личной переписки, обсуждений докладов наших студентов и выпускников в заявления об эффективности нашего обучения. И всегда готовы услышать про новинки в решении проблемы демонстрации качества обучения мыслительному мастерству.
Ещё можно указать, что в соответствии с SoTA causal inference, данных статистики мало для принятия каких-то решений, нужна ещё будет контрфактуальная объяснительная теория, которая будет согласована с этой статистикой и поддержана данными эксперимента. То есть нужны не только «замеры» и «статистика», но и какая-то научная теория под этими замерами, а такой теории на планете сейчас нет. Мы же занимаемся инженерией, и мы не будем ждать, пока такую теорию предложат и она выдержит критику, чтобы победить все остальные теории. Средневековый инженер, как указывал Billy Koen, не отказывался строить мостик через речку, ссылаясь на то, что сопромат будет изобретён человечеством только через пару сотен лет, и поэтому он не будет заниматься инженерией этого моста, а подождёт до момента надёжной опоры на сопромат в своём строительстве. Образование — это инженерия, и опора тут точно так же, на всю доступную науку, но и смелое экспериментирование в тех случаях, когда теория пока отсутствует. Инженерия и научна, и ненаучна (подробнее это было в курсе «Системная инженерия»).
И ещё поскольку ожидаются какие-то «административные выводы из теории», то агенты, которые понимают, как эти «административные выводы» следуют из теории, намеренно могут изменить своё поведение, чтобы оно не соответствовало теории — если выгоды от учёта «административных выгод» будут больше, чем выгоды неизменения поведения (и тем самым следованию теории).
Пока же мы не будем делать вид, что сейчас по-быстрому удовлетворим запросы на «экзамены» или какие-то другие замеры мыслительного мастерства выпускников ШСМ, замеры их успеха в жизни. Не удовлетворим, на эти запросы не отвечаем намеренно, этот намеренный неответ на провокационные вопросы и есть SoTA в измерении человеческого интеллекта. Это не личное мнение автора курса о том, что проблема измерения интеллекта не решена, это современное состояние науки, это SoTA ещё и для исследований искусственного интеллекта20.
вот небольшой обзор Twenty Years Beyond the Turing Test: Moving Beyond the Human Judges Too, https://riunet.upv.es/bitstream/10251/172312/7/Hernandez-Orallo%20-%20Twenty%20Years%20Beyond%20the%20Turing%20Test%20Moving%20Beyond%20the%20Human%20Judges%20Too.pdf
https://ailev.livejournal.com/1489047.html, три алгоритма сдали этот ЕГЭ на четвёрку, https://www.sberbank.ru/ru/press_center/all/article?newsID=72fb39fd-161e-423c-a58f-4ce41e4757f4&blockID=1303®ionID=77&lang=ru&type=NEWS
В мордокниге пост /groups/Teach4teach/posts/3183457131779315/
вот тут много таких докладов на видео, https://www.youtube.com/channel/UCJ0Uq_WB7GLmY-NTz2oFoUQ/videos, но немало таких материалов и в текстах, https://systemsworld.club/
«Измерение интеллекта: занимаемся миром/средой/окружением/контекстами/domain, становимся демиургами», https://ailev.livejournal.com/1609242.html и «Машинный интеллект на начало февраля 2022: до сих пор непонятно, как оценивать прогресс», https://ailev.livejournal.com/1610230.html