Оперантное формирование
Текст, который показывает, что "с RL zero ещё не совсем разобрались", "SimpleRL-Zoo: Investigating and Taming Zero Reinforcement Learning for Open Base Models in the Wild", https://arxiv.org/abs/2503.18892. we observe that different base models exhibit distinct patterns during training. For instance, the increased response length does not always correlate with the emergence of certain cognitive behaviors such as verification (i.e., the "aha moment"). Notably, we observe the "aha moment" for the first time in small models not from the Qwen family. We share the key designs that enable successful zero RL training, along with our findings and practices. Вот бы мне научиться получать этот "ага-момент" у мокрых нейросеток. Но они все не маленькие, не опен-сорс, а также одной и той же архитектуры. Вообще, тема RL одна из центральных. Вот добавляют воображения к RL пост-обучению LLM, грубо говоря, добавляют побольше search -- и это срабатывает, https://arxiv.org/abs/2503.18929, "Trajectory Balance with Asynchrony: Decoupling Exploration and Learning for Fast, Scalable LLM Post-Training", двигают SoTA.
Продолжаем смотреть материалы, которые вроде бы про улучшение обучения AI, но помогают многое что понять и улучшить в обучении мокрых нейронных сеток (и, повторюсь -- обучение мокрых нейронных сеток тут как "учить других", так и "учить себя"):
-- "Predictive Data Selection: The Data That Predicts Is the Data That Teaches", https://arxiv.org/abs/2503.00808. Давно понятно, что ключом к обучению являются качественные данные, textbooks are is all you need (https://arxiv.org/abs/2306.11644) положил начало огромному числу исследований. "Лучше меньше, да лучше" -- на мусорных данных получается мусорное качество обучения. Но как понять, какие данные являются не мусорными? Дело ведь не в том, что данные должны быть безошибочными. В работе https://arxiv.org/abs/2404.09937 было сделано наблюдение: Viewing language models as compressors, we show that the "intelligence" of language models as reflected by benchmark scores is almost linearly correlates with their ability to compress external text corpora. Дальше взяли данные -- и выбрали по нормализованным потерям сжатия (compression efficiency). Получили 10x reduction in compute requirements при pretrain. Это означает, что при правильном учебнике и задачах можно ожидать x10 уменьшения времени обучения и для мокрых нейронных сеток, и есть какие-то намётки, в каком направлении выбирать эти тексты. Можно, например, в качестве начального приближения взять предложенный алгоритм preSelect и попробовать поработать с текстами учебников-задачников. Это, конечно, не отменяет обучения с учётом кривых забывания для мокрых нейросеток, но это можно делать на более качественных текстах, а качество оценивать не "по правилам" или "по эвристикам", "по интуиции", а "по замерам". Вот "замерять" качество наших курсов по preSelect для начала, взялся бы кто за такое.
-- "Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of Highly Effective STaRs", https://arxiv.org/abs/2503.01307. Какие-то особенности нейросеток делают их умнее -- какие? Есть four key cognitive behaviors -- verification, backtracking, subgoal setting, and backward chaining -- that both expert human problem solvers and successful language models employ. Статья определяет priming как "подготовка разума показом примеров" в ходе обучения. И находит, что если показывать в ходе обучения примеры методов сильного мышления (показывать примеры проверки правильности, возвратов к развилкам, постановки промежуточных целей и планирование обратным ходом), то дальше легко учить RL и получать reasoning. А если не показывать -- то увы. Статья показывает, что мало иметь правильные ответы в обучающих данных, то есть textbook is not is all you need: если нет демонстрации приёмов мышления, то мышление "не заводится". Это всё можно легко перенести на людей. В части проверки правильности показать людям разобранные примеры, где кто-то перепроверяет свои шаги или подтверждает промежуточные результаты. В части возврата к развилке дать примеры, где человек сталкивается с тупиком, осмысливает ошибку (это дико трудно! Обсуждали "А чо такова?", https://ailev.livejournal.com/1653635.html -- пришли ровно к таким же выводам, надо научить признавать ошибку ошибкой просто показывая много примеров такого признания, иначе не берётся) и пробует другую гипотезу. В части постановки промежуточных целей показывать примеры разделения сложной задачи на простые "шаги". В части обратного планирования показать решения, построенные от конечной цели к началу -- исходя из желаемого результата планирование шагов обратным ходом. Когда это показывать? Как всегда, тут выбор: или учить специально только этому (учить мышлению), или потихоньку перед каждой новой темой показывать, как можно думать -- и дальше вставлять в текст задания как чеклист мышления: "проверял правильность шагов, разбивал задачу на части, возвращался после обнаружения ошибки и ставил другую промежуточную цель, пробовал обратное планирование", в надежде на то, что когда-нибудь это генерализуется. Далее -- тренировка с преподом (RL/дрессировка/"оперантное формирование", рассматривали в https://ailev.livejournal.com/1753981.html с внутренней, внешней и общественной позиций, в https://ailev.livejournal.com/1753533.html отдельным пятым подразделом RL в curriculum learning и в https://ailev.livejournal.com/1752137.html как "Изготовление (evo), а затем три шага обучения (devo)"). А ещё для понимания всего написанного надо заметить, что психологическая priming theory (https://en.wikipedia.org/wiki/Priming_(psychology)) была фальсифицирована, Kahneman объявил исследования прайминга "effectively dead". В обучении LLM (и в статье) значение priming -- показ примеров мышления перед RL, а в психологии -- unconscious activation of cognitive representations that supposedly influence later behavior. Варианты переноса тех методов выхода на сильное мышление, что предложены в статье для LLM, на людей больше опираются на вменяемость: предложение способа мышления в явном виде, затем тренировка (deliberative practice), в том числе скаффолдинг (scaffold -- "временная конструкция", "строительные леса": от специально сочинённых лёгких примеров к трудным, нарастание сложности). И да, те же проблемы, что с LLM: не любая нейросеть к этому способна, трансформеры способны больше, чем какие-то другие варианты, генетически люди тоже бывают разные в плане способностей, но всё-таки они все более способны, чем кошки.
У меня во всех лентах обсуждается выход GPT-4.5, ибо и впрямь что-то странное: все характеристики очень похожи на характеристики предыдущего поколения, которое обучалось x10 меньше. Стало ли лучше? Маргинально: в каких-то задачах да, в каких-то -- нет. По сравнениям людей в большой статистике предпочтения ответа GPT-4.5 ответам других сеток очень незначительные, и даже галлюцинирует эта сетка меньше, но не меньше других моделей OpenAI. Сотрудники OpenAI туманно говорят, что "лучше в тех аспектах, которые трудно измерить", скажем, отсутствие галлюцинаций по фактическим знаниям о мире. От общего тона обсуждений остаётся впечатление, что "подняли гуманитарные способности, ответы чуть больше будут нравиться гуманитариям, а технарские способности ниже SoTA -- ожидаем, что там что-то будет в reasoning режиме". Но по тестам строгих рассуждений там ниже, чем DeepSeek V3, тоже "без ризонинга". Очень, очень странное событие -- выход этой модели с такими характеристиками. Сам я последнее время пользуюсь Gemini 2.0 Pro Experimental и Grok 3 -- а ответами ChatGPT я как-то чаще недоволен, чем доволен. Ну ладно, конкуренция -- великое дело, всё только начинается. Интересный вопрос про то, как добиться умности -- учить подольше исходную модель или дать побольше времени на рассуждения. Вот несколько свежих материалов об этом:
-- на русском из сиолошной: https://t.me/seeallochnaya/2379: "условная o3, построенная на GPT-4o, может генерировать цепочки рассуждений в 50 раз длиннее, что условно равно увеличению мощностей на тренировку в 40 раз (цифры из головы). А поскольку GPT-4.5 тренировалась всего лишь в 15-20 раз больше, то получается, что ризонер на модели прошлого поколения как бы лучше
— однако эти цифры перемножаются, и ризонер на основе новой модели <должен быть> существенно лучше. Если модель ошибается реже на каждом шаге, то все мощности будут уходить в правильное русло, а не на исправление ошибок"
-- https://arxiv.org/abs/2502.15631, We systematically analyze chain-of-thought length across o1-mini and o3-mini variants on the Omni-MATH benchmark, finding that o3-mini (m) achieves superior accuracy without requiring longer reasoning chains than o1-mini. Moreover, we show that accuracy generally declines as reasoning chains grow across all models and compute settings, even when controlling for difficulty of the questions. This accuracy drop is significantly smaller in more proficient models, suggesting that new generations of reasoning models use test-time compute more effectively. Finally, we highlight that while o3-mini (h) achieves a marginal accuracy gain over o3-mini (m), it does so by allocating substantially more reasoning tokens across all problems, even the ones that o3-mini (m) can already solve.
-- https://arxiv.org/abs/2411.18071, тут попытка быстрой проверки гипотез: просят LLM оценить верность гипотезы (оценивает, точность низка), затем просят просимулировать феномен и сгенерировать табличку этого моделирования ("побольше порассуждать" что там происходит). По табличке с данными берут корреляцию -- и она оказывается точнее, чем просто ответ на вопрос о корреляции! Это явно не CoT, но явно удлинение времени размышления.
-- https://arxiv.org/abs/2502.20339, попытка загнать reasoning в mamba с её высокой эффективностью и низкой точностью, а затем дать побольше времени на reasoning, чтобы перегнать трансформер по точности на том же вычислительном бюджете: can models with lower complexity leverage their superior generation throughput to outperform similarly sized Transformers for a fixed computational budget? To address this question and overcome the lack of strong subquadratic reasoners, we distill pure and hybrid Mamba models from pretrained Transformers. Trained on only 8 billion tokens, our distilled models show strong performance and scaling on mathematical reasoning datasets while being much faster at inference for large batches and long sequences. Despite the zero-shot performance hit due to distillation, both pure and hybrid Mamba models can scale their coverage and accuracy performance past their Transformer teacher models under fixed time budgets, opening a new direction for scaling inference compute.
-- https://arxiv.org/abs/2502.16965, попытка загнать CoT в autoregression image generation, которая обычно хуже генерирует, чем диффузионные модели. И впрямь, CoT поднимает качество: autoregressive Image Generation with Thoughtful Reasoning (IGTR), Compared to the autoregressive method without prompts, our method shows outstanding performance and achieves an approximate improvement of 20%. Но если заглянуть внутрь — таки диффузию не догнали (сравнимые, даже чуть-чуть хуже, характеристики при вдвое большем числе параметров), но в авторегрессионных моделях они ого-го. Это подтверждает мысль, что исходной модели надо быть умной, глупой модели добавка reasoning помогает очень существенно, но не так сильно, чтобы перегнать более умную модель. Усидчивостью перегнать талантливых в общем случае не удастся. Если кошечка будет долго-долго думать, хоть и всю жизнь, она стишок не сочинит.
-- https://www.inceptionlabs.ai/news. Вот тут наоборот — диффузия для генерации кода, вдесятеро быстрее, но менее точна, чем чемпионы — https://www.inceptionlabs.ai/news.
-- ... тысячи этих работ, про test time compute против компьюта обучения не думает только ленивый. Вот даже я думаю. У меня ведь те же проблемы: учить студентов дольше, или просто заставлять их дольше думать в своих проектах (но ведь мы тоже хотим экономить test time compute -- за счёт того, что один раз потратим время на обучение, а потом много раз сэкономим на размышлениях)? Я обычно сильно удивляюсь, когда узнаю, сколько времени люди делают качественные продукты. Кажется, что хорошо обученные гении должны делать всё быстро -- но нет, у них test time compute тоже будь здоров! Жизнь показывает, что и учатся как можно лучше/дольше, и потом времени на подумать берут тоже побольше. И дальше лидируют в рейтингах.
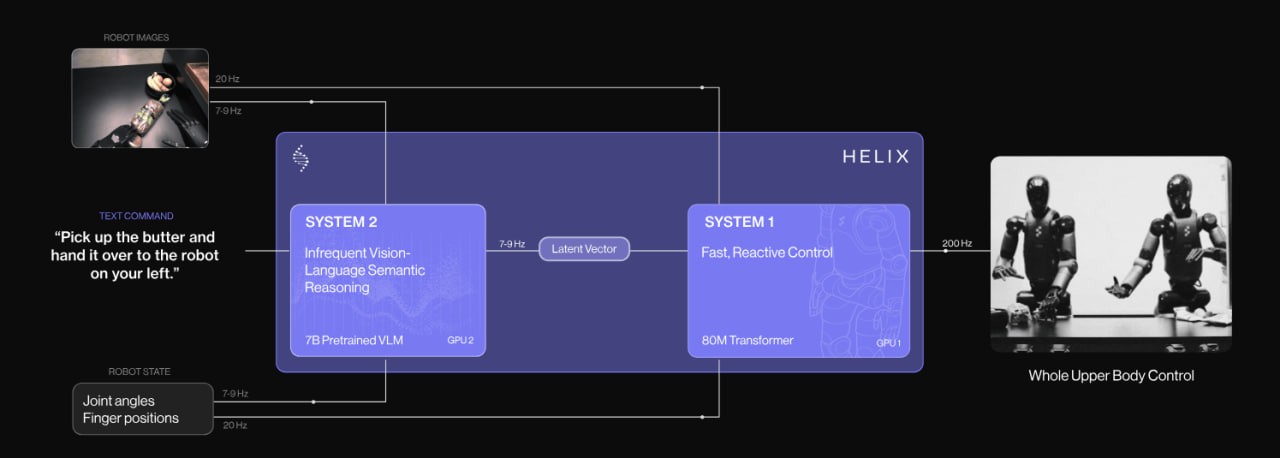
Я думаю, всё это закончится многослойными архитектурами, вот статья теории про эту скорость-точность в управлении, "Towards a Theory of Control Architecture: A quantitative framework for layered multi-rate control", https://arxiv.org/abs/2401.15185, а картинку из этой работы я приводил в конце предыдущего поста (https://ailev.livejournal.com/1755013.html) -- пешком передвигаться можно точно к месту назначения, но медленно, на самолёте -- очень неточно, но очень быстро, автобус -- не так быстро как на самолёте, но быстрее чем пешком, но не так неточно, как на самолёте, но не так точно, как пешком. А как надо? Вот так и надо: многослойное действие (пешком-автобус-самолёт-автобус-пешком). Вот тут эта многослойность управления и две нейронки уже есть: — медленный слой работает на 7-9Hz, быстрый — 20Hz, архитектура разная (7B VLM и 80М transformer), https://www.figure.ai/news/helix. Такое должно не только в роботах появляться, но и везде во взаимодействии AI-систем с окружением, хоть и не физическими. Диалог — как раз пример такого взаимодействия. Вот картинка: