5. Математика
Мета-моделирование aka онтологическая инженерия и место математики и физики
Из семантики мы уже понимаем, что нам нужно иметь какие-то идеальные/ментальные/математические объекты (понятия), знаки для этих понятий, а также объекты реального/физического мира, обозначаемые знаками/символами. И тогда их все можно связать друг с другом, чем и занимается семантика как «теория B» компьютерной науки. Это даёт возможность определить отдельные дисциплины для тех объектов, которые потом связываются семантикой:
-
Математика изучает поведение ментальных/идеальных/математических объектов
-
Физика изучает поведение объектов реального/физического мира
-
Семиотика изучает поведение знаков (нейросемиотика изучает знаки, чьё поведение определяется нейросетями)
Семантика устанавливает отношения между объектами, определяемыми этими разными дисциплинами. Эти дисциплины сами по себе не являются частями семантики. Хотя иногда семиотику в состав семантики включают, но отнюдь не всегда. Да ещё иногда и семантику считают не отдельной дисциплиной, а частью информатики/computer science, а саму информатику считают познанием/исследованием того, насколько физические объекты-вычислители могут своим поведением моделировать поведение математических объектов1 (это не такой тривиальный вопрос для создателей компьютеров, например, оптических2, квантовых3 или даже биологических на нейросетях4).
Математика как практика (роль практикующего математику — «математик») изучает поведение идеальных/ментальных объектов: какие они могут быть, как могут создаваться (construct, конструироваться), как преобразовываться друг в друга, какие у них могут быть свойства. Что не изучает математика, так это связь этих объектов с окружающим миром:
-
В физике математические объекты служат для описания поведения физических объектов, математика тем самым — язык естественных наук. Это основная цель математики: давать хорошо изученные ментальные/математические объекты (геометрические точки, поля, тензоры), поведение которых может быть использовано для формального/строгого/точного описания поведения объектов окружающего физического мира. Есть на эту тему замечательная статья про немыслимую эффективность математики в естественных науках5. Но математика используется готовой.
-
В информатике/вычислительной науке/computer science математические объекты служат предметом рассмотрения того, насколько точно и насколько полно физические объекты-вычислители могут моделировать их поведение. Математика опять же используется уже какая есть, как устоявшаяся уже дисциплина. Это обратная задача: в естественных науках (и, в частности, физике) мы подбираем математические объекты, чтобы выразить поведение физических объектов, а в информатике мы подбираем физические объекты, чтобы выразить поведение математических объектов.
Это взрослым людям кажется, что тут всё прозрачно и понятно. Но если взять ребёнка, которому нужно посчитать в компьютерной программе, на какой угол надо повернуть мотор робота, чтобы тот прошёл заданный путь, то быстро выяснится:
-
Ребёнок отлично понимает всё про физического робота и путь (это буквально бытовое знание, но и физика это изучает)
-
Ребёнок отлично понимает всё про математические формулы, по которым надо будет считать путь: что там с диаметром круга, пи, окружностью, углами
-
Ребёнок отлично программирует: пишет программы с циклами, формулами, вызовами подпрограмм.
-
Ребёнок абсолютно не понимает, каким образом описание поведения физического робота можно выразить математическими формулами, с которыми можно много чего интересного делать (по одной величине определять другую величину, и наоборот), а затем каким образом можно эти формулы писать в программе, чтобы получить нужное значение, и затем каким образом формулы-из-программы вдруг становятся поведением реального робота. Это знание даётся ребёнку в конечном итоге «исподволь», путём решения десятка похожих задач. Но если чуть-чуть пошевелить условия (перейти на язык программирования с другой парадигмой вычислений, робот будет другого типа, физика будет не механикой), то всё надо будет повторять. Интуиция какая-то будет, но она будет сбоить. А если традиционный компьютер заменить квантовым, то и у взрослого будут затруднения: что там в реальном физическом мире, какая там должна быть математика (иногда говорят даже «какая там физика», имея в виду математические формулы), как эту математику выражать в программе, чтобы добиться нужных изменений в реальном мире. Если идти в какую-нибудь вычислительную оптику, то с этими задачами только специалисты справятся — вопрос только в том, как они научились так думать, чтобы справляться?
Если забежать вперёд в онтологию, которая рассказывает об описании мира на разных уровнях абстракции (само описание мира — это задача физики и других естественных наук, а вот какие объекты брать в мире, чтобы их описывать и какие методы описания брать для этого — это задача «над физикой», как раньше говорили, «метафизика». Онтология — это извод метафизики, эпистемология (рациональное познание) — это способ, которым мы создаём онтологии, «как узнаём, какие объекты надо брать в физическом мире, чтобы их потом описывать объектами математического/ментального мира»). Это всё мы будем рассматривать дальше по интеллект-стеку, но там везде уже потребуется математика как универсальный пополняемый язык, на котором может вестись описание чего угодно (в том числе и описание описаний).
Математика — это мета-мета-мета-модель/теория/абстракция/онтология для science, естественных наук. Понятия/онтологии/описания самих естественных наук — это мета-мета-модели («из учебников фундаментальных наук»), прикладных/деятельностных/инженерных/трудовых предметных областей — мета-модели, описания объектов конкретных ситуаций (экземпляров) — модели. Материал про многоуровневое мета-моделирование (оно же — онтологическая инженерия, применение его — многоуровневое применение операции присвоения типа, задействование «машинки типов») описывается в онтологии, вместе с нюансами о том, что сама онтология — это про объекты окружающего мира или про описания объектов окружающего мира. Нюанс в том, что онтологией сейчас более чем часто называют онтологическое описание (определение по Gruber, Borst, and Studer: «ontology is a formal, explicit specification of a shared conceptualization», спецификация::описание), но и раньше, и сейчас онтологией называлась нарезка на объекты самого мира, а не описание этой нарезки. Но об этом подробней уже в курсе онтологии, а тут пока важно, что математика как раз должна дать типы объектов для строгого/formal явного/explicit specification/описания общей для разных агентов (служащей для целей обсуждения/коммуникации/коллективного мышления и действия) концептуализации/набора понятий. То есть математика должна дать описания интересных объектов идеального мира.
Что это за такие «интересные объекты»? Дело в том, что математика может выдумывать любые объекты, это же «ментальный мир», мир выдумки. Но большинство объектов будут неинтересными. Поэтому математики ищут «интересные» объекты, которые ведут себя как-то контринтуитивно. К сожалению, понятие «интересных объектов» не формализуется, оно даётся через обучение будущих математиков работой с нынешними математиками и этот поиск интересных объектов неожиданно оказывается сопряжён с путями организации математического труда (математического познания, математических исследований) учёными-математиками. Например, как описывает Роман Михайлов, математик должен продемонстрировать, что он понимает суть математики, решив одну из проблем, оставленных великими математиками прошлого. Это просто «сдача экзамена» на то, что математик может отличить «интересное» от «банального». Дальше такой математик получает не только право, но чуть ли не обязанность поставить какие-то проблемы перед следующими поколениями математиков — ибо он доказал решением предыдущих проблем своё право судить о том, что является интересным, а что нет, какие проблемы считать интересными для решения и достойными вложения труда, а какие нет. В том числе по Михайлову глубоко неправ Михаил Перельман, который одну из проблем прошлого решил, но свои проблемы не предложил. Дальше, конечно, сразу ставится задача определения «интересного» — но это же задача дисциплины познания/исследований в целом (там даже есть теория любопытства/curiosity), это даже не предмет математики как дисциплины, математики просто пользуются этим понятием, когда занимаются математическими исследованиями.
Так что с точки зрения употребления математики — она поставщик описаний важных объектов внимания (типов мета-мета-мета-модели/foundational ontology, а в прикладной части — мета-мета-модели/upper ontology) для рассуждения об объектах внимания естественных наук/sciences как типах мета-мета-модели и далее объектах каких-то прикладных инженерных практик как мета-моделях.
Так что у естественных наук уровень моделирования/онтологический уровень/уровень абстракции/уровень по отношениям классификации примерно тот же, что у моделей трансдисциплинарного методологического стека (мета-мета-модель/upper ontology с заходами на middle ontology), физика при этом просто входит в интеллект-стек, а другие науки входят как основания для инженерных/трудовых практик создания объектов какого-то масштаба и сложности — химия для вещества, биология для существа, и так далее. С одной стороны, это немного кривовато (много стройней было бы указание «метафизики» в интеллект-стеке фундаментальных трансдисциплин и разных вариантов «физик» в инженерных практиках, ибо квантовая физика микромира связана сегодня с малым масштабом, теория относительности с большим космическим масштабом, общей физики как-то ещё нет, только «принципы» — то есть метафизика), но интуитивно понятно, что всё-таки физика как базисная дисциплина на уровне принципов («законов о законах» — принципы симметрии, принципы сохранения и т.д.), а не законов для отдельных явлений, которые могут быть использованы в инженерии, должна быть в интеллект-стеке. А вот прикладная физика — это как раз отдельные «законы», она идёт в прикладные/инженерные практики, наряду с химией и приложениями механики для механической инженерии.
Вот ещё раз про то же самое и чуть-чуть примеров (по-прежнему забегая вперёд: мы не обсуждаем сейчас содержание математики, мы обсуждаем для чего эта математика потребуется, поэтому хотим, чтобы она была такой, какая сможет потом пригодиться. Даже число уровней и их именование — предмет обсуждения):
-
M3, мета-мета-мета-модель — foundational ontology, «основания математики» (чаще всего это логика, но отнюдь не все математики логицисты, о foundational ontology в математике договориться пока невозможно по совокупности причин), язык формального описания самой математики. На этом уровне определяются объекты и их группы, предикаты, субъекты, термы, а ещё и как это всё выражается (имена и прочее про «форму» из «формальности», как у Spencer-Brown с его Laws of Form6).
-
M2, мета-мета-модель — описание типов в методологической трансдисциплине, включая математику как типы для физики на уровне принципов (законов о законах). Система::объект, который включён в состав надсистемы::объекта и выполняет функцию::предикат. Дисциплины интеллект-стека главным образом определяются на этом уровне.
-
M1, мета-модель — описание типов объектов в прикладном (из практики инженерного стека, включая законы физики, химии и т.д., и там подтипы от кругозорной практики до прикладных практик уровня стандарта предприятия) domain. «Вот это стол — за ним едят, вот это стул — на нём сидят», при этом «Вот это стол::система — за ним едят::функция, вот это стул::система, за ним сидят::функция». Можно ввести два подуровня, метаУ-модель как именно «научная дисциплина/теория из Учебника» и метаС-модель как «Ситуационная модель/теория/онтология предметной области конкретного проекта», как это принято в конкретном проекте, возможно даже уникально на одном предприятии, объекты вводимые, например, только регламентом какой-то службы.
-
M0, модель — описание свойств экземпляров объектов физического мира. «Стол обеденный номер 5, стул кухонный номер 10», при этом «Стол обеденный номер пять»::стол, «стул кухонный номер 10»:: стул.
-
И не забываем, что есть ещё и физические объекты/экземпляры/индивиды, и как связана модель/M0 с этими объектами, будет обсуждать семантика, а как операции с этими объектами (взаимодействия физических объектов) отражаются операциями с описаниями (вычисления в физическом объекте-компьютере) — это будет предмет computer science.
Языком, на котором всё это будет обсуждаться, как раз и будет математический язык: основные объекты, которые предлагает математика (множества, категории, топосы и т.д.).
Дальше можно обсуждать, надо ли щепить M3 на отдельно «M4 — основания математики» и «M3 — математика» примерно так же, как щепим «физику на уровне принципов» и «прикладную физику как законы» по разным уровням. Но пока не будем этого делать: foundational ontology и upper ontology всё-таки относительно искусственное разделение (онтология тем и хороша, что «модель данных и данные — это просто разные уровни одной онтологии», в отличие от моделирования данных в классических базах данных, где данные отдельно, а модель данных отдельно, потому как живут в разных мирах моделирования). Мегамодель какой-нибудь ситуации включает в себя все эти мета-уровни.
Онтики, мегамодели, онтологии/графы знаний
Онтика в таком подходе — это когда мы просто игнорируем типизацию из очередного более высокого уровня абстракции, наличие каких-то явных мета-моделей. Если ты берёшь типизацию идеальными объектами из математики, то ты это делаешь теми ментальными объектами, поведение которых очень хорошо изучено. Например, онтика — это мы неформально вводим «скорость», но забываем приписать «скорость::вектор» (тут мы аннотировали физическую величину скорости типом вектора из математики, дающим её представление в мире идеальных объектов). Онтика как раз и есть «недоформализация»: объекты вводим, а типизацию математическими объектами с хорошо известным поведением — не вводим, «подразумеваем как-то понятной». И тогда оказывается, что утверждения о мире мы можем обсуждать, но не можем «посчитать». А если нельзя «посчитать», то нельзя продемонстрировать соответствие предсказаний о мире каким-то данным измерений, то есть нельзя провести эксперимент. Это будет нефальсифицируемая теория/модель, то есть плохая теория. Например, в интервью7 физика Виталия Ванчурина всё время повторяется эта идея: можно думать так, эдак, ещё как-то — но в одних случаях можно будет «посчитать» (то есть для выражения идеи используется математика), и это будет физика, а в других случаях математики в рассуждениях не будет, и тогда это «посчитать» нельзя, и тем самым нельзя опровергнуть, так что по этой линии отсутствия математики проникают разные фантазии.
Знание в таком подходе — это по возможности компактные и универсальные объяснительные теории/порождающие_мегамодели (generative models из active inference) aka «объяснения», которые могут быть использованы для действий в окружающем мире и которые выжили после многочисленных попыток опровержения. Компактность означает короткую запись, универсальность означает покрытие большого числа ситуаций. Четыре уравнения Максвелла описывают всё многообразие электромагнитных явлений, вот это оно и есть. Если бы не было этих уравнений (у которых довольно длинная история), пришлось бы описывать отдельно поведение электрического поля, отдельно поведение магнитного поля, отдельно зависимости от токов, отдельно от зарядов. И не факт, что можно было бы что-то точно вычислить, если при этом не использовать дифференциальное вычисление. А само это вычисление описывает ещё и механическое движение, и много ещё каких движений.
Основная идея математики — это предложение таких типов объектов и взаимоотношений между ними, которых будет немного, но их выразительная сила должна объяснить (в том числе предсказать) огромное количество явлений. Вот такой компактности/универсальности мы и добиваемся, для этого и работает математика, чтобы найти такие ментальные объекты, поведение которых максимально отражает поведение объектов физического мира. Это отражение по возможности должно быть такой точности, что станет в какой-то момент всё равно: использовать для нахождения ответа вычисление (изменение состояния памяти компьютера, а это состояние памяти отражает реалии физического мира) или непосредственное измерение чего-то в мире.
В какой-то мере в физике как раз и происходит что-то похожее. Так, классическое физическое поле8 (электрическое, магнитное и т.д.) не является ни в коей мере физическим объектом. Это математический объект, который оказался очень удобным для описания разных физических явлений. Физическое поле — это величина, для которой есть значение в каждой точке пространства-времени. Но в этом и проблема, что после перехода к состояниям и определения пространства состояний оказывается, что пространство в физике — это уже не пространство-время (физический объект), а вполне математический объект, построенный на основе особо удачных описаний физического объекта. Андрей Хренников пишет9, что к концу 19 века усилиями математиков была создана классическая модель физического пространства — декартова произведения трех вещественных прямых R3. Но ещё до квантовой физики, довольно быстро перешли к работе с гильбертовым пространством10, ибо приходилось описывать траектории и в традиционно понимаемом «физическом пространстве», но ещё и в фазовом пространстве11, и в конфигурационном пространстве12, которые уже не «физические», а вполне математические пространства, определяемые как математические объекты, наделённые «физическим смыслом», но не «физическим существованием». Потом появилась статистическая физика (броуновское движение тут как пример — траектория не непрерывно дифференцируемая, ибо между краткими участками прямого пути идут резкие изменения направления движения, плюс этих частиц очень много для точного указания состояния каждой частицы в любой момент времени), затем квантовая физика (фотоны и их поведение), где представления о частицах физического пространства или даже волнах (поначалу это были «волны эфира») физического пространства уже окончательно перестали отражать классические физические представления. Физика в последнее время стала теорией измерений, единица минимального измерения как раз бит — «что-то изменилось против ничего не изменилось». Физика по факту стала изучать не физические объекты и их взаимодействия, а описание реальности, как мы можем получить его результатами измерений. Тем самым математический аппарат постепенно подбирался таким, чтобы при его помощи сделать формальную явную концептуализацию непрерывно меняющихся представлений физиков об устройстве физической реальности. Результаты измерений физиков описывались как соответствующие соотношениям между математическими/ментальными объектами. Эти соотношения описывались языком математических формул, для которых обсуждались математические же операции по их преобразованию. Математические объекты были не только «математическая точка» или «натуральное число», но и более сложные: поля, пространства, многообразия и т.д., Про это и пишет Андрей Хренников, что к концу 19 века вся «геометрия» была переописана алгебраически, так что физика превратилась в абстрактное описание абстрактными/ментальными/математическими объектами каких-то тоже вполне абстрактных сущностей, которые мы могли бы наблюдать в физическом мире, делая какие-то замеры. Онтология физики — это математические выражения для физических теорий. В принципе, это верно для микромира, верно для макромира, верно для самых разных масштабов времени, поэтому верно и для описаний живых существ, сообществ, искусственных интеллектов и социальных отношений, а также эволюции в целом (ибо это всё описание физического мира, ничего мистического/трансцедентного).
Если у нас есть подобная онтология как «набор формул как находящихся в определённых отношениях математических объектов», и логические выводы/рассуждения по правилам (это обсуждается в логике) по такой онтологии хорошо предсказывают физический мир (это обсуждается в дисциплине познания/исследований), то это и есть результат работы физика, результат практики физических исследований. Физика оказывается онтологической инженерией для реального/физического мира, а онтологическим языком для неё будет язык математики. А ещё математика будет онтологическим языком и для самой математики. Это и есть роль математики, её место в интеллект-стеке.
Я использую термин «онтология» близко к тому, как это делается в практике ontology engineering с опорой на дисциплину computational ontology — с поправкой, что там ontology называют ontology description. «Истинная онтология из философии» про то, какие объекты в мире, а онтологическое описание — это описание того, какие объекты в мире, информация об объектах, а не сами объекты. Можно смело считать, что в computational ontology имеют в виду ровно ту самую онтологию, что и в традиционной философской метафизике, только добавляют необходимость строгого, то есть локального, а не коннективистского/распределённого описания, желательно ещё и доведённого до такого вида, в котором можно «посчитать» для фальсифицирования этого описания (помним, как Виталий Ванчурин в своём интервью13 настаивает, что разница между философами и физиками — философы предлагают разные идеи, и это повод поговорить, эти идеи нельзя проверить, а вот идеи физиков обычно можно проверить, для этого в них есть формулы — и дальше можно «посчитать»).
Формализация как присвоение типов на стеке уровней абстракции
Прирост человеческого знания в ходе эволюции случился по линии осознанной формализации: работы с алгоритмами рассуждений, ведущими к строгим результатам. Строгие — это которые не размываются в ходе длинных цепочек рассуждений. Если результаты носят не строгий/цифровой, а статистический характер, то в длинных цепочках рассуждений ошибка будет накапливаться. Но вот последовательности из строгих рассуждений ты можешь пройти десять тысяч раз по десять тысяч шагов рассуждений каждый проход, и если данные у тебя на входе были одни и те же, то ты получишь десять тысяч раз одинаковый результат. И знание тем самым сможет надёжно накапливаться, не размываться при передачах и хранении.
В онтологической инженерии/(мета)моделировании данных говорят о том, что создаётся «классическое онтологическое описание»/«семантическая сеть»/«semantic network»/«knowledge graph»14, выраженные в языке логики, для изложения которой был в конечном итоге выбран язык математической логики, то есть язык математики. Строгость обеспечивается математической записью: записывают хорошо изученные объекты и их отношения: множества как классы, экземпляры как элементы множеств, операторы как логические операции. А используется это всё как онтология/мегамодель, то есть набор типов объектов внимания и отношений между ними (в том числе описываемых формулами, которые сами сложные объекты, но в любом случае — используется математический язык составления описаний каких-то физических и ментальных объектов и отношений между ними, или операций создания этих объектов в случае конструктивных описаний, и для этих описаний используется набор математических/ментальных объектов, поведение которых хорошо изучено — тех же множеств, различных видов бесконечностей и т.д.).
Есть несколько подходов к построению knowledge graph/онтологии, они все основываются на многоуровневой типологизации/объективации (объективация: каким образом мы выделяем объекты из фона) M0-M4 примерно по той линии, по которой мы тут это и обсуждаем, хотя и с какими-то вариантами:
-
ad hoc/интуитивно, онтики. В произвольных проектах, где потребовалась хоть какая-то формализация: берём объекты внимания as is, делая вид, что это «просто объекты, никаких у них типов нет» (так не бывает, тем не менее). На выходе — онтика, просто перечисление самих объектов и отношений между ними, как это представляется человеку интуитивно, то есть как воспринимается его нейронной сеткой, работающей «без логики», «как у животных» — быстрое мышление S1 по Канеману. Нейронная сетка умеет и разговаривать, безо всякой логики, просто продуцирует какие-то наиболее вероятные высказывания: «Вот это стол — на нём едят, а это стул — на нём сидят».
-
как формализуют базы данных в промышленности, модели данных/data models в проектировании баз данных, справочные данные/reference data в проектировании информационных систем предприятий: берут строгую математическую теорию как foundational ontology, чаще всего это логика первого порядка в каком-то её изводе (их ведь тоже много разных). Эту онтологию (набор математических объектов с хорошо изученными свойствами) используют дальше как язык, на котором описывают объекты и отношения upper ontology — какие-то наиболее общие типы объектов, скажем «сущность»/entity, у которой подтипы «абстрактные объекты», «физические объекты», и так примерно 200 понятий из распространённых философских теорий (например, в онтологии ISO 15926-2 всего 201 такое понятие как upper ontology15). А дальше всем объектам онтики из предыдущего пункта (ad hoc/интуитивного описания предметной области/domain) присваиваем эти типы в надежде, что результат будет непротиворечив и более понятен. Мы уже многое знаем про мир, когда выделяем объекты, и вот это присваивание типа, который мы уже знаем — это трассировка/прокидывание этого «общего знания» ко всё более конкретным фрагментам знания. Общее знание — это математика, поведение математических объектов. Присвоение типов какой-то middle онтологии (онтологии широких предметных областей — химии, биологии, юриспруденции и т.д.) как раз уточняет знание об этих предметных областях: даёт возможность строить общие рассуждения. Если известно, что сепулька описывается как математическое множество, то к ней будут применимы одни операции, а если это кортеж, то другие, чем бы эта «сепулька» потом не оказалась. Это основной подход, который используется в инженерии при федерировании данных16. И тут возможны варианты: с микротеориями (для учёта противоречивости как в CYC17 — внутри микротеорий противоречий нет, а между ними могут быть, например, высказывания «Граф Дракула — вампир», «Вампиров не существует» не могут быть логически совместимыми без аппарата микротеорий) по части строения онтологии или без, на базе логики первого порядка или всё-таки порядок логики в некоторых случаях можно пробовать увеличить без потери реальной возможности что-то вывести на ограниченных ресурсах, или даже с потерей (математическая вычислимость оказывается не самым важным фактором в онтологиях), да и сами объекты upper ontology можно очень по-разному выбирать. В любом случае, вся эта формализация «графов знаний» базируется на математическом основании.
-
классический подход естественных наук (science), исчисление/calculus. Foundational ontology берётся из «оснований математики» (унивалентные основания математики, логицизм, конструктивизм как раз про это), а upper ontology — это математические объекты, которые затем используются в исчислениях18. В самом начале исчисления («как посчитать») трактовались как теории изменений так же, как геометрия была теориями о формах, а алгебра теорией об арифметических операциях. Но затем исчислением начали называть всё подряд, что изучалось методами математики — пропозиционное исчисление/логика утверждений19, вариационное исчисление, лямбда-исчисление и т.д. По сути исчисление — это более-менее обособленная микротеория на материале математики. Множество, многообразие, поле, интеграл, оператор, уравнение — это типы объектов из оснований математики как уровня, близкого к foundational ontology/мета-мета-мета-модели, upper ontology/мета-мета-модели (помним, что выделение этих уровней абстракции/обобщения более-менее произвольно, в разных школах мысли они могут выделяться по-разному, и эти выделения могут ещё и изменяться во времени, улучшения в понимании мира идут довольно быстро, это раньше надо было ждать сотню лет, чтобы в математике что-то сильно поменялось, сейчас ждать вообще не приходится). После того, как мы построили исчисление, для конкретной предметной области производится моделирование на основе исчисления. Скажем, классическая механика моделируется интегральным и дифференциальным исчислением, компьютерные программы в функциональном подходе — лямбда-исчислением, и т.д. Объектам и отношениям в предметном мире будут соответствовать какие-то математические объекты исчисления, а отношения между ними будут выводиться по математическим формулам, поведение объектов в мире при удачно подобранных формулах будет примерно соответствовать поведению математических объектов в ментальном/математическом/идеальном мире.
-
Современный подход естественных наук (новый «треугольник»): дробное исчисление/fractional calculus20, группа перенормировки/renormalization group и машинное обучение/machine learning. Все эти дисциплины связаны в какой-то мере с системным мышлением, предполагающим уровни рассмотрения проблемы. Дробное исчисление — это обобщение классического интегрирования и дифференцирования на произвольные (например, реальные или даже комплексные) порядки/степени интегрирования и дифференцирования. При этом порядки/степени понимаются как итерационное применение какого-то линейного оператора дифференцирования к функции. Это исчисление близко связано с работами по фрактальным описаниям. Математические описания с изменениями масштаба как в статистической классической/предквантовой физике и квантовой физике идут на базе субъективной/байесовской и некоммутативной/квантовой теории вероятностей, а также ренормализационной группы/группы перенормировки/renormalization group.21. А ещё машинное обучение, которое прежде всего включает в себя обучение представлениям/representation learning22 и глубокое обучение/deep learning23 — классы познающих/обучающихся алгоритмов, которые используются при создании программ искусственного интеллекта. В целом речь идёт о чём-то, напоминающем системный подход в физике: используется теория вероятностей, чтобы с какой-то уверенностью отмоделировать события на каком-то масштабе деления физического мира на части, а все невязки затем отмоделировать переходом к моделированию на уровень ниже, и так дальше по уровням (ибо всегда будет какая-то невязка моделирования, но она будет меньше и меньше по мере увеличения числа уровней моделирования). Собственно, речь идёт о математических многоуровневых моделях, как-то отражающих многоуровневость физического мира.
Мы тут не трогаем вопрос о том, что в онтологиях/графах знаний/мегамоделях есть по факту и модели абстрактных/математических объектов, и модели физических объектов — и сразу захватывается букет вопросов о том, как они связаны (мы уже упоминали, что связаны они через информатику/computer science, с этими онтологиями/мегамоделями работает какой-то физически реализованный агент-вычислитель).
В любом случае: для описания объектов и отношений в физическом мире, равно как объектов и отношений в ментальном мире (математических объектов) используются объекты математического мира. Математические описания онтологичны, а «строгость» (работа в правой части спектра формальности мышления) всего-навсего указывает на хорошо изученное поведение математических объектов, используемых для моделирования. Адекватность описаний этими объектами других объектов нужно ещё как-то доказывать, способы доказательств — в информатике (которую понимаем как семантику, логику, алгоритмику в их тесной взаимосвязи).
При выборе уровня формальности обязательно учитываем трудоёмкость формализации и последующих формальных вычислений (она, конечно, зависит от доступности вычислителя — если у вас есть знакомый живой математик, который готов потратить время на формальные выкладки, или даже математик-AI, то трудоёмкость их вычислений для вас будет ничтожна, но ресурс их всё одно придётся оценить и за него заплатить). Это важно на многих уровнях формальности:
-
формальное идеально строгое рассуждение: точный алгоритм, который даст ответ, если плюнуть на ресурсные ограничения (типа «теорема, что нейронная сеть с учётом неограниченной ширины и ограниченной глубиной является универсальным аппроксиматором»24). Это очень важный математический результат, только по большому счёту, он для не-математиков неинтересен и бесполезен: количество вычислений для аппроксимации с какой-то даже не очень большой точностью даже очень простых функций настолько велико, что никакой компьютер на Земле за хоть как-то адекватное время с этим не справится. А если нужно именно строить рассуждение, а не просто давать численную оценку какой-то простой функции (скажем, речь идёт об экспертной системе с парой сотен логических правил, причём каждое из них дано в нечёткой логике/fuzzy logic25), то формальное идеальное решение «как будет в принципе, строго и однозначно» перестаёт иметь смысл: формулу-то можно иметь, теорему можно доказать, но когда нужно получить конкретное рассуждение для конкретной ситуации с конкретными входными данными, ничего не получится: не хватит вычислительных ресурсов всей Вселенной и тысяч лет вычислений.
-
формальное реальное рассуждение: точный алгоритм/формула, которая даст точный ответ (скажем, программа с доказанной правильностью, то есть которая гарантированно не зайдёт в какую-то точку, где она вдруг остановится) в приемлемое время при данной физике вычислений и данном вычислительном ресурсе. Тут проблема в no free lunch theorem26: для каждого класса задач нужно будет искать способ/алгоритм рассуждения для той или иной физики рассуждения/вычисления (предварительно доказав, что операции в этой физике вычисления и впрямь соответствуют операциям с ментальными/математическими объектами), иначе не уложиться в ограничение. Но зато ответу можно доверять, он точный/строгий/формальный и при повторении рассуждения будет тем же самым. По большому счёту, ровно вот это называется «точными науками» (математика, физика, химия). По Канеману это соответствует медленному мышлению «по правилам», S2 (но надо учитывать, что для разной физической природы компьютеров время вычисления будет разным, плюс результаты будут сильно зависеть от алгоритма, то есть «правил рассуждения»).
-
неформальное рассуждение: неточный алгоритм, который даст максимально точный ответ за заранее заданное время. Или хотя бы постановку задачи для формального решения! Не зря ведь говорят, что «постановка задачи — это половина дела». Формальное же реальное решение потом можно будет получить, обратившись к специализированному вычислителю правильной природы. По факту этот подход эквивалентен тому, как изучают математику с помощью программы Mathematica: программа сможет вывести и подсчитать что угодно, но вы должны сообразить, что нужно сказать программе, чтобы получить корректный результат. Этот подход в машинном обучении сейчас известен как Toolformer27 или TaskMatrix28. По большому счёту этот подход не обсуждается в математике, ибо это предмет алгоритмики. Математическую интуицию (а если речь идёт о расчётах по физике или инженерии, то физическую и инженерную интуицию) вполне можно получить по этому пути, необязательно много возиться с формулами, эту обезьянью работу «вывода по правилам» сделает компьютер. А вот выбрать из тысяч и тысяч потенциально важных объектов внимания объекты внимания правильных типов, чтобы решить задачу в Mathematica или GPT-4 — вот это да, это важно! А дальше — вопрос алгоритмики, какой алгоритм выбрать, чтобы получить ответ заданной точности за отведённое на работу алгоритма время и отведённые ресурсы (например, ресурсы вычислителя смартфона или вычислителя уровня большого датацентра с парой суперкомпьютеров).
Итак, тяжёлую работу формального/строгого/точного рассуждения/вывода/inference будут делать компьютеры, а от людей потребуется только знание математической, физической и так далее (дисциплин интеллект-стека, а затем инженерной, менеджерской, предпринимательской) онтологии с типами, соответствующими объектам внимания. Для наших целей усиления интеллекта достаточно соответствующей предметной интуиции для приблизительных/интуитивных рассуждений с этими объектами внимания, чтобы высказывать догадки. А проверять эти догадки сможет и компьютер, никаких тут вопросов.
Математики так и делают: они доказывают свои теоремы неформально, а достижения теории доказательств только-только начинают (редко!) использовать, причём всё больше и больше в этом полагаются на компьютерные средства29. В философской энциклопедии так и пишут30: proof theory has so far not become a practical tool for the working mathematician; the applications in mathematics have been rather isolated cases. Recent work on formalizing mathematical proofs with computerized systems, called proof editors, may gradually change this picture. Чуть дальше мы покажем, что с этой проблемой пытаются сработать в рамках работ по унивалентным основаниям математики, где можно пробовать оставить и неформальный стиль доказательств, а в случае особой нужды использовать формальное компьютерное доказательство. Но чтобы это стало надёжно работать, требуется заменить основания математики!
Дальше (как всегда, когда начинаем использовать компьютеры) можно вспомнить, что математическая нотация из терминов, представленных одной буквой и операций, представленных одним знаком, плюс хитрая пространственная (не текстовая, не строчная) вёрстка с дробями и индексами — она нужна как стенография, быстрый и компактный ввод/вывод как раз для долгого формульного вывода. По-другому никак, если работать с карандашом и бумагой. И все привыкли. Как к нотам на пяти линейках с наложенной на них ритмикой и более чем странными «альтерациями», тоже не самое рациональное антикварное нотационное решение. Дальше имеем музыкальные редакторы и математические редакторы, где ввод перьевой с распознаванием картинок или прямо игрой на клавиатуре, а для математики будет разметка в хитромудром редакторе LaTeX. Но современным математикам надо работать с системами типа Wolfram Alpha и Wolfram Mathematica, и там, конечно, никакой особой вёрстки на вводе — используется запись текстом на компьютерном языке. За этим, конечно, будущее.
Вот скандальность и удобство может быть в том, что для разговора о математике использовать вообще тексты вместо привычных формул — возможно, тексты с аннотированием типов, чтобы было проще разбираться с материалом. Привычные формулы оставим прикладному курсу «раздела математики», если приходится его изучать. В курсе математического мышления, который должен быть в интеллект-стеке берём фундаментальное содержание, базовые понятия и их отношения. Считать ничего не будем (это нужно только в прикладных курсах), будем только рассуждать. И необязательно рассуждать точно/строго/формально, но зато рассуждать важно с правильно выбранными для этих рассуждений объектами. Не случайно выбранными, а правильными, соответствующими мета-мета-модели мира, «модели из учебника трансдисциплины» (а в случае оснований математики может быть ещё и мета-мета-мета-модель: язык, на котором рассказывается о языке математики, ещё один или даже пара уровней в многоуровневом построении объектов внимания. «Построение» — это отсылка к конструктивной математике, «определить объект — это задать процедуру/программу его построения из более мелких объектов»).
Как строят естественные науки: присваивают их понятиям типы математических объектов/понятий
Познание/исследования начинаются с того, что предлагаются новые типы объектов внимания, для которых делаются утверждения об аксиомах/принципах, которым они подчиняются (скажем, предлагается понятие евклидового пространства и высказывается догадка о том, что параллельные прямые в нём не пересекаются, или предлагается понятие энергии и высказывается догадка о принципе сохранения энергии). И да, в зачёт потом идут только теории, с которыми можно делать измерения (например, компьютерные/мысленные эксперименты для объектов идеального мира, реальные замеры для физического мира) и контрафактические рассуждения. Далее:
-
если объясняется меньшее число ситуаций, чем уже наличествующей теорией, то догадка откидывается (ну, или продолжает оставаться, если существенно проще в вычислениях, а точности или широты не нужно — типа ньютоновской механики, которую никак не выкинут на помойку истории)
-
критика логическая (включая непротиворечивость рассуждений с использованием типов мета-модели, включая непротиворечивость рассуждений с использованием и смежных теорий, подтягивающихся в рассуждениях по длинной цепочке определяющих друг друга понятий и формульных зависимостей). Если рассуждения противоречивы, объяснение считается опровергнутым. Конечно, при этом может обсуждаться используемая логика, ибо что противоречиво в одной логике, вполне может оказаться ОК в другой логике.
-
критика экспериментом, проверяется порождение более точных результатов, чем у теорий-конкурентов. Если менее точные результаты, объяснение считается опровергнутым.
В естественных науках чаще всего предлагают/«догадывают»/«кладут» объекты и отношения (предлагают некоторые аксиомы, принципы с использованием этих объектов и отношений) в рамках функциональных/поведенческих объяснительных теорий, называемых динамики/dynamic: кладём/guess какое-то описание поведения (что-то там течёт, взаимодействует, передаётся — функциональная схема с функциональными объектами, портами и потоками) как аксиомы, описываем математику этого поведения через исчисление, чаще всего это делается сейчас в форме дифференциальных уравнений для потоков, но возможны и варианты.
Потом выполняем концептуальную работу: или обратную инженерию/reverse engineering, то есть указываем, какие физические объекты/конструктивы/модули реализуют/implement эту заданную уравнениями функциональную схему, или прямую инженерию — предлагая физическую реализацию какими-то подходящими физическими объектами в реальном мире.
Это всё начиналось с механических моделей, но потом слово «механический» в моделировании стало означать просто «неучастие божественных сил», то есть возможность описания ровно той математикой, которая была разработана для решения задач механики, а потом и квантовой механики.
Пример тут — интегрированная информационная теория/integrated information theory (IIT)31, которая предлагает какую-то математическую модель сознания на базе предлагаемых для рассуждения объектов внимания (framework/ontology, как раз не в форме knowledge graph, а в форме набора аксиом и некоторой математической модели).
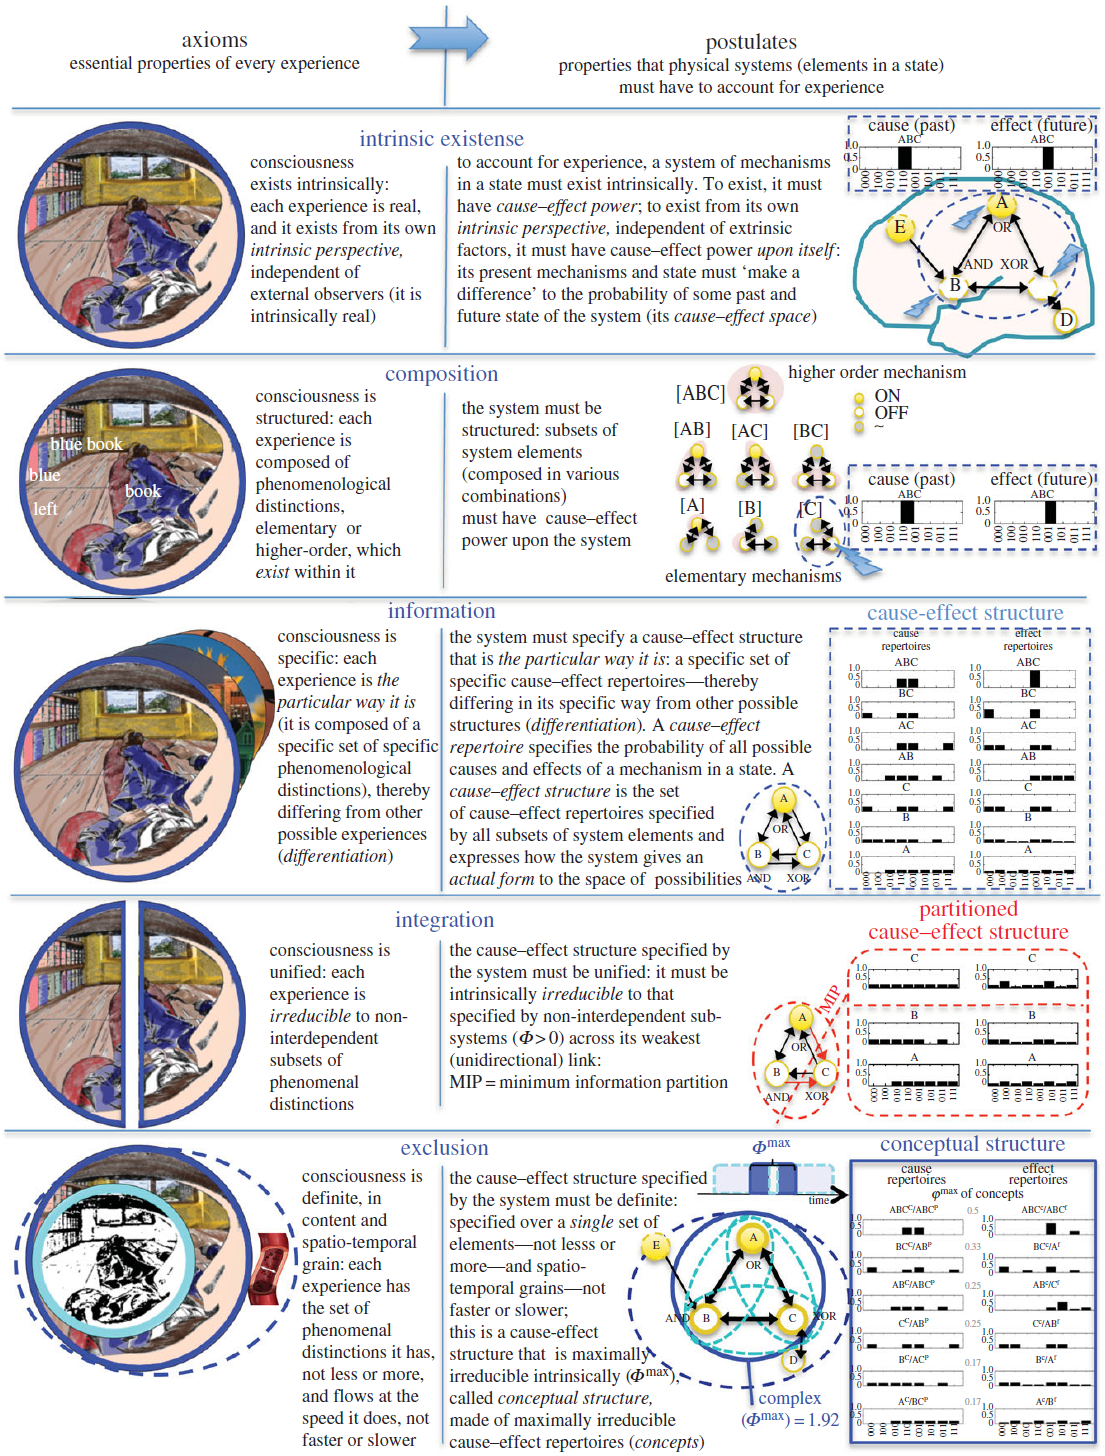
Далее разные варианты физических объектов/конструктивов/модулей для этих функциональных/поведенческих объектов внимания обсуждаются как реализующие или не реализующие её: «Начните с самого сознания, определив его основные свойства, а затем спросите, какие физические механизмы могут их объяснить». Именно такого подхода придерживается интегральная теория информации (ИТИ) - развивающаяся формальная и количественная структура, которая обеспечивает принципиальное объяснение того, что нужно для возникновения сознания, предлагает простое объяснение эмпирических данных, делает проверяемые предсказания и позволяет делать выводы и экстраполяции32.
Эта теория интересна тем, что сознание рассматривается как общефизический феномен, связанный с восприятием — и снимает многочисленные парадоксы, которые занимали философов, занимающихся сознанием. И подобных «механических» подходов к сознанию множество.
Дальше эти радикально новые догадки (frameworks/ontology), или предложения по изменению уже существующих догадок, начинают критиковаться умозрительно и экспериментально. Опора на математическую онтологию (присвоение «естественнонаучным понятиям» математических типов) для фреймворка позволяет подтвердить хоть какую-то строгость рассуждений: можно опереться в рассуждениях на свойства математических объектов и задействовать рассуждения по формулам. Если мы говорим, что «скорость — это вектор», то для понятия «скорость» можно использовать всё, что мы знаем о векторах, эти математические объекты хорошо изучены! А после логической/умозрительной критики затем можно «замерить и посчитать», то есть сравнить с данными эксперимента.
Компактификация/универсализация формальных описаний: нахождение аналогий в формулах
После критики эти догадки ещё и будут смешиваться с другими «догадками». Для этого находятся какие-то аналогии. Некоторые понятия и отношения между ними из разных теорий оказываются близкими, их отождествляют, а дальше работают с более компактной общей теорией. Есть множество подходов к тому, как находить аналогии и что такое вообще «рассуждение по аналогии», что такое вообще «аналогия». Самым популярным автором в этой области был Дуглас Хофштадтер, написавший «Гёдель, Эшер, Бах: эта бесконечная гирлянда» (1979)33. В математике поиск аналогий крайне популярен: теория категорий многими заявляется как хороший инструмент для отождествления находок в разных областях математики, а поскольку эти математические объекты представляют ещё и физические объекты, то можно говорить и об отождествлении находок в разных областях физики. Вот классическая работа на эту тему, с выразительным названием «Physics, Topology, Logic and Computation: A Rosetta Stone», 200934. В физике диаграммы Фейнмана используются для рассуждений о квантовых процессах. В 1980-х годах стало ясно, что в основе этих диаграмм лежит мощная аналогия между квантовой физикой и топологией: а именно, линейный оператор ведёт себя очень похоже на «кобордизм»35. Подобные диаграммы можно использовать для рассуждений о логике, где они представляют доказательства, и вычислениях, где они представляют программы. С ростом интереса к квантовой криптографии и квантовым вычислениям стало ясно, что существует обширная сеть аналогий между физикой, топологией, логикой и вычислениями. В работе «Розеттский камень» Joan Baez и Mike Stay уточняют некоторые из этих аналогий, используя понятие «замкнутой симметричной моноидальной категории»36. После описания взаимодействия систем как процессов в сетях/networks (электрические, гидравлические сети, а также сети взаимодействий в системной динамике, обычно связываемые с функциональными представлениями системы, то есть представлениями времени функционирования) Joan Baez делает предложение об использовании формализма теории симметричных моноидальных категорий для описания не просто процессов, но открытых систем, подразумевающих взаимодействие с окружающей средой37. Опять мы видим ход на использование теории категорий как foundational ontology для онтологии системы, и основной ход — это переход от выражения онтологии в статичных отношениях к морфизмам, изменениям. Этот ход соответствует ходу на конструктивизм в математике, когда от "вечных классов"/eternal classes и их отношений мы переходим к операциям построения/construction38.
Коннективистскую/распределённую/интуитивную линию рассуждений (реализуемую сегодня нейросетями) представляет работа с переводами: «аналогия между двумя текстами об одном и том же на разных языках». Берём множество объектов и отношений из огромного набора (корпуса) текстов какого-то языка о нашем мире и сопоставляем его с теми же объектами и отношениями корпуса текстов о нашем же мире на другом языке. Языковые модели в форме предобученных на корпусе текстов нейронных сетей ровно это и делают: берут два облака точек «описания мира» на двух языках (на самом деле — на сотне языков, далее в картинках, далее в действиях людей и роботов, далее в аудио, и т.д.) в многомерном пространстве смыслов и как-то совмещают их друг с другом так, чтобы по возможности направления в этом пространстве соответствовали отношениям — и максимально совмещают их «точка в точку», при этом точки в пространстве смыслов представляют собой понятия, а вот направления векторов характеризуют отношения между понятиями.
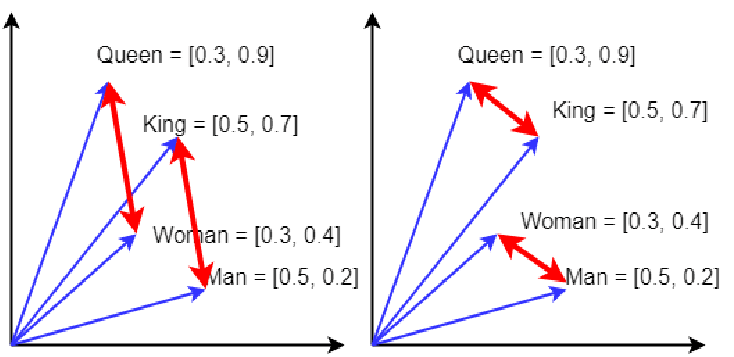
Это грубая модель, но современные нейросетевые модели переводят тексты, включая перевод на язык, на котором нет параллельных текстов39, в том числе работая не только нейролингвистически (текстами), но и мультимодально (картинки и т.д.): используется тот факт, что описываем-то в корпусах текстов, картинках, объектах для «ощупывания» в действиях робота один и тот же мир40. Проблема в том, что точность такого перевода заведомо оценить нельзя, а если переводить несколько раз, то будет эффект «испорченного телефона» (каждый раз вроде как вносится небольшая ошибка, но через три-четыре перевода результат вообще оказывается непохож на оригинал).
Эти проблемы легко преодолеваются, если опираться не на быстрое интуитивное «нейросетевое» аналоговое мышление S1, но на медленное и трудозатратное логическое мышление S2, которое весьма эффективно реализуется классическими электронными компьютерами, и которое реализуется эмуляцией «логического вычислителя» на нейросетевых вычислителях, в том числе человеческом мозге. В развитии цивилизации должна присутствовать строгость и краткость описания мира, это и даёт математика. Человечество опирается в своём познании и изменении мира в том числе на символистскую, а не только на коннективистскую онтологическую работу/метамоделирование. Символическая/семиотическая работа идёт на высоком уровне формальности/строгости/изученности поведения объектов, то есть задействует математику.
Наука достигла сегодняшнего состояния как раз за счёт использования математики как мета-мета-мета-модели/foundation model для онтологии своих поднаук, то есть наука опиралась на структурное сходство рассуждений по формулам для разных объектов внимания. Это и есть основной путь науки. При этом в математике есть ещё и предпочтения: примат булевой логики и полной формальности над байесовскими вероятностными вычислениями с их неопределённостью и квантовыми вычислениями с их ещё большими неопределённостями. Одна беда: чем более формальны описания (длиннее цепочка присвоения типов, то есть прописаны все типы по линии M0-M3 и иногда и M4, да ещё и для точности введены промежуточные уровни), тем больше нужно умственных усилий и тренинга для удержания этой цепочки. Поэтому большинство населения работает с онтиками, используя интуитивное нестрогое присвоение типов и неформальные (квантовоподобные, даже не байесовские, как это выясняется в современных исследованиях по теории принятия решений) правила рассуждений над типами M3 и M4, а хорошо обученное меньшинство населения (учёные) ухитряются работать со всей цепочкой, выдерживая строгую/булеву логику рассуждений с формальными типами на высоких уровнях абстракции — в том числе снимая неминуемые противоречия, возникающие на этих уровнях абстракции при попытке объединять рассуждения по разным онтикам.
Противоречия неминуемо проскакивают в этот мир строгой формализации, если используются разные онтики. Формализация имеет образовательный ценз, физмат-моделирование (моделирование явлений физического мира средствами математики) доступно не всем, ему нужно учить специально так же, как любой другой работе с типами: учить как набору лучших имеющихся типов как типов объектов внимания в какой-то предметной области, так и операциям присвоения типов и проверки, насколько удачны были догадки об этих типах (критика логическая и экспериментальная). И ещё есть ресурсный ценз на альтернативную формализацию отдельных онтик каждый раз, когда будет найдено очередное противоречие, возникающее при попытке общего описания. Даже у учёных с их компьютерами может просто не хватать ресурсов для ведения строгих рассуждений, требующих упоминания объектов из разных предметных областей.
Ситуация ещё сложнее в силу запутанности конечных классификаций/присвоений типа в классификационной иерархии как отношения репрезентации между физическим миром и абстрактным/математическим миром и наличием функциональных (в каком-то смысле "идеальных", обобщённых, типизирующих, ролевых) объектов, в которых выполняется моделирование физического мира. Объекты из учебника физики проще считать функциональными (рассматриваемыми в run-time) с их репрезентацией абстрактными/математическими объектами с хорошо изученным в математике поведением, а вот продукты/модули/конструктивные объекты какого-то прикладного domain — это уже физические объекты (а не объекты из учебника физики, те как раз функциональные!). То есть помидоры на весах мы моделируем как помидоры::продукт/физический объект, реализованный/realized/implemented by физическое тело::функциональный_объект, описываемый весом::переменная::скаляр::абстрактный/математический объект. Иначе не разобраться, см., например рассуждения по поводу понимания концепта Markov blanket у разных авторов у Ian Glendinning41.
Этот подход «совмещения формальных описаний» на базе сходства отношений между объектами этих описаний обычен и в мире «промышленных» онтологий, где вместо математической upper ontology с формулами, как у физиков, используется только foundational ontology из логики. John Sowa в софте компании VivоMind реализовал подход VAE (VivoMind Analogy Engine), когда просто ищутся два фрагмента графа знаний с одинаковой структурой объектов и отношений, такое даже компьютеру можно поручить (и в работах VivoMind показывается, что такой подход вполне практичен, есть успешные приложения AI, полученные во времена, когда ещё не было нейросетей)42. И таких работ множество, хотя тот же John Sowa после многих лет мучений с таким подходом пишет, что подобные методы поиска аналогий в правой/строгой части спектра формальности мышления очень вычислительно трудоёмки и вскрывают проблему: никакие промышленные upper ontologies не помогают в поисках аналогий, для разных задач удобные для них мета-мета-мета-модели кардинально различаются и общих рассуждений по ним принципиально не построишь.
Аналогичный результат будет и для вероятностных описаний: общее байесовское рассуждение для разных статистических теорий не проведёшь, приходится переходить к квантовоподобным, то есть переносу математики, разработанной для квантовой механики, на другие предметные области. Это требует перехода от колмогоровской теории вероятностей для вычислений по Байесу, которые в какой-то степени соответствуют строгой булевой алгебре, ко множеству несовместимых вероятностных алгебр, что отмечает в своих работах Андрей Хренников43. Отказ от «булевости» и «байесовоскости» важен также для более ресурсно-адекватного моделирования мира и отмечается также и другими авторами (квантовоподобные представления линейны и дискретны, это резко уменьшает объем вычислений, кроме того «байес» откидывает вероятности априорных событий, о которых мы не знаем, а квантовоподобный расчёт как-то их учитывает)44.
В функциональных объяснительных теориях ищут одинаковую структуру математических формул, которыми они выражены (при этом смотрят на то, чтобы речь шла не об одной формуле, а о каком-то массиве формул, чтобы подобие было более-менее развёрнутым/очевидным, а не эпизодическим случайным совпадением) — и делают выводы, что природа хорошо описываемых одинаковыми формулами явлений похожа, это всё проявления каких-то общих закономерностей. Каждый такой случай закрепляет использование общего для многих случаев математического аппарата. Ровно таким образом распространились классические «исчисления», а в последнее время распространяется «новый треугольник», просто предлагаемые ими математические объекты оказались очень универсальными в плане возможностей описания физического мира.
Пример: физмат-моделирование сознания и эволюции
Если «глазами по формулам» работать с теорией информации, разбираясь с «похожестью» формул, как это делал Shannon, то по аналогии с термодинамикой можно ввести и энтропию (информационную!), и свободную энергию (информационную!). E.T.Jaynes в «Теории вероятности как логике науки»45 просил не путать термодинамику и информатику, но далее оказалось вполне продуктивным таки их путать. Например: появляются тексты, где строится вполне строгая теория квантовых безмасштабных описаний физического выражения информационных явлений: Chris Fields со товарищи в 2020 году пишет работу «Information flow in context-dependent hierarchical Bayesian inference»46: «Последние теории, развивающие широкие представления о контексте и его влиянии на умозаключения, становятся все более важными в таких разных областях, как когнитивная психология, информатика и квантовая теория информации и вычислений. Здесь мы представляем новый и общий подход к характеристике контекстуальности, используя методы пространств Чу и теории каналов, рассматриваемых как общие теории информационных потоков. Это предполагает введение в формализм трех существенных компонентов: событий, условий и систем измерения».
Пространства Чу47 — это обобщение топологического пространства и там хорошо строить отображения разнородных объектов друг в друга. Например «типы-как-процессы»/types-as-processes, обновляющие понимание данных-как-программ/data-as-programs. В тексте «Types as Processes, via Chu spaces»48, 1997, говорится: «Типы-как-процессы вводятся как соответствие Карри-Ховарда "пропозиции-как-типы"/propositions-as-types, в котором пропозиции заменены процессами. Поскольку типы и процессы являются частью рабочего инструментария программиста, даже в большей степени, чем пропозиции, соответствие типы-как-процессы является более центральным для практики программирования, чем пропозиции-как-типы. Более того, эта связь очень хорошо работает математически, по крайней мере, до определённого момента».
И дальше по этой линии обобщения самой разной математики при помощи теории категорий с пространствами Чу на «естественную математику», Rational Mechanics and Natural Mathematics49, 2005: «Пространства Чу нашли применение в информатике, математике и физике. Они обладают полезной категориальной двойственностью, аналогичной теории решёток и проективной геометрии. Как естественная математика пространства Чу заимствуют идеи из естественных наук, в частности, из физики, а как рациональная механика - из гамильтоновой механики в терминах взаимодействия тела и разума».
Развитие этой линии рассуждений приводит к тексту «Minimal physicalism as a scale-free substrate for cognition and consciousness»50, 2021, от Chris Fields, James F. Glazebrook and Michael Levin, с опорой на уже упоминавшуюся ITT51 как физикалистскую теорию сознания, а далее «A free energy principle for generic quantum systems»52, 2021, от Chris Fields, Karl Friston, James F. Glazebrook, Michael Levin, — продолжение темы мышления и сознания с безмасштабным квантовоподобным описанием, но с добавкой идей active inference. И в этом направлении математизации теории сознания (математизация — это получение достаточной строгости/формальности описаний, чтобы можно было «измерить и посчитать», то есть переход от философии к физике посредством добавки математики в её онтологической функции) были даже работы53, где теории сознания проверяются на колониях муравьёв, и там прямо адресуется проблема «биологического индивида» и понятие сознания для сообществ. Хотя в этой работе ещё нет ничего квантового и безмасштабного, это только 2019 год, но это уже с опорой на IIT.
Эти же Chu spaces используются и дальше с прицелом на математику для онтологии, как foundational ontology (в отличие от логик первого порядка, которые традиционны в современной computational ontology для использования в качестве foundational ontology). Например, работа «Distributed Conceptual Structures»54, 2018: «Теория распределенных концептуальных структур, изложенная в данной работе, занимается распределением и формированием знаний. Она опирается на две родственные теории, информационного потока55 и формального анализа понятий56, которые она стремится объединить. Информационный поток (ИП) связан с распространением знаний. Основы информационного потока явно базируются на математической теории, известной как конструкция Чу57 в *-автономных категориях, а неявно - на математике замкнутых категорий. Формальный анализ понятий (FCA, formal concept analysis) занимается формированием и анализом знаний. В данной работе мы связываем эти два исследования, распространяя основную теорему формального анализа понятий на распределённую область информационных потоков. Основными результатами являются категориальная эквивалентность между классификациями и решётками понятий на уровне функций и категориальная эквивалентность между связями и полными примыканиями на уровне отношений. Этим мы надеемся достичь сближения между информационным потоком и формальным анализом понятий».
Другой ход по линии теорий сознания — это уже упомянутую ITT с её панпсихизмом физикалистского толка («сознание — это свойство физического мира во всём диапазоне от неживого до живого, включая организмы и даже сообщества организмов») смешивают с также ориентированной на математику и «посчитать» теорией сознания global workspace58 и получают integrated world modeling theory/IWMT59. В этой IWMT нет пространств Чу и теории категорий, но мы видим всё тот же набор идей по использованию математики как онтологии в области сложных феноменов, включая даже модные VAE GAN60 (порождающие нейронные сети на базе вариационных автоэнкодеров — помним, что нейронные сети тоже являются мощнейшей унификационной парадигмой в силу их доказанной универсальности как аппроксиматоров любых функций).
И таких работ «математизации» или «физикализма» (это две стороны одной медали) для ранее считавшихся «философскими» областей знания о сознании становится всё больше и больше. Мы видим, что прямо на глазах философское бла-бла-бла (которое не кончается ничем, экспериментами не проверишь, не «посчитаешь») в теориях сознания потихоньку переходит в естественную науку, онтология которой берётся из математики — из тех её областей, которые обладают наибольшим унификационным потенциалом.
Идеи информационной вселенной, где вещество во вселенной ведёт обработку информации как в тупой форме «камня», так и в форме простых и сложных жизненных форм и даже социальных форм той же жизни (человечество тут как пример) — это очень модная идея. Например, так считает квантовый физик Виталий Ванчурин в его ключевой работе на эту тему с выводом о вселенной как работающей непрерывно обучающейся/познающей нейросети61. Основная идея современной физики — это то, что под уровнем квантовой механики, описывающей поведение квантового мира частиц, из которых сделаны атомы, хорошо математически выражаемым постулатами квантовой теории поля62 лежит ещё один уровень математических структур, который потом можно будет использовать для объектов всё более и более крупного размера — но вот вести себя даже для уровня квантовых частиц эти ментальные структуры будут так, что их поведение выглядеть будет похоже на поведение квантовых полей. Есть множество вариантов таких «более мелких» структур, которые начинают вести себя как квантовые поля, но на самом деле не являются квантовыми полями: теория струн63 тут самая известная, Stephen Wolfram предлагает различные графы64, David Deutsch предлагает ссоздателей/constructors65, Виталий Ванчурин предлагает нейроны66 — это одна из основных мыслей его работ. Он говорит, что математика глубокого обучения/deep learning67 вполне подходит для описания динамики68 (описания изменений физического мира), и эволюция вселенной (в которую входит и эволюция жизни, и техно-эволюция) — это просто познание/обучение/learning этой многоуровневой нейронной сети. То есть мир состоит из нейронов, которые как-то взаимодействуют друг с другом, и это надо рассматривать на многих уровнях (deep learning, многослойные нейронные сети — это как раз отсылка к уровням). И если идти по этому пути «в основе всего лежат нейроны и обучение нейронных сетей», то у Ванчурина даже есть идеи, как обобщить математику (а, если математика — это онтология, то и физику) до минимальной, в которой остаётся свойство обучения — а затем предложить физические устройства, реализующие эту математику непосредственно. Ванчурин основал компанию69, которая даже будет пытаться выпускать такие устройства. И вот там-то будут работать «нецифровые компьютеры», ибо привычные «цифровые компьютеры» на цифровых логических цепях очень неэффективны для глубокого обучения. Показательна строчка копирайта с сайта компании Виталия Ванчурина: «Copyright © 2023 Artificial Neural Computing Corp.- All Rights Reserved by the Universe. Temporarily powered by digital computers».
Везде в этих проектах проводится одно и то же рассуждение: берём какие-то математические/ментальные объекты — и объявляем их поведение похожим на поведение базовых физических объектов, из которых устроена реальность. Дальше могут быть два варианта:
-
философы и математики пишут статьи, и на этом дело заканчивается — никакой физики, экспериментов, «измерить и посчитать».
-
физики придумывают эксперименты, в которых можно вычислить наблюдаемые свойства реальности на базе вот этой математики — и тем самым проверить, верна ли догадка.
Скажем, есть такие математические объекты как поля, частицы, струны, нейроны. Дальше можно учесть, что поля очень удобны для описаний происходящего в мире, если считать, что в физическом мире есть такие физические «поля», которые ведут себя в чём-то похоже на то, как ведут себя математические «поля». Но такое поведение наблюдается не везде и не всегда (особенно при смене масштабов — размеров, времени, энергий), проблемы в описании мира остаются. Тогда можно взять более мелкие объекты (струны или нейроны, или ещё какие) — и сказать, что на каком-то масштабе эти струны или нейроны ведут себя вполне как поля. Но это надо показать математически (формулы!) и проверить в эксперименте (измерения!), «посчитать» (смоделировать реальность — и проверить, совпадает ли результат моделирования с экспериментом лучше, чем у альтернативных теорий).
Если считать, что эти идеи обучения будут безмасштабными, то можно ставить эксперименты, например Ванчурин выдвигает идею «биологического коллайдера»: берём две биологические системы в равновесии, «познавшие мир» и сталкиваем их друг с другом в борьбе за выживание — и дальше смотрим, можем ли мы это описать нашими формулами. Та же идея, что с элементарными частицами и ускорителями: столкнуть и тем самым поломать, чтобы поглядеть, как оно там устроено.
Можно проверять математику и другими методами, например, математика подхода active inference говорит, что любая достаточно сложная система (например, нейроны мозга мыши или человека, которые были выращены на пластине) будет уменьшать неопределённость в окружении. В эксперименте DishBrain70 проверили ровно это: вырастили нейроны на электронной подложке и погрузили их в мир игры Pong. И за пять минут нейросеть научилась играть в Pong, безо всякого знания о «наградах»: наградой было то, что на входы системы не подавали шум, не увеличивали неопределённость, а вот в случае промаха ракеткой по мячику на вход подавали некоторое количество шума, увеличивали неопределённость окружающей среды — и через пять минут нейроны научились управлять окружающей средой так, чтобы снизить неопределённость, то есть перестали промахиваться виртуальной ракеткой по виртуальному мячику!
Тип этого эксперимента DishBrain ровно такой же, как открытие «на кончике пера» планеты Нептун71, а также создание атомной бомбы на основе выводов теории относительности («принятие всерьёз», то есть принятие как основание для действий в физическом мире математических выкладок, описано в книгах David Deutsch) или создание квантовых компьютеров на основе математических описаний того же David Deutsch. И вот уже появляется работа по созданию биологических компьютеров72, выход этой математики в физический мир по линии organoid intelligence (organoid73 — это выращенная «в пробирке» биологическая ткань какого-то органа, например, культура нейронов млекопитающих) и тоже создание компании74, которая на основе этих математических (вернее, физико-математических) идей собирается строить органоидные компьютеры.
Тут нужно удерживать во внимании это постоянное различение: как сделали бы философы (написали статью про нарезку мира на какие-то объекты — и что дальше? дальше ничего!), как сделали бы математики («вот забавные свойства вот таких ментальных объектов» — и что дальше? Что с этим делать?) и как делают физики (взять математику, проверить экспериментом, выдать физический эффект для инженеров, которые ищут очередной аффорданс).
Ванчурин подчёркивает, что в идее «нейрон как основа физической теории» лежит не квантовая механика, не классическая механика, а «другая математика, математика обучения». Смена онтологии (идей о том, из каких объектов составлен окружающий мир) сводится к смене математики, а дальше двустороннее движение — надо от этой математики прийти к описанию в терминах полей как «смене масштаба», потому что эти описания хорошо работают, но и наоборот — эксперименты с полями должны как-то валидировать математику познания/обучения/learning на основе нейронов. И там получается много интересного на этом пути «другой математики в той же физике»: скорость света познаётся/выучивается/learn, антропный принцип75 (константы удобны для жизни в целом и для существования людей в частности) становится другим — «удобные константы познаются/выучиваются, то есть природа к этой физике как набору постоянных/физических констант, удобных для существования разных устойчивых объектов, в том числе и людей, эволюционирует». И даже пространство-время становится не базовым, а эмерджентным/emergent (появляющимся на более высоких системных уровнях) понятием и соответствующим этому понятию объектом.
В работе «Ontological revision and quantum mechanics»76, 2022, говорится о том, что или вы берёте какие-то феномены и начинаете искать математику для выражения этих феноменов, или наоборот — если есть удобная математика, то нужно попросту переопределить онтологию физических объектов, используя эту математику. Скажем, не «частицы» или «волны», а какие-то другие описания материи. В этой работе говорится, что понятие «состояние» понимается как склонность объекта вызывать события у наблюдателей. Дальше работа предлагает онтологически объединить пространства положения и импульса в единое целое, связанное через преобразование Фурье — это же привычно для физики, точно так же ввели пространство-время, и такой ход Эйнштейна не вызвал какого-то особого отторжения у физиков. На основе этой пересмотренной онтологии квантовая механика выводится естественным путем, не опираясь на какие-либо искусственные предположения, такие как «квантовое условие» (по поводу которых до сих пор идут онтологические споры77), или математические аппараты, такие как гильбертово пространство78 и самосопряженные операторы79. Как следствие, такие острые вопросы, как «проблема измерения»80, либо разрешаются, либо просто исчезают.
Cамая интересная часть работы «Ontological revision and quantum mechanics» — это попытки рассуждать про онтологию и теорию познания (рациональность и исследования, то есть эпистемологию) в физике, и как находить в одних и тех же математических (если с размерностью — то физических) формулах самое разное понимание. Нет впечатления, что эта работа будет каким-то мейнстримом: на любую новую фундаментальную идею в математике и физике нужно много-много «вязания на спицах»: показывать феномен за феноменом, что каждый из этих феноменов переописывается проще, чем с использованием текущей физики (набор объектов физического мира с их свойствами) и математики (какие математические объекты были выбраны для моделирования физических объектов), или выглядят точнее в новой математике и физике. Без этого никакого широкого распространения теория не получит, но ресурсов на такую обширную работу ни у кого нет.
Тот же David Deutsch не слишком продвигается с constructor theory, ибо недостаточное число людей готовы овладеть новым набором базовых понятий, у Ванчурина и его команды амбиции по нейронной теории вселенной большие — но он и сам признаёт, что вот эта часть проверок и демонстрации того, что описание мира становится проще и объясняет мир точнее, ещё впереди, и непонятно, кто даст на это ресурсы.
При таком подходе можно брать за основу описания мира самые разные ментальные объекты. Например, если смотреть на работы Hwe Ik Zhang (автора статьи про ontological revision и quantum mechanics), то можно найти там и работы по математике и физике, стоящими за классическим восточным подходом Инь-Ян И-Цзин81, это очень популярная тема на Востоке: если можно класть какую-то онтологию в основании бытия и подтверждать её потом математикой-физикой, типа тех же «струн» или «нейронов», то что б не взять сразу привычный И-Цзин и понятия противоположностей Инь-Ян?! По этой линии предлагается82 современная переформулировка И-Цзин для биологии. Все эти попытки упираются в то, что какая-то такая «догадка об интересных (то есть с самым разным нетривиальным поведением) ментальных объектах и математике, стоящей за ними (то есть строго описанное, хорошо понятное поведение)» должна привести к смене онтологии/ontology revision — и надо вот просто взять, и всё остальное переписать с опорой на эту догадку, каждый раз показывая, что при переписке не теряется связь с экспериментом, что точность предсказаний мира не ухудшается. Но ресурсов на такое ни у кого нет. Почему у Ньютона и Лейбница получилось, почему у Шрёдингера получилось, почему у Эйнштейна получилось — не очень понятно, это очень интересный вопрос.
Даже если убрать связь математики и физики, в самой математике тоже радикальные идеи часто не имеют шансов. Например, классический случай Синити Мочизуки83, который попытался радикально преодолеть один из барьеров сложности в математике, но не преуспел84 — слишком мало математиков поняли его идеи. Профессиональному математику понять какую-то новую теорию в математике — это затратить на 1500-2500 страниц 250-500 часов труда, по 5-6 страниц абсолютно нового сложного (с незнакомыми формулами и идеями!) материала в час. Для физиков это будет примерно то же самое, но всё может оказаться сложнее, ибо в физике ещё есть место эксперименту, и с экспериментами тоже надо разобраться, просто «прочесть» не получится. Это означает, что кто-то из авторов теории пишет начальных 1500-2500 страниц изложения картины мира на базе каких-то новых радикальных понятий, а дальше любому новому человеку надо потратить 250-500 часов труда, чтобы продолжить развивать теорию, переписывать на этот новый язык все новые и новые описания, которые и так уже описаны старой теорией. Барьер оказывается ресурсный! Более того, в ходе такого переписывания не факт, что всё окажется лучше: возможно, будут найдены какие-то непреодолимые затруднения, и всё окажется зря, победит в конечном итоге другая идея. А ещё для первых последователей не будет кому проверить их выкладки (в том числе проверить выкладки самого первого автора). Поэтому есть огромные надежды на применение искусственного интеллекта, который сможет работать с такими радикальными идеями: во-первых, порождать такие идеи (типа объединения пространства и времени в пространство-время или объединить положение и импульс в один объект, или представить весь мир как нейроны или струны), а затем пробовать «переписать всю физику, уж сколько можно» на этот новый математический аппарат, подразумевающий выражение новых физических объектов. Но даже для искусственных интеллектов это может быть крайне трудно по ресурсам: представьте себе, что речь идёт о перетолковывании миллионов научных статей!
Но такие радикальные ходы в науке могут быть очень продуктивны, поэтому есть вероятность, что люди будут вкладываться, если демонстрировать универсальность предлагаемого подхода. Так, Ванчурин и его соавторы демонстрируют стандартный ход «аналогии теорий, определяемых на базе структуры математических формул» на смешивании рассуждений для математически выраженных фреймворков термодинамики, теории эволюции и теории нейронных сетей в работе «Thermodynamics of evolution and the origin of life»85, см. там, например, [7.6] и [7.7] про отношения между физическими и биологическими величинами. Это общий ход в рассуждениях такого сорта: «если математика одна и та же, то это проявление общего физического принципа, паттерн поведения вселенной». Так, free energy в информационной теории Шеннона сначала имела смысл не «физической энергии», а совсем другой смысл, просто «в формулах на этом месте в физике стоит обычно энергия, поэтому мы сохранили название в информатике». Но затем жизнь поменялась, и понятие «энергия» в физике стало обозначать ровно вот это — «какой-то физический объект, который ведёт себя так, как ведёт величина из формул, где участвует ментальный/математический объект «энергия»».
Заканчивается вся эта линия рассуждений Ванчунина и соавторов про нейроны и математику обучения как основы физики теорией многоуровневой эволюции как оптимизационного вычисления-познания по типу нейронной сети, «Towards a Theory of Evolution as Multilevel Learning»86, 2021.
Склейка математики, онтологии, физики и computer science
Есть работы, которые склеивают математику, естественные (физику, химию, биологию и т.п.) науки, компьютеры, онтологию (в том числе 4D экстенсиональную), онтологию собственно математики (основания математики, foundational ontology), а также дают намётки на то, как это всё совместно развивать, а также разъясняют, почему нельзя этого делать с текущей математической классикой, унаследованной из работ 20 века. Например, работа Андрея Родина87 «Venus Homotopically»88 (2016), а также его разбор естественнонаучной программы Владимира Воеводского «Voevodsky's Unachieved Project» (2020)89.
В этих работах объясняется, что логика первого порядка, которая традиционно используется как foundational ontology для выражения объектов и отношений в онтологической работе, оказывается не самым фундаментальным способом выражать математические объекты, особенно если помнить про то, что в какой-то момент эти математические объекты будут использованы для утверждений о физическом мире. Вместо идеи о множествах как коллекциях каких-то других объектов и построения логики на этих «алгебраических» основаниях более фундаментальной оказывается идея геометрическая: минимальным объектом объявляется точка, затем точка рассматривается в пространстве и становятся возможными утверждения (пропозиции), и только потом на базе этих пропозиций мы формулируем утверждения теории множеств.
В качестве примера тут берётся Венера, которая в некоторых странах называется Утренней звездой, а в некоторых странах называется Вечерней звездой. Отождествление объектов, обозначаемых терминами Венера и Утренняя звезда, а также Венера и Вечерняя звезда решается семантикой (в статьях отсылка идёт к «лингвистике», это вопрос языка, знаковой системы — каким знаком обозначаем объект). А вот для отождествления Утренней звезды и Вечерней звезды нужна более сложная операция, включающая какие-то доказательства, понимаемые как вычисления/математические выкладки/выполнение компьютерной программы. У нас есть «какой-то объект», который скрывается за горизонтом, а потом вдруг выплывает из-за горизонта, или наблюдается в другом месте планеты — и как узнать, это новый объект, или тот же самый объект? Даже Солнце, которое каждый день восходит почти в одном и том же месте — это одно и то же физическое Солнце, или каждый раз новое?
Тем самым управление вниманием к физическим объектам может быть описано в терминах указания на место в пространстве, занимаемое точками объекта, а также пути, который составляют эти точки, а доказательство того, что мы наблюдаем тот же самый объект, который просто прошёл некоторый путь в многомерном пространстве (возможно, более чем трёхмерном, или даже четырёхмерном пространстве-времени) ведётся в этих геометрических, или как об этом говорят математики, гомотопических терминах. Основная аксиома, которая позволяет обсуждать такую эквивалентность как «типы» (тигр и мышь в каком-то смысле эквивалентны/одинаковы/равноценны, ибо принадлежат к одному типу, Утренняя и Вечерняя звезда — эквивалентны/одинаковы, и дальше можно говорить об отнесении этой эквивалентности к эквивалентным термам/лексическим единицам разговора об объектах) — это унивалентная аксиома90, предложенная Владимиром Воеводским в 2006-2007 годах. На этой аксиоме и ряде других выстраиваются унивалентные основания математики91 примерно так же, как на базе аксиом были выстроены основания геометрии Евклида, его труд так и назывался «Начала/основания/elements/foundations геометрии»92.
Статья М.Атья более чем двадцатилетней давности (2000 год) про перспективы развития математики «Математика в двадцатом веке»93 говорит о теме многомасштабности (переход от локальных «бесконечно малых» к крупмномасштабным описаниям) и ведущей в этой теме роли топологии, а ещё про повышение размерности до бесконечных, переходе от коммутативного к некоммутативному умножению (квантовая физика вся на этом), переход от линейного к нелинейному (и там тоже примеры из физики), и главная тема дихотомии в математике: геометрия с поддержкой физики как описания законов природы против алгебры с целью создания «алгебраической машины». Вот Арнольд поддерживает геометрическую традицию, а Бурбаки — алгебру.
Атья пишет как раз про особенности мышления, которые поддерживают эти две «большие традиции»: геометрия (размерность) связана с пространством, а алгебра (последовательность операций) связана со временем. Чтобы описывать что-то связанное с пространством и временем, нужно использовать и геометрическое описание, и алгебраическое. И вот это уже очень близко к тому, что я хотел бы обсуждать в части общематематического (для всех, а не для профессиональных математиков!) образования. Для меня это та же линия обсуждения разницы 3D и 4D в онтологических описаниях94: описания мира в 3D были статичными-геометричными, а добавка их изменчивости как «последовательности состояний» вроде должна была давать «алгебраичность», компьютерную последовательность операций, но пока 4D онтологии (выражаемые, впрочем, как и 3D онтологии обычно в насквозь алгебраичной FOL как knowledge graph95) не очень распространены. В любом случае эти ходы от «пространств с возможными состояниями» к «последовательностям состояний» можно описывать как ходы на синтез «геометрии» и «алгебры».
Та же весьма и весьма условная линия может быть в различении членораздельного (алгебраического, «западного») и голографического (геометрического, «восточного») в социологии в работе Вячеслава Широнина (2016 год) и даже в глубоком обучении (представление многомерных пространств в нейросетях как «геометрическое» и символьное текстовое представление как «алгебраическое»)96. Та же линия в работах Владимира Мартынова по линии различения «письменной музыки» как «геометрической» и «аудиального джаза» с приматом развёртки во времени как «алгеброической» для джазовой импровизационной безнотной традиции97 (хотя что-то подсказывает, что тут это противопоставление геометрии и алгебры как работы с пространством и временем может сломаться — ибо тексты-нотации обычно оказываются как раз алгебраическими, а не геометрическими по природе своей), но всё одно интересно подумать и в этом направлении — мы же ищем универсальные различения, помогающие думать. Сюда же я бы добавил «The geometry of musical rhythm. What makes a good rhythm good» by Godfried T. Toussaint (2020)98, и обзор 2017 года по связи ритма и движения99.
В том числе Атья говорит об алгебраике как об искушении Фауста: отказаться от геометрической интуиции и надеяться на «алгебраическую машинку» — это продать душу дьяволу. И (это ещё 20 лет назад!) признание того, что наибольший вклад в собственно математику внесла квантовая теория поля, идущая от физиков100. И вот прогноз на 21 век (можно поглядеть, как он выполняется, уже ведь 22% прошло от 21 века): «XXI век может стать эпохой квантовой математики или, если угодно, бесконечномерной математики». При этом суть математики по Атья в том, что «найдены вполне строгие доказательства всех тех замечательных фактов, о которых размышляли физики».
Подход к унификации математики на чисто алгебраических принципах (основания математики от Бурбаки101 по опоре всей математики на теорию множеств Цермело как самую базовую математическую идею, из которой можно вывести все остальные положения математики) в конечном итоге провалился, искушение Фауста не сработало. Математика, как её описывали Бурбаки, оказалась не в состоянии описать многие интересные типы объектов топологии, ибо оперировала с уже довольно крупными/составными объектами, «множествами», а не более мелкими, как «точка». Стало понятно, что аксиоматический подход с описывающими геометрически задаваемые объекты аксиомами надо объединять с алгебраическими идеями конструктивизма. В конструктивной математике математический объект считается понятым, когда понятен способ его построения/конструирования из более мелких, и этот способ можно считать вычислением согласно доказательству или компьютерной программе на языке, способном записывать доказательства. Компьютерные системы, в которых возможны доказательства, были созданы102 — и хотя они оказались крайне сложны в использовании, тем не менее появился способ использовать компьютер для проверки математических доказательств, и это «алгебраический способ работы с основанными на геометрии понятиями», синтез двух разных математических подходов в самом основании математики.
Традиционно математики работают с «неформальными доказательствами», которые напоминают, скорее, «псевдокод», чем формальную компьютерную программу, которая может быть исполнена на каком-то вычислителе. Системы проверки доказательств, подразумевающие формальную запись доказательств и затем компьютерную проверку этих доказательств должны давать гарантии в том, что математическое знание согласовано между собой, то есть там нет ошибок. Ибо если в каком-то доказательстве ошибка, а на результаты такой работы ссылаются другие математики, то и эти работы становятся ошибочными, на них нельзя опереться. Поэтому кроме формальной теории типов, базирующейся на унивалентных основаниях математики, предлагается неформальная теория типов103, в рамках которой доказательства пишут «как обычно, неформально», но в которой в случае затруднений легко провести формализацию и затем проверить результат формализации компьютером.
Тем самым унивалентные основания математики позволяют:
-
Работать с доказательствами по практически всем типам математических объектов, которые были «невидимы» для предыдущих формальных/логических теорий. Грубо говоря, предложены кирпичи, которые позволяют описывать не только прямые стены, но и стены самых разных форм: переход к более мелким объектам даёт дополнительную выразительность. Тем самым через переформулирование в терминах более мелких объектов можно связывать между собой результаты в самых разных областях математики.
-
Предотвращать ошибки за счёт использования компьютеров для доказательств.
-
Обсуждать онтологические проблемы, в том числе проблемы задания объектов в физическом мире (базисные понятия геометричны, они связаны с обсуждением широко понимаемых форм/shapes, поэтому задействуют геометрическую интуицию, неотъемлемо присущую интеллекту, см. идеи Chollet104. В том числе легко решаются проблемы типа «отождествить Утреннюю и Вечернюю звёзды»).
-
Удобно стыковать основания математики (нужны для надёжного описания формализма), основной корпус идей «чистой математики» (придумывание новых типов математических объектов, которые обладают интересным нетривиальным поведением) и прикладную математику, которая после отождествления каких-то математических объектов с физическими объектами в плане поведения (то есть после моделирования) позволяет провести вычисление над математическими объектами для того, чтобы предсказать поведение физических объектов.
Теория типов даёт машинку «исчисления» (вычислений) как синтаксис, а теория категорий придаёт смысл теории типов (семантика) — что и для чего вычислять, там дуализм синтаксиса и семантики105.
Онтология и гомотопическая теория типов: унифицировать всё против найти «убойное приложение»
Основное назначение «чистой математики» — это давать интересные типы объектов, чтобы представлять/represent основные черты поведения объектов физического мира, а также основные черты поведения объектов ментального мира (других математических объектов). Само это представление/representation — это предмет онтологии. Онтологические исследования в приложении современной теории типов (а не теории множеств) как основы/элементов математики активно ведутся106, хотя не все математики и физики признают эту связь семантики, математики, онтологии, физики, теории понятий.
Представление о развитии математики тем самым оказывается связанным с важностью развития математики для решения каких-то внешних по отношению к математике проблем, а не просто «математики для математики». Это волновало Воеводского, волнует Родина и ещё множество математиков: если не получать время от времени задач из физики или других естественных наук, то происходит застой в самой математике — ибо не появляется интересных задач в прикладной математике, для которых чистая математика предложила бы новые типы математических объектов, удобные для их решения. Унивалентные основания математики тут помогут удержать разговор о новых типах математических объектов совместимым с разговором о старых типах объектов, то есть они помогают удержать рамки формальности/строгости в рассуждениях о постоянно расширяющемся наборе математических объектов с хорошо понимаемым интересным поведением.
Есть два варианта: либо пытаться воткнуть куда-то основания математики для 1) переписывания старого не очень формального (без компьютерной проверки доказательства теорем, написано в виде текстов на естественном языке с вкраплениями формул, совместно это «гипертекст», а не «компьютерная программа») и разношёрстного уже накопленного/legacy знания, или 2) поддержать новой математикой решение новых проблем: то есть повторить ход изобретения разных исчислений по потребностям естественной науки (типа как интегрирование и дифференцирование изобретены для решения задач механики, а потом развитие этих исчислений привело к выходу на квантовую теорию поля), и только потом формализации этих новых исчислений, уж насколько это возможно (полностью формализовать математические выкладки нельзя, об этом говорят теоремы Гёделя о неполноте107).
Одна из текущих проблем тут — это отсутствие развитого формального аппарата, компактно и формально описывающего распределённые представления/distributed representations. Нейросети стремительно растут в их применениях (в частности, появились LLM типа GPT-4 и Bard), но работ по распределённому представлению онтологий не так много. Отдельные работы по теории нейросетей и вычислениям в нейросетях как универсальных аппроксиматорах есть, но этих работ не так много и они по линии «классической математики с представлением функций», а не по линии классической онтологии с объектами и отношениями.
С доведением до практики, конечно, в этом направлении всё плохо: обычная проблема каких-то «оснований» в том, что с их приложениями знакомо много людей, а с самими основаниями — очень мало людей. С унивалентными основаниями математики людей знакомо очень мало, ибо основная аксиома во всём этом — аксиома унивалентности --сформулирована в 2006-2007 годах, для математики это очень малый срок (это ведь не распространение приложения по смартфонам, это распространение теории по головам людей, это проходит медленно).
К предложенному подходу с унивалентными основаниями математики отношение должно быть общим, как ко всем идеям, предлагаемым в ходе техно-эволюции (меметической эволюции): это гипотеза, что весь этот матаппарат будет хоть как-то полезен, сэкономит время, даст невиданные результаты. Пока непонятно, что может быть «убойным приложением»/«killer application». Текущая попытка найти такое приложение — это «доказательство правильности компьютерных программ» и предложение языков программирования, которые обладают повышенной выразительной силой в силу использования идеи зависимых типов (возможны вычисляемые типы переменных). Это явно не супервостребованное направление, особенно после понимания того, что значительная часть вычислений связана с нейронными сетями, где вопрос о формальности очень плохо проработан.
Как узнать, что получено «убойное приложение» какой-то идеи? Что-то должно стать эффективней, быстрее, дешевле, проще (то есть опять-таки дешевле и быстрее) — желательно, чтобы во много раз. Но с этими приложениями унивалентных оснований математики пока проблемы. Есть ли что-нибудь такое, что раньше нельзя было посчитать, а сегодня применили новую математику — и посчитали? Похоже, ничего такого нет — новых расчётов или повышения точности для старых расчётов при переложении со старых математических подходов на новые не предложено.
Если предположить, что новая математика нужна для компактификации и унификации математического знания (не помощь в новых расчётах, а объявление каких-то результатов, полученных разными математиками, «одним и тем же», переписывание старых результатов на новый язык, например, теоркатегорный язык), то считать, что экономится человеческое знание, тоже нельзя. Всё это «похожее» редко приходится рассматривать одним и тем же людям — разные инженеры делают разные расчёты, и как в эволюции идея каких-нибудь плавников или крыльев изобреталась много раз и реализована разными генами, так и в математике придумывалось много разных способов решения задач на каком-то уровне строгости. И интерес сейчас даже не столько к новому аппарату для формальной строгой математики, сколько к идеям нейросетей как универсальных аппроксиматоров, универсальных оптимизаторов, а также интерес к явно недоизученым распределённым (прежде всего нейросетевым, «выучиваемым») представлениям.
Математическому мышлению учат исподволь, а не явно
Математическому мышлению учат исподволь, хотя часто и осознают, для чего это делают: «если ответить на вопрос, зачем молодежи нужно изучать математику, то, в частности, потому что потом человек сможет работать во всех областях. Если ты хороший математик, то с тобой захочет работать хороший биолог, физик. Речь о том, что математика − это необходимая часть всего современного знания»108. Вот это высказывание состоит из двух частей: квантор всеобщности «всех областей» (всех-всех?) и прикладной аспект, то есть необходимая часть всего современного знания. Но знание особенностей крекинга тяжёлых углеводородов тоже «часть современного знания», но насколько она нужна всем, а не только тысяче или даже десяти тысячам причастных к нефтепереработке в масштабах мира?! Про математику и математиков те же вопросы про «необходимую часть современного знания» — что там необходимо из сотен тысяч известных математических результатов?
Математики активно спорят на эту тему: что у них там собственно «нужная всем математика», а что «прикладная, нишевая математика» — чему же таки учить даже не всех, а самих математиков, которые будут профессионализироваться в математике? Это всё обсуждалось и двадцать лет назад109, и даже кроме математики для математиков обсуждался (реплики чуть выше по приведённой ссылке) вопрос «нужно ли математикам знать что-то про computer science». И это было 20 лет назад, с тех пор мало что изменилось среди большинства математиков, несмотря на новые полученные результаты в основаниях математики. В программе изучения математики Михаила Вербицкого говорится110, что как ни изучай математику, будет разрыв в несколько лет между окончанием обучения и хоть какой-то работой, а в промежутке будет «бег за трамваем», ибо математика не стоит на месте. Вербицкий даёт оценку, что если свезло учиться по «альтернативной программе», а не «университетской классической», то бежать будешь где-то 4 года, а если у тебя «университетская классическая», то не быть тебе математиком, разве что ты гений и самообразовываешься. И тут же идут комментарии к этой программе: там нет теории вероятностей, без которой нет и современной физики!
Karl Friston предлагает111 самые разные теории (его интересует прежде всего теория active inference, но это приложимо к самым разным теориям, опирающимся на какой-то математический аппарат) излагать в двух разных связных описаниях:
-
Концепция использования (для чего использовать объекты теории, какие предсказания можно на основе теории делать, что можно делать инженерного/прикладного на базе этих предсказаний, как менять мир к лучшему). Сам Friston называет это описание «телеологическим»112, то есть для какого-то назначения, причём слово «телеология» поначалу шло из религиозного языка. В принципе, это довольно спорное терминологическое предложение, оно сравнимо с готовностью физиков использовать слово «панпсихизм», где мощнейшее направление внутри панпсихимзма «анимизм», то есть одушевление камней и рек. У Friston никакой религии или духовности нет, при этом упор в концепции использования идёт на функциональное описание, и концепция использования у него плавно переходит в функциональное описание концепции самой теории (какие там понятия используются для описания физического мира. Например, в физике это функциональный объект «физическое тело» и у него функциональные понятия «массы», «скорости»). Описание «целеориентированности» на достижение каких-то внешних целей (ответ на вопрос «для чего это надо») Friston называет teleology по старинной сначала религиозной, а потом философской традиции. Эту «телеологию» Friston считает необходимой в силу столетней давности прагматическому повороту в философии. Причём у Friston «цели» есть и у «недоагентов» (то есть не имеющих policy и plans, ибо агентность это не «есть-нет», а шкала).
-
Концепция дисциплины в части её конструктива (построения, construction). Это математическое описание функциональности дисциплины, сам Friston называет это under the hood (ибо «под капотом дисциплины у нас математика»). Грубо говоря, автомобиль телеологически/функционально/во время использования описывается для водителя (application/functional interface: как рулить и заправлять), а под капотом что там конструктивно — это описывается для механиков (как устроен мотор и из чего делают шины, «там математика»).
Во вводных курсах какой-то дисциплины упор делается на application interface (если там много математики в дисциплине, то при минимуме этой математики говорится про API), а в прикладных глубоких курсах — говорится про математику этой дисциплины, «как оно там внутри работает», чтобы можно было руками подкрутить что-то в вычислениях, что не охватывается обычным API «из коробки» (обычно рассказывается про framework/подход/онтику, позволяющий провести вычисления по конкретным формулам и алгоритмам «внутри дисциплины»).
В наших описаниях дисциплин интеллект-стека, и даже описании самой математики как дисциплины мы даём больше упор на «концепцию использования» (интерфейс дисциплины, итоговые рассуждения) и даём отсылки к литературе, описывающей дисциплины с использованием математического формализма (включая и отсылки к литературе по математике, хотя тут такой литературы и меньше, нам не так уж нужны «разделы математики»).
Если же обратиться к традиционному математическому обучению, то там внутри примерно то же самое: в прикладных курсах формулировки теорем и зачем они вдруг понадобились даются, а вот формальные доказательства — нет, ибо не ожидается, что кому-то потребуется «подкрутить излагаемую математику по потребности и что-то там передоказать». Дискуссии о том, нужно ли математику нематематикам давать с доказательствами теорем или таки давать без них, идут непрерывно: но поскольку очевидно, что знание теорем не равно умению что-то доказывать самому, а использование математики в её приложениях обычно не предполагает что-то там «передоказывать», эти дискуссии бесплодны. Одна сторона неявно говорит, что «математическое мышление как раз в доказательствах теорем, это же как раз то, что делают математики», другая сторона говорит, что «никакого математического мышления для использования математики не требуется, как не требуется знания программирования для использования MS Word или даже использования всех приложений смартфона вместе взятых, хотя они все сплошь составлены из софта — математическое мышление заключается в использовании математики»). Возможно, что «использование математики» — это всё-таки не математическое мышление (связанное с изучением поведения ментальных объектов, доказательства того, что они ведут себя именно так, как ожидается), а физическое мышление: подставка математических объектов вместо физических объектов и переход тем самым от натурных экспериментов к моделированию, «модельным экспериментам/экспериментам с матмоделью».
Преподавание математики с использованием пакетов типа Wolfram Mathematica113 и строго без таких пакетов тоже и у математиков, и у физиков, и у инженеров — это тоже предмет споров. Даже при преподавании таких предметов как семантика, собранность, логика вполне получается непосредственно привязать рассуждения в терминах объектов этих дисциплин (в терминах мета-мета-модели «из наших учебников») к рассуждениям о прикладных предметных областях (мета-моделях предметной области, «проектирование ведётся всегда в типах, и это типы мета-модели») и рассуждениям о конкретных ситуациях (операционных моделях, моделирование экземпляров объектов мета-модели). И используются моделеры, в жизни же всегда используются моделеры! Mathematica — это моделер для математических объектов, в жизни он просто обязан быть использован, поэтому непонятно, как учить математику и не использовать моделер. Это всё равно как учить программированию без компьютера, «чтобы лучше понимать» (помним, что конструктивная математика — это то же программирование). Что-то так, конечно, может быть выучено, но явно недостаточно выучено для использования в проектах, для «прикинуть в моделере». Это всё равно как землекопа учить сначала рыть руками, потом лопатой, потом только давать попробовать экскаватор, «чтобы лучше понимал предмет». Ресурс Conrad Wolfram (брат Stephen Wolfram, который придумал Mathematica) имеет слоган «Our mission is to reconceptualise the mainstream mathematics curriculum by assuming computers exist»114.
В случае математики не очень понятно, каким разделам математики надо учить «для примера» (все разделы всё равно не выучишь), чтобы студент после окончания курса мог разбираться в матмоделировании для каких-то проектов. Например, математика должна быть изложена на таком уровне, чтобы было понимание её объектов, используемых в квантовоподобных вычислениях. Основная идея там — это отрыв математики квантовых полей, описывающей явления физики на очень малых масштабах (элементарные частицы) от этих масштабов и описание используемыми там объектами самых разных других явлений. Этот ход уже был с успехом использован для механики: дифференциальное и интегральное исчисления были изобретены Лейбницем и Ньютоном для нужд механики, а затем начали использоваться для описания буквально всей физики, включая квантовую термодинамику. Ещё один пример — это математика глубокого обучения нейронных сетей в частности и её обобщение на обучение произвольных дифференцируемых структур/differentiable everything115.
Для понимания «как оно там внутри устроено» даже «без доказательств» нужно владеть материалом курса математического анализа (а «матан» — это полноценных четыре семестра в техническом вузе!), а ещё собственно выход на квантовоподобность, причём как это давать без рассказа о собственно квантовой физике и спора о её многочисленных интерпретациях (идея-то в том, чтобы оторваться от описаний этой математикой микромира и перейти к общим описаниям), так это пока невозможно понять. Да и с «непосредственным применением в жизни» всё не слишком понятно:
-
В физике абсолютно понятно, что без перехода к теории относительности и устранения «сил» из рассмотрения ничего не посчитаешь при запуске спутников навигации GPS, и дело не в искажении координат от сферической формы Земли, но в искажении пространства-времени массой Земли. С другой стороны, большинство других инженерных расчётов вполне могут быть сделаны на базе ньютоновской механики, и инженеров-робототехников учат именно ньютоновской механике.
-
Если брать какие-то биологические, социологические или психологические исследования, то множество данных эксперимента хорошо объясняется как раз квантовоподобным/quantum-like расчётом (excess Bayesian inference116 в рамках подхода active inference, или просто quantum-like расчётом «в лоб»117 как объясняющим итоги социальных, психологических, экономических и биологических измерений лучше, чем альтернативные методы). Но в какой момент переходить к такому расчёту? Сразу, или только после того, как показана неприменимость «обычного расчёта по Байесу»? Если мы знаем, что «рациональность на основе Байеса» даёт плохие результаты, а квантовоподобный расчёт точнее — не будет ли рациональней сразу считать квантовоподобно? Но в физике считают «рациональным» расчёт по Ньютону и Гамильтону для большинства случаев, и только для чётко выделенных случаев сверхмалых и сверхбольших масштабов расчёт по Шрёдингеру или Эйнштейну. В случае квантовоподобных расчётов в биологии и социологии таких критериев нет. Какой математике учить биологов, экономистов, социологов?
-
Учить надо «математическому мышлению» или «разделам математики», или и тому, и другому? Как избежать лишнего «обучения впрок» с одной стороны, и недоучивания до уровня, достаточного для самостоятельного системного моделирования, с другой стороны?
-
Если рядом с вами сидит гениальный математик-искусственный интеллект (а это по факту уже есть, в каждом смартфоне, в каждом компьютере — GPT-4 уже обладает довольно большими знаниями математики), то до какого уровня надо учить математику, чтобы не чувствовать затруднений в постановке математических задач для этого интеллекта?
Можно поставить задачу обучения математике как узкую задачу возможности сравнения двух онтик как выраженных в математических объектах. Скажем, Judea Pearl рассказывает в своей полухудожественной книжке The Book of Why (2018)118 о причинном выводе/causal inference. Он там претендует на универсальность понятия «причинный вывод», хотя книжка вся про медицину и сельское хозяйство плюс искусственный один пример с криминалистикой. Но чтобы оценить универсальность, можно обратиться к математическому аппарату причинного вывода. Когда про active inference рассказывает Karl Friston с коллегами (там ведь тоже inference, причём и causal inference есть, и даже парочка разных — и это не тот causal inference, что у Pearl, и в этом легко запутаться119)), у него универсальность от переопределения понятия агента до определения целей жизни и эволюции. Но если Pearl в своей книжке напирает на практичность (даёт концепцию использования), то у текстов Karl Friston со товарищи прикладное использование этих идей не просматривается, описания даны с большим количеством математики, но вот приложения — «они есть», предполагается, что функцию читатель сам как-то выведет из конструкции, из предлагаемой математики. Тут сразу две задачи:
-
Есть две теории вывода, в обоих говорится про «причинность». Насколько это одна и та же причинность? Это опять поднимается задача про совмещение Утренней и Вечерней звезды, обращение к доказательствам тождественности.
-
Насколько осмысленны конструктивные описания без функциональных? С одной стороны, они универсальны, «для любого использования». С другой стороны, пока не будет killer application, эта универсальность никому не нужна. «Это неуловимый Джек. Почему он неуловим? Потому что его никто не ловит» — «это универсальный математический аппарат. Почему универсальный? А его никто не пробовал применить, поэтому нам неизвестны неудачи в его применении».
Итого: математика во всех новейших подходах к описанию мира (включая панпсихичность, описание дарвиновской и техно-эволюции, описание причинности и объяснений, описание познания/обучения для нейросетей) как-то готова, поэтому прикладные курсы для специалистов с «конструктивным описанием дисциплин» можно читать прямо сейчас (по статьям и докладам, даже не дожидаясь учебников). Но почти ничего нет для обучения студентов общему математическому мышлению в рамках интеллект-стека, где упор делается больше на функциональное описание «если у тебя вот такие проблемы, то попробуй подумать так-то и так-то».
Скажем, решим давать математику-физику-computer science (они все тесно переплетены) «по-тяжёлой», то есть и «для использования/функционально/телеологически» (рассказывать для чего, и давать попробовать во взаимодействии с математиком-AI) и что там «под капотом» (вся сопутствующая математика и достижение в ней беглости и интуиции, чтобы разбираться в том, что и как там делает математик-AI или даже математик-человек). При всей возможной оптимизации по части методики обучения только на это может уйти два года студенческого full time, как на университетских физфаках или мехматах: чудес не бывает, царской дороги в геометрию нет. А с учётом того, что математическое знание непрерывно прирастает, то надо бы это время как-то увеличить, ибо не зря Вербицкий напоминал «бег за трамваем». Это будет очень круто и крайне полезно для всей будущей жизни такого студента (но уверенности, что это будет полезно для всей будущей и даже текущей жизни такого студента всё-таки нет, помним про математика-AI). Такого ли «хардкора» по математике мы хотим, или всё-таки чего-то более лайтового?! Лет пятьдесят назад ответ на такой вопрос был бы один, а сейчас изменилось всё: и сама математика, и способы её использования в проектах, и возможность математических выкладок в компьютере, и сам подход к обучению людей в условиях быстроменяющегося знания, накапливаемого человеческой (и уже не совсем даже человеческой) цивилизацией.
Что из математики должен знать условный директор стадиона? Чему из алгоритмики нужно учить условного директора стадиона? А чему учить условного директора стадиона из термодинамической теории эволюции и квантовоподобного active inference? И зачем ему знать хоть что-то про термодинамическую семантику, про нейросемиотику? Ответ «для общего развития» тут не подойдёт, нужно указать, как это будет потом использоваться в мышлении, в рабочих ситуациях. Ибо если не будет использоваться, то и учить не нужно! А что изучение математики (или физики) «ум в порядок приводит», так это не так, это из области городских легенд. Изучение математики должно определяться целями, внешними для математики!
На уровне науч-попа изучать «занимательную математику» — это будет просто «интересненько». Но нужно давать математику как трансдисциплину, чтобы увязывать самые разные рассуждения по самым разным моделям на многих системных уровнях и на многих уровнях абстракции/описаний. Всё это вроде как SoTA (ибо предлагаемая новейшая математика для новейшей физики хорошо согласуется с экспериментом, выдаёт результаты лучше других объяснительных теорий), но всё настолько свежее, что не накопилось опыта массового использования в проектах самых разных масштабов, речь идёт пока только о нескольких лабораториях мира, где идёт исследовательская (а не инженерная) работа, где мир познают в его отдельных очень узких аспектах, но пока не активно меняют его к лучшему (при всём уважении к точке зрения, что познать мир и поменять мир — это одно и то же, active inference).
Какая-то интуиция подсказывает, что математика и физика интересны не только своим прикладным знанием «разделов математики» и «разделов физики», что вполне важны для интеллект-стека математическое и физическое мышление. Это знание вполне общеобразовательное, фундаментальное/трансдисциплинарное/мультимасштабное «для всех уровней сложности от инертного вещества через киберфизические системы и живые организмы до людей и человечества с его AI». Но вот зачем и как в голову студентов ставить понятизацию, собранность, семантику, онтологию с её «машинкой типов», и что будет, если этого в голове нет, можно буквально на пальцах объяснить. Зачем нужно заземление/grounding и как его делать в переходе к конкретным описаниям — это сразу становится понятным.
Но вот абстрактные математические понятия, которые стали физическими (поля, пространства, и даже энергия, в том числе свободная энергия) и отличия байесовского вывода от квантового вывода (в том числе понятие вариационного исчисления, а также байесовского сюрприза, вычисляемого в вариационном выводе) — это не факт, что быстро удастся описать. А нейронные сети? Понятно, что мало кто в мире знает про то, как работают и как делают микропроцессоры, и как именно устроены нейронные сети. Или секрет рецепта кока-колы. И ничего, живут. А вот active inference — это такое же «важное, но вполне прикладное знание, которое будете использовать, только если попадёте в эту узкую предметную область, что-то типа рецепта кока-колы, который нужен только если именно кока-колу производите», или это «фундаментальное/мультимасштабное знание/трансдисциплина, которую вы будете использовать каждый день при рассуждениях о самых разных других предметах для самых разных системных уровней, поэтому математику active inference надо хорошо знать»?
Общий принцип active inference вполне можно использовать и без знания математики (например, обсуждая governance в менеджменте, это уже преподаётся на наших курсах, есть учебник120 и разбор материала).
Гипотеза в том, что математику в active inference всё-таки знать надо (принципы вариационного исчисления), и её можно будет использовать чуть ли не ежедневно, если её знаешь. Какие-то порождающие/generative модели, требуемые этой теорией, и так делаются практически в каждом проекте, хотя и очень разные, но говорить о них как-то единообразно придётся, и для этого вполне подходит следование идеям active/embodied инференс, которые как раз предлагают различать виды моделей и виды действий (изменение моделей себя и/или окружения, изменение себя и/или окружения).
Если вы преподаёте системный фитнес, то будете объяснять, как ставить тело под собственный контроль (body control) через predictive performance framework — и это знание PPF на основе active inference должно быть общим не только для системного фитнеса, ибо если вы ставите корпорацию под контроль, то и про корпорацию (corporate control/governance) должны рассуждать примерно так же.
При этом переход к геометрическому моделированию агентов может быть очень продуктивным, постоянно выходят работы в этом направлении, в том числе и по геометрическим методам в active inference121. Под любым описанием (в том числе описаниями, исходящими из принципа минимизации свободной энергии) будет холст, на котором оно нарисовано. Вот геометрические «точка» и «пространство», выраженные алгебраически, вместе с ещё несколькими уровнями описания между ними, вполне могут быть таким холстом, базовыми понятиями, основаниями математики. Но множество ходов, которые начинают с более высоких уровней. Вот, например, использование теории категорий в качестве математического основания для active inference, «Mathematical Foundations for a Compositional Account of the Bayesian Brain»122, ход на конструктивизм в нейронных сетях на основе байесовских методов. Тут, конечно, нужно учитывать, что математические описания active inference склоняются к квантовым методам123, а не чистым байесовским.
Чему учить в математике (написано в соавторстве с GPT-4)
В написании этого подраздела был использован следующий ход: из статей Владимира Воеводского был взят список важных математических объектов, которые придумали математики в последние годы, но которые пока почти не используются в естественных науках: categories, sheaves, cohomology, simplicial sets. Затем взята идея «оснований математики» на базе унивалентной аксиомы: вместо логик разных порядков (формулируемых на базе теории множеств) иметь гомотопические уровни объектов разных типов (формулируемых на базе алгебраического выражения геометрических представлений о форме). Автор попросил GPT-4 рассортировать categories, sheaves, cohomology, simplicial sets по этим уровням. А потом попросил дополнить этот рассортированный список объектов другими важными объектами (важность определялась GPT-4 самостоятельно). Вот итог, в котором было вставленное по-русски дополнение про теорию порядков, это важно для выражения идей кардинализма и ординализма, например, в экономике, но всё остальное порождено GPT-4 и осталось нетронутым:
-
h-level 0 (contractible types):
- Point: A single point is a contractible space, as it can be continuously deformed into itself.
-
h-level 1 (propositions):
-
Cohomology: Cohomology theories usually involve abelian groups or modules, which are sets, but the actual cohomology groups can be seen as propositions when considering them up to isomorphism.
-
Equivalence relations: An equivalence relation on a set partitions the set into disjoint subsets, and can be seen as a proposition about the elements of the set.
-
Equations: Mathematical statements that assert the equality of two expressions can be seen as propositions.
-
вся теория порядков - предпорядки, решетки, соответствия Галуа и т.п.
-
-
h-level 2 (sets, и тут вычислимость, так как объекты стали различимы и можно вычислять их свойства):
-
Chu spaces: A Chu space is a set-theoretic structure consisting of a set of states, a set of events, and a satisfaction relation between them.
-
Categories: A category consists of a set of objects and a set of morphisms, along with composition and identity operations satisfying certain axioms.
-
Simplicial sets: A simplicial set is a functor from the simplex category to the category of sets. The category of sets is an h-level 2 object, so simplicial sets can be considered at this level.
-
Topological spaces: A topological space is a set of points, along with a collection of open sets satisfying certain axioms.
-
Groups: A group is a set with a binary operation satisfying certain axioms, such as associativity, identity, and inverses.
-
Functions: A function is a relation between a set of inputs and a set of possible outputs with the property that each input is related to exactly one output.
-
Matrices: A matrix is a rectangular array of numbers, symbols, or expressions, arranged in rows and columns.
-
Vectors: A vector is an element of a vector space, which is a set of objects that can be added together and multiplied by scalars.
-
Sequences and Series: A sequence is an ordered list of elements, while a series is the sum of the terms of a sequence.
-
Graphs: A graph is a mathematical structure consisting of a set of vertices and a set of edges connecting pairs of vertices.
-
Probability Distributions: A probability distribution is a function that describes the likelihood of obtaining the possible values of a random variable.
-
-
h-level 3 (groupoids):
-
Sheaves: A sheaf is a functor from a category (usually a topological space or a site) to the category of sets or groupoids, satisfying certain axioms. Since groupoids are at h-level 3, sheaves taking values in groupoids can be considered at this level.
-
Lie groups: A Lie group is a group that is also a smooth manifold, with the group operations being smooth maps. Since groups are h-level 2 objects and manifolds are h-level 3 objects, Lie groups can be considered at this level.
-
Fractals: A fractal is a complex geometric shape that exhibits self-similarity and has a non-integer dimension. Fractals can be considered at h-level 3 as they often involve groupoid structures.
-
Проблема в том, что переформулирование онтологии предметной области в терминах теории категорий как объектов с хорошо изученным поведением в терминах теории типов — это тяжкий и весьма объёмный труд, хотя его сегодня можно делать с использованием AI.
Но что потом можно будет сделать легче, или вообще сделать? Ответы пока не слишком внятны. В целом вроде как можно пройти по спектру формальности в сторону больших кусков проверенных формальных связных согласованных утверждений о мире. Но вот польза от этого пока не была продемонстрирована, и тут дело даже не в одном-двух примерах, необходимо демонстрировать что-то массовое и доведённое до практики (скажем, какие-то массовые инженерные расчёты).
В учебных программах ШСМ по интеллект-стеку можно использовать эти материалы как поправки к мета-мета-модели. Это не слишком формальная онтология, которая позволяет точнее и быстрее думать (но не вычислять более формально, о чём больше всего заботится подход унивалентных оснований математики в частности и теории гомотопических типов в целом). Пока понятно, что проблема не столько в отсутствии формальности в мышлении, сколько в плохих объектах для мышления на среднем уровне формальности, и выбирать объекты желательно так, чтобы потом проще было формализовывать, если это будет сочтено нужным.
Обучение математике тем самым стоит посвятить математическому мышлению, а не изучению поведения некоторых конкретных классов математических объектов. Если примерно понятно, как устроена математика в целом, что там в основаниях математики (foundational ontology), что на уровне «чистой математики» (изобретение новых видов математических объектов), что на уровне прикладной математики (использование вычислений с известными математическими объектами), то можно рассчитывать на то, что при встрече с какими-то проблемами в математическом моделировании можно будет разобраться хотя бы с постановкой задачи для математического AI. Конечно, нужно будет при обучении получить какие-то примеры таких связных рассуждений (что там в основаниях, как предложены какие-то конкретные важные математические объекты, какие модели и вычисления с ними делаются в естественных науках), но это именно примеры. Не стоит ожидать, что просто на изучении поведения объектов в каких-то «разделах математики» появится это математическое мышление. Конечно, если математику преподаёт какой-то «великий математик» (или «великий физик», которому нужна новая математика для его области физики), то может состояться неформальная передача этого математического мышления, но это будет у одного студента из десяти. Нужно же экономить время обучения: тому, что понятно про роль математики в науке и инженерии учить непосредственно, как и учить непосредственно тому, что и как в математике развивается.
Это открытый вопрос: можем ли мы поднять качество мышления в целом, если перетолкуем текущую математику выражения онтологии на гомотопии. С одной стороны — геометрические интуиции пространств, путей (траекторий), типизация вроде как вся остаётся (хотя её нужно будет перетолковывать). С другой — непонятно, насколько это поможет в мышлении «вот прямо сейчас». Учитывать нужно, что уже есть AI класса GPT-4 с Wolfram Alpha и выше, которые помогут в мышлении с «классикой». Но в любой науке есть идеи «удобных для мышления объектов» прошлых поколений, с использованием которых было наработано довольно много знаний. А потом всё равно приходилось перетолковывать этот огромный корпус знаний заново по мере получения более формальных, более точных, более универсальных знаний.
Если впрямую научить рассуждать про обычный мир вокруг в терминах объектов и операций, предлагаемых в основаниях математики (обычно хватает понимания 70-80 понятий для начального обучения мышлению в какой-то предметной области, тут можно ожидать такого же), то станет удобней мыслить об окружающем мире, и проще потом будет заниматься математическим моделированием. Такой подход поможет быстрее проходить развилку: чистая философия против физики, «думайте в терминах вот этих объектов» против «думайте в терминах вот этих объектов, и вы сможете что-то посчитать и сравнить результаты с измерениями». Самой математикой должны заниматься компьютеры, но обучать нужно тому, что в этих занятиях нет никакой магии, никакого «вдохновения» или «гениальной интуиции», но есть рациональные объяснения.
Высказывание «математика царица наук, но служанка физики» оказывается в каком-то смысле верным: математика открывает новые типы ментальных объектов и изучает их поведение, но затем эти объекты оказываются нужны для того, чтобы как-то отождествлять их с физическими объектами и судить по поведению математических объектов о поведении физических объектов. Физикам приходится тем самым ограничивать своё воображение только теми ментальными конструкциями (сконструированными из более мелких более крупными ментальными объектами), которые как-то соответствуют данным экспериментов. Из физиков вырастают великолепные руководители крупных организаций, но из математиков такого почти никогда не бывает. Но по мнению Александра Жаворонкова (CEO Insilico Medicine124), для задач создания новых видов нейронных сетей, занимающихся решениями биологических и фармакологических проблем, лучше использовать математиков: они для таких задач оказываются немного креативней физиков, «отвязней» в своих догадках. Так что учить только физическому мышлению в его привязке к физическому миру не совсем правильно, нужно ещё и обучать математическому «отвязному» мышлению.
Что из математики надо знать «простым людям» (не-математикам) для того, чтобы точнее делать предсказательные/порождающие модели для своих самых разных ситуаций? Что «одинаковое в математике» вынести за скобки всех проектов и выучить один раз, чтобы потом по-быстрому применять во всех проектах? Идея о том, что «все будут профессиональными физиками» — не работает, «все будут профессиональными математиками» — тоже не работает, и даже «все будут профессиональными программистами» — так же не работает. Какой объём математических идей должен попасть в мышление (возможно, заменив сегодняшние «бытовые» мемы/эвристики/догадки более продуктивными, найденными математикой-физикой-информатикой), чтобы продуктивно использоваться в повседневном мышлении по решению самых разных классов проблем?
Тут надо бы слушать не столько самих математиков, сколько тех людей, которым математика зачем-то была нужна, и которые были бы и рады без неё обойтись, но не могут, ибо она оказалась полезней всего остального для их проектов. Первые из этих людей — физики, вторые — программисты (включая программистов систем искусственного интеллекта), третьи — инженеры, но математических модельеров надо искать и в других областях. Трудность в том, что они не знают ни современной математики, ни альтернативного способа организации обучения математике, поэтому расскажут только о том, как учили их самих и дадут какую-то оптимизацию этого старинного образования. «Всё новое приходит сбоку», прорывы в математическом образовании и использовании математики придут явно не от математиков.
Важнее всего оказывается разделить «содержание математики» на многочисленных её уровнях выше основания, «разделы математики» и собственно математическое мышление как способы наработки нового содержания математики, способы применения этого содержания к жизни, в том числе к другим трансдисциплинам, способы построения математических объяснений.
Есть сотни книг вроде как про «математическое мышление», скажем, Барбара Оакли, «Думай как математик. Как решать любые задачи быстрее и эффективнее»125. Эта (и многие другие похожие книги) больше похожи на курсы собранности, а не математики: там рассказывается про память, концентрированное и деконцентрированное внимание, прокрастинацию, а также дают прикладное знание по собранности, то есть дают постановку привычки учиться. И это всё дано бытовым языком, на байках и метафорах, теории собранности нет, только «лайфхаки». Книга оказывается не про математическое мышление как задание важных объектов внимания и операций с ними для рассуждений об использовании математических знаний в проектах. Книга также не про собранность в приложении к математике, но про «психотерапию для обучения математике» (терапия — это «ремонт», убираем отклонение от нормы, убираем недостатки).. Нет в книге ответов на вопрос «почему именно это» (объяснений), и на вопрос «как именно это нужно делать?! Легко сказать, что надо быть поэтом! И ещё хорошим поэтом! Но как именно?!» (нет описания методов). В книге не даются какие-то понятные принципы с понятной объяснительной теорией за ними, но даётся сборник психотехнических лайфхаков общего вида. Для постановки математического мышления хочется другого, больше похожего на старинную (больше двадцати лет назад) статью Атья и более новую статью Родина. Но Атья и Родин писали как математик для математиков. А надо писать для всех людей, и не как математик, а как учитель мышления, показывающий роль и место математики в ряду самых разных других трансдисциплин. Поместить математику в контекст, вот что важно!
Итого из относительно нового, что надо знать про математику в 21 веке:
-
HoTT (homotopy type theory) и дальше теория категорий вместо теории множеств и FOL (first order logic) как foundation ontology для теории понятий «объектов и отношений» (теория понятий лежит в основании онтологии предметного мира), так и математики как непосредственно используемой онтологии физики и естественных наук (мат.объекты и операторы как отношения). Новый синтез геометрии и алгебры в математике.
-
обсуждение «среднего уровня формальности» (informal type theory), то есть ходы на свободную формализацию и деформализацию, то есть изучение способов мышления на уровне «псевдокода», удобного для дальнейшей формализации и последующих строгих вычислений.
-
Обучение математическому мышлению, «как оно там в математике устроено» вместо обучения «разделам математики» в надежде, что появится математическое мышление.
https://en.wikipedia.org/wiki/The_Unreasonable_Effectiveness_of_Mathematics_in_the_Natural_Sciences
Хренников А. Ю. Введение в квантовую теорию информации. — М.: ФИЗМАТЛИТ, 2008. — 284 с.
https://en.wikipedia.org/wiki/Proof_theory (и там смотрите Formal and informal proof)
https://royalsocietypublishing.org/doi/10.1098/rstb.2014.0167, "Consciousness: here, there and everywhere?", 2015, by Giulio Tononi and Christof Koch
https://en.wikipedia.org/wiki/Symmetric_monoidal_category, https://en.wikipedia.org/wiki/Closed_monoidal_category
Symmetric Monoidal Categories: a Rosetta Stone, https://johncarlosbaez.wordpress.com/2021/05/28/symmetric-monoidal-categories-a-rosetta-stone/
Constructive Mathematics, https://plato.stanford.edu/entries/mathematics-constructive/
https://mt.cs.upc.edu/2021/02/08/major-breakthroughs-in-multilingual-neural-machine-translation-ii/
https://www.sciencedirect.com/science/article/pii/S0303264720301994 и https://www.frontiersin.org/articles/10.3389/fnbot.2022.910161/full#B45
https://en.wikipedia.org/wiki/Variational_autoencoder, https://en.wikipedia.org/wiki/Generative_adversarial_network
https://en.wikipedia.org/wiki/Analytical_dynamics, https://en.wikipedia.org/wiki/Dynamics_(mechanics)
https://arxiv.org/abs/2012.01150, слайды и видео рассказа от декабря 2022, https://philomatica.org/2022/12/univalent-foundations-and-applied-mathematics/
The simplification in integration architecture that 4D supports https://gateway.newton.ac.uk/sites/default/files/asset/doc/2105/Ian%20Bailey.pdf
https://planetmath.org/informaltypetheory, и такие тексты, как "свобода от логики", https://golem.ph.utexas.edu/category/2012/11/freedom_from_logic.html, traditional mathematics is usually written in natural language (with some additional helpful symbols), but in a way that all mathematicians can nevertheless recognize as “sufficiently rigorous” — and it’s generally understood that anyone willing to undertake the tedium could fully formalize it in a formal system like material set theory, structural set theory, or extensional type theory. By analogy, therefore, we would like an “informal” way to write mathematics in natural language which we can all agree could be fully formalized in homotopy type theory, by anyone willing to undertake the tedium.
On the Measure of Intelligence, https://arxiv.org/abs/1911.01547, 2019
https://ncatlab.org/schreiber/show/Modern+Physics+formalized+in+Modal+Homotopy+Type+Theory, https://ncatlab.org/schreiber/show/Some+thoughts+on+the+future+of+modal+homotopy+type+theory, https://disk.yandex.ru/i/B9RvP1YrUUEm9w