7. DevOps
DevOps и инженерия платформы
Как всегда, современное состояние методов системной инженерии нужно смотреть не в «железной» инженерии или каких-то прикладных «не очень инженерных» её видах типа инженерии организаций (менеджмент) или мастерства (образование), но в программной инженерии. Управление жизненным циклом ещё лет пять назад в программной инженерии и системной инженерии считали почти согласованными между собой, и даже более-менее успешно велись работы по унификации стандартов управления жизненным циклом: стандарты методов жизненного цикла «железной» и «программной» инженерий (ISO 15288 и ISO 12207) стремились сделать как можно более похожими друг на друга, но тут оказалось, что если продолжать следовать этим стандартам, то невозможно вести крупные программные проекты типа «информационная система транснациональной корпорации», где надо поддержать вебсайт интернет-магазина с личными кабинетами миллионов пользователей, поддержать финансовый учёт и контроллинг, поддержать управление запасами и работу кадровиков, поддержать собственно проектирование и производство продукции, поддержать свод всего этого для самых разных подразделений компании, раскиданной по многим континентам, и ещё при этом никогда не сбоить и не останавливаться на переналадку. Так что в программной инженерии пришлось много экспериментировать и менять разделение труда, чтобы перейти к эволюционной инженерии. Разделение труда в классической системной инженерии отставало от экспериментов в программной инженерии, но разрыв этот всё меньше и меньше: уже понятно, что даже и разработка ракеты никогда не заканчивается, и разработка автомобиля, и чего угодно, даже зданий и сооружений, которые вроде бы ставятся «на века».
Разделение труда — это ведь задача архитектуры организации: вам надо для модулей-агентов иметь такие назначенные на них функции, чтобы они могли работать по возможности автономно. Сплочённость агентов (связность внутри агентов) должна быть высокой, а связи/зацепления между агентами — по возможности низкими, иначе организация проекта из этих агентов не сможет развиваться по мере развития целевой системы. Это означает, что сработает не любое разделение труда, не любая организация проекта. То, что мы рассказываем тут в руководстве — то, что выжило в ходе многочисленных проб.
Вместо «управления жизненным циклом» и постадийной расстановки ролей вдоль понятного всем «водопада» пришла эволюционная инженерия, и на первый план вышла вот эта эволюционность, непрерывность. Оказывается, систему надо не просто спроектировать/design, изготовить (manufacture или compile and make), один раз собрать/integrate (в том числе испытать/test в собранном виде), один раз развернуть/deploy на месте эксплуатации, один раз ввести в эксплуатацию (deliver). Нет, инкременты надо выпускать по полному циклу разработки по многу раз в день — идея «непрерывного всего», чаще всего сокращаемая до «непрерывной сборки/интеграции» и «непрерывного введения в эксплуатацию», CI/CD.
Архитектор, визионер оказались работающими на уровне целой системы, а разработка ушла во множество асинхронно работающих над разными частями системы команд, которые выпускают множество маленьких инкрементов разных фич. Команды сами принимают решение о том, чтобы выпустить какой-то инкремент пользователю, сами получают обратную связь от тех пользователей, которые пользуются этими новыми фичами.
Но вот кто там изготавливает, собирает/интегрирует, разворачивает/настраивает, вводит в эксплуатацию? Как называется эта роль — которая занимается этим после проектирования/design? Новый инженерный процесс некоторое время пытались называть «гибкой разработкой» (agile development), включая в «разработку» и работу разработчиков/developers, и собственно изготовление-сборку-наладку-ввод в эксплуатацию, которыми в software engineering занимались эксплуатационщики/operators (часто — system administrators, «распорядители системы»). Но термин быстро обессмыслился: гибкий инженерный процесс ещё имел смысл, но традиционный акцент именно на разработке всех сбивал с толку. В гибком инженерном процессе больше всего поменялась не разработка (хотя и тут происходит много интересного, взять тот же vibe coding, он же software 3.0), но отношение к сборке/integration, разворачиванию/deployment, «введению в эксплуатацию»/delovering — при этом ввод в эксплуатацию перестал быть разовой конечной точкой проекта, он стал постоянным, непрерывным (continuous delivery). Конвейер (трубопровод, pipeline, а теперь говорят про «внутреннюю платформу разработки»/ «internal development platform»), который никогда не останавливается и выносит всё новые и новые изменения огромного числа взаимосвязанных новых возможностей (фич) пользователям.
Метод, который заменил традиционное однократное «управление жизненным циклом» на «управление прохождением инкрементов системы от разработчиков к пользователям» получил название DevOps1: работа в смычке разработчиков и операторов. Операторы, они же «сисадмины» в службе эксплуатации системы до появления методов DevOps брали у разработчиков исходные коды базиса (baseline, «административно утверждённая стабильная конфигурация») новой версии софта у разработчиков, компилировала и собирала её в нужном операционном окружении (операционная система, версии СУБД), разворачивала/deploy на «боевых серверах», затем давала доступ пользователям, то есть вводила в эксплуатацию, deliver. «Разработчики отдают, а системные администраторы принимают» — это было наследием водопада, неудачность такого разделения труда (его часто ассоциировали с «перебрасыванием через стену»: разработчики изготавливают код системы, а потом перебрасывают его через высокую кирпичную стену службе эксплуатации, operations — и там хоть трава не расти, «обязанности разработчиков выполнены») была очевидной. Поэтому появилось «движение» (как общественное движение: принципы ясны, но нет общего центра, который бы отслеживал чистоту идеи — реализация везде была уж какая получалась, не было «предписанного умными людьми верного метода») DevOps: «соединения труда», ранее разделённого на труд разработчиков (Dev) и труд операторов-сисадминов (Ops). DevOps провозглашало ответственность разработчиков за то, что происходит там у операторов, то есть «разработчики сами администрируют свои работы, ибо только они понимают, что это они разработали».
В DevOps постепенно включили и поддержку тестирования, и мониторинг, и управление конфигурацией, и много чего ещё, и ещё было много путаницы от начальной формулировки целей DevOps (Development, Operations) как «устранение противоречий между разработчиками и службой эксплуатации/системными операторами». Разработчики начали осваивать agile-разработку и стали готовы выдавать не одну версию системы в год (ну вот примерно как сейчас выходит версия операционной системы Android или iOS), а одну версию системы в день (ну вот примерно как сейчас выходят версии операционной системы Windows, чуть ли не каждый день какое-то обновление), а после автономизации команд — и множество версий в день. Системные администраторы при выходе каждой новой версии должны были её развернуть, оттестировать, аккуратно перенести в неё пользовательские данные, а потом иметь вал запросов от пользователей по поводу устранения новых ошибок, которые разработчики явно не спешили устранять, ибо они были заняты уже новыми фичами.
Возник неожиданный конфликт: сисадмины попросили разработчиков выпускать свои релизы не быстрее, а медленней! Разработчики при этом говорили, что не могут — клиенты ждут новых фич! Сисадмины тогда просто начали пропускать новые версии софта: продолжали работать на старых, иногда годами. Ибо «всё работает, не надо чинить не поломанное». Новые фичи перестали доходить до клиентов, это было массово.
Поэтому и появилось движение DevOps как решение этих проблем: «ответственные разработчики взялись помочь операторам (системным администраторам) и создали DevOps». Это понималось очень по-разному, например иногда как «теперь разработчики у нас ещё и системные администраторы, эти службы объединили!». Но жизнь пошла не по пути «объединения служб под одним начальником, который как-нибудь разрулит их конфликты».
Очередная проблема возникла, когда «ответственные разработчики» пришли к «безответственным сисадминам» — и обнаружили, что те таки реально не справляются, новые версии системы устанавливались тяжёлым ручным трудом. Поэтому первое, что начало происходить — «завод по изготовлению работающего софта из исходных кодов» начали автоматизировать. Появилось огромное количество технических приёмов по интеграции/сборке программных приложений и более-менее безопасному (а вдруг ошибки?!) их вводу в эксплуатацию.
Появилось множество новых видов софта, автоматизирующего и интеграцию результатов работы отдельных команд в целую систему, и инженерное обоснование успешности системы: прежде всего разнообразное тестирование, включая и функциональные тесты, и тесты на соблюдение архитектурных решений/fit functions, и включая многочисленные варианты тестирования на надёжность, типа случайного отключения крупных частей системы, чтобы проверить работоспособность в условиях катастрофы — chaos engineering, а ещё мониторинг защиты/security. Новые инструменты вели мониторинг уровня дефектов в системе, они собирали отклики пользователей, и так далее. По факту все эти новые инструменты делали части того, что потом назовут «внутренняя платформа разработки», конвейер/трубопровод каких-то «деталей системы с новыми функциями» от многочисленных команд разработчиков, за которыми присматривают архитекторы, собирающийся в целую систему, тестирующийся и предоставляющийся в конечном итоге пользователям системы.
Сисадмины по факту перестали существовать, появился термин IaC (infrastructure-as-code)2, когда под это движение DevOps подстроились инженеры компьютерной аппаратуры: конфигурирование и настройка компьютеров стали тоже происходить без нажатия на физические кнопки, а специальными программами. Повторить конфигурацию платформы — это нажать кнопку, чтобы прогнать код, который всё-всё настроит. А раньше? Скрипта не было, было выполнение руками многочисленных операций типа «скопируй вот эту программу отсюда туда, укажи ей адрес, по которому лежат её данные», а операции делались «согласно документации» и «записям в записных книжках» самых опытных сисадминов.
Похожий метод получил название SRE (site reliability engineering, инженерия надёжности сайта, причём необязательно именно веб-сайта), он появился даже раньше DevOps, в 2003 году в Гугле. После осознания роли автоматизации было даже предложено переименовать DevOps в NoOps3, похожие методы стали появляться в самых разных инженериях XOps (MLOps, PlaftormOps, DataOps, и т.д.4). Появились конференции DevOps, учебные курсы/руководства/стандарты/регламенты DevOps, люди начали себя называть DevOps, если они работали в этой роли в инженерии.
И тут появилось ещё одно интересное следствие, повлиявшее на разделение труда: разработчики получили в руки сложнейший набор разнообразного софта по автоматизации, инструментов DevOps (как их начали называть). Результаты автоматизации породили множество специализированного универсального софта, который надо был как-то адаптировать к условиям текущих проектов, к закупленным операционным системам, мощностям датацентров, соединять в какие-то «трубопроводы/конвейеры». Самые разные программы «DevOps» занимались тестированием, упаковкой приложений в контейнеры для операционной системы, мониторингом работоспособности, балансированием нагрузки — пара десятков типов «инструментов DevOps», каждый из которых представлен какими-то конкурирующими версиями инструментов от разных провайдеров. Это всё равно как дать конструкторам из конструкторского бюро обязанность выбирать у поставщиков машиностроительных станков разные версии всех этих «обрабатывающих центров», «измерительных стендов», «упаковочных станций» — настраивать их и работать на них, чтобы вручать клиенту не чертежи, а работающую уже собранную и проверенную конструкцию. А завод? Ну, это ж идея DevOps — проектировщики вроде как должны были стать и заводчанами, поэтому дальше у них не должно было быть конфликта с заводчанами!
Вот типичная картинка5, которую приводят, когда описывают инструменты/«станки» для DevOps в программной инженерии:
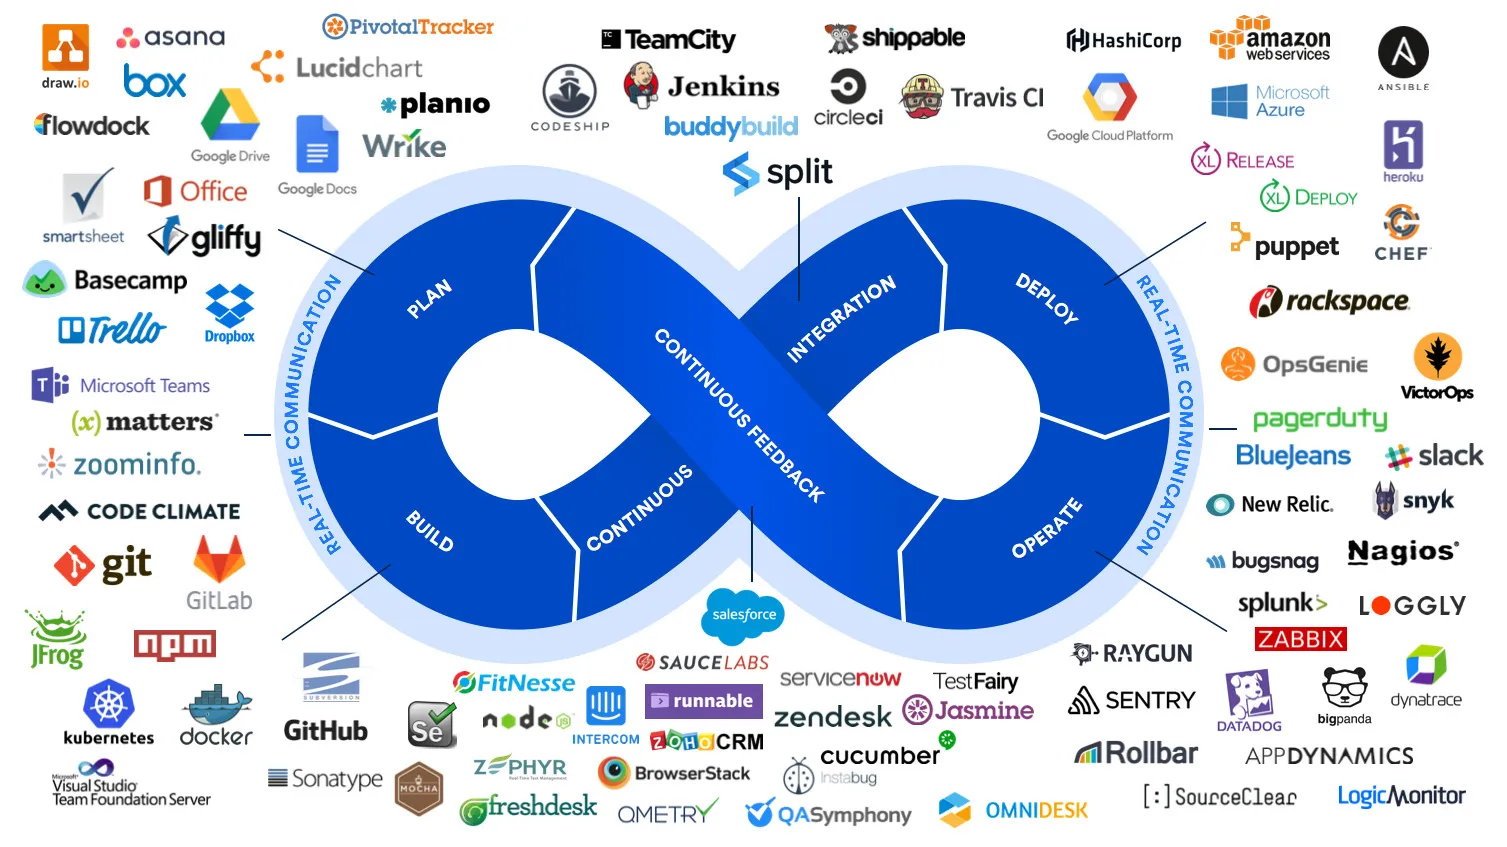
Понятно, разработчики не справились: они начали повсеместно «выгорать» от этой новации, им некогда было уже разрабатывать новые фичи целевого софта, они непрерывно разворачивали и переналаживали свой «конвейер», свой «трубопровод» по выпуску софта. Решение было в
-
выделении отдельной роли для этой деятельности — инженер внутренней платформы разработки (internal development platform). Обязанность — закупить и развернуть весь этот софт платформы (инструменты DevOps), настроить его для выпуска целевой системы, а также научить разработчиков работать с этим уже развёрнутым и настроенным софтом.
-
Объявлении этой внутренней платформы разработки продуктом, который оказывает сервис разработчикам, и поэтому там должны быть соблюдены все принципы продуктовой разработки для клиента (customer development), разработчики — «внутренние клиенты».
-
Сохранении основной идеи DevOps, иногда формулируемой как «ты это построил, ты это и эксплуатируй» (you build it, you run it), разве что в руки разработчики получают готовый инструмент-завод, а не полуфабрикат «сделай себе свой завод сам», «платформу разработки собери и настрой сам». Нет, завод тебе создадут — и дадут готовый.
Platform engineering — это не отдельная от DevOps идея, это развитие идеи DevOps — просто оказалось, что для исправления ситуации разделения труда между разработчиками и системными администраторами нужно выделить ещё одну деятельность/культуру/инженерию — инженерию внутренней платформы разработки (internal development platform, и помним, что платформы бывают очень разные, сегодня модно вообще любую систему называть «плафтормой»). Это верно и для разработки «железа», в жизни сегодня встречаются три основные ситуации:
-
Аутсорс завода. Plaftorm-as-a-service, инженеры платформы сдают свой завод в аренду. Более того, на этом заводе может быть ещё и свой технолог, то есть разработчикам не надо «производить на заводе», они «отдают информационную модель» («чертежи» тут в далёком прошлом) — получают или полуфабрикат, который собирают-настраивают, или даже готовое изделие, которым уже можно пользоваться. Конечно, чтобы стать «платформой», заводу приходится быть универсальным. Например, на заводах ставятся универсальные обрабатывающие центры (CNC, computer numerical control6 machines, станки с ЧПУ) и 3D-принтеры (additive manufacturing). Вот это отделение заводов от конструкторских бюро и универсализация производства — это тренд! Найти описание этого тренда можно в обзоре «Platform-based manufacturing7». Это всё может описываться как «оборудование-как-сервис» или «производство-как-сервис», но всё сводится к тому, что вместо тесной связи конструкторского бюро с заводом заказ «размещается где-то в Китае», а вместо «тесной связи» работают цифровые стандарты. Платформа — это прежде всего стандартизация интерфейса её использования. В программировании всё то же самое: где-то «в облаках» размещаются платформы, которыми можно воспользоваться, их много, совершенно неважно кто их поставщик. В итоге мы имеем производственную сеть (manufacturing network). Проблемы? Их много. Например, государство может решить, что ваше предприятие не должно пользоваться чужими платформами, или владелец платформы решил, что вам нельзя пользоваться его платформой. Но эти проблемы решаются, тренд неостановим. Вы просто перейдёте с самой выгодной платформы на чуть менее выгодную, это не займёт много времени (хотя придётся помучаться немного, vendor lock-in8 реальная проблема) — там будет, скорее всего, примерно тот же стандарт интерфейса, примерно те же правила пользования. Это очень удобно, когда «завод» может быть даже анонимным. Но, повторим, возникают специфические проблемы доверия и надёжности в такой среде.
-
Ровно обратное от предыдущего пункта: если производство раскидано по самым разным платформам, то вы можете оказаться в ситуации непрерывного ведения переговоров по поводу размещения заказов, логистики, срывов сроков поставок, трудности проведения изменений и согласований характеристик. Поэтому вы делаете собственное производство, отдавая на аутсорс для изготовления минимум. И получаете резкое ускорение: внутрифирменное согласование обычно много быстрее, чем внешнее. Ровно это произошло в космической промышленности: крупные контракторы NASA выполняли как один из приоритетов задачу раскидывания космических заказов по огромному числу мелких производств. И всё там поэтому было медленно, ненадёжно, дорого. SpaceX поменяла правила игры: основное по проектированию ракет и их производству собрала у себя, внутри фирмы. Минимум аутсорсинга. Только внутренняя платформа разработки. И дальше было продемонстрировано, что это в разы и разы быстрее, чем раскидывание заказов по «производственной сети».
-
Внутренняя платформа разработки, чаще всего обсуждается в рамках движения DevOps. Попытка универсализации и стандартизации, как в первом варианте «аутсорс завода», но «производственная сеть» создаётся на собственных мощностях, «внутренняя/internal платформа», а не «внешняя».
Все эти тренды работают одновременно. Иногда даже обсуждаются «стратегические приёмы», например, чтобы поддерживать конкурентоспособность своей платформы, её заставляют продавать часть услуг для чужого аутсорса — и если не удаётся, то считают, что «неконкурентоспособна». Понятно, что у всех подобных инициатив есть и горячие сторонники, и горячие противники. Гибридных форм тоже более чем достаточно, но в итоге бал правит некоторое количество общих идей, которые выигрывают независимо от того, как это раскладывается по фирмам:
-
Инструментарий изготовления чего бы то ни было рассматривается не изолированно друг от друга, а как составная часть «производственной платформы» (внутренней или внешней — это уже неважно).
-
Платформа должна быть удобна для использования разработчиками, клиентами и пользователями платформы считают разработчиков, а не пользователей конечной произведённой продукции. То есть пользователей произведённой системы и пользователей производственной системы не путают. Создатель системы и создаваемая система — они отдельно! У каждой есть свои клиенты. В некоторых случаях разработчики — «внутренние клиенты», но это не меняет к ним отношения.
-
Инженер платформы отвечает за закупку оборудования, логистику и общую готовность платформы к работе. Но он не отвечает за то, что на этой платформе производится. За это отвечают разработчики.
-
А кто же всё-таки производит? Вопрос сегодня сложный, но чаще всего ответ — «никто», производит сама платформа. Завод сегодня — это завод-автомат. Даже если там есть какие-то работники внутри, они не считаются «работниками, с которыми можно договариваться о производстве». Нет, они «части машины», интерфейса к ним нет (платформа — это модуль, видимость того, что происходит внутри, ограничена).
-
Платформа представляет разработчикам стандартизированный интерфейс, стандартизированное управление.
Вот учебник «The DevOps Handbook» (второе издание, 2021), в котором рассказывается о практике DevOps как совокупности технических и организационных решений:
Основной целью метода DevOps (помним, что «инженерия платформы» — это просто развитие идеи DevOps, это не отдельное течение, так что обсуждение касается и инженерии платформы) заявляется поддержка постоянного введения в эксплуатацию (continuous delivery). По факту же это существенно модифицированный метод «управления жизненным циклом», преобразованный согласно идеям agile для ситуации эволюционной/непрерывной разработки, эволюционного/непрерывного принятия архитектурных решений и непрерывного (тут реже говорят «эволюционного») введения в эксплуатацию. Отсутствует собственно «жизненный цикл» с его стадиями, система инкрементально развивается, а не замысливается-проектируется-изготавливается-испытывается-вводится в эксплуатацию-эксплуатируется. «Жизненный цикл» остался только там, где в головах по-прежнему идея «водопада». Например, в госпроектах: там вся система финансирования выстроена ровно под это, «что заказали, то и получили».
Заметьте, что мы тут разделяем «что в жизни» и «как мы описываем жизнь». Сам инженерный процесс может быть устроен вполне по-современному, гибко. Но вот обсуждение с менеджерами и заказчиками будет всё равно «водопадным», то есть будут и требования, и разовые (а не постоянные) инженерные обоснования. Проблема тут в том, что описание жизни оказывается оторванным от собственно жизни: люди работают не так, как они это описывают. Мы тут даже не будем обсуждать, к чему такое приводит. Скажем, вы ремонтируете транзисторное устройство, а у вас принципиальная схема его нарисована с радиолампами, да и все менеджеры говорят про радиолампы, а про транзисторы можно говорить где угодно, только не на официальных совещаниях. Будет ли работать транзисторное устройство? Да, будет, но «вопреки»: не спрашивайте про сроки, стоимость, нервы всех участников проекта.
Инженерная жизнь в 21 веке существенно поменялась (в 2003 году вышел agile manifesto и появился в Гугле SRE, первая конференция по DevOps прошла в 2009 году), сегодня DevOps и инженерия платформы — это «метод по умолчанию» в программной инженерии, и потихоньку распространяется на другие виды инженерии. Суть производства поменялась: вместо выпуска одной хорошо отлаженной системы надо уметь выпускать много-много версий хорошо отлаженной системы, в каждой из которых есть много мелких и крупных изменений — при этом от всех этих многочисленных изменений качество продукта не падает, а растёт.
А ещё инженерия производственной платформы очень проблематична в части описания разделения труда в инженерии:
-
Традиционно DevOps и тем самым инженеров платформы включали и обсуждали как входящих в команду инженеров-разработчиков (в этом-то и был смысл затеи! Вернуть функции и людей Ops в функции и состав Dev!). Потом оказалось, что жизнь поменялась, и у нас scaled agile, поэтому DevOps и роль «инженер внутренней платформы разработки» ушёл из разработчиков-в-командах на уровень проекта — туда, где архитектор и визионер. Но по-прежнему это относилось к «инженерам в целом». Менеджеры рулили «инженерами», которые разрабатывали систему, в инженерах были разработчики, архитекторы, визионеры, инженеры платформы.
-
Но если обратить внимание, что продуктом инженеров платформы является платформа, которая предоставляет сервис разработчикам, среди которых в том числе и архитектор (платформа нужна для того, чтобы там выполнялись fitness functions), и визионер (который отслеживает выдачу фич), то становится понятно, что «инженер системы» и «инженер завода» — это разные инженеры, и с «заводом» (платформой) можно разворачивать полноценную инженерию. Инженер платформы (роль) тем самым включает визионера, архитектора, несколько команд разработчиков (функциональные проектировщики, проектировщики, технологи, операторы) и даже инженера внутренней платформы разработки внутренней платформы разработки! Действительно, в программной инженерии это рассматривать как-то не очень наглядно (ну, «программисты и программисты», с точки зрения менеджмента), но если взять инженеров ракеты и инженеров ракетного завода, то это же оно и есть! При этом ракетный завод сделать существенно трудней, чем ракету! Автомобильный завод сделать существенно трудней, чем автомобиль! Элон Маск недаром говорил, что «выпустить прототип лучшего в мире электромобиля — это очень легко, но вот наладить массовое производство с конкурентоспособной ценой — вот это трудно». Так что инженеров платформы можно и не рассматривать как входящих в команду инженеров проекта целевой системы, можно считать их инженерами совсем другого проекта.
А как же с общностью идеи инженерии платформы для систем самой разной природы? Всё в порядке:
-
В фирме, которая выпускает мастерство (например, университет) собственно производство представляет собой деканат. Вот инженеры платформы — они разрабатывают, производят, настраивают и являются операторами деканата (конечно, чаще всего сотрудники деканата совмещают в себе роли и инженеров деканата (создатели деканата), и работников деканата (частей созданного деканата). Подробней про это в руководстве по инженерии личности, которое рассказывает о методах инженерии мастерства.
-
В менеджменте какого-то предприятия, инженеры платформы — это создатели «администрации». Администрация — это и есть «внутренняя производственная платформа» для коллектива, то есть бухгалтерия, заведование хозяйством, «кадры», канцелярия, и так далее. Подробней про это в руководстве по системному менеджменту, которое рассказывает об инженерии предприятия.
Составляющие DevOps
Современный метод непрерывного ввода в эксплуатацию (DevOps) отличают от методов управления работами (work management, operations management). Администрирование функционирования/работы (operations) целевой системы — DevOps, а вот администрирование функционирования/работы (operations, works) предприятия — это операционный менеджмент. Их различение уже рассматривалось в руководстве по методологии.
Несмотря на то, что сегодня практически везде переходят на DevOps, во многих и многих «железных» проектах остаётся ещё старинный вариант управления жизненным циклом, ибо не столько даже инженеры, но менеджеры продолжают считать, что текущий такт разработки — последний, да и «водопад назад не течёт!». Это и есть «опыт»: двадцатилетний опыт чаще всего — однолетний опыт двадцатилетней давности, повторённый двадцать раз. Бойтесь своего опыта! Чем больше лет вашему опыту, тем подозрительней!
Как специалисты DevOps любят указать, что «наши методы подойдут и для организации водопадной разработки, просто используйте их не все, применяйте творчески», так и специалисты по управлению жизненным циклом любят заметить, что «для agile у нас тоже отлично всё работает». После этого возникают довольно причудливые сочетания самых разных методов организации работы в проекте. Надо не обращать внимания на названия, которые используют, а обращать внимание на объяснительные теории, на которых базируются используемые в проекте методы, проверять обоснование этих методов. Упоминавшаяся уже книга «Accelerate» как раз подробно об этих исследованиях разных вариантов организации выпуска продуктов рассказывает. Исследования обычно убедительно показывают, что интуитивные представления о том, как надо работать, непродуктивны. Лучшие методы работы — контринтуитивны. Не поленитесь-таки прочесть «Accelerate», убедиться, что ваша интуиция не противоречит реальности.
DevOps — это метод выполнения в проекте правильных работ по правильным методам с правильным инструментарием. Какие «рабочие процессы»/«методы работы»/практики входят в составляющие DevOps?
Управление конфигурацией (configuration management). Работы проекта будут выполняться со всеми появляющимися в ходе проекта конфигурационными единицами (configuration item)9, и ни одна из этих конфигурационных единиц при этом не будет забыта, потеряна, перепутана. Вот это «не забыть, не потерять, не перепутать, для этого в проекте надо всё уникально именовать, знать, где что лежит и в каком состоянии находится» выполняется методом управления конфигурацией (configuration management)10. Конфигурация системы — это набор конфигурационных единиц, представляющих собой систему в какой-то заданный момент времени (по умолчанию — текущий момент). Конфигурация системы — это сама система, не её описание! А что с описанием? Можно говорить о конфигурации описания, из чего состоит в какой-то момент времени описание. Это означает, что мы знаем, что вчера в системе был модуль А с серийным номером 234, а сегодня это модуль Б с серийным номером 345. Мы знаем, что в описании системы вчера была принципиальная схема версии 4, а сегодня уже там версия 5. И мы не путаем разные конфигурации — вчерашнюю и сегодняшнюю. Когда система собрана из частей, которые не соответствуют друг другу — это конфигурационная коллизия, ) считается большой бедой проекта.
Выбор и непрерывное развитие/адаптация «методологии разработки»/«инженерного процесса» (раньше — «определение вида/модели жизненного цикла», причём без непрерывного развития, а «раз — и навсегда»). Этот метод был подробно разобран в руководстве по методологии, а в нашем руководстве по системной инженерии как нормативной дисциплине говорится о том, что вариант «методологии разработки»/«инженерного процесса» нужно выбрать явно, адаптировать, развивать в ходе всего проекта, организовывать работы всех участников проекта в соответствии с ней. В разработке софта сегодня предпочитают разные варианты гибкой разработки/agile, в разработке киберфизических систем на сегодня до сих пор можно встретить разные старинные варианты вроде V-модели, но уже понимается неизбежность принятия гибких методов разработки «железа». В инженерии предприятия (менеджменте) сегодня говорят о непрерывном стратегировании, о циклах непрерывного совершенствования. Во многих других сферах (например, инженерии личности, в сфере медицины) на эту тему особо не разговаривают, и этот «неразговор» — большая ошибка. Даже если инженерный процесс де-факто формулируется как «не интересоваться, какие у нас основные альфы, как мы планируем и отслеживаем изменения основных альф», это нужно проговорить в проекте явно, выбор даже отсутствия обговорённой методологии инженерного процесса должен быть сделан явно. Если вы начинаете новую разработку, то не факт, что вам удастся сразу реализовать современное разделение труда и преодолеть ограничения мышления об однократном прохождении «водопадного» жизненного цикла. Конечно, сам инженерный процесс по факту будет идти как описано у нас в руководстве (догадки как гипотезы, много итераций по инкрементам), но всё-таки содержать много лишнего (типа обязательной разработки требований и связанного с этим «испорченного телефона», подготовки отчётности, которую никто не читает), в нём наоборот, не будет многих методов DevOps и инженерии внутренней платформы разработки как выделенной инженерной работы.
Людей в проекте нужно будет научить выбранному методу работы в целом, выбранному инженерному процессу. Если не научить, то каждый будет работать, как считает нужным — в результате будет огромное количество лишней работы, переделок, а часть необходимой работы не будет выполнена — о ней никто не вспомнит!
Регламентация: для выбранного метода инженерной работы («инженерного процесса») в целом надо выбрать его составляющие прикладные методы, подходящие для природы систем в вашем проекте, начать организовывать работников на их выполнение — и продолжать это в ходе всего проекта. Этот выбор метода делают инженеры, но вот затем сделать так, чтобы люди и инструменты ему следовали — это часть задачи менеджеров, оргразвитие. Получается, что оргразвитие в существенной мере (содержательная часть регламентов работы, предписанный метод работы) определяется не менеджерами, а инженерами. Не знаешь, какие методы нужны для работы — не можешь организовать на их выполнение людей и AI с необходимыми инструментами.
Стандарты, регламенты работ, нормативно-справочная информация, чеклисты — это всё тут. Чем больше это похоже на бюрократическую заводскую разработку по военным проектам (где главное — это не результат, а кто будет сидеть в тюрьме за ошибки, «сбор улик»), или на медицину (где врач три четверти времени заполняет бумажки, подтверждающие, что он следует процессу), или на любую другую зарегулированную насмерть государством отрасль (атомная энергетика, строительство), тем менее эффективна будет работа в проекте, не lean, не элегантна, много лишней работы. Но если работ регламентации не делать — то наладить коллективную проектную работу не удастся, каждая роль будет работать «каким-то», а не нужным для проекта методом, результаты работы всех ролей будут «какими-то», а не нужными, часть работ по важным методам окажутся пропущенными (например, часто пропускают работы по инженерным обоснованиям).
В этом месте излишнего бюрократического увлечения регламентацией часто получают какие-нибудь «службы качества», занятые тем, что пишут регламенты работы (например, следуют стандартам серии ISO 9000 в написании «процессных регламентов»): вроде как если есть жёсткое следование регламентам, это должно поднять качество. Но нет, эксперименты показывают, что стандарты эти не влияют на качество. Поэтому сейчас принято «покупать сертификацию», использовать эти стандарты для того, чтобы предъявлять как формальный аргумент «заботы о качестве» (полностью эквивалентно покупке вузовского диплома: этот формальный документ иногда важен, но по факту никогда не свидетельствует о реальном мастерстве). Надо запомнить, что в этой регламентационной работе надо попасть в goldilocks — не переборщить, но и не пустить работу в части методов на самотёк, не отдать всё в «устное согласование» — и помним, что содержание работ обычно идёт от инженеров, но вот бюрократические навороты обычно идут от менеджеров, менеджеров надо сдерживать в их бюрократических аппетитах. Это и есть принцип lean/элегантности, минимально необходимая работа делается, но не более, и не менее.
Вот книга Donald Reinertsen, «The Principles of Product Development Flow: Second Generation Lean Product Development» (2009), она посвящена операционному управлению для элегантности в работах, то есть управление минимальностью работ в проекте.
В этой книге вводится принцип «E6: The U-Curve Principle: Important trade-offs are likely to have U-curve optimizations». Этот принцип гласит, что если у вас есть две переменные, влияющие на производительность труда в разные стороны, то результат чаще всего будет U-образной кривой (или инвертированной U), при этом не требуется очень большая точность — ибо в этих кривых нет ярко выраженных пиков.
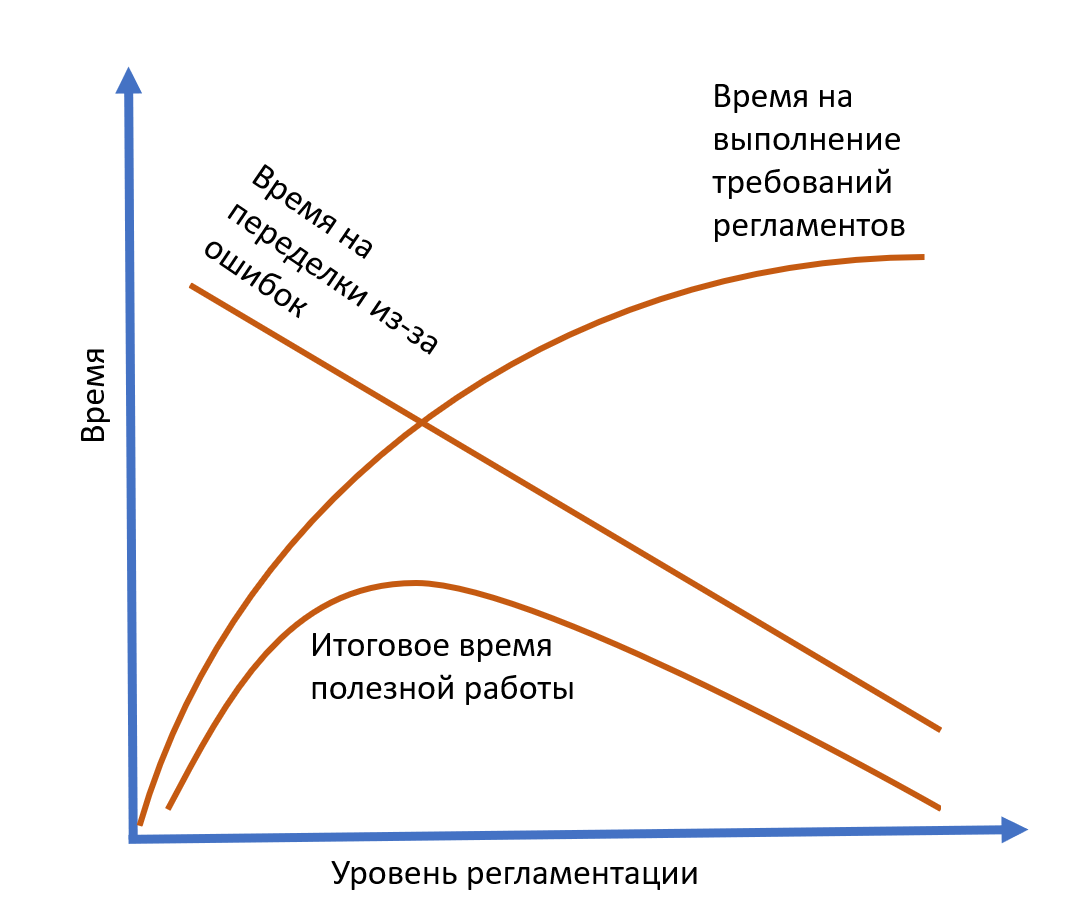
При отсутствии регламентации («делай, что хочешь»), производительность мала, силы тратятся на бесчисленные переделки. При оптимальной регламентации (организованная работа по методу) скорость оптимальна. При уровне регламентации выше оптимума будет много лишних действий на выполнение ненужных уже регламентов, и уменьшение ошибок в выполнении работ уже не компенсирует потери времени на выполнение лишних регламентированных действий. И это даже в ситуации, когда лишние действия действительно снижают число ошибок! В этом весь принцип элегантности: делать и регламентировать только то, что нужно, ничего лишнего! Элегантность даёт высокую скорость работ за счёт того, что не нужно выполнять лишние работы.
Опять подчеркнём: метод, по которому работать, задают инженеры, ибо они знают, что надо делать — а менеджеры (операционные менеджеры) должны проследить, чтобы следование методу было, регламентация работ была, но они не были чрезмерными. Итальянская забастовка (work-to-rule)11 — это «работа по всем правилам», это правый край диаграммы. Не организуйте саму работу как итальянскую забастовку! При этом, конечно, если работу не организовывать, правил нет, методы не заданы и их выполнение не отслеживается (например, по чеклистам), то это тоже забастовка — левый край диаграммы.
Качество продукта обеспечивается не строгим следованием письменной процедуре, а быстрым внесением изменений в процедуры, в дизайн продукта, непрерывным улучшением, а не дословным выполнением стремительно устаревающих жёстких инструкций. Иногда этот метод совмещают с методом compliance (проверка соответствия стандартам, требуемым законодательством), но compliance больше соответствуют методам управления жизненным циклом — проверка идёт один раз, и далее считается, что «ничего не меняется, соответствие есть». Действительно, это очень дорого — проводить независимое сертифицирование с участием представителей надзорных органов каждый раз, когда меняется конструкция, а она меняется часто. Выход тут всё-таки в прогоне полных тестов для каждой модификации целевой системы, чтобы убедиться этому соответствию — но также в тесты входят и fitness functions, и тесты защиты, и функциональные тесты. Поскольку каждая модель автомобиля Tesla или ракеты SpaceX имеет модификации в силу «полного agile» на производстве, то принята стратегия полных испытаний/тестирования каждого экземпляра — а удешевление тут идёт за счёт автоматизации тестов.
Чеклисты по сути — те же проверки, что работы выполнены, состояние системы достигнуто. Но они проверяют не только конечное, но и промежуточное состояние. Прохождение чеклистов, конечно, тоже надо автоматизировать. Но «ручные» чеклисты имеют встроенный в себя механизм удержания работы по документированию выполнения методов: по ним проверяется не абсолютно всё, а только самое важное (и это отдельно обсуждалось в руководстве по методологии и в книге Atul Gawande «The Checklist Manifesto»).
Чеклисты задаются регламентацией (пишутся регламенты и шаблоны чеклистов для отслеживания состояния важных объектов проекта, а агенты — люди и AI — обучаются выполнять метод из регламента и заполнять чеклисты по ходу его выполнения). Состояние важных объектов отслеживается в рамках учёта конфигурации. «Чтобы заполнить что-нибудь ненужное, надо сначала задать шаблон ненужного»: регламентация предшествует конфигурационному учёту.
Почему мы вдруг отвлеклись и заинтересовались производительностью труда, операционным менеджментом, регламентацией, мы же вроде обсуждаем DevOps — работу инженеров? Ops из DevOps — это operations, ими занимаются операторы/администраторы, которые вроде обязаны в platform engineering воспринимать разработчиков как клиентов (в фирме — это администраторы, которые обязаны воспринимать сотрудников фирмы как клиентов, в вузах — это деканаты). Но на деле разработчики оказываются от них крайне зависимыми, избежать выполнения требований (да, тут — «требования», деонтический аспект и никаких отмен, «раз и навсегда установлено») администраторов нельзя, и если требования неоптимальны, то вы получаете итальянскую забастовку сотрудников — и эта забастовка против воли сотрудников, она организована менеджерами, которые просто не отследили лишние требования по организации работы.
Что тут говорит литература по методам инженерии платформы? «Надо найти оптимальный баланс между жёстким механически работающим конвейером и возможностью вносить изменения в эту жёсткую механистичность» — проблема понимается, но решение проблемы отдаётся в конкретные проекты, общих рекомендаций тут нет.
Конфигурационный/операционный учёт самих «предметов работы»/«рабочих продуктов»/артефактов и документированных их описаний. Эти описания часто в инженерии называют «данными жизненного цикла»: всё что угодно, документированное в разные моменты времени проекта, отсюда и отсылка к «жизненному циклу» в попытках сказать «в ходе всего проекта», то есть в ходе создания и развития системы, включая эксплуатацию. Это именно операционный/менеджерский учёт, часть не столько инженерии, сколько менеджмента, ибо учётные единицы тут рассматриваются не содержательно, а чисто логистически: «взял физические объекты и данные на хранение, учёл и сохранил, ничего не потерял и не добавил, не исказил, нашёл по запросу и передал кому надо — но что там внутри, неважно». Иногда операционный учёт считают управлением конфигурацией — но нет, это только часть управления конфигурацией (учесть/документировать — это ещё не управлять! Учесть/документировать направление движения автомобиля — это ещё не рулить/управлять!).
В DevOps тоже рассматривают версионирование (для описаний) и управление конфигурацией (для целевой системы), на этом основан метод непрерывной интеграции (continuous integration, в любой момент времени есть готовый целостный вариант системы). Часть этого метода — магистральная разработка/trunk-based development. Управление изменениями (change management, когда инженеры превращаются в аналитиков и «готовят предложения: запросы на изменения», а кто-то внешний потом их рассматривает и либо принимает, либо нет) в виде независимого принятия решений какой-нибудь «комиссией по изменениям» экспериментально было показано, что не работает (см. подробности в книге «Accelerate»).
Это очень контринтуитивно, но команда сама принимает решение, что ей добавлять в общий продукт, какие вносить изменения. Нет долгоживущей версии baseline/базиса (что считалось ключевым в управлении жизненным циклом 20 века), нет трудной для разработчиков жёстко регламентированной и крайне медленной процедуры внесения изменений в этот базис. Более того, одновременно в работе (например, при A|B-тестировании) могут находиться несколько версий системы, все они «главные», и все они экспериментальные/рабочие. В любой момент жизни системы она рассматривается не как окончательная конфигурация на базе окончательной версии описаний системы, полученных из разработки, но как «текущая», которая будет меняться много раз в день. Поиск конфигурационных коллизий, «разваленной/broken конфигурации» — как раз в конфигурационном учёте.
Логистика рабочих продуктов и документов/данных с акцентом на передачу результатов очередным исполнителям в инженерном процессе, иногда говорят об «управлении выпуском», если «очередные исполнители» — это пользователи. Совместно с конфигурационным учётом и учётом изменений логистика оставляет в проекте коллективное понимание того, что и где находится в каждый момент времени, кем и когда изменяется, каковы результаты изменения. Тут и физическая логистика (всякие конвейеры и склады, трубопроводы и прочий транспорт), и «логистика данных». Цель: каждый важный объект в проекте должен быть предоставлен тем, кому он нужен для работы в тот момент, когда он нужен. В случае физической логистики этим занимается операционный менеджмент (под разными названиями, например supply chain management, enterprise resource management), в случае логистики данных говорят про «управление информацией»/«интеграции данных жизненного цикла»/«цифровой нити».
Инженерные обоснования и связанные с ними испытания/тестирование (включая функциональные тесты, архитектурные fitness functions, тесты защиты/security, а также мониторинг в ходе эксплуатации) рассматриваются в DevOps и инженерии платформы как составные части метода, требующие какой-то поддержки специализированными инструментами (испытательные стенды, сигнализация, разворачивание цифровых теней и двойников). DevOps инженеры (инженеры платформы) учитывают «сдвиг влево» у разработчиков и обеспечивают надлежащее выполнение тестов по защите и использование методов защиты разработчиками. Иногда даже пишут DevSecOps, чтобы отразить необходимость превращения разработки в учитывающую необходимость защиты и тестирования защиты в ходе всей разработки, «культуру безопасности» (на самом деле — «культуру защиты», ибо «безопасность» тут safety, «наша система никому не причинит вреда», а «защита» — это security, «никто не причинит вред нашей системе»).
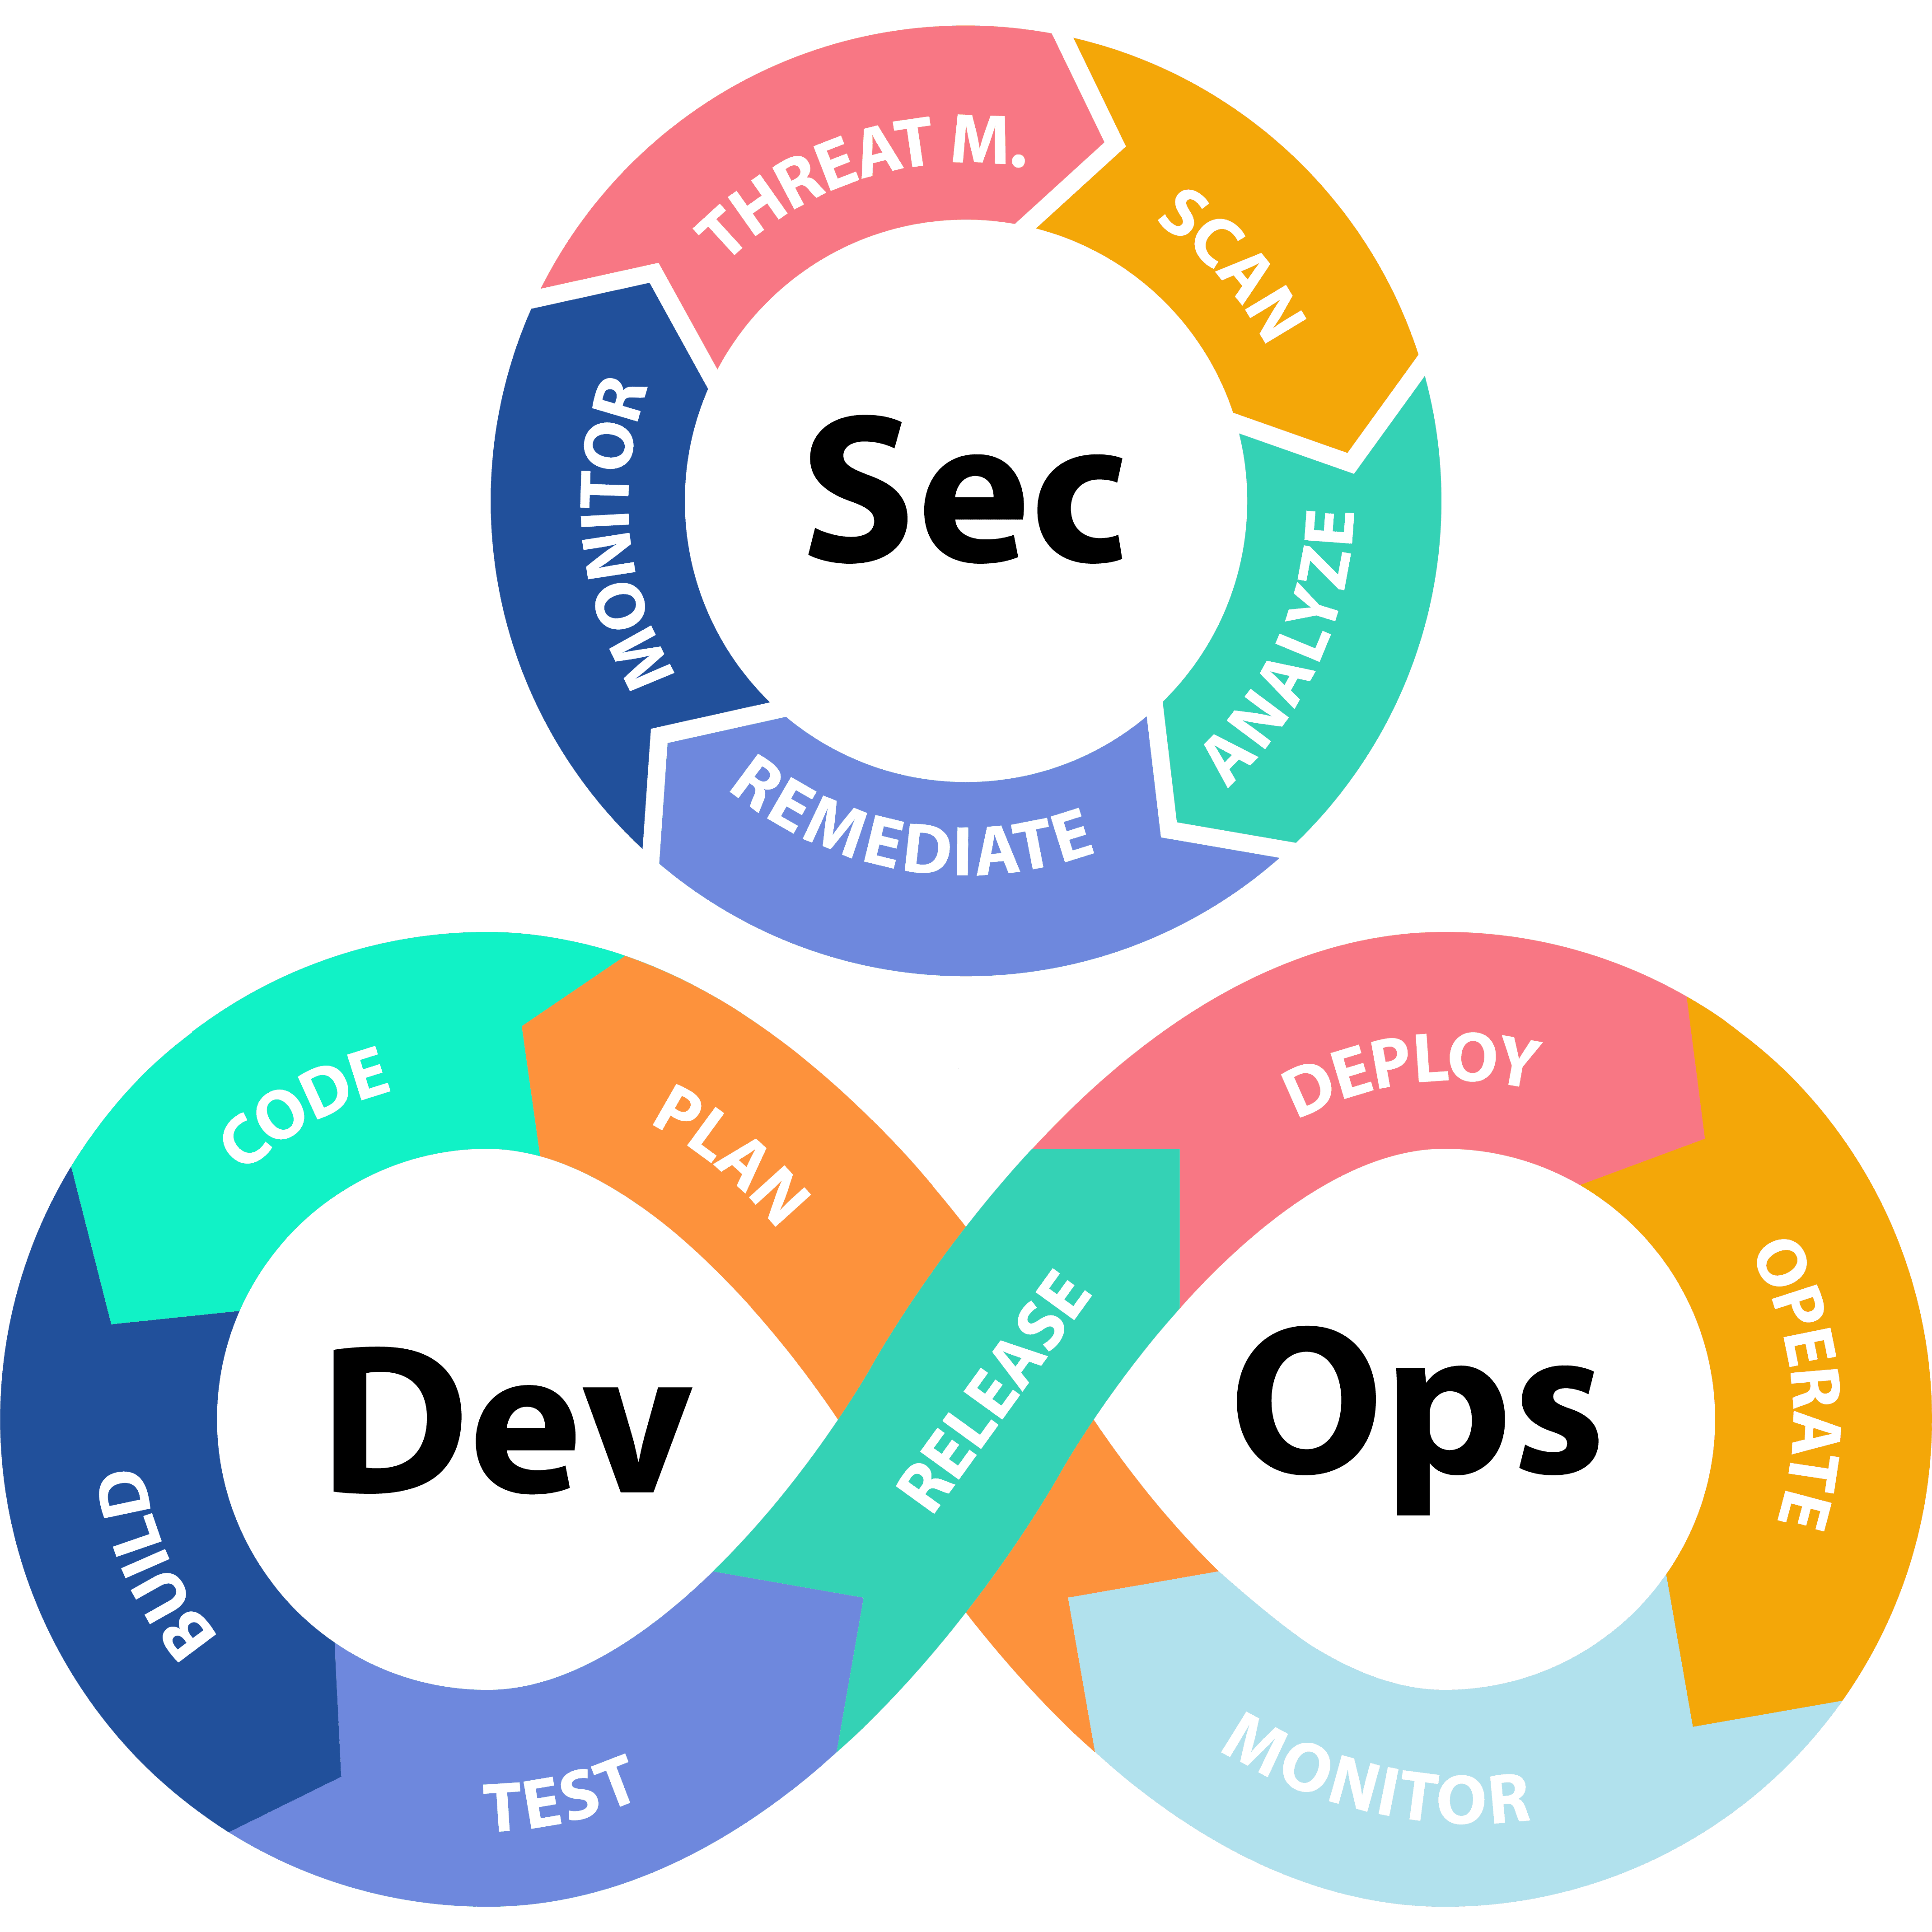
Тут тоже разночтения: DevSecOps как метод работы защитников «такой же, как у DevOps» против DevSecOps как трансформацию DevOps для учёта «сдвига влево» не только тестирования, но и мероприятий по защите. Иногда поэтому «цикл Sec» изображают рядом с «циклом DevOps», а иногда просто замечают, что «цикл DevOps сегодня — он включает Sec, как важную часть». Вот изображение из текста, где говорится про «DevSecOps как учёт Sec в DevOps», но вводится отдельно роль «безопасника как DevSecOps», действующего «рядом», причём в тексте поминается ещё и старинный SDLC (software development lifecycle)12:
Так что смотрите на содержание методов, а не на названия: у многих людей в голове «модные слова», но вот отвечают ли этим «модные идеи» — это не факт. Проверяйте!
В современном DevOps ещё и учитывается работа архитекторов с их архитектурными тестами (fitness functions): как минимум, DevOps-инженеры предоставляют компьютерную и программную инфраструктуру для разворачивания архитектурных фреймворков, предписанных архитекторами, и эксплуатируют их, и они же ещё они обеспечивают архитектурный мониторинг, проверяют выполнение fit functions. Тут даже не приходится говорить о «сдвиге влево» архитектурной работы, это все понимают. И нет специального имени для DevArhOps13, это будет просто DevOps.
Управление конфигурацией
DevOps, инженерия внутренней платформы разработки, SRE — это самые разные имена метода эволюционной (иногда и не очень эволюционной, там будет «управление жизненным циклом») инженерии производственной платформы как разработки и развития внутреннего «завода», а затем поддержания его сервисов для разработчиков.
Но это не все имена, есть и много других «синонимов с нюансами», каждый из которых имеет свои оттенки смысла и используется в инженерных процессах для систем разной природы. Так, часто инженерия инженерной платформы приходит под именем «управление конфигурацией и изменениями», хотя и с нюансами:
-
Ничего не говорится о собственно платформе как наборе инструментов.
-
Ничего не говорится о явном выборе вида инженерного процесса, поэтому не обсуждается непрерывность изменений.
-
Ничего не говорится об испытаниях (хотя в управление конфигурацией и включают проверку того, что конфигурация системы соответствует конфигурации из проектной документации, «то, что сделали — это то, что описывали, что планировали»).
Как видим, это урезанные практики DevOps, но в машиностроении вы чаще встретите именно этот термин, наряду с «жизненным циклом изделия» как названием для инженерного процесса. Иногда даже говорят об «управлении инженерной документацией», это уж совсем анахронизм, но в государственных проектах это так, а также это может встречаться в сильно зарегулированных инженерных сферах — строительстве, авиации. Часто при разговоре об «управлении инженерной документацией» теряется акцент на том, что конфигурация системы — это сами части системы в физическом мире, а документация с описаниями системы важна, но по большому счёту их конфигурация вторична к конфигурации системы, она нужна только для того, чтобы создавать и эксплуатировать само воплощение в физическом мире. Ну и сама идея непрерывной разработки, непрерывной интеграции, непрерывного ввода в эксплуатацию при этом теряется абсолютно, ибо акцент только на описания, интеграция/сборка, разворачивание с наладкой и ввод в эксплуатацию отсутствуют.
Если отсутствует управление конфигурацией (в том числе конфигурационный учёт — документирование состояния важных объектов проекта, прежде всего целевой системы и её документации, состояния систем графа создателей), то в проекте появляется огромное количество так называемых «конфигурационных коллизий»: когда одна часть системы и/или описание системы не соответствует другой. Вот пример такой коллизии: «в информационной модели, которую отдали строителям, сплошная стена. В информационной модели, которую отдали монтажникам, через стену в этом месте идёт трубопровод. Что делать — разбивать свежепостроенную стену и пропускать трубопровод в этом месте, или перепроектировать трубопровод, но стену не трогать?!». Или «на совещании в середине прошлого месяца мы приняли решение делать ракету диаметром 5 метров. А вы продолжаете после этого целый месяц проектировать ракету диаметром 4.5 метров. Как это могло произойти?!». Вот традиционный пример из программной инженерии: «Ваше приложение не будет работать в нашей операционной системе, ибо оно пользуется новым фреймворком, который наша старая версия операционной системы не поддерживает. Нет, мы не планируем обновлять версию нашей операционной системы, это вы сделайте что-нибудь со своим приложением».
Конфигурационные коллизии обходятся проекту очень дорого, они требуют переделывать (re-work) большие куски проектов, часто по нескольку раз, это не lean, не элегантно. Советы типа талебовского «не будь лохом», традиционные рекомендации «не надейся на авось», «наведите порядок в проекте», пожелания «не прощёлкивать важные события» — они все чаще всего про недопущение конфигурационных коллизий, то есть про постановку метода управления конфигурацией и изменениями.
Иногда конфигурационными коллизиями считают неизбежные для систем конфликты между системными уровнями (один уровень требует скорости и лёгкости, другой уровень готов выдать мощность для скорости, но за счёт тяжести — и это могут считать «несоответствиями в конфигурации»). Правомерно ли так считать? Это вопрос открытый. Мы считаем, что если конструкцией достигнуто субоптимальное проектное «расчётное» решение в рамках достижения какого-то квазиустойчивого/неустроенного состояния (frustration, как это обсуждалось в руководстве по системному мышлению), то это не конфигурационная коллизия.
Конфигурационная коллизия — это когда противоречия настолько сильно проявляются, что система становится неуспешна. Скажем, актуальная целевая система при заявленной «разовой водопадной разработке с однократным вводом в эксплуатацию» не соответствует документированным требованиям к этой системе: хотели сделать систему быстрой, поставили тяжёлый аккумулятор, и удовлетворили требованию скорости, но не требованию к массе системы, требуются ещё итерации в разработке, но их не предусмотрено ни одним документом, финансирование поэтому кончилось, проект окончен, система так и осталась неуспешной.
Часто в управлении конфигурацией, которая унаследовала идею «требований» под развалом/breaking конфигурации (терминология тут может отличаться, например, будут говорить о misconfiguration) ещё понимают и тройное соответствие: конфигурации системы, конфигурации описаний и конфигурации требований! Например, так принято в атомной энергетике по до сих пор действующему документу 2003 года (расцвет моды на инженерию требований) «Configuration management in nuclear power plants»14:
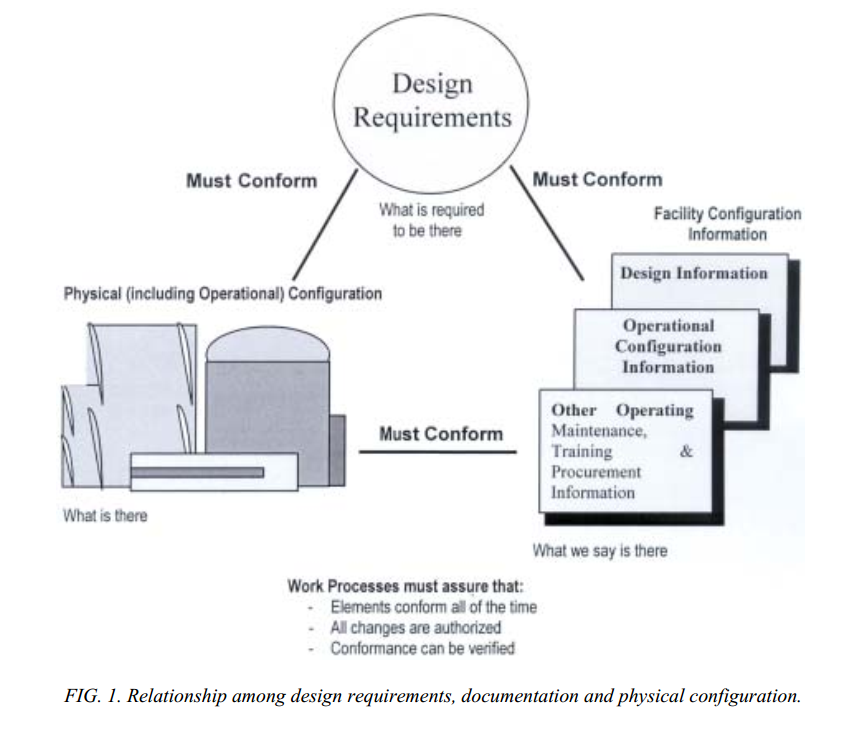
В этом документе также сказано, что в среднем 25% аварий, зарегистрированных в системе отчётности об авариях атомных станций, могли быть вызваны ошибками в конфигурации или недостаточностью в управлении конфигурации. Как о таком думают сейчас? Описания должны быть версионированы (что должна делать система — это тоже ведь её описание, а «требований» — нет), конфигурация — это физическая конфигурация, хотя иногда могут говорить и о конфигурации описаний как набору версий, соответствующей конфигурации системы. Надо внимательно смотреть по смыслу, что говорит та или иная терминология. Нельзя опираться на «словарные значения» или «значения из стандартов», в каждом проекте вы обнаружите какие-то особенности.
Основные положения управления конфигурацией на примере бумажного документооборота (нет современных IT-решений типа «облачная система получения сводных заказных спецификаций») в машиностроительном предприятии на кругозорном уровне и даже без отсылок к стандартам системного управления конфигурацией вроде стандарта именования инженерных рабочих продуктов IEC 81346 (он хорош для отражения нескольких разных способов разбиения системы на части, это обсуждалось в руководстве по системному мышлению), хорошо раскрыты в короткой (188 страниц) книге Frank Watts «Configuration Management for Senior Managers» (2015).
Существует и неофициальный русский перевод этой книги. Несмотря на упомянутые недостатки (бумажный документооборот, нет использования современных инженерных стандартов), эта книга содержит в себе довольно много опыта управления конфигурацией в традиционных машиностроительных производствах и популярно даёт представление об основных понятиях этого метода. Книга оказывается очень полезна айтишникам, которые плохо представляют себе, как устроено материальное производство в «реальном секторе», и даже не «современное производство», а вообще производство/manufacturing: сами программисты работают с кодом, который превращается в программы — и им неведомы проблемы реального производственного мира. А менеджеры вдруг начинают после этой книги понимать, о чём им пытаются иногда говорить инженеры. Много наших инженеров-менеджеров находили книгу очень полезной для развития инженерного кругозора.
Книга выделяет в управлении конфигурацией несколько составляющих методов, выпячивая понятия выпуска/release и передачи/hand-over рабочих продуктов, включая выпуск и передачу данных. Эти понятия отличаются от delivery/«пуск в эксплуатацию». По факту книга ограничивается простым «собрать все части системы без пропусков и лишних деталей и передать в комплекте кому-то вовне предприятия», не идёт и речи о тестировании, защите и безопасности, архитектурных тестах и всём прочем, о чём говорится в DevOps. Но знать эту книгу полезно, ибо вы не можете ждать десятка лет, пока все «железные» инженеры проникнутся идеями DevOps, а все DevOps проникнутся проблемами «железных инженеров».
Центральным понятием для управления конфигурацией в этой книге является выпуск/release, в том числе передача/hand-over рабочих продуктов (физических систем и их частей, а также документов с описаниями). данными жизненного цикла). Книга выделяет следующие составляющие управления конфигурацией (которое само часть инженерии производственной платформы), и обратите внимание, что в принятом в книге инженерном процессе изменения утверждаются независимыми экспертами (управление изменениями идёт как отдельный метод), это оказалось в непрерывной инженерии непродуктивно, и мы это уже отмечали:
-
Выпуск/release рабочих продуктов, в том числе hand-over данных. Это о том, как отслеживать целостность мегамодели и системы-в-железе, а также соответствие их версий друг другу. Если у вас есть три варианта архитектурного описания и четыре вполне рабочих прототипа, то как узнать, что из этого было отвергнуто, а что продолжило дорабатываться и станет когда-нибудь окончательной архитектурой и вариантом системы с этой окончательной архитектурой.
-
Управление изменениями (change management) как 1. то, что происходит с запросами на изменения (запросы иногда заканчиваются изменениями проекта/design) 2. сами изменения проекта/design (изменения иногда заканчиваются выпуском)
-
Выпуск заказных спецификаций (BOM, bill of materials). Иногда это отдельные спецификации того, что будет заказано у внешних подрядчиков (приобретение/acquisition), иногда это полный список (свод) по всему проекту: сводная заказная спецификация. Конечно, это специфика главным образом машиностроения и промышленного производства, для систем другой природы будет совсем другая терминология. Но это верно для всей обсуждаемой книги Frank Watts: нужно уметь прочесть её содержание «безмасштабно», вычленить основные мысли про управление конфигурацией, понять необходимость управления конфигурацией в самых разных проектах создания самых разных систем. В целом метод выпуска заказных спецификаций связан с выборкой из мегамодели данных проекта правильных с точки зрения организации логистики кусков (это не bounded context, не предметные области! Не функциональные описания), «нарезкой мира на передаваемые между исполнителями предметы работы», к которым дальше применяются логистические процедуры — т.е. вычленить те «рабочие продукты»/«предметы работы», которые перемещаются между инженерными организациями.
-
Управление вариантами (variant management). Часто выпускается не одна какая-то система серийно, но несколько вариантов системы, в том числе и каждый отдельный уникальный вариант (mass customization, например, каждый отдельный автомобиль или компьютер может идти в какой-то уникальной комплектации).
Книга Frank Watts даёт много интересных советов и по организации службы/подразделения управления конфигурацией на машиностроительном предприятии. Например, даётся совет подчинять службу управления конфигурацией инженерам, а не операционным менеджерам. Управление конфигурацией в его разных формах (в том числе форме инженерии платформы) сегодня — это «серая зона» системной инженерии, ибо с одной стороны речь идёт о принятии технических решений по поводу целевой системы (разнообразные информационные модели системы), а с другой стороны это управление/management, то есть решения по поводу создателя (выделяемые создателем ресурсы на проведение работ по выбранным «технарями» методам работы).
«Технари», повторимся, тут условны — в нашем курсе мы всех называем «инженерами». Инженеры эти могут быть электромеханиками, коучами, хореографами, политиками, программистами, но мы считаем их занимающимися целевой системой, её созданием и развитием как изменением мира к лучшему. А создателем (это же люди, организация!) и его ресурсами обычно занимаются менеджеры, в данном случае операционные менеджеры, логисты. Поэтому DevOps с инженерией платформы (никакого отношения к операционному менеджменту!) иногда пытаются объединять с менеджментом: вроде как у менеджмента и DevOps общая цель — построить такого создателя (систему разработки и производства), чтобы от момента запроса на новую фичу до момента её получения клиентом проходило как можно меньше времени.
«Как можно меньше времени» — это задача операционного менеджмента. Но Frank Watts всё равно даёт совет: подчиняйте людей, которые этим занимаются, инженерам (главному инженеру предприятия, который занимается методом производства и станочным парком, а не главному инженеру проекта, который занимается целевой системой, или CIO, если речь о софте, а не архитектору конкретной целевой системы), а не менеджерам. Эта «серая зона» между инженерией и менеджментом тяготеет всё-таки к инженерии, DevOps сегодня прежде всего инженеры платформы — они строят завод-автомат, это не менеджмент.
В руководстве по системному менеджменту будет рекомендация в проекте прежде всего наладить управление конфигурацией, то есть «навести порядок», чтобы избавиться от операционных коллизий. И только потом заняться операционным менеджментом как следующим необходимым методом. Ибо если работа с вашей производственной платформой порождает конфигурационные коллизии в количестве, то ускорение работы будет увеличивать число этих коллизий: вы будете просто производить больше беспорядка в единицу времени. Чтобы об этом помнить, будет дана мантра распожаризации/lean/«элегантной работы», о которой говорилось ещё и в руководстве по рациональной работе. Вот её кратчайшая форма (помним, что это фокусировка на логической последовательности процесса, но не «шаги работы»):
-
Прекратить делать ненужное (просто прекратить!). Будет меньше работы! Это инженерия прежде всего.
-
Меньше переделок за счёт управления конфигурацией системы, работ, данных и тем самым уменьшения конфигурационных коллизий! Это инженерия прежде всего, хотя и с выходом на менеджмент. Миллионы индивидуальных деталей и пять-десять операций с каждой надо отследить, ни одной не пропустить, ни одной не потерять!
-
Уменьшать время ожидания (цикл непрерывных улучшений Голдратта: убирать ограничения, но только в тщательно вычисленных местах, не везде). Это операционный менеджмент: TameFlow в проектировании, ERP15 «по Голдратту» в стройке.
-
Собственно развитие: изменение инженерных практик работы по самым долгим операциям. Но не раньше, чем пройдёте три предыдущих пункта.
Прохождение работ по этой мантре должно привести к тому, что «тушение пожаров» прекратится, пожары перестанут возникать!
Но эта мантра будет работать только тогда, когда вы сначала выберете метод инженерной работы, выдержите все споры по поводу выбора «непрерывного ввода в эксплуатацию», «водопадной» разовой приёмки-сдачи или какого-то их гибрида, а затем выберете методы управления конфигурацией и изменениями, управления информацией. И только потом вы сможете организовать людей на выполнение какого-то метода управления работами (например, TameFlow). А потом? А потом нужно будет улучшать сам продукт, улучшать сервис создателя-провайдера, улучшать методы проектирования и изготовления, сборки, разворачивания системы, введения её в эксплуатацию. Но всё это только после того, как в рамках выбранного вами инженерного процесса налажена работа по выбранному методу DevOps (включая включение в «конвейер» испытаний/тестирования, защиты, мониторинга и т.д.).
Начинать заниматься управлением конфигурацией в проекте нужно с себя:
-
Не пишешь — не думаешь. Управление конфигурацией собственных идей. Мышление письмом, на память надежды нет. Все ходы записываются, как в шахматных партиях: или конфигурацию шахматной партии держит доска, которая не может быть забыта или неправильно вспомнена, или запись шахматной партии (что много удобнее: её можно переслать через чат, а физическую шахматную доску не перешлёшь). Собранность у человека поддерживается инструментально, голым мозгом не работают, биологической памяти не верим, она сбоит!
-
Всё, что кому-то передаётся (hand-over, release), должно оставлять след во внешней по отношению к мозгу памяти, а не только запоминаться головой. Например, должны храниться входящие и исходящие письма, полуфабрикаты и готовые рабочие продукты. Если было не письмо, а разговор, то должен остаться след: minutes/заметки по содержанию разговора, issue в issue tracker, записи в case file (папку «Дело №___»). Над этим всем должен работать компьютерный поиск, чтобы не искать перебором или «я это оставлял где-то вот тут, но где это лежит сейчас, почему не видно?». Если это материальные рабочие продукты, то работаем со складским учётом: ищем по карточкам, быстро находим.
-
Все предстоящие дела (работы, а не только рабочие продукты) записываются, на память надежды нет. Используются разные системы ведения дел по мотивам старинного «Getting things done»16 или «Джедайских техник»17.
-
Все рабочие продукты имеют версии, для которых должно быть уникальное имя и время последнего изменения, а также должно быть известно кто, что, когда изменял. Нужно, чтобы можно было сравнить «что было» и «что стало» после изменения. Прошлые версии документов сохраняются «на всякий случай» (ведётся бэкпапирование).
Всё то же самое нужно делать в масштабах всего проекта, какой бы большой он ни был (и чем больше проект, тем строже это отслеживать: маленький беспорядок может нанести существенный убыток в большом проекте).
Тем самым управлять конфигурацией нужно для всех систем проекта:
-
Целевой системы и её описаний, в том числе учёт незавершённого производства (сырьё, склады). Это относительно просто и понятно, если речь идёт о программном обеспечении или даже атомной станции. Если вы занимаетесь социальной инженерией, то «конфигурация сообщества и его описаний» будет представима более тяжело, а для общества так и вообще непредставима.
-
Систем в окружении (чтобы не оказалось, что появились конфигурационные коллизии между целевой системой и системами в окружении)
-
Систем в графах создателей (организация должна быть документирована, включая органиграмму и какие оргроли играют какие оргзвенья, то есть кто и какими методами выполняет какие работы, а ещё должен вестись операционный финансовый учёт, кадровый учёт, учёт оборудования и помещений, и т.д.).
Управление конфигурацией отдают обычно инженерам, но недостаток такого организационного решения в том, что менеджеры после этого забывают о необходимости управлять конфигурацией. А ещё у менеджеров явный сдвиг обычно от работы с конфигурацией системы на работу с данными, поэтому они будут предпочитать говорить «управление информацией», имея в виду «информацию о конфигурации системы». Но нет, нам надо убеждаться, что управляем конфигурацией системы, а не только конфигурацией описания системы!
Современное управление конфигурацией включает в себя также отслеживание и работ: структуру разбиения работ/WBS (как плановую, так и фактическую) тоже ставят под управление конфигурацией, проверяя коллизии наличия работ без наличия системы, с которой ведутся работы и наоборот, наличия систем, с которыми не ведётся никаких работ. Это проще понимать при управлении проектами (up-front planning), хуже при управлении кейсами, но кейсы тоже ставят под управление конфигурацией, отслеживают — в платформе это будет специальный софт issue tracker (issue — это вопрос/проблема, которую решают работы кейса).
WBS тоже может иметь конфигурационные коллизии, если собирать его по разным подрядчикам работ, но главное — менеджеры могут этот WBS не синхронизировать по части предметов работ, ибо это «по ведомству инженеров, а WBS — это наше». Нужно отслеживать, чтобы мероприятия метода управления конфигурацией проводились как по линии целевых систем, так и по линии систем создания, и они были согласованы между собой (так, метод управления конфигурацией/информацией у инженеров должен быть согласован с методом управления данными у менеджеров, и отслеживать нужно не только их наличие, но и согласованность их друг с другом).
Управление конфигурацией требует жёсткой дисциплины. Пример правила, которое подчёркивает важность управления конфигурацией: «Если делается какая-то работа, которая не учтена в конфигурации работ — считаем, что работа не делалась». Если сотрудник что-то делает, что не учитывается в системе управления конфигурацией (скажем, работает с версиями системы, которых нет в системе управления конфигурацией), и это происходит систематически, то он может быть уволен: разбираться с неизбежными при этом конфигурационными коллизиями дороже, чем возможная польза от работы этого сотрудника. Недисциплинированные в части управления конфигурацией сотрудники безжалостно увольняются, их не терпят. Элегантная работа — это без лишней работы, но управление конфигурацией не лишняя работа, без неё число переделок из-за конфигурационных коллизий существенно тормозит все работы!
Главные понятия управления конфигурацией:
-
Конфигурация/configuration — это система, для которой известна версия каждого её модуля и общий состав этих модулей, в том числе обеспечено соответствие конфигурации документации, корректно описывающей эти (возможно, ещё будущие, пока не созданные) модули. Если какие-то части системы или документация ведут к конфигурационным коллизиям (неработоспособности из-за несогласованности версий модулей), то говорят о «разваленной/broken конфигурации»/«неверной конфигурации»/misconfiguration. Конфигурация системы — это сама система, а не её описание! Конфигурация компьютера, собранного из многочисленных комплектующих — это сам компьютер! Конфигурацию чаще всего относят к моменту эксплуатации.
-
Конфигурационная единица/configuration item — она определяется логистически как «единица передачи», «операционная единица», а не просто конструктивно. У инженеров может быть и более мелкое конструктивное деление. Так, у транзистора будут различаемые инженерами затвор, сток, исток — но конфигурационной единицей будет транзистор в целом, а не его части, которые отдельно не изготавливаются и не передаются.
-
Версия/version — это конфигурация модуля/комплектующего в каком-то его варианте (эти варианты могут меняться, версии поэтому отслеживаются и именуются). В проекте работают с какими-то версиями модулей, из которых составляют в конечном итоге конфигурацию системы. Версии больше акцентируются на времени сборки/создания из них конфигурации, а конфигурация — это понятие, более центрированное на времени эксплуатации (скажем, в софте «версии» лежат в системе управления версиями, а на компьютерах датацентра работает «конфигурация»).
-
Базис/baseline — это конфигурация, которая утверждена специальной административной процедурой, обычно включающей дополнительные проверки на отсутствие конфигурационных коллизий. Выпуск/release происходит именно базисов, а не «рабочих версий». Часто даже выделяют отдельно управление конфигурацией как поддержание целостности версий и управление изменениями как административные процедуры по внесению изменений в базисы (назначению какой-то «рабочей» версии «базисом»). Удивительно, но идея о том, что какие-то конфигурации просматриваются более тщательно, чем другие и поэтому называются базисами — не работает, есть на эту тему исследования (подробней в книге «Accelerate»), но легенды живы, особенно в машиностроении, где может быть серийный выпуск на основе какого-то базиса. Современный подход тут — continuous integration, базис поддерживается постоянно, рабочие версии мимолётны.
Понятие конфигурации и версии очень часто путаются друг с другом, но в целом признаётся, что управление конфигурацией (configuration management, реже configuration control) не сводится исключительно к управлению версиями (version control), ибо в управлении конфигурацией есть и много других стоставляющих: управление данными, выпуск/release рабочих продуктов и их передача/hand-over между исполнителями работ, и т.д.
В управление конфигурацией включают часто как отдельный важный метод именования/кодирования рабочих продуктов и их документированных описаний: назначение идентификаторов/identifiers (имён, которые однозначно позволяют отличить названный такими именами объект от других объектов проекта), обозначений/designators (имя-идентификатор, который учитывает вхождение объекта в какую-то систему в рамках какого-то из системных разбиений по какому-то аспекту, IEC 81346-1:2022 для проектов материального производства как раз стандарт для введения обозначений, которые как-то могут пониматься инженерами одинаково в самых разных проектах), иногда стандарт обозначений называют стандартом кодировки. Выбор и поддержание идентификации, обозначений/десигнаторов/кодировки — важная часть управления конфигурацией.
Моделирование: рабочие продукты, которые вы изменяли
Заполните табличку с не менее чем тремя последними рабочими продуктами, которые вы изменяли.
| Номер продукта | Имя продукта | Дата выпуска и версия продукта до изменения и после изменения: где их смотреть? | Каким методом давали имя версии? | Где хранится предыдущая, где хранится текущая версия? | Отметьте, задумывались ли вы о возможном отсутствии управления конфигурацией для этого рабочего продукта. Кто инженер DevOps, который задал метод управления конфигурацией? |
|---|---|---|---|---|---|
| 1. | |||||
| 2. | |||||
| 3. | |||||
Задания
Поставьте отметку о выполнении дел.
-
Прочтена или предлагаемая в руководстве книга по управлению конфигурацией (она о машиностроении), или любая другая литература (от 100 страниц и более, две страницы чьего-то поста в блоге будет мало!) по управлению конфигурацией в вашей привычной предметной области.
-
Прочтён стандарт IEC 81346-1:2022.
-
Опубликован пост с рецензией прочитанного материала по управлению конфигурацией и в этом посте есть выводы по отношению к практике управления конфигурацией вашего текущего проекта (какая она, что хорошо, что нужно менять).
Чеклисты в регламентации
Про чеклисты мы довольно много говорили в руководстве по методологии, но в системноинженерной работе надо уже не просто говорить — но уже делать, задействовать эти чеклисты в работе. Чеклисты появляются в ходе регламентации, то есть при нормативном описании метода работы:
-
Готовится (и непрерывно обновляется!) регламент/руководство/инструкция/стандарт, который не повторяет учебник со всеми деталями и нюансами, но содержит указание на важнейшие объекты с их графом состояний, а также операции, которые надо делать с этими объектами, чтобы проводить их по графу состояний. Это язык метаС-модели, принятой на предприятии. Это всё на понятном людям языке (понятный для машин язык тут может быть, например, автоматного программирования — машины состояний, но в общем случае — любой язык программирования. Повторим, что это мы обсуждали в руководстве по методологии). Регламент должен быть в операционном софте сотрудника, который должен его знать, а не в операционном софте его разработчика (и надо сопротивляться сведению всех регламентов в Единую Информационную Систему Всех Регламентов, это означает, что сотрудник никогда туда не заглянет и не сверит свои действия с регламентом. Если очень надо, делайте репликацию).
-
К регламенту готовится шаблон/пустографка чеклиста, представляющий собой список вопросов, положительные ответы на которые означают достижение того или иного состояния альфы. Чеклист предусматривает проверки ситуаций, когда что-нибудь может «пойти не так».
-
Для шаблона чеклиста делается чеклист, который проходится для каждого экземпляра альфы. Обычно это табличная форма в операционном софте сотрудника, выполняющего регламент. Если что можно в прохождении чеклиста автоматизировать, надо автоматизировать.
-
Сотрудник обучается прохождению регламента (выполнению работы по методу, описанному регламентом) с заполнением чеклиста (первый раз разработчик регламента и чеклиста проходит его с сотрудником).
-
Прохождение регламента ставится под надзор — чтобы не было соблазна не заполнять чеклисты, не выполнять все предписанные регламентом операции, а потом «для проверки» заполнять их в конце недели, как будто реально прошли все проверки.
-
Если чеклисты сотрудником игнорируются по причине их неважности (мы уже тут говорили, что разработчики регламентов легко загоняют фирму в ситуацию итальянской забастовки), то надо оставить в чеклистах только действительно важные вопросы. Если вопросы важны, но всё равно игнорируются сотрудником — дешевле сотрудника уволить, чем постоянно ликвидировать последствия ошибок этого сотрудника. Недисциплинированные сотрудники на работе не нужны, от них вред.
Управление работами — это управление выделением ресурсов и выполнения работ, в том числе это управление включает трекинг/отслеживание прохождения всех контрольных точек (milestones/вех) проекта/project. Контрольная точка — это момент времени, в который ожидается какое-то событие. Событие — это смена состояния какого-то важного объекта внимания в проекте (альфы). Смена состояния обычно происходит не сама собой («система сама себя не разработает и не изготовит», техноэволюция — это не биологическая эволюция), а представляет собой результат чьей-то работы по какому-то методу (если застывает бетон, то у вас работа — «подождать», намеренное отсутствие работы — это тоже работа!). Смена состояния обычно сопровождается ответом на контрольный вопрос о достижении какой-то характеристики этого состояния.
Скажем, вам нужно закрыть дверь. Контрольная точка — это момент времени, в который происходит смена состояния: «дверь открыта» на «дверь закрыта», при этом «дверь закрыта» — это характеристика целевого состояния двери. Контрольный вопрос — это закрытый (подразумевающий ответы «да», «нет», «не знаю», открытый вопрос подразумевает развёрнутый ответ, описывающий ситуацию) вопрос, в котором есть:
-
высказывание/assertion о состоянии (описание состояния), «закрыта»,
-
указание системы, для которой дана характеристика: «дверь»,
Контрольный вопрос тут «дверь закрыта?». Для закрытия двери требуется провести работу. Контрольная точка — это привязанное ко времени ожидание события закрытия двери (смены состояния «дверь открыта» на «дверь закрыта»), то есть ожидание положительного ответа на контрольный вопрос в какой-то момент времени.
Контрольная точка просто «проходится», ответ на её вопрос о достижении значения характеристики, привязанный ко времени ожидания этого события в части управления работами принимается системными и прикладными инженерами проекта, а также операционными менеджерами проекта (а часто и внешними проектными ролями, им тоже это интересно, чтобы корректировать свои планы) «для сведения». Если не проходится, то с работами было что-то не так: они или не проводились (вопрос к операционному менеджеру, проблемы с работами) или проводились, но «что-то пошло не так» (вопрос к целевому инженеру, проблемы с методом выполнения работ).
Гейт/gate — это контрольная точка, в которой принимается решение, идти ли в проекте дальше, или прекратить проект. То есть, если вовремя дверь не закрыта, и это обычная контрольная точка, то вы таки дожидаетесь работы по её закрытию, но все остальные работы проекта при этом продолжаются, или это не простая контрольная точка, а гейт — и тогда вам придётся принимать решение, дожидаться ли закрытия двери, или всё в целом в проекте настолько плохо и критично, что нужно прекратить весь проект. Скажем, в авиапроекте гейтом является получение денег по предзаказам на самолёт. Если деньги не получены в срок (контрольный вопрос: «деньги получены?», веха/milestone в качестве гейта/gate — «деньги к 23 мартобря 2022» получены?»), то закрывается весь проект создания самолёта, прекращаются все работы проекта. Общий тренд сегодня — это уменьшение числа заранее назначенных гейтов, и мониторинг прохождения вовремя контрольных точек. Да, время это нельзя спланировать, но менеджмент этого не допустит — потребует от инженеров выдать оценку времени, затем превратит бандитским приёмом «никто тебя за язык не тянул» оценку в обещание, и вот у вас появилась контрольная точка. Это плохой метод организации работы, но он более чем распространён. Если есть какие-то проблемы с прохождением вовремя контрольных точек, то принимаются самые разные меры — включая и такие, как закрытие всего проекта, то есть признание проекта неуспешным.
Всё описанное лишний раз демонстрирует, что состояние kernel альф «воплощение системы», «описание системы» и «методы работы системы», «работы системы» для каждой области интереса систем проекта (целевой системы и систем графа создателей — различных команд и коллективов) оказываются тесно переплетены, а контрольные вопросы, задаваемые в контрольных точках проекта, помогают отслеживать состояние проекта в части продвижения в достижении планируемых состояний этих альф к конкретным датам проекта.
Этих контрольных вопросов как к целевой системе и её окружению, так и к системам-создателям во всех их графах, так и к внешним проектным ролям много, они как раз и собираются в чеклисты/checklists для каждой альфы. Эти чеклисты делаются и для состояний подальф, и так на несколько уровней вниз. Каждый контрольный вопрос в этих чеклистах/«контрольных списках»/«списках контрольных вопросов» подразумевает изменение состояния альфы путём выполнения работ по каким-то методам. Эти контрольные вопросы отлично увязывают управление работами (обычно это кейс-менеджмент) и ведение инженерного процесса (какой-нибудь вариант agile, предусматривающий планирование работ на лету, исходя из инженерного анализа ситуации с альфой).
Контрольные вопросы составляются инженерами, ответственными за изменение состояния соответствующих альф в ходе регламентации: инженерами целевой системы, или инженерами систем из графа создателей (менеджерами). Это инженеры внутренней платформы разработки, инженеры DevOps. Именно инженеры знают те состояния, через которые проходит каждая альфа и подальфа и те методы работы, которые могут привести альфу из одного состояния в другое. Поэтому обязанностью системных инженеров целевой системы, а также системных инженеров систем-создателей в их графе будет:
-
адаптация набора состояний основных альф проекта создания и развития системы (целевой или «нашей» в графе создателей) к предметной области проекта
-
составление или адаптация списка контрольных вопросов к каждому состоянию
-
указание методов перевода состояний альфы, а также последовательности применения методов, оценка времени их выполнения. Это входная информация для операционного менеджера (этим операционным менеджером может быть софт issue tracker — операционному менеджеру не нужно особо вмешиваться в выполнение работ, им легко может быть и алгоритм).
-
Выделение подальф, чтобы отслеживать проект с нужной степенью детальности. Для подальф нужно тоже выделить состояния и составить списки контрольных вопросов.
Мы подробно рассматривали чеклисты в руководстве по методологии, но иногда кажется, что можно как-нибудь обойтись и без них. Нет, нельзя обойтись. В книге Атул Гаванде «Чек-лист. Как избежать глупых ошибок, ведущих к фатальным последствиям»18 нет ничего особенного, чего мы бы не разбирали в руководстве по методологии, разве что даётся множество примеров и объяснений — и после прочтения этой книги (обязательное чтение!) обычно барьер принятия всерьёз работы с чеклистами снимается:
Чеклисты отражают не буквально все-все состояния, через которые проходят альфы, но только самые важные. Все-все состояния можно легко найти в учебниках предметной области и рабочих инструкциях, а чеклист — это средство отслеживания состояния проекта, а не рабочая инструкция. Тем самым чеклист состоит из самых-самых банальных вопросов, которые подразумевают обычно положительный ответ. Но в условиях стресса, пожара, коллективной и личной несобранности, ошибок планирования, сбоев в рациональном мышлении люди (даже с учётом задействования ими внешней памяти компьютеров) забывают выполнить какие-то работы — и прогон проверки ответа на контрольные вопросы это обнаруживает. Если контрольный лист составлен правильно, то проблемы будут находиться этим чеклистом только один раз из десятка, а то и реже. Но этот один раз обычно спасает проект.
Чеклисты появились впервые в авиации, когда одного пилота стало маловато, чтобы управиться с большим многомоторным самолётом: то с ручного тормоза забудут снять, то один из моторов завести, то убедиться, что перед самолётом на взлёте ничего нет. Аварии на взлёте были очень часты, и чеклисты с банальными контрольными вопросами («ручной тормоз снят», «правый двигатель работает», «левый двигатель работает», и т.д.) практически устранили эти аварии. Девять раз из десяти на все вопросы ответы были положительными, а один раз какой-то ответ был отрицательным — и принимались меры, чтобы аварии не было. Контрольные вопросы прогоняются перед или после выполнения каких-то пакетов работ в специальных паузах, чтобы обнаружить проблемы. Они служат для снятия рисков в командной работе: отслеживают то, что все нужные работы были выполнены и альфа пришла в требуемое состояние.
Стандарт OMG Essence предусматривает как раз такой способ ведения работ в проекте: предлагаемые им примеры kernel альф имеют какие-то более-менее абстрактные (мета-мета-модель) состояния, каждое из состояний включает к нему контрольные вопросы, далее альфы должны быть конкретизированы на один уровень абстракции ниже, до объектов предметной модели (мета-модели).
В простейшем виде состояния альфы и контрольные вопросы к ней (ещё не адаптированные, или уже адаптированные) могут быть оформлены как «карточки», например:
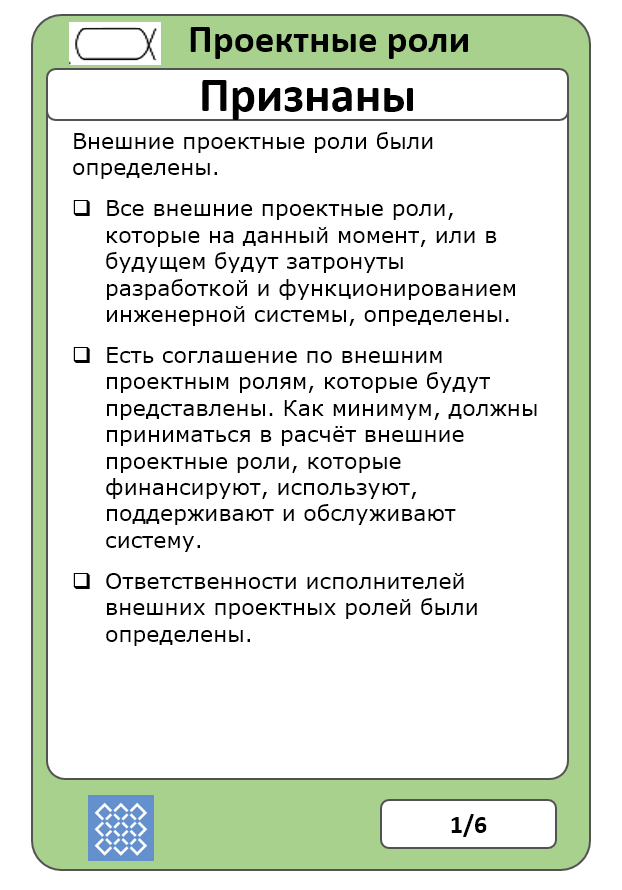
Это неадаптированная карточка альфы «проектные роли», состояние «признаны», первое из шести состояний. Состояние описано как «внешние проектные роли были определены» и это высказывание разбито на более детальные три.
Для ответов на вопросы по альфе должны быть использованы какие-то рабочие продукты (инженеры не верят на слово, биологическому мозгу никакого доверия в смысле памяти, у них «все ходы записаны»). В данном случае можно предположить следующие рабочие продукты:
-
Длинный список (long list) внешних проектных ролей, куда помещаются самые разные проектные роли, которые удалось выявить. Это даст ответ на первый вопрос «Все внешние проектные роли, которые на данный момент, или в будущем будут затронуты разработкой и функционированием инженерной системы, определены». Чтобы добиться создания такого списка, нужно запланировать работу, например «узнать про роль X», «выписать набор нужных ролей из учебника Y», «провести мозговой штурм в отделе Z», и т.д.
-
Короткий список исполнителей внешних проектных ролей, которые будут представлены в проекте какими-то отдельными людьми, и он утверждён (есть отметка об утверждении). Чтобы получить такой список, нужно провести работу — например, совещание, на котором будут прямо в таблице длинного списка проставлены отметки о тех ролях, которые будут представлены, и туда добавлены имена исполнителей необходимых ролей, от которых ожидается нужная квалификация для участия в проекте. Совещание придётся готовить, это тоже работы! А затем нужно ещё и как-то утвердить этот список: решением совещания или решением какого-то ответственного лица (тут мы говорим очень аккуратно: это может быть начальник, инженер, менеджер, но смысл решения тут не столько инженерный, сколько выделения нужных ресурсов). А остальные роли, которые остались в длинном списке? О них будут как-то помнить, но учитывать их интересы без общения с какими-то специально выделенными для этой цели внешними людьми.
-
В коротком списке должно быть указано, за что ответственны исполнители внешних проектных ролей. Чтобы получить этот рабочий продукт, нужно провести работу: обсудить и сформулировать, что должны делать эти исполнители.
Карточку альфы, можно представить как карточку (рабочий продукт, предлагаемый OMG Essence), но также как шаблон/пустографку/таблицу и далее проектировать в ходе адаптации эти таблицы в каком-то универсальном моделере (coda.io, notion.so или аналогичном), а запланированные работы для заполнения этих таблиц представить как issues в issue tracker. С этого момента операционный менеджер будет контролировать закрытие этих issue, а инженеры будут контролировать реальное выполнение условий.
Обычно трудно разобраться, как использовать механизм отслеживания проекта по состоянию альф в условиях непрерывной разработки, когда система всегда «в бета-версии», непрерывно эволюционирует/развивается. Мы об этом упомянули уже, но повторим:
-
Для всей системы основные альфы всей системы хорошо использовать до момента выпуска MVP, а дальше переходить на альфы инкрементов
-
Не использовать диаграммы с альфами, использовать таблицы. Тогда вы будете легко порождать новые альфы по потребности. Почему тогда не порождать такие таблицы «из головы»? Потому как основные альфы и прописанные в наших руководствах для инженеров-менеджеров их подальфы заставят вас подумать о тех подальфах, которые важны, но о которых вы бы сами не подумали бы в суете проекта. Сами «альфы из учебника» выражаются в формате чеклистов с контрольными вопросами по достижению их состояний. И их ещё рекомендуется как-то адаптировать к ситуации вашего проекта, чтобы чеклисты были точнее. То есть альфы предписывают, о чём вы должны подумать, что должны отслеживать. Они нормативны, «так надо думать» в проекте, выделять вниманием эти альфы.
-
Основная идея — это отслеживание состояний альф, когда эти альфы являются предметами кейсов (но состояние их свидетельствуется в физических объектах, рабочих продуктах и агентах, альфы отличаются от рабочих продуктов: скажем, альфа «метод» — это не рабочий продукт, но вы можете оценить её состояние по каким-нибудь отчётам). Когда нужное состояние альфы достигнуто, кейс считается закрытым. Пока не достигнуто — продолжаем выполнять кейс, устранять обнаруженные проблемы. Если предметом кейса делать рабочий продукт, то получается похуже (рабочие продукты вроде все готовы, функция оказывается невозможной — кейс закрыт, но эксплуатировать результат нельзя, функция по разным причинам не выполняется, надо искать причину и открывать новый кейс. Вот «кейсы из альф», а не «кейсы из рабочих продуктов» решают эту проблему, отслеживается сразу конечный эксплуатационный результат, а не «папа, я собрал все шестерёнки от твоих часов в кучку, но эта куча шестерёнок почему-то не показывает время»).
Если содержание этого подраздела плохо понятно, вернитесь к наставлениям руководства по методологии, там всё изложено более подробно. Но ещё будет дополнительное изложение в руководстве по системному менеджменту.
Задания
Поставьте отметки выполнения дел.
-
Выбран пример важной для текущего проекта альфы или подальфы, состояние которой нужно отслеживать (не путать альфу и рабочий продукт в физическом мире или документ!) и определены состояния этой альфы в вашем рабочем проекте, а также методы, которыми вы достигаете этих состояний. Документирование в форме регламента.
-
Для состояний выбранной в предыдущем пункте альфы составлены контрольные вопросы для определения прохождения событий достижения этих состояний. Документирование в форме шаблона чеклиста.
-
Взят экземпляр чеклиста по его шаблону. Определено, какие состояния уже достигнуты, а какое состояние должно быть достигнуто (и если есть трудности в ответе на это вопрос, то нужно выделить подальфы и дальше проводить все эти действия уже с ними, возвращаясь к общей альфе по мере разбирательства с подальфами — для этого вернуться к регламенту и шаблонам).
-
Определены рабочие продукты, по которым можно будет отвечать на контрольные вопросы («доказательства»/«свидетельства» достижения состояния альфы или подальфы). Документировано в регламенте.
-
Составлен и опубликован в issue tracker список дел, которые нужно сделать, чтобы получить положительные ответы на контрольные вопросы для состояний выбранной альфы или подальфы.
6-, Multi-, poly-, … D
Управление данными (раньше — «управление данными жизненного цикла», сегодня — «управление данными инженерного процесса») условно относят к:
-
управлению данными продукта (делается при помощи систем PDM, product data management), когда речь идёт о проектных базах данных, в которых удерживается конфигурация целевой системы (включая промежуточные состояния сырья, ведущие к появлению сначала частей системы, а затем и всей готовой системы в целом)
-
управлению данными жизненного цикла (PLM, product lifecycle management), когда кроме данных о продукте добавляются и данные о создателях (кто что делает)
-
управлению пользовательскими впечатлениями/опытом (customer eXperience) в порядке eXperience management. Тут говорится, что речь идёт о широком наборе ролей, для которых предоставляются данные, причём сюда относят и внешние проектные роли. Главное, что успешность управления данными определяется не по оценкам инженера внутренней плафтормы разработки, а по оценкам пользователей платформы — и эта платформа так и начинает называться: customer eXperience platform (например, learning eXperience platform, LXP). Это кардинальный сдвиг, обычно очень трудный, ибо сдвижка референтного индекса даётся трудно19.
Помним, что если кто-то::создатель что-то::метод делает, то есть и данные об организации проекта и состоянии этой организации, и обязательно есть данные о том, над чем эти работы ведутся — данные рабочих продуктов, которые постепенно обрабатываются и превращаются в целевую систему. Это ведёт к появлению самых разных гибридных описаний, которые описывают и целевую систему по ходу её развития (в том числе эксплуатации), и системы графа создателей.
Тренд сегодня в том, что к числу обязательных системных разбиений добавляют разбиения уже не только самой целевой системы «как в PDM», не только разные другие виды моделей (скажем, физические модели) кроме разбиений, но и прихватывающие рассмотрение систем в графе создателей (например, четвёртый аспект рассмотрения системы по стоимости уже прихватывает не только стоимость сырья и стоимость заказных компонент системы как продуктов, но и стоимость выполнения работ, в том числе эксплуатационную стоимость — разбиение полной стоимости владения). А ещё кандидатом на обязательное разбиение становится разбиение работ (WBS, work breakdown structure). Формально PLM отличается от PDM как раз тем, что хранит конфигурацию не только продукта (целевой системы), но и проекта (создателей в их графе, в том числе конфигурацию работ). По факту PLM состоит обычно из системы версионирования (репозитория), в которой хранится информация о конфигурации продукта и issue tracker, в котором хранится конфигурация работ. Например, для случая софта это может быть репозиторий Git и issue tracker к нему, которые собраны в какой-то общий сервис вроде GitHub20 или GitLab21. В случае «железного железа» (механические системы, не компьютерное железо) это может быть сервис типа OpenBom22.
Последний тут тренд — это переход от PLM систем к eXperience Platforms (XP). Основная идея eXperience platform — это управлять данными, выходящими за пределы традиционно понимаемого инженерного процесса (прежде всего — данные о внешних проектных ролях, например, данные по продвижению продукта — маркетинг, продажи, данные по постпродажному обслуживанию, эксплуатационные данные). Ещё одна проблема, которую решает переход от PLM системы к XP — это управление информацией, важной для внешних проектных ролей по отношению к команде проекта (PLM прежде всего ориентировались на поддержку команды проекта, и обычно не на всём жизненном цикле, а только на стадии разработки). Так, UX (user eXperience) от UI (user interface) отличается тем, что призывает поглядеть на user отнюдь не в тот момент, когда он нажимает кнопки приложения на экране: его проблемы начинаются сильно раньше и заканчиваются сильно позже, и момент нажатия на кнопки там только часть происходящих событий у пользователя. Впечатления/опыт пользователя поэтому не сводится только к «нажатию красивых кнопок красивого интерфейса», а связаны с тем, удалось или нет пользователю решить задачу — и если при отличном пользовательском интерфейсе не удалось, впечатления будут плохие. Грубо говоря, если вам хамит красивый человек с приятной улыбкой, то впечатление останется от его хамства (поведения), а не от интерфейса. Вот этот аспект оказывается очень труден для понимания: отслеживание общего впечатления самых разных проектных ролей, внимание на eXperience.
В предметной области UX не доходят до систем управления данными, не доходят до управления конфигурацией, просто указывают на вот этот разворот в понимании жизненного цикла как eXperience. Но в инженерии внутренней платформы разработки этот тренд stakeholder eXperience (самые разные проектные роли! Не только customer!) был подхвачен, и как пример, программный комплекс PLM ENOVIA плавно перешёл и по названию, и по сути в 3DEXPERIENCE23. Теперь этот программный комплекс занимается управлением информацией (данными) инженерного процесса машиностроительных и строительных проектов (указывается на применимость в 11 отраслях). Смысл переименования из PLM ENOVIA в 3DEXPERIENCE PLATFORM был в том, что он начал поддерживать работу с данными инженерного процесса далеко за пределами стадии проектирования, как это было в ENOVIA. Но всё же там в основе платформы ровно то же самое, что было верно и для PLM: репозиторий для отслеживания версионирования конфигурации (конечно, с интерфейсами к самым разным CAD/САПР системам, самым разным моделерам) и issue tracker для управления изменениями конфигурации.
Ещё один пример — это LMS (learning management system, аналог PLM для систем образования, поддерживает решение проблем команды образовательных организаций) стал сейчас LXP, learning eXperience platform, ибо поддерживает решение проблем студента, а не только решение проблем учителей24. Так что в современное руководство по системной инженерии мы вписываем и PDM, и PLM, и eXperience (со второй большой буквой, чтобы отличить от просто «опыта»). И это ещё не конец истории, поскольку появился и новый термин, обращающий особое внимание на операционные данные (данные стадии эксплуатации): цифровой двойник (digital twin) в его вариантах цифровой модели, цифровой тени и истинного цифрового двойника. Но об этом в текущем разделе руководства будет говориться немного дальше.
Главное, что нужно запомнить, что во всех этих вариантах внутренних платформ разработки увязываются работы внешних проектных ролей (eXperience), создателя (PLM) и конструкция целевой системы (PDM): все контрольные точки (они нужны для операционного управления, то есть для управления работами создателя по воплощению, а также по удовлетворению интересов внешних проектных ролей) порождаются для модели проекта/project на основе модели продукта (design). Тут асимметрия: не из работ по воплощению делается разбиение системы, а наоборот: для каждой части системы (они описываются в design) проектируются работы по её созданию («заказать, получить, проверить, смонтировать, наладить/настроить, проверить работу в составе системы»), а каждая работа имеет свою контрольную точку — для того, чтобы отследить её выполнение. Потом можно назначать работников и начальные моменты старта для уже понятных работ/задач/task.
Моменты времени для контрольных точек расставляются исходя как из технологической последовательности («сначала стены, потом крыша»), так и из балансировки ресурсов («побыстрее» против «равномерной загрузки» — или в пике на стройке атомной станции вдруг обнаруживается 2700 человек, и начинаются проблемы с туалетами, обедами, жильём, но всё идёт очень быстро, или равномерно на станции работает каждый день примерно 700 человек, не сильно больше и не сильно меньше — стройка будет длиться подольше, но и многие проблемы пиковых авралов на 2700 человек при этом будут отсутствовать).
Проверка качества такого планирования в «железных» и строительных проектах может быть — анимационными роликами (имитационное моделирование). В них хорошо видно, как «забыли завезти крупногабаритное оборудование вовремя, пришлось разбирать свежевозведённую стену, чтобы затащить оборудование в помещение».
Такой метод порождения контрольных точек из данных по продукту получал разные названия, потому что люди из маркетинга очень хотели иметь собственное для каждого поставщика инструментария внутренней платформы разработки фирменное наименование для такого «прогрессивного способа» увязывания конфигурации продукта (3D-модели продукта для киберфизических систем) и конфигурации работ. Чаще всего эти названия крутились вокруг числа «пространственных измерений/размерности/dimension», потому как 2D-чертежи заменялись 3D-информационной моделью. Число D (dimension) в итоговой мегамодели для «железных» и строительных проектов потихоньку росло с начальных 3D и переставало быть «пространственной размерностью». У Toshiba в конце нулевых в софте для конструирования было 6D (хотя это уже давно забытый факт, но технология называлась 6D), у НИАЭП Росатома в начале десятых годов 21 века уже было радикальное Multi-D25, число размерностей признавалось радикально большим, много больше трёх пространственных измерений.
В последние несколько лет популяризируется 8D как самое броское в популяризации подхода, например 8D digital twin experience от SNC-Lavalin26. В 8D подходе всё ровно то же самое, что можно было услышать десяток лет назад в презентациях по PLM, но слова другие — digital twins, ибо акцент уже не только на проектировании и сооружении, но и на эксплуатации, поэтому engineering data дополняются asset data, а конечная цель — автономная (без человека, где-нибудь в абсолютно безлюдной местности) эксплуатация на основе «единственного источника правды», single source of truth (это мы повторяем материал руководства по системному мышлению, подраздел *«*Альтернативные варианты основных видов разбиения системы на части»):
-
1D метаданные, документация (тексты)
-
2D чертежи (там, где «обычные двумерные чертежи» ещё есть, «родные файлы» из CAD/САПР)
-
3D информационные модели (это представление физической формы/геометрии/компоновки системы с указанием материалов и многих других характеристик)
-
4D «видеоролик» стройки/сборки в развёртке во времени, то есть к 3D добавляется план/schedule сооружения (стройки и монтажа) или сборки
-
5D это ресурсы, material status/cost, то есть добавляется стоимость
-
6D вот тут появляется operation, real time data (и мы перешли из «construction time»/«enabling realm»/«времени создания» в «operation realm»/«operation time»/«время эксплуатации», и с этого места принято говорить, что речь идёт не о системе поддержки жизненного цикла/PLM, а цифровом двойнике/digital twin уже созданной физической системы)27
-
7D это live streaming, передача видеопотока работающей целевой системы и её окружения (с видеокамер, со спутника — отдельно от real time data с датчиков, ибо это огромные объемы данных).
-
8D это уже аналитика, предсказания систем машинного обучения (ML predictive data)
Во всех этих методах создания внутренней платформы разработки все данные инженерного процесса ставятся под контроль конфигурации (иногда это называют «управление информацией», иногда «интеграцией данных жизненного цикла», иногда «непрерывная интеграция») так, чтобы можно было проверить отсутствие конфигурационных коллизий в компьютерной модели до того, как они проявятся в момент изготовления системы и уж тем более эксплуатации системы.
Если система имеет электропитание 12 вольт (и это электропитание проектирует одна фирма), а осветительную лампочку в неё запроектировали на 220 вольт (это делала другая фирма), то это должно быть обнаружено ещё до покупки лампочки, до выдачи лампочки в монтаж, до включения лампочки в актуальной системе. И особо повторим: кроме интеграции инженерных данных о продукте (целевой системе) нужно ещё интегрировать менеджерские данные о создателях. И тоже думать об отсутствии конфигурационных коллизий — чтобы не оказалось, что лампочку должен вкручивать вчера уволенный электрик.
Вот эта проверка конфигурационных коллизий между создателями и создаваемой системой интересна тем, что в ней хорошо видны не только банальные ошибки планирования, но и тщательно запланированные злоупотребления: выполнение работ с никакой частью системы, закупка комплектующих, которые потом не задействованы никакой работой.
Вот картинка, которая показывает более чем обычную ситуацию: две внутренних платформы разработки (XP или даже более древние PLM) системы в одном проекте, при этом они могут быть развёрнуты или в разных подразделениях одной большой фирмы, или даже в разных фирмах, когда разработка ведётся в рамках «производственной кооперации»/ «extended enterprise»:
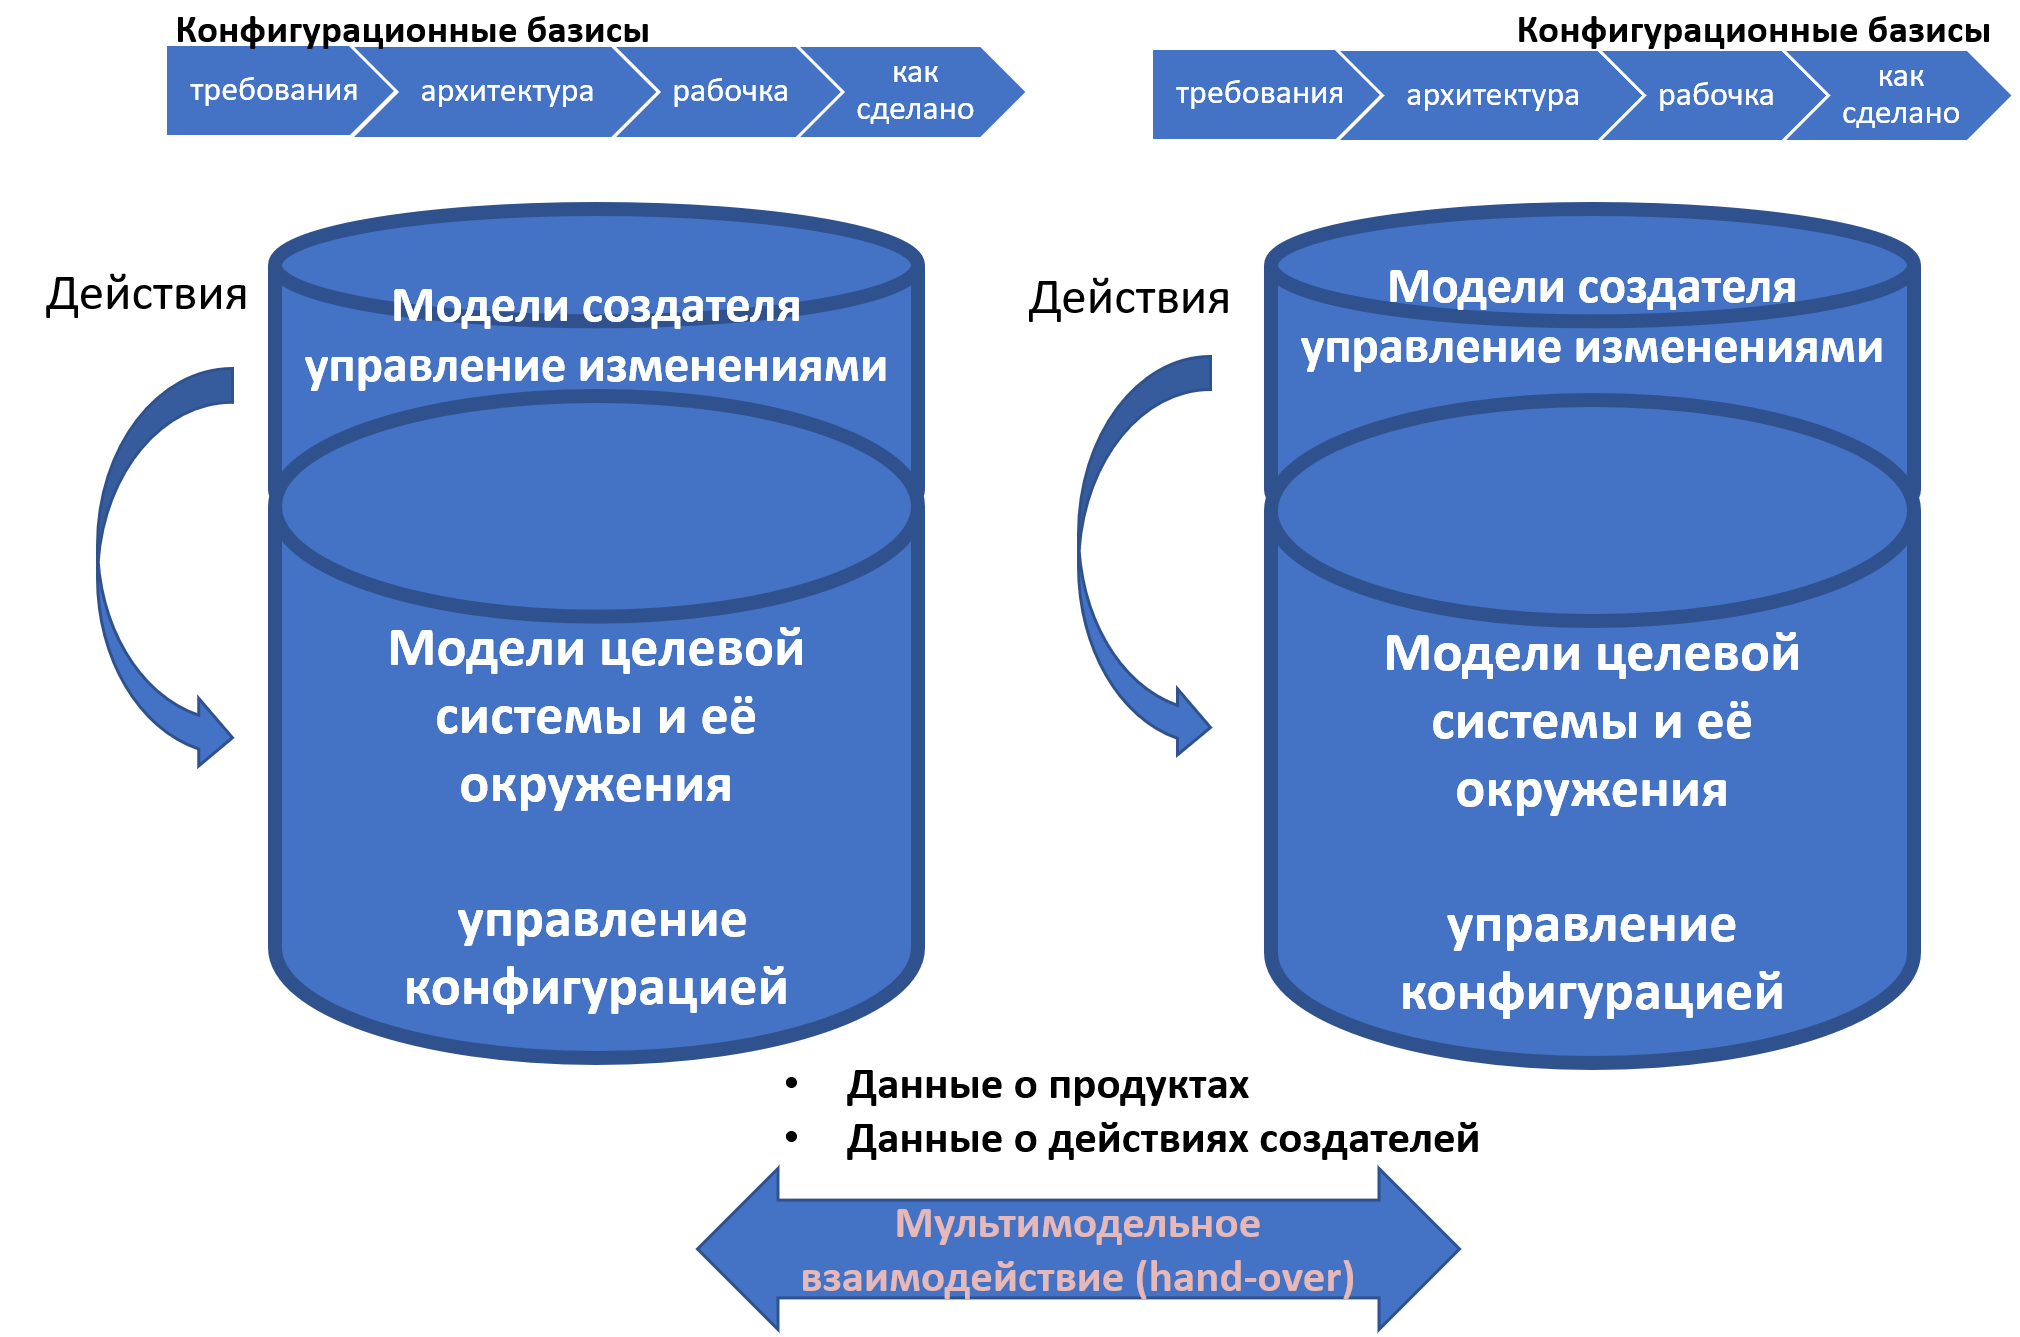
Картинка отражает обычное на сегодня состояние «железного» проекта, как это понимается в классической «железной» системной инженерии, предусматривающей «однократный ввод в эксплуатацию». Научитесь по таким картинкам определять, что они «из прошлого десятилетия» (хотя они могут быть подготовлены буквально вчера!). Какие признаки старого мировоззрения, старой инженерии? На картинке же вроде правильные слова про «модели», правильные слова про управление конфигурацией, правильные слова про системы? Но на ней явно приведены два «однократных» водопада, начинается всё с требований (а не других современных способов описывать функциональность системы), рабочка и «как сделано» тоже последовательны (не каждое отклонение немедленно вносится в рабочку, а «сначала всё делаем, потом вносим все изменения разом» — в уме рисовавшего диаграмму был «водопад»). Вы должны распознавать всё это, ибо рядом с такими диаграммами будут обязательно написаны слова про agile (это же модно! Все хотят быть «гибкими» и «современными», а слово написать на эту тему нетрудно).
Но давайте разберёмся, о чём нам говорит такая диаграмма (она ведь описывает положение дел, которое вам наверняка встретится в каком-нибудь строительном проекте, или проекте создания электростанции). В каждой внутренней платформе разработки есть и система версионирования продукта (отслеживание модели целевой системы и её окружения, обычно репозиторий, относится к управлению конфигурацией, PDM) и issue tracker (модели создателя, прежде всего проводимых создателем работ по созданию его системы в графе создателей — расширение PDM до PLM). Эти системы общаются между собой (обмениваются данными), и тут нужно помнить: передавать между системами нужно не только информацию о продукте (например, новую деталь или программный модуль с замечаниями к ним), но и информацию о планируемой работе (например, указание на то, что нужно посмотреть на свежеразработанные деталь или программный модуль и прислать в ответ замечания). А что с ходом на eXperience management? В картинке ничего этого не видно, выхода на управление информацией для внешних проектных ролей не показано (при этом выводы делать рано: «не показано на картинке» — это не значит, что в самом проекте этого не было сделано! Возможно, всё сделано, но просто «не показано», посылка открытого мира).
Как будет идти жизнь в проекте, который делался по показанной в диаграмме картинке? По «водопаду»? Нет, мы неоднократно замечали, что «водопад» — он только в мозгах, «модель». В жизни будут непрерывно меняться требования (ибо природу «гипотезы», «догадки» никто не отменял, даже если очень хочется считать это «окончательно зафиксированными требованиями», это просто документированные догадки). Только менять их будет административно очень тяжело, равно как административно тяжело будет менять проектные решения (базисы, которые устарели сегодня) под изменившиеся требования, равно как и менять реальные конфигурации воплощения системы. Жизнь будет как в agile проекте, только с искусственными административными препятствиями. Работа будет не элегантной, не lean.
Иногда управление конфигурацией относят именно к управлению инженерными данными для целевой системы (версионирование), а управление изменениями в целевой системе к управлению данными о том, кто и что с будущей целевой системой делает, то есть управлению операционными данными о создателях. Как ни разносить интеграцию данных инженерного проекта по разным методам, нужно просто понимать, что конфигурационные коллизии нужно искать в мегамодели, которая описывает и проект/design продукта/product, и менеджерский проект/project, и это нужно делать в условиях множества не только продуктов-подсистем целевой системы и окружающих систем в надсистеме (учитывать множество самых разных design, которые разрабатываются в самых разных системах автоматизации проектирования и моделерах), но и в условиях множества проектов/project, которые ещё готовы как-то делиться инженерной информацией, но часто не готовы делиться информацией о выполнении работ из своих issue trackers или систем классического проектного управления (например, строительных).
Интеграция данных
Управление конфигурацией, управление изменениями, управление инженерной документацией, управление информацией, интеграция инженерных данных (данных жизненного цикла, данных инженерного процесса), создание цифровых двойников28 с использованием цифровой нити29** —** эти все методы близки до неразличимости, нюансы невелики. Во всех этих методах инженерии внутренней платформы разработки:
-
Моделируй разные аспекты самых разных систем при помощи самых разных моделеров. Иногда это проектирование (модели нет, системы нет, придумываем модель, потом её реализуем), но иногда создание (или хотя бы модификация) моделей путём reverse-engineering. Это происходит с надсистемой, когда в её состав вписывают целевую систему в рамках составления гипотез по концепции использования, но также и при создании модели as built, потому как не всегда в реальной физической системе удаётся соблюсти её соответствие проектной/design модели (модель «as built»/«исполнительская модель», например в строительстве до сих пор строят не роботы, и результат в физическом мире будет не совпадать с исходной информационной моделью: нужно будет привести модель в соответствие с жизнью). Тут используются моделеры, системы автоматизации проектирования (САПР/CAD), раньше говорили «автоматизированные рабочие места» (АРМ, но этот термин уже сильно устарел). DevOps инструментарий в программной инженерии должен учитывать и IDE (interactive development environment)30.
-
Используй версионирование: всегда знай, с какими версиями моделей ты работаешь. Для этого храни версии не в моделере, а собирай их в системе ведения версий (репозитории моделей), где ты сможешь ещё и сказать, какие версии каких моделей соответствуют друг другу, а также проверить наличие конфигурационных коллизий. Давай доступ в том числе и внешним проектным ролям (eXperience platform).
-
Отслеживай не только модели, но и продукт, который построен по этим моделям. Знай всегда конфигурацию продукта (что из каких версий частей модели вошло в отгружаемую или даже уже эксплуатируемую систему). Конфигурация системы — это сама система, а не её описание, не её модель.
-
Интегрируй, то есть управляй конфигурацией и проверяй на отсутствие конфигурационных коллизий, чтобы найти их как можно раньше в ходе разработки, исправить до того, как начали создавать физическую систему.
-
Интегрируй не только информацию о целевой системе/продукте, но и о проекте (графе создателей, то есть информацию менеджеров, информацию проектного управления). DevOps инструментарий в инженерии должен учитывать не только CAD/CAM/CAE с PLM или eXperience platform, но и ERP31 (enterprise resource planning, планирование потоков полуфабрикатов/ресурсов уровня предприятия) и MES32 (manufacturing execution system, планирование уровня цеха).
-
Не останавливайся на разработке: продолжай моделировать систему и отслеживать её конфигурацию в ходе её эксплуатации, это даст переход к цифровому двойнику.
Проблемы тут в том, что всем этим будут заниматься информационные системы самых разных поставщиков, они как «коллективные экзокортексы» будут принадлежать самым разным фирмам, предметом их работы будут самые разные аспекты самых разных (целевая, надсистема, подсистемы, создатели в их графах) систем, эти системы будут в самых разных состояниях готовности в самых разных версиях, и у этих систем будут самые разные физические, финансовые и иные модели, мета-модели и мета-мета-модели, которыми руководствовались разработчики этих систем. Грубо говоря, у одной колёсной системы будет «путь в метрах», у другой «угол поворота колеса в радианах» (что позволяет вычислить путь в метрах, но это ещё нужно догадаться, как). И это самый простой случай.
По факту в интеграции данных речь идёт о переводе с одного языка на другой, и представьте, когда в проекте родные языки сотрудников китайский, суахили и испанский. На каком языке будет общение? На «нейтральном», которым служит английский, на котором никто не говорит! Это была основная идея «цифровой нити»: переводить всю информацию в «нейтральный формат» и тем самым налаживать обмен информацией между информационными системами.
Давайте рассмотрим жизненный цикл какой-нибудь задвижки на трубопроводе.
Объект «задвижка» появляется в проекте/design задолго до появления физической задвижки на трубопроводе. Это отражено на рисунке, показывающем состояния экземпляра задвижки по мере прохождения ей состояний от «задумана» до «выведена из эксплуатации»:
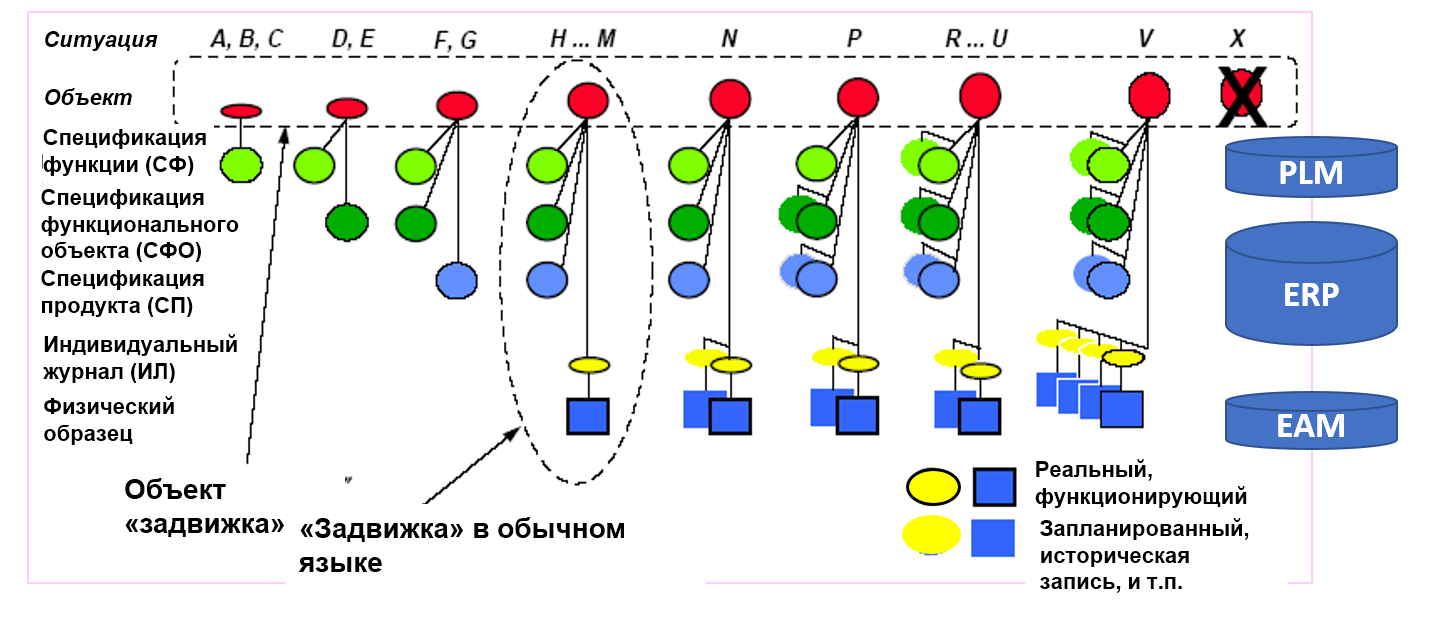
В системе проектирования трубопровода процессный инженер разрабатывает спецификацию функции перекрытия трубопровода, после этого говорит, что трубопровод будет перекрываться функциональным объектом «задвижка» с какими-то определёнными характеристиками, появляется спецификация уже не только функции задвижки, но и её самой (функция — это поведение ролевого объекта, функция задвижки — перекрывать поток). Далее идёт конструирование/проектирование: для функциональной задвижки определяются параметры конструктивного объекта задвижки как типа возможного конструктива/модуля, и этот объект с подходящими параметрами ищется у производителей задвижек.
Когда найден производитель подходящей по параметрам задвижки, там покупается конкретный физический образец задвижки с каким-то серийным номером, и на него заводится индивидуальный журнал ремонта и обслуживания задвижки. «Задвижка» в обычном языке означает вот это всё вместе: физический объект, изготовленный каким-то заводом, который играет роль функционального объекта в создаваемой системе.
Далее можно представить замену этой задвижки другой с каким-то другим серийным номером, это тоже нужно будет отразить в информационной модели системы. Далее можно представить, что как-то меняем систему и меняем спецификацию продукта, а то и функционального объекта, а то и самой функции (скажем, поменялся состав жидкости, давление жидкости, и теперь нужно использовать задвижки с другими характеристиками).
Обычно для киберфизических систем функциональное проектирование ведётся в CAD, но дальше информация хранится в системе PLM (или eXperience platform, но прогресс дошёл отнюдь не до всех компаний реального сектора). В PLM системе обычно не хранятся серийные номера физических заглушек, а информационная модель там «в типах», ибо проектирование всегда ведётся «в типах»: информацию о требуемой заглушке передадут в ERP-систему (Enterprise Resource Planning), которая отследит закупку системы у какого-то поставщика, её логистику и выдачу в монтаж (логистика и операционный менеджмент ресурса «заглушка»), а затем эту информацию передадут в EAM-систему (enterprise asset management), где будут вести индивидуальный журнал эксплуатации заглушки как актива (в последнее время вот такие EAM-системы называют всё чаще «цифровыми двойниками», ибо речь идёт о стадии эксплуатации и чаще и чаще эти заглушки уже не «ручные» из косного вещества, а с датчиками и моторчиками — роботизированные, и цифровой двойник поддерживает модель актуального состояния эксплуатирующейся заглушки). PLM-система по-прежнему при этом будет содержать информацию о том, какую функцию выполняет эта заглушка, а ERP-система будет помнить, у кого её купили и что там говорилось в договоре покупки — это очень пригодится, когда что-нибудь с этой заглушкой пойдёт не так (скажем, поломается, в том числе поломается в рамках гарантийного срока, или её потребуется заменить или оставить в ходе при модернизации всего трубопровода).
Разные цвета на рисунке — разные по типу «задвижки», они и называются по-разному (чтобы отразить в названии их тип) в разных информационных системах:
-
Зелёный цвет — это функциональный объект «комплектующее», с ним работает PLM-система
-
Синий цвет: кружок — это конструктивный объект «предмет снабжения», с ними работает ERP-система, а квадрат — это «установленное оборудование», с ним работает EAM, и там это может называться ещё и «актив» (asset).
-
Жёлтый цвет — это документ с описанием конструктивного объекта, с ним работает EAM (цифровой двойник).
По большому счёту, мы можем заменить заглушку в киберфизической системе на сотрудника в организации. Тогда в оргмоделере предприятия будет определён метод, который должна будет выполнять какая-то оргроль и сказано, какая это оргроль, а ещё определено оргзвено, выполняющее эту роль. Этот оргмоделер будет абсолютно аналогичен САПР (CAD), а ещё там будет хранилище данных такого САПР, аналог PLM-системы. Затем в софте службы кадров будет проведён поиск специалиста или специалистов, которые могут выполнить эту работу (аналог ERP-системы). И в том же софте службы кадров и софте бухгалтерии появится «досье» на нового сотрудника, где будет накапливаться информация о его повышениях квалификации, выговорах и премиях (аналог EAM системы, цифрового двойника).
Конечно, информационных систем в подобных проектах много больше, чем три, и управление информацией занято тем, чтобы исключать медленные и дорогие со множеством неизбежных ошибок (ведь это работа людей!) передачи данных путём «прочесть глазами в одной системе, вбить руками в другой системе» из одной системы в другую. Интеграция информации жизненного цикла делается не глазами-руками, а программами конвертирования информации. Эти программы называют часто «цифровой нитью». Вот рисунок, на котором схематично изображена такая «цифровая нить» для производственных систем:
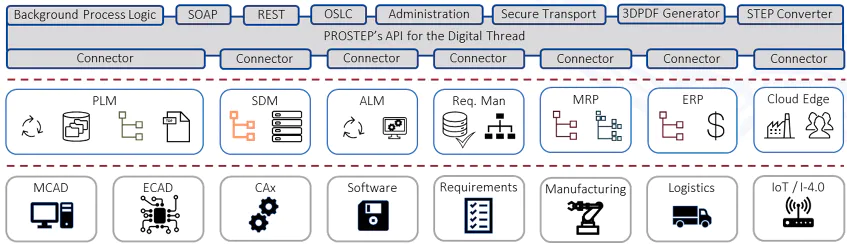
Серый прямоугольничек — это разные программные интерфейсы для самых разных информационных систем, которые могут встретиться в жизненном цикле системы (читай: встретиться в организациях-создателях в самых разных графах создателей), и там важны коннекторы/адаптеры/конверторы форматов данных в какой-то нейтральный формат. Этих форматов тоже множество, никакого аналога «рабочего английского», как в естественных языках, для цифровых нитей не было разработано — каждая фирма-поставщик цифровой нити изобретает свой вариант нейтрального формата и даже ухитряется сделать такой формат международным стандартом, причём стандартов таких удивительно много, поэтому разные цифровые нити жёстко конкурируют на рынке и плохо совместимы друг с другом.
Цифровые нити работают с интеграцией данных нескольких разных видов:
-
Операционные/транзакционные данные, то есть данные о конкретных экземплярах целевой системы и её описаний, а также действиях с ними: от проекта/design и проекта/project до эксплуатационных данных целевой системы, мы как раз обсуждали в этом разделе именно эти данные в их разнообразии.
-
Мастер-данные (master data)33, которые используются в нескольких проектах предприятия, работающих с самыми разными целевыми системами. Это чаще всего данные по клиентам и поставщикам.
-
Справочные данные (reference data)34, которые используются в бизнес-эко-системе, то есть одинаковы для проектов самых разных предприятий: нормативно-справочная информация, стандарты, единицы измерения и т.д.
Интеграция данных работает с двумя основными сценариями:
-
Одно- или двухстороннего доступа из одного приложения в другое.
-
Разовый перенос информации из старого приложения в новое (это называют «миграция данных», data migration35)
Для систем другой природы управление конфигурацией совсем не так очевидно устроено, и цифровая нить может быть устроена совсем по-другому. Например, когда мы говорим о связывании цифровой нитью информационных систем государства, то встаёт множество вопросов по защите персональных данных, смещению баланса власти между людьми и чиновниками, превращению государства в полицейское (любой чиновник будет знать о любом гражданине много больше, чем можно себе представить — это приводит к злоупотреблениям, ибо власть развращает, а абсолютная власть развращает абсолютно). Но если речь идёт о так называемых «госуслугах» (которые вам, конечно, вменяют — вы их берёте не добровольно, а подчиняетесь требованиям закона), то становятся ненужными бумажные справки: то, что какая-то госслужба знает о вас всё, оказывается в этом случае вам же и выгодным. Как всегда в эволюции, цифровая нить даёт огромные новые возможности развития информационных систем в инженерных проектах, но она же порождает конфликты, приводящие к неустроенностям/frustrations, множеству примерно одинаковых по оптимальности самых разных решений.
«Цифровая нить» (digital thread) тут тоже одно из многих маркетинговых имён, продолжающих увеличивать количество терминов, использующихся для указания на информационные системы и методы, помогающие управлять конфигурацией и изменениями в инженерных проектах. Эта же «цифровая нить» в корпоративных информационных системах разных провайдеров сервисов (банков, страховых компаний и прочих, где речь не идёт о традиционных продуктах-вещах) будет называться сегодня гиперавтоматизация/hyperautomation36 (RPA, robotic process automation37 как автоматизация заполнения экранных форм, когда-то придуманных для работников-людей, плюс добавление программ искусственного интеллекта, помогающего распознавать отчёты одних программ и создающих затем содержание для заполняемых при помощи RPA форм). В любом случае все такие проекты относятся к интеграции данных проекта какой-то системы, и речь идёт об обеспечении взаимодействия информационных систем путём их интеграции, унификации или федерирования. Это рассматривалось в руководстве по системному мышлению в подразделе «Платформы и технологические стеки», там упоминался стандарт налаживания взаимодействия ISO 11354-1:2011, framework for enterprise interoperability38. Помним, что принято говорить «интеграция информации» или «интеграции данных» (иногда добавляют «проекта», «жизненного цикла», «предприятия», «инженерного процесса» — по вкусу), но по факту это обычно федерирование (информационные системы ничего друг о друге не знали до федерирования), очень редко унификация (информационные системы соответствуют одному стандарту) и почти никогда — именно интеграция (информационные системы проектировались специально для совместной работы) в смысле ISO 11354-1:2011.
В каком направлении развивается метод цифровой нити? Сегодня основное — это так называемая «семантическая интеграция данных», то есть использование конверторов из одной формально-логической схемы данных в другую. Но она, увы, плохо работает: разные формально-логические схемы оказываются несовместимыми друг с другом. Поэтому надежда на системы искусственного интеллекта, которые для совмещения разных объектов из разных информационных систем могут использовать естественный язык и непрерывное (а не дискретное формально-логическое) многомерное пространство значений. Идея активно обсуждается39, но реальных производственных приложений пока нет.
Использование цифровой нити в управлении конфигурацией и изменениями даёт возможность задействовать параллельную инженерию (concurrent engineering)40 в проектах, которые подразумевают «разовую» одноцикловую инженерию (строительные проекты тут как пример). При параллельной инженерии все работы по разным методам инженерного процесса идут почти одновременно, «в параллель», то есть замысливание (в частности, запросы новых возможностей/features), проектирование, изготовление и эксплуатация системы идут одновременно, «в параллель».
Но как можно строить, например, дом, если ещё не закончен его проект? Наверняка же будут многочисленные коллизии! Будут закупаться не те количества материалов, которые нужны, будут возводиться стены там, где они не предусмотрены ещё не сделанным проектом, много чего будет! Но нет, благодаря современным методам управления конфигурацией и изменениями удаётся избегать конфигурационных коллизий, а времени на разработку и изготовление уходит меньше, и даже эксплуатация начинается раньше: пока строят правое крыло здания, в левом уже живут, а башенку уже заканчивают проектировать — всё с разными частями системы происходит в разное время, а управление конфигурацией и изменениями плюс высокая точность изготовления не допускают, чтобы все эти части будущей системы вдруг не состыковались друг с другом.
Ещё один тренд — это цифровая нить, связывающая системы проектирования и системы изготовления. Раньше передача данных проекта/design осуществлялась путём перевозки грузовиками бумажной проектной документации из конструкторских бюро на завод, или из проектных институтов на стройку. Теперь передача данных проекта/design происходит онлайн, причём при необходимости происходит конверсия форматов. Это не так просто, ибо часто в момент проектирования контрактор по изготовлению ещё неизвестен (ибо ещё непонятно, что будет заказываться, непонятно, сколько будет стоить изготовление). Идеал, когда конструктор или проектировщик и технолог организации-изготовителя/производителя системы сидят рядом в ходе проектирования и выполняют работу вместе (так называемое «проектирование для изготовления»/design for manufacturing), соблюдается редко. Но такое тоже случается всё чаще и чаще: компании вроде SpaceX и Tesla собирают проектирование и изготовление вместе, проектировщики и технологи там действительно работают вместе, и это в таких сверхсложных системах, как современные ракеты, оказывается выгоднее, чем размещать разовые заказы «где-то в Китае» и потом разбираться с возможными рассогласованиями и задержками.
Цифровая нить стимулирует объединить информационные системы проектировщиков и изготовителей и предотвратить коллизии типа «вот вы тут разработали деталь, а её невозможно изготовить дёшево и быстро, или даже вообще нереально изготовить на имеющемся оборудовании». Зависимость проектирования от способа изготовления оказывается существенной: тренд на «меньше деталей, но сами детали более сложной формы» связан с распространением полностью цифрового проектирования и полностью цифрового изготовления на 3D-принтерах: стоимость 3D-печати сложных деталей оказывается меньше стоимости точной обработки деталей для достижения герметичности на многих стыках простых деталей, плюс стоимости логистики деталей для сборки, плюс стоимости сборки и проверок.
Так что после того, как вы сделали первый ход по мантре «распожаризации»/lean и прекратили заниматься ненужной работой, обязательно продолжайте наведением «инженерной бюрократии», как иногда называют управление конфигурацией и изменениями: наводите в проекте порядок, чтобы не возникало конфигурационных коллизий как основного источника «пожаров» с неминуемыми переделками. И только потом резко ускоряйте работы за счёт сначала грамотного операционного менеджмента инженерной разработки и изготовления (уменьшения времени ожидания операций), а затем и за счёт использования более современных методов разработки и изготовления систем самой разной природы, самых разных масштабов.
Моделирование: конфигурационные коллизии
Опишите больше трёх последних конфигурационных коллизий, которые были обнаружены в вашем проекте:
| Номер п/п | Описание коллизии | Участвующие конфигурационные единицы | Метод работы, при выполнении которого проявилась операционная коллизия | Сколько времени заняла повторная работа (re-work) |
|---|---|---|---|---|
| 1. | ||||
| 2. | ||||
| 3. | ||||
Задания
Поставьте отметки о выполнении дел.
-
Убедитесь, что для каждой части вашей рабочей системы у вас запланирована работа по её проектированию, изготовлению, сборке-наладке-отладке, инженерному обоснованию.
-
Убедитесь, что для всех ваших рабочих продуктов у вас есть система ведения версий и известно, кто и когда вносил какое последнее изменение.
-
Написан и опубликован пост «Цифровая нить нашего проекта», где описываются информационные системы в вашем проекте, описания каких систем (целевой, подсистем, надсистемы и систем в окружении, создателей в их графах) для выполнения каких методов работы в инженерном процессе они содержат, и как они обмениваются между собой информацией в свете ISO 11354-1:2011 (в соответствии с каким подходом они создавались: интеграции, унификации или федерирования информационных систем).
-
Написан и опубликован пост по развитию тренда digital transformation и hyperautomation в сторону использования систем AI. В пост включено несколько абзацев про перспективы AI в инженерном процессе вашей организации.
Цифровой двойник
«Железная» системная инженерия потихоньку решает проблему, которую решали DevOps в программной инженерии: методы разработки и методы эксплуатационной инженерии систем оказались разобщены, ибо в ходе разделения труда одни инженеры-разработчики и инженеры-производственники проектировали и изготавливали систему, а другие инженеры-операторы занимались её эксплуатацией (настраивали для получения оптимальных режимов работы, загружали сырьём, следили за отсутствием поломок, а если системами пользовались люди-неинженеры, то помогали этим людям).
У системных администраторов программных систем и разработчиков программных систем был образ, когда разработчики перекидывают очередной релиз через высокую кирпичную стену на сторону сисадминов, а дальше сисадмины мучаются, пытаясь объяснить пользователям, почему всё вдруг не работает, или работает не так хорошо, как хотелось бы. Движение DevOps как раз решало эту проблему, но эта проблема есть во всех видах инженерии. Например, она есть у официантов и кухни в ресторанах: претензии клиентов слышат официанты, а повара делают своё дело, полностью изолированные от клиентов. Инженерия внутренней платформы разработки была призвана это изменить: разработчики должны были сами развернуть систему и предоставить её пользователю, услышать его вопросы, узнать впечатления/eXperience — а работа операторов по настройке и разворачиванию должна была полностью исчезнуть, она автоматизировалась, её брала на себя инженерная платформа, DevOps превращалось в Dev + NoOps = потому что новая роль «инженеры внутренней платформы разработки» обеспечивали автоматизацию, NoOps. Кухня — и сразу едоки, никаких официантов, а пищу из кухни в зал выносит робот. С роботом не поскандалишь, и робот заодно меньше ошибается и работает быстрее и дешевле.
В системной инженерии «железных систем» этот же тренд DevOps развивался как движение «цифровых двойников», digital twins. Это именно двойники, то есть они похожи друг на друга, а не «близнецы», ибо их природа разная: физический двойник это и есть целевая система, а виртуальный/цифровой двойник — это операционная модель целевой системы. Путь к настоящему цифровому двойнику занимает обычно несколько шагов по связи цифровой модели и физического двойника, отражённых на рисунке:
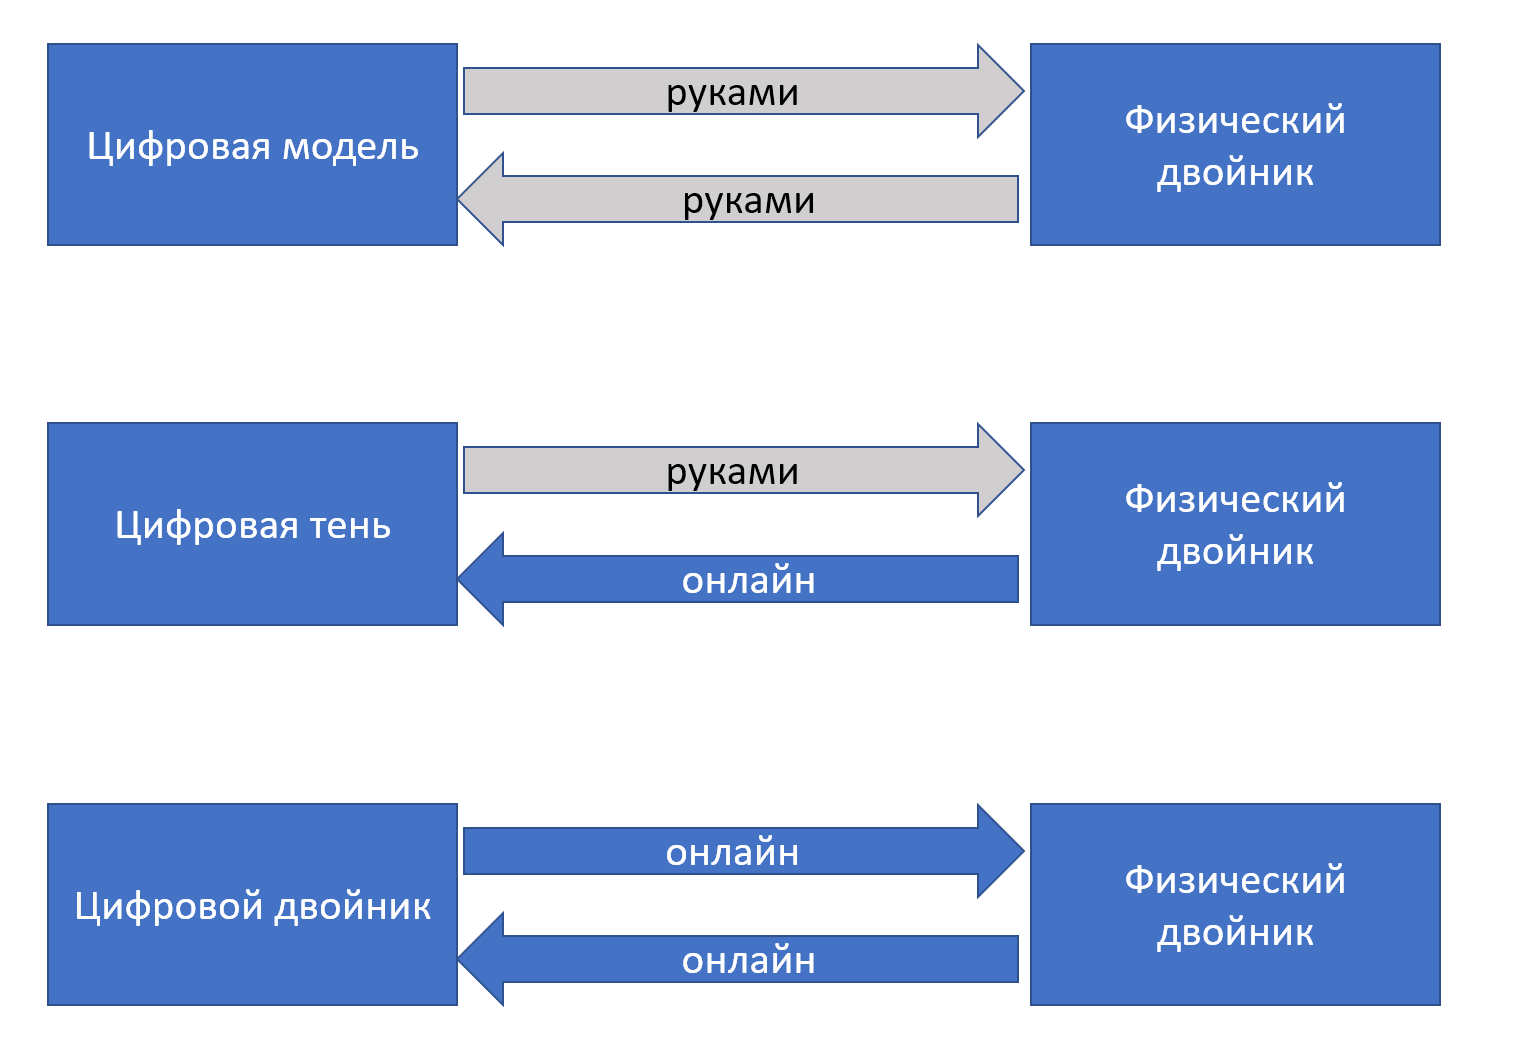
Сначала появляется цифровая модель физического двойника, которая не связана с физическим двойником цифровой нитью. Цифровая модель отличается от обычной мегамодели, используемой в инженерии (в PLM, ERP, EAM и eXperience platforms системах) тем, что она содержит в себе какие-то данные и приложения, работающие с так называемыми историческими данными, то есть данными времени эксплуатации, обычно это значения каких-то характеристик в разные моменты времени, «временны́е ряды». Эти данные анализируются, и по ним принимаются решения о том, как операционные инженеры должны изменить настройки физического двойника, чтобы оптимизировать его работу, или решения о том, когда оптимально провести ремонт физического двойника. Импорт-экспорт данных и с датчиков физического двойника и результатов расчётов оптимальных режимов работы на модели происходят вручную.
Потом налаживается съём информации с датчиков физического двойника в реальном времени через цифровую нить (в онлайн-режиме, постоянно, а не руками и изредка). Цифровая модель начинает в любой момент времени отражать важные характеристики физического двойника, и её называют уже цифровой тенью.
Цифровой двойник — это когда результаты работы цифровой тени в виде предложений по настройкам физического двойника попадают в физического двойника не «вручную», а тоже в режиме онлайн, то есть цифровая тень онлайн начинает рулить физическим двойником, так что она уже не совсем тень. Так что с этого момента говорим о полном цифровом двойнике, а не модели или тени.
Так что цифровой двойник — это автоматизация (гиперавтоматизация, цифровая нить, цифровая трансформация и т.д.), разработки, которая доводится до стадии эксплуатации. Особый упор тут на физическое моделирование и использование данных физического (имитационного) моделирования для настройки эксплуатационных параметров системы.
Особо нужно отметить использование термина «цифровая трансформация» (digital transformation)41. Формально: «замещение бескомпьютерных технологий и ручной работы компьютерными» или «замена более старых компьютерных технологий на новые». То есть формально это ничего не значит, любые изменения в работе, происходящие от замены чего-нибудь компьютерного, например, старого компьютера на новый, старого корпоративного приложения на новое.
Но неформально трансформация означает организационные изменения (появление новых методов работы, поддержанных оргструктурой организации и ресурсами, то есть появление новых оргвозможностей/capabilities), необходимые для интеграции данных и использования цифрового двойника. Цифровой двойник тут относится к системам самой разной природы: автомобиль, космический корабль, пациент, студент, предприятие, завод-автомат, район городской застройки. Ключевое тут то, что мегамодель цифрового двойника заходит в стадию эксплуатации/operations, а не только используется в ходе разработки/development и изготовления/construction.
Концепт цифрового двойника, объединяемого цифровой нитью, оказался очень удачным, и его начали использовать повсеместно вместо специализированных PDM (систем версионирования продукта), PLM (в которых добавлен issue tracker), eXperience platform (добавлены все стадии разработки, а также изготовление и выход на внешние проектные роли). Его начали использовать и в машиностроении, и в медицине, и в строительстве (и даже градостроении, ибо идут разговоры о «цифровом двойнике умного города»), и в образовании — идея захватила массы.
В частности, вы можете не только читать наше руководство как регламент/стандарт мышления и работы, но и использовать его как учебник, проходя стажировку в мастерской инженеров-менеджеров (МИМ). В МИМ для помощи в освоении работы по руководству задействуется информационная система Aisystant. В принципе, её можно отнести к LXP (learning experience platform)42: поддерживается конфигурация учебных материалов (руководства инженеров-менеджеров), которые предъявляются инженерам-менеджерам как стажёрам/учениикам/студентам, поддерживается конфигурация группы текущих активных в части освоения работы по руководствам инженеров-менеджеров (и не только текущих, но и прошлых тоже, это ведь в том числе и система версионирования!), поддерживается учёт наставлений, работу по которым инженеры-менеджеры уже освоили, поддерживается учёт оценок квалификации инженеров-менеджеров в момент эксплуатации освоенного мастерства43. Конечно, это пока не полноценный цифровой двойник (где в реальном времени и без участия людей отслеживается информация о поведении инженера-менеджера, а потом этому инженеру-менеджеру даются рекомендации, как ему оптимизировать свою «эксплуатацию»), но как минимум, это цифровая модель, затрагивающая эксплуатацию уже изготовленного мастерства, эксплуатацию личности после прохождения очередного шага её рабочего, личного, исследовательского развития.
Цифровой двойник — это безмасштабная идея: говорить о цифровых двойниках начали по отношению к каким угодно целевым системам (мостам, городам, пациентам, студентам), и вся эта история про цифрового двойника, провязанного цифровой нитью, только-только начинается44.
Что будет дальше? Дальше, конечно, выход за пределы отслеживания физического двойника и переход к отслеживанию и окружения тоже: выход на отслеживание эволюционного динамического ландшафта приспособленности. И, конечно, использование AI в принятии самых разных решений и роботов в реализации этих решений.
Что отслеживать в проекте в связи с DevOps с опорой на инженерию внутренней платформы разработки? Ведь там множество методов, причём многие из них называют разными терминами, акцентируя разные их аспекты — и прежде всего тут управление конфигурацией и изменениями (в том числе версионирование, интеграция данных, непрерывная интеграция, непрерывный ввод в эксплуатацию)? Конечно, альфы, в данном случае это будут подальфы основных/kernel альф. Как их отслеживать? Сделайте из альф кейсы и отслеживайте прохождение состояний этих альф (прохождение кейса) через issue tracker.
В нашем руководстве приводится изложение самого общего, «безмасштабного» уровня, который не зависит от масштаба и вида целевой системы и создателей. Это уровень мета-мета-модели. Но проблема управления инженерным процессом, в том числе DevOps с инженерией платформы, управления конфигурацией и изменениями, а в последнее время и проблема разработки и эксплуатации цифровых двойников на основе цифровой нити хорошо описаны для целевых систем самой разной природы. Это уровень мета-модели «из культуры».
Чтобы получить искомую мета-модель для предметной области вашего проекта, которую вы будете использовать в вашей проектной культуре, а потом и модель актуальной конфигурации отслеживаемых систем (как целевых, так и их окружения, так и создателей в их графах), и описаний этих систем, нужно будет выполнить адаптацию: перейти от предельно абстрактного языка мета-мета-модели к конкретному языку метаУ-модели из культуры (результат «погуглить» или «спросить AI», итог прохождения университетских курсов и чтения учебников по прикладным дисциплинам), а затем конкретному языку метаС-модели (язык регламентов, руководств, стандартов), принятому в вашем предприятии или предприятии-клиенте.
Поэтому первым делом вам нужно изучить доступную литературу по методам разработки вашей предметной области: она будет основываться на тех же самых принципах, о которых мы рассказали в нашем руководстве, но там может отличаться терминология, а также будут указаны варианты технологии ведения конфигурации целевой системы или системы создания и конфигурации работ, которые применимы в вашей конкретной проектной ситуации с использованием какой-то школы управления инженерным процессом, школы инженерии платформы, приспособленной к системам определённой природы и масштаба.
Больше всего материалов по управлению конфигурацией и изменениями вы встретите по разработке программного обеспечения, главным образом для разработки корпоративного софта. Интересно то, что по большей части этот разрабатываемый софт — это тоже софт управления конфигурацией и изменениями, но каких-то других объектов (если это корпоративный софт для обувной фабрики, то он будет управлять конфигурацией партий обуви, а также конфигурацией самого предприятия-создателя этих пар обуви, то есть будет софтом внутренней платформы разработки и изготовления обуви). Если вы понимаете, как устроен граф создателей в вашем проекте, то вам будет легко разобраться и не запутаться, когда вы говорите об инженерных процессах разных систем в графе создателей и о разных внутренних платформах разработки, которые вам (или не вам) придётся интегрировать в вашем проекте.
Конечно, есть огромное количество вариантов описанных в литературе методов управления конфигурацией и видов производственных платформ и для самых разных других систем. Например конфигурация незавершённого производства в машиностроительном предприятии (операционный учёт) будет храниться в ERP-системе на верхнем уровне учёта и построенного на данных этого учёта планирования, а также MES-системе на уровне цеха — мы это уже упоминали.
Если вы занимаетесь администрированием каких-то территорий, то вам будут помогать геоинформационные системы, а язык какого-нибудь «кадастрового учёта» вообще будет слабо напоминать язык системной инженерии или программной инженерии. Если у вас розничная торговля, то информационная система у вас тоже главным образом учитывает конфигурацию, управляет изменениями, отслеживает конфигурационные коллизии. Принципы управления конфигурацией, тем не менее, будут примерно те же, что мы обсуждали в текущем разделе с медленным движением от «учёта продукта» к «учёту продуктов и работ» и далее выходу к стадии эксплуатации и переходу роли инженера-оператора эксплуатации к компьютерной системе в составе цифрового двойника, а также предоставление доступа к информации производственной платформы внешним проектным ролям (например, роли покупателей и поставщиков). Там и тогда, где и когда вы используете какой-то «учётный софт», там будут вставать общие проблемы управления конфигурацией и изменениями.
Есть, конечно, огромное количество нюансов, которые появляются в ходе адаптации метода. Так, если у вас есть какой-то софт учёта конфигурации, который используется несколькими организациями, то непременно всплывёт идея использовать «распределённый реестр»/блокчейн как способ обеспечить доверие к этой системе. Если учитывать нужно права (обычно тут говорят о ценных бумагах, но это понятие чётко прописано в законодательстве всех стран, поэтому часто говорят о «токенах», чтобы по возможности уйти в «серую зону» для этого законодательства, чаще всего это просто синоним для «ценной бумаги, учтённой в блокчейне как регистраторе»), то возникнет вопрос о различиях юридической защиты в момент, когда «что-то пошло не так». И тут будет разница между депозитарными учётными системами (основанными на римском вещном праве, хорошо проработанный юридический механизм) и регистраторскими системами (основанными на обязательственном праве, плохо проработанный юридический механизм). Конечно, без глубокого знания предметной области (тут это — основы законодательства о рынке ценных бумаг, основы законодательства о денежной системе) не обойтись, и в разных странах это будет ещё и разное знание.
И не надейтесь наладить DevOps в проекте, если вы не знакомы с культурными SoTA вариантами инженерного процесса и SoTA вариантами инструментария внутренней платформы разработки для вашей предметной области! Впрочем, это относится к любым инженерным методам — и прикладной методологии, и архитектуре, и проектированию, не только DevOps. Знания нашего руководства системной инженерии будет достаточно, чтобы вы могли обсуждать связь вашего проекта с многочисленными другими проектами в самых разных других областях, или чтобы быстро разбираться в прикладной инженерии каких-то других систем, для которых у вас нет опыта. Но этого знания совершенно недостаточно, чтобы вести прикладные проекты, профессионально работать, не делать новичковых ошибок!
Так что мы не будем давать примеры возможных подальф, ограничимся только несколькими замечаниями для управления конфигурацией, как важнейшей части DevOps:
-
Подальфы управления конфигурацией в проекте могут относиться как к целевой системе, так и к создателю, так и к работам, так и к описанию целевых систем и создателей. Впрочем, управлять конфигурацией ваших сведений о надсистеме тоже нужно.
-
Инженерный процесс тоже может отслеживаться в проекте как подальфа альфы «метод» создателя (либо создателя целевой системы, либо создателя «нашего» создателя в графе создателей, смотря чей инженерный процесс рассматривается). Эта подальфа может проходить состояния и отвечать на контрольные вопросы адаптированной альфы «метод» (пример состояний альфы «метод» и подробности были в руководстве по методологии, она давалась как подальфа описания создателя).
-
Метод ведения обозначений в конфигурации как подальфа описания целевой системы, но для «нашего» создателя это тоже актуально, вам же нужно создать модель предприятия. Так что и тут вам придётся обсуждать вопрос именования и альф, и рабочих продуктов, и работ. Но ещё и размещений, и даже финансовых величин (помним, что системное описание включает в себя и стоимостное описание, конфигурация включает в себя тем самым и финансовое описание).
-
Конфигурация как подальфа воплощения целевой системы с возможными состояниями: замыслена, версионируется и бэкапируется, ведётся (изменяется, аудируется/обосновывается/проверяется, данные конфигурации управляются, то есть доступны всем, кому они нужны), архивируется.
-
То же можно сказать для версионирования описаний.
-
Конфигурация целевой системы в эксплуатации и версии описания системы ведутся и их соответствие трассируется.
-
Грубо можно описать состояния подальфы цифрового двойника альфы описания системы: цифровая модель, цифровая тень, цифровой двойник.
Никакого жёсткого ориентира для моделирования альф инженерного процесса нет. Даже если посмотреть сам стандарт OMG Essence, то он как раз служит для описания разных вариантов инженерного процесса. То есть «использование альф для отслеживания состояния проекта», «отслеживание состояний рабочих продуктов для отслеживания состояния проекта» — это тоже часть управления инженерным процессом, поэтому так трудно разговаривать об «альфах, описывающих альфы», «рабочих продуктах, документирующих описание другими рабочими продуктами состояний других альф».
Так что проявляйте творчество и гибкость, не будет никаких чётких рекомендаций по тому, как устроить управление инженерным процессом, управление конфигурацией и изменениями, управление инженерной документацией, операционный или какой иной учёт, какого сорта задействовать информационные системы (моделеры конфигурации, в том числе моделеры конфигурации систем, описаний, работ), как создать внутреннюю платформу разработки, интегрировать данные, поставить метод работы DevOps для вашего проекта с вашими особенностями целевых систем и их создателей. Но вы не можете проигнорировать все эти методы, с них и надо начинать проект. Ибо все остальные методы инженерии затем будут основываться на том, что вы как-то управляете вашим инженерным процессом, не пускаете его на самотёк. Вы и ваша команда должна знать: что и как нужно делать и каким инструментарием для этого пользоваться, знать, что происходит в проекте — какие состояния важнейших отслеживаемых в проекте объектов.
Моделирование: цифровые модели, тени, двойники в рабочем проекте
Выпишите три и более цифровых модели, тени, двойника, которые вы используете в текущем рабочем проекте:
| Номер п/п | Название физического двойника (в момент эксплуатации!) | Тип цифрового двойника (модель, тень, двойник) | В какой информационной системе (или ряде информационных систем) поддерживается |
|---|---|---|---|
| 1. | |||
| 2. | |||
| 3. | |||
Задания
Поставьте отметки о выполнении следующих дел.
-
Опубликован пост с вашими мыслями о DevOps, инженерии внутренней платформы разработки и управлении инженерным процессом (по всем материалам руководства и материалам предыдущих заданий).
-
Вы откомментировали не менее трёх постов по материалам текущего раздела, написанных другими инженерами-менеджерами.
Но некоторые архитекторы ещё в 2019 году выражали сожаление по поводу неиспользования термина и ухода от явного обсуждения ситуации, «ИТ-архитекторы же продолжают сидеть в своих башнях из слоновой кости, подобно Винни-Пухам, застрявшим после сытного перекуса в домике Кролика. Даже тег DevArchOps остаётся неизвестен гуглу и воспринимаемся им как бессмысленный набор символов», https://mxsmirnov.com/2019/06/06/architecture-as-a-code/#more-2892.
https://www.litres.ru/atul-gavande/chek-list-kak-izbezhat-glupyh-oshibok-veduschih-k-fatalnym-po/
Тут, конечно, не нужно путать с 6D для экспоненциальных технологий от Peter Diamandis и Steven Kotler (exponential organizations должны быть digitised, deceptive, disruptive, dematerialized, demonetized, democratized, это Singularity University в 2016, когда модно было искать везде экспоненты и единорогов) — https://www.diamandis.com/blog/the-6ds
https://en.wikipedia.org/wiki/Concurrent_engineering, не путайте с collaborative engineering, http://ailev.livejournal.com/943532.html
Подробней смотри серию публикаций https://ailev.livejournal.com/1549559.html, https://ailev.livejournal.com/1548016.html, https://ailev.livejournal.com/1550931.html