8. Инженерные обоснования
Испытания, проверка и приёмка, обоснования
В инженерии вроде бы очевидно, что должны быть какие-то испытания созданной системы, чтобы получить уверенность команды проекта и внешних проектных ролей в её успешности, в том, что проект изменил жизнь к лучшему, а не «хотел как лучше, получилось как всегда».
Тут вопрос о том, уверенность в чём именно обосновывается? Приживается сегодня термин «качество» как удовлетворительные значения архитектурных характеристик, которые называют часто «требованиями качества» (всякие «‑ости», такие как безопасность, надёжность, доступность, ремонтопригодность и т.д.). Термин «обоснование качества»/quality assurance1 для обоснования успешности системы прижился, но он оказался неточен. Обосновывать приходится не только и не столько уверенность в «качестве» системы, то есть уверенность в том, что архитектурные характеристики имеют приемлемые значения, но нужно обосновывать и результативность работы системы, выполнение её функции в надсистеме. К тому же есть некоторое несоответствие между определениями того, чем занимается системная инженерия (созданием успешных систем с расшифровкой, что это учёт интересов самых разных проектных ролей, удовлетворение их ожиданий) и вдруг сведением успешности к просто абстрактному «качеству». Опять же, говорят не про «качественное лечение», а «успешное лечение», не про «качественную жизнь», а «успешную жизнь». Так что мы не будем тут говорить пафосно «обоснование изменения жизни к лучшему», но консервативно будем говорить об инженерных обоснованиях как обоснованиях успешности системы (цель системной инженерии — создание успешных систем, successful systems), а не просто об обоснованиях качества.
Когда мы говорим об инженерных обоснованиях, то чаще всего вспоминается вопрос о безопасности, самый болезненный — и это даже мы не касаемся традиционной путаницы «безопасности» и «защиты» (safety как «система никому не вредит» и security «системе никто не вредит»). Вспоминаются истории о том, что инженер становится под железнодорожный мост, когда по нему едет первый состав, лётчик-испытатель как «инженер-оператор самолёта» (пользователи тут — пассажиры) ассоциируется с повышенным риском и несёт как раз эти «испытания» в своём названии. Испытания — это переход от «голословных заявлений» к evidence-based, то есть заявлениям, основанным на экспериментальных свидетельствах.
Проблема в том, что большинство людей никак не испытывают результаты своей работы, оставляя испытания пользователям сделанных ими систем:
-
у них просто нет культуры это делать, «большинство людей» — это не специально обученные инженеры, которых учат не пропускать испытания! Но иногда об испытаниях забывают даже «специально обученные инженеры», ибо нет письменной культуры планирования и выполнения испытаний — нет чеклистов выполнения испытаний. В проектах мало кто знает, как разрабатывать планы испытаний, как именно эти планы выполнять, и что делать с результатами испытаний (как их трактовать: ожидалось значение характеристики Y как 10, замер показал — 8.3. Это успех или неуспех?!).
-
испытания требуют времени, а времени обычно нет, ибо «время — деньги» (и на испытания легко может уйти даже 85% всех затрат проекта). И всегда ведь есть вероятность, что система просто будет успешной, вдруг она реализуется как раз в нашем проекте?!
-
испытания ресурсоёмки: расходуются и материалы для переработки системой, и экземпляры системы, а ещё требуется дополнительное испытательное оборудование и агенты, которые эти испытания проводят. В бюджете всего этого нет, менеджерам всё это не объяснить, так что «салюта не было по шестнадцати причинам. Первая: нет пороха!».
-
Непонятно, как эти испытания делать. Как испытывать ракету, которая построена в количестве одной штуки и дальше должна лететь на Марс? Этот полёт одновременно и испытывает ракету, и является эксплуатацией ракеты. Как испытывать человека, который заканчивает школу? Ведь испытывать нужно вроде как его готовность к самостоятельной жизни, а проверяется знание математики и литературы, которое мало относится к тому, для чего выполняются испытания. Как испытывать искусственный интеллект, отвечающий на вопросы? Ему ведь наверняка при эксплуатации зададут вопрос, который не предусмотрен на испытании! Как испытывать беспилотный автомобиль? Как испытать сотрудника, которого изготовила для вашего отдела служба найма? Как испытывать общество, которое будет построено по программе правящей партии?
По мере развития инженерии стало понятно, что каких-то испытаний целевой системы недостаточно. Испытанная работоспособная система оказывалась бесполезной, потому как требования с их «испорченным телефоном» недостаточно отражали то, что хотели получить потребители, пользователи, заказчики системы и её сервисов.
Если вы согласились на разработку автомобиля «по требованиям», где указано, что это «автомобиль для торжественных ритуальных сервисов», «плавно трогаться с места и тормозить, ибо речь идёт о крупном городе», то вы вполне можете спроектировать катафалк, когда клиент ожидает от вас свадебный лимузин. Тут помогли бы сценарии использования, прямые контакты разработчика с пользователями, обследование надсистемы разработчиками и архитекторами — и ошибки бы при составлении концепции использования не было.
Проблемы обычно возникают в эксплуатации в составе надсистемы, а не при заводских испытаниях. Такое случается сплошь и рядом: вы покупаете абсолютно работоспособную модную рубашку, которая просто «не смотрится», когда вы её носите. Но она шикарно выглядит, когда висит в шкафу! И даже когда её примеряет сосед! Но носить-то её вам, а она «не смотрится». Нужны ещё испытания, показывающие, что работоспособна надсистема, когда в её составе работает целевая система. Свадьба с автомобилем для торжественных мероприятий, вы с модной рубашкой. Идея, что готовую рубашку можно будет дорабатывать/кастомизировать каждую под конкретный запрос, не приходила в голову: считалось, что это будет запредельно дорого (и при малом уровне автоматизации, плохом управлении конфигурацией это так. Автоматизация делает изменения дешевле).
К этому моменту уже появился системный подход и испытания разбили на два вида: проверку/верификацию/verification и приёмку/валидацию/validation, и оба этих вида начали упоминать вместе вместо слов «испытания», «проверка и приёмка», «verification and validation», сокращённо V&V. Одновременно становилась культура документирования потребностей и требований (до этого формальной дисциплины «инженерия требований» не было, и каждый уж что умел, то умел: документировалось отнюдь не всё). Вместо «испытаний работоспособности» начали проводить два вида испытаний для двух разных систем:
-
Проверка — это испытания удовлетворения целевой системы требованиям. На границе целевой системы наружу выдаётся некоторый сервис (поведение по изменению объектов в окружении), он соответствует описанному (например, водяной насос выдаёт воду под давлением 6 атмосфер). «Какой функциональный объект задумали, такой конструктив и сделали!».
-
Приёмка — это испытания того, что надсистема удовлетворит потребности. Надсистема требует от системы некоторой функции/сервиса, чтобы смочь дальше выполнить свою функцию/сервис по отношению к над-надсистеме (например, из крана на 6 этаже и высоте этажа 3 метра должна политься вода, она не полилась, давления не хватило — нужен другой насос, «что-то пошло не так»). Тут тонкий момент, что удовлетворение модулем функции так, чтобы была удовлетворена потребность — это гипотеза. Вполне возможно, что нужна была чуть другая функция, другое затребованное поведение. А сервис модуля, актуальное его поведение, оказался другим. Более того, тут проблемы могли возникать со стороны архитектурных характеристик, а не функциональных: всё могло работать, но, например, только в ходе испытаний, один раз, при «демонстрации из рук разработчиков». А дальше? А дальше система могла работать ненадёжно, быть недоступной, плохо масштабироваться и т.д. — но это обнаружится уже после испытаний!
Судьба этой новации с одной стороны была счастливой (стали говорить про V&V вместо просто testing, например в NASA программа интегральной верификации и валидации IV&V начала работать с 1993 года2), с другой стороны — мало кто вне аэрокосмической промышленности был знаком с системным подходом. Идея, что проверять нужно работоспособность двух систем (целевой и надсистемы), а не одной только целевой, в массы широко не пошла, пошло только название метода — и мало кто задавался вопросом, почему в названии два разных слова. Автор задавал вопрос участникам крупнейшей российской конференции по тестированию программного обеспечения, чем отличаются verification и validation друг от друга — и внятного ответа не получил, это воспринималось участниками (профессионалами в тестировании софта!) просто как «устойчивое словосочетание», означающее просто «тестирование». То, что разница между проверкой и приёмкой как испытания разных систем прописана во множестве стандартов, даётся в учебниках — это не дошло до массовой практики тестирования.
В водопадной «однократной разработке» деньги платятся обычно по выполнению проверочных испытаний (выполнены требования), а не приёмочных (система успешна), а дальше кто виноват, если проверка проходит, а приёмка нет — это очень спорный вопрос. Переход к непрерывной разработке был, в частности, связан именно с этим: испытывать приходилось неоднократно, вносить исправления в систему приходилось неоднократно, и тут пришлось менять и устройство испытаний (подробно это разбирается в DevOps: как провести минимум испытаний, чтобы после добавления в состав системы каждого инкремента сохранилось высокое качество всей системы) и способы контрактации подрядчиков. Современные контракты на разработку не предусматривают варианта разовой поставки готовой системы, они предусматривают всегда сопровождение, какой-то вариант непрерывной разработки.
И это, заметим, мы не касаемся хода на то, что успешность определяется общим впечатлением, которое получит клиент (customer eXperience, вы можете приготовить шикарный борщ, но если вам придётся его есть в вонючем помещении — общее впечатление клиента будет испорчено, и клиент даже не будет разбираться, это ваш борщ воняет, или помещение, «что-то пошло не так», впечатление испорчено, ожидания не оправдались «от обеда с борщом»). Это очень трудный ход мысли: в инженерном проекте не просто целиться во время эксплуатации системы, которой ещё нет, но и учитывать будущие впечатления/опыт/eXperience тех людей, которые сталкиваются с системой, ибо интересы внешних проектных ролей не совпадают с интересами разработчиков, выпадают из внимания.
Разделение проверки и приёмки, а потом и мониторинг реальных впечатлений пользователей были не последним шагом в развитии метода испытаний. Они оказались только частью того инженерного метода, который должен был давать уверенность в том, что целевая система таки изменяет жизнь к лучшему (сильная формулировка, как мы замечали в первом разделе руководства) или хотя бы является успешной (то есть соответствует ожиданиям проектных ролей, или даже превышает эти ожидания, более слабая формулировка, но пока более распространённая в системной инженерии — и далее с выходом на eXperience). Этот метод получил название инженерного обоснования/assurance — получение аргументированной уверенности в верности каких-то утверждений о свойствах системы (ну, или утверждений о впечатлениях внешних проектных ролей).
В нулевых годах 21 века столкнулись два подхода к инженерным обоснованиям:
-
Обоснование на основе свидетельств (evidence-based assurance, доказательные обоснования),
-
Обоснование на основе процесса (process-based assurance).
Менеджерам (инженерам предприятия, во внимании которых не столько целевая система, сколько система-создатель целевой) полюбилось обоснование на основе процесса, это было закреплено в стандартах «обеспечения качества» серии ISO 9000, разрабатываемых с 1987 года. Этот тип обоснования стал мощной отраслью по торговле сертификатами соответствия требованиям «стандартов качества». Суть была в том, что надо было документировать рабочие процессы, а затем требовать их выполнения в том виде, в каком они были документированы — и подразумевалось, что соблюдение документированного процесса даст вам отличное качество целевой системы. На деле оказалось, что:
-
Использование «стандартов качества» серии ISO 9000 не так уж надёжно в обеспечении качества. Было множество исследований, которые показывали проблемы с результативностью и эффективностью этих стандартов3.
-
Следование процессу совсем необязательно приводит к гарантированному качеству продукта, испытания всё равно оказывались нужными.
-
С подобными стандартами были связаны «ступени зрелости». Компании очень быстро проходили эти «ступени зрелости» — и останавливались в улучшении своих методов работы, ибо их текущие методы оказывались хорошо документированными, дисциплина им следования соблюдалась, и это вместо предполагаемого бесконечного совершенствования процессов оказывалось тормозом в развитии, конечной остановкой. Лекарство оказывалось болезнью!
Системные инженеры поэтому пошли по другому пути: обоснований на основе свидетельств/evidence-based assurance. Это «доказательное обоснование» (по примеру перевода evidence-based medicine как «доказательная медицина», хотя более точный перевод будет «основанная на свидетельствах медицина» и то же верно про инженерные обоснования/assurance) уже было записано в документах по проверке и приёмке. Нет свидетельств, или свидетельства не задокументированы хоть как-то — считаем, что нет обоснований для уверенности в полезности, работоспособности, безопасности, надёжности и т.д. системы.
Ещё один вопрос, как строить на базе свидетельств доказательство того, что с будущей системой (обоснование обычно происходит до момента эксплуатации, это утверждение о будущем!) всё будет в порядке? Для этого лучшим способом оказался метод, похожий на ведение судебного дела: все свидетельства подшиваются в папку «дело»/case и получается документ::«рабочий продукт» «обосновывающее дело»/assurance case, а само доказательство/обоснование строится так же, как доказательство в суде — на основе аргументирования каких-то промежуточных утверждений (в том числе использующих свидетельства/evidence), ведущих к выводам по поводу верности конечных утверждений. Все найденные свидетельства «подшиваются к делу» (то есть документы в папке реально прошиваются ниткой, чтобы исключить возможность их изъятия и подмены, повышая тем самым уверенность в том, что их учтут при общем выводе суда. Отсюда и выражение «шить дело»). В суде заключением по делу (свидетельствам в папке «Дело №____») будет «виновен» или «не виновен», а в инженерии — система признана «успешной» или «неуспешной».
Этот метод «ведения дела» в обоснованиях успешности системы на сегодняшний день в инженерии считается SoTA, хотя давно уже нет никаких папок, а речь идёт о записях в базах данных инженерной документации.
Инженерное обоснование проектного/design и/или архитектурного решения (время замысла и разработки, rationale) отличалось от обоснования успешности готовой системы (время эксплуатации, assurance). Когда говорили rationale, то обосновывали принятое решение, надеясь, что система сработает после того, как будет изготовлена. Когда говорили про assurance, то обосновывали то, что сработает уже изготовленная система.
Скажем, технико-экономическое обоснование (ТЭО) или инвестиционное обоснование (инвестиционный меморандум) — это обоснование того, что система будет разработана «как надо» и после этого «заработает как надо», будет успешна в будущем, это rationale. Но после изготовления системы мы знаем о ней много больше, чем тогда, когда делали обоснование проектного решения (скажем, выбирали вариант архитектуры). И мы должны дополнительно провести обоснование того, что уже готовая система будет соответствовать нашим (и в этом «мы» собраны самые разные проектные роли) ожиданиям, это assurance, и надо, например, провести испытания (например, воткнуть свежесобранный утюг в розетку и поглядеть: не идёт ли из него дым, нагревается ли он до нужной температуры, не бьёт ли током, не забыли ли при сборке утюга какую-то его деталь, не царапает ли ткань его подошва, и т.д. — то, что в проекте всё это было предусмотрено, и были обоснования проектных решений не отменяет того, что эти обоснования могли не оправдаться). Итак, если вы сделали ТЭО и получили финансирование на проект, не лишним будет проверить, не изменилось ли ваше заключение по ТЭО в середине выполнения проекта, и после того, как система сделана. Поэтому rationale раньше всегда выделяли как отдельный вид обоснований, но в современной эволюционной разработке rationale часто просто считают его всех обоснований, включая обоснования на основе испытаний — это просто будет какая-то часть assurance. Главное, что метод обоснований тут один и тот же: логика с опорой на эксперимент (evidence-based: измерения, тестирование, а не чисто «умозрение» и «интуиция»).
Инженер отличается от не-инженера тем, что он относится к инженерным обоснованиям всерьёз: обязательно их выполняет в ходе всего проекта, постоянно тратит на них ресурсы.
Моделирование: обоснования в инженерии
Вспомните последние десять рабочих продуктов в вашем рабочем проекте, которые вы изменяли и потом передавали другим людям и заполните табличку по обоснованию уверенности в том, что результат вашей работы был успешен:
| Номер п/п | Рабочий продукт | Работа с ним | Какие проверки успешности результата вы сделали | Какие проверки успешности результата работы надо было бы сделать | Была ли приёмка? | Остались ли письменные следы о результатах проверок и приёмок? |
|---|---|---|---|---|---|---|
| 1. | ||||||
| 2. | ||||||
| 3. | ||||||
| 4. | ||||||
| 5. | ||||||
| 6. | ||||||
| 7. | ||||||
| 8. | ||||||
| 9. | ||||||
| 10. |
Что обосновывают в инженерии
Есть довольно много разных мнений о том, что следует обосновывать при создании систем, но большинство из них подразумевает однократное обоснование, а не инкрементальное эволюционное/непрерывное обоснование того, что делается:
-
Общую успешность системы (как в суде — чёткий короткий вердикт об успешности. И если завтра система неуспешна — это уже завтра, что с этим делать, непонятно).
-
Соответствие систем (надсистемы и целевой системы) потребностям и требованиям, пункт за пунктом. Проблема испорченного телефона не волнует, ожидается, что потребности и требования тоже обоснованы и «истина, подписанная заказчиком один раз, причём навсегда».
-
Соответствие работы создателя системы каким-то практикам (process-based) в надежде, что это приведёт к успешности системы. Эта идея стоит за самыми разными процессными стандартами серии ISO 9000 и даже стандартами системной инженерии ISO 15288 и программной инженерии ISO 12207, уровнями зрелости процессов (если вы уже достигли зрелых процессов, то всё хорошо, улучшаться дальше некуда, а результаты автомагически должны быть успешными). Если вы вдруг создали вместо борща яичницу, но с соблюдением всех правил готовки и все шаги приготовления у вас записаны, то считаем результат успешным, хотя нужен был борщ (а яичница — это была ваша гипотеза, которую вы уговорили подписать заказчика как требования, но дальше вы её готовили по всем правилам!).
-
Впечатления пользователя. Неважно, что и как делает система, но если пользователь доволен — всё в порядке!
-
… и так далее.
Малопонятно, какой детальности должны быть обоснования. Например, хватит ли обоснования «честное слово, всё будет в порядке!» в письменном виде от генерального конструктора ракеты перед её вылетом на Марс? Или всё-таки нужно проверить хотя бы крупные блоки ракеты и иметь тем самым не одно «всё в порядке», а список частей, у которых «всё в порядке»? Или всё проверять до последнего винтика — но как это сделать в уже собранной ракете? А если у вас каждая ракета как экземпляр отличается от предыдущей множеством улучшений — это требует полного нового обоснования, или часть предыдущих обоснований можно считать проделанной, и какую именно часть, там ведь сложные взаимодействия по линии эмерджентности новых фич, которые добавлены в ракету?
«Обосновывающее дело»/«assurance case» стало ответом на эти вопросы: было признано, что если у вас есть хорошо документированные свидетельства о том, что всё, что можно, было испытано, что нельзя испытать, то хотя бы обсуждено экспертами, то нельзя сделать никаких выводов, если не строить какую-то структуру из взаимосвязанных аргументов/arguments для ответа на общий вопрос о том, удалось ли сделать систему успешной. Всё остальное можно рассматривать лишь как аргументирование в поддержку или опровержение общей претензии/claim на успешность системы. Свидетельства/улики/evidence поддерживают или опровергают какие-то аргументы, а аргументы (все вместе их рассматривают как «структурированный аргумент») поддерживают или опровергают претензию на успешность. И это, конечно, не просто «логические» обоснования, а «причинно-следственные» (вы проходили это в руководстве по рациональной работе).
Для claim может быть много разных вариантов перевода как синонимов-с-нюансами. Так, перевод «претензия» подчёркивает то, что высказанное – не факт, а только претендует быть фактом. Перевод «заявление» -- вполне подходит, но не учитывает, что заявление означает любое высказывание, в том числе и претендующее на то, чтобы быть фактом. Но и не претендующее на это тоже. Гипотеза и тезис – это в науке, относится к объяснениям, а не к выражению создателем уверенности в достигнутых характеристиках. Утверждение – тоже нейтрально. Ещё часто переходят к глаголам: «мы претендуем на то, что наш алгоритм на данной аппаратуре и для типичных данных на входе срабатывает за время, меньшее 0.2 секунды», «мы заявляем о том, что наш алгоритм …». Поскольку мы хотим подчеркнуть, что не обоснованное – не факт, мы как перевод claim берём именно «претензию», хотя, повторим: адаптируйте к своей предметной области.
Главная проблема в инженерных обоснованиях в отличие от судебных доказательств, в том, что речь идёт обычно о будущем времени, а не о произошедшем уже событии. «Виновен» — это про прошлое, а вот «успешна» — это про то, что система в момент эксплуатации будет наносить непоправимую пользу, на неё можно будет положиться, от неё можно будет зависеть, и она не подведёт.
Обоснование тем самым представляется порождающей/generative моделью, в которой мы можем посмотреть на вероятное/возможное будущее. То есть мы строим объяснительную порождающую излагаемую контрфактуально теорию, которая должна дать оценку сюрприза (surprise, термин из байесовской вероятности) неприятных событий при эксплуатации целевой системы в её окружении4.
Какие неприятные события? Прежде всего, это аварии: отказы в работе. Аварии делим на проектные (которые учтены в проекте) и запроектные (которые настолько неожиданны, что в проекте не учтены). Конечно, мало кто реально считает байесовские вероятности и именно «байесовский сюрприз», но в инженерных проектах реально пытаются обосновывать поведение системы в будущих ситуациях не только нормальной работы, но и ситуациях аварийных.
В инженерных обоснованиях тем самым занимаются рациональным (на основе лучших известных нам методов принятия решений) принятием решений о том, можно ли считать инженерный проект успешным и считать успешной целевую систему, которая должна будет эксплуатироваться по итогам этого проекта. Это как начинается с обоснований/rationale при принятии проектных/design (концепция системы — «пишите комментарии с обоснованиями») и архитектурных решений (обязательно писать в ADR обоснование, rationale), так и продолжается проведением самых разных тестов и формулированием выводов на основе этих тестов (это проведение испытаний обсуждается в DevOps/SRE/«platform engineering», ибо должно быть учтено инструментами внутренней платформы разработки).
В больших дорогих проектах «железной» системной инженерии в серьёзно зарегулированных областях (авиастроение, строительство, ракетостроение, военная инженерия и т.д.) обоснование занимает огромное количество времени и выполняется более-менее строго, за это получают зарплату надзорные органы (и часто справедливо говорят, что они получают зарплату за то, чтобы хоть что-то найти — поэтому даже если всё в порядке, они что-нибудь найдут и потребуют исправить, отсюда совершенно неслучайный скепсис по отношению к выполнению их требований).
Делаются претензии/claims на выполнение требований (это же регулируемая государством инженерия, без требований вам не дадут ничего сделать, «испорченный телефон» входит в условия работы), которые не нужно путать с самими требованиями/requirements. Основное отличие претензий от требований в том, что в требованиях модальность деонтическая (долженствования, то есть используются слова «должен», «рекомендуется», «может» и т.д.), а в претензиях — алетическая (существования, то есть используются слова «быть» или «будет», причём в английском это is или will be, а в русском этих слов может и вовсе не быть, разве что в каком-то совсем уж канцелярите будет «является» или «будет»). Скажем,
-
Требование/requirement: для модуля М напряжение на выходе q всегда должно быть больше или равным напряжению на выходе r для всех наборов входных напряжений.
-
Претензия/claim: для модуля М напряжение на выходе q всегда больше или равно напряжению на выходе r для всех наборов входных напряжений.
Эти рассуждения весьма распространены в однократных жизненных циклах классической старомодной системной инженерии. В современной инженерии модальность не деонтическая, а доксическая (веры): для модуля М напряжение на выходе q всегда ожидается больше или равным напряжению на выходе r для всех наборов входных напряжений, поэтому в ответ на доксу (веру) даётся алетика (существование): «всегда больше», а не «всегда ожидается больше» или «всегда должно быть больше».
И вот именно эту претензию в алетической модальности (модальности существования) обосновывают аргументами/arguments, в поддержку которых предъявляют свидетельства/доказательства/evidence. Например, свидетельством о выполнении претензии из предыдущего абзаца могла бы быть таблица самых разных входных напряжений и приведённые для них замеры напряжений выходов q и r, а аргумент — «мы проверили довольно много вариантов входных напряжений, и для всех них оказалось, что напряжение на выходе q больше или равно напряжению на выходе r». Или свидетельством был бы предоставленный образец модуля, для которого нам бы пришлось для построения аргумента самим провести замеры выходов для самых разных входных напряжений и тем самым самим подготовить таблицу.
Идея инженерных обоснований с использованием «обосновывающего дела» (assurance case) в том, что документируются (в программной инженерии ведутся логи/«журналы»)
-
и свидетельства (результаты испытаний и сам факт их проведения, экспертные заключения и т.д.),
-
и аргументы (объяснения, которые кладутся в основу заключения о верности претензии)
-
и сами претензии, которые считаются верными или нет (то есть признали ли мы выполненными требования и потребности, или нет).
Проблема в том, что претензия обычно говорит о тех ситуациях, когда невозможно представить какие-то достаточно убедительные формальные основания, и прежде всего это ситуации-в-будущем, то есть в момент эксплуатации. В предыдущем примере мы могли убедиться, что претензия вполне обоснована на момент проведения замеров. Но будет ли она обоснована, когда модуль M — это модуль ракеты, и он улетит в космос и будет там работать в невесомости и вакууме после всех механических перегрузок, которые у него будут на взлёте? Или после попадания молнии в корпус ракеты, которая несёт модуль M? Но тут ещё важно, что сама ракета с её окружением модуля М, но и сам модуль М будут меняться от экземпляра к экземпляру, современная инженерия давно вышла за пределы однократного прохождении жизненного цикла системы, обоснованность претензии «вчера» ничего не говорит об обоснованности претензии «сегодня» и тем более «завтра».
С гипотезами всё ещё хуже, ибо нельзя «доказать верность гипотезы», можно лишь её опровергнуть, это общий вывод попперианской науки и, как всё более и более становится очевидным, «попперианской инженерии». Наиболее чётко это сформулировано в книге «The Lean startup», 2011 (есть и русский перевод):
Предпринимательство (создание работающей бизнес-модели, то есть понимание того, как инженерия целевой системы будет приносить доход больший, чем расходы на эту инженерию) тут показано как идущее по пути непрерывного уточнения гипотез и непрерывных попыток их обосновать сначала «умственно» на основе инженерных представлений об окружении будущей системы, а затем обязательно в эксперименте-тестировании. Идея тут в том, что испытания жизнью (как в эволюции! Тебя проверяют на соответствие окружающей среде не специальными испытаниями, а просто жизнью — выжил и успел размножиться и вырастить детей, значит хорош. Не успел — ну, не успел. В биологии это «умер», а если «все умерли», то «вымер», в техноэволюции — «давайте что-то переделаем и продолжим») это самые главные испытания, и инженерное обоснование базируется на том, что потребители и все остальные внешние проектные роли довольны системой, то есть дело не в соблюдении каких-то характеристик, а в eXperience.
Это не последняя книга серии, в которой поддерживается идея обязательного столкновения идеи с жизнью для обоснования успешности продукта, в том числе успешности достаточной, чтобы вкладывать силы в массовое производство. Eric Ries5 (автор «The Lean Startup») — это ученик Steve Blank6, который не остановился на идеях курса по стартапам, изложенного его учеником в «The Lean Startup» и через год (2012) написал с Bob Dorf ставший классическим в современном образовании серийных предпринимателей учебник «The Startup Owner's Manual»:
В этом учебнике подчёркивается, что идею продукта нельзя найти в том здании, где находится разработчик — надо выходить из здания и общаться с внешними проектными ролями там, где находятся эти проектные роли с их eXperience. Но более того: пока не удалось в ходе постоянных итераций сделать MVP, испытать бизнес-модель — нельзя даже думать об организации службы маркетинга!
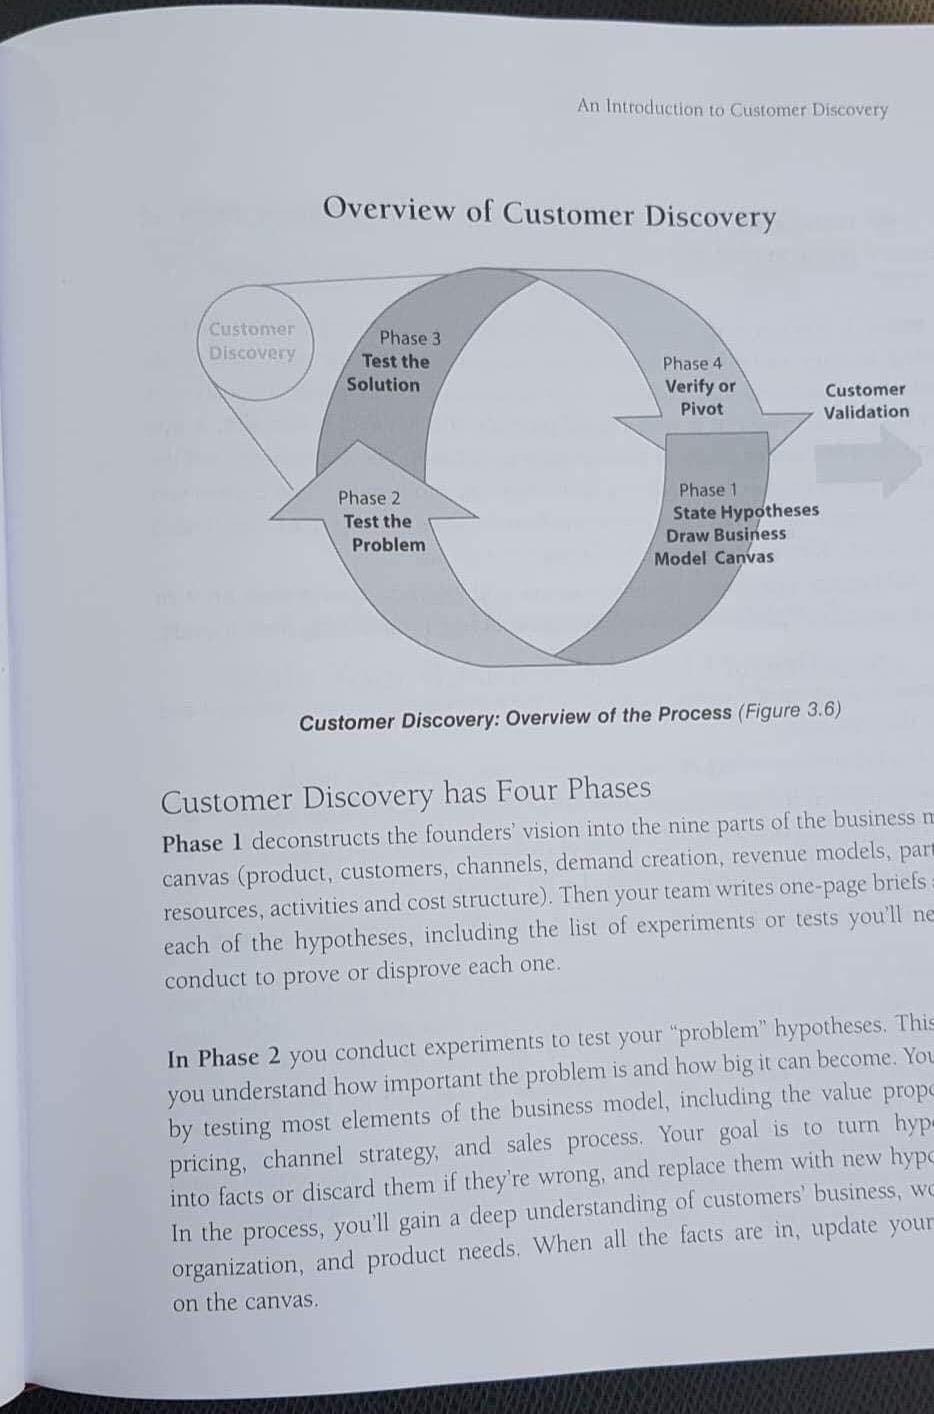
Каждый шаг при создании стартапа (не только продукта, но и создателя продукта!) надо проверять, что вы его сделали надлежащим образом. Для этого в книге используются чеклисты — те самые чеклисты, с которыми мы хорошо знакомы по нашим руководствам. И посмотрите, какое внимание уделяется там экспериментам, это типичная страница в книге, смотрите сколько раз там упомянуто слово test и experiment (для получения свидетельств/evidence), verify, хотя разговор вроде бы идёт не о тестировании, а о выявлении/discovery. Конечно, вначале высказывается гипотеза/hypothesis — и дальше её тщательно проверяют, а затем не успокаиваются — и переходят к тому, чтобы принять/validate:
Подход инженерии платформы разработки в рамках DevOps не снимает множества вопросов — но подталкивает к тому, чтобы автоматизировать все испытания и на основе этих испытаний выдать результат: инженерное обоснование. Скажем, мы меняем в огромном самолёте винтик в кресле пассажира, формально это ведь изменит конфигурацию! Должны ли мы провести полноценные лётные испытания после этого? А если поменяли не винтик, а двигатель? А если поменяли материал крыла, взяли другой композитный материал? Если мы сертифицировали какую-то конфигурацию операционной системы на выполнение всех требований безопасности (тут «требования», ибо деонтическая модальность со стороны регуляторов: «должны», и в проекте это «должны» не обсуждается!), а потом поменяли три каких-то модуля в связи с замеченными в них потом ошибками — считаем ли, что это уже другая версия операционной системы, и она опять должна пройти все сертификационные проверки? Мы проверили, что тренировочный центр для собак сумел научить пять собак подавать лапу и не кусаться почём зря. Считаем ли, что этот центр сможет учить этому всех остальных собак? А если в нём заменили после проверки половину инструкторов? А если заменили всех инструкторов? А если речь идёт не о следующем дне после проверок и испытаний, а о нескольких годах после? В DevOps обоснование успешности системы тяготеет сегодня к автоматизации испытаний, и это начинается с того момента, когда разработчик описывает ожидаемое поведение системы (функциональность) сразу на языке тестирования. Это верно пока главным образом для разработки софта, но по факту распространилось уже и на передовое машиностроение, и на многие другие отрасли. Испытаний, тестирования, экспериментов в инженерии становится всё больше и больше — а чтобы жизнь от этого не остановилась под грузом непосильных затрат времени и средств, эти испытания (включая A|B тестирование7 новых фич, проверку fitness functions) автоматизируют — а часть их выносят в мониторинг, сама система для себя становится автоматическим испытательным стендом.
Ещё одно осложнение связано с принципиальной многоуровневостью оптимизации межуровневых конфликтов, которую пытается решить предлагаемая целевая система. Это означает, что обосновывать нужно выполнение каких-то требований и потребностей на многих уровнях, в том числе учитывать и отдалённые во времени последствия, то есть решения по обоснованию придётся принимать отнюдь не только по проверочным (целевой системы) и приёмочным (надсистемы) испытаниям, но и возможно придётся разбираться со многими уровнями проверок и приёмок, и ещё строить общий аргумент для вывода о многоуровневости в успешности системы (что выглядит успешным для одного уровня, может выглядеть абсолютно неуспешным для другого уровня: вас не отпустили в отпуск с работы и заставили проработать лишнюю неделю, и для уровня организации это успех, а вот для вас лично — не очень. Считать ли проект организации по организации вас на работу вместо отпуска прошедшим обоснования? Вроде бы и требование выполнено — вы не ушли в отпуск, и потребность организации удовлетворена, она смогла закончить какой-то проект. Но вы крайне недовольны и уже договорились о переходе в другую фирму, от которой не ожидаете таких «успешных проектов». Считаем ли мы до сих пор результаты проекта по вашей задержке на работе обоснованными, проект успешным?).
Понятно, что в этих ситуациях всё равно придётся принять решение, и метод ведения обосновывающего дела (assurance case) предписывает документировать не только разные свидетельства/evidence, которые нужны для принятия решения о рациональной обоснованности претензии/claim, но и сам способ обоснования того, как было принято решение, то есть вид аргумента/argument.
Рациональность обоснований
Обоснования успешности сложных классических инженерных систем (важное программное обеспечение, киберфизические системы типа ракеты или атомной электростанции) помогают проводить инженерные стандарты. Большинство стандартов инженерных обоснований использует классические теории решений, где рациональность отождествляется с математической логикой, хотя и позволяется от этой логики отходить в сторону разных «экспертных» заключений в тех случаях, когда строгая логика не работает. Общая тут отсылка — это судебные дела, где предполагается строгое рациональное аргументирование решения на базе каких-то свидетельств/улик. Сама по себе эта отсылка должна как-то настораживать, ибо в судах расследуется что-то прошлое (поэтому вердикт однозначный), а в инженерии речь идёт о чём-то ожидаемом, и эти ожидания наверняка будут меняться со временем, даже если они обоснованы в текущий момент.
В основе традиционного однократного обоснования лежит обычно метод картирования аргументов (argument map). Он не очень удобен, ибо чаще всего даётся в диаграммной форме (часто пишут как argument diagram)8. Этот метод реализован в довольно разной терминологии в самых разных стандартах инженерных обоснований для водопадной модели однократного прохождения жизненного цикла, которые помогают как-то унифицировать ведение обосновывающих дел главным образом в «железной» инженерии крупных инженерных систем (часто с госфинансированием и жёстким регулированием инженерной деятельности со стороны госорганов самых разных стран). Это прежде всего стандарты:
-
IEEE/ISO 15026 «Systems and software engineering — Systems and software assurance»9 (в русском переводе assurance перевели как «гарантирование», что плохо отражает инженерную суть дела10), четыре его части в разных версиях вышли в 2011-2021 годах.
-
GSN, Goal Structuring Notation Community Standard11, версия 2 вышла в 2018 году.
-
OMG SACM, Structured Assurance Case Metamodel12, версия 2.2, вышла в 2021 году
-
CAE framework, Claims, Argument, Reasoning13, разработка Adelard LLP. с 2007 по настоящее время14. Именно этот фреймворк поддерживается наиболее распространённым софтом для построения обосновывающих дел, ASCE15. Впрочем, и для всех остальных вариантов достаточно моделеров, все они строят дерево обоснования, для простейших случаев рекомендуют использовать любой софт Mind Map для отображения деревьев, но и аутлайнеры (в том числе outliner в MS Word) с этим справляются, если отойти от диаграммной формы для дерева и перейти к списку с гнездованием/отступами.
-
Assurance 2.0 framework16, разработка 2020 года. Основная тут цель — это поддержка инноваций (ибо любое новое инженерное решение кажется при традиционных обоснованиях подозрительным и ненадёжным) и инкрементальное построение обоснования (более совместимое с agile).
-
… и это ещё далеко не всё. Стандарты «де юре» (нейтральные по отношению к инструментам разных поставщиков), разработанные организациями стандартизации и стандарты «де факто» (стандарты, задаваемые конкретным программным инструментарием) для assurance case более чем распространены, а ещё они часто не отдельны, а входят в самые разные другие стандарты.
Практически идентичные идеи структурирования обоснований на основе аргументов лежат в основе стандартов целеориентированной инженерии требований (GORE, goal-oriented requirements engineering), где упор делается на то, что требования должны быть обоснованными, равно как обоснованными должны быть и претензии на удовлетворение этих требований. Все эти стандарты появились существенно раньше примерно 2015-2016 года, когда инженерия требований перестала восприниматься как живой, активно развивающийся инженерный метод. В основе всего этого движения был агент-ориентированный фреймворк i*17 ещё 1995 года и основанный на нём стандарт ITU-T 151 User Requirements Notation (URN) с его диалектом Goal-oriented Requirement Language (GRL). Есть работы, которые показывают, что типичный стандарт инженерных обоснований ISO 15026 легко отображается на GRL, и сам этот стандарт ISO 15026 может думаться как подмножество GRL за минусом агентской ориентации GRL18. Такие же стандарты начинают появляться в области обоснований принятых решений (rationale).
Обоснования успешности/assurance (часто переводят как «обоснование качества» или «гарантирование качества»), обоснования решений/rationale (например, архитектурных решений, architecture rationale) все имеют общую природу — обоснования/assurance, иногда их называют и рассуждениями/reason, и доказательствами/proofs, и аргументированием/argumentation.
Все эти стандарты сделаны для того, чтобы было легче находить ошибки аргументации. Обратите внимание, что чаще всего в обоснованиях делают не ошибки проведения испытаний, или моделирования, или экспертизы, а именно ошибки аргументации — ошибки вывода заключения на основе каких-то свидетельств, то есть логические ошибки, в том числе ошибки в причинных рассуждениях (causal inference). Рациональность как метод принятия решений на основании причинных рассуждений в условиях неопределённости объяснялась в руководстве по рациональной работе. Но до причинности (и связанной с причинностью контрфактуальностью) в инженерных обоснованиях часто не доходят, довольствуются простыми проверками «формальной логики», а не проверками логики причинности.
В частности, стандарт ISO 15026-2 ссылается на работу «A Taxonomy of Fallacies in System Safety Arguments»19, в которой приводится классификация ошибочных аргументов (заблуждений/fallacies) и приводятся их примеры в хорошо известных обоснованиях. Вот эта классификация:
-
Circular Reasoning
-
Circular Argument
-
Circular Definition
-
-
Diversionary Arguments
-
Irrelevant Premise
-
Verbose Argument
-
-
Fallacious Appeals
-
Appeal to Common Practice
-
Appeal to Improper/Anonymous Authority
-
Appeal to Money
-
Appeal to Novelty
-
Association Fallacy
-
Genetic Fallacy
-
-
Mathematical Fallacies
-
Faith in Probability
-
Gambler’s Fallacy
-
Insufficient Sample Size
-
Pseudo-Precision
-
Unrepresentative Sample
-
-
Unsupported Assertions
-
Arguing from Ignorance
-
Unjustified Comparison
-
Unjustified Distinction
-
-
Anecdotal Arguments
-
Correlation Implies Causation
-
Damning the Alternatives
-
Destroying the Exception
-
Destroying the Rule
-
False Dichotomy
-
-
Omission of Key Evidence
-
Omission of Key Evidence
-
Fallacious Composition
-
Fallacious Division
-
Ignoring Available Counter-Evidence
-
Oversimplification
-
-
Linguistic Fallacies
-
Ambiguity
-
Equivocation
-
Suppressed Quantification
-
Vacuous Explanation
-
Vagueness
-
Один из выводов этой работы ещё и в том, что люди — это очень плохие критики, в одних и тех же текстах даже стандартизированных инженерных обоснований разные даже очень квалифицированные люди находят разные ошибки, и иногда эти ошибки даже из одной категории предложенной классификации не пересекаются друг с другом, один инспектор её видит, а другой не видит, и наоборот.
Подключение искусственного интеллекта тут пока плохо помогает. Есть работы, которые демонстрируют, что искусственный интеллект, построенный на нейронных сетях, тоже склонен делать такие же ошибки, как и люди20. Хотя простая просьба «проверь перед тем, как отдать результат» существенно повышает вероятность правильного ответа21, но этот шаг проверки-приёмки надо запланировать и сделать! AI будет ведущим трендом, ибо несмотря на всю свою слабость его работа обходится дешевле работы людей, он работает быстрее, а также каждые полгода его умственные возможности растут с каждой новой моделью, с каждым новым доступным инструментом, а вот возможности людей –не растут, люди остаются прежними, весьма склонными к ошибкам и весьма сопротивляющимися тратить время на дополнительные проверки.
Есть и множество других работ, которые анализируют предвзятости человеческого мышления (cognitive biases), которые ведут к ошибкам аргументации22. Тем не менее, исследования показывают, что люди — это очень плохие формальные логики, они лучше как байесовские вычислители, и при этом довольно неплохи как квантовоподобные вычислители. Квантовоподобные23 (не путать с квантовыми! Это не квантовая физика, а математика, которая используется в том числе в квантовой физике) модели оказываются довольно точно соответствующими реальности24, так что как относиться к этим число логическим «предвзятостям» — не очень понятно. Более того, поиск таких предвзятостей обычно абсолютно отвлекает от сути дела: теряется предмет обсуждения, цели обсуждения, насколько важно искать именно логические предвзятости или же лучше делать что-то другое (например, поставить дополнительный эксперимент) в условиях дефицита мыслительного ресурса.
Инженерные обоснования в ходе эволюционной инженерии надо делать непрерывно (continuous assurance), нельзя «сделать и забыть». По факту создателями системы реализуется модель active inference25, в которой система-агент имеет
-
границу с окружением,
-
порождающую модель себя,
-
порождающую модель окружения,
и непрерывно принимает решения по изменению и моделей себя и окружения, и физических себя и окружения, чтобы минимизировать предсказанный негативный сюрприз (то есть выжить).
В инженерии всё то же самое, но поскольку целевые системы до сих пор довольно безмозглы (если это не агентные AI-системы26, которые становятся всё умнее и умнее), всё это моделирование и работы по изменениям на основании итогов моделирования делается создателями системы. Тут ещё и слово «создатель» имеет оттенок однократности: вроде как «создал, и система есть». Нет, читать это слово нужно как «создатель MVP системы, а дальше он непрерывно продолжает развивать систему». То есть «создатель-развиватель», мы это неоднократно подчёркивали.
«Сопровождение» (maintenance) раньше включало в себя только поддержание работоспособности системы, а сейчас включает в себя развитие системы (иногда пишут modification или continuous adaptation), и даже смена слова на «поддержка» (support) не совсем тут адекватна. Речь ведь идёт о непрерывном вводе в эксплуатацию новых и новых возможностей системы. Увы, пока непонятно, как об этом говорить в части инженерных обоснований, устоявшихся общепризнанных методов и фреймворков нет.
Оказывается, нельзя говорить и об обосновании как чём-то, что переводит систему из состояния «свойство не обосновано» в состояние «свойство обосновано», ибо речь идёт уже не о статической системе, а о быстро меняющейся системе. «— Посмотри, у меня поворотник на машине работает? — Да, смотрю. Работает, не работает, работает, не работает…». Обоснованность тут меняет своё значение, она говорит о том, что если что-то окажется необоснованным, то оно будет замечено, в какой бы момент проекта (когда эксплуатация уже идёт!) эта необоснованность ни появилась.
И тут нужно ещё помнить, что обоснования требуют затраты ресурсов: если вам нужно обосновать использования винтика под крестообразную отвёртку или под обычную, это будет одно обоснование. Если этот винтик как-то существенно оказывается связанным с надёжностью получающейся системы и скоростью её изготовления и ремонта, то вы ещё подумаете о других развилках (сварка, 3D-печать, болт и гайка, клеевое соединение и т.д.). Цена вопроса тут совсем другая, но всё одно обоснование вряд ли потребует много ресурсов. Но вот если какое-то ваше проектное/design или архитектурное решение требует выделения $2 млн., то объём обоснований будет существенно больше, а при $2 млрд. может оказаться и нелинейно больше, при этом «непрерывное уточнение функциональности, архитектуры и учёт изменений окружения системы» и прочие ваши трудности с рассуждениями мало кого будут волновать. Ещё одна проблема в том, что вы легко сможете отбиться, изобразив «формальное обоснование в полном соответствии со стандартами»: часто речь идёт о выделении не личных денег, а вполне себе обезличенных каким-то «фондом», собранным инвесторами в лучшем случае, или денег госбюджета, которые гарантированно не принадлежат распорядителям этих денег, и поэтому этим распорядителям могут быть важны не собственно обоснования, а убедительная демонстрация того, что какое-то внимание обоснованиям таки было уделено. Так что содержание обоснований не посмотрят, критику аргументации вести не будут, continuous delivery с его «проверкой гипотез» обсуждать не будут, но на любые несоответствия формы записи обратят особое внимание, будьте к этому готовы.
Если у вас политический проект, то на рациональность обоснований и вовсе смотреть не будут, а за рассуждения о том, что какая-то «программа партии» выражает гипотезу успешности будущей общественной системы, а не гарантирует успешность просто фактом своего наличия, так и вовсе накажут.
Почему это всё важно? Мышление происходит на основе высказывания каких-то догадок, часто ошибочных. Чисто логически нельзя доказать догадку, но можно её опровергнуть, показав ошибочность аргументации в её поддержку. Поэтому качество мышления зависит от нескольких факторов:
-
Качество выдвижения догадок. Нужно быть достаточно безумным фантазёром, чтобы выдвинуть догадку, до которой раньше никто ещё не додумался. Догадки должны быть «умными», а не совсем уж случайными. Эволюция должна быть не совсем уж методом проб и ошибок: все пробы должны быть крайне вероятными в части их возможного успеха.
-
Качество критики. Все ошибки в догадках должны быть обнаружены как можно раньше. И вот тут помогает логика. Логика не может дать качественную догадку, догадки не выводятся из данных, но зато на основе данных можно качественно прокритиковать догадку. Инженерные обоснования не говорят, как получить успешную систему. Но они не дают получить неуспешную систему, они прямо указывают на её неуспешность и дают границы для уверенности в успехе.
-
Ресурсы, которые вы можете потратить как на выдвижение догадок, так и на критику. Ибо пока толстый сохнет, тонкий сдохнет. В конечном итоге на рынке (или в политической борьбе, или в экосистеме — инженерии бывают очень разные) победит тот, у кого хватит ресурсов больше выдвигать догадки, жёстче их критиковать и больше экспериментировать в реальной жизни.
Задания
Поставьте отметки о выполнении:
-
Найдены десять ошибок в инженерных обоснованиях вашего проекта, они задокументированы в произвольной форме, для каждой ошибки указан её вид (назван вид заблуждения или предвзятости из какой-то выбранной вами классификации).
-
Подготовьте инженерное обоснование для какой-то части вашего рабочего проекта, использовав структуру «претензия — аргумент — свидетельство». Для каждого свидетельства в аргументе оцените достаточность проведённых испытаний.
Обоснование выполнения требований стандартов (compliance)
Стандартизация в инженерных обоснованиях идёт по двум вариантам:
-
или стандартизация формы самого обоснования (assurance case с аргументацией, или произвольное эссе, или обязательное решение комиссии независимых экспертов, и т.д.)
-
или стандартизация требований к системе, выполнение которых (compliance, подчинение требованиям) надо обосновывать (если это стандарт, то в нём — требования, а не «гипотезы» или даже use cases).
Проблемы со стандартизацией формы обоснования — это прежде всего трудоёмкость формализации: как выделение отдельно претензий, отдельно аргументов, отдельно свидетельств, отдельно сведение всего обоснования в связную непротиворечивую структуру, так и дополнительные работы по исправлению ошибок (жёсткая форма подсвечивает ошибки, которые легко пропустить в неформальном тексте). Результат стандартизации формы обоснования получается качественным, но дорогим, и тут нужно быть начеку: не слишком ли дорог этот качественный результат? Насколько экономически обоснована лишняя жёсткая формализация?
С обоснованием выполнения требований предметных стандартов (compliance) тоже часты трудности. Часто оказывается, что эти «требования стандартов» не в меру безумны, особенно для стандартов безопасности и защиты, ибо в порядке «ужесточения норм безопасности» в какой-то момент уровень требуемой характеристики становится уже такой низкий, что его непонятно как измерить на фоне шума (ниже естественного природного фона, или погрешности измерительной аппаратуры — решение ведь принимают политики и менеджеры, а не инженеры, такое, например, было на Калининской АЭС, когда для очередного энергоблока оказалось можно брать воду из местного ручья, но нельзя было её возвращать после использования на станции для охлаждения — уровень естественной радиации этого ручья был больше, чем разрешалось стандартом для сброса воды со станции), или же речь идёт о таких редких событиях, что нельзя продемонстрировать статистику (например, аварии автомобилей без водителя: они слишком редки, чтобы можно было делать уверенные выводы о безопасности или опасности таких автомобилей по сравнению с автомобилями с водителем. Можно предлагать результаты моделирования столкновений, но стандарты обычно требуют испытаний «в натуре», а для них данных обычно бывает абсолютно недостаточно для хоть какой-то уверенности). Часты ситуации, когда достижение желаемых уровней безопасности очень и очень дорого, а сам уровень установлен произвольно политиками. «Человечество разучилось рисковать», как сказал Элон Маск, когда комментировал жёсткие требования лицензирования полётов в космос. Это всё проблемы, которые нельзя обычно решить на уровне одного проекта, это чистой воды «политика». Опять же, понятие «безопасность» все понимают по-разному, ибо решения принимаются часто политиками как социальными инженерами, а не инженерами по образованию — и понятие «опасность» в нормативных документах рассматривается по-бытовому27.
Но иногда бывает наоборот, отсутствие compliance обходится очень дорого. 42-тысячный Эрзинь находится на юге Турции, в центре провинции Хатай. В результате произошедших 6 февраля подземных толчков разрушены здания во многих районах Хатая, кроме Эрзиня. В городе не появилось не только развалин, но и хотя бы обломков, а ни один местный житель в итоге не пострадал. Все здания в городе остались целы, потому что мэр города Эрзинь Оккеш Эльмасоглу не разрешал строительство с нарушениями стандартов. А почему здания в других районах Хатая были разрушены? Потому что там соблазнились более низкими ценами на строительство. Compliance — это дорого, но не всегда безумно.
Стандарты безопасности бывают сформулированы по принципу контроля результата (performance-based) или контроля способа (design-based). Конечно, нужен результат, но соблазн перейти на design-based велик, ибо в разы проще проверять (например, не «прочность балки должна быть достаточной, чтобы выдерживать нагрузку в 100 тонн», а «использовать квадратную балку из стали XYZ и стороной квадрата 10см, лежащую на опорах с шагом не шире 1м»). Но тут проблема в остановке инноваций, ибо если будет изобретён какой-то новый способ выдерживать нагрузку в 100 тонн (какие-нибудь углепластиковые балки, лёгкие и прочные), то их использовать в случае performance-based стандарта будет можно, хотя нужно будет предоставить расчёт и результаты испытания, а вот в условиях design-based стандарта их использовать будет нельзя, разве что нужно будет менять сам стандарт (смена стандарта — это проект масштаба отрасли, а не масштаба конкретного проекта). Скажем, стандарты атомной промышленности США performance-based, а атомной промышленности России (по наследству от времён ещё СССР) design-based. Поэтому сертификация безопасности российских атомных станций в мире весьма затруднительна, если только какая-то страна не берёт за основу своей сертификационной системы весь пакет design-based стандартов и не соглашается на фактическую остановку прогресса на технологиях, закреплённых этими стандартами много десятков лет назад. Что там конкретно выбрано в качестве структуры аргументации внутри самого проекта, какой из многочисленных стандартов нотации и формализации, тут уже не имеет значения: просто некоторые аргументы не принимаются «в силу законодательства», речь уже не идёт о рациональных рассуждениях и теориях решений: решения были сделаны давно, не рационально, другими людьми в другой ситуации.
Если начинать на уровне отрасли/сообщества (а часто и общества) исправлять ситуацию и принимать какие-то рациональные решения, то эти решения имеют огромную цену реорганизации отрасли, в которой давно всё налажено и работает, хотя и не рационально: представьте себе цену смены ГОСТов в России, где на них ориентирован и весь станочный парк, и документация предприятий, и транспорт, и обученные миллионы людей. Эти исправления обычно явно выходят за пределы решений одного инженерного проекта, они выходят на уровень работы с сообществами и даже обществом.
Но на уровне общества могут работать ровно обратные механизмы, поскольку можно политически предложить явно лишние меры по защите и безопасности, в том числе и предъявление развёрнутых формальных обоснований даже там, где они не нужны — и обоснование этих явно лишних мер сделать за счёт денег налогоплательщиков.
Не забываем, что большинство стандартов для инженерных обоснований в форме «обосновывающих дел» зародились где-то в середине нулевых годов 21 века, когда резко повышались требования к безопасности чего бы то ни было со стороны законодательства. Это легко наблюдать, например, на законодательстве о детях: всю историю человечества они свободно играли на улицах практически в любом возрасте, а вот сейчас их нельзя одних выпускать из дома до 12 лет (это даже не ученики начальной школы, это пятый класс!). Можно отдельно обсуждать причины этого явления, но в системной инженерии обойти это обсуждение нельзя: происходящее в конкретном инженерном проекте на уровне технических решений целевой системы и в проектах организаций графа создателей определяется в существенной мере и тем, что происходит в сообществах и обществах, в которых происходят эти разработки и последующая эксплуатация систем.
Ещё одна проблема стандартизации обоснований в требованиях визуальных/диаграммных языков моделирования. Эта мода появилась ещё в конце 20 века, но в жизни они не получили большого распространения: софт для такого моделирования уникальный и дорогой. Хуже всего то, что визуальные модели невозможно вести/изменять (то есть трудно вести/изменять «обосновывающее дело»), их очень трудно ставить под контроль конфигурации, сравнивать и модифицировать, интегрировать с другими моделями. Так что все эти стандарты формы обоснования получили ограниченное распространение за пределами госзаказа с его неограниченными деньгами и неограниченными требованиями к обоснованиям.
Но несмотря на все эти трудности, обоснования в инженерии остались, принципы обоснования на базе документирования свидетельств и явного изложения аргументов, использованных при рассуждении, остались.
В стандартизации сама известность процедуры обоснования соответствия стандарту (compliance) делает стандарт стандартом в отличие от просто «публичного документа», например, «фреймворка» (описание того, какие объекты внимания важны в предметной области, советы «как думать»). Скажем, известный cистемноинженерный фреймворк CPS PWG (Cyber-Physical Systems Public Working Group) Cyber-Physical Systems (CPS) Framework28 — это публичный документ, ибо для него не предусмотрено, как обосновывать следование этому документу. ISO 15288:2023 предусматривает обоснования того, что система-создатель какой-то системы следует предписаниям этого стандарта. Все положения этого стандарта следуют рекомендациям стандарта ISO 33001:2015 (он заместил более древний стандарт ISO 15504:2004 SPICE) по оценке процессов (process assessment). Это означает, что известна процедура, по которой можно оценить, следует ли какая-то разработка положениям стандарта ISO 15288 (и варианта его для программной разработки ISO 12207), и в какой степени следует. Это не означает, что вы прямо-таки должны следовать положениям этого стандарта и должны проводить оценку, но это означает потенциальную возможность: известность процедуры.
Обоснование соответствия стандарту — важная часть стандартизации, а стандартизация — важная часть системной инженерии. Обосновав соответствие стандарту (например, что вилка вашего электроприбора соответствует стандарту), вы исключаете необходимость обоснования (например, путём испытаний) соответствия вашего продукта огромному числу других продуктов (например, огромного числа розеток для этой вилки). Если вы сделали компьютерную клавиатуру, и она следует стандартам компьютерных интерфейсов (USB или Bluetooth), то вам нужно только, чтобы она честно следовала этим стандартам, и испытывать нужно именно это соответствие/compliance стандартам. Не нужно будет проверять работоспособность клавиатуры во всех возможных режимах со всеми потенциально возможными компьютерами, док-станциями, удлинителями кабелей и т.д.
Инженерное обоснование деятельно, оно требует ресурсов
Инженерное обоснование выглядит как некоторое рассуждение, которое изложено в структурированной форме, легко посчитать его чисто «умственной работой», ноль требуемых ресурсов — но это глубоко не так. Информацию/свидетельства/evidence для рассуждений нужно добыть, чтобы снизить неопределённость в суждениях, а это часто означает необходимость проведения экспериментов/тестирования/испытаний (для которых часто надо ещё и построить какие-то испытательные стенды), а затем только нужно провести рассуждения (сформулировать аргументы, что тоже требует ресурсов), проверить на отсутствие ошибок, документировать этот результат, но главное — затем принять всерьёз, то есть воплотить результат в жизнь, проявить «политическую волю» (а это может быть нелегко, но если результаты обоснования не использовать, то его можно вообще не делать — надеяться на «авось», работать, возможно, в заведомо неуспешном проекте).
Стандарты тут не помогают, ибо они говорят про то, что без обоснования в документированном виде (а хоть и в виде логов автоматизированного прохождения тестов и оценки того, что «тесты прошли», безо всякого аргументирования, если сможете показать, что это и есть «документирование обоснований») обойтись нельзя. Обычно стандарты задают только форму записи результатов инженерного обоснования, но ничего не говорят, как именно получить это обоснование, какими мыслительными процедурами.
Что считать рационально обоснованными решениями? Обычно такими решениями называют решения, выработанные согласно SoTA известным человечеству теориям решений (мы уже касались этого вопроса, когда говорили о прохождении развилок/trade-off studies):
-
Нужно быть lean, если проблема неважна, то просто её не решаем.
-
Если важна, то шаг формализации того, чего нужно достичь, какую проблему решаем (и тут нужно понимать, что пока вы занимаетесь решением проблемы, обстоятельства могут измениться, проблема может «поплыть», формализация станет сомнительной). В формальной постановке проблемы проще находить ошибки, без этого нельзя.
-
Сгенерировано какое-то количество альтернатив (уже известных, или новых). Нет альтернатив — плохие решения. Помним, что всё, что говорится про мутации (абсолютное большинство плохих и ухудшающих, немного примерно одинакового квазиоптимального SoTA уровня, крайне редко скачки в SoTA за счёт предложения нового решения, оптимизирующего конфликты на многих системных уровнях за счёт усложнения) верно для генерации альтернатив. Если альтернатива одна, то есть альтернатив нет — у вас плохое воображение, это провал.
-
Выбор между альтернативами (прохождение развилки) обоснован согласно SoTA методам. Когда-то это была только булева логика, затем вероятностный выбор частотный, потом вероятностный выбор по байесовской статистике, затем вероятностный выбор по квантовоподобным вычислениям29. Текущие стандарты обоснований поддерживают в их простейшей форме «научный метод» как «рассуждения по индукции и дедукции», лучшие из них (например, Assurance 2.0) выходят в статистические методы снятия неопределённости, большинство признаёт важность в том числе и принятие «экспертных» (читай: интуитивных, никак не формализованных) решений. Мало какие методы учитывают то, что понятие рациональности двигается со временем. Мало какие методы вообще подразумевают явные отсылки к разным теориям рациональности и теориям решений. И ещё важно помнить, что речь идёт про причины и следствия и контрфактические рассуждения, а не просто про «логику» (логика легко отрывается от физической реальности, а вот причины и следствия обычно стараются как-то привязать к реальности).
-
Дальше надо принять рациональный выбор всерьёз: запланировать работы по итогам выбора.
-
Выполнить запланированные работы! Учтите результаты обоснований! Если обосновать успешность системы не удалось, то надо или отказаться от проекта, или что-то менять в системе!
-
Убедитесь, что результатами пользуются: если не пользуются, то всего этого можно было бы и не делать.
Из этих пунктов больше всего вопросов вызывает генерация альтернатив — это работа воображения, творческая/изобретательская деятельность. Основная ошибка рационального обоснования: берём любые две (одну вроде как неприлично) опции обоснования, выбираем затем строго формально и вроде как рационально лучшую из них. Но нет, качество этого решения определяется не качеством выбора, а качеством предложения этих начальных опций: вполне возможно, что если подумать лишний день или другой, то лучшим выбором была бы опция номер три, которой не было в тщательно организованном процессе выбора! И ещё всегда есть опция номер ноль: вы делаете выбор решения не той проблемы!
Говорим мы тут об обосновании выбора технического решения (rationale для выбора, например, одной архитектуры из трёх предложенных — но их сначала надо три предложить!) или о самом выборе способа обоснования (выбор типа аргумента, их тоже лучше рассмотреть несколько)? Речь идёт об обоих случаях. И технические решения нужно предложить в достаточном количестве и качестве, чтобы было из чего выбрать, а затем нужно предложить достаточное количество способов обоснования этих решений, чтобы выбирать уже из этих способов.
Вспомним предыдущий пример обоснования того, что модуль M реализует требование, там говорилось о том, что обоснование велось
-
или на основе предоставленной таблицы с образцами замеров,
-
или на основании собственных замеров (испытания) и затем полученную таблицу смотреть как в предыдущем подходе.
Но можно предложить и ещё варианты:
-
доказать, что претензия всегда удовлетворена «в силу конструкции» (by design, и это недопустимый способ, нельзя обосновывать «в силу требования» или «в силу проекта/design», ибо необязательно в воплощении системы будет реализовано требование или конструкция, это как раз и обосновывается: получили то, что хотели, а не «верно, потому как хотели»),
-
построить тестовую установку, которая будет случайным образом менять напряжения на входе и отмечать/записывать ситуации, когда не выполняется требование (то есть автоматизировать шаги построения таблицы и сравнения значений замеров).
-
… таких вариантов можно предложить ещё и ещё.
Потом выбрать из этих вариантов, включая экономические соображения и вероятность того, что тот или иной вариант обоснования может быть недостаточно надёжным.
Ещё надо помнить об эргодичности30: гипотеза эргодичности говорит, что результат подбрасывания монетки 1000 раз в плане выпадания решки и орла такой же, как подбрасывания 1000 монеток по одному разу, ибо монетки и условия одинаковы. Увы, в технических системах с памятью всё не так, эти системы не эргодичны. Вы не можете согнуть телефон 1000 раз и сказать, что с ним дальше при сгибаниях всё будет в порядке, если он не поломался от этого. Ибо в материале накопилась усталость, в материале есть память на эти сгибания. Если вы завели автомобиль перед выдачей его покупателю, это вовсе не означает, что он и дальше будет заводиться так же всё время его эксплуатации. В обоснованиях нужно учитывать и этот эффект.
Для некоторых ситуаций вы не можете провести испытаний (единственная ракета, которая летит на Марс: как испытать её в полёте?). Тогда вы можете приложить значительные усилия, чтобы отмоделировать эти «испытания». Так, после всемирного моратория на ядерные испытания в 1985 году резко возрос спрос на компьютеры для моделирования ядерных взрывов, и доступ к суперкомпьютерным технологиям стал приравниваться к доступу к самим испытаниям, на экспорт мощных процессоров США постоянно вводят эмбарго31 как раз из-за того, что они помогают разрабатывать ядерное оружие, не прибегая к натурным испытаниям, проводят обоснования успешности разработки ядерного оружия за счёт моделирования.
Вот этот деятельностный характер моделирования ни в коем случае нельзя выпускать из виду:
-
Если это деятельность, то она задействует ресурсы. Если нет информации для снижения степени неопределённости инженерного обоснования, то нужно её купить. Если нельзя купить, нужно что-то делать самим, но это тоже можно оценить в деньгах. Инженерные обоснования дорогие, программы всевозможных испытаний (главный способ добычи свидетельств для обоснований успешности) могут доходить до 85% стоимости проекта.
-
Обоснования тесно связаны с безопасностью и защитой, поэтому они предмет манипулирования («ради безопасности мы за ценой не постоим» и далее расчёты ресурсов на обоснования не производятся, решение принимается «политическое» — в том числе с необоснованно высокими тратами ресурсов). Оцените финансовые потоки на обоснование того, что вы не болеете коронавирусной инфекцией в 2020-2021 году, и до сих пор неадекватность принятых тогда политических решений не принято обсуждать (хотя уже начинаются попытки, но тут правду ещё долго не узнают — данные для любых обоснований на самом нижнем уровне учёта массово подделывались).
-
Работы по обоснованию (отнюдь не только испытания/testing, но и другие виды обоснований) нужно планировать, эти работы нужно адекватно оплачивать. Тут легко и перефинансировать выше оптимума, и недофинансировать (иметь недостаточную уверенность в успешности). Как вы будете определять оптимум выделения ресурсов на обоснования?
-
Обоснования трудно выделить в отдельный метод, ибо обоснования рекурсивно задействованы в каждой части проекта (когда вы сделали винтик M3 для самолёта, это хорошо бы как-то обосновать — точно ли это винтик M3, или «какой-то винтик», но есть обоснования и уровня всего самолёта в целом, так что отдельно посчитать ресурсы и финансы «на обоснования» по факту невозможно, нужно считать их на каждом отдельном системном уровне).
-
Чем формальнее обоснование, тем оно кажется точнее. Это совсем не так! Проблема с обоснованиями на среднем уровне формальности: там, где невозможно сделать точный расчёт вероятностей успешности и любой шаг повышения формальности крайне дорог, но и любая чисто интуитивная оценка не годится. Стандарты «обосновывающих дел» запредельно дороги в их применении именно потому, что заведомо требуют неадекватно высокого уровня формализма, и их применение вдруг делает весь проект невыгодным. Атомная энергия дико дорогая потому, что нормы обоснований на атомный проект в разы и разы выше, чем в среднем по промышленности: трубопроводная арматура там стоит в разы выше, чем для нефтепроводов, водопроводов и газопроводов именно из-за дополнительных обоснований. Оправдано ли это экономически? Нет, это обсуждается в профессиональных кругах, но поскольку речь идёт о ценах, которые платят налогоплательщики (по факту нет «частного мирного атома»), то ситуация становится только хуже.
-
Если вы что-то обосновали вчера, то сегодня вам нужно обосновывать это заново: жизнь изменилась!
Вот примерные составляющие цены обоснования потребительских продуктов через их испытания (и это только сбор свидетельств в пользу претензии на успешность системы, а ещё аргументирование, документирование, коммуникация и т.д.)32:
-
Время аренды лаборатории и её оборудования, в том числе время переналадки оборудования, проведения измерений, уборки после проведения испытаний. Если речь идёт о скоростном тестировании износа (скажем, смоделировать двухлетнюю эксплуатации за всего месяц испытаний), то это получается всё равно долго, поэтому дорого.
-
Продукты и их части, особенно если это разрушающее тестирование. Если это прототипы, то они обычно существенно дороже стоят, чем серийная продукция, так что это может быть ещё дороже, чем вы думаете.
-
Спецоборудование для тестирования: начиная от крепления до довольно сложных стендов, создающих предположительно эксплуатационную обстановку. А поскольку речь идёт о тестировании в каких-то диапазонах параметров окружающей среды, это может быть довольно дорого: представьте себе тестирование устойчивости к перепадам температур при диапазоне каких-то влажностей, причём сопряжённое с измерением механических характеристик: печка-холодильник с контролируемой влажностью. Дальше вопрос о размерах ваших продуктов, о массовости замеров.
-
Логистика на доставку продуктов на тестирование, зарплаты, если это лаборатория, то ещё и накладные расходы на дивиденды владельцам лаборатории. Но если вы проводите тестирование у себя, то не факт, что оно будет зачтено (независимость тестирования важна, в своей-то лаборатории заведомо всё будет «суперуспешно»), плюс много выше начальные затраты (оборудование лаборатории с нуля стоит довольно дорого).
И помним, что не испытывать будет много, много дороже:
-
Время разработки может оказаться много дольше, если не оттестировать разные варианты. При этом с развитием средств моделирования доверие к моделированию по сравнению с испытаниями растёт, но и само моделирование тоже оказывается довольно дорогим («лучшей моделью кошки является другая кошка, желательно та же самая» — и моделирование неизбежно будет приходить к этому).
-
Проблемы, не найденные тестированием, будут найдены пользователями продукта. Дальше будут: затраты не только на ремонт, но и на возможное покрытие ущерба, покрытие судебных издержек, страховых издержек. Если пропущен какой-то крупный дефект, связанный с безопасностью, придётся «отзывать продукцию», что крайне дорого. И одно дело, если «включил я вашу батарейку, а она не работает», и другое дело, если «включил я вашу батарейку, а она взорвалась», и совсем уж третье, когда «включил я вашу батарейку, она взорвалась и погибла пара человек вокруг».
-
Репутационные потери, которые финансово могут быть тоже неожиданно большими. Скажем, одиночные аварии автомобилей без водителя, которые проходили даже во время испытаний, время от времени заставляли прекратить даже сами испытания! Одиночные аварии самолётов приводят к остановке всего флота самолётов данной марки «для выяснения причин».
Не все обоснования делаются по итоговой уже изготовленной/воплощённой системе. Чем раньше вылавливается ошибка, тем дешевле она исправляется. Поэтому проверяются и описания. Такие проверки обычно называют просмотры/review — кода, проекта/design, архитектуры, требований, программ испытаний (часто review передают калькой, так и говорят: «архитектурное ревью»). Это тоже средство обоснования заявки на успешность/качество целевой системы, призванное «отловить баги» (найти ошибки) на ранних стадиях разработки, а не в ходе приёмо-сдаточных испытаний или даже эксплуатации. Коллеги и специально приглашённые эксперты смотрят описания системы, которые делают разработчики и задаются вопросами, почему эти описания именно такие, и что можно было бы сделать иначе. Это очень дорогой способ работы.
Скажем, в гейтовой/gate модели жизненного цикла каждый гейт стадии разработки предусматривал сборку к дате прохождения гейта всех описаний проекта в связное целое (а если проект какого-то винтика на нижнем уровне системы не готов, то ждут его завершения — чтобы уж гарантированно рассматривать связное полное описание), а затем работы останавливаются и происходит тщательный просмотр для оценки претензии, что система будет успешной/качественной — и этот просмотр делался обязательно внешними независимыми экспертами. Если просмотр гейта неудачен, то проект останавливается. Если частично удачен — проект занимается доработкой, если удачен — финансирование проекта продолжается. Это оказалось настолько неэффективно, что от гейтовой схемы отказались практически повсеместно: разработки разных частей системы идут асинхронно, просмотры описания частей системы и иногда доступных к просмотру описаний целой системы происходят независимо друг от друга, результаты испытаний/тестирования (включая замеры fitness functions, характеристик безопасности и защиты) тоже рассматриваются асинхронно, гейтов нет. Решения об остановке проекта принимаются, но они принимаются быстро, никто никого не ждёт при этом, эти решения не привязаны к гейтам.
Проблемы в проверке описаний (поиск ошибок, проверка rationale) в том, что в отличие от испытаний, проверять как «испытание» можно только исполняемые модели, дают ли они правильный результат (если вы, конечно, знаете, какой результат будет «правильным»). Конечно, можно проверить формат записи (наличие синтаксических ошибок, пропущенных частей описания и т.д.), но семантические/смысловые ошибки так просто не выявишь, требуется «исполнить модель в голове», и формализовать такое обычно не удаётся.
Мало что можно сказать про проверку описаний. Вообще, работа с описаниями понятна меньше, чем работа с физическими объектами — ибо заземление/grounding много проще для физических объектов. Так, для физических объектов есть отношения части-целого, они понятны, на этой основе строится системное мышление. А вот для описаний непросто разобраться, что такое «часть» и «целое», чем отличается «функциональная часть описания» от «конструктивной части описания» (в отличие от функциональных и конструктивных частей самой системы). Так что про «испытания описаний» (кроме как «сделать воплощение системы по его описанию и затем испытать это воплощение») можно немного сказать, это на сегодня больше искусство, чем наука/дисциплина, и уж тем более нормативная дисциплина.
Роль имитационного моделирования (когда модель вычисляется не «в голове», а «в компьютере») растёт, но каких-то существенных рекомендаций «для учебника» сделать пока нельзя. Фронтир инженерии проходит где-то в этом месте. В любом случае, породить какое-то проектное решение (описание) оказывается часто сложней, чем проверить, что это описание позволило изготовить успешную систему (когда вы поняли, что для самолёта можно использовать неподвижные крылья и пропеллер с лёгким двигателем внутреннего сгорания, а не продолжать работы над махолётом, то построить десяток самолётов для проверки такой идеи оказывается просто, непросто догадаться, что именно нужно строить, чтобы проверить идею, непросто догадаться про неподвижное крыло с пропеллером и двигателем внутреннего сгорания).
Решения по остановке проекта на базе неудачного обоснования основываются не всегда на обоснованиях технической части проекта. Например, проект самолёта могут закрыть на основании того, что были неудачи с предварительными продажами, но не на основании того, что техническое решение амортизации колеса оказалось плохим (техническое решение можно поменять, а вот неудачи с продажами показывают, что в проекте что-то совсем не так с его успешностью). Или может выясниться, что «прототип автомобиля лучший в мире, результаты его испытаний блестящи, но мы не можем построить успешный завод по дешёвому надёжному массовому производству этого автомобиля», и проект будет закрыт в связи с невозможностью налаживания производства (и такое часто бывает: строить завод по массовому производству продукта X обычно сложней, чем строить на этом заводе продукт X: построить завод по выпуску ракет сложней, чем построить ракету на этом заводе).
В методе экстремального программирования/eXtreme Programming предложили довести идею просмотра кода до экстремума, «если хорошо, чтобы на код смотрела не одна пара глаз, так пусть всё время смотрит не одна пара», эту концепцию назвали «парное программирование»/pair programming33. Как и в случае TDD (test-driven development, с многочисленными его последующими вариантами вроде BDD, ATDD, мы это уже обсуждали в нашем руководстве) результаты улучшений оказались не такие драматические, к ним было много вопросов (удивительно, но производительность не падала вдвое, но и не росла при заданном уровне дефектов), и после периода краткой моды этот метод так и не стал распространённым. Ситуация поменялась с появлением дешёвых «парных программистов» в составе IDE (GitHub Copilot, Amazon CodeWhisperer, Cursor и т.д.), ситуация аналогична в CAD/CAM/CAE — copilots (а то и peer programmer) становятся важным средством повышения производительности труда инженеров. Но помним, что как люди, так и AI лучше «пишут без ошибок», чем находят уже сделанные ошибки, мы это уже упоминали. Получается, что инженерные обоснования делать чуть ли не дороже, чем проектировать!
Но всё-таки ситуация с автоматизацией как проектирования, так и инженерных обоснований меняется, и по историческим меркам — меняется быстро. Сейчас ошибки безопасности в софте и ошибки несоответствия стандартам в информационных моделях строительства находят специализированные программы анализа кода34 и проверки соответствия информационных моделей стандартам, но «автоматизированные ревью» пока ещё не очень надёжны, хотя инфраструктура для них уже более-менее готова (тот же инструментарий DevOps и eXperience platforms). Расчёт всё-таки делается на просмотр кода, информационных моделей и прочих описаний самими разработчиками, но уже с участием агентов AI. А уж если говорить о тех обоснованиях, от которых нельзя отказаться, то есть обоснование соответствия стандартам безопасности, то рынок автоматизации такого обоснования более чем насыщен35.
В целом на инженерные обоснования надо закладывать от 20% до 85% бюджета проекта, и для не-инженеров это неожиданно. Конечно, автоматизация тестирования помогает снизить затраты, но не так сильно: сами коммерческие программы анализа кода или информационных моделей, или построения программ испытаний какой-то аппаратуры стоят достаточно дорого, а испытания на каждом инкременте требуют солидных вычислительных ресурсов. Ну, и написание тестов (даже если их совместить с описанием функциональности или описанием принятых архитектурных решений) тоже занимает время. Или пользователи превращаются в отдел обоснования качества, находят ошибки сами, но и последствия для бизнеса от этого соответствующие. Поэтому надо запомнить, что инженерные обоснования в классических инженерных проектах — это по стоимости примерно половина проекта (хотя это всего-навсего небольшой раздел в нашем руководстве, но по ресурсам он тянет на половину всех ресурсов, нужных на разработку).
Испытания: это измерения
Испытания считаются важнейшим видом свидетельств успешности/качества. Испытания — это измерения с целью получить обоснование претензии. Как и любое измерение, это действие, требующее ресурсов и времени. Даже «восприятие», как отмечалось в руководстве по системному мышлению — это действие, это не пассивная «фильтрация сигналов из окружающего мира»:
-
Планирование измерения, оно не происходит «случайно само». Нужен выбор того, что измерять (причинно-следственные связи с целью: инженерное обоснование) и тут важно сгенерировать достаточное число альтернатив, выбор того, как измерять (тоже из достаточного числа альтернатив, с которыми хорошо бы быть знакомым), планирование ресурсов измерения и обоснования, обеспечение их выделения (координационная работа). Это всё требует удержания внимания (в инженерии это означает, что всё это записывается, а не происходит «в уме»).
-
Подготовка измерения. Даже если речь идёт о простейшем «внешнем осмотре», это означает, что нужно физически привести во взаимодействие измеряемый объект и измерительный прибор, то есть как-то подтащить измеряемый объект к проводящему наблюдение инспектору или подвести инспектора к измеряемому объекту. Это время и ресурс как наличия и логистики от места изготовления к месту осмотра объекта, так и наличия и логистики от его текущего места к месту осмотра инспектора (без приборов при «внешнем осмотре», или с приборами. Впрочем, сейчас и при внешнем осмотре вполне могут фотографировать, то есть и тут приборы).
-
Взаимодействие в ходе измерения. И хотя в случае квантовых измерений шаг по выводу информации измерения за пределы датчика рассматривают отдельно (бит — это результат измерения, и может копироваться; кубит — результат измерения, но не может быть откопирован)36, будем считать, что речь идёт о классическом в смысле физики измерении с результатом в битах. И этот результат тоже как-то документируется. И если речь идёт о статистических результатах, то этих взаимодействий (и подготовок к ним) в измерениях может быть множество, а сами измерения могут занимать и фемтосекунды, и годы.
-
Принятие решений на основе результатов измерения. Если это эксперимент в рамках попперианского понимания науки, то он определяет выбор той теории, которая будет считаться фальсифицированной/опровергнутой (эксперимент как измерение какой-то характеристики при определённых условиях производится для опровержения тех теорий, которые хуже предсказывают результаты измерения)37, если это инженерное обоснование качества/успешности системы, то результат обоснования: удовлетворение или неудовлетворение претензии/claim.
Есть огромное число разных вариантов проведения испытаний, которые породили обширную терминологию, связанную главным образом с тем, как готовятся измерения и с особенностями проведения измерений (список тут абсолютно неполный, это просто примеры того, что часто встречается в разговорах об испытаниях как лучшем источнике свидетельств для аргументирования претензий на успешность/качество системы):
-
Мониторинг — это «постоянно идущее в ходе эксплуатации испытание», входные характеристики окружения при этом задаются эксплуатационной средой, а результаты оцениваются для обоснования заключения об успешности эксплуатации, или о необходимости ремонта («ремонт по состоянию», скажем, акустический датчик на трубе слушает шорох песчинок в протекающей по трубе с какими-то отложениями на стенках нефти, на основе анализа этого шороха делается вывод о работоспособности трубы и необходимости её чистки или даже замены), или о коррекции эксплуатационного режима (цифровой двойник). Если речь идёт о подобном в какой-то определённый момент (например, в момент старта работы), то говорят не о «мониторинге», а самотестировании/самодиагностике. Система мониторинга тут — часть системы. Если это вопросы безопасности и защиты, то вместо «мониторинга безопасности» лучше говорить о «сигнализации» как системе и обсуждать, что там должны делать все остальные в ответ на сработавшую сигнализацию. Скажем, в иммунной системе часть — сигнализация, а часть — средства устранения угрозы, всё это части организма. Очень часто «поставщики систем безопасности» поставляют не «системы безопасности», а только сигнализацию — а уж кто там будет реагировать и что делать в ответ на сигнал о проблеме, это остаётся за рамками проекта. То, что вместо «безопасности» предлагается только «сигнализация в никуда» — это надо обсуждать всегда явно, это типовая ошибка.
-
Всевозможные тестируемые объекты («железо»38, софт, модели, люди, системы) in-the-loop, причём loop тут понимается как симулятор надсистем, то есть симулятор окружения, в которое помещается тестируемый объект, на входы-выходы которого подаются нужные для полноценного тестирования сигналы (для «железа»), нужные значения на API (для софта), нужные параметры (для модели, чаще всего это компьютерная модель), нужные стимулы (для людей), нужные изменения в среде (для систем), а потом считывается реакция и происходит её анализ. Этот самый loop иногда называют «стендом». Этот цикл «задать набор характеристик системного окружения, предъявить системное окружение с этим набором характеристик, получить отклик тестируемой системы, задокументировать, вернуться к заданию набора характеристик» происходит в случае «стенда» чаще всего в разы дешевле и быстрее, чем в реальной жизни, где нужно долго ждать, пока встретятся какие-нибудь редкие сочетания входных параметров. Скажем, если у вас hardware-in-the-loop (компьютер какого-нибудь гаджета с его прошивкой), то вы можете подавать на вход самые разные значения, якобы получаемые от датчиков этого гаджета, но на самом деле генерируемые «стендом» и смотреть на отклик так же быстро (не глазами, а считывая значения, выдаваемые компьютером гаджета для актуаторов — это иногда моторчики, иногда дисплеи, иногда что-то ещё). Если бы вы помещали этот гаджет вместе с датчиками в какую-то реальную среду и делали каждый раз реальный замер (например, не подав сигнал датчика температуры «как будто у нас -30°C», а реально прикрепив датчик и охладив его до нужной температуры), то это было бы в разы и разы медленней и дороже.
-
Регрессионное тестирование — это повторное тестирование того, что уже вроде как тестировалось. Оно наиболее развито в программном обеспечении, где считается хорошим тоном прогонять все тесты в автоматическом режиме (это относительно дёшево) при любом изменении. Но и для «железа» оно тоже довольно часто. Скажем, вы тестируете тормозной путь, но поменяли шины. И опять тестируете на тормозной путь. Или поменяли бортовой компьютер, а не шины — и всё равно тестируете. Повторный экзамен для людей часто не менее осмыслен: профессиональные ассоциации заставляют переэкзаменовываться каждые несколько лет, это как раз и есть регрессионное тестирование (при этом тесты ЕГЭ являются более-менее бессмысленными, и уже через пару лет после школы их мало кто сможет сдать повторно, поэтому вопрос о регрессионном тестировании «готовности к жизни» не поднимается, ЕГЭ имеет абсолютно другие цели, не связанные с готовностью школьников ко взрослой жизни).
-
Юнит-тестирование (тестирование отдельных модулей) и системное тестирование (системы в целом) и приёмочные/acceptance (хотя тут есть терминологическое противоречие с приёмкой/validation) испытания обсуждаются в плане необходимости соблюдения некоторого баланса между ними. Проблема в том, что из-за системного эффекта обоснование успешности в работе отдельных модулей не гарантирует успешности работы системы в целом, и тем более работы надсистемы, да ещё и в необходимом разбросе параметров условий эксплуатации. Но заведомо неуспешный модуль вполне может вести к заведомой неуспешности системы, и его довольно легко обнаружить. Системное же тестирование крайне дорого. Вопрос в том, сколько внимания при фиксированном бюджете на тестирование уделять испытаниям модулей, и сколько испытаниям системы. В программной инженерии TDD, ВDD, ATDD и прочие варианты стиля разработки, ориентированные на test first, по сути сводятся к тому, что сразу пишется «испытательный стенд», как сказали бы в «железной инженерии», который проверяет результаты работы одного модуля/юнита (unit-testing). Попутно выяснилось много интересного: независимо написанные тесты оказались качеством не лучше, чем написанные самими разработчиками модуля. Но два уровня (юниты и система) — это только начало разговора, сегодня это обсуждается как пирамида тестирования. Идея в том, что на нижнем уровне пирамиды (юнит-тестирование) используют быстрые простые тесты, на уровне API уже тесты изощрённые, а на уровне UI — сложные и длительные сценарии тестирования. Результаты этого подхода в 2025 году (конечно, этот подход поддерживается современным инструментарием, без которого результаты невозможны)39: выполнение тестов на 65% быстрее, покрытие кода тестами на 40% выше, уменьшение числа сбоев в ходе эксплуатации на 90%. Это в программной инженерии, но в «железной» инженерии всё то же самое: проверки делаются быстрые на буквально каждой операции, но есть ещё и испытания на специальных стендах с трендом превратить систему в испытательный стенд для самой себя.
-
Автоматизированное тестирование40 в противовес ручному тестированию. Если понятно, что должна делать программа (но это надо задокументировать! И почему бы не сразу на языке тестов?), то можно поручить какой-нибудь программе составить программу испытаний/тестирования (набор тестов/измерений), а потом «прогнать тесты/замеры». И получить на выходе список результатов тестов/замеров, часть из которых которые будут «неприятным сюрпризом», «провалом испытаний». Проблема в том, что для получения ошибки может быть задействован довольно хитрый и длинный сценарий, и простой случайный перебор сочетаний входных параметров не даст выявленной ошибки, поэтому современные методы стараются анализировать код, чтобы найти ещё не проходившиеся его коды. Если тестировщик думает о том, какую ошибку мог бы совершить разработчик, то он тоже действует не случайным перебором, а целенаправленно — и находит ошибку. Но человек-тестировщик крайне медлен и крайне дорог. Проще добавить вычислительной мощности и поручить тестирование алгоритму. Но чем больше становится система, тем трудней в ней найти ошибку, даже если пытаться как-то делать «метод тыка» менее случайным. Сейчас ручное и автоматизированное тестирование сочетаются, хотя исход этого соревнования заранее ясен: победит автоматизированное тестирование — по мере того, как растёт роль vibe coding и Software 3.0, программы AI тоже будут начинать с test first.
-
Инженерия хаосом/chaos engineering41 как проведение испытаний путём планового отключения каких-то модулей на работающей системе и проверки того, как это влияет на работоспособность системы. Отличие от «аварии» только в том, что это отключение происходит в заранее известный момент времени, и известно, что именно выключается (поэтому есть шанс всё вернуть на место, если что-то пойдёт не так). Это очень жёсткий способ испытаний, в чем-то эквивалентный древним способам испытания мостов, когда под мостом стоит главный инженер и его команда, а по мосту движется первый грузовой поезд, да ещё и с максимальной загрузкой. Представьте, когда вам нужно по плану заглушить двигатель самолёта в полёте, и проверить, что самолёт нормально летит дальше на оставшихся двигателях. Или заклинить один из рулей и проверить, что остальных рулей хватает, чтобы лететь нормально. В случае программных систем это не выглядит так драматично, но представьте, если вам нужно оторвать интернет-соединение, за которым находятся три миллиона ваших клиентов — сколько от них прилетит звонков, если что-то пойдёт не так? Какую ответственность вы почувствуете за их убытки? Но зато при инженерии хаосом вы будете уверены, что при всяких «неожиданностях» ничего особо неожиданного не произойдёт, «у нас отвалилось крыло, как пару месяцев назад на плановом отвале крыла, занимаемся определением причин поломки, но летим нормально, жалоб нет».
-
… методов проведения испытаний/тестирования множество, и каждый день появляются новые, список можно продолжать и продолжать. Отслеживайте их, что считалось верхом совершенства вчера — сегодня уже вчерашний день. Стратегируйте: регулярно проверяйте ваш выбор методов проведения испытаний.
Поскольку в программной инженерии можно легко делать множество версий системы в день (изготовление по большому счёту проходит автоматически и мгновенно по сравнению со временем написания исходного кода программ, хотя и тут ситуация меняется: AI-системы пишут код быстро, и с каждой новой версией своих моделей качество этого кода лучше и лучше), то новинки в методах программной инженерии появляются где-то на 10 лет раньше, чем аналогичные новинки появляются в классической «железной» инженерии и инженерии кибер-физических систем. Этот разрыв быстро сокращается (скажем, с появлением таких технологий, как 3D-печать, а также технологий точного физического моделирования), но в целом для понимания фронтира в инженерных методах, включая использование AI, целесообразно смотреть именно на программную инженерию — и знание мета-мета-модели поможет избавиться от особенностей предметной области с её мета-моделью и перенести новые идеи в проектную ситуацию другой предметной области, инженерии систем другой природы.
Для понимания, в какую сторону развиваются методы инженерных обоснований, нужно прежде всего рассмотреть метод DevOps в программной инженерии, где сегодня поддерживается
-
непрерывная/continuous сборка/интеграция (CI): в любой момент времени разработки есть работающая версия системы с конфигурацией без известных конфигурационных коллизий,
-
непрерывное введение в эксплуатацию (continuous delivery, CD): в любой момент времени есть поставляемая пользователям полезная версия системы, а хоть и с ограниченной функциональностью по сравнению с задуманной, то есть рабочая конфигурация не просто «есть», а ещё и доступна для использования и поддерживается (иногда говорят про continuous deployment, но это просто «развёрнуто на месте использования и настроено-налажено», но доступности для использования и поддерживаемости пока нет, это отдельные действия),
-
непрерывная разработка/development: разработка идёт всё время проекта, реализуются всё новые и новые возможности системы, нет момента «мы закончили работать, теперь пользуйтесь, а мы пошли отдыхать» — по факту система эволюционирует во множестве маленьких жизненных циклов, идут умные мутации в разных частях системы, пользователи получают всё новые и новые версии системы в новых и новых вариантах конфигурации,.
-
непрерывное обоснование качества/conutinuous QA, сводящееся к тому, что обоснование качества ведётся непрерывно в ходе всего проекта42.
Сама идея DevOps в том, чтобы разработчики брали на себя больше методов из правой части V-диаграммы или ромб-диаграммы жизненного цикла: эксплуатацию (а не сдавали систему каким-то внешним операторам), введение в эксплуатацию (а не оставляли это тем же операторам), а также инженерные обоснования, что их система успешна (а не оставляли это тестировщикам). То, что «осталось справа» — автоматизируется, это первая задача инженеров внутренней платформы разработки.
Без DevOps методов (это до сих пор часто встречается в «железной инженерии») инженеры-разработчики отправляют очередную версию системы тестировщикам («инженерам по качеству», испытателям), а те возвращают список дефектов, инженеры-разработчики опротестовывают эти дефекты («это дефекты в ваших тестах и методике испытаний, а не в нашей системе, и вообще с такими дефектами можно эксплуатировать»), затем после исправления ошибок тестировщики отправляют систему операторам-администраторам, которые её сначала собирают/integrate, затем разворачивают/deploy и настраивают, затем выдают доступ пользователям системы (delivering) — и дальше пользователи обвиняют во вновь найденных ошибках операторов (в подгорелой котлете виноват официант, а не кухня: почему принёс это?), те обвиняют тестировщиков (почему пропустили это?), те обвиняют разработчиков (почему сами не оттестировали это?). DevOps заставляет всех работать с использование общей платформы/инструментария/конвейера/трубопровода/pipeline. В случае ресторана повара берут ответственность на себя за доходящее до клиента блюдо, а не отгораживаются официантами и службой контроля качества. Основной способ, которым такое становится возможным — это автоматизация и тестирования, и разворачивания/«ввода в эксплуатацию»/transfer/deployment, и даже пользовательской поддержки (например, in-line help/«контекстная помощь»). И ещё автоматизируется даже то, что раньше плохо понималось, например, мониторятся fitness functions, что оказывается важным не разработчикам, а архитекторам.
У подхода DevOps в части инженерных обоснований есть альтернативный вариант, который начинался в Гугл, а затем стал весьма распространён. Называется он SRE (Site Reliability Engineering)43 и одно из важнейших там отличий от «просто DevOps и инженерии платформы» — это различение работ по исправлению найденных ошибок и работ по увеличению функциональности. Подход SRE говорит, что обоснованная успешность системы — это прежде всего надёжность, безошибочность функционирования тех её возможностей, которые уже есть. И уже потом — добавление новых возможностей. Поэтому новые возможности разрешается добавлять только после того, как уровень известных ошибок в системе снижается до заранее оговорённого. До этого или уже разработанные новые возможности «кладутся в стол» и не вводятся в эксплуатацию, или их вообще прекращают разрабатывать, ибо силы всех доступных разработчиков направляются на устранение найденных ошибок, новая функционально просто перестаёт разрабатываться, все инкременты выпускаются с исправлением ошибок, а не с новыми фичами.
Как в случае осетрины, которая «или первой свежести, или не осетрина», так и в SRE: система признаётся (успешной) системой только тогда, когда на неё можно положиться. Иногда совместно рассматриваемые архитектурные характеристики, все эти -ости»/-ilities называют dependability, как раз указывая, что «на эту систему можно положиться», и инженерное обоснование должно это обосновать на базе каких-то свидетельств, а не «умозрительно».
Прогресс в развитии подходов и DevOps, и SRE, включая такие радикальные варианты обоснований как инженерия хаосом, существенно зависит от прогресса в автоматизации. Настолько зависит, что SRE (куда намеренно включается и работоспособность аппаратуры, и учёт физических внешних воздействий типа обрывов оптоволокна интернет-каналов, ураганов с возможным обрывом энергопитания и т.д.) декларирует рассмотрение всех этих проблем как «проблемы программного обеспечения», то есть недостаточной автоматизации в учёте всех неожиданностей и недостаточной автоматизации в разворачивании исправлений для известных ошибок в программах и аппаратуре.
В программной и «железной» инженерии, включая совместную для них инженерию кибер-физических систем, непрерывное инженерное обоснование (continuous QA) в рамках DevOps с инженерией платформы и SRE — это сегодня основной технический тренд. Но и он сводится к тому, что идёт автоматизация испытаний, тренд автоматизации оказывается и тут важнее. Инженерное обоснование требует огромных ресурсов, от выделения этих ресурсов нельзя уклониться, но эти ресурсы можно существенно снизить за счёт автоматизации.
Обоснование — это описание ожидаемой (или уже реальной) успешности системы. Альфа инженерного обоснования и все её подальфы — это подальфы описания, а рабочие продукты этих описаний — это assurance case, «папка обосновывающего дела», как папка судебного дела или дела/досье в какой-нибудь канцелярии, то есть документ (сегодня это обычно набор записей в базе данных, а не «листок бумаги» или даже «листок бумаги в электронной форме, например .pdf файл»).
В стандартах (QA, обоснование качества) чётко говорится, что обоснование успешности системы должно вестись в ходе всей разработки системы, это не «особая стадия перед выпуском в эксплуатацию», это просто часть разработки.
Испытания частей (юнит-тесты, которые пишут сами разработчики) ведутся незадолго до интеграционных испытаний, ибо нет никакого накопления новых частей перед интеграцией — введение новых версий системы в эксплуатацию происходит непрерывно, для софта это — по многу раз в день. После начала эксплуатации (это происходит с каждой фичей, с каждым «железным» изделием в серии, возможно каждое изделие в серии будет другое) эти же испытания/мониторинг ведутся так же регулярно (скажем, самодиагностика во время включения у оборудования, в котором есть хоть какой-то микропроцессор — это уже обычное дело, и помним про манифест прочности44: система всё время себя оценивает, что с ней происходит, чтобы быть прочной). А ещё в инженерных обоснованиях всё начинается с подготовки испытаний (современные варианты TDD, «что мы хотим от системы» документируется на языке испытаний), а затем ещё до испытаний документируют rationale, включая rationale на старт самого проекта создания системы — визионер должен принять информированное решение, согласиться с аргументами!
Инженерные обоснования — это метод, которым пользуются в ходе всего процесса инженерной разработки, укрепляя и укрепляя уверенность в том, что система получается успешной, она не только выполняет свою функцию, но и на неё можно положиться (система dependable, ещё одно часто используемое слово для выражения претензии/claim на успешность/success — и есть архитектурная характеристика dependability45).
При непрерывном вводе в эксплуатацию обосновывается в том числе каждая новая фича/инкремент, но также обосновывается, что вся система будет работать с этой новой фичей (и это даже не на двух уровнях, а на нескольких, помним про пирамиду тестирования). Так что в начале проекта формулируется претензия/claim на успешность MVP, и дальше накапливаются материалы, её обосновывающие (подчинённые претензии в их иерархии/subclaims, аргументы и доказательства).
В целом состояния, которые должна пройти альфа какой-то системы (или фичи/возможности/feature в очередном инкременте системы, там всё похоже — когда речь о системе, то чаще всего это просто MVP), могли бы включать следующие подсостояния (и для них нужны контрольные вопросы) по учёту инженерных обоснований:
-
Система/фича будет нужна — претензия на нужность системы обоснована (инвестиционное или технико-экономическое обоснование/rationale концепции использования наличествует)
-
Система/фича технически и экономически возможна — претензия на достижимость результатов проекта обоснована (концепция системы обоснована, архитектура обоснована, программа испытаний ясна)
-
Система/фича спроектирована — представлены rationale по принятым проектным и архитектурным решениям, «код написан»/«информационная модель для завода подготовлена»/«решения для персонала предприятия (если система — предприятие) приготовлено» и включает тесты. Можно изготавливать и тестировать (работа с платформой разработки, которую предоставили инженеры платформы).
-
Система/фича отмоделирована и испытана — получены свидетельства для обоснования успешности системы (и фичи, и всей системы).
-
Система/фича успешна — получено полноценное инженерное обоснование успешности системы (для собранных свидетельств построены аргументы, обосновывающие претензию на успешность системы, аргументы приняты — это делается при обоснованиях успешности по compliance со стандартами, и изредка при обоснованиях продолжения проекта для топ-менеджеров, занимающихся стратегированием).
-
Система/фича выведена из эксплуатации — получены свидетельства о том, что дальнейшая эксплуатация ранее успешной системы/фичи невозможна или невыгодна.
Как видите, тут можно считать, что для каких-то альф или подальф отслеживание обоснований можно сделать в форме подсостояний, требующих своих отдельных контрольных вопросов. Но можно говорить и о том, чтобы собрать это всё в отдельную подальфу инженерных обоснований — и сделать её подальфой нескольких альф, в том числе альфы коммерческой возможности (тем более что первый пункт прямо относится к коммерческой возможности ведения проекта по созданию системы или микропроекта одной команды по созданию/модификации новой фичи для системы). Альфы представляют собой не дерево, а граф, подальфа вполне может быть подальфой нескольких альф (это особо оговаривается и в стандарте OMG Essence). Учитываем, что:
-
все состояния альф ссылаются друг на друга (это особо обговаривается в стандарте OMG Essence), это лишний повод обратить внимание организации проекта на важность удерживать отслеживание проектной ситуации по всем альфам в их взаимосвязи, нет требования иметь «ортогональные независимые» альфы. Если вам важно удерживать инженерные обоснования как особый приоритет в отслеживании, смело заводите подальфу для всех альф, для которых вы ожидаете проблемы с обоснованиями. Заботиться о формальной «ортогональности», «независимости» необязательно.
-
онтологическая строгость определения альф и подальф не слишком большая. Каждая организация проекта адаптирует альфы к своей проектной ситуации до уровня мета-модели (предметной области из культуры, «как в учебниках» и предметной области «как у нас в проекте», то есть согласно регламентам и стандартам предприятия и предпочтениям сотрудников организации проекта). Так что нужно смотреть на то, как обычно устроены обоснования в вашей предметной области, но наше руководство и упомянутая в нём литература даст много идей о том, что может быть там пропущено или наоборот, что может быть лишним (особенно, если лишние обоснования лоббируют «безопасники», ибо они за обоснования не платят, им дёшево требовать лишнее).
Один из студентов-бакалавров, изучавший системную инженерию по предыдущей версии руководства на вопрос, что ему пригодилось больше всего из изученных методов мышления и работы, сказал: «я понял, что есть проверка и приёмка — и работы по этим методам в проекте обязательны. И я начал проверять всё, что выходит из моих рук перед тем, как отдавать результаты своей работы. И моя жизнь драматически изменилась к лучшему». Не жадничайте тратить ресурсы на инженерные обоснования с самого начала до самого конца проекта, не ленитесь их делать, и ваша жизнь тоже драматически изменится к лучшему! Но будьте готовы, что на это уйдёт половина вашего времени, а то и больше! Ещё больше времени удастся сэкономить: за счёт того, что не будете тратить время на заведомо неуспешные проекты.
Задания
Поставьте отметку о выполнении:
-
Написан и опубликован пост с изложением ваших проблем при выполнении предыдущего задания в части подготовки инженерного обоснования. Особо в посте уделено внимание испытаниям как источникам свидетельств для аргументов в вашем обосновании. Сказано, как обоснование проверялось на отсутствие ошибок в аргументации. В посте также приведена оценка экономики: сколько было потрачено на обоснование, сколько было бы потратить оптимально, как принималось решение о необходимом объёме обоснования.
-
Написан и опубликован пост, в котором вы оцениваете состояние инженерных обоснований в вашем рабочем проекте, методы, которые вы использовали для этих обоснований (и где можно почитать об этих методах), предложения по улучшению работы с обоснованиями в вашем проекте, учитывая материал, изложенный в текущем разделе руководства.
Проблемы инженерных обоснований для существ, личности, сообщества, общества
Многочисленные проблемы появляются в тех случаях, когда мы выходим из инженерии киберфизических систем и/или программных систем в инженерию систем другой природы, и вот несколько примеров:
-
Проектирование финансов предприятия, сводящееся к бюджетированию. Обычно оно связано с разработкой бюджета, а затем исполнением бюджета, что занимает годичный цикл. Движение beyond budgeting и аналогичные ему46 представляет собой по факту попытку сделать непрерывное бюджетирование по модели DevOps, где сначала вместо годичного цикла (за год может случиться и скачок цен на продукцию, и уход надёжных поставщиков материалов, и скачки в валютных курсах, и забастовки, и наоборот — новые открытия, которые дают новые коммерческие возможности, но строгий годичный бюджет не даст возможность выжить в этих условиях) идут «итерации» бюджетирования «скользящим окном» сначала квартальным, потом месячным, но затем всё переходит к непрерывному бюджетированию, где разные части бюджета непрерывно дорабатываются, публикуются как план расходов, а потом происходит контроль исполнения бюджета, и в случае явных ошибок идёт быстрое изменение бюджета. Если на заводе Tesla кто-то знает, что он может улучшить свою часть инженерного процесса, то он просто обязан это сделать: купить новое оборудование и провести эксперимент. Для того, чтобы это сделать, нужна упрощённая процедура выделения финансов — ровно это и происходит. Не надо год ожидать, пока проверят твоё обоснование, rationale этих трат. Не надо потом год ждать, пока результаты эксперимента окажутся в основном производственном процессе.
-
При покупке предприятий, при заключении крупных сделок обычно проводят процедуры проверки due diligence47, чтобы убедиться в отсутствии каких-то неприятных сюрпризов, которые могут произойти после завершения сделки. Это тоже инженерное обоснование, «входной контроль», но речь идёт о личностях и организациях, и возникает сразу много интересных особенностей. Как минимум, полностью меняется терминология, полностью меняются процедуры, а ещё это разовое действие — хотя и тут возможны варианты, по ходу проекта ведь сразу начинается организационное развитие уже совместного (после M&A48, merges and acquisitions) предприятия.
-
Если речь идёт о показаниях в суде и высказываемых в них претензиях/claims отдельных людей, то как могут быть устроены обоснования? Врёт или не врёт человек, может быть проверено на детекторе лжи, который сам по себе может врать или не врать, надёжность такого «доказательства» очень низка. Можно использовать «сыворотку правды», хотя это по факту конспирология (набор легенд) и вряд ли работает с надёжностью выше случайности49, причём можно и попросту пытать «по старинке», хотя пытки — метод «испытаний» тоже не самый надёжный и полученное под пытками или даже угрозами пыток свидетельство/evidence в основу аргумента сегодня не положишь, поэтому и обосновать мало что получится. Тут сразу поднимается множество вопросов об этике методов получения свидетельств/улик/показаний/замеров, включая «судебный поединок»50 как ранее считавшийся вполне SoTA методом и сводящийся к дуэли. И вот мы получили вроде как свидетельства/улики/evidence такими сомнительными методами. Как оценивать результаты, как строить аргумент, если заранее известно, что свидетельство ненадёжно? Никакой же статистики для отдельных людей по отдельным вопросам набрать нельзя, а должны же быть вопросы про false positive и false negative заключения, ибо от ложных обоснований как positive, так и negative могут быть весьма драматические последствия (скажем, пожизненное заключение невиновных на основе ложных обоснований, сделанных судом). Всегда нужно помнить, что на любой плохой метод инженерного обоснования можно вспомнить метод ещё хуже, и по факту используются все эти методы, иногда и в одном проекте.
-
Клинические испытания51, которые массово проводятся прямо сейчас в порядке реализации идеи «доказательной/evidence-based медицины», представляются нерациональными, их нельзя считать получением надёжных обоснований52. Дело в том, что получаемая статистика относится к группе людей, а назначение лекарства после испытания получает один человек, а не группа. И при текущем положении дел с методами аргументирования классической статистикой путём проведения клинических испытаний даже двойным слепым методом, ничего сказать про персональное назначение препарата потом нельзя, но можно сказать методами причинного вывода/causal inference. По большому счёту, вся сегодняшняя «доказательная медицина» построена на песке, она ничего не доказывает (вернее, доказывает, но совсем не то, что нужно для инженерной части: для предсказуемого изменения мира), малопонятно, что с этим делать. Причинный вывод сегодня мало кем понимается, хотя он и решает множество имеющихся проблем. Впрочем, и текущий вариант причинного вывода нельзя считать последним словом: он опирается на расчёт байесовской, а не квантовоподобной вероятности, то есть заведомо даёт искажённый по сравнению с реальностью результат53. Тут есть ещё один интересный момент: если у вас больной заведомо умрёт, но есть минимальный шанс, что выживет, если вы дадите ему потенциально опасное лекарство, которое ещё не прошло клинических испытаний ни по какой методике (скажем, просто не успели): вы будете испытывать это лекарство на таком больном? Это будет лечение или испытание? А если вы оставите каких-то больных «контрольной группы» без этого лекарства, они ж заведомо умрут! Этично ли это? Вопросы множатся и множатся. Ровно такое же рассуждение надо проводить и для психотерапии, которая тоже терапия и должна быть evidence-based, и тут тоже огромное число вопросов к воспроизводимости результатов индивидуальных интервенций, набору статистики для абсолютно уникальных случаев и даже неотличимости «разговора с другом» или «разговора с AI» от терапевтического вмешательства. Переход от врача или психотерапевта к AI тут ничего не меняет: многочисленные статистические (даже двойным слепым методом) свидетельства того, что «AI не хуже человека-профессионала» не убирает вопросов к обоснованности того, что делает человек-профессионал в случае индивидуальных назначений.
-
Обоснование успешности обучения как инженерное обоснование какого-то мастерства. Подробней этот вопрос поднимается в руководстве по инженерии личности, вывод там печальный: экзамены обычно не показывают успешности обучения, кроме самых простых случаев элементарных навыков. Диплом вуза не показывает успешности в работе, результаты ЕГЭ не показывают успешности в жизни. Более того, большие проблемы с «экзаменами» (benchmarks) как методом получения свидетельств для обоснования успешности создания машинного интеллекта, то есть «испытания» тут понятно, как сделать, но положить их в основу обоснования успешности — нельзя.
-
Обоснование идей по социальной инженерии поднимает те же вопросы «экспериментов на людях». При этом даже в случае получения отрицательных результатов (например, все случаи сознательного устройства общества на основе социалистических идей были провальны, но попытки продолжаются и продолжаются, несмотря на «отрицательный результат испытаний», под лозунгом «они там всё неправильно делали, а вот у нас непременно получится!»). Одно из решений тут — ход на классический либерализм как обобщение хода, выработанного в ходе Реформации и кровопролитных религиозных войн католиков и гугенотов: они там все разрешили друг другу маршировать прямо в ад, ибо честно считали, что именно это и происходит, но прекратили насаждать путь в рай военным путём. Поэтому кто хочет маршировать прямо в социалистический голод и диктатуру (как считают одни) или социалистический рай (как считают другие) — пусть марширует, если не втягивает в это других людей, это неплохое начало. Но если это реальная социальная инженерия («я социальный инженер, то есть политик, знаю, как вам жить, верьте мне, я умней вас, неразумных»), а не допотопная эволюция, то неплохо бы для начала получить какие-то обоснования — и чтобы они были не «верую, так лучше», а не менее надёжны, чем инженерные обоснования для автопилотируемого автомобиля или атомной электростанции. И тут оказывается, что как и для клинических испытаний, как для экзаменов «готовности к жизни», как для «интеллекта» каких-то надёжных методов обоснования успешности социального инженерного проекта (обоснования успешности результата социальных реформ) нет. Это не значит, что нельзя предлагать каких-то «умных мутаций» и как-то пытаться выделить их результаты среди всего многообразия жизненных явлений (легко ведь сделать и неверные выводы: «100% из попробовавших в своей жизни огурцы людей рано или поздно умерли. Значит, огурцы вредны, статистика не может врать!»).
Проблема налицо: образование, социальная инженерия (политика), менеджмент, медицина, психотерапия — всё это, конечно, инженерия, но пока игнорирующая главный технический инженерный тренд: ход на непрерывное обоснование, ведение обосновывающего дела, автоматизацию экспериментального получения свидетельств успешности или неуспешности предлагаемых методов.
Без различения model-based и model-driven.
https://ru.wikipedia.org/wiki/Теория_субъективной_ожидаемой_полезности и https://ru.wikipedia.org/wiki/Теория_ожидаемой_полезности, https://ru.wikipedia.org/wiki/Ординалистская_теория_полезности, https://ru.wikipedia.org/wiki/Кардиналистская_теория_полезности, https://ru.wikipedia.org/wiki/Предельная_полезность. Вполне могут переводить сегодня и «ценность», при этом понимание на русском будет хуже. Вот сравните: «добавленная ценность» и «добавленная полезность» — первое непонятно как понимать, а второе — вполне понятно. В английском бывает https://dictionary.apa.org/subjective-expected-value, но запросто будет и https://en.wikipedia.org/wiki/Subjective_expected_utility. В принципе, нюансы использования value — «общее ощущение», а utility — «структурированная оценка в моделях и теориях».
Smart mutation — не случайные, а алгоритмически наиболее вероятно ведущих к лучшему, из https://arxiv.org/abs/1709.00268 или https://arxiv.org/abs/2206.08896
https://ailev.livejournal.com/1106188.html, это текст ещё 2014 года. События 2022 года показали, что в этом мире «непрерывной разработки» отключить миллионы людей от пользования самыми разными системами стало не просто легко, а очень легко.
https://arxiv.org/abs/2410.02543, но ещё в 2021 году была предложена работа https://www.pnas.org/doi/full/10.1073/pnas.2120042119, в которой давалась таблица соответствия понятий термодинамики, биологической эволюции и машинного обучения. Число подобных работ растёт.
https://en.wikipedia.org/wiki/Geometrical_frustration, обязательно смотрите там фильм про неустаканенность магнетизма в твёрдых телах
https://en.wikipedia.org/wiki/Geometrical_frustration, там обязательно смотрите видео Frustrated magnetism in solids, ибо нужно понимать динамику происходящего, она лучше даётся в видео.
первый абзац в https://ailev.livejournal.com/1621262.html
Математика по физике агентов в сочетании с active inference можно найти в https://chrisfieldsresearch.com/, а работы по active inference — в https://www.activeinference.org/
https://youtu.be/XvVa-mByxMs?t=1240, больше информации в «Minimal physicalism as a scale-free substrate for cognition and consciousness», 2021, https://chrisfieldsresearch.com/min-phys-NC-2021.pdf
https://ailev.livejournal.com/1416697.html
https://en.wikipedia.org/wiki/Fitness_landscape#/media/File:Visualization_of_a_population_evolving_in_a_dynamic_fitness_landscape.gif, со страницы https://en.wikipedia.org/wiki/Fitness_landscape

Картинка в высоком разрешении— https://ic.pics.livejournal.com/ailev/696279/212554/212554_original.png

Картинка в высоком разрешении: https://ic.pics.livejournal.com/ailev/696279/285342/285342_original.png

If there is an issue between SE and EoS, it may be semantic, rather than grammatical. Classically, the first word moderates the second: so, in SE, 'systems' appears to moderate (describe the type or flavour of) engineering; and in EoS, 'engineering' appears to moderate (describe the type and flavour of) systems. — из prof. Dereck Hitchins, «SYSTEMS ENGINEERING VS. ENGINEERING OF SYSTEMS - SEMANTICS?», https://systems.hitchins.net/profs-blog/systems-engineering-vs.html
"It's relatively easy to make a prototype but extremely difficult to mass manufacture a vehicle reliably at scale. Even for rocket science, it's probably a factor of 10 harder to design a manufacturing system for a rocket than to design the rocket. For cars it's maybe 100 times harder to design the manufacturing system than the car itself. The issue is not about coming up with a car design — it's absolutely about the production system," Musk said. "You want to have a good product to build, but that's basically the easy part. The factory is the hard part." — https://www.businessinsider.com/elon-musk-says-building-factory-100-times-harder-than-making-car-2019-3
Картинка в высоком разрешении — https://ic.pics.livejournal.com/ailev/696279/276990/276990_original.png

По мотивам https://www.researchgate.net/publication/200026050_Collaborative_Networks_Reference_Modeling
Обычно deep, «глубина» в речи означает рост числа уровней какой-то иерархии. Скажем deep learning — это многоуровневое обучение, то есть обучение нейронных сетей с числом скрытых уровней/слоёв больше одного. В углублении разделения труда речь идёт об увеличении числа уровней иерархии по отношению специализации (род-вид) между методами.
См. доклад Влада Свяжина рассуждениями об этой идее, с 1:04:11, https://www.youtube.com/watch?v=lpgpnCoV14w&t=3851s
Подходы к определению импровизации см. в https://ailev.livejournal.com/1730660.html
О плохих объяснениях рассказывается в курсе «Создание объяснений», см. также книгу Дэвида Дойча «Начало бесконечности. Объяснения, которые меняют мир».
Turton, Richard, et al. (2003) Analysis, Synthesis, and Design of Chemical Processes, Upper Saddle River, NJ: Prentice Hall.
Термин появился ещё в 2011 году https://go.forrester.com/blogs/11-02-07-i_dont_want_devops_i_want_noops/, но дебаты идут до сих пор, ибо путается создание платформы (где нужны пока люди) и её работа без людей.
https://www.anandtech.com/show/21408/tsmc-roadmap-at-a-glance-n3x-n2p-a16-2025-2026, к этим «проектным нормам» нужно относиться с осторожностью, https://www.iguides.ru/main/other/sovremennye_tekhprotsessy_grandioznyy_obman_razbiraemsya_v_marketingovykh_tonkostyakh_protsessorov/
https://en.wikipedia.org/wiki/Cognitive_behavioral_therapy на базе behavior and cognitive psychology, https://www.apa.org/ed/graduate/specialize/behavioral-cognitive
См. про архитектурную оптимизацию в https://ailev.livejournal.com/1464563.html
https://www.diapazon-pharm.ru/kisecnorastvorimye-kapsuly-preimusestva-i-spros, https://patents.google.com/patent/RU2569742C1/ru
https://www.researchgate.net/publication/343999144_How_Formal_Requirements_Specifications_Inhibit_Creativity_in_Software_Engineering, и то же самое про шаблонизированные требования https://www.researchgate.net/publication/354528878_How_Templated_Requirements_Specifications_Inhibit_Creativity_in_Software_Engineering. Эта тема «иллюзии требований» разрабатывается с 2013 года, https://www.researchgate.net/publication/255831240_The_Illusion_of_Requirements_in_Software_Development
https://ru.wikipedia.org/wiki/Клеточный_автомат, https://ru.wikipedia.org/wiki/Автоматное_программирование
)пример Netflix — https://jivimberg.io/blog/2023/09/04/the-inverse-conway-maneuver/, ещё один пример — https://www.thoughtworks.com/insights/blog/customer-experience/inverse-conway-maneuver-product-development-teams
Пример architecture characteristics worksheet — https://www.developertoarchitect.com/downloads/architecture-characteristics-worksheet.pdf, в классической инженерии их продолжают называть system quality attribute — https://en.wikipedia.org/wiki/List_of_system_quality_attributes
https://www.aia.org/sites/default/files/2024-11/AIA_Design_Deconstruction_Adaptability_Reuse.pdf
https://www.cerebras.net/blog/cerebras-wafer-scale-engine-inducted-into-the-computer-history-museum/
https://www.artlebedev.ru/izdal/yazyk-shablonov/ — по-русски pattern language переведён как «язык шаблонов».
В сборнике Transactions on Pattern Languages of Programming IV, 2019
https://en.wikipedia.org/wiki/Current_reality_tree_(theory_of_constraints), https://www.6sigma.us/six-sigma-in-focus/current-reality-tree/
https://www.amazon.com/How-Measure-Anything-Intangibles-Business/dp/1118539273, 3rd edition, 2014
Есть русский перевод, https://www.litres.ru/dzhez-hambl/uskoryaysya-nauka-devops/, но мы рекомендуем всё-таки читать оригинал
https://www.anthropic.com/news/paris-ai-summit, февраль 2025
Но некоторые архитекторы ещё в 2019 году выражали сожаление по поводу неиспользования термина и ухода от явного обсуждения ситуации, «ИТ-архитекторы же продолжают сидеть в своих башнях из слоновой кости, подобно Винни-Пухам, застрявшим после сытного перекуса в домике Кролика. Даже тег DevArchOps остаётся неизвестен гуглу и воспринимаемся им как бессмысленный набор символов», https://mxsmirnov.com/2019/06/06/architecture-as-a-code/#more-2892.
https://www.litres.ru/atul-gavande/chek-list-kak-izbezhat-glupyh-oshibok-veduschih-k-fatalnym-po/
Тут, конечно, не нужно путать с 6D для экспоненциальных технологий от Peter Diamandis и Steven Kotler (exponential organizations должны быть digitised, deceptive, disruptive, dematerialized, demonetized, democratized, это Singularity University в 2016, когда модно было искать везде экспоненты и единорогов) — https://www.diamandis.com/blog/the-6ds
https://en.wikipedia.org/wiki/Concurrent_engineering, не путайте с collaborative engineering, http://ailev.livejournal.com/943532.html
Подробней смотри серию публикаций https://ailev.livejournal.com/1549559.html, https://ailev.livejournal.com/1548016.html, https://ailev.livejournal.com/1550931.html
https://www.arxiv.org/abs/2502.19414, https://arxiv.org/abs/2502.06556, https://arxiv.org/abs/2502.09858
https://en.wikipedia.org/wiki/Cognitive_bias, https://utminers.utep.edu/omwilliamson/engl1311/fallacies.htm
Вот пример 2015 года, http://new.gva.vc/ru/about/news/512/?PAGEN_2=4
Для софта, например, https://www.guru99.com/code-review-tools.html, для информационных моделей
Дэвид Дойч, «Начало бесконечности. Объяснения, которые меняют мир»