Руководство по системной инженерии для инженеров-менеджеров
Анатолий Левенчук
Введение
Руководство по системной инженерии для инженеров-менеджеров наставляет фундаментальному методу работы: системной инженерии как способу изменения мира к лучшему. Поначалу системная инженерия развивалась главным образом в сложнейших аэрокосмических проектах, в инженерии транспорта, отличаясь от традиционных видов инженерии тем, что опиралась на системный подход, позволяющий увязать в одном инженерном проекте мышление об объектах самого разного масштаба — от маленького винтика в самолёте до огромного аэропорта, поддерживающего самые разнообразные перевозки самолётами. Сегодня практически все инженерные разработки в мире для систем самого разного масштаба (от отдельных веществ в химическом синтезе или деталей из какого-то однородного материала до обществ или даже человечества в целом, что позволяет говорить о «безмасштабности») делаются с использованием подходов системной инженерии: в них выделяются разработка концепции использования, концепции системы, архитектуры системы, управление версионированием и конфигурацией, делаются инженерные обоснования. Кроме безмасштабности современная системная инженерия опирается на третье поколение системного мышления, которое выходит за рамки одного жизненного цикла на идеи эволюции/развития, и поэтому в руководстве описана эволюционная/непрерывная инженерия: метод эволюционной/непрерывной разработки, непрерывного принятия архитектурных решений, непрерывного ввода в эксплуатацию системы. Системы создаются, а затем эволюционируют/развиваются как виды/species в непрерывно меняющемся окружении.
Руководство даст представление о том, чем занимаются инженеры в своей работе, даже если они не называются «инженеры» (например, менеджеры — это инженеры предприятия, врачи — инженеры человеческого тела, агрономы — инженеры урожая, продвиженцы — инженеры клиентуры). Особенность руководства в том, что оно даёт кругозор по созданию систем самой разной природы, которые не всегда сегодня ассоциируются с инженерной работой: простых механических систем без встроенных компьютеров (уровень «вещества»), киберфизических систем (со встроенным компьютером), живых существ (от бактерий и растений через животных до человека, взятого как биологическое существо, включая генную инженерию и медицину как методы инженерии живых существ), личностей (психология и образование как инженерные методы), организаций (системный менеджмент как инженерия предприятия), сообществ (строительство сообществ, маркетинговые кампании для инженерии клиентуры), обществ (госстроительство, политика как социальная инженерия), человечества в целом.
Тем самым освоить работу по нашему руководству предлагается не только «классическим» системным инженерам киберфизических систем, которые планируют далее освоить ещё много других прикладных методов работы, чтобы профессионально заниматься инженерией гаджетов, ракет и термоядерных реакторов, но и менеджерам, интересующимся тем, что делают в проекте инженеры (и эти менеджеры обнаружат, что они заняты системной инженерией непрерывно изменяющихся организационных систем) и предпринимателям-основателям предприятий (они, оказывается, тоже занимаются инженерией предприятий, но в предметах их интереса концепция использования целевой системы этого предприятия), а также представителям всех остальных профессий, которые занимаются изменениями мира: от агрономов и маркетологов до разработчиков софта и политиков (они тоже занимаются инженерией систем, просто их системы другой природы, нежели у классических «железных», программных инженеров и менеджеров).
Наше руководство уникально, ибо на данный момент большинство современных монографий, стандартов, учебников и руководств «железной» системной инженерии (systems engineering) хорошо доносят идею безмасштабности как применимости одних и тех же методов разработки, основанных на применении системного подхода в инженерии для самых разных систем самых разных масштабов, в том числе традиционно не понимаемых как инженерные. Но они основаны на предыдущем, втором поколении системного мышления: создатели в их графе однократно создают систему, а затем сдают её в эксплуатацию, что отражается в понятии «жизненный цикл системы» с упором на разовое введение в строй какой-то большой системы (например, атомной станции). Современные монографии, стандарты, учебники и руководства программной инженерии (software engineering), наоборот, хорошо передают эволюционный/agile/непрерывный характер разработки, идею непрерывного уточнения изменяющегося окружения уже работающей системы, уточнения потребностей внешних проектных ролей и непрерывный ввод в эксплуатацию всё новых и новых возможностей/features/traits для уже работающей системы. Но они абсолютно провальны в показе общеприменимости идей инженерной разработки к самым разным видам систем, ограничиваются только программными системами.
Наше руководство даёт гармонизированное (результат концептуального синтеза1) представление как о безмасштабности современной системной инженерии, так и о её эволюционном характере. Конечно, через некоторое время появится много литературы, которая закроет этот разрыв «железной» и программной инженерий, но пока «лучшее из двух миров» собрано именно в нашем руководстве, плюс обобщено на другие виды инженерий (менеджмент организаций и сообществ, учебные проекты, и т.д.).
В руководстве даётся основное представление о методах инженерии систем самой разной природы на самом высоком уровне абстракции, удобном для соотнесения этих методов для этих разных видов — начиная от традиционных для инженерии прошлого простых механических систем через сегодняшние киберфизические системы к живым организмам, личности, сложным социотехническим системам (предприятиям) и далее социальным системам — сообществам и обществам.
В руководстве излагается не конкретный вариант метода системной инженерии, принятый, например, в NASA или SpaceX, или полностью соответствующий текущей версии учебника системной инженерии INCOSE, по которому ведётся сертификация профессионалов в системной инженерии, или конкретный метод учебника agile системной инженерии компании Flow. Излагается не метод, который полностью соответствует духу и букве какого-то конкретного одного стандарта методов (они традиционно называются practice) системной инженерии, например ISO 15288:2023. Нужно помнить, что все эти международные и корпоративные стандарты и публичные документы чаще всего привязаны к работе в сложнейших аэрокосмических проектах (системный уровень киберфизической системы), часто устарели, трудно адаптируются к современным проектам, основанным на идеях вроде Lean Startup. Кроме того, эти стандарты подразумевают обучение на многочисленных специализированных курсах в порядке магистерской подготовки профессиональных системных инженеров киберфизических систем, а в нашем руководстве мы даём наставления на уровне фундаментального образования для инженеров и менеджеров на уровне относительно коротких курсов «Foundations of Systems Engineering», это только введение в специальность системного инженера. Для работы инженером в прикладных проектах, конечно, надо учиться дополнительно прикладным методам работы, принятым в вашей организации по соответствующим прикладным учебникам, регламентам, руководствам, инструкциям.
Наставления руководства могут оказаться неожиданными для инженеров, получивших классическое инженерное образование. Так, в руководстве отражается изменение в разделении труда между прикладными разработчиками (визионерами и прикладными методологами), визионерами и архитекторами, появление инженерии внутренней инженерной платформы (уже после выделения DevOps с многочисленными вариациями в самых разных видах инженерии), фактическое исчезновение классической инженерии требований (что вызывает максимальное отторжение у привыкших к работе с требованиями инженеров). Жизнь изменилась, мы не можем излагать в нашем современном руководстве по системной инженерии то, чему учили в вузах нас самих, не можем излагать опыт старых лучших инженерных проектов. Мы консультировались с системными инженерами из компаний-единорогов, чьи продукты используются миллионами людей, и они подтвердили: за последние пять лет ситуация с разработкой требований кардинально изменилась, кардинально изменились методы архитектурной работы, из роли «опытного разработчика» выделилась не только роль архитектора, но и роль методолога. Так что мы просто добавили разъяснений по этим вопросам, но инженерию требований в руководстве не излагаем, как устаревший уже метод работы.
Лучшие инженерные методы появляются сегодня сначала в программной инженерии корпоративных информационных систем (включая инженерию систем с искусственным интеллектом, включая методы инженерии данных), потом заимствуются с некоторым лагом (5-10 лет, хотя сегодня бывает и меньше) оттуда в классические проекты аэрокосмической и транспортной системной инженерии, а затем оказываются общеприменяемыми в самых разных проектах: непрерывное уточнение потребности в системе и разработка концепции использования с определением границ целевой системы и функций системы в её рабочем окружении в рамках стратегирования, непрерывная разработка самой системы прикладными инженерами с обязательным участием методологов, разработка системной архитектуры, обязательность инженерных обоснований, в том числе испытаний и частей системы, и системы в целом, непрерывная интеграция результатов работы самых разных разработчиков, и так далее.
Все эти методы уже абсолютно привычны для программных инженеров, успешно осваиваются работающими классическими «железными» инженерами, но для будущих инженеров, менеджеров и работников самых разных других специальностей (учителей, медиков, продвиженцев) нужно объяснить эти методы, дать их примеры, дать попробовать их применить в рабочем проекте. Первому знакомству с этими методами безмасштабной эволюционной системной рациональной (этот список эпитетов можно продолжать и продолжать) инженерии и посвящено наше руководство.
После освоения системноинженерной работе по нашему руководству вам будет предложено освоить работу по руководствам инженерии личности и системного менеджмента. В этих руководствах вы получите примеры адаптации описания разделения инженерного труда не только по созданию и развитию «железных» и программных систем, но и по развитию личностей, организаций, сообществ. Это тоже кругозорные руководства, для профессиональной работы тоже надо будет осваивать работу по прикладным курсам, руководствам, регламентам, инструкциям. После кругозорного фундаментального образования, конечно, нужно получать профессиональное образование: в реальных проектах на одном кругозоре далеко не уедешь.
Хотя освоение работы по нашему фундаментальному руководству по системной инженерии предполагается первым из инженерной серии руководств (перед освоением руководств по инженерии личности и системному менеджменту), оно возможно только после освоения мышления и работы по руководствам-пререквизитам, то есть руководствам по рациональной работе, системному мышлению, методологии. Из других пререквизитов укажем только на необходимость владения английским языком: вся оригинальная современная литература по системной инженерии доступна только на английском, на русском есть только переводы немногих классических (и поэтому уже устаревших) работ великих системных инженеров прошлого, причём нужно учитывать, что эти работы великих системных инженеров прошлого главным образом будут инженерными работами для относительно простых систем уровня вещества и киберфизической системы, а также там будет однократный «жизненный цикл», а не бесконечная эволюция системы на основе эволюционирующей современной архитектуры, отслеживающей саму возможность длительного развития системы с целью адаптации её к изменениям в жизни. Наше руководство по системной инженерии безмасштабно в отношении целевых систем самой разной природы, эволюционно в отношении инженерного процесса и неантропоцентрично в отношении задействования AI-агентов в качестве исполнителей ролей в инженерном процессе.
Основные наставления руководства изложены с использованием не столько стандартов системной и программной инженерии (они отражают идеи, которые были передовыми больше десяти лет назад, поэтому не отражают произошедшего с тех пор сдвига в эволюционную инженерию, но продолжают использоваться в сильно зарегулированных госорганами больших инженерных проектах создания кибер-физических систем типа атомной электростанции и авианосца, изменений инженерии там можно ожидать очень нескоро), сколько по современной литературе 2017-2025 годов. При этом в руководстве нет фрагментов, сгенерированных AI-системами.
В руководстве даны ссылки на почти два десятка англоязычных учебников и руководств по системной, программной инженерии и инженерии организаций, разъясняющих подробно те или иные положения курса. Больше половины этих учебников и руководств отсылают к примерам из программной инженерии, но мы надеемся, что при их изучении будут учтены идеи безмасштабности и применимости к системам самой разной природы (а идеи эволюционности/непрерывности разработки в них всех уже есть).
Руководство не делает акцента на моделеориентированную2 системную инженерию, ибо сегодня другой системной инженерии уже не бывает, вопрос лишь в выборе уровня формальности моделирования, а также опоры на самые разные языки моделирования. Эти языки системного моделирования отнюдь не все относятся к визуальным языкам начала 21 века, принятым для больших окологосударственных проектов классической системной инженерии. Упор делается инженерное моделирование с использованием low code систем (productivity tools, гибриды электронных таблиц и баз данных, типа excel в его современных версиях, coda.io, notion.so), а также всевозможных прикладных инженерных моделеров и систем автоматизации проектирования. Использованию AI не уделяется специальное внимание, это считается само собой разумеющимся.
История руководства начинается с 2012 года, когда автор начал чтение односеместрового курса «Введение в системную инженерию» (Foundations of Systems Engineering) на межфакультетской (впоследствии — межвузовской) кафедре технологического предпринимательства МФТИ. Буквально на следующий год курс был поделен на семестровый курс системного мышления, и отдельно — семестровый курс системной инженерии. Обучение на кафедре по этим курсам затем продолжили выпускники программы (Михаил Бухарин и Илья Бурдин). В Школе системного менеджмента работа над курсом продолжилась, несколько лет там курс «Системная инженерия» на базе курса системного мышления читал Вячеслав Мизгулин. В 2022 году было окончательно сформировано видение опоры курса системной инженерии на интеллект-стек методов фундаментального мышления, уделено особое внимание безмасштабности и нейтральности по отношению к самым разным видам систем, а также отражён эволюционный характер инженерии, окончательный отход от «водопадной» модели с её одним стадийным «жизненным циклом». В кооперации между Школой системного менеджмента и Русским отделением INCOSE была создана рабочая группа из инженеров, имеющих и опыт преподавания системной инженерии, и опыт руководства системноинженерными проектами, и опыт применения интеллект-стека методов фундаментального мышления к системам самых разных уровней. Рабочую группу возглавил К.Гайдамака, научным руководителем стал А.Левенчук. Версия курса 2022 года стала результатом работы этой группы, в которой прошло множество плодотворных обсуждений. Текст в итоге написан А.Левенчуком.
В 2023 году мы исправили много опечаток и заменили некоторые источники литературы в курсе на более современные, а в 2025 полностью переписали курс, чтобы согласовать его с терминологическими новациями курсов-пререквизитов, а также добавить роль прикладного методолога (функционального проектировщика, процессного инженера) в разделении инженерного труда. Более чётко в этой версии курса был прописан и эволюционный характер современной инженерии на основе расширенного эволюционного синтеза (eco-evo-devo). Весной 2025 года также «курс» превратился в «руководство», а «материалы курса» в «наставления руководства» что более точно отражает нацеленность текста на рабочий, а не чисто учебный контекст.
Это новое видение нашего руководства с учётом руководств-пререквизитов отразило в том числе и опыт многочисленных попыток преподавать какие-то основы системной инженерии в самых разных вузах: поскольку часы в программе на пререквизиты к освоению работы по руководству не были предусмотрены, большинство этих попыток оказались неудачными. Идеи безмасштабности и включению в предмет системной инженерии работы с живыми существами, организациями, сообществами и обществами вошли, в частности в INCOSE VISION 2035. В программной инженерии массовые изменения по линии непрерывности разработки прошли с переходом на микросервисные архитектуры, это стало массовым и отразилось в учебной литературе приблизительно с 2017 года (хотя сами идеи обсуждались ещё с момента выхода Agile manifesto в 2003 году). Системное мышление, которое в третьем своём поколении вышло за пределы жизненного цикла и включило в себя идеи эволюции, базирующиеся на общих физических законах, как раз помогает в понимании этого направления развития инженерных методов.
Спасибо Роману Варьянко за корректуру и ценные содержательные замечания.
Замечания и предложения по наставлениям руководства можно давать в чат поддержки программы рабочего развития инженеров-менеджеров https://t.me/systemsthinking_course (общий для руководств по рациональной работе, системного мышления, методологии, системной инженерии, инженерии личности, системного менеджмента), там вы можете не только задать вопросы инженерам-менеджерам, дать предложения авторам руководства. Наставления руководства регулярно обновляются, ибо системная инженерия быстро развивается, а руководство уделяет особое внимание работе по современным её методам, а не работе по-старинке (в инженерии старинными будут сегодня методы буквально пятилетней давности).
Оглавление
[Введение 1](#введение)
[1. Безмасштабная эволюционная системная инженерия 9](#безмасштабная-эволюционная-системная-инженерия)
[Инженерия 9](#инженерия)
[Системность инженерии как задающая её безмасштабность и эволюционность 16](#системность-инженерии-как-задающая-её-безмасштабность-и-эволюционность)
[Моделирование: «неинженерные» инженерные проекты 24](#моделирование-неинженерные-инженерные-проекты)
[Инженерия и эволюция 24](#инженерия-и-эволюция)
[Динамический ландшафт приспособленности 35](#динамический-ландшафт-приспособленности)
[Эволюционная неизбежность этических/политических проблем и инженерные подходы к их решению 43](#эволюционная-неизбежность-этическихполитических-проблем-и-инженерные-подходы-к-их-решению)
[Слова-термины в безмасштабной эволюционной инженерии и важны, и не важны 53](#слова-термины-в-безмасштабной-эволюционной-инженерии-и-важны-и-не-важны)
[Прикладная инженерия как специализация системной инженерии 62](#прикладная-инженерия-как-специализация-системной-инженерии)
[Задания 73](#задания)
[2. Архироль создателя/инженера и разделение инженерного труда 74](#архироль-создателяинженера-и-разделение-инженерного-труда)
[Роль системного инженера в её отличии от роли прикладного инженера 74](#роль-системного-инженера-в-её-отличии-от-роли-прикладного-инженера)
[Разделение инженерного труда 81](#разделение-инженерного-труда)
[Системная инженерия в основе сотрудничества 87](#системная-инженерия-в-основе-сотрудничества)
[Инженерия и наука 103](#инженерия-и-наука)
[Ненаучность инженерии. Эвристики 110](#ненаучность-инженерии.-эвристики)
[Инженерная наука 123](#инженерная-наука)
[Моделирование: мои инженерные проекты 132](#моделирование-мои-инженерные-проекты)
[Задания 133](#задания-1)
[3. Инженерный процесс 133](#инженерный-процесс)
[Тренды современной системной инженерии 133](#тренды-современной-системной-инженерии)
[Моделирование: инженерные тренды и мой рабочий проект 144](#моделирование-инженерные-тренды-и-мой-рабочий-проект)
[Что делают разработчики 145](#что-делают-разработчики)
[Смерть инженерии требований 156](#смерть-инженерии-требований)
[Моделирование: мой «испорченный телефон» 177](#моделирование-мой-испорченный-телефон)
[TEST концепция использования и концепция системы 178](#test-концепция-использования-и-концепция-системы)
[Разработка концепции использования и концепции системы 179](#разработка-концепции-использования-и-концепции-системы)
[Моделирование: визионер, разработчик, эволюционный архитектор в моём проекте 190](#моделирование-визионер-разработчик-эволюционный-архитектор-в-моём-проекте)
[4. Прикладная методология предметной области 190](#прикладная-методология-предметной-области)
[Функциональное проектирование 190](#функциональное-проектирование)
[Сценарии использования 202](#сценарии-использования)
[Задания 219](#задания-2)
[5. Эволюционная архитектура 220](#эволюционная-архитектура)
[Архитектура: было «про трудно изменяемое», стало «про облегчение изменений» 220](#архитектура-было-про-трудно-изменяемое-стало-про-облегчение-изменений)
[Архитектурные характеристики 225](#архитектурные-характеристики)
[Моделирование: архитектурные характеристики 232](#моделирование-архитектурные-характеристики)
[Архитектурные решения 233](#архитектурные-решения)
[Прохождение архитектурных развилок 239](#прохождение-архитектурных-развилок)
[Задания 243](#задания-3)
[Архитектурные стили 243](#архитектурные-стили)
[Задания 247](#задания-4)
[6. Эволюционное проектирование 247](#эволюционное-проектирование)
[Проект/design и проектирование/design 247](#проектdesign-и-проектированиеdesign)
[Моделирование: идеи для концепции моей системы 251](#моделирование-идеи-для-концепции-моей-системы)
[Принятие решения: прохождение развилок (trade-offs) 252](#принятие-решения-прохождение-развилок-trade-offs)
[Системное проектирование 259](#системное-проектирование)
[Проектирование как следование архитектуре 265](#проектирование-как-следование-архитектуре)
[Как неправильно понять первый подраздел про «требований теперь нет» 272](#как-неправильно-понять-первый-подраздел-про-требований-теперь-нет)
[Задания 276](#задания-5)
[Системный менеджмент и разработка 277](#системный-менеджмент-и-разработка)
[Задание 286](#задание)
[Безошибочность проектирования, точность изготовления, тотальная автоматизация инженерии 286](#безошибочность-проектирования-точность-изготовления-тотальная-автоматизация-инженерии)
[Задание 292](#задание-1)
[7. DevOps 292](#devops)
[DevOps и инженерия платформы 292](#devops-и-инженерия-платформы)
[Составляющие DevOps 301](#составляющие-devops)
[Управление конфигурацией 309](#управление-конфигурацией)
[Моделирование: рабочие продукты, которые вы изменяли 319](#моделирование-рабочие-продукты-которые-вы-изменяли)
[Задания 320](#задания-6)
[Чеклисты в регламентации 320](#чеклисты-в-регламентации)
[Задания 327](#задания-7)
[6-, Multi-, poly-, … D 327](#multi--poly--d)
[Интеграция данных 333](#интеграция-данных)
[Моделирование: конфигурационные коллизии 340](#моделирование-конфигурационные-коллизии)
[Задания 341](#задания-8)
[Цифровой двойник 341](#цифровой-двойник)
[Моделирование: цифровые модели, тени, двойники в рабочем проекте 347](#моделирование-цифровые-модели-тени-двойники-в-рабочем-проекте)
[Задания 348](#задания-9)
[8. Инженерные обоснования 348](#инженерные-обоснования)
[Испытания, проверка и приёмка, обоснования 348](#испытания-проверка-и-приёмка-обоснования)
[Моделирование: обоснования в инженерии 354](#моделирование-обоснования-в-инженерии)
[Что обосновывают в инженерии 355](#что-обосновывают-в-инженерии)
[Рациональность обоснований 362](#рациональность-обоснований)
[Задания 368](#задания-10)
[Обоснование выполнения требований стандартов (compliance) 368](#обоснование-выполнения-требований-стандартов-compliance)
[Инженерное обоснование деятельно, оно требует ресурсов 371](#инженерное-обоснование-деятельно-оно-требует-ресурсов)
[Испытания: это измерения 379](#испытания-это-измерения)
[Задания 387](#задания-11)
[Проблемы инженерных обоснований для существ, личности, сообщества, общества 388](#проблемы-инженерных-обоснований-для-существ-личности-сообщества-общества)
1. Безмасштабная эволюционная системная инженерия
Инженерия
Инженерия — это культура изменения физического мира к лучшему, подразумевающая рациональное принятие решений в ходе этих изменений:
-
Рациональное принятие решений — это отсутствие симпатической магии3, то есть действий с моделями/описаниями и верой в то, что реальность как-то сама отразит изменение этих описаний, отсутствие упований на «дружественную вселенную» или «злых духов». Подробно про рациональность было в руководстве по рациональной работе.
-
Фактически «изменение физического мира» означает или создание и развитие каких-то новых, ранее не существовавших систем, или развитие (изменение свойств/traits/features) каких-то уже существующих систем. Важно, что системы — это часть физического мира. Если физический мир в ходе инженерного проекта в конечном итоге не меняется — то это не инженерный проект, его можно не делать, физический мир ведь всё равно не изменится! Иногда «изменение» систем в проекте означает и уничтожение, если это как-то меняет мир к лучшему. Подробно про системы было в руководстве по системному мышлению.
-
Культура — это следование методу работ, который общий для какого-то сообщества. Наше руководство по системной инженерии как раз про типовое разложение инженерной культуры на составляющие её культуры/методы/практики/стили (синонимов тут много). Подробно про культуры/методы работы было в руководстве по методологии.
Как понимается «изменение к лучшему»? Тут есть несколько вариантов, отвечающих на разные интересы/concerns:
-
Изменения к лучшему — оценку того, «к лучшему» или «к худшему» эти изменения, даёт этика. Этика — это фундаментальный метод мышления, входящий в интеллект-стек (по этике есть отдельный раздел в руководстве по интеллект-стеку). Выполняется этот метод ролью совести. Простых ответов не будет, ибо современная системная этика учитывает конфликты между множеством системных уровней: что для клеток печени «мы растём!», то для организма «рак печени».
-
Изменения к лучшему — это часть культурной/техно-эволюции, часть бесконечного развития цивилизации, часть процесса деятельного (изменяющего мир!) познания, тем самым он не заканчивается разовым проведением какой-то одной системы по жизненному циклу, а непрерывно вводит в эксплуатацию новые и новые изменения, ввод в эксплуатацию непрерывен/continuous, он не происходит один раз за время проекта, это не «водопад» для одного организма (development), а эволюция для технического вида/species с необходимым внутривидовым разнообразием и даже порождением новых видов. Неважно, сколько там было организмов в ходе эволюции: один с заменяемыми частями, или множество последовательных. В инженерии, как и биологической эволюции, доступны множество «почти одинаково выгодных» решений, выгода всегда многоуровневая, ухудшения в выживаемости систем часты, нейтральные решения более редки, крупные улучшения в выживаемости встречаются очень редко. Тут, правда, есть оговорка: эволюция не всегда ведёт к «прогрессу», «к лучшему» в абсолютном смысле, независимо от места и времени. В eco-evo-devo (экологической эволюционной биологии развития) понятие «прогресс» обычно не понимается в терминах универсального или неотъемлемого улучшения в направлении к предопределённой глобальной/абсолютной цели — если сейчас надо спасаться от холода, то приобретение печки сегодня будет полезно, а если завтра наступит жара, или даже сегодня, но при переезде в другое место — эта же печка окажется вредной. Современное понимание эволюционной оптимизации подразумевает, что «прогресс» можно описать как увеличение сложности, разнообразия или интеграции в некоторых «родословных» систем, но эти изменения не обязательно «лучше» независимо от места и времени. Они лучше только относительно определенных сред или проблем, «здесь и сейчас» или «там и тогда». «Изменения» тем самым не является универсально полезными, универсальными «к лучшему», они не представляют движение к единому идеальному состоянию, но они могут быть выгодными в текущем окружении развиваемой системы.
-
Изменения к лучшему — это действия по минимизации свободной энергии целевой системы и/или её надсистемы, согласно теории деятельного рассуждения (active inference). Эта минимизация «свободной энергии» сводится к минимизации неприятных «сюрпризов» типа «система разрушилась и рассеялась в окружающей среде». Другой вариант того же рассуждения про минимизацию свободной энергии — это многоуровневые эволюционные оптимизации инженерных систем, отражающие неустроенности/frustrations от конфликтов между системными уровнями (было более подробно рассмотрено в руководстве по системному мышлению). В ходе развития системы неизбежно будут оставаться и даже множиться (эволюционный рост сложности, увеличение числа системных уровней!) неустроенности в целевых системах, и приходится снова и снова инженерно/деятельно/практично решать сложную оптимизационную задачу на многих системных уровнях, опять всё упирается в эволюцию системы и сопутствующую эволюцию графа создателей системы. Ключевое «к лучшему» тут — это более длительные сроки удержания целостности какой-то системы за счёт адаптации (постоянных изменений состояния этой системы перед лицом много превосходящих внешних воздействий). Грубо говоря, «к лучшему» — это когда меньше ожидания незапланированного разрушения системы, меньше байесовских неприятных «сюрпризов» типа «тебя съели», «ты умер от голода», «ты не смог размножиться». Конечно, это просто метафора для инженерных систем, но спросите у серийных предпринимателей, насколько они воспринимают такие высказывания как метафоры по отношению к их бизнесам по изменению мира к лучшему, и вы поймёте, что в каждой шутке есть доля шутки. Про эту долю шутки мы ещё не раз вспомним в нашем руководстве.
-
Изменения к лучшему в экономике — это изменения, которые приносят максимальную пользу владельцам развиваемой системы. Value/utility переводим как «польза», ответы на вопрос «ценна ли твоя система» и «полезна ли твоя система» обычно сильно различаются: все системы чем-то ценны, но мало систем полезны. Максимизация пользы для владельцев целевых систем приводит к обмену ими своих ресурсов на эту пользу (субъективная теория полезности4) при этом граф создателей получает от них достаточно ресурсов, чтобы создатели поддерживали собственное существование.
Конечно, есть и множество других вариантов понимания «к лучшему», но мы ограничимся этими, добавив ещё специфический системноинженерный вариант создания и развития «успешных систем» как соответствующей ожиданиям самых разных проектных ролей. Главное, что все эти понимания «к лучшему» или «успешности» предусматривают физические изменения в мире как конечный результат (появление, изменение или исчезновение какой-то системы или целого ряда систем), а также указание на то, что это изменение было «к лучшему» или «успешно», то есть достигнуты какие-то оптимальные характеристики системы, а не произошли какие-то случайные изменения ради изменений. Рациональность работы в инженерных проектах в том, что решения проекта ведут «к лучшему миру» и к «успешным системам», а не ведут «куда-нибудь».
Современная (SoTA, state-of-the-art, лучшая из известных на сегодняшний момент, и именно о такой мы будем говорить в нашем руководстве) инженерия является системной, ибо её методы опираются на системное мышление в его третьем поколении. Всё это «движение к гибкости/agile» — это просто отражение постепенных изменений системного мышления, которое в конечном итоге привело в его третьем поколении к восприятию неэргодических (то есть с памятью) физических систем в том числе и в эволюционном масштабе времени. Напомним, что учёт графа создателей (системы не сами себя делают, как живые организмы) — это второе поколение, а в первом поколении царил экологический подход — рассматривались только системы в их окружении/среде (и внимание к окружению/среде какой-то системы часто подавалось как «экология»).
Эволюционирующий усложняющийся мир может рассматриваться, как в биологии — «сам себя эволюционирует», как целое, «я сам себя почесал». Но можно рассматривать этот мир так, что одни системы-создатели в нём развивают другие системы, которые в свою очередь будут системами-создателями, «моя правая рука под управлением моего мозга почесала левую руку», никакого запутывающего «само». Тогда мы можем предположить, что какие-то из этих агентов-создателей достаточно интеллектуальны, чтобы их мышление было рационально, в том числе системно в части моделирования мира и принятия решений — они и будут инженерами, практикующими инженерную культуру изменения мира к лучшему.
Создаваемые инженерами системы в таком быстро меняющемся в ходе (био, культурной, техно) эволюции мире имеют много системных уровней, число которых непрерывно растёт. Системы разных видов/species (включая технические системы, включая биологические системы, в том числе и сложные — вроде биогеоценозов) на каждом из этих уровней требуют каких-то особых методов работы для их создания и развития. Так, с созданием генно-модифицированных свиней работают не так, как с созданием людей — хотя в части генетики они очень похожи. Создание пастбища отличается от создания города, хотя это «участки земной поверхности».
Согласно приведённому определению, SoTA инженерия должна быть системной и не просто многоуровневой, но и безмасштабной (вообще не привязанной к каким-то уровням, «ренормализуемой» — с одинаковой математикой, применимой ко всем уровням), и эволюционной (в инженерии иногда говорят «непрерывной», continuous):
-
Безмасштабность (общность основных положений инженерии для всех возможных масштабов, отсутствие указаний на масштаб систем) гарантирует, что инженеры (рационально мыслящие и действующие создатели) не остановятся в своей оптимизации мира «к лучшему» на границе какого-то масштаба. Это в системной инженерии называют «рекурсивным применением системной инженерии», одно и то же мышление для систем разных системных уровней (разных масштабов). Безмасштабность означает, что инженеры (которые, конечно, не будут называться инженерами, а будут называться самыми разными другими ролями в зависимости от вида систем и специализации — но нас тут интересует то, что они меняют мир к лучшему на основе рационального и системного мышления) не изменят личность так, что от этого развалится общество, не сделают киберфизическую систему такую, что она уничтожит всё живое в радиусе трёх километров. Нет, они любую систему рассматривают в контексте её системного окружения, причём не забывают это рассмотрение доводить до времени эксплуатации. Можете подумать о том, как по-разному аргументировали это безмасштабное «изменить мир к лучшему» инженеры, создававшие атомную бомбу, на каком уровне они останавливали свои рассуждения, примат какого системного уровня (уровня сложности) был у них в голове — вещества, киберфизической системы, существа, личности, организации, сообщества, общества, человечества? Функциональную ли они рассматривали иерархию, или конструктивную? Или речь идёт о геополитике, то есть примат был в пространственном, территориальном разбиении?
-
Эволюционность (непрерывность, «continuous everything» в agile методологиях разработки) означает, что каждое изменение системы её создателями («умная мутация»5) в порядке попытки оптимизации под непрерывно изменяющееся понимание ситуации использования системы и ситуации создания и развития системы не будет разовым. Поток этих инженерных изменений («умных мутаций» в эволюции системы), влияющих на успешность системы в условиях непрерывного изменения ситуации с потребностями проектных ролей, будет в проекте нескончаем. Текущая успешность системы будет непрерывно отслеживаться во времени командой проекта, а не удостоверяться разово на момент единичного за время жизни системы ввода в эксплуатацию. Эволюционность (в инженерии это «continuous everything» с акцентом на непрерывный ввод в эксплуатацию, continuous delivery) означает, что одно разовое создание экземпляра или серии системы вряд ли возможно, и нужно непрерывно подстраивать систему-как-вид/species под стремительно меняющееся окружение, непрерывно вводить в эксплуатацию всё новые и новые «фичи», менять характеристики/traits как результат «умных мутаций». Какие-то из этих новых фич позволят системе выжить среди систем-конкурентов, какие-то окажутся ненужными и временными, но непрерывность означает, что инженерия не разово делает системы, а evolve/«эволюционирует» их. По-русски это лучше будет говорить «развивает» (ибо «выращивает» сложно говорить про какой-нибудь ледокол-атомоход, но можно сказать, что этот ледокол-атомоход развивается. Впрочем, идея эволюционности/непрерывности инженерии до атомоходов ещё не дошла, её мы больше наблюдаем на примере программного обеспечения. Посмотрите, как часто обновляется Windows или даже BIOS в вашем ноутбуке, как часто обновляется модель LLM у провайдера вашего AI-чата). Но вот до космических кораблей эта идея уже дошла, большинство космических компаний уже выпускают каждый новый экземпляр ракеты с улучшениями конструкции и программного обеспечения.
Альтернативная, более простая формулировка инженерии — это создание успешных систем (было подробно разобрано в руководстве по системному мышлению). Успешность системы определяется как соответствие её ожиданиям внешних проектных ролей (stakeholders), которых множество самых разных. Успешность системы для её оценки сразу ведёт к безмасштабному (на многих уровнях) рассмотрению, ибо для систем на разных системных уровнях будут находиться разные проектные роли. А ещё ожидания этих ролей по поводу системы динамичны, так что систему надо будет непрерывно менять, чтобы она оставалась успешной — надо систему непрерывно эволюционировать/адаптировать/модернизировать/развивать/обновлять (используют по факту все синонимы).
Определение системной инженерии через создание и развитие (если не «с нуля»/greenfield, а просто изменение каких-то систем, brownfield, то и просто «развитие», без создания) успешных систем более традиционно и основывается на классических рассмотрениях проектов системной инженерии, ведущихся ещё со второго поколения системного подхода (с 80х годов прошлого века). Если команда проекта всех договорила между собой (с учётом соображений безопасности и того, кого считать врагом, а кого считать другом и клиентом) и продолжает договаривать всё время существования системы, то система успешна. Обратите внимание на формулировку: не «договорилась со всеми», а «всех договорила».
Если всех не договорили и при изменениях ситуации не успевают передоговаривать (непрерывное передоговаривание, а не разовое) — система оказывается не успешна. Тут по факту тоже оптимизационная задача, но рассмотрение не столько многоуровневое/безмасштабное системное, сколько методологическое/культурное по линии разнообразия ролей, предметов их интереса и интересов в этих предметах, а также выходящее за рамки одного жизненного цикла техноэволюционное рассмотрение.
«Успешность системы» — в разы более конкретный критерий, чем абстрактное «изменение мира к лучшему»: «если все внешние проектные роли, которые мы выявили, непрерывно соглашаются с ходом и результатами проекта, то это и означает, что мы мир изменяем к лучшему — наша система непрерывно успешна».
Классическая системная инженерия ещё несколько лет назад выкинула бы отсылку к эволюции, слово «непрерывно», ибо в головах системных инженеров прошлого система изготавливалась однократно, и больше не менялась по ходу эксплуатации, не нужно дальше никого договаривать вокруг системы и её графа создателей, не нужно дальше менять систему. Модернизации системы, конечно, предусматривались, но они были абсолютно автономными: тоже разовыми проектами, а не частью непрерывно ведущейся инженерии. Ближе тут, конечно, была концепция апгрейда (например, апгрейд компьютеров, который был популярен в 90е годы прошлого века6). Но это была «инженерия пользователя» для редкого класса систем, а не штатный способ организации инженерной деятельности. В телефонах наоборот: апгрейд аппаратный был запрещён (невытаскиваемая батарейка, отсутствие слота для внешней памяти), зато расцвёл апгрейд прошивок и апгрейд приложений. Телефон перестал быть неизменяемым объектом, даже когда попадал к покупателю. Это, конечно, создаёт и множество проблем (чей это теперь телефон, если его купили, но продавец продолжает его «производить» — обновлять и модернизировать? Ответ не такой очевидный7). Автомобиль Tesla стал программно-аппаратным комплексом, который регулярно обновляется в программной части.
Но тут кроется и много проблем: разработка обычно центрируется на поведении целевой системы в её непосредственном системном окружении, то есть главным образом на двух системных уровнях. Если в таком подходе разрабатывается киберфизическая система, то могут не учитываться соображения более высоких системных/эволюционных уровней — включая уровни бизнес-экосистемы (бизнес-сообщества), общества, человечества.
Необязательно речь об оружии, где мнение противника о том, что считать «успешным оружием» или «успешным боевым подразделением», заведомо будет учтено с обратным знаком. Например, представьте какую-нибудь «социальную сеть»::система или «новостной портал»::система, и влияние этих по СМИ на «общество в целом»::система. Как учесть такое влияние, кто из внешних и внутренних проектных ролей этим влиянием озабочен? И речь тут даже может идти не о том, что СМИ могут распространять вредные и полезные идеи — одновременно, и непонятно будет, больше от них зла или пользы (запреты соцсетей чаще всего связаны с предположением, что даже малое количество источников даже умеренно вредных идей перекрывает всю пользу от во много раз большего числа источников существенно полезных идей, при этом вредность идей может очень по-разному оцениваться чиновниками разных стран). Всё может быть и проще, ибо идеал для таких сервисов — это максимизация времени пребывания на этом портале всех, кто туда зачем-то зайдёт, алгоритмы настроены именно на это. И эти алгоритмы постоянно перенастраиваются по мере изменения интересов широкой публики, чтобы никто от этой максимизации не убежал (инженерия непрерывна).
Но полезно ли это для общества в целом? Сутками «тупить в вконтакт/тикток/телеграм» хорошо ли для личности, сообщества, общества, человечества? А ведь именно длительность времени «тупления в соцсеть/портал» будет критерием успешности разработчиков соцсети/портала и акционеров фирмы-провайдера соцсети/портала как успешного сервиса по возможности «тупить» и потреблять при этом рекламу вместо чего-то полезного (да и что тут будет «полезным»?). И искусство пиара/пропаганды тут подсказать клиентам сети/портала, что «тупление в соцсетях» надо называть «развлечением и отдыхом», так называемый «рефрейминг», переформулирование зла в добро. Потом оказывается, что почему-то алгоритмы для увеличения времени просмотра подсовывают не трудные научные статьи, а ровно наоборот — хлёсткие фейки.
Могут не учитываться соображения внешних проектных ролей и по более низким системным уровням, чем уровень целевой системы (то есть уровней подсистемы целевой системы). Если это идеологический геополитический (читай: «военный») или религиозный проект, то вполне может зайти речь об игнорировании интересов огромного числа обычных граждан — их жизни могут приносить в жертву каким-то геополитическим или религиозным целям. «Обществу» или «сообществу» будет ой как хорошо (например, какое-то общество выиграет в войне), но вот нескольким миллионам человек этого общества вдруг может оказаться ой как плохо по сравнению с вариантом без войны, но они будут проигнорированы, ибо геополитические или религиозные проекты принципиально не работают с масштабом отдельных людей! А потом пройдёт немного времени, и мнения людей поменяются — то, что считалось успехом, будет считаться большой ошибкой. Принесение в жертву людей «ради всего хорошего» вдруг окажется принесением в жертву «по трагической ошибке»: «хотели как лучше, получилось как всегда».
Этот критерий «успешности» конкретней, чем «к лучшему», но список недостатков можно продолжать и продолжать: у каждой проектной роли может быть множество интересов, часть из которых может быть удовлетворена, а часть — нет, поэтому роли могут быть «частично удовлетворёнными», а ещё не все проектные роли обычно выявляют и интересуются тем, как система вместе с её графом создателей (проблемы могут быть даже не в целевой системе, а в какой-то системе из графа создателей — например, экологам может нравиться целевая система, но не нравиться загрязнение окружающей среды производящим эту целевую систему заводом) удовлетворяет ожиданиям. Опять же, всегда можно найти политически озабоченные роли, удовлетворить которые будет невозможно, так что чисто формально никакая система не может стать полностью успешной, можно говорить о какой-то шкале успешности, но не о бинарной характеристике. Можно даже обсуждать: успешность тут кардиналистская (можно получить оценку в каких-то единицах, например, процентах от 0% до 100%), или ординалистская (численной оценки дать нельзя, но можно определить, что одна система успешней другой). Можно говорить о том, что успешность — это не скалярная, а векторная величина, она многомерна.
Системность инженерии как задающая её безмасштабность и эволюционность
Особенность современной инженерии в том, что она по факту стала системной: создатели создают не просто какие-то «артефакты» (объекты искусственного происхождения), а именно системы, как они понимаются в современном системном мышлении. Это означает, что она сразу принимает постулаты системного подхода в явной (классическая системная инженерия) или неявной форме (разные другие виды инженерий, где системное мышление используют без явных к нему отсылок, «неосознанно»). Это всё объяснялось в руководстве по системному мышлению:
-
Изменение мира к лучшему происходит путём эволюции/развития/адаптации систем на многих системных уровнях, выделяемых по отношению «часть-целое» несколькими разными способами в момент эксплуатации, это тезис первого поколения системного мышления.
-
Методы создания систем (во втором поколении системного мышления появились создатели системы в разных ролях, они работают по разным методам) на разных системных уровнях разные, у них даже могут меняться имена. Если «железную» деталь-подсистему «изготавливают», то мастерство как подсистему личности человека (или даже робота, у которого набор его мастерств недостаточен для признания личностью) «обучают» или его «осваивают» (в зависимости от референтного индекса: внешней или внутренней позиции восприятия, у детали ведь нет внутренней позиции восприятия, а у человека есть, у робота — можно уже обсуждать, там «философская серая зона»). В любом случае, это методы целенаправленного развития какой-то системы — изменения физического мира «к лучшему».
-
Третье поколение системного мышления говорит, что однократным созданием системы в рамках «жизненного цикла» дело не обходится, процесс разработки оказывается эволюционным/непрерывным, это часть со-эволюции технического мира. Непрерывно оптимизируем конструкцию системы и подстраиваем её функции, чтобы как-то адаптироваться к непрерывно меняющемуся окружению. А ещё непрерывно оптимизируем системы в графе создателей, чтобы адаптироваться к непрерывно меняющейся целевой системе и непрерывно меняющемуся инженерному процессу её развития.
Если принять эти положения в полной мере, то системная инженерия будет безмасштабна/scaleless/scale-free: не зависеть от масштаба/размера систем, эволюционного системного уровня. Термин этот идёт из физики, иногда об этом говорят как многомасштабность/multiscale, но это менее точно: применимость ко всем масштабам (безмасштабность) — это вовсе не учёт только нескольких выделенных заранее масштабов, но отсутствие привязки к масштабу в рассуждениях. Иногда в физике эту «безмасштабность рассмотрения» относят к использованию одного и того же математического аппарата, ренормализации8.
Безмасштабность означает «вынос за скобки» того общего, что имеет инженерия как изменение мира к лучшему на всех масштабах, всех уровнях эволюционного стека — это означает «одну и ту же математику», «одну и ту же концептуализацию для мышления» (мы предлагаем её в наших руководствах для инженеров-менеджеров и называем мета-мета-моделью мира, «картиной мира инженеров-менеджеров») на разных системных уровнях, а также удержание общего мышления обо всех уровнях сразу — хотя бы попытка оптимизировать системы для учёта всех конфликтов между всеми уровнями (даже теми, о которых мы не знаем! Как минимум, сделать попытку узнать о них!).
Современные инженерные проекты будут заниматься оптимизацией своих систем в части минимизации конфликтов системных уровней не разово в попытке угадать какой-то «оптимум» для «текущей ситуации», а довольно долго, развивая систему для подстройки под непрерывно меняющиеся обстоятельства. Впрочем, если считать «безмасштабность» применимой и ко времени (масштаб времени эксплуатации релиза, масштаб времени создания релиза в ходе непрерывного ввода в эксплуатацию, масштаб времени всей непрерывной разработки), то непрерывность инженерии — тоже следствие безмасштабности: учитывается не один масштаб физического времени, а все, причём логических времён тоже несколько (время эксплуатации, время создания, методологическое время отработки графа создателей — разные роли интересуются разными временами).
В нашем руководстве мы довольно грубо и почти произвольно в методических/учебных целях определяем уровни этого системноинженерного/эволюционного стека физических масштабов как (от более крупных к более мелким масштабам):
-
Вселенная (пока разговоры об инженерии для вселенной в целом носят сугубо теоретический характер, а ещё ведь есть и концепция «мультиверса», как множественности миров. Но приводим тут как предельный масштаб/размер)
-
Цивилизации в целом, инопланетные и человечество (тут тоже чисто гипотетическая инженерия, уровень привели только для того, чтобы лучше показать принцип выделения уровней по отношению часть-целое)
-
Человечество — мы тут одни на маленьком одном глобусе (хотя есть мысли уже насчёт Марса), и неплохо бы изменить всё человечество к лучшему (в том числе защитить от астероидных опасностей, вымирания от техногенных катастроф, барьеров роста из-за ограничений в экологии и т.д.). Конечно, никто не может похвастаться тем, что занимается инженерией человечества, хотя желающих — хоть отбавляй.
-
Общество — каталлактическая самоорганизация по фон Хайеку9 (не знаем контрагентов в лицо, ибо их слишком много, не знаем интересов этих контрагентов, ибо они могут занимать самые разные роли), но общество в целом тоже может быть достаточно организованным и некаталлактически (то есть через силовые органы власти как организации с понятным подчинением принуждать всех остальных исполнять приказы нескольких человек), чтобы выставлять границы на свою территорию и противодействовать своему исчезновению при агрессивных изменениях окружения (скажем, войны с другими обществами) или изменениях в своей организации (скажем, захват власти религиозным фанатиком или диктатором и последующая сознательная или даже неосознаваемая их работа по уничтожению этого общества в силу каких-то иррациональных убеждений). Желающих заняться инженерий обществ много, они отчаянно конкурируют друг с другом, цели их часто прямо противоположны. Поэтому говорить об инженерии общества (социальной инженерии) трудно: влиять как-то можно, но уж точно нельзя предсказать результаты этого влияния.
-
Сообщество (людей) —community, community of practice10 (CoP, сообщество практики), learned society11 (наученных создателей, не учёных!), school of thought12 («незримый колледж») из википедии: все говорят о том, что речь идёт о группе агентов, имеющих общую культуру (метод, мастерством выполнения которого владеют все в этом сообществе). Можно говорить и о племени (очень модно!), и о «муниципальном образовании» типа «деревня, где все друг друга знают», землячестве бывших (или даже нынешних) членов одного общества в каком-то другом обществе. Ориентируемся на число Данбара13 (150), но с учётом современных компьютерных средств («записных книжек», социальных сетей) человеческая «память на лица» быстро растёт. В сообществе всё равно может быть и больше людей/личностей, чем можно помнить даже с помощью записной книжки. Например, число системных инженеров киберфизических систем в Международном совете по системной инженерии (INCOSE) на 2023 год — более 2200014, эти люди считают себя членами сообщества системных инженеров, тем самым примерно известны их ролевые интересы. Это не означает, что речь идёт о традиционной организации, которая создаёт какую-то целевую систему, или что все там примерно знакомы друг с другом и доверяют друг другу сильно больше, чем своим соседям по улице. Сотрудники штаб-квартиры INCOSE, однако, занимаются построением сообщества системных инженеров как целевой системы, действуя методами управления сообществами (об INCOSE в нашем руководстве будет отдельно сказано через несколько разделов). А маркетологи пытаются делать сообщества потребителей каких-то продуктов, «клиентуры» как множества клиентов. Как думать о сообществах говорилось в руководствах по системному мышлению и методологии, также наставления о том, как развивать сообщества даны в руководстве по специализации системной инженерии для организаций, то есть руководстве по системному менеджменту. Нам сообщества важны для того, чтобы их развивать, а community management сейчас традиционно рассматривается в рамках инженерии организаций (организация представляет собой в том числе и сообщество сотрудников). Тут тоже надо учесть, что менеджмент сообществ не даёт предсказуемых надёжных результатов, поскольку на каждого формального менеджера сообщества найдётся десяток неформальных менеджеров, которые будут организовывать это же сообщество в соответствии со своими представлениями о «лучшем».
-
Организация — это организованные (то есть с понятными ролями и полномочиями каждого агента по распоряжению трудом и капиталом) группы агентов. Инженерия предприятия как «организовывание» работает с системами этого уровня, инженерия на стадии эксплуатации получившейся организации — это операционный менеджмент. Руководство по инженерии организаций тем самым — это руководство по системному менеджменту. Связь прикладной инженерии целевой системы организации и инженерии организации-создателя системы (системного менеджмента) обсуждается в нашем руководстве в разделе эволюционной/непрерывной разработки.
-
Личность — и тут «инженерия личности» (хотя так и не говорят, но мы советуем думать именно так!) сводится к разным психотерапиям («ремонт» личности), коучингу (помощь в стратегировании), образованию, просвещению. Включать ли сюда разные варианты обучения «разумных роботов», то есть личностей не на базе homo sapiens? Почему бы и нет. Поэтому тут можно рассматривать и проекты развития AI, и проекты создания киборгов из людей и классических компьютеров в качестве экзокортекса Грубо говоря, развитие человека путём добавки внешней памяти и возможности простых вычислений, ибо добавка искусственного зрения, искусственной печени и т.д. — это уже более низкий системный уровень, «существа». Развитию личности посвящён отдельное руководство по инженерии личности.
-
Существо — тут разведение живых существ, включая «системную биологию» как разработку и производство полностью искусственной жизни. Но в целом тут инженерия и вирусов, и бактерий, и растений (агрономия), а дальше червей, рыб и до зверей (включая приматов и даже человека вне аспектов его разума). Медицина/ветеринария, фермерство, генная инженерия — это всё оказывается инженерными дисциплинами, «изменением мира к лучшему». Сюда же трансгуманизм как отрыв личности от обязательного использования генома homo sapiens (хотя усиление интеллекта живых организмов уровня выше возможности планировать представляется принадлежащим к уровню личности. Граница существа и «разумного существа» весьма размыта, как и граница «робота», «киборга», «существа»).
-
Киберфизические системы (физические системы, включающие классический и AI-софт на компьютере-контроллере датчиков и эффекторов/актуаторов). Тут классическая «железная» системная инженерия с её классическими видами систем: ракеты и самолёты, атомные и солнечные электростанции, умные (то есть обвешанные датчиками и кое-какими исполнительными устройствами) дома, роботы-пылесосы.
-
Косное вещество (молекулы, простые механические детали): тут от органического синтеза до инженерии мыльниц и электролампочек, то есть инженерия простых систем без сложного управления с контроллерами-компьютерами в их составе.
Конечно, в системноинженерном/эволюционном стеке присутствуют все обычные проблемы представления системных уровней какой-то системы (тут дана вся вселенная как система) в виде даже не дерева, а «стека», тем более неадаптированного к условиям какого-то конкретного проекта:
-
Легко находится множество новых уровней внутри одного уровня из этого стека, поэтому для целей какого-то конкретного проекта может существовать множество вариантов такого стека (скажем, у биологов уровень биогеоценоза — явно не просто «существо», один организм, об этом будет чуть позже, и этот «биогеоценоз» явно система, но которая непонятно как соотносится «сообществом людей»::система (хотя понятно как с «сообществом» в биологии15 как группой популяций) или «обществом»::система — особенно, если не рассматривать в рамках конкретного проекта, например, обустройства природного заповедника).
-
Не оговорено, это функциональное, конструктивное или пространственное разбиение, а также есть возможность одновременной множественности таких разбиений (нестрогость иерархии). Считаем, что на границах уровней системы в рамках этих разбиений совпадают, но это не всегда факт: так, внутри одного и того же общества легко выделить разные сообщества, составленные из одних и тех же людей, и даже разные организации. СМД-методология называет это «популятивными объектами»16, когда люди одновременно входят в состав разных их устойчивых групп, термин «популятивности» был позаимствован из популяционной биологии, об этом тоже будет чуть дальше.
-
Каждый уровень включает не одну систему, а множество их самых разных, это больше «иерархия/дерево», а не «стек», а системы на каждом уровне нетривиально связаны.
Тем не менее, мы принимаем за основу в нашем руководстве именно такой системный/эволюционный стек роста масштабов и тем самым роста системной сложности в части составления целых объектов из их частей. Главное в нашем руководстве по системной инженерии — наставление по компактному типовому инженерному рассуждению о том, как создавать и развивать системы (рассуждение об инженерном процессе, методе разработки):
-
независимо от природы и масштаба системы, её функционального назначения в надсистеме
-
рекурсивно (то есть для систем разных системных уровней) и
-
итеративно (для разных моментов времён создания, развития и существования работающей/эксплуатирующейся системы).
Повторим времена, важные в рассмотрении эволюционной/непрерывной/agile разработки всех этих систем различной природы:
-
Время эксплуатации одной версии/релиза системы, скажем, автомобиля Tesla с одной версией автопилота.
-
Время доработки/модернизации очередной версии системы (время разработки, малый масштаб), скажем, разработка очередной версии автопилота и интеграция его в автомобиль Tesla.
-
Время эволюции системы как вида: непрерывная инженерия (время разработки, большой масштаб), общее время разработки и выпуска разных вариантов автомобилей Tesla, включая разработку разных версий автопилота.
Конечно, вы можете, и даже должны адаптировать эти стеки систем разных масштабов (помним, например, про платформенные стеки) для ситуации вашего проекта. Самый простой способ это сделать — это выписать конкретные масштабы и виды систем из вашего проекта, выявив их по типам из нашего руководства (помня при этом, что эти уровни выделены более-менее произвольно, для целей упрощения понимания). Например, если вы создаёте таблетку из лактобактерий как биодобавку, вам потребуется как-то изменить (в том числе уговорить принимать эту таблетку! Свойство вменяемости/уговариваемости у роли «пациент» — комплаентность17) системы на следующих уровнях стека:
-
Потребнадзор::роль представителя интересов сообществ и общества
-
Клиентура::сообщество (важно для продвижения: маркетинг, реклама, продажи)
-
Пациент::клиент::личность
-
Желудок и кишечник::органы (части организма как подуровня существа)
-
Таблетка::«косное вещество» (если таблетка в оболочке — термин меняется на «капсула», в ней будет желатиновая оболочка и активное вещество в форме порошка).
-
Лактобактерия::клетка (подуровень одноклеточного организма уровня существ)
В этом примере есть даже два «перескока уровней»: лактобактерии производятся как живые системы, а затем высушенные становятся частью вполне неживой таблетки или капсулы. Потребнадзор тут половинчат (обычное свойство госорганов): отражает мнение сообщества медиков, сообщества пациентов — и вроде как мнение общества в целом, хотя у общества обычно есть самые разные соображения по поводу тех или иных систем, выражаемые самыми разными политиками, которые даже не эксперты по обсуждаемым проблемам. Но «потребнадзор» тоже нужно изменить (уговорить считать таблетку безопасной, используем вменяемость агентов, играющих роль потребнадзора). Лактобактерии — это биоактивные добавки (грубо — сушёная простокваша), они не требуют медицинского лицензирования и речь идёт просто о маркетинговом трюке «добавления убедительности к заявлению о полезности штамма простокваши». Если бы это было лекарство, то ситуация была бы более сложной.
Суть всего этого представления систем из самых разных системных уровней — это понимание, что в проекте придётся менять физический мир к лучшему, действуя с самыми разными типами систем, то есть инженерная работа (изменение мира к лучшему) будет на всех этих уровнях. Поэтому в проекте придётся обратиться к самым разным инженерам: которые умеют работать с существами, работать с разнообразными предметами из косных веществ, работать с личностями, работать с сообществами и даже обществом в целом (если выяснится, что это как-то затрагивает общественные интересы и нужно вести какие-то общественные дискуссии, менять законодательство и тем самым заниматься политикой). Это неважно, что все они называются как-то по-разному в своих ролях. Нам надо уметь думать о них более-менее одинаково, экономить мышление. Поэтому мы говорим, что это интеллектуальные агенты-создатели в функциональной роли инженера. Это означает, что каждый из них будет задействовать какой-то метод инженерии, пользоваться какой-то инженерной методологией — и в нашем проекте надо будет увязать вместе деятельность их всех (и работы, и методы этих работ).
И это простой и обозримый пример, хотя уже и в нём нужно затрагивать проблемы высоких уровней. Скажем, все штаммы молочнокислых бактерий, грубо говоря, «штаммы простокваши и йогурта разных сортов», обладают примерно одинаковой полезностью по влиянию на микрофлору и уж точно не являются лекарствами, их даже «биодобавками» считать сложно — если вы упакуете простоквашу или йогурт в капсулы, они ж не станут от этого «биодобавками»? Но вы можете использовать «связи в министерстве», чтобы эта простоквашу с йогуртом в капсулах назвать лекарством, получить лицензию и устроить на этом маркетинг! Это этично, или нет? Хорошо ли от этого будет людям (они получат плацебо!), а хорошо ли будет (гражданскому) обществу?
А теперь представьте реальную разработку: вряд ли проект закончится выпуском партии таблеток. Скорее всего, команда будет готовить другие версии — улучшать упаковку, вещество, варьировать цену, увеличивать разнообразие вариантов в надежде на привлечение покупателей, менять название и рекламные слоганы, получать новые сертификаты и лицензии, собирать статистику по итогам применения, и т.д. Инженерия таблетки оказывается не разовой, а непрерывной для многих версий/релизов, при этом работа идёт отнюдь не только с веществом таблетки, она вполне многомасштабна.
Если вы хотите изменить мир хоть неживой, хоть живой, хоть в небольших масштабах, хоть в больших — вы должны будете предположить функцию вашей системы, описать конструкцию, изменить физический мир, чтобы реализовать конструкцию, а потом подстраивать получившуюся систему к непрерывно меняющимся условиям, причём делать это на множестве системных уровней на множестве масштабов времени. Неважно какими вы словами это называете, насколько различны те системы, которые вы затрагиваете своими изменениями мира к лучшему, и насколько сильны традиции работы с этими системами (в этих традициях может что-то не учитываться из всего перечисленного, они же именно «традиции», поэтому могут не учитывать знаний современной инженерии).
Вы должны всё это делать, и делать на многих масштабах/системных уровнях как вещества, так и масштабах времени (эксплуатация, один жизненный цикл системы или фичи, эволюция как множество жизненных циклов). Поэтому такой подход и называется системной инженерией, а не просто инженерией. Безмасштабность и эволюционность/непрерывность просто характеризуют её современное состояние, отвечающее третьему поколению системного мышления, появившемуся по историческим масштабам совсем недавно, в десятые годы 21 века.
Потребуется каждый раз описывать функциональность системы и определять приоритеты в архитектурных характеристиках (надёжность, изменяемость и т.д.) для систем из каждого уровня, принимать архитектурные решения, разрабатывать концепцию системы и изготавливать её, вводить в эксплуатацию и заниматься всеми остальными инженерными методами, хотя они и будут носить разные имена и для веществ, и для существ, и для личностей, и так далее. В руководстве по методологии мы рассматривали, как разговаривать о методах работы, они же рабочие процессы, методы разработки, инженерные процессы. В нашем руководстве по системной инженерии мы рассмотрим не «как разговаривать», а дадим конкретные наставления по типовому разделению труда (ролям в инженерном процессе) в проекте создания и развития каких-то систем: дадим современное (SoTA) разложение метода инженерии на один уровень и назовём типовые роли исполнителей методов работы в таком разложении.
Моделирование: «неинженерные» инженерные проекты
Опишите больше трёх инженерных проектов, которые не принято называть «инженерными», тем не менее они сводятся к изменению физического мира к лучшему, к созданию успешных систем.
| Номер п/п | Описание проекта | Физические объекты, которые изменяются проектом | Масштаб/уровень для изменяемых проектом систем | Называют в быту такие изменения не инженерией, а каким методом? |
|---|---|---|---|---|
| Пример | Повышение квалификации инженера | Мастерство системной инженерии (как часть мозга, выполняющая мышление для работы по какому-то методу) | Личность (часть личности) | Обучение |
| 1. | ||||
| 2. | ||||
| 3. | ||||
Инженерия и эволюция
Как соотносятся инженерия и эволюция? Технический прогресс/техноэволюция, которая делается инженерами — это просто часть эволюции? Или это не эволюция, а просто инженерия, «метод работы таких создателей, как агенты-люди с приданными им компьютерами и роботами с AI»? Как об этом думать? Участвуют ли инженеры в эволюции, или они и есть эволюция, или эволюция сама по себе, а инженеры творят сами по себе, вне эволюции?
В рамках современных воззрений на эволюцию (прежде всего это так называемый расширенный синтез эволюционных теорий, extended evolutionary synthesis, EES18), речь идёт о продолжении эволюции — она одна и та же в биологии, в культуре, в технике, более того, она ещё и эволюционирует: методы эволюции развиваются в ходе самой эволюции. Биология, которая следует из такого понимания эволюции, получила название eco-evo-devo — это синтез eco/экологии (учёт влияния внешней среды), evo/эволюционной биологии (изучение происхождения видов) и devo (биологии развития — что происходит при развитии организмов из гаметы до взрослого организма, а также что происходит с организмом в ходе жизни).
Инженерам и менеджерам надо иметь представление о современных взглядах на эволюцию, они несколько раз менялись за последнее время, и они продолжают быстро меняться.
Так, сегодня в биологической эволюции гены не считаются уже главными эволюционными единицами, за ними эту роль потеряли COGs (clusters of orthologious groups) и другие группы гомологичных генов (то есть одинаковых генов, работающих в разных видах организмов19), теперь это GRN (gene regulatory networks)20 — генные регуляторные сети, в которых кроме генов там много ещё чего, но акцент уже не на объекты, а на отношения — биологию там даже пытаются называть иногда «релятивистской». Оказалось, что свойства организма не полностью определяются его генами. Простейшая проблема была — это объяснить, как из одних и тех же генов во всех клетках почему-то в одном многоклеточном организме появляются такие разные клетки, как клетки печени, нейроны мозга и фагоциты иммунной системы. GRN хорошо показывали, как из одних и тех же генов в результате регулирования их экспрессии могут появляться совершенно разные белки. Но на следующем шаге пришлось отказаться и от того, что эволюционируют GRN как «главные единицы». Эволюционируют все уровни, одна и та же «математика эволюции» оказывается работающей на всех системных уровнях, на всех уровнях сложности.
Эволюция работает как многоуровневая динамически проходящая оптимизация всех объектов по отношению ко всем остальным объектам — и она хорошо описывается методами статистической физики, прежде всего ренормализацией21. Более того, растёт число работ, в которых показывается, что алгоритмы эволюции крайне похожи на то, что происходит в нейронных сетях22. Напомним, что в руководстве по методологии говорилось, что алгоритмика обобщается с алгоритмов как описания действий с информацией (вычислений) до алгоритмов как описания действий создателей/constructors (произвольных преобразований физического мира). Современный взгляд на эволюцию говорит, что на всех уровнях в эволюции есть репликаторы, которые конкурируют друг с другом в части роста собственного числа. Первыми такими репликаторами начали считать гены (genes)23. Потом заметили, что реплицируются и идеи — мемы (memes)24. Было много модификаций, например, David Deutsch подчёркивал, что важны не просто какие-то идеи, а идеи объяснений, а ещё был предложен «третий репликатор» кроме генов и мемов — темы (temes), как репликатор, копируемый техническими средствами (скажем, размножающийся компьютерный вирус)25. Эти нововведения коснулись и алгоритмики. Так, в числе эволюционных алгоритмов появился класс так называемых меметических алгоритмов26 — расширение эволюционных алгоритмов оптимизации (мутации, стохастическое «блуждание»/поиск глобального оптимума) вставкой классических оптимизационных алгоритмов (какой-нибудь градиентный спуск, вычисление локального оптимума).
Сейчас уже более-менее консенсус, что эволюционируют объекты самых разных системных уровней, все они в какой-то степени «эгоистичные репликаторы»: вполне можно считать, что каждая из моделей того же смартфона «хочет размножиться числом поболее», а для этого постоянно модифицируется/модернизируется/адаптируется/эволюционирует, чтобы выжить в конкуренции с другими моделями. Точно так же можно считать, что не просто «гены человека хотят размножиться» (оказалось, что у человека очень много генов таких же, как у свиньи и мыши — даже не только обезьяны), но размножиться хочет и сам человек как физический объект.
В принципе, в биологии рассматривают сейчас две иерархии эволюционирующих уровней:
-
наследуемых «идей» (условно говоря, функциональную, иногда по этой линии даже говорят «функциональная эволюция»27) как генеалогическую28 по многим уровням репликаторов, которая легко путается с конструктивами как носителями информации этих идей, например, в значительной части работ по биологии «ген» и «геном» как все гены — это материальные носители информации, то есть молекулы с этой информацией, но в части работ — это информация безотносительно носителя. Вот стек уровней (конечно, там иерархия, или даже сеть, обсуждение трудности выражения функциональных описаний было в руководстве по методологии) эволюционирующих функциональных объектов, которые в конечном итоге ведут к выживанию, репликации (на разных уровнях! не только уровне генов!) и адаптации к среде в ходе выживания и репликации: сodons-genes-COGs-GRNs-organelles-cells-tissues-organs-organisms-demes-species-clades/lineages-orders-classes-phyla.
-
воплощений идей, экологическую/конструктивную, по частям-целым, модульную, это про границы между системами и интерфейсы. И тут тоже путаница как модулей-носителей информации/репликаторов, так и модулей, описанных этой информацией/репликаторами. Вот эти уровни (помним про платформенные стеки, описаны в руководстве по системному мышлению): atoms-molecules-proteins-cells-tissues-organs-organisms-populations-communities-ecosystems.
Конечно, функциональные и конструктивные декомпозиции в системных иерархиях оказываются тесно переплетены, а в биологических системах наследуемые репликаторы как функциональные объекты ещё и могут считаться информацией (те же гены) и вписаны в конструктивы как носители описаний, и такое будет на всех конструктивных уровнях.
У биологов уже не принято говорить про уровень только генов, что «гены полностью описывают итоговый организм и даже популяцию» — нет, там всё много сложнее, «генетика определяет всё» осталось в прошлом веке. На первый план вышел вопрос не только о survival of the fittest, «выживание наиболее приспособленного», но и arrival of the fittest, каким образом эволюция дала вариант наиболее приспособленного, и внимание сейчас уже не только на классификации видов и описании их эволюции, но и на предсказание результатов работы эволюции.
Кого это всё интересует в инженерии? С того момента, как инженерия стала эволюционной, теория эволюции начала интересовать множество инженерных ролей. Так, руководство по методологии заканчивается изложением теории стратегирования, в которой утверждается, что «всё новое приходит сбоку». Речь идёт о новых идеях, новых устройствах — и мы понимаем, что всё это эволюционирующие объекты. В биологии на уровне генов в таких случаях говорят о «горизонтальном переносе генов» (то есть переносе генов не от генома предшествующего вида в следующий вид, который появился путём мутаций, но межвидовой перенос генов). Обобщённая стратегия, которая описывается как «прыгание по камушкам» (stepping stone) оказывается вариантом меметического алгоритма — большие мутации, stepping stone новых проектов оказываются частью исследований того, где может быть глобальный максимум (exploration), а ведение проекта в попытке получить побольше ресурсов — это оптимизация в районе локального максимума (exploitation). При этом понимаем, что вся эта картина «камушков в тумане» непрерывно меняется — эволюция идёт не в статическом многомерном fitness landscape29, а в динамическом ландшафте приспособленности: расположение минимумов и максимумов меняется со временем: «вчера был треш, сегодня тренд», и наоборот «вчера был тренд, сегодня треш».
Оценкой приспособленности/fitness (насколько впишется система в какую-то экологическую/рыночную нишу) занята роль шумпетерского предпринимателя, в инженерии это роль визионера/visionary, она будет рассмотрена подробней дальше в нашем руководстве. Это означает, что для агента, который играет в разделении труда роль визионера, эволюционное мышление (мышление с использованием современной теории эволюции) — профильное. В менеджменте визионер — бизнесмен (он смотрит, вписывается ли в свою бизнес-нишу фирма, которую развивают в проекте фирмы, фирма — это его продукт), в обучении — культуртрегер (он смотрит, вписывается ли в культурную нишу мастерство, которому обучают в проекте).
То же можно сказать о роли архитектора системы: важнейшей архитектурной характеристикой системы оказывается «эволюционируемость», evolvability. И достигается это выбором модульности, modularity. Это ровно те же evolvability и modularity, что рассматриваются как важнейшие характеристики эволюционирующих биологических системы.
Обсуждение тех же организмов и видов различается: в генеалогии важны функциональные признаки/особенности/возможности/features/traits и связанное с ними поведение/processes (скажем, фенотипические признаки и адаптации разных уровней, например, уровня организма с его фенотипической пластичностью30, или уровня вида/species), а в экологии — там сразу ход на масштабы и модульность. Конечно, всё это обсуждается совместно и нещадно путается как биологами, так и инженерами. Скажем, наследуемость идёт по функциональной линии, а материал воплощения этой наследуемости — по конструктивной линии. Поэтому очень и очень условно — но можно говорить о методологии (как раз она про функционал) как о генеалогической линии (мемы и темы — там, гены оставим биологии) в инженерии как важной для визионеров, а об экологической линии (модули воплощения и межмодульные интерфейсы) как важной для архитекторов. Форма следует функции, конструкция отражает метод, архитектура следует методологии. Но и наоборот тоже верно: методология учитывает архитектуру, если каких-то нужных модулей или нужных интерфейсов нет, то функция оказывается невозможна — нет произвола в работе методолога, нет произвола в работе эволюции, не любая точка пространства признаков/особенностей/возможностей достижима, и это верно для систем на всех системных уровнях, не только уровне целевой системы инженерного проекта или уровне организма в биологических исследованиях.
И ещё нужно помнить, что эволюционирует не только целевая система, эволюционируют ещё и системы графа создателей. Всё сложно, но инженер должен иметь какой-то общий паттерн рассуждения об эволюции/развитии систем. Теория эволюции в её самом общем виде оказывается важна для образования самых разных инженерных ролей.
Ходы от однократного «водопада» с его предписанными стадиями к «непрерывному всему» — это ходы к неизбежному описанию технологической эволюции, движение agile в конечном итоге оказалось описанием неизбежности эволюционной разработки.
Это не уникально для инженерии. Мы обсуждали в руководстве по методологии, что описание какого-то процесса как строгой последовательности шагов, ведущих к строгой последовательности смены состояний каких-то объектов, очень соблазнительно своей простотой. Есть только одна проблема: оно не работает, жизнь чаще всего устроена не пошагово, в ней нет чётко выраженных ступенек продвижения к успеху. И даже когда ступеньки вроде бы есть, последняя ступенька чаще всего оказывается не последней (поэтому очень модные раньше в менеджменте «ступени зрелости» не прижились: фирмы довольно быстро проходили все эти ступеньки, но жизнь-то на этом не заканчивалась — эволюция продолжалась, а ступеньки это уже не описывали).
Например, для процесса развития личности первые же попытки описания (исследовательские, влиять не пытались) были на описание личности в её конечной взрослой форме, аналог биологического «фенотипа». Затем появились ходы на devo, психологию развития личности — примитивные, без eco (влияния окружающей среды на развитие). Конечно, эти ходы на devo были такими же, как ранние ходы на devo в проектном управлении и инженерии: этапы/стадии/фазы развития с попыткой указать на результат достижения каждого этапа. Для проектного управления и инженерии такой ход подробно разбирался в руководстве по методологии. Практически все «теории стадий развития личности» (Piaget с когнитивным, Kohlberg с моральным, Erikson с развитием идентичности, Beck and Cowan с развитием приверженности ценностям, этих теорий огромное количество) развалились под гнётом самых разных аргументов — начиная с невоспроизводимости результатов экспериментов и плохой процедуры относимости к плохо определяемому понятию стадия/фаза/этап31.
Следующие теории развития личности шли по той же линии, что и методологии инженерии, что и eco-evo-devo в биологии: упор на многоуровневость и многолинейность развития личности в ответ на самые разные внешние воздействия в самых разных контекстах (например, прихват новых мемов) и в ответ на внутренние какие-то размышления человека («подумал-подумал — и принял решение», в том числе под давлением каких-то генетически определённых склонностей, при всей условности «генетической определённости»). В стадийности развития личности вместо чёткой последовательности стадий начали указывать на нелинейную последовательность прохождения этих стадий, а также начали указывать на переплетённость когнитивных, моральных, социальных и прочих факторов вместо подстраивания развития по стадиям одной из тематических линий. Это во многом такой же переход от «водопада» к «непрерывному всему», в инженерии личности тоже победили идеи agile, личность теперь считается эволюционирующей и участвующей в общей эволюции — биологической, человеческой, культурной, технической. При этом отношение к инженерии личности двоякое: с одной стороны это инженерия (например, явное воспитание родителями, обучение в школе, самостоятельная «работа над собой» этой личности), то есть работа рациональных создателей, но с другой стороны — создателем личности выступает весь мир, в том числе значительная часть свойств личности определяется генетически как итог биологической эволюции. Это то же eco-evo-devo, только другими словами. Современные теории инженерии личности предусматривают какое-то «путешествие» личности в контактах с её окружением, идею путешествия мы разбирали в руководстве по методологии.
Сторонники популярных стадийных теорий развития личности сегодня могут говорить, что «эволюционно стадии предписаны, но они могут проходиться в разном порядке, проявляться в разное время». Эта оговорка по факту сводит «теорию» к обычной богатой метафорами классификационной схеме типа знаков зодиака и типов личности в соционике или оргдизайне, с примерно таким же уровнем обоснованности. Обычно в таких теориях и обоснованность отсутствует, например, в той же спиральной динамике, которая продолжает быть популярной. Кризис репродуцируемости и плохой методологии экспериментов проехался по всем этим теориям, там концы с концами в плане эмпирических обоснований не сходятся.
Как описывалось в руководстве по системному мышлению, во вселенной действует эволюционный физический процесс, который можно представить как (вполне деятельное, то есть физичное) оптимизационное обобщённое до изменения физического мира вычисление по какому-то алгоритму — этот алгоритм и есть алгоритм биологической, культурной, технической эволюции. Сам этот алгоритм тоже предмет эволюции, эволюция как процесс тоже развивается.
Какие цели эволюции, что она оптимизирует? Она реализует физический принцип минимального действия, который в данном случае трактуется как информационный: минимизация свободной энергии, что можно перефразировать как минимизация неприятного сюрприза, который агент/IPU/«ренормализованный/обобщённый нейрон»/создатель/репликатор (тут очень разная терминология для эволюционирующей системы) получит от окружающей среды (помним, что эта среда — системное окружение, в нём также эволюционирующие системы). Репликаторы в ходе эволюции усложняются, чтобы лучше бороться с энтропией, которая рано или поздно присылает какое-то существенное изменение внешних условий. Достаточно подумать о более длительных масштабах, нежели «догнали и съели» или «умер от голода»: удары астероида, взрывы сверхновых и т.д. Не вопрос, будет ли катастрофа. Вопрос в том, когда будет, и насколько удастся жизни проэволюционировать к этому моменту, чтобы не исчезнуть.
Пока достижений эволюции хватило примерно на 3.5 миллиарда лет репликации систем, похожих на клетки, но репликация людей пошла уже немного по-другому: они получились очень устойчивыми, и хорошо размножились. Население Земли сегодня составляет порядка 8 миллиардов человек32. Руководство по системному мышлению начинается как раз с того, что сравнивает массу всех людей с биомассой всех остальных видов, а также оценки массы преобразованной «неживой» части земли (автор тут задумчиво смотрит в окно и оценивает массу домов, домашней утвари, дорожных покрытий, производств, еды и отходов в радиусе 100 км вокруг себя, а живёт он в Москве).
В ходе эволюции появились такие репликаторы как клетки, появилось разделение на два пола (а для некоторых организмов, например, грибов, больше десятка тысяч полов33), появился стайный образ жизни (самец и самка — это два организма, популяция), появились особенности воспитания детей в порядке культурной эволюции, появилось поведения по созданию удобных для существования экологических ниш (вплоть до терраформирования: строительство плотин бобрами) и т.д.
Эволюция усложняет и усложняет репликаторы (они же — создатели/constructor в случае физической системы-репликатора, но помним, что репликаторами в теории эволюции могут считать мемы и темы — информацию) так, чтобы эти репликаторы были более и более устойчивы к воздействиям окружающей среды, чтобы были способны ко всё более длительному выживанию во всегда в конечном итоге враждебной среде. Муравейник потыкать палкой — он за ночь восстанавливается, но и если город потыкать какой-нибудь огромной палкой (печальные прецеденты с атомными бомбами, да и просто тысячами тонн взрывчатки были), то город тоже восстанавливается, причём масштабы этого «потыкать» несопоставимы. Город восстанавливается во много бо́льших масштабах, и речь идёт именно о количественных характеристиках: масса, энергия и скорость (учёт массы, преобразуемой за какую-то единицу времени).
Итак, эволюционный процесс имеет целью получить устойчивый репликатор (минимизация свободной энергии сводится тут к минимизации байесовского сюрприза от внешней среды — это и есть цель эволюции), который копируется и копируется, выживая всё лучше и лучше на всё новых и новых уровнях квазиустойчивости. При этом устойчивость к внешним воздействиям и адаптивность резко повышается время от времени за счёт роста сложности в больших эволюционных сдвигах: многоклеточные организмы, популяции, паразитизм и симбиотика (когда паразит и хозяин вдруг находят взаимную, а не одностороннюю выгоду. Когда-то наши митохондрии были паразитами в клетках). Не забываем при этом, что оптимизация эта не статична: что было оптимально вчера, станет неоптимальным завтра, и наоборот.
Между системными уровнями есть неизбежные конфликты, квазиоптимальных оптимизационных/архитектурных решений на предмет минимизации негативных сюрпризов от проявления этих конфликтов много и от этого возникает неустроенность как разнообразие самых разных вариантов вида и разнообразие множества более-менее похожих друг на друга видов (когда варианты уже сильно отличаются друг от друга), которые выживают примерно одинаково в текущих условиях. Это объясняет, почему у нас так много моделей автомобилей, смартфонов, холодильников, систем AI и т.д. — характеристики их выживаемости «в природе»/«на рынке» примерно равны, равно как и страны с постоянно меняющимися границами имеют более-менее одинаковые условия для жизни, они существенно отличаются только в деталях (чтобы понять, что отличия именно в деталях, достаточно сравнить страны с ними же, но в достаточно далёких моментах в истории, например со средневековьем или даже с каменным веком, разница сегодняшнего дня в части устойчивости к массовому вымиранию людей будет хорошо видна).
Иногда в ходе эволюции возникают существенные оптимизации, типа тех самых переходов от одноклеточных к многоклеточным, или появление хорошей цифровой памяти типа мозга с ручкой-бумажкой, или на следующем этапе типа компьютеров с интернетом. Это мы просто продолжаем пересказывать идеи работ группы Ванчурина-Кацнельсона-Вольфа-Кунина, опять отсылаем для более обстоятельного рассказа об эволюции к руководству по системному мышлению, подробности тут приводить не будем. Почему мы отсылаем к этим работам, а не к работам по биологической эволюции? Потому что нас интересует обобщённое описание, которое не только более-менее легко распространяется на культурную и техническую эволюцию как «понятный нарратив», но и имеет выражение в математике — а именно, рассказывается языком статистической физики. Инженеры захотят выйти на количественные описания эволюции физиками, чтобы получить возможности предсказывания результатов эволюции, хотя бы на коротких отрезках времени (скажем, как предсказывать погоду — на ближайшие два часа сегодня это легко, на неделю — вполне возможно, на пару месяцев вперёд — невозможно).
Эволюционный алгоритм можно ускорить через моделирование, то есть реплицировать на всех уровнях только важное, а потом эти уровни систем-репликаторов заставлять в самых важных аспектах проживать свою жизнь, доказывая свою живучесть, в компьютере (виртуальном достаточно большом мире, чтобы вмещать популяции и моделировать более-менее точно эффекты от взаимодействия популяций с окружающей их богатой средой, возможно содержащей и другие популяции). Если иметь достаточные вычислительные мощности, то делать это можно быстрее, чем проживать популяциям полную жизнь в реальном мире. Можно считать это «ускоренным воспроизведением», да ещё и параллельно можно пробовать множество разных вариантов, но опять же, если хватает вычислительных мощностей. Эволюция крайне затратна в вычислениях, а эти вычисления ещё и медленны — это главный недостаток эволюционных алгоритмов.
Переход к «проживанию модели в компьютере» — это вроде как уже инженерная работа, «применение вычислителей для генерации догадок о полезных мутациях, а потом фильтрации догадок об удачных мутациях». Инженерия тут в том, что физически создаётся вычислитель виртуального мира, а в нём создаются процессы «проживания» для моделей репликаторов/создателей/агентов/IPU (включая аналоги уровней «клеток», «организмов», «популяции», «экосистемы» — но помним, что в жизни этих уровней много больше, биология тут хороший пример) с потенциально интересными мутациями. Это отличный способ ускорить прогресс, но у него есть существенные ограничения: требуются немыслимо большие вычислительные мощности на моделирование N миров, в которых живут и размножаются организмы и популяции, на которых мы пробуем те или иные мутации. С этим боремся так: уменьшаем объём моделирования (скажем, пытаемся вычислить только догадку о мутации, но не моделируем выживание), увеличиваем доступную компьютерную мощь, увеличиваем эффективность эволюционного алгоритма в целом (качество генерирования догадок, точность моделирования и т.д.).
Например, в статье Evolution through Large Models34, предлагается использовать внутри эволюционного алгоритма вместо случайных мутаций «умные», то есть «разработанные/вычисленные», а вместо человека-инженера, высказывающего догадки о полезных мутациях, использовать нейронную сетку большой языковой модели (модели языка и мира, выученной нейронной сеткой определённой архитектуры).
Основная проблема в инженерии путём генерации новых репликаторов нейронными сетями в том, что архитектура этих репликаторов должна давать вариант многоуровневой оптимизации конфликтов между системными уровнями, при этом нейросеть обычно не может сгенерировать оптимизацию, которая выходит за рамки тех примеров, которые ей показывали в ходе обучения. А эволюционный алгоритм принципиально может. Поэтому статья предлагает оставить снаружи эволюционный алгоритм, принципиально дающий новизну решений за пределами того, что уже видела нейронная сеть, но вставляем внутрь «умный мутационный оператор» на основе нейросети, который предлагает потенциально не смертельную мутацию. Помним, что в работах по эволюции как многоуровневой оптимизации подчёркивалось, что всё в ходе эволюции давно уже квазиоптимизировано, какие-то локальные оптимумы для минимума свободной энергии целевой системы достигнуты, поэтому большинство случайных мутаций будут смертельными (выходим за рамки локального оптимума в менее благоприятные зоны), немного их будут нейтральными (находим другой квазиоптимум, они очень близки обычно), редко что-то приводит к маленькому улучшению текущего локального оптимума, и совсем уж редко что-то радикально приближает к обычно недостижимому глобальному оптимуму.
Если в основу эволюции брать не проверки по большому объёму бессмысленных смертельных мутаций, а проверки по менее большому объёму заведомо более осмысленных предложений, эволюция в целом пойдёт быстрее. Статья демонстрирует это на примере эволюционного алгоритма для генерации программного кода, порождаемого нейросетью ровно как это делают системы подсказок для кода программ: GitHub Copilot и Amazon CodeWhisperer. Если грубо, то статья предлагает вместо случайных перестановок текста в генетических алгоритмах использовать подсказки всех этих Copilots и CodeWhisperers35. И там же даётся ещё много разных других способов ускорить эволюцию (ибо много ещё мест, где «универсальный аппроксиматор/оптимизатор» типа нейронной сетки можно задействовать в эволюционном алгоритме).
Это статья 2022 года, с тех пор было выяснено, что достаточно большие хорошо обученные сети могут предлагать решения проблем, которые эта нейросеть ещё не видела — в том числе и потому, что алгоритм нейросети в чём-то сам эквивалентен эволюционному алгоритму. Нас ждёт ещё много открытий на этом пути использования нейросетей для решения инженерных проблем, синтеза новых инженерных систем, которые раньше никто не видел.
Если представить, что у всех инженеров в голове есть вычислители этих самых «умных мутаций» и других оптимизационных вставок в эволюционный алгоритм, да ещё в последнее время эти «вычислители в голове» умощняются компьютерами и средствами компьютерной связи для объединения вычислений многих людей и компьютеров, то мы смело можем считать инженеров всей Земли ускорителями эволюции. Мы берём инженеров вместе с их моделерами и заводами: моделеры документируют мутации, а заводы производят какие-то продукты, которые потом «пробуются жизнью на соответствие среде», некоторые из них оказываются удачны настолько, что предложенные в них «мутации» оказываются достойными повторения. А поскольку в нашем подходе инженеры — это те, кто что-то меняют к лучшему в физическом мире, то всё человечество оказывается мощным вычислителем-ускорителем физической эволюции, то есть работает на то, чтобы минимизировать негативные сюрпризы от окружающей среды. Это и есть одна из трактовок для «изменения жизни к лучшему». Сложность окружающего мира продолжает расти, но уже не только за счёт классической биологической эволюции, но и за счёт культурной и технологической эволюций, которые выполняются сейчас людьми с их культурой и инструментами, и которые просто составляющие общей «физической» эволюции.
Итак, если инженеры угадали новое техническое решение, которое квазиоптимально приспособлено к сегодняшнему окружению, то «бинго, вымри твой вид продукта сегодня, а мой вид завтра». Если не угадали, то наоборот: финансирование работ тех, кто не угадал, будет прекращено. В эволюции биологической вид вымирает, и эта неудачная ветвь просто прекращает существование. В технологической эволюции ничего страшного не происходит: все люди и их компьютеры обычно остаются живыми и просто производят следующий вариант «умной мутации техносреды», пробуют что-то ещё.
Так что для уменьшения бизнес-неудач остаётся поднять вероятность угадывания хороших концептуальных (найти аффорданс/affordance: как какую-то функцию реализовать каким-то объектом из окружения, решения по концепции использования и концепции системы) и архитектурных решений (способ разбиения конструктивных объектов на части-модули и организация взаимодействия их такие, что архитектурные характеристики становятся «наименее плохие из возможных») как «умных мутаций», и предложение таких мутаций — это ровно то, что могут всевозможные Copilots для систем автоматизации проектирования, программирования, моделирования.
Дальше можно думать о том, чтобы запускать алгоритмы «умной мутации» и для того, чтобы улучшать и сами эволюционные алгоритмы: для того, чтобы улучшать мутационный оператор, и для того, чтобы улучшать моделирование мира для определения того, выживет ли индивид с фенотипом, определяемым мутацией в генотипе, в виртуальном мире, чтобы уменьшить время экспериментирования и ресурсы, требуемые для проверки выживаемости в физическом мире. Тут есть и альтернативные подходы, которые прямо говорят о генерации каких-то оптимальных технических решений, без связи этого с идеями эволюции (то есть рассматривается разовая генерация решения, а не то, что параллельно идёт конкуренция с другими проектами, которые предлагают другие варианты решений какой-то проблемы). Скажем, можно «смягчать»/relax формулирование проблем конструирования системы из языка дискретных решений так, чтобы получать набор вроде бы непрерывных, то есть дифференцируемых функций для характеристик системы, затем искать конструктивный оптимум на этих функциях нейросетевыми или даже какими-то другими алгоритмами, потом возвращать в дискретную область проектных/design решений для формулирования ответа на вопрос об оптимальной конструкции36.
Динамический ландшафт приспособленности
Ключевая концепция для современной эволюционной инженерии — это динамический ландшафт приспособленности, dynamic fitness landscape37. Ландшафты приспособленности (fitness landscapes38) были предложены ещё в 1932 году как средство визуализации хода эволюции: одномерный ландшафт обычно показывает ось с величиной какого-то признака, а высота — степень оптимальности для выживания (приспособленность/fitness).
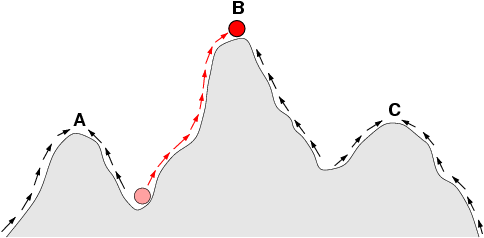
Пики в таком ландшафте стоят на месте, это статический ландшафт. Точка обозначает популяцию, у которой меняется величина признака (скажем, длина крыла, толщина панциря, кислотность желудка). Так, популяция, показанная красным, эволюционирует из неблагоприятной для репликации величины признака к более благоприятной — глобальному максимуму. Приспособленность популяции тем самым растёт. Особи, которые имеют не очень большую приспособленность, плохо реплицируются, не так хорошо размножаются — у них меньше вероятность оставить потомство, которое сможет мутировать дальше, чтобы быть ближе к максимуму.
Если мы берём два признака, то получаем двумерный ландшафт приспособленности (всё ещё статичный, пики никуда не деваются). И на таком ландшафте всё ещё больше похоже на «горную местность», собственно, «ландшафт». Вот как такая картинка показывает возможные стратегии поведения фирмы в бизнес-литературе39, и здесь даже поминается, что «ландшафт сам может меняться»:
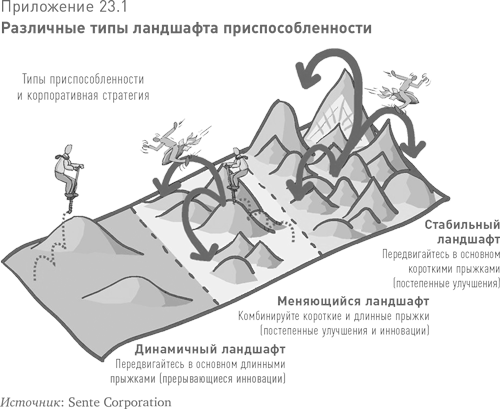
Тут очень сложно увидеть, что же это такое «меняющийся ландшафт» — это что, небольшие бугорки высокой приспособленности, отстоящие далеко друг от друга? И где популяции? Это же должны быть продукты с немного отличающимися признаками (а на картинке показаны создатели, а не популяции продуктов!). Опять же, на картинке ландшафт только на два признака. Вот как это показывают биологи (в материалах по первым двум ссылкам в этом подразделе приводятся видео, это раскладка кадров в .gif файле):
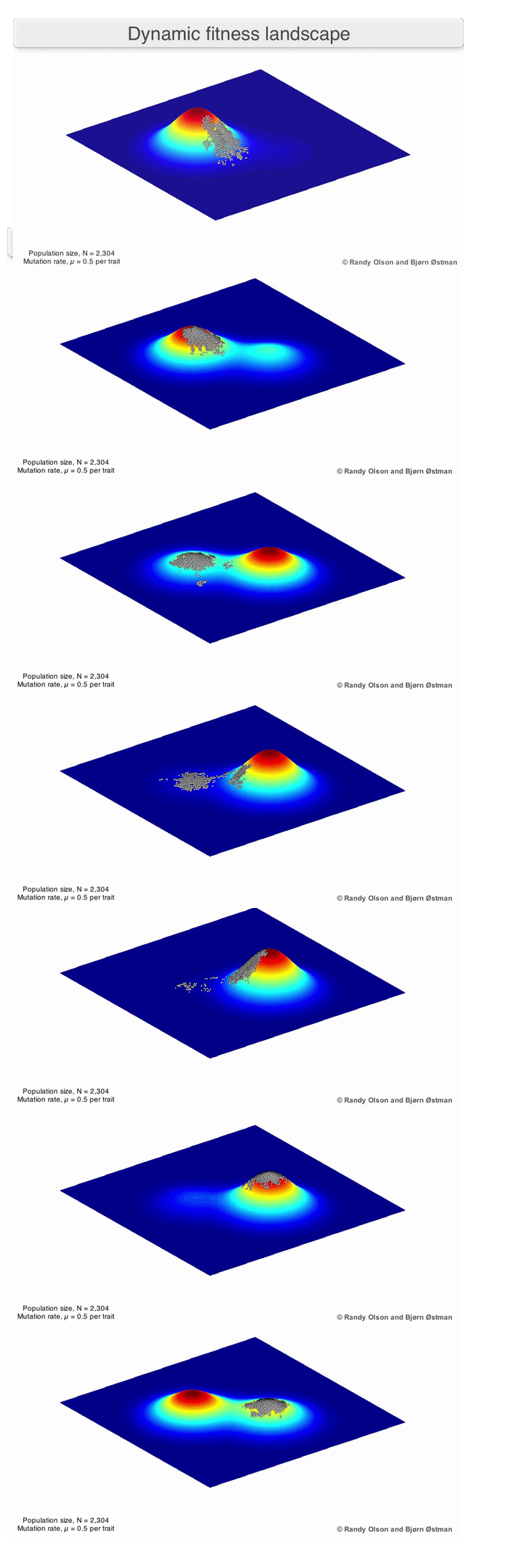
Тут видно, что никогда речь идёт не об одном продукте, об одном организме, но всегда о популяции с немного отличающимися признаками каждой особи. В ходе эволюции обязательно нужно разнообразие (quality diversity40), и оно обязательно будет в силу неустроенности (обсуждалась в руководстве по системному мышлению). Зайдите в магазин смартфонов, вы увидите множество моделей с очень похожими, но всё-таки разными характеристиками. Посмотрите на автомобили — они все похожи, но характеристики их немного разные. А ещё видно, что сам ландшафт — он непостоянен, и в какой-то момент может оказаться, что выживут потом не самые приспособленные сейчас особи — их эволюционные достижения окажутся балластом.
Примеров тут множество. Так, мобильные телефоны развивались в направлении маленьких размеров: чем меньше, тем было лучше. Самые маленькие были самые «любимые». Потом телефоны сменились смартфонами, где уже не было кнопок, а экран занимал практически весь корпус. Первые смартфоны были явно побольше, ибо речь шла по факту об экране компьютера. И оказалось, что чем больше экран, тем удобнее на него смотреть. Появились смартфоны-лопаты (ибо формой они как раз и напоминали лопату, разве ручки не было), затем через некоторое время появились планшеты, ибо телефон с огромным экраном уже телефоном не назовёшь. Через некоторое время самые маленькие смартфоны вымерли (включая маленькие смартфоны фирмы Apple, которая дольше всех придерживалась идеи, что телефоны должны быть маленькие, чтобы удобно было управлять ими пальцами одной руки). Но и сверхбольшие смартфоны тоже вымерли: оказалось, что их неудобно носить в кармане или сумочке. Мода на планшеты тоже быстро прошла: сверхбольшие телефоны не нужны, а ноутбук с клавиатурой хорошо заменял планшет. Всё быстрое можно было смотреть прямо на телефоне, он «всегда в кармане», а всё медленное можно было отложить до ноутбука с большим экраном и удобной клавиатурой. Сейчас обсуждается вопрос о переходе к новому формфактору — функциональность телефона может уйти в очки AR, чтобы поддержать работу AI-агента «всегда на связи»41.
Мы уже приводили в руководстве по методологии разнообразные описания функциональности нейросетей в качестве примера. Тут мы опять вернёмся к нейросетям, показав в качестве примера их эволюцию42. Чаще всего в инженерии эволюцию называют словом «история» (история самолёта, история смартфона, а вот мы расскажем историю нейросетей — но с упором на «великие вымирания» и «неожиданные возрождения»).
В 60х годах прошлого века технологии нейросетей были очень многообещающие, ибо «так работает мозг, значит мы скоро решим проблему искусственного интеллекта». Но оказалось, что интеллект существенно зависит от вычислительной мощности алгоритма — а сам алгоритм при огромной вычислительной мощности может быть и не так важен (этот тезис известен как «горький урок Sutton»43, но сформулирован он был только в 2019 году). Поэтому искусственные нейросети показали очень неубедительные результаты — и стали в 80х годах маргинальными, нейросетевые алгоритмы продолжали изучать очень небольшое количество исследователей, инженеры ими практически перестали заниматься. Это общее место в эволюции: даже очень успешные ныне виды регулярно оказываются «на грани вымирания», даже люди имели в какой-то момент крайне небольшую численность44. Идеи/мемы/репликаторы знаний о нейросетях таки как-то выжили в эпоху «зимы AI» аж до начала 21 века. В 21 веке развитие видеоигр привело к развитию видеоускорителей, в 2007 году появился интерфейс CUDA для вычислений (сложения и умножения), в 2011 году догадались использовать ускорение для нейросетей — они получили «больше компьюта», в 2012 году наступил "момент ImageNet", новое пришло в нейросети сбоку, а обработку изображений — сбоку. Биологи бы сказали, что это паразитизм, который оказался симбиозом: сначала алгоритмы нейросетей подсаживались в предназначенные для совсем других целей и автономно существующие видеоускорители, а затем наоборот — эти видеоускорители перестали ориентироваться на обработку изображений для видеоигр и специально были оптимизированы для нейросетей. Разработчики GPU не подозревали, что у них будет такое использование — но вовремя развернулись в эту сторону45.
Дальше берём в нейросетях (которые были сначала главным образом дискриминативными, а не порождающми/generative, то есть классифицировали объекты по каким-то классам, а не порождали картинки, видео, тексты, аудио) линию порождающих алгоритмов (ибо их было предложено множество разных, в эволюции это quality diversity, разнообразие разных признаков у популяции какого-то вида, об этом же разнообразии признаков в эволюции говорят как про geometry frustrations, ибо выживаемость особей с разными признаками существенно зависит от окружения и конфликтов — об этом мы говорили в руководстве по системному мышлению). Дальше наблюдаем, как разработчики массово увлеклись линейкой алгоритмов GAN (это было настоящее сумасшествие!), пока в 2017 появился для текстов transformer — об этом говорят как о «моменте трансформера», это был крупный сдвиг в эволюции: большинство исследователей бросили заниматься разными вариантами GAN (но не все! Какая-то популяция этих алгоритмов продолжает жить и развиваться!) и начали работать с трансформерными архитектурами.
Дальше с трансформерами (которые улучшались и улучшались, и продолжают улучшаться) идём в рассмотрение инженерного процесса: в биологии это development/развитие, но в инженерии development означает часто continuous development, включающий и проектирование, и изготовление, и эксплуатацию силами создателей из графа создателей, а вот в биологии это «самоизготовление», организм самовырастает из зиготы. Ежели упор на изменения признаков в ходе эволюции — это эволюционная биология, evo. А вот как меняется «инженерный процесс» — это evo-devo, эволюционная биология развития46.
Дальше нам нужна инженерия в целом — что там эволюционного. Современная инженерия работает вроде как development до момента delivering, и это development явно не похоже на развитие организма в eco-evo-devo, да и переводится «разработка». Затем появляется continuous development, continuous integration, continuous delivering — и оказывается, что continuous everything из инженерии это и есть эволюция, continuous development тут — эволюционная разработка, и даже архитектура по новым воззрениям — эволюционная.
А сама эволюция (биологическая, культурная, техническая/инженерная) ещё и evolved, то есть меняются эволюционные ходы, они тоже запоминаются паттернами среды (а не только генами, что толку мне запоминать в генах, как кушать траву, если у растений ещё генов нет, как эту траву выращивать? Ручка-бумага и даже мозги тоже оказываются носителями записей о паттернах, но весь мир хранит отпечатки того, что в нём происходит, сам-себе-ручка-бумажка).
Итак, эволюция нейросетей продолжилась не только в части того, какой алгоритм взят в качестве «вручную закодированной заготовки» и какова была его эволюция, но и в части того, как именно подавать пары «входные данные — выходные данные», чтобы на выходе получить более-менее разумную AI-систему, а не просто «алгоритм». Это как раз evolution evolved, менялись способы, которыми происходила эволюция нейросетей — в расчёт начали брать не только эволюцию алгоритма нейросети, но и алгоритмы обучения (то, что делает не нейросеть в ходе её эволюции, а что делают создатели, «как учат»/«изготавливают»). Тут можно выделить несколько моментов (конечно, это очень грубо и упрощённо):
-
Обучение воспроизводить паттерны входного текста, pretrain. На выходе pretrain — базовая модель. И дальше с ней можно было чатиться: начинать какую-то строчку (в том числе и задавать вопрос) и получать наиболее вероятное продолжение в ответ.
-
Дальше произошло понимание того, что во всех этих случаях речь идёт просто о парах «входная информация — выходная информация», это был «подход T5», text-to-text transformer47. И вот это давало возможность учить не просто «паттернам входного текста», а «паттернам ответов на вопросы». В итоге появились модели класса «instruct», которые после pretrain дообучали/finetune на подобных паттернах. Техники дообучения росли, в дообучении принимали участие люди — они «натаскивали» нейросеть на «правильные» (полезные/helpfulness и безвредные/harmlessness) ответы, это назвали RLHF (reinforcement learning with human feedback48). В результате нейросетки получали паттерны того, как можно отвечать на вопросы — и это совсем не то, что просто генерировать наиболее вероятные ответы. Это был «момент ChatGPT», когда на основе instruct нейросети был создан продукт осмысленного чата с нейросетью. Осмысленный — это когда ты получал на выходе на какой-то вопрос вполне осмысленный ответ. Конечно, quality diversity в эволюции была и тут: довольно много инженеров пытались повторить, и даже повторяли эти результаты. Проблема была только в том, что процесс обучения заключался в том, что нейросеть обучали «отвечать», её не обучали «думать»!
-
Дальше сразу несколько исследователей находят способ, как заставить модель не отвечать сразу, а прокручивать ровно тот цикл размышлений, который характерен для эволюции: высказывать догадку — и не сразу вываливать её в качестве ответа, а сначала проверять, и высказывать новые догадки, если текущая догадка оказалась неверной. Дальше наступает «момент DeepSeek», ибо фирма DeepSeek не просто предложила вниманию публики коммерческий продукт с такой «рассуждающей» нейросеткой, но опубликовала эту нейросеть в свободном доступе, да ещё и написала подробную статью, как такие нейросети делать. Это был третий шаг, «обучение с подкреплением» (RL), причём подкрепление было в том числе за правильность рассуждений перед ответом.
-
… конечно, это не последнее изменение в процедурах разработки нейросетей! Эволюция неостановима как в части целевой системы как итогового результата, так и в части того инженерного процесса, каким этот результат получается. Так что ждём выхода на бесконечность, open-endedness в развитии AI49.
Это важно: мы имеем одну и ту же нейросеть «на входе обучения», но на выходе имеем разной силы алгоритмы после разного обучения этой нейросети: или бездумного поэта, который выдаёт произвольные ассоциации, или подмастерье, который пытается воспроизвести ответы по способу мышления мастера, или самостоятельно думающего мастера. Всё зависит не от «конструкции нейросети», а от того, «как готовили». Как говорится, «из той же мучки, да не те ручки». Это эволюция метода, в данном случае метода обучения. Как долго длилась эта эволюция метода? Относительно долго: архитектура трансформера для «базовой» сети была получена в 2017 году, публика получила instruct модель с доученными от людей «безвредностью» и «полезностью» такой сети в формате чата 30 ноября 2022 года50, «момент DeepSeek» (назван так по образцу «Sputnik moment», потрясение мира в момент запуска СССР первого спутника) произошёл 25 января 2025 года. В техноэволюции всё быстро, репликация идей из одних мозгов в другие, из одних компьютеров в другие происходит почти мгновенно — через интернет.
В целом, похожесть инженерной эволюционной разработки биологической эволюции заметили уже давно и подробно изучают. Вот одна из типичных диаграмм, которые появляются в таких исследованиях51:
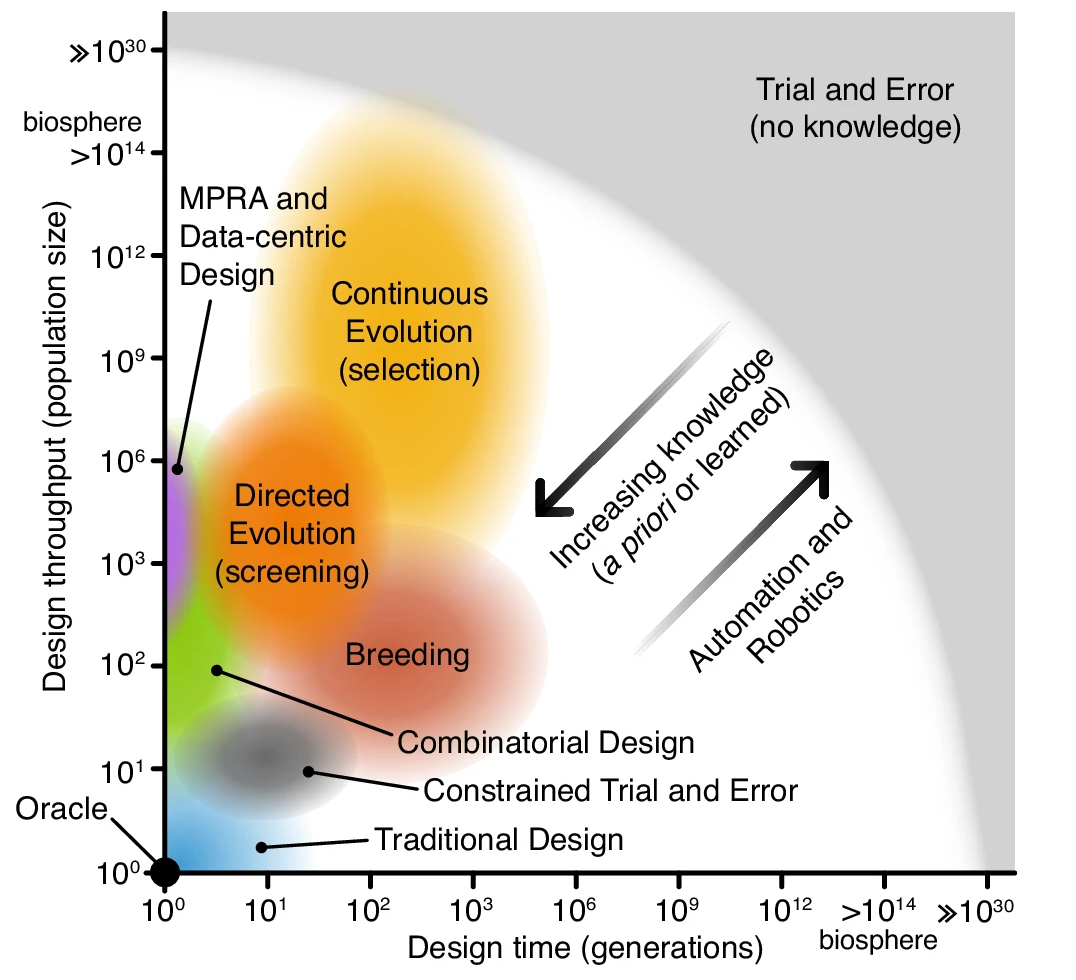
Подходы к проектированию в нижнем левом углу имеют небольшое количество вариантов (размеров популяции) и циклов проектирования (поколений). Они требуют значительных предварительных знаний для успешного проектирования с оракулом, способным создать идеальный дизайн за одну попытку. Подходы к проектированию в верхнем правом углу мало используют предварительные знания и обучение, требуют меньшей способности к развитию, и их поиск менее ограничен. Метод проб и ошибок (без предварительных знаний) попадает в эту крайность, где для проектирования нетривиальных систем требуются гиперастрономические масштабы. Все остальные методы проектирования расположены между этими крайностями. Во всех этих случаях предварительные знания могут использоваться для ограничения пространства проектирования, а полученные знания могут динамически направлять процесс на лету. Кроме того, автоматизация и робототехника могут помочь увеличить производительность эволюционного процесса проектирования и количество поколений, которые могут быть реально опробованы.
Напомним основные идеи современных теорий эволюции (их явно не одна), которые мы как-то затронули:
-
open-endedness52 (наличие двух агентов: один решает всё более и более трудные проблемы, второй формулирует всё более и более трудные интересные проблемы, а не любые проблемы, и ещё мир, достаточно богатый для бесконечно усложняющихся проблем)
-
quality diversity53 для меметических алгоритмов54, то есть работа с популяциями и работа с локальными и глобальными оптимумами динамического ландшафта приспособленности
-
многоуровневость и сложность (с конфликтом между системными уровнями и geometry frustrations, неустроенность — и связь неустроенности с quality diversity). Это работы группы Ванчурина-Кацнельсона-Кунина-Вольфа55.
-
невозможность отследить эволюцию одного объекта изолированно на любом эволюционном/системном уровне, ибо можно отслеживать только совокупную эволюцию, при этом эволюция идёт не только среди объектов одного уровня, на одном уровне (скажем, гена или вида) но на всех уровнях. Это тоже работы группы Ванчурина-Кацнельсона-Кунина-Вольфа.
-
Уход от статического fitness landscape и тем самым уход от обсуждения приспособленности через «пользу» (польза получается эмержджентной, и отнюдь не сразу — и «польза» обычно одноуровнева, а нужно учитывать все уровни и их конфликты). Так, у черепахи сначала появился щиток на брюхе, чтобы была платформа, удобная для копания. И затем из рёбер вырастали небольшие щитки наверху, сквозь кожу, ибо близко же — из клеток, которые шли в том числе и на рёбра! Ни о какой «защите панцирем» и речи не шло. Затем щитков на спине стало больше, и они срослись с щитками платформы на брюхе. Вот с этого момента — «панцирь, у него защитные функции». А до этого — нейтральные случайные особенности/traits, разбегающиеся в рамках популяционной quality diversity.
-
Кроме evo в обсуждениях эволюции обязательны development и eco (eco-evo-devo56).
Эволюционная неизбежность этических/политических проблем и инженерные подходы к их решению
Системное творчество заключается в том, что оно переводит проблемы в задачи: там, где непонятно, что делать, находится метод/алгоритм (помним, что это необязательно «последовательность шагов»), по которому надо просто выполнить работы, чтобы решить эту проблему. Но основная проблема в том, что проблемы создаются просто из-за многоуровневости, многомасштабности мира: между системными уровнями существуют неразрешимые конфликты, которые ведут к неустроенности/неустаканенности/«geometrical frustrations»57 (помним, что «геометрический» тут означает просто упоминание многомерного пространства состояний конфигураций всех систем на всех уровнях).
Эволюция заставляет рассмотреть конфликты, связанные с удержанием репликации на каждом уровне в каких-то границах — если клетки печени хотят неограниченно реплицироваться, то с точки зрения организма это рак. Если какой-то организм хочет неограниченно реплицироваться, то с точки зрения остальных организмов эко-системы это тоже что-то типа рака. Конфликты между системными уровнями в эволюции неизбежны: все системы хотят жить вечно и реплицироваться, но ресурсов для этого заведомо на всех не хватит. Поэтому эволюция изобретает новые и новые формы освоения окружения, в том числе паразитизм и симбиоз, «многоклеточность со специализацией» в биологии, конструкции биологических организмов становятся всё сложнее и сложнее, число уровней растёт, растёт и разнообразие форм/архитектур жизни, у биологической сложности есть физические основания58.
Примерно те же процессы идут и в культурной эволюции (культура исповедования теорий флогистона и теплорода не выжила в конкуренции с термодинамикой), и в технической эволюции (телефон вытеснил телеграф, чаты уже почти вытеснили телефон). Неизмеримо выросла и продолжает расти сложность культуры (взять, например, современную культуру инженерии со всеми её знаниями по созданию систем самого разного вида). Выросла и продолжает расти сложность инженерных систем. Посмотрите, сколько систем должны слаженно сработать для того, чтобы вы могли вызвать со смартфона такси — и спутники должны летать, и наземные приёмники сигналов спутника, умещающиеся в смартфон, и компьютер-в-кармане быть доступным, и датацентры построены с развёрнутым в них софтом, и автомобили такси должны быть созданы, а сталь для них выплавлена, но ещё поддержаны надёжные быстрые расчёты по деньгам сложнейшей банковской системой, и даже проведён учёт user eXperience — опросы и расчёт рейтингов водителей и пассажиров, ибо маркетплейс учитывает не только пассажиров, но и водителей как пользователей. И это всё как-то синхронно работает вместе, чтобы было легко вызвать такси в самые разные места, а затем рассчитаться за поездку.
Если смотреть на инженерию как эволюцию, то она сведётся к предложению новых конструкций систем, ведущих к многоуровневой оптимизации их конфликтов на многих системных уровнях, за счёт этого удачные системы получат шанс на существование — но недолгое, ибо квазиоптимальное (теоретический оптимум недостижим в принципе) решение сегодня не означает того же уровня квазиоптимальности завтра. Эта «временность решения проблем» — следствие со-эволюции всех систем, никакая система не развивается сама по себе, все они развиваются одновременно и взаимодействуют весьма сложным образом. Непрерывно появляются новые виды, осваивающие новые экологические ниши, ранее недоступные жизни (биологической, культурной/знаниевой, технической) но какие-то виды перестают быть оптимальными — они вымирают. Культ Зевса и теория флогистона — культурные динозавры, они вымерли, эти виды/species репликаторов больше не размножаются, но мы можем наблюдать их следы, как палеонтологи наблюдают окаменевшие остатки организмов вымерших видов. Телеграф — технологический динозавр, тоже вымер. Хотя автор руководства работал на телеграфном ключе и участвовал в соревнованиях по приёму-передаче сообщений на скорость по азбуке Морзе, но в жизни «вживую» уже много десятков лет не видел ни одного телеграфного ключа, хотя их можно купить до сих пор — в качестве технического сувенира, ровно как можно купить и сувенирную фигурку какого-то вида динозавров.
При таком подходе к инженерии как оптимизации конфликтов систем на разных системных уровнях в ходе эволюции и понимании, что инженерия занимается развитием не только «железа» и «софта», но и систем самой разной другой природы (личностей, организаций личностей, сообществ, обществ), появляется возможность по-новому взглянуть на старые этические/политические проблемы.
Скажем, если мы применим «умные мутации» к человеческому геному, то получим евгенику59 средствами генетической инженерии. Далее можно задать вопрос: сколько людей в идущей в том числе и сейчас биологической эволюции человека умрёт до появления «оптимизированной усиленной версии человека будущего»
-
в ходе естественных случайных мутаций, «в ходе обычной биологической эволюции, в геном не лезем» против
-
в ходе «инженерной эволюции», где мутации будут предлагаться на основе какой-нибудь многоуровневой модели организма (не только генома!), например, отмоделированной на базе большой нейронной сети, а затем реализовываться методами генной инженерии, методами влияния на развитие организма из зародыша?
Ведь вся суть предложений «смарт мутаций» как раз в том, чтобы уменьшить порождение потенциально вымирающих от несоответствия/misfit окружающей среде индивидов, которым суждено быть просто «неудачными ветвями эволюции»! Это алгоритмы увеличения количества живых, которые будут более живучи в мире, но при этом минимизирующих количество мертвецов, на которых пробовали разные мутации. Эволюция человека тут просто предельный случай, который сразу поднимает жёстко сформулированные этические вопросы жизни и смерти. Можно выделить два предельных мнения:
-
«Руки прочь от естественной эволюции, что-нибудь повредите, всякие генетические инженерии и социальные инженерии опасны!», — это подход охранителей с их скрепами. Например, во Франции законодательство прямо запрещает любые попытки улучшить природу человека, это уголовно наказуемо как «преступление против человеческого вида»60. Во многих странах вы не имеете даже права выбрать пол ребёнка, это уголовно наказуемо61.
-
«Вы что, сдурели оставлять всё естественной эволюции, у неё ж на поиски улучшений человека уйдёт миллион лет и миллиард смертей! А то и вообще всё сдохнет-вымрет, это ж эволюция! Срочно зовите инженеров!», — эту точку зрения представляет, например, John Doyle62.
Генная инженерия, селекция и прочие практики изменения хода естественной биологической эволюции поэтому сразу сталкивается с подобными вопросами, иногда теорию этики называют для этой темы «биоэтика»63.
Эволюция AI-агентов тут пример поближе к «обычной инженерии», но и тут могут быть вопросы, например, популярно обсуждение «можно ли выключать нейронную сеть, если мы заметили, что у неё есть сознание?» (при этом «сознание» неверно понимается как бинарная характеристика, а не по-современному, как шкала, что порождает множество пустопорожних рассуждений, «спор о терминах»64). Вопросы вызывает вообще отношение к непрерывно усиливающемуся интеллекту компьютера, а затем и робота: понятно, что разумные существа должны иметь какие-то свободы, но должны ли роботы иметь возможность размножаться, если они окажутся умнее людей и даже смогут заработать на своё размножение и проживание?! Впрочем, рабов-людей тоже тысячи лет не считали людьми, что уж говорить про рабов-машин, даже разумных! При этом идеи охраны свободы животных никак не влияют на идеи свободы роботов! Более того, в Новой Зеландии (2017) и Канаде (2022) права людей были даны рекам!
Эволюция атомных реакторов («безопасность человечества против доступа к дешёвой электроэнергии») тоже идёт под строгим контролем, действует «режим нераспространения».
Ещё жёстче стоит вопрос регулирования эволюции при выходе на уровни социальной инженерии, и тут уже работать могут не только судебные, а затем силовые (тюрьма) механизмы против отдельных людей, которые пытаются установить какие-то новые правила жизни, но даже военные механизмы против больших групп людей (автор понимает, что привлечение примеров из политики может существенно отвлечь внимание и ему знаком текст «Политика — убийца разума»65, но надеется на то, что из примеров будет вычитываться не собственно политика и политические решения по конкретным кейсам, а будет вычитываться применение принципов инженерии к сообществам, обществам, человечеству).
Так Касым-Жомарт Кемелевич Токаев как президент Казахстана сказал в 2022 году66: «Подсчитано, что если право наций на самоопределение в реальности будет реализовано, то вместо 193 государств, входящих в состав ООН, на земле возникнет более 500 или 600 государств, конечно же, это будет хаос. По этой причине не признаем ни Тайвань, ни Косово, ни Южную Осетию, ни Абхазию. И, по всей видимости, этот принцип будет применен в отношении квазигосударственных объединений, коими, на наш взгляд, являются Луганск и Донецк».
Тут даже неважно, если дать право людям на свободную сецессию67, будет ли 500-600 государств, а не 3500. И почему сегодня в мире не хаос, когда всякие Чечни, Тайвани, Крымы, Донецки и так далее (включая потенциально страну басков, время от времени желающий отделиться Техас и сотни других регионов) можно или «отпускать» в независимость на основании права на самоопределение как «борцов за независимость», или не отпускать, считая «сепаратистами», или войной забирать в другие страны, считая «возвращающимися в родное старое государство» и это всё не ведёт к хаосу, а каким-то чудом его предотвращает. Почему 600 государств вдруг будут хаосом, если отпускать без войны? Война уничтожает людей, но мирное изменение границ государств само по себе не уничтожает людей, и уж точно не приводит к «хаосу», просто чьи-то амбиции по рулению себе подобными ущемляются, а чьи-то нет.
Хаос возникает именно от войны, в том числе военного и изменения границ, и военного неизменения границ. Нужно чётко понимать, что при изменении границ нужно обсуждать проблемы разных системных уровней. Когда-то Россель, будучи губернатором Свердловской области, высказал те же аргументы Ельцину по поводу автономии для области, что Ельцин высказывал Горбачёву для автономии РСФСР от СССР. Абсолютно те же аргументы, но Росселю и его сторонникам автономизироваться никто не дал, а Ельцин у Горбачёва и СССР в точно такой же ситуации выиграл. Нужно понимать, что это всё попытки инженерной деятельности, по изменению устройства общества. Принципы, которые учитывают одноуровневую оптимизацию (границы государств, например, и только), а не многоуровневую (структуры уровня мельче государств и уровня крупнее государств) плохие, они не ведут к изменению жизни к лучшему, они не дают многоуровневой оптимизации. Они пытаются содействовать выигрышу какого-то одного уровня в межуровневых конфликтах. Но это невозможно, ибо эволюция стремится к нахождению многоуровневого оптимума конструкции репликаторов, а не одноуровневого. И это не достижение равновесия, «стремление к нахождению» — это не нахождение! Эволюция продолжается, причём меняется даже она сама.
В случае границ государств как оформляющих границы разных общественных организованностей (обществ с разной одинаковостью его членов) нужно помнить о неустаканенностях/frustrations таких же, какие наблюдаются в спиновых стёклах68. В руководстве по системному мышлению это рассказывается подробнее, даются ссылки на литературу по эволюции (например, почему существует множество похожих по качеству решений оптимизационной проблемы, и легки переходы между состояниями системы, соответствующими этим решениям69). «Остановить историю» не получится, социальная инженерия реализует эволюцию, она непрерывна: «добиться достижения цели» нельзя, ибо сама цель непрерывно движется, и обстоятельства её достижения меняются, а ещё системы неэргодичны, у них есть память и нельзя просто «вернуть всё назад», поддерживать равновесие, гомеостаз. Развитие не гомеостатично, эволюция — это не гомеостаз (хотя удерживание какой-то границы между отдельной системой и её окружением и можно с трудом назвать гомеостазом, но акцента на изменениях в подстройке к происходящему и убеганию от ожидаемых опасностей в будущем больше, чем акцента на неизменности, на которой центрируется гомеостаз).
Более того, тренд на глобализацию, «большую деревню», убирание всех и всяческих границ — это не эволюционный тренд. В эволюции системы защищают свои границы и стремятся увеличить сферы своего влияния. Если границы исчезают, то через эти границы приходят полчища паразитов и хищников — поэтому в биологической эволюции появляется мозг (управляет реакцией бей-беги) и «нементальный мозг»70, иммунная система (управляет воспалением, иммунным ответом). Полицейское государство — это просто аутоиммунная реакция, попытка сохранить и размножить культуру, даже если речь идёт о самих носителях этой культуры71! В принципе, в эволюции и управление многоуровневое/многомасштабное — причём одни и те же принципы управления/control и в биологии, и в технологии72. Инженеры, которым надо делать систему управления роботом, предприятием, эко-системой, обществом — им надо всем понимать эти принципы многоуровневого управления/control, а также обязательной защиты межмодульных границ и интерфейсов от всевозможных паразитов.
В инженерии можно действовать методом: проб и ошибок, как будто до сих пор верна дарвиновская теория эволюции, в которой считалось, что мутации случайны. В социальной инженерии тоже так можно делать. Но ценой этого будет много смертей, и хорошо если это будут смерти фиктивных сущностей (скажем, если умрёт государство, то некоторым людям будет просто очень-очень обидно, но если умрёт множество людей вместе с государством, то это уже не «просто обидно», это невосполнимые потери).
Современная теория эволюции говорит, что алгоритм эволюции сам по себе эволюционирует, но в эволюции правит отнюдь не случайность: выживают не все мутации, нейтральных мутаций (которые часто открывают путь к резким эволюционным скачкам, но не сразу, а через много поколений) немного, а прорывных мутаций, дающих какой-то позитивный результат сразу — совсем мало. Ход эволюции можно предсказать, хотя и ограниченно, если понимаешь, как устроен мир — если есть объяснительная модель, объяснительная теория.
Если нет нормальной объяснительной контрфактуальной порождающей теории/модели для эволюции, в том числе культурной эволюции и технической эволюции, то ничего сделать в политике нельзя: любой пробегающий мимо специально обученный риторике как убедительной речи «пропагандист» даст более яркую картинку для яркой картинки предыдущего «пропагандиста», и уведёт за собой толпу людей. Часть толпы, правда, останется. А ещё часть просто разбредётся. Но если будет какая-то рациональная теория, то действию пропагандистов можно будет как-то сопротивляться — это трудно, но возможно.
Без SoTA теории в политику как социальную инженерию идти нельзя, как и в любую инженерию. Нужны сущностные аргументы, а не просто «пропаганда» и «яркий образ». Дело тут даже не в строгости логики (можно обсуждать, какой логики: булевой, байесовской или квантовоподобной, этим занимается фундаментальная дисциплина рациональности, подробней см. в руководстве по интеллект-стеку фундаментальных методов мышления), но хоть какой-то объяснительной теории того, что происходит. Если такой теории нет, то мы имеем дело с безжалостной случайностью, при которой никакие изменения не будут к лучшему чисто статистически, никакое политическое лыко не будет в строку. При этом если есть труды типа тех же трудов Ванчурина-Кацнельсона-Вольфа-Кунина, то текущие политические теории о той же сецессии73 нужно признать прокритикованными (они объясняют меньше и хуже, чем новые эволюционные теории). Надо помнить, что разные культуры дают разные ответы на вопрос о примате интересов сохранения одних образований над сохранинем других — включая вопрос о возможности недобровольных человеческих жертв для сохранения какой-то культуры (религиозной, языковой, культуры одежды, культуры поддержания способа распределения в экономике, вроде рынка или планового хозяйства — это неважно).
Основная идея в том, что при многоуровневой организации общества (хоть сколь-нибудь устойчивые структуры разных масштабов, составленные из людей и их вещей, включая землю и недра) неизбежны конфликты между целями разных уровней, а главная цель — «сохраниться, чтобы не съели и не умерли от голода, холода и болезней», и делать это с минимальными усилиями, lean/элегантно, с соблюдением принципа минимального действия из физики. Чистая физика-математика, а не идеалы из какого-то «исторического прошлого».
Есть множество субоптимальных решений, которые примерно одинаково неоптимальны, пока не появляется (редко!) какое-то крупное новшество, обычно приводящее к появлению нового системного уровня (типа одноклеточные стали многоклеточными, а многоклеточные образовали популяции с двумя полами). Это означает, что есть огромное количество разных конфигураций «стран» с самыми разными вариантами границ между ними и устройством жизни в этих странах, и эти варианты конфигураций деления мира на страны все будут примерно одинаковы в части успешности межуровневых конфликтов — хоть этих стран будет как сейчас 193, хоть 600 или даже 3500. Границы никуда не денутся, на любую глобализацию будет своя деглобализация, на любые таможенные и связные союзы будут находиться достаточное число противников, выступающих за протекционизм и цензуру, как бы ни были рационально привлекательны альтернативные варианты. Ибо границы — это безопасность от паразитов и хищников, исчезновение границ приводит к тому, что любая проблема распространяется со скоростью пожара. Подводные лодки делают с герметичными отсеками, то же самое делают с цивилизацией: делят её на «отсеки», на каждом уровне. Это эволюция, от этого не удастся избавиться никаким «прогрессом».
Ситуация в части стран может незначительно меняться в случае «блоков» (так, Единая Европа, НАТО, ОДКБ тут примеры попыток социальной инженерии этого межстранового уровня, но можно думать и о других вариантах конструкции межстрановых объединений), новых типов стран (федеративное и конфедеративное государство когда-то было таким новым типом, тоже признающим, что оно состоит как целое из частей) и новых типов частей стран (областей, графств, штатов или как они там могут называться, включая разный уровень автономизации этих типов). Но принципиально тут мало что изменится, разве что можно уточнять правила бескровной смены границ: как демократия делает возможной бескровную смену монарха или диктатора в случае неудачного его правления, так можно предлагать похожие бескровные механизмы для смены границ. Но никакое одно решение для одного системного уровня не пройдёт, чтобы границы стран можно было переустраивать без войн и неизбежных смертей, нужны оптимизационные изменения на всех уровнях сразу.
Конечно, президент «страны» плевать хотел на президента «графства», это ж понятно — он это просто по должности должен делать, защищать интерес этого уровня, «держать и не пущать», а также «строить империю, собирать земли». Но иногда графство/область вдруг начинает дружить «через голову» с другими президентами стран и даже страновыми объединениями, тогда страновое объединение уже выращивает свою бюрократию и плевать хотело на того президента, который против. Всё это непрерывно перемешивается и обладает памятью, как спиновые стёкла: возврата назад в какие-то прежние границы регионов и в теории не бывает, и в истории наблюдаем ровно это. Нужно крепко думать над словами тех, кто хочет стабилизировать неустроенности/неустаканенности/frustrations, обзывая их чистым хаосом, а не проявлением общих эволюционных законов. Если «заморозить границы по их сегодняшнему состоянию», то жди беды рано или поздно.
Какие могут быть инженерные решения? Опять приведём в пример демократию — это пока ещё относительно плохой и плохо проработанный, но всё-таки способ бескровной смены правителя, исправления ошибки выбора (или речь идёт о безошибочности выбора в начале срока правления, но жизнь меняется — и выбор оказывается ошибочным позднее). Без демократии монарха или диктатора можно было бы менять только их убийством, а также убийством прикормленных ими их сторонников. А при демократии при голосовании сразу видно, много ли сторонников, и поэтому никого убивать не надо, можно позволить всем жить. На уровне стран могла бы быть какая-то подобная процедура, и следы этой процедуры даже обговариваются, это идеи сецессионных или объединительных референдумов. Но дальше, как всегда, есть противники самих этих референдумов (и они же могут себя считать сторонниками демократии, не забываем, что у агентов разных системных уровней будут разные интересы и поэтому разные обоснования для «свободы для текущих частей» и «свободы от текущих целых» на каждом системном уровне).
По факту вся инженерия (как классическая, так и просто создание и изменение самых разных систем в части попыток изменить мир к лучшему) оказывается ускорением эволюции жизни как таковой. Инженерия тут просто увеличивает вероятность неумирания биологической жизни (как минимум, homo sapiens) при резких негативных изменениях в окружающей среде: люди выживают сегодня в ситуациях, где ещё сто лет назад точно бы умерли, их изделия инженеров и от болезней вылечивают, и от голода спасают, и от холода, и (после распространения кондиционирования воздуха) от жары.
В техноэволюции (и тем самым общей эволюции) активно участвуют не только инженеры классические (изобретатели архитектурных новаций в киберфизических системах), но и основатели/founders предприятий, которые строят предприятие на основе какой-то «предпринимательской гипотезы», ибо эта гипотеза как раз и есть предложение «умной мутации»: новый продукт, который сможет хорошо размножиться/реплицироваться в окружающей его среде. Предпринимательские гипотезы выдвигаются и маркетологами, и простыми людьми, которые строят свои действия на догадках о том, как изменить свои модели мира, модели себя, а также изменить мир и себя для того, чтобы избежать неприятных последствий. Некоторые из этих предпринимательских гипотез оказываются настолько интересными, что они реализуются хотя бы единожды, а некоторые настолько интересные, что их реализацию пробуют реплицировать/размножить.
Вся инженерия самых разных систем оказывается «умной эволюцией», а неинженерные, то есть не на основе рационально мышления, изменения мира к «чему получится», а не «к лучшему» — частью «просто эволюции», методом случайных, а не умных проб и ошибок, ведущих часто к смерти системы от предложенных мутаций.
Концепция использования (предпринимательская гипотеза), концепция системы (результат системного творчества) с их методологическими/функциональными и архитектурными/конструктивными решениями оказываются предложением «умных мутаций». И речь идёт не об однократном предложении каждой такой «умной мутации», но об «умной эволюции»/развитии в целом: длинные цепочки меметической эволюции (поиски непрерывно ускользающего глобального оптимума и нахождение локального оптимума конструкции системы, максимально вписывающейся в какую-то экологическую нишу — рыночную, географическую, культурную, техническую), подразумевающие предложение и опробование множества «умных мутаций» и получение быстрой обратной связи о выживаемости предложенных конструкций системы.
Если не понимать принципы эволюции для технических систем, то мы откатываемся в старинные «водопадные» проекты с их неизбежным перерасходованием средств и большим количеством неудач. Agile-движение побеждает, это и есть осознание инженерами принципов эволюции. Если выйти на уровень социальной инженерии, то плохое понимание эволюционных процессов ведёт к войнам в буквальном смысле слова, это признак очень плохой инженерии, признак предложения и воплощения в жизнь «неумных мутаций», полученных не путём рациональных рассуждений, игнорирующих теорию.
Взгляд на системную инженерию как метод «умной эволюции/развития» систем самой разной природы упирается в пока ещё недостаточное знание инженерами современного (третьего поколения) системного мышления: откуда физически берётся эмерджентность и как она может быть описана традиционными для физики математическими средствами. Уже понятно, что:
-
все описания эволюционирующего мира оказываются квантовыми в том смысле, что физические процессы излагаются как информационные (если можем что-то изменить при взаимодействии, то система генерирует ноль или единицу, квант/бит информации, это и есть «новая квантовость»74 как информационный взгляд на физику, а не как особенности физики микромира с «квантовыми явлениями»).
-
мы имеем дело с одними системами, которые являются моделями других систем, то есть их описаниями, даже если речь идёт о физических системах, в смысле «физической модели самолёта». То есть работа с описаниями-репликаторами оказывается тесно связана с физикой как мы обычно это себе представляем (а физика теснее связана с информатикой, чем раньше казалось тем же физикам).
-
в информационных системах количество неожиданно переходит в качество, то есть эмерджентность растёт при росте масштаба вычислителя, а в обучающихся системах и при росте масштабов данных для обучения (об этом был раздел в «Системном мышлении», в том числе и разные трактовки эмерджентности математиками как шкалы для какого-то свойства и физиками как появления нового свойства).
Без обсуждения трёх масштабов времени (1. жизнь как «эксплуатация», 2. умные мутации на многих системных уровнях в ходе эволюции системы и 3. разработки одного релиза/версии). Если раньше интересовала главным образом стратегия и план «выпуска системы» как выпуск единственного релиза/версии, то в эволюционной инженерии без обсуждения ещё и стратегии и планов по выпуску этих версий (roadmap) никаких инженерных рассуждений проводить нельзя. Все решения по текущему релизу принимаются исключительно в контексте roadmap, «никакая версия системы не является последней».
Чтобы разбираться в эволюции, потребуется хорошенько разобраться со всем интеллект-стеком, всем набором фундаментальных дисциплин: там и про эволюцию, и про этику, и про инженерию, и про «движущую силу эволюции» как те самые конфликты между системными уровнями, и про многое другое. Для чего разбираться, мы уже говорили: в инженерии эволюцией профессионально занимается роль визионера, эволюцией SoTA методов/функций занимается методолог, свойством развиваемости/evolvability занимается архитектор, а инженер внутренней платформы разработки занимается эволюцией ещё и этой платформы, которая поддерживает эволюцию инженерной/engineered системы. Непрерывное всё, эволюционирующее всё, безмасштабное (со многими системными уровнями) всё. Современная системная инженерия — это эволюционная инженерия.
Слова-термины в безмасштабной эволюционной инженерии и важны, и не важны
Терминология, под которой скрывается безмасштабность (многоуровневость) и эволюционность (развитие системы как выпуск множества релизов/версий) в современной науке (предложение новых теорий, описаний мира) и инженерии (новые изменения физического мира) может существенно различаться. В разных мета-моделях (как научных, там чаще всего метаУ-модель, «как в учебнике», так и принятых в конкретном проекте метаС-моделях, «ситуационных») системы на каждом уровне и сами уровни будут называться разными именами, в том числе системы разных релизов/версий. За типами надо будет внимательно следить. Так, даже слово «релиз/release» может означать три разных объекта:
-
систему в определённой конфигурации, синоним «версии»,
-
процесс разработки (development) и введения в эксплуатацию (delivering) версии, поведение создателя версии/конфигурации системы,
-
событие выпуска версии, причём не окончание сборки/integration (куда часто ещё включают и инженерные обоснования успешности, quality assurance с испытаниями функциональности, соблюдением архитектурных решений и решений по защите и безопасности), даже не окончание разворачивания/deployment, но чаще всего это окончание «введения в эксплуатацию»/delivering.
Когда речь идёт о «водопаде» против agile — это чаще всего отсылка к эволюционной инженерии, но слова «эволюция» не увидите, будет использовано только слово development, в английском достаточно многозначное, чтобы иметь оттенки «развития» и «разработки». То, что русскоязычное ухо слышит как «разработка», в английском включает в себя и «развитие», а для русского уха «развитие» как раз отсылка к эволюционному масштабу времени, evolution. Про выпуск новых и новых версий будут говорить agile development, но там внутри неожиданно — про evolutionary architecture.
Безмасштабность/scale-free/scaleless (одно и то же описание на самых разных системных уровнях) тоже в разных научных и инженерных школах будет обсуждаться разными словами, которые будут «синонимами с нюансами», отсылками к одной идее, но с подчёркиванием разных её аспектов:
-
ренормализация как применение одного и того же формализма, одной и той же математики для описания каждого системного уровня. Это обычно там, где много физиков, знакомых с методами статистической физики.
-
рекурсия как применение одного и того же метода работы на каждом системном уровне, это в системной инженерии (например, в стандарте ISO 15288:2023 этот термин используется для объяснения, что материал стандарта приложим к системам на всех системных уровнях)
-
фрактальность, отсылка к самоподобию устройства уровней, в инженерии это весьма распространено75.
-
инвариантность к масштабу (scale invariance, invariant scaling)76 как противопоставление «многомасштабности» (multiscale), где наоборот, подчёркивается роль различного моделирования на разных системных уровнях с выходом на общий результат моделирования77.
-
самоподобие (Self-affinity, self-similarity78), как указание на повторяемость по отношению к самому себе, более общий термин по отношению к инвариантности к масштабу — ибо там самоподобие по отношению только к масштабу, но тут может быть распространено, например, на фракталы, где повторяется на разных масштабах форма.
-
… ожидайте больше вариантов, идея «одинаковых паттернов на каждом уровне» (где паттерны — паттерны объектов, то есть типы, паттерны поведения, то есть методы, паттерны описания, то есть типы моделей) распространена, но каждый раз для этой идеи выдумывались свои термины и подчёркивались свои особенности.
Как у нас называются сущности, которые являются частями друг друга и целыми друг ко другу на самых разных уровнях? Очень по-разному:
-
Системы/systems имеют границу и окружение, основное отношение часть-целое. Систем предлагается огромное количество, например, древние автопоэтические системы малоотличимы от агентов. Холоны — подчёркнуто то, что система состоит из частей-подсистем и сама часть надсистемы. Почему автопоэтические системы и холоны остались только в литературе прошлого века? Это хорошие метафоры (из frameworks, набора понятий), но под ними было мало формализации и математики, они были плохи для формального разговора и более-менее точных предсказаний. Там, где мало математики и нельзя чего-то посчитать и сверить с экспериментом, не надо ждать сохранения. Но сам термин «система» из физики, так что с ним будет всё в порядке.
-
Агенты/agents с главным свойством автономности, в том числе у них важна устойчивость к распаду от внешних воздействий. Варианты агентских подходов весьма разнообразны, например, в подходе «деятельных рассуждений»/«active inference» как раз в терминологии чаще всего используются агенты79. Математики и физики с этой терминологией довольно много, поэтому можно ожидать сохранения термина.
-
Ренормализованные сущности/entities, подчёркивают идею инвариантности к шкале, уровню гранулярности и использованию одной и той же математики для описания явлений на разных уровнях80.
-
Ренормализованные нейроны, упор на применимость математики машинного обучения, этим занимаются во многих местах81. Иногда возникают терминологические коллизии, если ожидается, что эти работы будут читать биологи, для которых «нейрон» — это не тип объекта в многоуровневой системе, а биологический нейрон, клетка. Поэтому иногда для «ренормализованного нейрона» из физики вводят синоним: IPU (information processing unit, причём этот термин вводится только в рамках этой теории и означает по сути «систему», описываемую в терминах машинного обучения — полный синоним «ренормализованного нейрона», выбор такого термина связан с его общностью).
-
Cоздатели/constructors, акцент на неизменность-неразрушаемость при выполнении операций с окружением (что очень похоже на агента, но акцент не на автономность, а на готовность к повторению операций, неразрушимость во взаимодействиях)82.
-
Наблюдатели/observers, в таких, например, работах, как «Towards scale-free formalization of physical systems as observers»83.
-
Машиностроительные узлы/nodes, подчёркивают идею многоуровневой сборки из комплектующих84.
По большому счёту, это всё отсылки к одному и тому же концепту, «синонимы с нюансами» — разные термины подчёркивают разные аспекты описания, разные акценты.
Большинство теорий, которые используют многоуровневые безмасштабные представления, не различают функциональную и конструктивную декомпозицию/синтез — при этом подразумевается, что в этих то ли уровнях, то ли слоях (чаще всего «уровни» и «слои» в таких теориях — синонимы, выбор их произволен) отношения между объектами образуют сети, называемые часто:
-
организацией, если речь идёт о функциональных отношениях (потоки и порты). Скажем, «Discrete IPUs (that is, self- vs. nonself-differentiation and discrimination) exist at all levels of organization» из той же работы Ванчурина со товарищи85. Организация указывает, каким процессом функциональные части системы склеиваются в функциональное, стабильное (и часто — эволюционирующее) целое. Границы тут не очень важны.
-
архитектурой (изредка — структурой), если речь идёт о конструктивных отношениях (физические взаимодействия и интерфейсы), а в случае экземпляров — это конфигурация. Архитектура — это про то, как именно модули-части собираются в целое, взаимодействуя через свои границы по интерфейсам. Границы тут как раз важны.
-
компоновкой, если речь идёт о пространственных отношениях и прилеганиях в пространстве
-
стадийностью, если речь идёт о временно́й/эволюционной структуре
-
... и там ещё много всякого, в том числе гибриды типа "стоимости", которая тоже многоуровнева, но цепляет самые разные другие многоуровневые представления.
Если вы понимаете идею безмасштабного/рекурсивного/многоуровневого/фрактального/ренормализованного/системного (и так далее! синонимов тут много!) описания мира, то вы разберётесь с любыми терминами, которыми пытаются выразить эту идею.
Так, «организация» — это часто «функциональная многоуровневость», а архитектура — это часто «конструктивная многоуровневость». Но «часто» --это не всегда. Самые разные «опытные разработчики» прошлого будут называть функциональные диаграммы с dataflow и портами (без интерфейсов!) «архитектурой». Дело даже не в том, что архитектура — это не описание, это реализация какого-то паттерна отношений/relations частей конструкции, то есть сами части конструкции, связанные по какому-то архитектурному паттерну. Нет, просто значение слова поменялось.
Скажем, устойчивое словосочетание «архитектура нейронной сети» задействует старое значение слова «архитектура», когда интуитивно она понималась как «всё важное», а развиваемость/evolvability системы и связь развиваемости с модульностью были не вполне ясны. Потом появилась эволюционная/evolutionary архитектура (первая книга на эту тему вышла в 2017 году) — и после этого значение слова «архитектура» начало меняться.
Но культуры распространяются медленно, переучиваться с одной теории архитектуры на другую трудно — поэтому архитектурой могут назвать и принципиальную схему, и отображение функций на конструкцию, и структуру самой конструкции с описанием связей между её частями.
Что происходит, когда алхимия заменяется химией? Как протекает просвещение в среде учёных и инженеров? По печальной шутке «наука продвигается с каждыми похоронами». Точнее, Макс Планк заметил: «Новая научная истина побеждает не тем, что убеждает своих оппонентов и заставляет их увидеть свет, а тем что оппоненты в конце концов умирают, и вырастает новое поколение, уже с ней знакомое»86.
Точно так же люди легко назовут «модульной организацией» какую-нибудь сеть модулей-на-интерфейсах, и даже не вспомнят в этот момент слово «архитектура». Надо ли с ними спорить о том, что «это не архитектура»? Конечно, нет. Спор на тему «объект X не принадлежит классу Y» — типичный «спор о терминах», и там два слоя:
-
попадает ли какое-то понятие в таксон какого-то классификатора (надо понимать, что вариантов классификаторов и критериев классификации тут множество, а ответ на вопрос обычно неважен, если речь не идёт о каком-нибудь государственном классификаторе, попадание в таксон у которого ведёт к каким-нибудь прибылям или убыткам)
-
каким словом назвать это попадание изо всех возможных синонимов.
Помним, что разбираться надо сразу по существу: что там за понятие, с какой целью нам его сообщают, какие интересы у тех, кто нам говорит про архитектуру и организацию — и для надёжного заземления/grounding просить привести примеры. Спорить о терминах не надо, это бесполезно. Но и не надо ошибаться: если вам показали «принципиальную схему», а потом показали «архитектурную диаграмму», на которой вы тоже обнаружили ролевые объекты и их поведение, а модулей и их интерфейсов не показали — ищите модули и интерфейсы, как бы они в этом проекте ни назывались. Просто считайте, что люди там говорят на иностранном языке — и либо вы их научите говорить на «культурном инженерном языке» (понятия и терминология SoTA системной инженерии), или это слишком затратно, тогда вы думайте на культурном языке, а говорите с этими людьми на их туземном. Слова важны и не важны, ибо важны понятия — и они обозначаются словами, что важно, но слова можно и поменять, а понятия с их типами — нет, поэтому слова оказываются не так важны.
Путаница слов-терминов «организация» и «архитектура» — это простой случай, и даже тут можно запутаться ещё больше. Так, «организация» часто используется для указания не на свойство следования паттерну отношений между функциональными объектами в системе, а в качестве синонима для оргзвена. То есть даже не архитектура (тоже свойство системы), а вообще — синоним модуля. И «организация» и «архитектура» — это не исчерпывающий список терминов для указания на многоуровневую сетевую (сеть отношений между системами каждого уровня) структуру. Путаться тут будет и «конфигурация» (отнюдь не экземпляров модулей, как вы могли бы ожидать), и «топология», и даже «композиционная структура».
Эволюция чаще всего обсуждается как эволюция каких-то функциональных объектов, но и тут надо быть настороже: если говорим о версионировании или переконфигурировании, то это обычно обсуждение «эволюции архитектуры».
Не факт, что хоть кто-то задумался о выборе слова «организация» при написании фразы «Discrete IPUs (that is, self- vs. nonself-differentiation and discrimination) exist at all levels of organization»87 (более того, в статье даже синонимия ренормализованного нейрона и IPU не прописана, хотя авторы не в статье подтвердили эту синонимию88). Интуитивно понятно, что речь идёт о функциональном описании — при этом назначение/purpose подозрительно напоминает описание просто «системы», это же про границы между системой и окружением! Но нет, IPU как «нейрон» обладает способностью к обучению, описывается функцией активации, функцией потерь, входами и выходами. Этот подход подразумевает, что все системы можно так описывать, на всех системных уровнях! Но потому-то и не используется слово «система», что в общем случае при его использовании нельзя ожидать, что будет ровно вот такое описание в терминах систем-нейронов. Синоним, но «с нюансами». Тем не менее, говорится об организации этих нейронов, то есть авторы неосознанно выбрали терминологию, указывающую на функциональные объекты. Слова в тексты приходят «навеянные музыкой», общим «культурным фоном» (нейросеть мозга подставляет «наиболее вероятные» слова для обозначения объектов, следует неявно выученным паттернам, которые часто встречались раньше). Ваш «культурный фон» может быть не такой, как у вашего собеседника. Поэтому каждый раз надо в каждом проекте и каждой теории разбираться с типами: какие слова какие понятия каких типов из каких теорий используются при описании разных систем проекта.
Ещё одна проблема безмасштабных описаний — в постулировании разных типов на разных уровнях этих описаний. Так, узлы состоят из узлов. Но в машиностроении вам могут заметить, что узлы собираются из деталей — это такие узлы, которые уже не узлы, ибо их нельзя собрать. А на верхнем уровне узлы собираются в подсборки и сборки, а уже они — в изделие. При любом изменении организации и архитектуры приходилось переприсваивать типы объектов. Сама идея, что уровни по отношению «часть-целое» (разбиения/декомпозиции, например, «разузловки», иногда «синтезы» — термины выбираются в зависимости от предпочтительного направления рассмотрения иерархии по отношению «часть-целое») должны содержать какие-то единицы/units одного типа — она в системную инженерию шла очень медленно, а до многих мест «просто инженерии» пока ещё вообще не дошла. Вот картинка из ISO 15288:2023, это пояснение понятия «система» — суть картинки в том, что системы многоуровневы. И там неожиданное нарушение этого принципа: если это последний уровень в какой-то ветви иерархии, то это уже не тип «система», а тип «системный элемент»:
Если вы вдруг решите сделать этот элемент из двух или трёх частей, то придётся поменять тип с «системного элемента» на «систему». И то, что типов всего два (а тип будет отслеживаться в компьютерной системе, разные типы будут в ней запрашиваться по-разному) — это счастье, ибо раньше у вас это было деталью, узлом, подсборкой, сборкой, подсистемой, системой (и это даже не все предписанные уровни), и вам надо было хорошо понимать в любой момент времени, говорите вы о детали, об узле, о сборке или подсистеме. С одной стороны, это очень удобно в неэволюционной архитектуре: сразу понятно, о каком уровне говорим! Но если у вас меняется организация и архитектура в ходе развития системы, отслеживание смены типов объектов каждого системного уровня при их объединении из частей или разделении на части превращается в головную боль, единообразие мышления об объектах каждого уровня нарушается.
Многоуровневость и (функциональной) организации, и (конструктивной/модульной) архитектуры, и (пространственной) компоновки, и (гибридной по многим другим разбиениям) полной стоимости владения в инженерии повсеместна. Например, в теории управления показывается теоретически, что надлежащее управление вы можете иметь только в том случае, когда речь идёт о многоуровневом управлении. В cтатье «Towards a Theory of Control Architecture: A quantitative framework for layered multi-rate control»89 основное внимание уделяется необходимости строгой теории многоуровневых архитектур управления (LCA) для сложных инженерных и естественных систем, таких как энергосистемы, сети связи, автономная робототехника, бактерии и сенсомоторное управление человеком. Термин «архитектура» тут по факту означает «концепция системы», ибо речь идёт и о многоуровневой организации, и о многоуровневой структуре модулей (датчики, эффекторы) различного размера и различных характеристик. Особенность многоуровневости в том, что на большом масштабе/размере физической системы вы будете иметь много силы и скорости, но малую точность, а на маленьком масштабе вы будете иметь малую силу и скорость, зато большую точность. Чтобы добиться большой силы, высокой скорости, большой точности, вам принципиально/теоретически нужна многоуровневая архитектура. И тут авторы замечают, что успехи существующих архитектур (прежде всего — функциональная организация) от бактерий до Интернета обусловлены поразительно универсальными механизмами и паттернами конструкции/design. Это во многом обусловлено эволюцией путём естественного отбора, а не разумным проектированием. И дальше авторы ставят цель: описать универсалии/инварианты архитектуры и наметить предварительные пути к полезной теории дизайна. Каждое вхождение слова «архитектура» тут означает «всё важное в его взаимосвязи, прежде всего решения по многоуровневому синтезу функциональной организации управления и дальше по многоуровневой нарезке на модули разного размера». Вам надо каждый раз разбираться, как люди используют слова: инженеры и менеджеры, а тем более гуманитарии могут использовать слова в самых разных значениях, обозначать ими объекты самого разного типа — и часто совсем не того, который вы привыкли обозначать этими словами, и не того, который мы используем тут для обозначения понятий мета-мета-модели наших руководств для инженеров-менеджеров. Каждый раз, когда встречаете такие слова в рабочих разговорах, настораживайтесь и требуйте разъяснений с заземлением: организация, архитектура, структура, концепция, методология, подход, процесс, протокол, процедура, практика, механизм, инструмент, технология, платформа, интерфейс, система, фреймворк, модуль, компонент, элемент, блок, фрагмент, сегмент, часть, единица, сущность, объект, уровень, слой.
Но вернёмся к вопросу многоуровневости, принципиально необходимой разномасштабности как в биологических, так и в технических/инженерных системах. То, что эволюция отбирает такие многоуровневые системы, как успешные, заметили не только авторы работ по синтезу систем управления. Термодинамическое рассмотрение эволюции ведёт к тому же: росту сложности систем путём объединения систем нижнего уровня в системы более высокого уровня — это поднимает устойчивость систем к воздействиям, снижает их свободную энергию. Молекулы объединяются в клетки, клетки объединяются в многоклеточные организмы, организмы — в популяции. То же самое происходит в технологии: микросхемы, экраны, камеры, корпуса объединяются в смартфоны, атомные реакторы и турбины — в атомные электростанции. На эту тему есть множество работ, например, «Physical foundations of biological complexity»90, «Modeling complex systems as interacting agents»91. В этой последней работе говорится как раз, что сложное понятие «система» моделируется через более простое в понимании понятие «агента», это ход на панпсихизм в версии минимального физикализма: «всё на свете живое, только в разной степени». Агент (даже если это молекула) воспринимается немного антропоморфно, что для каких-то людей может существенно облегчать понимание материала. С другой стороны, системы подразумевают рассмотрение их самых разных аспектов, а агенты — только части, упор на автономность и взаимодействие, поэтому агентский язык более «узкий», чем системный. В любом случае, всё это «синонимы с нюансами», обозначения многоуровневых «единиц эволюции».
Заведомая многоуровневость может быть ключом к бизнес-успеху. Так, для контроллеров робототехники у NVIDIA в 2024 году был не один чип и один «суперкомпьютер на маленькой плате», а целая линейка таких92. Скажем, Jetson Orin Nano series — «Up to 40 TOPS, 7-15W, 70mm x 45mm, Starting at 199 USD, Available now» как младшая модель, а вот модель побольше — Jetson AGX Orin series — «Up to 275 TOPS, 15-60W,100mm x 87mm, Starting at 899 USD, Available now». В промежутке между Nano и AGX есть ещё Jetson Orin NX series. Важно, что эти модели программируются одинаково, эту «одинаковость программирования» NVIDIA гарантирует для следующих поколений подобных моделей, а ещё эту же «одинаковость программирования» гарантирует для симуляторов Isaac (чтобы отлаживать управляющие алгоритмы не на физических роботах, а на виртуальных роботах). Рынок тут смотрит не на характеристики платы, а на итоговые характеристики команды, которая выбрала эту плату: вам надо научить людей в команде работать с этими контроллерами один раз, хотя у всех у них разные характеристики. Для контроллеров на многих уровнях управления у вас будет одинаковое программирования, если потребуется как-то поднять характеристики контроллера на каком-то из уровней управления, то это можно будет сделать без переписывания программы. Во многих и многих системах вам придётся делать сложную/многоуровневую систему управления, делать её разные уровни на зоопарке дешёвой аппаратуры и тем самым зоопарке дорогого в разработке софта — так себе идея. Поэтому NVIDIA имеет существенное конкурентное преимущество: вы сохраняете все вложения в разработку софта, когда переходите с одного «железа» NVIDIA на другое — как в плане размера в продуктовой линейке, так в плане новых моделей. Это безопасней в плане эволюционной разработки, меньше рисков промахнуться. Неудивительно поэтому, что огромное число робототехнических фирм используют более дорогие, но поддерживающие многоуровневость и развиваемость/evolvability контроллеры NVIDIA, а не более дешёвые более простые AI-контроллеры мелких фирм.
Важнейшее свойство учёта безмасштабности в развитии систем — это «не меняем ни строчки в математике, но занимаем разные экологические ниши на разных системных уровнях многоуровневых систем управления». Одна математика (формулы) на всех уровнях управления, с учётом специфики каждого уровня, но разная скорость её работы и разные характеристики скорости-точности на каждом уровне. NVIDIA целится в занятие всех возможных ниш, а не занятие одной ниши. Нельзя рассматривать одиночный одноуровневый продукт и разовый его выпуск, без последующего развития. Обязательно нужно какое-то многоуровневое рассмотрение, закрывающее диапазон шкал и характеристик и предусматривающее неизбежное последующее развитие/evolution.
Конечно, для каждого уровня будут адаптации и специализации, но общий ход рассуждений остаётся одним и тем же для каждого из уровней и понимания, как там всё (отдельный вопрос — что именно «всё») укладывается в эти уровни.
Зачем эта универсальная многоуровневость нужна в инженерии? Кто видит эту многоуровневость мира — тот этим миром правит. Скажем, NVIDIA — это команда системных мыслителей, там вообще презентации и коммуникации велись через предъявление многоуровневости их систем93. Ведущая роль NVIDIA была долго малозаметна для публики, многие ещё путали NVIDIA с поставщиком видеокарт для компьютерных игр. А сейчас это лидер рынка аппаратуры для AI. Этот рыночный успех не случаен, ибо компания всё это время демонстрировала мышление системных инженеров, простирающееся на много уровней (логические цепи, схемотехника/«IP cores» частей чипов со многими логическими цепями, чипы со многими IP, платы со многими чипами, компьютерные рэки со многими платами, серверные стойки и компьютеры со многими рэками, поды датацентров со многими серверными стойками, датацентры и суперкомпьютеры «под ключ», много уровней софта для датацентров — и это только линейка продуктов для датацентров). Помним, что деньги приходят на более высокий системный уровень, а инновации (эволюционные novelties) приходят сбоку на низкие системные уровни. И эта эволюция происходит на каждом уровне.
Весь текст этого подраздела раскрывает системный подход в инженерии, причём это главным образом системный подход первого поколения:
-
рассказывается о чём-то многоуровневом, причём подчёркиваются универсалии каждого уровня и подход к описанию всех уровней вместе (безмасштабность описания каких-то единиц, например, компьютеров-контроллеров в системах управления — функциональные из теории и «железные» из продуктовой линейки NVIDIA)
-
не рассказывается о создателях, хотя это и не совсем так, например, явно оговариваются преимущества коммерческого предложения продуктовой линейки NVIDIA для организации работы команды: создатели освоят или один метод разработки для всех уровней/масштабов железа и софта NVIDIA — или им придётся осваивать зоопарк методов разработки для зоопарка разного железа и софта на разных уровнях/масштабах. Но в целом — всё как в биологии, создатели и графы создателей в тексте не поминаются.
-
не затронуты вопросы эволюционного масштаба времени (скажем, dynamic fitness landscape, «кто был королём, тот в новой ситуации станет никем, если не поменяется», но если меняется — королём останется, популяция какой-то системы как типа эволюционирующего объекта отслеживает перемещение пика адаптационного ландшафта94. Хотя мы косвенно это и затронули в примере с той же NVIDIA).
Прикладная инженерия как специализация системной инженерии
Системная инженерия — это нормативная («как надо делать», деонтическая модальность, описание лучших практик) версия методологии. Методология говорит о том, как думать о методе работы. Системная инженерия рассказывает в общем виде о лучших практиках/методах создания успешных систем, изменения мира к лучшему. А что с «не лучшими практиками», например, методами поэтапной инженерии («водопад»)? Ими пользоваться нерационально, поэтому надо следовать текущим методам работы эволюционной системной инженерии. И тут мало не перепутать, что уже не лучший метод работы, а что уже не «эксперименты с неясным и непроверенным результатом», а лучший метод. Ещё надо эти лучшие методы работы конкретизировать/специализировать по шкале охвата систем разной природы:
-
всем системам (безмасштабная системная инженерия, «инженерия вообще»),
-
системам какого-то одного сорта (авиационная инженерия, генная инженерия, добыча полезных ископаемых),
-
какой-то одной системе (мастерство выращивания бананов в средней полосе, робот-кардиохирург, служба продвижения электровозов на международных рынках).
1. Отсутствие специализации: безмасштабная эволюционная системная инженерия
Наше руководство как раз наставляет системноинженерной работе в самом её общем виде. Оно приложимо к инженерному процессу для всех видов создаваемых систем и описывает разложение инженерного метода на составляющие, которые исполняются типовыми инженерными ролями (иногда говорят «ролями инженеров») в рамках типового разделения труда, да ещё и с учётом графа создателей — с учётом того, что в инженерном проекте по созданию и развитию какой-то системы будут участвовать и менеджеры, и продвиженцы, и много кто ещё.
Если вы хотите проложить трамвайный маршрут по городу, вашей команде придётся учитывать и общественное мнение, и особенности городского планирования и налаживания пассажиропотока, и особенности электротранспорта и его технической инфраструктуры, и особенности вагонного парка, включая отслеживание трендов по беспилотному транспорту (включая особенности беспилотности рельсового транспорта, который не может «уклониться» от внезапно появившегося сбоку препятствия). Команда будет адаптировать модель графа создателей, взяв его из руководства по методологии. Вот эта модель в самом общем виде (но помним, что надо работать с этой моделью в форме таблиц, а не диаграммы, и обязательно надо будет её адаптировать)95:
Даже такое общее представление о проекте изменения мира к лучшему позволяет точнее стратегировать (выбирать, над чем и как будет работать проект — в том числе с изменениями стратегии «на лету» в agile-проектах), планировать (включая динамическое планирование в case management), а также выполнять работы в многомасштабном коллективном инженерном проекте. Многомасштабность, а не безмасштабность вашего проекта — это признание того факта, что вам не удастся охватить своим проектом улучшение мира, описываемо одинаково на всех возможных масштабах, придётся ограничиться многими существенно различающимися в своих описаниях масштабами из всех эволюционных. Но не одним!
И даже из такого очень недетального рассмотрения можно найти много интересного. Скажем, команда развития создаёт и инженерную службу, и службу продвижения — но и службу IR (investor relations), которая занимается инвестурой — хотя вроде бы это прерогатива основателей фирмы. Как поделены работы и методы работы с инвестурой между основателями и командой, занимающейся инвестурой, которую создают организаторы, созданные основателями? В каждой фирме, конечно, этот вопрос будет решён по-разному.
Конечно, в современных инженерных проектах эта диаграмма отражает непрерывную/эволюционную работу над всеми её системами — и целевой системой, и инженерной командой, и так по всей диаграмме. Те, кто придерживаются идеи «водопада» (верят, что они заняты разработкой конечной версии системы — работают-то они не так, но верят в несбыточное), обнаруживают, что каждая система (и целевая, и инженерная команда, и клиентура, и команда продвижения, и даже команда основания фирмы) надолго застревают в состоянии воплощения на «80% сделано», и каждый день там будет что-то доделываться новое и что-то удаляться из уже не нужного, а ещё рекомендуемый норматив времени на работу с так называемым «техническим долгом»96 — 20%, так что в любой момент времени оказывается, что готово только 80%, а ещё 20% нужно «отдать должок», и так может происходить годами.
В жизни часто всё ещё менее однократно: представьте себе, что вы готовите круглосуточный шведский стол в курортном пансионате, причём не только подачу в этом стиле97, но вместе с работой кухни, «под ключ». Ни в один момент времени вы не можете сказать, что закончили работу: что-то подъели, и нужно приготовить дополнительную порцию, что-то, наоборот, испортилось несъеденное, и нужно убрать. А ещё нужно планировать сезонную смену меню, отвечать на жалобы тех, у кого болит живот (ни у кого не болит, а вот у этого одного заболел — и он сразу публично пожаловался на качество еды!) и кто нашёл жучка в тарелке (никто не нашёл, а вот этот один нашёл — и выложил фото в соцсетях!) и следить, чтобы не уносили слишком много еды с собой. Это явно не описывается движением кейса «шведский стол» к однократной приёмке-сдаче целевой системы. Закрытие кейса, прекращение работы — это будет как раз неуспех!
Трудно представить, но операционная система Windows — это примерно такой же проект, как «шведский стол», идёт эволюционная разработка. И к этой модели стремится огромное число других систем. Так, ракеты SpaceX планируется выпускать одну штуку каждые 72 часа, но это не штамповка одной и той же ракеты — нет, каждая ракета отличается новыми доработками. Автомобили Tesla каждый проходит уникальный путь на заводе, ибо непрерывно эволюционирует не только сам автомобиль, но и завод, выпускающий эти автомобили98.
Даже если вы делаете революцию в обществе, это тоже будет только «открыть двери изначально накрытого шведского стола», а потом этот кейс нельзя будет считать закрытым, закрыть после этого двери — это неуспех проекта, аварийная ситуация.
Можно, конечно, обсуждать по такой диаграмме (но лучше бы не диаграмме, а набору таблиц) какой-то конкретный релиз, какую-то конкретную версию системы, выпуск инкремента. Кто-то что-то захотел изменить в системе, это предложили, описали, спроектировали, воплотили в жизнь, ввели в эксплуатацию — но не факт, что и тут не было небольшой эволюции, множества вариантов этого «чего-то». То есть в случае шведского стола это «давайте заменим крем в эклерах, будет и вкуснее, и дешевле, и готовить его быстрее». Lead time тут будет от появления этой идеи до момента, когда первый клиент откусит эклер с новым кремом, только в этот момент «ввели новую фичу в эксплуатацию». Но назавтра начнут улучшать и переделывать этот вчера ещё «новый» рецепт крема, а ещё начнут улучшать рабочий процесс его приготовления. В современной эволюционной инженерии нет однократных разработок — это сейчас очень редкое исключение.
И это мы рассматриваем «инженерию вообще», системы самой разной природы, без какой-то специализации. Мы ещё много раз вернёмся к этой идее шведского стола как современной метафоре разработки. Знакомиться с системной инженерией на уровне кругозора, как в нашем руководстве, на уровне мета-мета-модели как раз и нужно для того, чтобы вы понимали одинаковость инженерии шведского стола, инженерии ракет, инженерии корпоративного софта, генной инженерии, инженерии сообществ. В каждом проекте нужно не только «всё сделать», но и много раз переделать, пополнить, проследить, чтобы не было просрочено, подавать по-разному разные части (как в шведском столе — что-то доохладить, что-то держать горячим), а ещё нужно сделать так, чтобы всем желающим хватило, чтобы не нужно было долго ждать, и затем ещё быстро убрать объедки, не забывая при этом про улучшение раскладки и найм персонала. Это и есть современная инженерия, нацеленная на непрерывный ввод в эксплуатацию, continuous delivery, а сейчас уже понятно, что это эволюционная системная инженерия:
2. Специализации инженерии для одного вида систем: прикладная инженерия.
В многомасштабном проекте, тем не менее, на каждом системном уровне нужно каким-то образом вести свой локальный проект создания успешной системы, использующий методы системной инженерии с их особенностями для систем разной природы. Воплощение системы оказывается или инертным веществом, или киберфизической системой (или её частью, например, компьютерным софтом), или личностью (или её частью, например, мастерством), или организованной группой людей (организацией или её частью, например, департаментом, или даже сообществом), и так далее.
Методы безмасштабной эволюционной системной инженерии при этом уточняются, дополняются, описываются уже не на самом абстрактном, фундаментальном уровне мета-мета-модели, а на прикладном уровне — уровне модели предметной области, метаУ-модели. Прикладная инженерия какой-то предметной области продолжает оставаться эволюционной, но нельзя уже сказать, что она «безмасштабная», ибо системы конкретных предметных областей (рубашки, филиалы крупного холдинга, мастерство, небоскрёбы, клиентуры) всё-таки имеют какие-то масштабы и конкретизированные методы будут привязаны к этим масштабам.
Так, классическая «железная» системная инженерия — это (прикладная) инженерия киберфизических систем, развивавшаяся главным образом на примере программно-аппаратных комплексов (компьютеры и операционные системы, «прикладной софт»/приложения тут обычно не рассматривают), аэрокосмических систем (гражданская и военная авиация и ракетная техника) и других транспортных систем (автомобили, поезда, военный транспорт). Или программная/software инженерия, занимающаяся информационными системами как компьютерными программами (без включения аппаратуры в программно-аппаратном комплексе, но с включением приложений). Или инженерия предприятия, часто понимаемая как менеджмент (с операционным менеджментом как аналогом эксплуатационной инженерии).
Все эти отдельные виды инженерии имеют свою специфику, свои регламенты/руководства/учебники/стандарты, но все следуют одному и тому же чуть более абстрактному образцу/нормативу инженерного процесса, взятому из безмасштабной эволюционной системной инженерии. Хотя исторически было ровно наоборот: это безмасштабная эволюционная системная инженерия была сформулирована главным образом на базе инженерии киберфизических систем, когда пришлось включать в эту инженерию людей, заниматься системноинженерным менеджментом и поэтому описывать инженерный процесс в его наиболее общем виде, на уровне абстракции мета-мета-модели. Но потом эти общие безмасштабные идеи из системной инженерии/systems engineering пошли в самые разные прикладные инженерии систем/engineering of systems.
Скажем, если взять инженерию личности, как прикладную инженерию мастерства (подробней будет в руководстве по инженерии личности), то можно представить себе модификацию диаграммы графа создателей99:
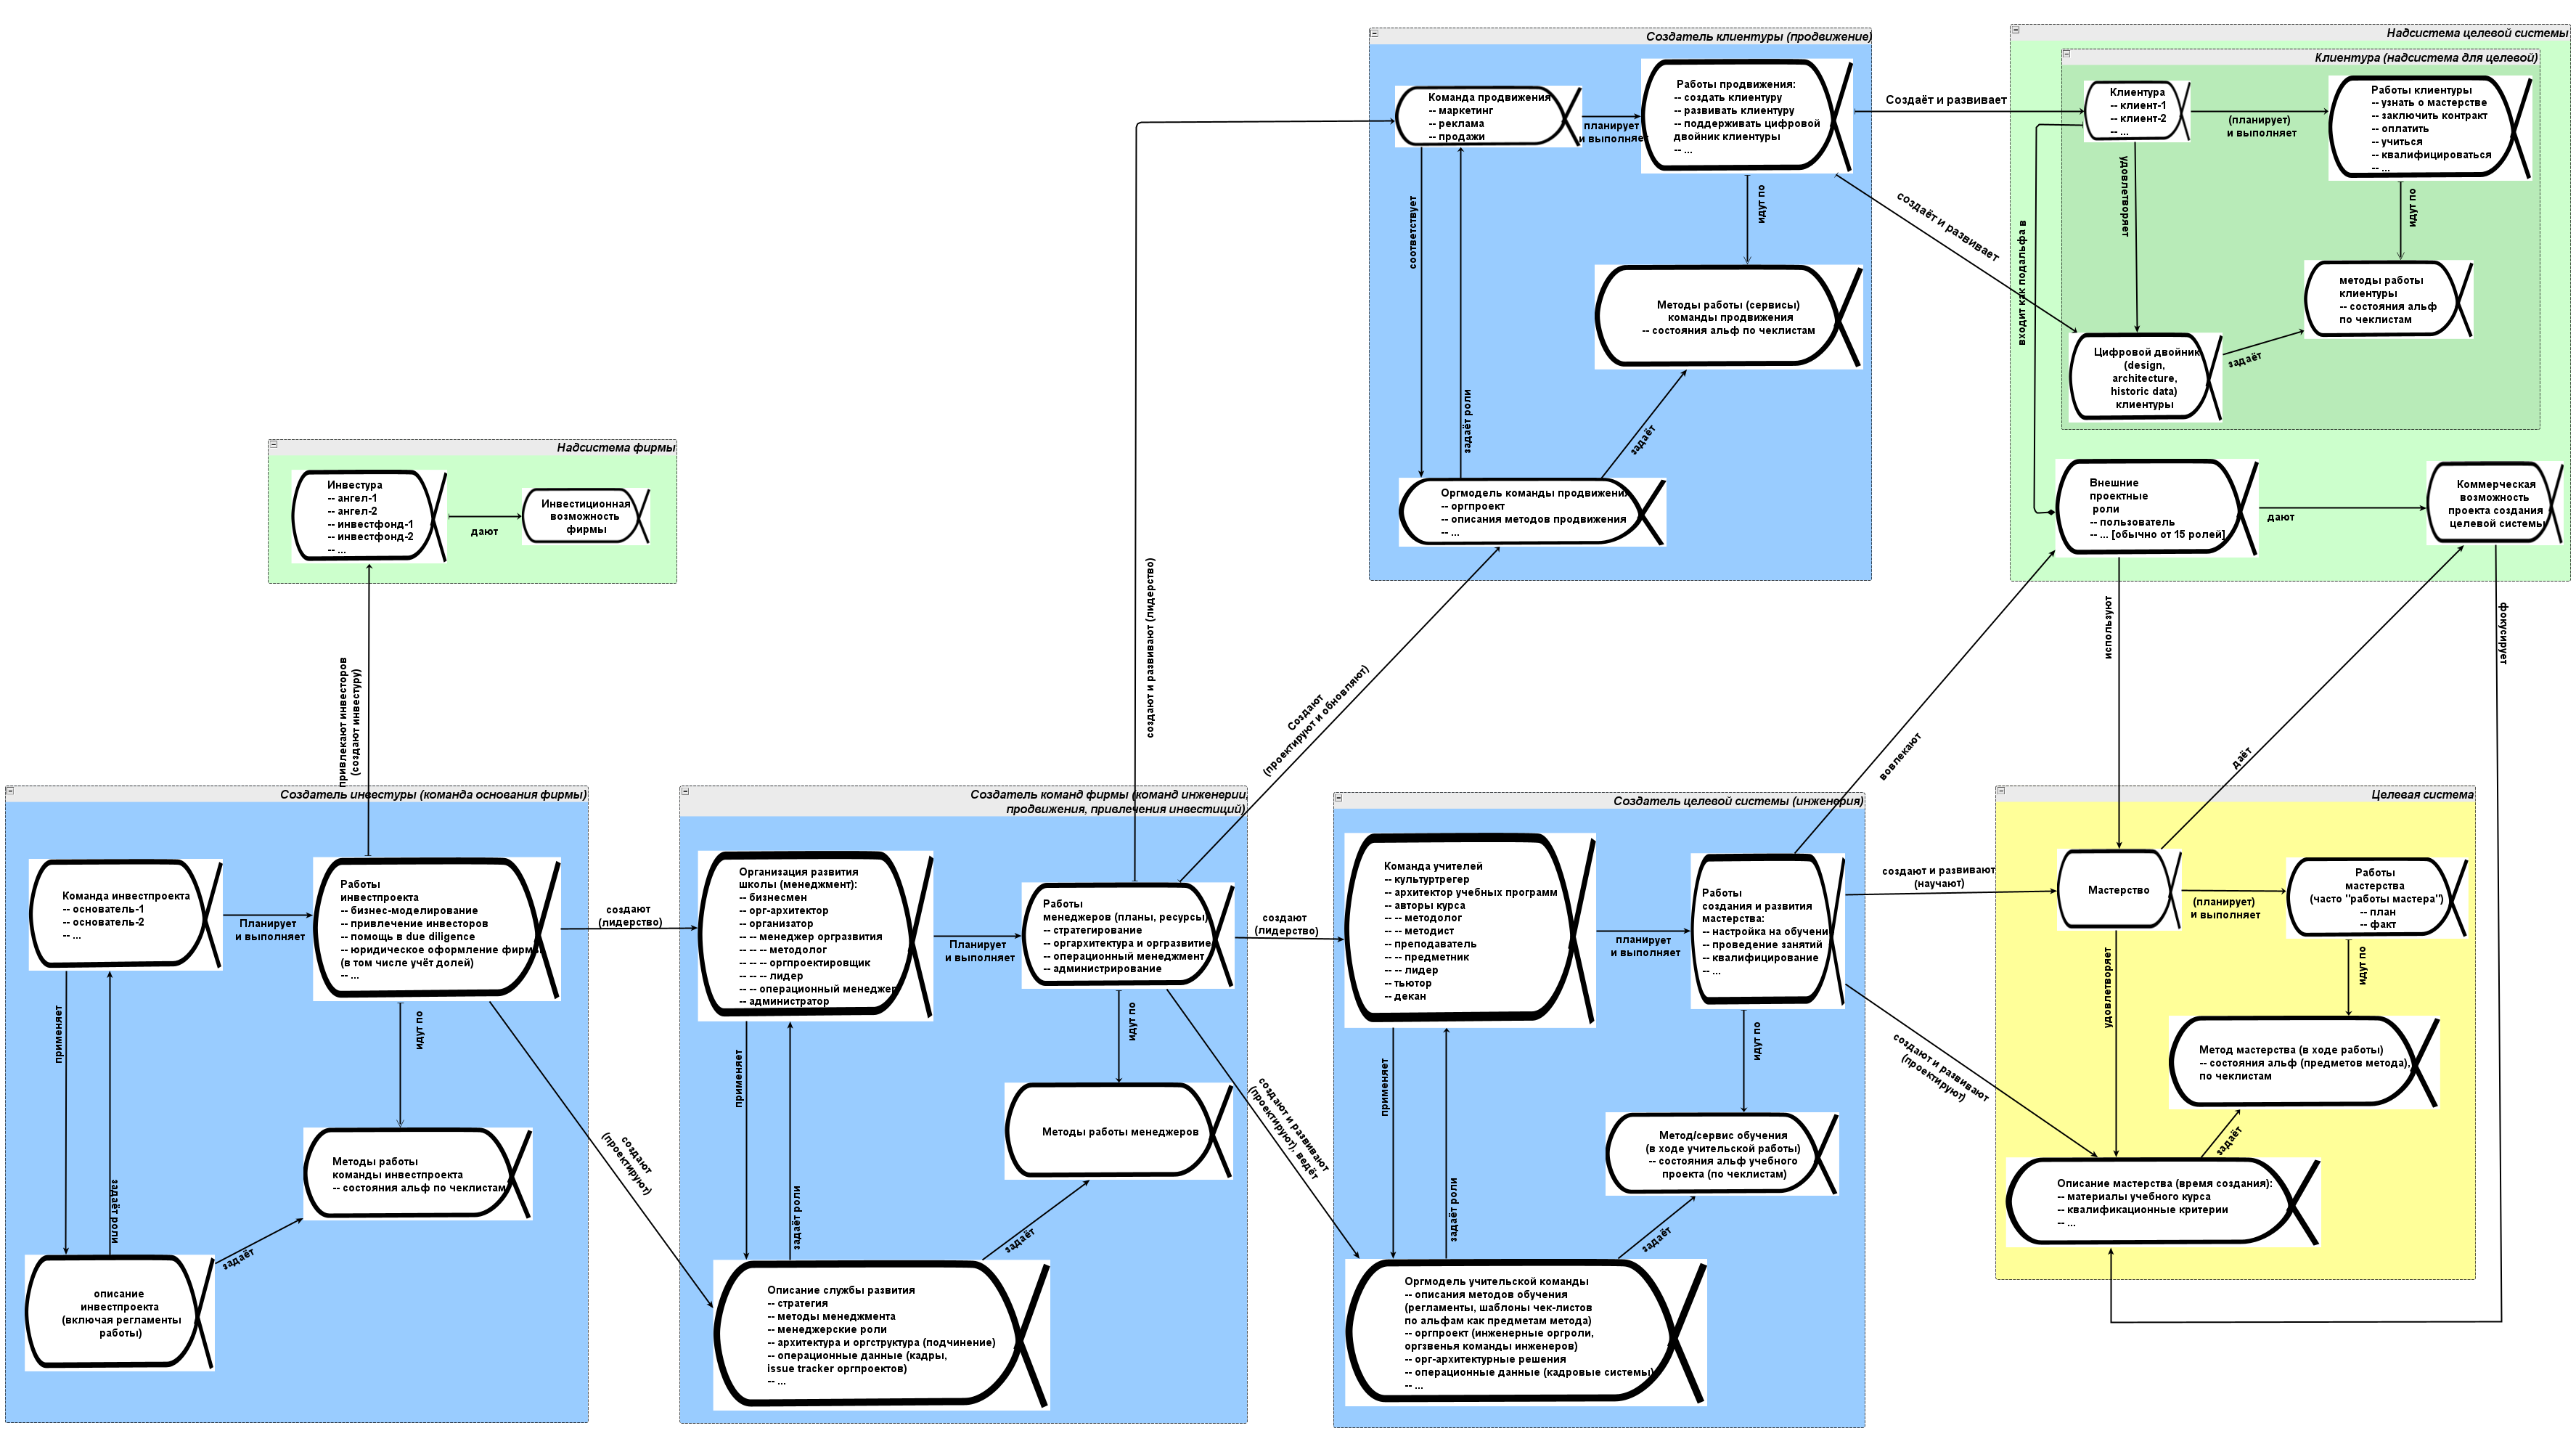
В этой схеме уже не абстрактное «воплощение системы», а конкретизированное «мастерство», не абстрактная «организация проекта», а «команда учителей», не просто «описание системы», а «описание мастерства». Если посмотреть на команду учителей, то тоже видно — поменялись названия ролей из общих на роли, специфичные для проекта создания мастерства. В ходе адаптации для прикладной инженерии также убрали агентуру, хотя в каких-то проектах привлечения клиентуры в учебных проектах она и может быть. Тут убрали агентуру главным образом для того, чтобы показать, что исходная диаграмма графа создателей — не догма, её вполне можно менять в ходе конкретизации абстрактных фундаментальных описаний в какие-то прикладные, учитывающие предметную область инженерного проекта.
Проект создания и развития мастерства может быть частью какого-то другого проекта, например, это может быть частью проекта создания и развития предприятия, будут учить мастерству сотрудников (например, работе на новом типе станков). Тогда надо будет увязать общий проект и этот прикладной проект, рассмотреть графы создателей и предприятия в целом, и мастерства сотрудников этого предприятия. Эту увязку проектов, рассмотрение общего графа создателей удобно делать на языке системной инженерии, общем для всех проектов создания чего бы то ни было.
Для такого сорта систем как мастерство, даже если принять «инженерный подход к делу», а не «педагогический» или какой-нибудь менее определённый «культурных изменений» или чего-то более размытого в плане указания на цели и способы работы, есть много особенностей. Чтобы научиться прикладной инженерии, нужно освоить не просто общее мышление инженера, но методы обучения, которые даже называться будут традиционно «обучение», а не «инженерия». Обучение, в свою очередь, как метод создания и развития мастерства, будет разложено на множество разных составляющих методов. Это метод культуртрегерства как создания концепции использования мастерства в его «личностном окружении» (начало разработки — старт проекта, роль культуртрегера тут чаще всего будет выполняться человеком на должности product-manager, не путаем роли и должности), методы методологии и методики как разработки проекта мастерства и проекта его создания (это будет называться «материалы учебного курса»), методы преподавания как одни из составляющих методов работы деканата (в инженерии это работа инженеров внутренней платформы разработки и самой внутренней платформы разработки — изготовление и проверка частей, сборка из частей и проверка целого, введение в эксплуатацию — вынос в жизнь, в нашем случае это всё будет про мастерство), методы мастерского выполнения деятельности как эксплуатация мастерства. И это не разовое прохождение жизненного цикла: в современной инженерии личности как эволюционной инженерии нужно ещё и обновлять мастерство в уже выученных агентах-мастерах, как сейчас обновляют прошивки телефонов в давно изготовленных телефонах. Называться это, конечно, будет «обучение», но все рассуждения про современное обучение надо проводить так же, как про инженерию — современное обучение будет эволюционным/непрерывным (но масштабным, масштабы личности и мастерства).
Эта адаптация методов системной инженерии для самых разных её приложений к целевым системам самой разной природы, самых разных видов, происходит для всех масштабов систем самой разной природы. Концепция использования, инженерные обоснования (все с разными названиями, конечно) будут нужны и для театральной постановки, и для ледокола, и даже для парламента. Их необходимость обсуждается в системной инженерии, но в своих предметных областях они все называться будут по-разному, и разрабатываться по-разному, разными методами. Про методы их разработки будет говориться в прикладных «инженерных» курсах/руководствах/регламентах/стандартах. Слово «инженерный» тут в кавычках, чтобы напомнить: не все эти инженеры будут соглашаться на то, что они будут называться именно «инженерами». Но мы в нашем руководстве по системной инженерии будем их называть именно так, ибо они как раз будут те, кто меняет мир к лучшему, кто создаёт и развивает успешные системы.
По каждой такой конкретизации/адаптации, в каждом приложении системной инженерии к какому-то виду целевых систем нужно владеть прикладным методом инженерии, часто называемой «инженерия таких-то систем» в случае уровней косного вещества и киберфизических систем (например, инженерия систем управления, control systems engineering, и помним, что systems engineering отличается от engineering of systems100) и уж совсем по-разному в случае более высоких системных уровней. Например, обучение мастерству (включая проектирование этого мастерства и проектирование метода его создания) является именно конкретизацией/адаптацией системной инженерии.
3. Уровень специализации инженерии конкретной системы
Даже при том, что безмасштабная и непрерывная системная инженерия конкретизируется для какой-то прикладной инженерии систем определённого масштаба и вида (авиация, образование, медицина, фермерство, госполитика), для каждого конкретного проекта будет ещё одно уточнение для того конкретного типа системы, который будет создаваться и затем развиваться в единичном экземпляре или выпускаться серийно (включая особенности разных провайдеров сервиса) — уточнение для конкретного типа системы, моделирование на уровне метаС-модели, модели конкретной ситуации. Так, легко представить себе, что конкретизации инженерии мастерства для мастерства системного фитнеса, мастерства игры на фортепиано, мастерства решать дифференциальные уравнения при помощи программ компьютерной алгебры и численных методов, общего мастерства безмасштабной эволюционной системной инженерии (наше кругозорное руководство как раз про это) будут совсем разными для конкретных учебных проектов. И надо ещё будет уточнить, что слово «учебный» тоже не всегда присутствует, ибо стажировка обычно рассматривается как рабочий проект, а не учебный — при этом учебный характер стажировки не отрицается, но термин «обучение» не используется. Мы в наших руководствах тоже предпочитаем термин «освоение работы» вместо термина «обучение».
Скажем, игра на фортепиано — это метод, задействующий мышцы. По факту эта игра может быть надстроена над мастерством системного фитнеса, но не только — в это мастерство входит как минимум ритмика, которой нет в системном фитнесе и можно ещё обсуждать промежуточный метод музицирования, который неразличим для вокала, игры на фортепиано и игры на скрипке, и учёт всех этих особенностей даст совсем разные методы игры на фортепиано, которые по-разному могут преподаваться в музыкальных школах, но неизбежно при их практиковании в течение долгого времени приведут к более-менее похожим результатам (игра на любительском уровне станет профессиональной). Помним про неустроенности и эволюцию: есть множество выживающих почти одинаковых вариантов оптимизаций для межуровневых конфликтов (и это разнообразие для эволюции важно), а резкие улучшения довольно редки. Это означает, что есть множество самых разных вариантов «инженерии музыки на инструментальной базе фортепиано», они дают все примерно одни и те же результаты, плохие варианты рыночно вымрут, а улучшения будут, но крайне редки. Скажем, улучшение типа игры на клавишном синтезаторе, или магнитофон, а затем и плеер, который позволяет не играть пьесу каждый раз, а просто воспроизводить записанное, но затем музыкальные сервисы искусственного интеллекта, которые могут уже не воспроизводить пьесу, а сочинять её и воспроизводить вообще без фортепиано и людей. И ещё роботы, которые будут проигрывать пьесу на старинном фортепиано, но там не будет человеческой мышечной работы, а ещё есть моторизированные фортепиано, которые сами-себе-роботы. Эволюция методов происходит постоянно, а с ней и эволюция инструментария для этих методов. Соответственно, меняется и прикладная инженерия.
Если какая-то команда занялась инженерией какого-то вида систем, то она будет развивать этот вид систем, подстраивая варианты целевой системы под изменения окружения и используя всё новые появляющиеся альтернативы по концепции системы как способы реализации функций какими-то интересными новыми конструктивными элементами. А ещё команда будет развивать себя, будет менять методы инженерии (и свой состав: часто новые методы — это и новые люди, новый инструментарий), равно как и методы/функции работы своей целевой системы.
На этом уровне специализации инженерии конкретной системы можно использовать или граф создателей, отмоделированный для уровня метаУ-модели (предметная область какой-то инженерии «как в учебнике») с предыдущего уровня, или всё-таки конкретизировать метаУ-модель для создания конкретного вида развиваемой в проекте системы: киберфизической системы (авиалайнера или игрушечного самолёта), или предприятия (стартапа на пять человек или большого агропромышленного холдинга), мастерства (игры на фортепиано или операционного менеджмента, и ещё тут разница — на уровне хобби/кругозора, или на профессиональном уровне). Все эти уточнения потребуют адаптации графа создателей, детальности моделирования проекта, а ещё будут самые разные варианты разложения инженерного процесса для систем разной природы, всё это обсуждали в руководстве по методологии.
Количество уровней конкретизации системной инженерии как фундаментальной дисциплины до какой-то прикладной уникальной версии инженерного процесса (инженерного метода, способа разработки — помним, что тут множество имён) может быть и больше, чем наши примерные уровень мета-мета-модели (настоящее руководство как раз этого уровня), уровень метаУ-модели (например, конкретизация до предметной области системного менеджмента, руководство по системному менеджменту как раз такое), уровень метаС-модели (конкретизация для конкретного проекта конкретного предприятия, набор регламентов конкретного предприятия и культура прикладной инженерии в головах конкретных сотрудников этого предприятия определяют его прикладную инженерию, например, как конкретно происходит создание и выпуск электромобилей на заводах именно Tesla, но не «вообще в автомобильной промышленности мира»).
Если вы будете создавать «службу найма сотрудников», то её создание будет описываться ситуационной метаС-моделью (уровня стандарта предприятия), например, описанной в регламенте «Ведение организационных изменений», а для этой метаС-модели ведения организационных изменений ещё будет модель конкретной проектной ситуации с учётом экземпляров (операционным учётом проекта организационных изменений — какой-нибудь issue tracker, который учитывает состояние альф проекта организационных изменений, в данном случае организации службы найма сотрудников — то ли из вновь набранных людей, то ли это будет сдвиг части работы службы HR на какую-то AI-систему и служба будет «виртуальной», то ли это сдвиг найма на аутстаффинговую компанию и служба будет внешней, то ли это выделение части сотрудников из числа уже занимающихся HR в обособленное подразделение). На втором уровне конкретизации (культурная метаУ-модель, «как в учебниках», а не «как в регламентах») это будет предметная область «организационные изменения», методы там прописываются в учебниках менеджмента — причём часть методов по собственно организационным изменениям будет прописана в части по организационным изменениям, но будут и приёмы работы по организации именно найма сотрудников, это можно будет найти в части учебников менеджмента, описывающих методы HR в части найма сотрудников, а не в части, общей для организационных изменений. Это общий принцип: искать методы обычно надо в разных местах — ибо граф создателей включает много разных работ.
Скажем, вам надо выпускать тонкие стеклянные трубочки. Для этого вы читаете учебник по стеклянным трубочкам, там будут описаны не только сами трубочки (целевая система), но и как их делать (то есть описано создание этих трубочек, инженерный процесс, по факту описаны методы работы создателя стеклянных трубочек), причём аспекты работы создателя, связанные со стеклянными трубочками — какие станки, какие квалификации ожидаются у мастеров, какие рабочие операции они должны делать, но вряд ли там будут общие сведения о том, как организовывать людей, сведения об операционном менеджменте для производства стеклянных трубочек. А вот когда вы захотите реально организовать выпуск, то вам надо будет читать ещё учебник «как организовывать», ибо про создание создателей будет говориться там — менеджеры должны будут знать, как организовать производство (вообще производство, то есть как собрать и обучить каких-то людей, купить станки, наладить доставку сырья, и т.д.). Но общих знаний «как организовывать» тоже не хватит, надо пользоваться и знаниями из учебника по производству стеклянных трубочек. В учебнике по изготовлению стеклянных трубочек, может, и не скажут, откуда брать мастеров (где брать работников — это не специфическое знание прикладной инженерии), но уж точно расскажут, чему надо этих мастеров дообучить, чтобы ваши трубочки были качественные. А ещё что, кроме учебников? Обязательно посмотрите материалы компании-поставщика станка для производства стеклянных трубочек: наверняка там вы сможете найти не только про стеклянные трубочки и их станок, но и советы по организации труда на их станках.
И не путайте системные уровни (отношение часть-целое) и уровни абстракции (отношение принадлежности к классу, конкретизация как противоположное по направленности абстрагированию отношение как раз тут). А ещё тут отношение создания и развития в графе создателей (система-создатель создаёт и развивает создаваемую систему, это и не часть-целое, и не абстракция).
Такой подход многоуровневой конкретизации инженерного метода решает и традиционные проблемы классического подхода к инженерии как отдельной от менеджмента, и проблемы обучения как отдельного и от инженерии, и от менеджмента, и особость генетической инженерии, которая оказывается вообще ни на что не похожа, и особенности программной инженерии, и всех остальных инженерий.
В классической системной инженерии как инженерии сложных киберфизических систем обычно вынуждены описывать менеджмент проектов создания самолётов и подводных лодок как «системноинженерный менеджмент». Если понимать, что речь идёт об инженерии организации, которая будет заниматься созданием киберфизической системы, то это просто описание двух инженерных проектов в графе создателей: создание киберфизической системы (самолёта или подводной лодки — концепция использования и программа испытаний, архитектурные решения, и т.д.) и создания организации проекта (стратегия как концепция использования, то есть что будет делать организация, какие изменения к лучшему приносить в окружающий мир какими методами, архитектура организации/команды/коллектива/предприятия/«производственной кооперации» проекта, решения по концепции системы — какие оргзвенья будут какие рабочие процессы выполнять, и т.д.). Эти проекты существенно связаны. Детский сад устроен не так, как завод ракет. В частности, инженерия целевой системы и инженерия организации связаны через закон Конвея/Conway и обратный манёвр Конвея, подробности будут и в нашем руководстве по системной инженерии, и в руководстве по системному менеджменту.
А чему учить тогда системных инженеров, например, классических киберфизических систем? Учить тоже методам работы, взятым на разных уровнях абстракции:
-
общей безмасштабной и непрерывной системной инженерии, это и есть предмет нашего руководства.
-
затем инженерии киберфизических систем (кругозорный уровень предметной области для какого-то эволюционного уровня),
-
затем конкретизации этой инженерии для самолётов (конкретная предметная область, и это будет весьма разная инженерия для одномоторного одноместного самолёта и авиалайнера на три сотни пассажиров — domain), и доводить это обучение до узкого метода, который используется в конкретном проекте (и тут говорят про ограниченную предметную область, предметы метода рассматриваются как bounded domain из DDD101, и это сейчас мейнстрим, про domain-driven-design мы будем говорить подробней).
-
и обязательно менеджменту, то есть организационной инженерии с конкретизацией для инженерных организаций в авиации.
При этом есть всегда надежда, что при знании общего подхода к инженерии (наставления нашего руководства, наиболее абстрактный подход к инженерии — уровень мета-мета-модели) обучение каким-то особенностям методов создания и развития какого-то класса систем не только займёт меньше времени, но и пригодится, когда будут происходить неизбежные события техноэволюции и будут меняться и методы создания, и сами создаваемые системы.
Эти события происходили, происходят и будут происходить, от них нельзя спрятаться, это эволюция. Скажем, когда самолёты вдруг будут заменяться или электросамолётами для ближних рейсов, или многоразовыми ракетами для дальних рейсов, причём это будут автопилотируемые электросамолёты и ракеты: основное знание «как создать киберфизическую систему» останется, но придётся поменять представления о том, что там нужно будет делать конкретно для изменившегося вида систем. А когда пойдут организационные изменения (а они обязательно будут!), то у инженера-авиастроителя будет понимание происходящего, хотя бы в общих чертах.
Задания
Поставьте отметку о выполнении дел.
-
В нашем руководстве были отсылки к материалам руководств-пререквизитов: по рациональной работе, системному мышлению, методологии. Места, на которые были отсылки, вы нашли, и не только перечитали там учебный материал, но и посмотрели сами научные работы групп Ванчурина-Кацнельсона-Вольфа-Кунина, Дэвида Дойча, Филдса-Глазебрука-Левина, Джона Дойля, на которые там давались ссылки (все разъяснения по теме эволюции и конфликтов системных уровней даны не в текстах наших руководств, а в первоисточниках! Привыкайте читать первоисточники!). А после этого написали пост с вашим пониманием того, как вы участвуете в техно-эволюции.
-
Написан и опубликован пост с вашими мыслями о том, каким образом ваш рабочий проект является многомасштабным (системы каких уровней он затрагивает, включая проекты разных создателей в их графе) и эволюционным/непрерывным (как долго вы уже развиваете, и как долго ещё собираетесь развивать вашу целевую систему и что при этом в ней меняется в ходе проекта, насколько ваш проект следует культуре непрерывного ввода в эксплуатацию, continuous delivery).
2. Архироль создателя/инженера и разделение инженерного труда
Роль системного инженера в её отличии от роли прикладного инженера
Ответственность за всю систему на многих уровнях как целое (whole system) и связанная c этим фундаментальность/трансдисциплинарность/transdisciplinarity подхода к прикладным инженериям (механической, электрической, программной, предприятия и т.д.) отличают системную инженерию от всех её частных/предметных/domain конкретизаций. Представим себе ледовую буровую платформу:
Сотни тысяч тонн металла, бетона, пластмассы, компьютеров (самих по себе сложно устроенных) и оптоволокна, необходимых расходных материалов, обученная вахта должны собраться вместе далеко в море среди льда. В строго определённый момент эта огромная конструкция должна начать согласованно работать — и не просто работать, а приносить прибыль и обеспечивать безопасность в части загрязнения окружающей среды и здоровья находящейся на платформе вахты, а также в чётком согласовании со службами берегового обеспечения (нефтепереработка, провайдеры связи, метеорологические службы, государственные надзоры по самым разным линиям и т.д.). В течение долгих лет потом живые люди ещё должны постепенно заменяться роботами (человекоподобными, нечеловекоподобными и даже программными, чаще всего с AI, но и это не обязательно — иногда хватает простого автомата).
Какой метод работы должен учесть результаты работ самых разных агентов в ролях прикладных инженеров, работающих на самых разных системных уровнях — собрать в единое целое данные ледовой обстановки, санитарных норм в помещениях для обслуживающего персонала, обеспечение электричеством попавших туда компьютерных серверов, необходимые характеристики этих серверов и программное обеспечение с нужными функциями и нужной надёжностью? Кто озаботится учётом в конструкции платформы изменений в длине металлоконструкций за счёт разницы суточных температур и одновременно установкой акустических датчиков на трубах, которые прослушивают шорох песка, чтобы по этому шороху нейросетевые алгоритмы определяли износ труб и предлагали редкий и нужный «ремонт по состоянию» вместо относительно частого и бесполезного «планового/профилактического ремонта»? Методом работы, который ответствен за обеспечение целостности системы и её графа создателей в инженерном проекте является системная инженерия.
Инженеры нефтяной платформы в их самых разных ролях создают (проектируют и изготавливают) и развивают нефтяную платформу как изменяющее мир к лучшему или хотя бы просто успешное (безопасное, надёжное, прибыльное, ремонтопригодное и т.д. — разным внешним проектным ролям нужно от этой платформы разное) целое, в том числе отдают части этой работы каким-то инженерам, которые специализируются на прикладных видах инженерии каких-то подсистем, входящих в нефтяную платформу (инженерам-строителям, машиностроителям, инженерам-электрикам, компьютерщикам/айтишникам и т.д.) и собирают результаты их работ так, чтобы удерживать успешность нефтяной платформы в течение многих лет. Агенты, исполняющие как роли инженеров нефтяной платформы, так и роли прикладных инженеров самых разных специализаций, по факту владеют на каком-то кругозорном уровне и системной инженерией, чтобы понимать происходящее в проекте как в части его целевой системы, так и в части организации проектной работы. Именно системная инженерия помогает договориться, как в целом создать и развивать успешную систему и как в целом разделить труд в команде создателей этой системы.
В тот момент, когда инженеры заняты удержанием целостности и успешности целевой системы, какой бы природы она ни была, они — системные инженеры. Василий Петрович как инженер в проекте выполняет тем самым две роли: системного инженера целевой системы (когда заботится об успешности проекта в целом) и прикладного инженера, когда размышляет об успешности какой-то системы в графе создателей — например, заботится об успешности сетей компьютерной связи на нефтяной платформе, или успешности команды изготовителей металлоконструкций.
Это главный признак, отличающий системных инженеров «по роли» от всех других прикладных инженеров: они отвечают за целевую систему в целом, как в части деталей-частей (разные системные уровни требуют разных методов для работы с типовыми для них системами — с микросхемами работают не так, как с компьютерами, а с компьютерами не так, как с системами управления, в состав которых входят компьютеры), так и в части использования детальных знаний отдельных инженерных методов (разные свойства систем какого-то типа требуют знания разных методов: если вам нужно сделать корпус компьютера, то нужны и знания инженера-механика, чтобы корпус был прочным и лёгким, и знания инженера-теплотехника, чтобы компьютер не перегревался и корпус обеспечивал достаточную вентиляцию). Главная задача создателя в роли системного инженера — чтобы не было пропущено какой-нибудь мелочи, ведущей к провалу.
Авиалайнер — это много-много кусков металла и пластика, синхронно летящих вместе с людскими телами и чемоданами на скорости 900км/час (0.85 от скорости звука, это типовая скорость Boeing 787 Dreamliner) на высоте 11км. Системный инженер в его прикладной специализации «авиационный инженер» — это тот::роль, кто озабочен их надёжным и экономичным совместным полётом, озабочен увязкой самых разных интересов самых разных ролей (грузоподъёмность, расход топлива, дальность полёта, шум при взлёте и посадке, ограничения по длине разбега и посадки, необходимость лёгкого обслуживания на земле, отсутствие обледенения, безопасность людей на борту, и т.д. и т.п.). Эти интересы отстаиваются самыми разными исполнителями внешних проектных ролей, представляющими самые разные профессиональные и общественные группы исполнителей тех или иных методов (экологи, военные, урбанисты, коммерсанты, и т.д., и т.п.), но если не удастся договорить их всех, проект будет неуспешен.
Для авиалайнера примерно шесть миллионов деталей замысливаются, проектируются, именуются, изготавливаются, проверяются, доставляются в одно место, собираются в одно изделие, принимаются как целый авиалайнер и продаются, в аэропорту эти собранные детали как одно целое обслуживаются, заправляются топливом и едой, заполняются пассажирами и грузом, диспетчируются на взлёт — и вот эти шесть миллионов деталей летят, обеспечивая комфорт пассажирам и прибыль владельцам, но на этом проект не заканчивается — в проект вносятся какие-то изменения, и очередной экземпляр лайнера выходит немного другим (нет двух одинаковых конфигураций, выходящих из завода!), а кроме этого ещё и обсуждается проект новой базовой модели — авиационная инженерия тоже эволюционная.
Это даже не вся история: авиазавод тоже надо создать и развивать как успешную систему в графе создателей авиалайнера — и это тоже требует задействования инженерами этого завода методов работы системных инженеров. Более того, ключевыми тут будут как раз инженеры внутренней платформы разработки — в ответственности которых инструментарий непрерывной разработки в частях как замысливания и проектирования, так и изготовления. В идеале завод (инструментарий изготовления) — это инструмент-автомат, там нет людей, это «тёмная холодная фабрика», потому и тёмная и холодная, что освещать и отапливать ввиду отсутствия людей её не надо. Это идеал, но к этому идеалу человечество движется довольно быстро.
Элон Маск не боится компаний, которые делают прототипы электромобилей. Для автомобилей создать массовое производство автомобилей в сто раз трудней, чем создать автомобиль102. Для ракет, для чего угодно: создать рентабельное серийное производство ракет и чего угодно вдесятеро или даже в сто раз трудней, чем создать саму ракету. Безопасные бритвы получили широкое распространение только после того, как Жиллет наладил массовое производство дешёвых одноразовых лезвий, которые были острыми (то есть были массово изготовлены с большой точностью), но их можно было просто выбросить после использования103.
Можно создать восхитительный проект компьютерного чипа силами десяти человек и пары искусственных интеллектов, а вот чтобы изготовить этот чип, потребуется завод чипов, для этого завода потребуется оборудование для изготовления чипов — и тут выяснится, что чипы могут разработать инженеры почти в каждой стране мира, но разработать оборудование для производства и построить завод для современных чипов, а не чипов двадцатилетней давности могут буквально в нескольких странах. Компания ASML104 является много лет почти полным монополистом в производстве оборудования для современных, а не давно устаревших микросхем, и эта ситуация не спешит меняться.
Заводы тоже строят создатели/инженеры, находящиеся в двух инженерных ролях: прикладных методов работы для систем той природы, которыми занимается завод (скажем, машиностроение::метод, если на заводе выпускают машины, менеджмент::метод для тех «заводов», которые выпускают организации из людей), и роли системного инженера — когда надо удерживать целостность целевой системы, целостность систем из графа создателей (в том числе целостность завода, как одного из создателей в этом графе). Хотя ролей даже не две, а больше — если учесть, что любой метод работы можно раскладывать на составляющие довольно глубоко (в приближение иерархического представления, подробней об этом в руководстве по методологии), то ролей можно получить заведомо больше, чем число участников проекта.
Как об этом думать? Традиционно: как о разделении труда, причём часть труда — это мышление, оно трансдисциплинарно. Какой-то человек (или даже AI) когда думает о своём проекте, выполняет огромное число ролей:
-
Прикладного инженера, который озабочен методами работы для конкретного вида систем (механика, электрика, авиация, обучение). Стишок про «мамы разные нужны, мамы разные важны»105 как раз про это. Возможно, одному агенту нужно будет играть даже роли разных прикладных инженеров.
-
Системного инженера, который озабочен успешностью системы в целом, успешностью графа создателей в целом.
-
Самые разные другие роли, прежде всего роли из интеллект-стека: например, роль совести, поскольку в любом проекте приходится сталкиваться с этическими проблемами, роль разума, поскольку надо принимать рациональные решения, и так далее.
Поскольку речь идёт о разных ролях, то велика вероятность существенного конфликта интересов (напомним, что термин маркирует ситуацию, когда два интереса по одному и тому же предмету у двух ролей противоположны и эти роли играет один агент). Так, роли инженера-технолога, предлагающего новую технологию производства и специалиста по оценке эффективности этой технологии, если они исполняются одним человеком, в конфликте интересов. Одна роль заинтересована в демонстрации преимуществ предлагаемой технологии, что может побуждать эту роль занижать или даже полностью игнорировать возможные эксплуатационные риски и недостатки. Однако роль визионера, который должен оценить, выгодно ли задействовать эту технологию, требует наоборот — выявления всех возможных рисков, причём не только сиюминутных, но и возможных к появлению в будущем. Какая роль «победит»? Возможно, в этот момент надо подключать мышление ролей рациональности (рациональное принятие решений в условиях неопределённости) и совести (оценка своего конфликта интересов).
При этом нельзя считать, что конфликт интересов фатален, ибо всегда можно найти конфликт интересов ввиду разнообразия ролей, которые приходится исполнять одним и тем же людям (в том числе конфликт интересов роли «совесть» и всех остальных инженерных, например, когда инженер знает, что проект «дохлый» и лишь расходует деньги инвесторов, которые могли бы быть потрачены на другие, более успешные проекты). Есть и парадоксальные результаты. Например, дальше в нашем руководстве будет рассмотрено (и дана литература), что в современной программной инженерии функциональные тесты пишет не независимый агент-тестировщик, а тот же агент, который выполняет роль разработчика — и экспериментально показано, что качество программы при таком подходе не ниже (хотя и не выше), чем в ситуации, когда тестирование проводится независимыми разработчиками.
Но всё-таки большие инженерные проекты делаются не одним человеком, который исполняет все проектные роли, а коллективами с разделением труда по созданию систем самой разной природы в составе целевой системы и систем в графе создателей. Кроме того, в любом проекте обычно находятся множество агентов, которые исполняют внешние проектные роли — и часто не только число внешних проектных ролей начинается от пятнадцати, как обсуждалось в руководстве по системному мышлению, и всегда есть минимум одна не выявленная роль, но и число отдельных агентов, играющих (или представляющих в проекте — если, скажем, в игровом проекте роль игрока играют 40 тысяч человек, представлять все эти 40 тысяч человек может один агент, человек или AI) эти роли, легко может быть тоже от пятнадцати уже не ролей, а человек — ещё и по нескольку человек могут играть одну внешнюю проектную роль, и между ними могут быть даже разногласия по предпочтениям.
Для любого производства киберфизической системы нужно учесть потребности внешних проектных ролей, разработать концепцию использования и концепцию системы, принять архитектурные решения, создать информационную модель с детальностью, достаточной для изготовления, далее выполнить все закупки комплектующих, выбрать или даже построить завод как производственную платформу, запустить/наладить его оборудование, нанять и обучить людей, потом управлять тем, чтобы этот завод работал «как машина» (несмотря на то, что работают на нём не только машины, но и люди), и делать это для системы-как-вида, с учётом постоянных изменений в окружении целевой системы в ходе её эксплуатации, постоянных изменений в предложениях конкурентов, постоянных изменений в потребностях, постоянных изменений в методах производства и используемых материалах, постоянных изменений в команде. Это всё требует многоуровневого (системного) учёта мельчайших деталей всех систем — и целевой системы с её окружением, и систем графа создателей с их окружением.
Если где-то на конвейере завода неудачно выпадет винтик из-за того, что что-то там было плохо спроектировано, потом плохо смонтировано, поломка плохо диагностирована, может неожиданно остановиться весь завод. Если архитектор не справился со своей работой и внести новую фичу/возможность в систему можно только путём «разработки с нуля, перенастройки производства с нуля», то может неожиданно остановиться весь проект. Ну, или работники завода могут забывать вести учёт изменений оборудования этого завода (провалено управление конфигурацией завода) — и будет непонятно уже, какое там стоит оборудование, и как его ремонтировать. Или производство организовано так, что оно разбито на отдельные более-менее автономные участки с уникальным оборудованием и мало уже кто знает, какое именно там оборудование на соседних участках — и это хорошо, это позволяет быстрее выполнить переналадку производства на новый инженерный процесс (так работают, например, производство автомобилей Tesla — но это требует особой организации сборки автомобилей, причём эта организация учитывает эволюцию самого хода сборки, равно как эволюцию проекта/design автомобиля).
Проблема организации труда инженерной бригады в целом — это проблема менеджмента, причём менеджмент тут оказывается тоже инженерией, просто это инженерия уже не целевой системы, а инженерия предприятия как системы в графе создателей. Это «организационный менеджмент» в части создания и модификации/модернизации организации, «операционный менеджмент» в части эксплуатации созданной организации. И инженерия киберфизических систем (роботов — больших вроде стадиона, самолёта, автомобиля, ракеты, и маленьких, вроде человекоподобных роботов и роботов-собак, промышленных роботов), и менеджмент — это всё прикладные инженерии, конкретизации лучшего известного человечеству способа делать успешные системы, менять физический мир к лучшему — прикладные конкретизации системной инженерии.
Наше руководство в основном будет основано на примере такой конкретизации в части киберфизических систем (иногда это называют «классическая системная инженерия»), а также программных систем, это программная инженерия (software engineering). Мы не слишком много будем давать примеров «нежелезных» и «непрограммных» систем, но всё излагаемое приложимо и к ним. Мы уже смотрели на «мастерство» как пример такой системы. Но это же работает и с биологическими системами, а также системами «на грани неживого», например, вирусами (они как раз занимают пограничное положение между «живым» и «неживым», нет однозначного их отнесения к одному из этих классов).
Скажем, если вы работаете с генной инженерией, то как раз будете заниматься вирусами. Это означает, что вам нужно соответствующим образом простроить работу исследовательской лаборатории (инженеры-разработчики), работу производственных мощностей (выпуск вируса), организовать работу с персоналом и ещё отвечать на многочисленные вопросы по биоэтике, а также делать это достаточно долго: проект не должен закончиться первым же генным продуктом, будь он удачным, или даже не очень удачным — надо будет выпускать новые и новые вирусы. То есть работать нужно отнюдь не только с самими вирусами! Какая роль удерживает все эти различные системы, над которыми надо работать, в их сложных взаимосвязях, договаривает всех вокруг по поводу взаимодействия всех этих систем? Это роль (не должность!) системного инженера.
В крупных проектах подобную роль «удержания целого» могут выполнять десятки людей в качестве основного времени их занятости, а не в приложении к занятости как прикладного инженера и сопутствующей их занятости как «мыслителя» в части интеллект-стека фундаментальных методов мышления. И их могут называть по этой обобщённой «архироли» — системные инженеры, даже если они занимаются только частью методов системной инженерии: только методологией, только архитектурой, только созданием концепции системы или только эксплуатацией. Со стороны люди отмечают, что «он занят системой в целом, проектом в целом» — и дальше уже не разбираются в деталях, маркируют как исполнение роли системного инженера, не выделяя составляющие этой роли.
Системный инженер держит все (и в целевой системе, и в её окружении, и в графе создателей) системы в проекте взаимоувязанными, ибо именно у него (тут может путаться роль и исполнители роли — могут говорить «у него», если один агент, или «у них», если проект большой и исполнителей этой роли несколько) в голове и компьютерах (основной инструмент — моделер для системного моделирования) метод раскладки всей сложной системы в её окружении на уровни, а также раскладки рассмотрения разных интересов в рамках одного уровня на разные методы, многоуровневой оптимизации решений для удовлетворения всех интересов (конфликтов/противоречий между решениями разных уровней избежать нельзя, нужно проявлять изобретательность, и всё равно в результате будет неустроенность/неустаканенность в конструкции системы, будет проявляться субоптимальность в решении этих конфликтов), а ещё он будет заниматься также системами в графе создателей — ибо чаще всего это не биология и система не создаёт себя сама (не жизненный, не цикл), её создают создатели в их графе. Системная инженерия — это как раз способ думать о том, как создавать и развивать самые разные системы и создателей этих систем.
В помощь людям, которые играют роль системных инженеров тут прежде всего их коллеги (включая AI, а не только людей), прикладные инженеры (тоже необязательно живые, и речь тут о разделении труда и разделении работ — проекты коллективны!), а также «просто компьютеры», позволяющие удерживать всю эту сложность в их человеческой, но усиленной компьютером памяти, проводить имитационное моделирование для экономии времени и материалов по сравнению с пробами и ошибками в реальной жизни. Компьютеры помогают удерживать коллективную собранность в коллективах, где много людей: проявлять коллективное внимание к каждой мелочи нижних уровней разбиения систем, удерживать типы объектов для избегания ошибок. Компьютеры (в том числе и AI-системы, но необязательно) дают моделеры, удерживающие от утери коллективного внимания ко всему огромному целому на верхних его уровнях, заходящих в нижние уровни окружения. Это коллективное внимание будет удерживаться компьютерами также и на этих верхних, надсистемных уровнях окружения, а также по необходимости на всех уровнях систем и их окружения в графе создателей. Именно роль системного инженера (коротко говорим, опуская тип «роль» — «именно системный инженер») организует коллективное многоуровневое внимание к самым разным системам. «Системный» тут не случайно. Как всегда в случае системного подхода, это термин отсылает к безмасштабности и абстрактности внимания, в отличие от более узкого внимания прикладных инженеров к одной предметной области какого-то одного системного уровня для систем какого-то одного вида.
Разделение инженерного труда
Все рассуждения про роли и создателей (из многочисленных синонимов-с-нюансами вроде агентов/IPU/«ренормализованных нейронов»/«единиц эволюции»/«систем» выберем тут создателя, подчёркивая аспект изменения окружающего мира без собственного разрушения, термин из constructor theory, мы рассматривали это в руководствах по системному мышлению и методологии) как инженеров полностью применимы к системным инженерам. Причём для системных инженеров как создателей будет два вида прикладной конкретизации в порядке «определения этой роли в жизни»/заземления/grounding:
-
Конкретизация по линии масштабов и природы систем в каждом масштабе. Системный инженер обычно занимается несколькими масштабами системы/продукта в её окружении, где на разных масштабах системы оказываются разной природы. Скажем, полупроводниковые чипы — ими занимаются электронщики, в полупроводниковом чипе на уровень ниже — IP как какие-то логические блоки на логических схемах, ими занимаются проектировщики микросхем, ещё ниже — транзисторы, которыми уже занимаются физики и химики, в самолёте тоже — уровнем ниже там двигатели, которыми занимаются двигателисты, и салон, который рассматривают по линии эргономики и эстетики. Вот системный инженер размышляет, как это всё собрать вместе в работающее целое. Прикладные инженеры по конкретным системам чаще всего занимаются каким-то одним видом системы, одной предметной областью, хотя при этом они хорошо знают уровень выше (в системы которого надо встроиться со своей системой) и уровень ниже (из систем которого собирают свою систему). То есть системный инженер на первом шаге конкретизируется по природе его целевой системы, например, в инженера-робототехника (скажем, должность «ведущий робототехник»), врача (инженера человеческого организма, чаще всего с проектами «ремонт», а в случае паталогоанатома — «вывод из эксплуатации»), инженер предприятия (скажем, на должности «директор по развитию» или «менеджер проекта»), инженер общества (скажем, должность «депутат Госдумы»). Эта конкретизация требует, конечно, обучения особенностям каких-то конкретных систем, в приведённых примерах нужно хорошо разбираться с дисциплинами, объясняющими работу роботов, предприятий, общества, с методами их создания и развития. Если ограничиваться только общими знаниями по безмасштабной эволюционной системной инженерии (например, знанием наставлений нашего руководства) и ничего не знать про особенности целевой системы, то будет «хотели как лучше, а получили как всегда». Уже давно нет «врачей вообще», ровно так же, как и «инженеров вообще» (хотя сто лет назад были и просто врачи, и просто инженеры) а есть врачи по отдельным подсистемам человеческого организма: отоларинголог, уролог, стоматолог, клинический психолог или даже психиатр. Ещё есть варианты тоже по линии изменения состояния целевой системы (педиатры, патологоанатомы). Вот это деление врачей по их целевым системам, как ни странно, ровно такое же, как и инженеров по их видам систем и подсистем: например, специалисты по фюзеляжам самолёта или инженеры-двигателисты в авиапромышленности. Врачи — это тоже инженеры, они тоже меняют физический мир к лучшему!
-
Конкретизация по линии разных составляющих методов создания и развития одного и того же сорта систем —тут часто системными инженерами называют вполне прикладных архитекторов, занятых архитектурой системы в целом, а также инженеров внутренней платформы разработки (internal development platform), тоже вполне прикладных. Об архитекторах и инженерах внутренней платформы разработки тоже будут большие разделы руководства. Получается так, что «системным инженером» часто называют прикладного инженера, который занят увязыванием в одно целое работ многочисленных прикладных инженеров проекта. Это не случайно, ибо такой вроде бы прикладной инженер существенно задействует системное мышление. Интересно, что раньше сюда относили и инженера по требованиям — ибо требования вроде бы определяли всю систему в целом. Сейчас это не так, ибо сбор вместе всех требований оказался непродуктивным. Инженеры реализуют гипотезы по разным фичам/возможностям (в биологии это traits, признаки) системы, по возможности асинхронно друг от друга, это уже не требования, и согласования требований «всей пачкой» уже нет, об этом тоже будет рассказано. Деятельность методологов тоже не считается системной, ибо для разных фич/возможностей их функциональность обсуждается по-возможности независимо, а не совместно. Методологи поэтому «более прикладные» (хотя методология в целом, конечно, присутствует в мышлении всех инженеров — это же один из фундаментальных методов мышления в составе интеллект-стека).
У врачей тоже есть подобное разделение. Например, по типам методов вмешательства/«изготовления»: терапевт (неинвазивные вмешательства и сборка разных других видов вмешательств в работающее целое, «ввод в эксплуатацию»), хирург (инвазивные вмешательства), врач функциональной диагностики (нет вмешательства, только диагностика как часть проектирования будущего вмешательства). И тут обычно обязательно будет добавляться вид подсистемы системы (сердце, печень, мозг), ибо вид вмешательства/изготовления существенно может отличаться в зависимости от вида/природы системы. Так, хирург лет двести назад ещё не был ярко выраженной специализацией роли врача, а хирургия была просто одним из врачебных приёмов. Лет пятьдесят назад хирургия была уже отдельным методом в рамках врачебного разделения труда, а сейчас практически независимо практикуется нейрохирургия и кардиохирургия, да и в целом уже не встретишь «хирурга общего профиля», кроме самых захудалых сельских больниц. Конечно, на какой-нибудь подводной лодке можно встретить даже «врача» по всем вопросам, а в деревне «фельдшера» (даже не совсем врача, но тоже по всем вопросам), но это уже не типичная ситуация, не отражает «лучших известных на сегодня методов»/state-of-the-art (SoTA). В инженерных проектах по созданию киберфизических систем можно встретить инженера-электротехника, инженера-теплотехника, инженера-электронщика, но в маленьком стартапе на трёх человек можно встретить и просто «инженера», а исполнитель этой роли ещё будет прихватывать и другие роли — продавца, проектного менеджера и даже уборщика помещения. Так и в системной инженерии бывает «просто системный инженер», но сегодня чаще даже этот абстрактный метод изменения мира к лучшему разбивают на его составляющие — и для этих составляющих имеют разные роли. Вот эти роли106:
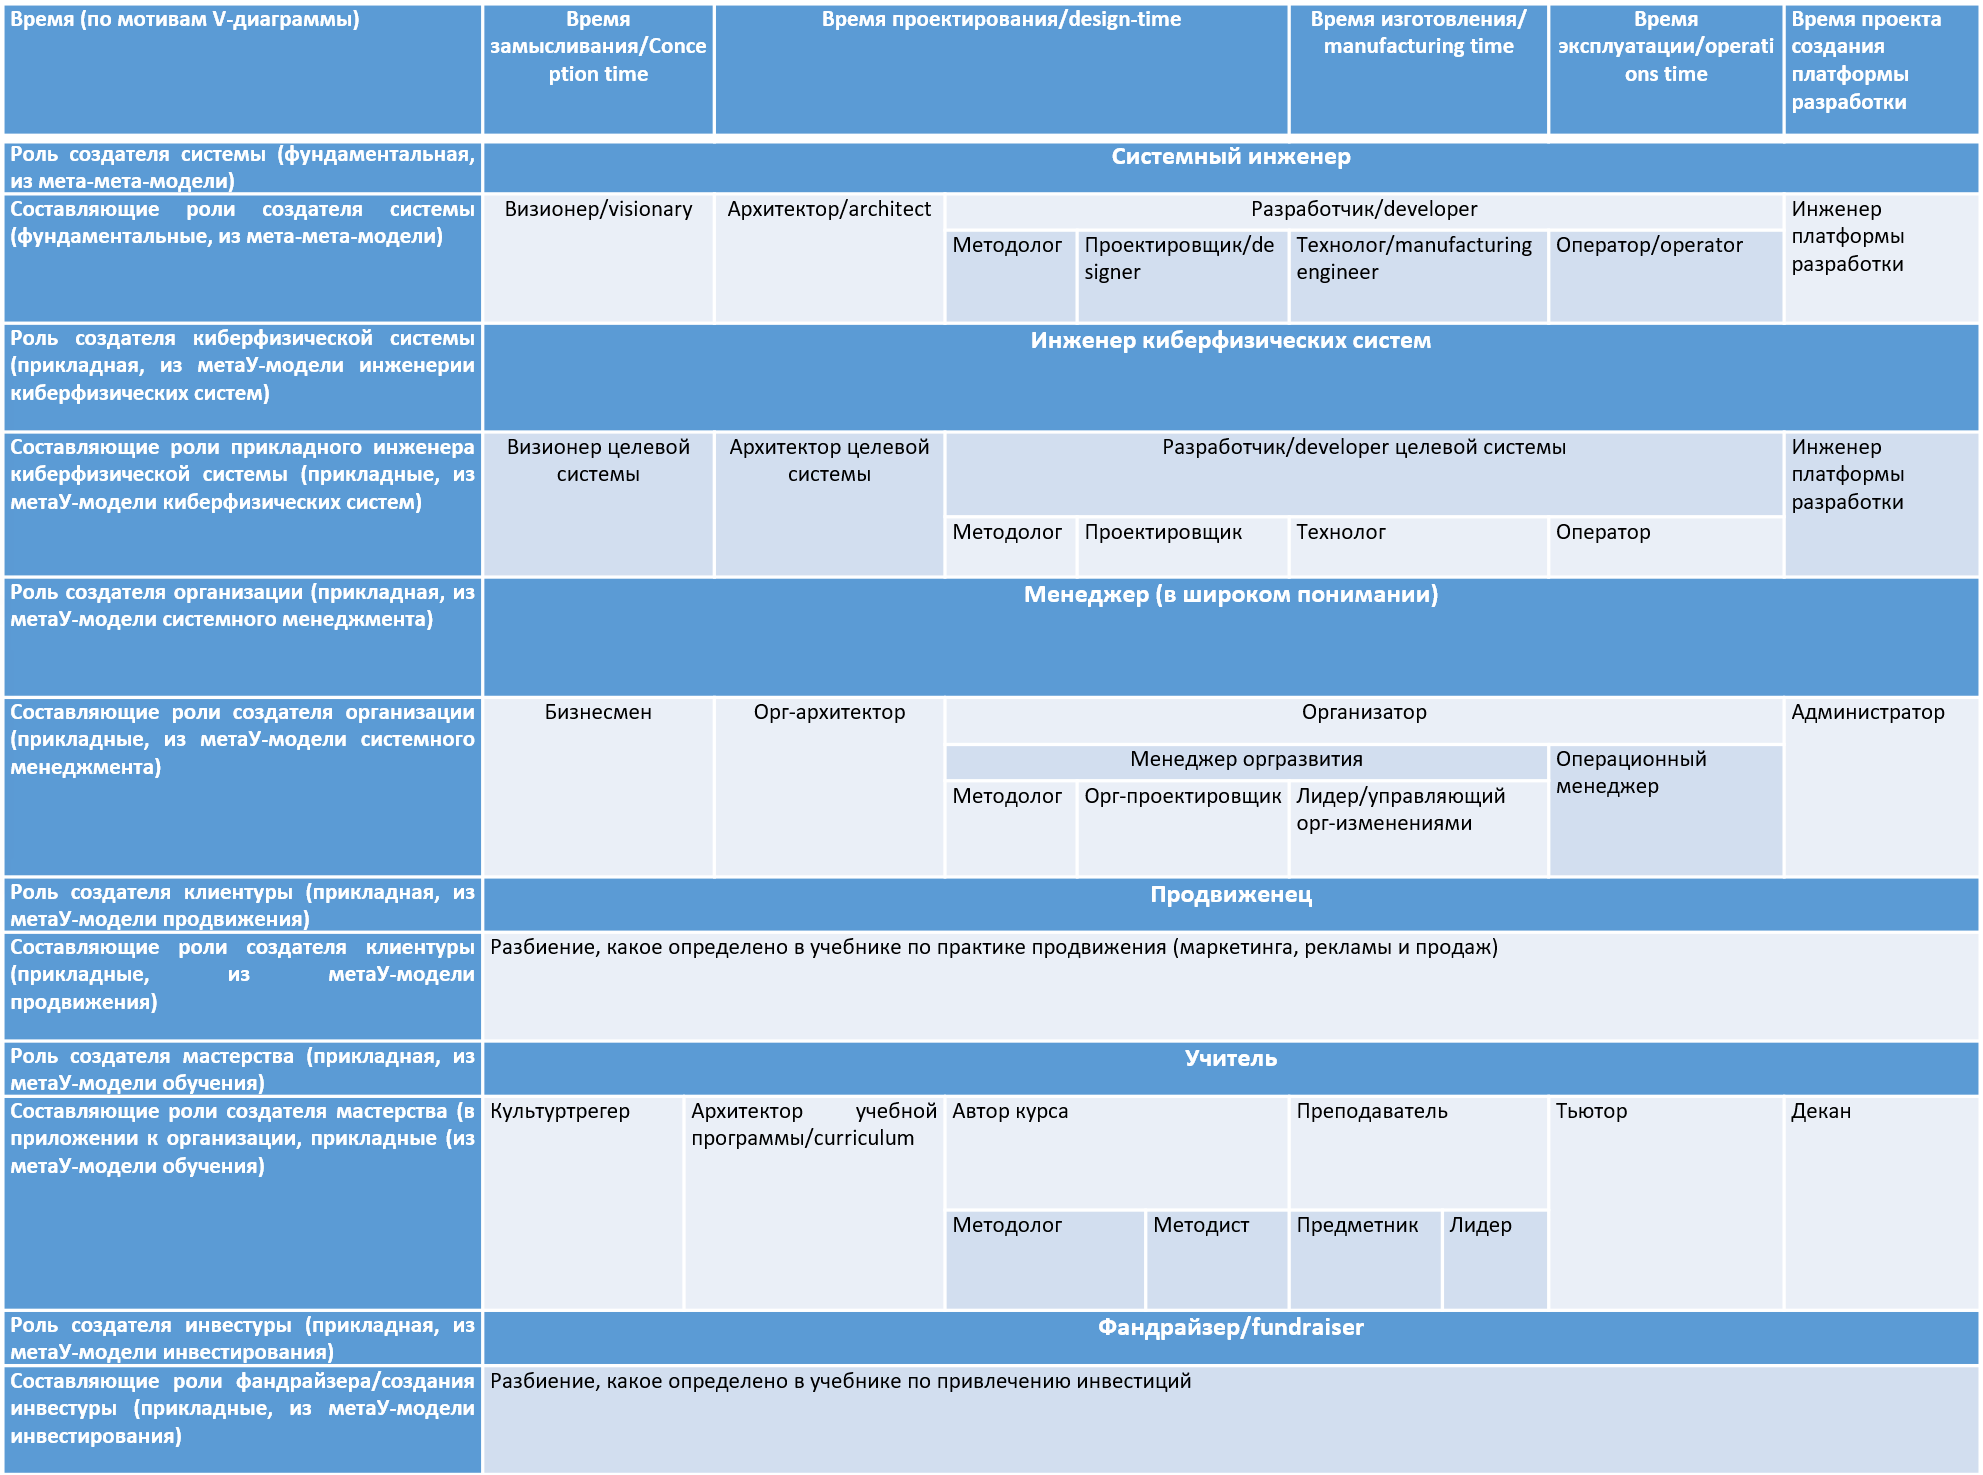
Тут хорошо видно, что роль системного инженера и составляющие этой роли — они фундаментальные, но вот прикладные роли для систем разной природы и составляющие этих ролей совпадают для киберфизических систем, но вот для систем другой природы названия существенно отличаются, хотя общая структура разделения труда остаётся.
Из руководства по методологии помним, что в случае методов работы плохо определяются части-целые (там функциональные описания, «функциональное программирование»), поэтому и для исполняющих эти методы ролей тоже трудно вводить иерархию частей-целых — хотя в системной инженерии часто делают упрощение и функциональные объекты-целые делят на части-подсистемы (функциональная декомпозиция), аналогично и роли-целые тоже делят на части-подроли, как и любые другие функциональные объекты, но это, конечно, упрощение. Поэтому мы сами иногда говорим «составляющие роли», а иногда — «подроли» (используя «под-» для указания не на специализацию или классификацию, но на композицию, «часть-целое», как в случае подсистемы).
Всё разнообразие прикладных ролей, которые получаются конкретизацией масштабов и видов/природы систем, а также составляющих их ролей, которые получаются конкретизацией методов создания и развития этих систем (то есть методов инженерии) будет выполняться какими-то создателями (агентами, обычно людьми и их организациями, но также и AI), имеющими должности или составляющими какие-то оргзвенья — функциональные объекты играются конструктивными объектами («наследующие» эволюционирующие/генеалогические/ролевые объекты играются устойчиво существующими экологическими объектами, мы в предыдущем разделе обсуждали биологические варианты функционального и конструктивного разбиений).
Не нужно думать, что «прикладной системный инженер» (мы говорили, что это прикладной инженер, который значительную часть времени озабочен удержанием целостности системы и её создателей, чаще всего это такие составляющие роли инженера, как архитектор и инженер платформы разработки) будет называться по должности именно так. Он может быть на должности «ведущий инженер», может называться «декан» в случае образовательных учреждений, может быть «координатором» в случае менеджеров крупного холдинга, смотреть нужно на содержание его работы, выполняемый им метод, оценивать процент времени, который он тратит на выполнение роли (или оценивать то, какую роль он выполняет прямо сейчас, по ситуации) — и уже дальше называть его роль по мета-мета-модели или по метаУ-модели. Обычно знание того, как роль называется в метаС-модели даёт не так много, надо таки «переводить на общий язык», чтобы разобраться. Думаем мы в терминах мета-мета-модели, метаУ-модели. Действуем и общаемся — в терминах метаС-модели, «по ситуации».
Чтобы сочетать самые разные составляющие роли самых разных инженеров, делают гибридные должности типа «продакт-менеджер» или сокращённо «продакт», который
-
выполняет роль визионера, ответственного за реализацию бизнес-модели проекта (грубо говоря, «чтобы проект деньги зарабатывал, а не проедал»), но также
-
выполняет роль операционного менеджера, принимающего решения по срокам развития систем (срокам разработки отдельных фич) и приоритетам работ по разным фичам.
Таких «гибридов» может быть множество. Так, регулярно совмещаются роли менеджерские и инженерные — в машиностроении часто начальник отдела не просто «менеджер, организующий работу инженеров», но ещё и методолог и архитектор, а также проектировщик систем, которые разрабатываются инженерами отделов — то есть принимает не только менеджерские, но и технические решения. А какой-нибудь технический директор кроме принятия решений по методам разработки (работа методолога) вполне может составлять планы работ по своим проектам (работа операционного менеджера).
Помним, что ни по поводу гибридных названий должностей, ни по поводу наименований типовых составляющих ролей инженера, менеджера, учителя, продвиженца и т.д. консенсуса нет, каждое сообщество имеет тут свои традиции. В разных организациях и разных предметных областях даже привычные наименования должностей и ролей означают совершенно разное. TeamLead в веб-разработке и где-нибудь в лесотехническом машиностроении может означать очень разные обязанности, ещё и существенно зависящие от страны и организации, а также от года, в котором ведётся обсуждение: в прикладных видах инженерии, включая инженерию предприятия всё стремительно меняется, включая «модные» и «локально правильные» названия типовых должностей. А ещё TeamLead — это должность (не роль!) «начальника», и мы помним, что заниматься на этой должности приходится чем угодно, роли начальника могут быть любыми, начальственные должности — это «джокеры» в смысле ролей. Конечно, начальники (по должности!) могут выполнять и роли инженеров организации-создателя (менеджеров), и прикладных инженеров каких-то создаваемых систем: киберфизических систем, мастерства, клиентуры и т.д.
Позиция единства инженерного взгляда как минимум на инженерию и менеджмент уже давно признаётся системными инженерами киберфизических систем (иногда их называют «классическими системными инженерами»). Вот в журнале «Project Performance Engineering Systems Engineering News» в апреле 2022 это даётся на седьмой странице обведённым в рамочку107, чтобы классические системные инженеры об этом не забывали:
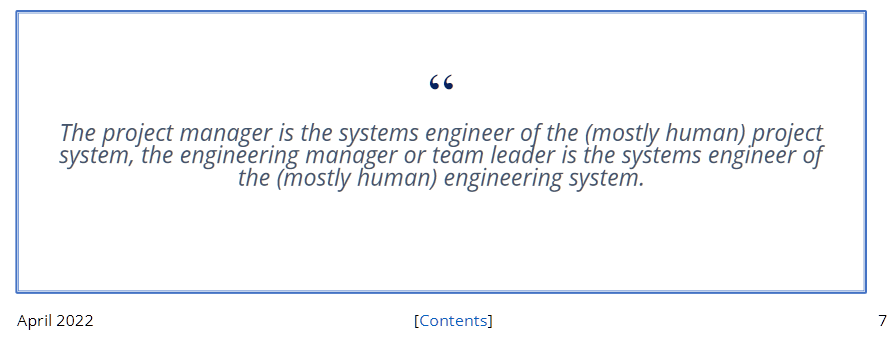
Человек на должности инженера может сутки напролёт играть роль менеджера, планируя работы, и наоборот, человек на должности менеджера может сутки напролёт разбираться в инженерных задачах. Элон Маск сообщает о себе, что 70% времени занят решением инженерных задач «по железу», то есть играет роль инженера киберфизических систем. Элон Маск — считается прежде всего менеджером, бизнесменом (он ведь CEO и в Tesla, и в SpaceX), но роль менеджера он исполняет меньше времени, чем роль инженера «по железу»! Да и эти 30% менеджмента оказываются инженерией — инженерией предприятий, то есть инженерией систем из всевозможных графов создателей.
Если вы понимаете, как устроена инженерия на самом высоком уровне абстракции (наше руководство как раз про это), вам будет легче разобраться в неизбежном разнообразии видов труда по созданию систем самой разной природы. Оказывается, все виды деятельности по созданию чего бы то ни было, а также созданию создателей этого «чего бы то ни было» в их длинном и запутанном графе, если брать их в более-менее SoTA (а не любом!) варианте, выдержавшем эволюционный отбор, похожи друг на друга: это просто варианты безмасштабной эволюционной/непрерывной системной инженерии, которую вы проходите в нашем руководстве. Те же объекты внимания, те же операции с ними, хотя конкретизированные и по-разному называемые. Это просто разные виды одного рода, у них «фамильное сходство»!
Вовсе не факт, что вы в жизни будете встречаться с классическими «железными» проектами инженерных систем или даже не такими классическими проектами программной инженерии. Но если вам встретится в жизни какой-нибудь детский садик Монтессори или организация выборов в какой-то профессиональной ассоциации или даже муниципалитете, вы сможете разобраться быстрее, если будете понимать, что это тоже проекты по изменению мира, то есть это тоже инженерные проекты. Методы работы, которые вы будете выполнять в этих «неинженерных» проектах — это инженерные методы работы, а не какие-то особые экзотические уникальные методы, которые дано понять только посвящённым людям. Даже если будет казаться, что проект состоит только из методов по описанию мира (реверс-инженерия уже существующей в мире системы в её окружении, или даже будущей системы, которую только потом нужно изготовить), а не изменению, это будет просто часть какого-то проекта по изменению мира, то есть часть какого-то инженерного проекта. В любом случае, вы сможете задать правильные вопросы к проекту, разобраться в происходящем.
Все сегодняшние проекты по изменению мира к лучшему различаются и по их форме, и по их содержанию, но одновременно и все проекты оказываются в чём-то одинаковыми: они являются разными вариантами инженерных проектов, проектами по созданию (часто не с нуля, но это дела не меняет) успешных систем. Если оказалось, что речь идёт не о проектах по изменению мира к лучшему (то есть не об инженерных работах), то такие проекты выполнять не нужно.
Скажем, инженерная ли работа, в которой я поднимаю штангу по вечерам? Да, это проект инженерии себя. Можно пообсуждать, как распределены инженерные роли между мной, врачом, тренером, диетологом и внешними проектными ролями — включая внешние проектные роли тех, кто воспользуется результатами этого инженерного проекта, в число этих людей можете попасть не только вы, но и члены вашей семьи, а если ваша работа связана с физической культурой, то и рабочее окружение. Если вы художник, или политик, или музыкант, то тоже полезно задумываться, что вы меняете в окружающем мире, и происходят ли эти изменения к лучшему. Никакие названия должностей, ролей (и связанные обычно с названиями ролей названия профессий и квалификации), названия методов и «исторически сложившиеся традиции» не должны препятствовать такому инженерному взгляду на мир.
Конечно, надо учитывать ещё и процесс эволюционного углубления разделения труда. Появляются всё новые и новые способы изменить мир к лучшему — инженеры придумывают всё новые и новые способы удовлетворять интересы, которых раньше и не было, это и есть эволюция. А разделение труда — это когда разные создатели/агенты исполняют разные составляющие какой-то роли, исполняемой ранее одним создателем.
Так, у неандертальцев не было интереса к мастерству системной инженерии, да и самой системной инженерии ещё не было. По мере развития человеческой цивилизации появилась «просто инженерия», потом в середине прошлого века вместе с появлением системного мышления первого поколения появилась системная инженерия, в конце 20 и начале 21 века она сосредоточилась на киберфизических системах («классическая системная инженерия»), а в последний десяток лет оказалось, что речь идёт об огромном разнообразии прикладных инженерных методов для систем самых разных масштабов и самой разной природы. Развилась методология, которая стала изучать разные виды инженерных процессов (процессов разработки, методов создания и развития систем) и стало очевидно, что все эти методы изменения мира к лучшему чем-то похожи (как минимум, все они нужны для создания и развития каких-то систем разной природы), но в чём-то и радикально непохожи (мастерству учат, а вот сталь — выплавляют).
Общие черты для их методов работы нашли и у «железных» инженеров, и у программных инженеров, и у врачей, и у деятелей искусства. Например, везде идёт углубление разделения труда — в коллективном труде участвуют создатели с самой разной специализацией. Достаточно посмотреть на титры какого-то кинофильма, чтобы оценить масштаб разделения труда в киноискусстве. Конечно, при создании «железных» систем разделение труда не меньше, просто не принято так подробно выписывать участников инженерной работы, как это принято в кинопроизводстве, «титры инженерного проекта» не встретишь.
Так что число инженерных методов и связанных с ними инженерных ролей будет продолжать непрерывно расти, но можно смело опустить слово «инженерных»: число методов (инженерных, то есть изменения мира) и связанных с ними ролей будет продолжать расти. Можно смело считать, что лучшим современным (SoTA) методом изменения мира к лучшему является системная инженерия, а все прикладные варианты инженерии являются или конкретизацией системной инженерии для какого-то сорта систем (скажем, селекция и производство коров как для производства молока, так и для производства мяса в политической оппозиции веганам — и в этой части это будет социальная инженерия), или приложением составляющих методов системной инженерии к каким-то системам (например, приложение методов архитектурной работы для систем AI, приложение методов создания внутренней платформы разработки для мастерства).
Системная инженерия в основе сотрудничества
Напомним, что в руководстве по методологии крайне упрощённо обсуждались степени взаимодействия агентов/создателей в организации108:
-
Игнорирование (ignorance) того, что делают другие агенты, можем даже нанести им вред. При этом иногда заявляют «ничего личного, это бизнес» — и что самое интересное, и заявитель такого верит, что это отличное оправдание, и даже те, кому вредят, вроде как «понимают мотивы». А поскольку игнорируем, то никакого общения, делами других не интересуемся, свои дела никому не показываем.
-
Информирование и общение (networking): готовы общаться, но не готовы ничего менять в своих планах и действиях. Если кто-то готов подстроиться под нас, то и хорошо. Но сами работаем, как работаем. Скажем, вывешиваем часы своей работы — но не готовы их менять даже когда кому-то очень надо.
-
Координация (coordinated networking): готовы поменять какие-то свои планы и действия. Например, поглядеть на часы работы соседа и прийти в его рабочие часы. Заполнить форму, какую от меня требуют в той системе, в которой требуют, а не написать заявку в произвольном формате и отослать личным письмом.
-
Кооперация (cooperation): участвуем в разделении труда и ресурсов, то есть договариваемся о том, как взаимодействуем на входных и выходных интерфейсах, согласовываем всё с соседями. При этом ответственность за то, что всё в целом будет как надо, у участников кооперации отсутствует. Если пиджачок сшит криво, и он ко мне попал на пришивание пуговиц, то я пришью пуговицы крепко, зубами не оторвёшь: к пуговицам точно претензий не будет, а что пиджачок в итоге кривой — не моя забота. Все рабочие процессы работают как часики, инженерный процесс в целом — не факт, что вообще работает.
-
Сотрудничество (collaboration): делёжка не только трудом и ресурсами, но и ответственностью за общий результат всех участников работы. Но это труднодостигаемо, ибо требует удержания у каждого участника понимания не только его собственных операций, но и их влияния на результаты в целом (по факту — требует системного мышления от участников кооперации, удерживания внимания на довольно длинных цепочках рассуждений о причинах и следствиях).
Сотрудничество не появляется само собой, оно требует, чтобы участники работы имели представление и об общем результате работы (целевой системе, а не только «своей системе», ибо «наша система» какой-то одной инженерной команды — это часто не «общий результат работы»), и об организации работы создателей в их графе — как разделены работы по создателям, как разделён по создателям труд (составляющие инженерного процесса, методы работы). Если мы хотим, чтобы участники проекта сотрудничали, они часть времени должны думать о результате своих работ в целом и организации работ в целом — то есть они должны выполнять роль системного инженера, задействовать системноинженерное мышление.
Системные инженеры-генералисты в отличие от инженеров по более узким инженерным специальностям должны технически направлять инженерные коллективы, так прописано в документах системных инженеров для киберфизических систем (скажем, в systems engineering body of knowledge109). При этом помним, что по факту в документах инженеров киберфизических систем речь идёт о прикладных инженерах по конкретным видам систем, которые заняты целостностью целевой системы и инженерным процессом, а обсуждение чаще идёт не про роль, а про людей на этой роли.
Понятие технического лидерства (technical leadership, отличается от организационного лидерства, organizational leadership) означает помощь в организации коллективной мыслительной работы по отношению к той или иной технической идее: все участники проекта должны делать одну и ту же систему, а не разные. Отличия технических лидеров от «технических евангелистов»:
-
технические евангелисты — это проповедники чужих идей на предмет их воплощения в самых разных проектах инженерной компании или даже отрасли,
-
технические лидеры — сами себе «технические иисусы христы» в отдельных конкретных проектах, они сами поставщики тех технических решений, в которых потом они должны уметь убедить других людей в их конкретном проекте.
Создатели в роли системных инженеров должны брать на себя ответственность за целостность системы, а не просто думать об этой целостности. Системные инженеры не просто берут идеи от одних инженеров, а потом убеждают других инженеров их принять. Системные инженеры генерируют технические идеи самостоятельно. Как мы уже говорили, среди прикладных инженеров системными инженерами чаще всего называют архитекторов и инженеров внутренней платформы разработки, берущих часто на себя ещё и функции организаторов процесса непрерывной разработки. Поэтому у системных инженеров чаще всего это архитектурные идеи и идеи организации непрерывного выпуска. Системные инженеры встают в отношение менторства по отношению к инженерам-разработчикам. Они принимают решения, разъясняют их инженерам-разработчикам и добиваются их понимания — это менторство. Но затем там отношение надзора, governance (не путать с управлением, management): менеджер поручает работы/works, а надзирающий не может дать такого поручения, но он отслеживает выполнение метода — в том числе соблюдение принятых архитектурных решений и принятых решений по организации инженерного процесса. Техническое лидерство состоит в убедительном менторстве по поводу принимаемых решений, а затем эффективном надзоре за выполнением технических решений. Если прикладным инженерам трудно работать согласно принятым решениям, то их дополнительно менторят. Но если уж совсем не умеют работать, или упёрлись в своём упрямстве и саботируют принятые технические решения — их увольняют без сожаления, хорошо проекту не будет.
В принципе, этот же подход применим и для всех остальных прикладных инженеров, а не только инженеров киберфизических систем или программных инженеров: они кроме сугубо технических составляющих своих ролей ещё и заняты общением с другими инженерами и менеджерами, и вот тут должны проявлять мастерство технического лидерства, мастерство убеждения людей в тех или иных технических решениях, которые они принимают.
Врачи как инженеры уровня существа (а с учётом клинической психологии и уровня личности) тоже должны быть «медицинскими лидерами» во врачебных коллективах с коллегами — особенно в тот момент, когда они заняты пациентом в целом, то есть будут «системным инженером». Каждый врач может быть таким «системным инженером», ибо проходил в вузе специальность «врачебное дело». Скажем, терапевты обычно занимаются медикаментозным лечением внутренних органов — каждый по своей специальности, например, пульмонолог занимается лечением лёгких. Но они вполне могут взять ответственность за деление врачебного труда (например, направить пациента к хирургу, или на ЛФК), обеспечат «врачебное лидерство», направляя общий ход лечения больного, который посещает множество других врачей и получает множество других процедур, и ещё инструктируют самого больного, убеждая его выполнять врачебные рекомендации.
Политики тоже могут заниматься «политикой по всем вопросам», у них тогда в составе их роли составляющая роль «политического лидера» в политических коллективах (партиях), аналогичная составляющей роли «технического лидера» у системного инженера: они занимаются тем, что пропагандируют идеи какой-то общественной культуры (методов поведения в обществе), какие-то «технические решения» по поводу устройства общества.
Организационные лидеры заняты немного другим делом: они помогают людям занять свои роли в организации и катализируют сотрудничество в выполнении методов работы этих ролей, делают организацию (одного из создателей в графе создания) целостной. В какой-то мере организационные лидеры заняты тем же, что и технические лидеры, которые делают целевую систему целостной — но у них главный аспект организационный, а не просто какие-то технические решения. И они тут больше «евангелисты»: идеи самой организации они получают от роли орг-проектировщиков, которые проектируют организацию на основе идей методологов и орг-архитекторов. Технические же лидеры сами по себе вырабатывают уместные в данной ситуации технические идеи (в том числе, например, орг-архитекторы тоже вполне себе технические лидеры по линии инженерии организации).
Лидеры сообществ занимают промежуточное положение между техническими и организационными лидерами: с одной стороны, они чаще всего технические лидеры, ибо в сообществах нельзя сказать, что речь идёт о многочисленных ролях и каком-то «сотрудничестве» по достижению результата. Но если приглядеться, то жизнь сообществ состоит в том числе и из многочисленных мероприятий, активными участниками которых являются лидеры сообществ — и вот в момент вовлечения членов сообщества в дела сообщества, то есть в мероприятия, проводимые с участием членов сообщества, эти лидеры сообществ заняты тем, что помогают членам сообщества занять какие-то организационные роли в проведении мероприятия (в том числе и организации, и «просто участии») и катализируют сотрудничество в рамках этого мероприятия. Как относиться к мероприятию не как к процессу, а как к организации с ограниченным сроком существования, было рассказано в «Системном мышлении».
В давней (это статья 2009 года. Помним, что первый iPhone появился в 2007 году. В инженерии 2009 год — это очень давно! Всё в инженерии происходит быстро, и не только в железной инженерии) статье «Наука и искусство системной инженерии»110, отражающей опыт космической системной инженерии NASA, приводится сравнение системного инженера со специально обученным и талантливым дирижёром симфонического оркестра, который творит Симфонию. Системный инженер, как дирижёр, налаживает работу «симфонического оркестра» из многих инженеров-разработчиков, и даже часто не отдельных людей-разработчиков, а целых команд разработчиков. Это одновременно и правда, и неправда. Правда в том, что системные инженеры — это технические лидеры. Неправда в том, что системный инженер — это один человек, «рулящий» огромными коллективами других инженеров. Это не человек, это роль — а роль может исполняться и одним человеком, причём необязательно full time, но может исполняться и целым коллективом. Всё зависит от масштаба проекта, от принятых в проекте технических и организационных решений, от таланта работников (включая «талант» AI-систем).
Как в инженерии произошло разделение на инженеров по специальности (механиков, электриков, программистов, теплотехников и т.д.), как в западной медицине произошло разделение врачей по разным врачебным специальностям, и врачи редко работают поодиночке, так подобное углубление111 разделения труда уже произошло и в самой классической системной инженерии как прикладной инженерии киберфизических систем, и во многих других видах труда — менеджерском труде (операционный менеджер не всегда архитектор организации, это разные специализации), учительском труде (в начальной школе всему учит один преподаватель, а в средней — уже нет, да и учебники преподаватели не пишут, а ведь подготовка учебников — это тоже часть учительского труда).
Инженеров разной специализации может быть в одном проекте целая команда, которая делится, как мы помним
-
и по видам подсистем (у самолётов это могут быть двигателисты, у промышленного холдинга — менеджеры завода. Подсистемы тоже имеют свою целостность и имеют свою природу, они будут требовать «системной инженерии», например, архитектурной проработки и какой-то организации инженерного процесса на основе внутренней платформы разработки),
-
и по методам работы (прежде всего это деление на разработчиков, включая занимающихся функциональностью системы в целом, архитекторов, отвечающих за архитектурные характеристики, инженеров внутренней платформы разработки, отвечающих за минимизацию времени ввода в эксплуатацию каждого инкремента системы, который сделали разработчики и инструментализацию непрерывности/эволюционности в инженерии).
Вспомните ситуацию начала времён WWW (это сейчас говорят просто «интернет»), когда появилась и начала бурно развиваться профессия веб-мастера в середине 90х прошлого века. Трудно уже вспомнить, но всего тридцать лет назад был один человек, который занимался для вебсайтов всем: программировал «программный движок» (web framework), разрабатывал арт-дизайн, пришивал его к движку, наполнял вебсайт материалом, продвигал его в Сети и т.д. Один человек, который совмещал в себе всё разнообразие прикладной инженерии для сайтостроения. Сейчас «вебмастера» уже нет, а есть отдельно программисты фронт-энда и бэк-энда, дизайнеры, тимлиды, инженеры внутренней платформы разработки (иногда их ещё по-старинке называют DevOps), редакторы (в вариантах editor и content manager, причём второго уже и редактором не называют, а раньше называли), администраторы, модераторы, специалисты по пользовательским интерфейсам и по пользовательским впечатлениям (раньше их не различали, теперь даже пишут UI/UX), SEO (search engine optimization), уже давно появившиеся спецы по SMM (social media marketing), и это ещё не полный список (вы заметили, что в этом списке не хватает методолога, не хватает архитектора? Они обязательно должны быть, просто часто их роли выполняют какие-то другие инженеры, эта работа делается — но неявно, никем не замечаемая, маркируется обычно как «важные решения опытных разработчиков»). Это всё разные роли, которые мог бы выполнять и один человек, особенно если он пользуется поддержкой AI.
По факту же для всех этих ролей вводятся отдельные должности, на которых работают разные люди — это и есть разделение труда в веб-разработке. Добавка AI в инструментарий ведёт к резким изменениям в разделении труда — но какое в будет (не итоговое, а постоянно меняющееся!) разделение каких новых инженерных ролей по людям и их AI-инструментарию, пока сказать нельзя. В любом случае это не «вот тут был рабочий, его заменил робот» в рамках одного завода, а «вот тут был рабочий одного завода, его заменило две сотни человек другого завода, которые делали робота, плюс на заводе с заменённым рабочим появились наладчики роботов».
Разложение новых методов работы, когда они становятся массовыми, практически неизбежно приводит к тому, что знания/теории/модели составляющих этих методов становятся обширными, требуют добавочного времени для достижения мастерства в их SoTA, и это приводит к раздроблению итогового труда по разным его видам у разных создателей. Для объединения всего разложенного по составляющим и сдвинутого на разных людей труда используются различные кибер-методы обеспечения коллективной собранности, например, чеклисты (сегодня практически повсеместно компьютерные, а не бумажные). Поэтому отличным учебником по разделению труда может выступать книга Atul Gawande «The Checklist Manifesto. How to Get Things Right»112, это обязательная литература для изучения инженерами-менеджерами в программе рабочего развития. Мало разделить какой-то вид инженерного процесса по людям, надо потом уметь его собрать в непротиворечивое целое — чеклисты как раз помогают это делать.
Один человек, даже если он гений, не в состоянии удержать целостность в современных сложных проектах: целостность удерживается в современном мире только командно и уж точно не людьми, а хорошо налаженными компьютерными моделями, которые точно не забудут ни одной детали, ни одной строчки ни одного документа. То же самое относится к информационным системам и AI-системам: их потребуется множество, и нужны будут средства интеграции их работы в одно непротиворечивое целое. Универсальности не бывает, даже современные AI-системы приходится специализировать.
От играющих самые разные роли и поэтому имеющих самые разные интересы людей, AI-систем и даже больших организаций из людей и AI-систем с их коллективной памятью, поддержанной базами данных, в инженерном проекте требуются две вещи:
-
Согласовывать свои решения. Не договорились — не делаем! Если делаем ракету, то нужно договориться, сколько у неё ступеней — две или три. Если делаем рыбу (марикультура или проект генной инженерии), то нужно договориться, какой она должна вырастать длины. Если делаем общество (политический проект), то нужно договориться, какое именно общество. При этом договариваться нужно не только со своей командой и для ракеты, и для рыбы, и для общества: не забываем о внешних проектных ролях! Нам нужны успешные системы, а не какие-то неуспешные системы, о которых мы договорились в своей инженерной команде. Следствие: хорошо бы разделить проблемы так, чтобы нужно было поменьше согласовывать решения (например, диаметр болтиков на плате и цвет корпуса прибора можно не согласовывать между собой, эти решения могут принимать разные команды разработчиков независимо, но если болтиком занимаются две команды, то их решения придётся между собой согласовывать). Этим занимаются инженеры-архитекторы, архитектурная работа ставит своей непосредственной задачей оптимизацию (прежде всего — минимизацию) зависимостей между модулями. И архитектурная работа тоже в текущем её виде появилась в порядке углубления разделения труда, она нужна, чтобы сделать это разделение труда ещё более глубоким.
-
Дисциплина всё записывать/учитывать: договорились и делаем — записать, о чём договорились, что делаем, что сделали, чем обосновывали. Не записали — это не договорились, так что — не делаем! Памяти не верим, верим записям, нужна не «ментальная собранность», нужна киберсобранность. Современная инженерия без компьютеров не делается! Внимание людей к деталям проекта и целокупности проекта поддерживается компьютерами! И личная собранность, и организационная/командная/коллективная собранность сегодня держится не на биологической памяти, а на компьютерной памяти! Голыми руками и голым мозгом не работаем, используем инструменты! И даже если речь идёт о выполнении работы компьютерами, то тоже всё записываем — ведём компьютерные журналы, logs113. То, что «все ходы записаны» и легко разобраться в ситуации, за это отвечают инженеры внутренней платформы разработки (управление версионированием и конфигурацией у них).
Есть ли «системный инженер» в сайтостроительстве как отдельная должность? Нет, должности для этой роли не называют, должности чаще всего называют для букета ролей прикладной инженерии и менеджмента. Помним, что «системный инженер» — это когда любой создатель вдруг занимается проектом (деятельностью графа создателей) и его системой как целым, то есть практикует фундаментальный метод мышления по мета-мета-модели из нашего руководства, а ещё это профессионализация прикладного инженера на составляющих метода его работы, нацеленных тоже на целостность системы и её проекта, чаще всего это связывают с архитекторами и инженерами внутренней платформы разработки, которые так и будут называться в инженерии киберфизических систем, но в предприятии это архитекторы предприятия и администрация, в обучении это архитекторы учебных программ и деканат. В любом случае, «системный инженер» в названии должностей проявляется редко.
Но вернёмся к сайтостроительству: есть ли метод работы «системная инженерия» в сайтостроительстве? Безусловно, есть: это и обсуждение веб-сайта как целого (создание концепции использования), и метода создания архитектуры веб-сайта, и метода технического и организационного лидерства как поддержки совместного технического творчества инженеров как в технической части, так и в организации труда этих инженеров, и методов организации и инструментальной поддержки инженерного процесса непрерывной разработки вебсайта, то есть создания внутренней платформы разработки (иногда это по-старинке называют DevOps).
Вспомним ещё раз сравнение по факту несуществующей должности «системный инженер» с должностью дирижёра симфонического оркестра, которое приводилось в статье NASA (и не будем тут даже обсуждать, что NASA представляет тут крайне медленную и неэффективную системную инженерию — что не было видно, пока не появилась быстрая и эффективная системная инженерия в компаниях типа SpaceX или Relativity Space). Это сравнение системного инженера с дирижёром можно прокритиковать и с другой стороны. Метафора симфонического оркестра соответствует административной модели управления, «писанной музыке», и чуть ли не «руководству» как буквально «руками водству». Может возникнуть впечатление, что системный инженер — это человек с должностными полномочиями командовать какими-то «несистемными» инженерами, то есть прикладными инженерами-разработчиками разных специализаций, которые слыхом не слыхали о системных уровнях, архитектуре и непрерывном вводе в эксплуатацию. Вроде как это такой «дирижёр», который прямо диктует музыкантам, когда и какую ноту играть каждому, как это происходит иногда в симфонических оркестрах с авторитарным дирижёром, заботящимся о каждой ноте, чтобы она соответствовала именно его дирижёрскому замыслу, или его пониманию замысла автора. И да, раньше и в инженерии (помните Туполева, Королёва, Мессершмита?), и в политике (вождизм — это как раз от этого, несменяемые цари-диктаторы как раз таковы) так и было. Но ведь ещё в прошлом, XX веке музыка по факту пошла другими путями:
-
в симфонической музыке за счёт компьютерной поддержки композитора оказались выкинутыми и дирижёр, и его оркестр, а «симфонические» фонограммы к современным фильмам и играм готовятся самим композитором буквально в одиночку — но на компьютере. Компьютер настолько увеличивает возможности одного человека, у которого есть в голове полный замысел, что других людей можно смело выкинуть из процесса. Музыка оказалась несложной, умещается в одной голове, если ей помогает компьютер. Симфонический оркестр с нотной записью партитуры для каждого музыканта и дирижёром по факту оказался не нужен. В мире также добавились люди, которые умеют делать компьютеры, которые помогают в музыке, труд перераспределился, стал более эффективным. В 21 веке вообще оказывается не нужным человек-профессионал, пользующийся компьютером, ибо музыкальный AI делает сложную музыку «под ключ» по индивидуальным заказам. Музыкальный завод-автомат, включая не только изготовление, но и проектирование, и даже замысел музыкальных треков. Труд опять перераспределился.
-
в музыкальной мейнстримной живой культуре сегодня преобладает джаз, подразумевающий совсем другие принципы коллективного творчества: импровизация плюс взаимоподстраивание (рок — это развитие того же джаза, ибо в рок-группах никакого «дирижёра», а вместо «нот» используется звукозапись).
-
симфонические оркестры остались как очень дорогое средство антикварного хранения традиции, и от них никакого развития музыки не ожидается. Эпоха великих композиторов и великих дирижёров окончилась. Развитие музыки и музицирования идёт, при этом идёт достаточно бурно, но в совершенно других формах. Например, дети массово заканчивают сегодня не столько музыкальную школу, сколько школу диджеинга — и там игра идёт не отдельными нотами, а более крупными блоками (сэмплами, треками), и на выходе не только «треки», но и отдельные «сеты» (аналоги альбомов звукозаписи или концертных программ в живой музыке). И даже это ещё не конец истории, ибо ещё непонятно влияние AI-музыкантов как на массовое потребление музыки в качестве muzak (фоновое прослушивание в ходе еды или работы), так и массовое потребление заказной музыки (написать песню ко дню рождения друга, написать песню к рекламе).
Эволюция беспощадна даже к самому углублению разделения труда: нельзя считать, что оно однонаправленно, нельзя считать, что разделённый труд продолжает существовать долго, и даже сравнения одних видов труда с другими не выдерживают испытания временем.
Если посмотреть на то, что происходит в инженерии (в том числе и программной, и «железной», и инженерии организации, и врачевании, и социальной инженерии как политике, и любых других видов инженерии), то тренд к «джазовой» организации деятельности несомненен. Все движение agile — это движение именно в эту сторону «джазовости» как импровизационности и согласованию деятельности «на лету», эволюции/развитию как системы, так и создателей системы с их методами работы и тем самым занимаемыми ими ролями.
Эта эволюционность, непрерывное развитие (необязательно при этом всегда «прогресс», помним про динамический ландшафт приспособленности — это может быть легко «развитие в эволюционный тупик») и понимается как «гибкость», непредзаданность последовательности шагов, уменьшение размера планируемой заранее работы по принципу small batch size114 и с возможностью небольших изменений для каждой партии/batch, введение в эксплуатацию (delivering) не всей долго разрабатываемой системы с тысячей функций одним шагом (и этот шаг с подписанием акта приёмки-сдачи будет последним шагом проекта), а непрерывно инкрементами, функция за функцией. Как ни странно, такой «постепенный» подход заодно улучшает скоростные характеристики разработки за счёт того, что раньше получается отклик от задействования целевой системы в её окружении и поэтому раньше исправляются ошибки, меньше тратится времени на проработку заведомо неудачных идей.
Все остальные примеры новинок в организационных дисциплинах (например, переход от акцента на централизованном administration/management к shared leadership, предложение «распределённых финансов» на блокчейн-технологиях в обычно централизованной финансовой инженерии) тоже идут именно в эту сторону отсутствия «единоличного лица, принимающего все ответственные решения, потому как имеющего огромные знания по всем методам работы, по которым приходится принимать решения». Вот это «все решения, потому как имею максимальное знание» попросту неверно, никакой эффект «согласования самых разных решений, принятых подчинёнными» эту неверность не убирает, потому как нет в том числе и знаний, которые позволяют согласовать несовместимые решения — просто будет неизвестно, что там ошибка, знаний не хватит всё согласовать. А ещё это крайне медленно, централизованное принятие всех решений.
Ситуация, при которой все главные решения принимаются одним лицом, которое всеми «дирижирует», опасна. «Дирижёр всего» потенциально создаёт угрозу появления в проекте «бутылочного горлышка», существенно замедляющего принятие инженерных решений. Решений много, «дирижёр всего» — один, все решения он не то что скоординировать — он просто познакомиться с ними для утверждения не успеет толком, даже если ему будут предлагать эти решения, да ещё и по три варианта каждого решения! Но главное тут даже не в замедлении работы: одному человеку иметь образование и опыт во всех дисциплинах, в которых принимаются важнейшие решения по проекту невозможно: гений в одних вопросах вполне закономерно может быть полным идиотом в других вопросах. Метафора «великого вождя» в системной инженерии не соответствует духу времени.
Приведём только один из примеров: в одном из машиностроительных холдингов обсуждалось, что инженеры перестали быть инженерами (принимающими решения по изменению физического мира!), а стали «аналитиками» (которые максимум «дают советы», но сами решения не принимают), сохранив за собой должности инженеров. Это проявлялось в том, что инженеры «готовили предложения», которые должны были затем утверждаться их начальниками — а те тоже затем «готовили предложения», которые затем должны были утверждаться их начальниками. Никто не брал на себя ответственность выпустить/release какой-то технический артефакт, принять обязательное к исполнению другими инженерами и менеджерами решение в своей зоне ответственности (да и не было архитектора, который нарезал бы систему и проект на такие зоны ответственности). Поэтому все суточные результаты работы инженеров скапливались к вечеру в почтовом ящике у технического директора — и он вынужден был утверждать не глядя порядка двухсот документов. Изменение корпоративной культуры, когда каждый инженер перестал быть аналитиком, «дающим советы, готовящим предложения наверх», а каждый инженер-начальник перестал быть «утверждающим решения снизу», но каждый занялся своим делом — оно заняло примерно полгода, это потребовало изменения большинства привычек для полутысячи человек холдинга.
Разделение труда — это ещё и разделение ответственности за результат труда, ибо виды труда (методы) распределяются по оргзвеньям, чтобы быть выполненными в работах, и вот оргзвенья при этом становятся ответственны за результаты этих работ. Эти работы или кому-то помогают (и вот этот «взгляд наружу», в глобальные результаты — это и есть взгляд системного инженера), или наоборот, вредят, и даже не могут быть просто «безвредными», ибо тогда они вредят тем, что съедают ресурсы, которые могли бы быть потрачены на полезную работу.
А ещё каскадирование (поручение работы в административной иерархии сверху донизу, а затем сбор результатов снизу доверху) — это крайне долго, это дикие задержки во времени. Это будет проходиться подробнее в руководстве по системному менеджменту. Если сотрудник будет принимать решение на своём уровне, согласовывая «по горизонтали», а не «по вертикали» (никто не говорит, что решения не должны согласовываться!), не каскадируя, то работа будет идти существенно быстрее — меньше будут накладные расходы на координационные акты (для них существенно время ожидания, например, ожидания, когда технический директор утвердит «не глядя» предложенное техническое решение в порядке «координации работ», или это будет утверждено проходящим раз в месяц «техническим советом» или другим коллегиальным органом, что означает «добавляем месяц к длине проекта» на каждый такой орган) и больше на продукционные акты (выполнение самой работы — размышления, согласования характеристик, проведение экспериментов и т.д., это может быть всего несколько часов после нескольких месяцев ожидания).
Разделение труда как многоуровневое разделение всего инженерного процесса на составляющие, выполняемые различными создателями в графе создания полностью соответствует и идеям, о которых говорит John Doyle в его работах по системам управления115: для устойчивого (не срывающегося на ошибки в широком разнообразии режимов) точного и скоростного не в ущерб точности управления нужно иметь множество датчиков, актуаторов, обработчиков информации, которые организованы многоуровнево, системно, и что важно — они должны иметь разные характеристики (прежде всего они должны быть разные по точности и скорости). В структуре управления при этом должно быть множество самых разных сложно устроенных обратных связей и просто устроенных прямых связей. Так, прямые связи простые — команды контроллеров «просто исполняются», а вот информация от датчиков обрабатывается сложно. Крупные быстрые силовые элементы дают скорость, мелкие медленные малосильные — точность, и оптимум скорости-точности будет достигнут только при сочетании достаточного числа вот этих разных масштабов систем, появлении множества мест принятия решений, то есть множества контроллеров для отслеживания множества датчиков и выдачи сигналов управления множеству контроллеров. Быстрое и точное управление обязано быть многоуровневым116.
По большому счёту именно такое управление инженерным процессом и происходит в «джазовом»/agile/эволюционирующем проекте, в котором непрерывно меняется как будущее окружение (оно предсказывается, его же ещё нет, системы ещё нет), так и в ответ на эти предсказанные изменения в будущем непрерывно меняется целевая система (которая только-только проектируется и изготавливается, её тоже зачастую ещё нет), так и в ответ на необходимость менять целевую систему меняются создатели в их графе (по мере изменений целевой системы требуется изменять и метод её создания, то есть менять создателей, которые могут исполнить метод, имеют для этого мастерство).
Реализация этих трендов приводит к тому, что каждый прикладной «по видам систем» инженер (авиатор, генный инженер, учитель) существенную часть времени проводит в роли системного инженера, озабоченного успешностью целевой системы и её проекта в целом, а не только по какой-то одной его прикладной характеристике. Прикладная «по методу» инженерия (электрика, механика, теплопередача) так и вообще сдвигается на AI-copilots, которые оказываются всё более и более подготовленными к выполнению роли прикладных инженеров, решению каких-то узких задач.
Создатели в роли системных инженеров не руководят («руками водят», то есть дают поручения на выполнение работ по развитию системы, начальствуют) прикладными разработчиками, но принимают решения по принципам их работы и структуре развиваемой/evolving разработчиками системы, а также создают условия (в том числе инфраструктуру) для работы всех разработчиков. Это не руководство или управление/management, это:
-
разработка какого-то технического решения: высказывание догадки, критика, рациональный выбор наименее плохого решения (ибо лучшего решения заведомо нет, оптимальность принципиально недостижима). Это чаще всего и называют инженерной работой — по роли инженера. Но это только начало инженерной работы над решением!
-
принятие решения (по David Deutsch — «принятие всерьёз», то есть решение кладётся в основу для действия, а не просто «принимается к сведению»). Важно, что это самостоятельное, полномочное, инженерное принятие решения, а не как у аналитика «принятие решения по вынесению предложения» для того, чтобы «принятие всерьёз» сделал кто-то другой — начальник, который ничего не понимает в этом решении, не имеет достаточно времени на его рассмотрение и просто «верит аналитику».
-
информирование всех о принятом решении (можно дальше долго обсуждать, принудительным уведомлением/push или по добровольной подписке/subscribe — тут это пока неважно, но нельзя принять решение так, чтобы о нём никто не знал), но затем разъяснение и обучение тому, в чём суть этого принятого инженерного решения и почему оно принято именно такое, а не какое-то другое. Тут используют разные слова для метода этой работы, чаще всего «техническое лидерство» (у классических «железных» системных инженеров), а у программных инженеров, следующих методам инженерной эволюционной разработки — «менторинг».
-
надзор/governance за тем, чтобы решения реально выполнялись. И если не выполняются, то принятие мер (вплоть до увольнения сотрудников, которые эти решения саботируют).
Команды системных инженеров не столько руководят специализированными на работе в каких-то прикладных инженерных областях (domains) людьми, выполняющими ещё более узкие инженерные методы, сколько организуют их взаимодействие по поводу разделения их труда, выполняя свой кусок инженерной работы в части целевой системы и технологий, используемых в проекте создания (прежде всего технологии непрерывного ввода в эксплуатацию).
Вместо «дирижёрской» поэтому лучше использовать «джазовую» метафору описания деятельности, это подробней будет изучаться в руководстве по системному менеджменту (системный менеджмент понимаем как инженерия организации, чаще всего — инженерия предприятия, но это может быть и инженерия организованного сообщества). Увы, время бежит быстро, поэтому «джазовая метафора» тоже стремительно устаревает — джаз сегодня играют не живые музыкальные ансамбли, а AI. Тем не менее, ещё несколько лет эта метафора должна быть понятна: речь идёт о коллективной импровизации117 прежде всего. При этом в музыкальном ансамбле можно выделить руководителя, который выбирает, какую музыкальную тему будут импровизировать музыканты (но он не командует — кому, когда что играть!), музыкантов с какими-то музыкальными инструментами, звукорежиссёра, занимающегося аппаратурой звукозаписи и звукоусиления, вокалиста — у него инструментом будет голос. Но их всех вполне могут назвать не «руководитель», «гитарист», «клавишник», «вокалист», а просто обобщить до «музыкант» — записав в музыканты и звукорежиссёра! Так и импровизирующих в своих ролях прикладных инженеров и эпизодически выполняющих роль системных инженеров тоже вполне могут называть «инженерами» или даже «системными инженерами». В руководстве по системному менеджменту как инженерии организации вы получите дополнительный опыт того, как строить системы из людей и компьютеров с AI так, чтобы в их состав входили все нужные виды инженеров (входили люди и компьютеры с AI, исполняющие все необходимые для создания и развития целевой системы методы, исполняя все нужные инженерные роли, включая роли создателей в их графах).
Разные инженерные роли имеют разные акценты в их образовании. Так создатель как инженер-архитектор знает множество архитектурных паттернов для того вида целевых систем, который развивается в проекте, и он обычно много времени тратит на системноинженерную фундаментальную работу — размышляет о целевой системе и проекте в целом. И ещё он имеет опыт разработки (опыт методолога, опыт проектировщика, опыт технолога изготовления, и т.д.), чтобы не отрываться от реальности и не требовать от команд разработчиков невыполнимого. Инженер внутренней платформы разработки (раньше его называли DevOps) хорошо понимает в операционном менеджменте, ибо его главная задача — уменьшать Lead Time (этих Lead Time есть ещё и много разных вариантов), в общем случае определяемого как время от момента, когда появилась идея очередного инкремента системы (например, реализующего какой-то запрос клиентов на новую фичу) до момента, когда потребители смогут воспользоваться этим инкрементом в составе эксплуатируемой системы. Ввод в эксплуатацию результатов работы должен происходить быстро, но без роста числа дефектов эксплуатирующейся системы (да, это умение выполнять модернизацию двигателя автомобиля не выключая двигатель, и даже не прекращая движения! И тут только доля шутки).
По большому счёту, такие акценты в образовании, какие нужны архитекторам и инженерам внутренней платформы разработки, девопсам (впрочем, и разработчикам тоже, им же нужно изобретать в рамках их рабочих обязанностей!), сегодня по факту есть уже в образовании каждого инженера, ибо рано или поздно в своей жизни каждый человек или AI столкнётся с необходимостью быть системным инженером, то есть с необходимостью отвечать за всю систему в целом (даже если это маленькая подсистема в составе какой-то большой системы). Помним, что если ты не понимаешь, как результаты твоего труда отражаются на системе в целом, не представляешь системы в целом, проекта в целом — то ты не можешь сотрудничать, ты не можешь определить, улучшаешь или ухудшаешь ты своей работой систему, разваливаешь или наоборот, продвигаешь проект в целом.
Инженеры во всех ролях должны выходить в фундаментальное мышление, чтобы переводить проблемы в самых разных предметных областях (которые непонятно, как решать) в последовательность задач (которые понятно как решать) в ходе многоуровневой оптимизации неизбежных конфликтов между системными уровнями в разрабатываемой системе. Инженерия ведь подразумевает и функциональный, и модульный синтез, которые вовсе неочевидно как сделать, ибо учитывать приходится минимально четыре разных описания системы (функциональное, конструктивное, размещение, стоимостное), да ещё и на многих системных уровнях, да ещё и для каждого создателя в их графе. В настоящем руководстве будет дано представление о таких методах разработки как методах системного творчества. И это надо делать инженерам не разово, а много раз в проекте — без ухудшения одной из важнейших архитектурных характеристик системы, evolvability, способности системы без полной переделки развиваться/эволюционировать в ходе непрерывной её разработки.
В любом случае, «инженер» и «системный инженер» (как особо беспокоящийся о целостности целевой системы, собираемой из многих уровней подсистем, а также её развиваемости/evolvability, беспокоящийся о сотрудничестве создателей в их графе) будет использоваться в руководстве как название роли (тип мета-мета-модели, объект из нашего руководства, а не классифицированный этим типом объект из жизни, у которого будет совсем другое название), но нужно учитывать, что в жизни в разных предметных областях (культурная, «из учебника» метаУ-модель, отражающая domain и ситуационная метаС-модель, отражающая принятый способ работы в конкретном проекте) вы будете слышать самые разные другие имена и ролей и тем более должностей. Вы должны будете догадаться, что речь идёт об инженерии, в том числе системной инженерии (вообще-то всегда идёт речь о системной инженерии! Прикладные инженерии по типам систем лишь её конкретизации для систем разной природы, а прикладные инженерии по составляющим метода — конкретизации каких-то составляющих разложения метода системной инженерии), и тогда вам в самых разных проектах пригодится мышление по наставлениям нашего руководства.
При этом вам может встретиться отнюдь не SoTA версия инженерии, то есть инженерия в вашем проекте может оказаться не системной, не безмасштабной, не эволюционной/непрерывной — и ещё люди будут гордиться, что они заняты «искусством», проявляют находчивость и изобретают велосипеды, а лучшие из них будут считать себя «ремесленниками», а не инженерами. Десяток лет в программной инженерии такое отношение к методам собственной работы было даже модно, «инженерия как кустарное ремесло, craft» сейчас об этом предпочитают не вспоминать.
В мире существует несколько профессиональных организаций системных инженеров киберфизических систем (прикладных инженеров киберфизических систем, которые акцентированы в своей работе на удержании целого, строят её на базе системного мышления), из них наиболее значительной является международный совет по системной инженерии (INCOSE, International Counsil of Systems Engineering, http://incose.org).
В этой организации есть индивидуальное членство ($50-$160 в год) и корпоративное членство ($4750-7250 в год), в 2023 году более 22 тысяч индивидуальных членов во всех стран мира118 и 134 коллективных члена.
Цели INCOSE — распространять знания по системной инженерии, обеспечивать международное сотрудничество и обмен опытом системных инженеров, устанавливать стандарты профессионального мастерства и проводить сертификацию системных инженеров на соответствие этим стандартам, обеспечивать поддержку корпоративных и правительственных образовательных программ в области системной инженерии. Но у этой организации есть существенные проблемы:
-
Исторически там собрались системные инженеры киберфизических систем, и значительная часть их занимается государственными инфраструктурными и военными проектами. Это означает, что меньше всего там используются принципы lean, ведущие к минимальному дублированию работ (госбюджет заплатит! Это не рынок!) и agile (государство строго планово! Никакого «планирования на лету» и тем более «неудачных экспериментов»!). По факту варианты системной инженерии, поддерживаемые этой организацией, базируются на идеях «водопада» и не учитывают идей непрерывной инженерии (в общих словах — признают и учитывают, но при рассмотрении сути методов в публикуемых учебниках, документах, стандартах — нет). Ровно по этой причине частная компания SpaceX смогла за несколько лет сделать в космических проектах больше, чем все традиционные контракторы NASA (достаточно сравнить проект Starship с проектом SLS по скорости разработки и новациям). И таких «частных компаний» в организации явно недостаточное представительство, больше представителей компаний с крупными военными проектами. SpaceX активна в INCOSE была где-то в 2007 году, но не сейчас.
-
INCOSE признаёт, что системная инженерия безмасштабна и используется для всех системных уровней (это ясно видно по INCOSE Vision 2035119). Но исторически всё равно центрируется на системно-эволюционном уровне киберфизических систем как основных для членов этой организации.
-
Также INCOSE признаёт, что «инженеры систем» и прикладные инженеры по отдельным прикладным инженерным практикам (электрики, теплотехники, метрологи) по факту тоже используют системное мышление, и произошло проникновение системной инженерии во все «другие инженерии». Но всё равно организация поддерживает главным образом инженеров-генералистов для киберфизических систем (робототехников, автостроителей, авиастроителей, ракетостроителей).
Повторим, что совсем необязательно называться системным инженером, чтобы им быть. Так, архитекторы софта (software architects) вполне себе системные инженеры, специализирующиеся на программных системах. Архитекторы предприятий — системные инженеры, специализирующиеся на организационных системах. Дело совсем не в названии должности или метода, не в членстве в ассоциации, дело в содержании: в реально выполняемых методах работы.
Мы тут опять использовали термин «системная инженерия» в двух разных значениях, так он используется и в жизни:
-
Любая инженерия с использованием в мышлении системного подхода, ибо без системного подхода, учёта самых разных систем в окружении и графе создателей, учёта эволюции и непрерывной подстройки под изменения нельзя менять мир. Как бы ни назывался метод, он оказывается инженерным, тем самым системноинженерным. Любой инженер — это системный инженер. Это соответствует определению «системная инженерия — это инженерный метод, задействующий системное мышление».
-
Те методы системной инженерии, которыми занимались люди, считавшиеся системными инженерами в инженерии киберфизических систем: на сегодня это главным образом архитекторы и инженеры внутренней платформы разработки (ранее DevOps), но сейчас сюда попадают и методологи (люди, занимающиеся эволюцией методов и предлагающие функциональный синтез, «принципиальную схему» системы). Эти люди получают специальное обучение по своим составляющим методам инженерного процесса. Это соответствует определению «системная инженерия — это метод поддержания целостности системы, в отличие от прикладных инженеров-разработчиков, системный инженер занимается системой в целом, а не какими-то частями системы или прикладными особенностями системы».
Какое значение правильное? В жизни используются оба, в нашем руководстве тоже так.
Инженерия и наука
Нельзя путать роли инженера и исследователя. Мы тут говорим слово «исследователь», а не «учёный» главным образом потому, что научное/рациональное мышление как построение объяснительных (про причины-следствия) порождающих (generative, пригодных для «обратного моделирования», предсказания состояний мира, конкретизации/рендеринга) теорий сегодня используется отнюдь не только в «науке» как особой культуре «учёных», но повсеместно в самых разных культурах, в том числе инженерии.
Исследователи (это роли, а не люди!) ровно обратны инженерам: если инженеры делают реальные материальные вещи, опираясь на какие-то (необязательно «научные»!) описания, то исследователи делают объяснительные теории физической и абстрактной (математики как раз занимаются исследованием поведения абстрактных/ментальных объектов) реальности. Исследователи получают компактные, понятные и формальные описания действительности. Слово «реальность» тут означает именно физический и ментальный мир, а вот «действительность» — мир, преломлённый нашими понятиями, отражающими то, что нам об этом мире уже известно и что мы можем выразить по поводу этого мира (скажем, если человечество пару веков назад не знало о существовании электронов, то в реальности они были, а в действительности их не было).
Конечно, инженерия и исследования тесно переплетены:
-
когда инженер получает инженерную систему, поведение которой не отвечает его замыслу, он исследует проблему: пытается найти наиболее компактное описание работы этой инженерной системы (модель/теорию/алгоритм), из которого было бы понятно, в чём он ошибся при замысле системы и её воплощении. Затем исправляет ошибку: меняет систему.
-
когда исследователь моделирует мир, то есть придумывает новый способ его описания (новую модель, мета-модель, мета-мета-модель), более компактный и лучше объясняющий мир, чем предыдущие способы, то он прежде всего строит догадки о тех понятиях, которые помогут ему построить это описание. Затем критикует эти догадки, и в том числе проводит эксперименты. Отнюдь не все эксперименты «мысленные». Некоторые из них требуют создания весьма и весьма сложных инженерных систем (например, ускорители частиц — это одни из самых сложных на Земле инженерных систем, и их строят именно для проведения экспериментов в предметной области физики высоких энергий). Когда эксперимент проведён, исследователи корректируют свои объяснительные теории в зависимости от результатов эксперимента (выбирают лучшую из имеющихся, или модифицируют какую-то из них для лучшего соответствия их предсказаний с результатами эксперимента).
Тем самым инженерная и исследовательская деятельности оказываются связаны в цикл, и в каждом исследовательском или инженерном проекте обычно приходится много раз этот цикл повторять:
Как только мы что-то делаем в рамках какого-то метода, «выполняем инструкцию», результаты нашей работы очень скоро начинают расходиться с предсказаниями наших моделей «из учебника». В этот момент нужно «включать мозг» в плане силы его общего интеллекта, то есть переходить на использование интеллект-стека фундаментальных методов мышления. А поскольку наши модели мира несовершенны, а ещё каждый раз находится что-то, что меняет мир, меняет нас прямо по ходу наших занятий каким-то методом, то вот это несоответствие предсказаний мира моделями «из учебника» и реальной обнаруживаемой в ходе работы ситуацией происходит постоянно. Нужно постоянно разбираться, что происходит, поправлять наши модели мира. Исследования/познание оказываются вплетены в жизнь более тесно, чем можно себе представить. В учебнике написано — «ударить молотком три раза, и гвоздь будет забит!». Вы бьёте всего один раз — и попадаете не по гвоздю, а по пальцу, или гвоздь гнётся, или гвоздь забивается по самую шляпку сразу и молоток разбивает ещё и ту поверхность, куда забивается гвоздь, или оказывается, что вы пытаетесь вбить гвоздь в камень, или… этот список можно продолжать и продолжать, и это простейший метод! Хуже, когда вы даёте человеку лекарство, а оно работает совсем не так, как описано в инструкции по его применению. Вы должны стать исследователем, чтобы понять происходящее!
Главное тут — цель объемлющей деятельности, а не собственно сама работа «исследований» или «инженерии» и её отнесение к какому-то классу. Цель этой объемлющей деятельности обычно — изменение мира к лучшему, то есть либо появление какой-то материальной системы, приносящей пользу каким-то внешним проектным ролям, либо появление какого-то компактного описания/объяснения/«generative model» того, как устроен мир, чтобы на следующем шаге иметь возможность изменить этот мир к лучшему. В любом случае, либо инженерия оказывается спрятана в исследованиях/познании, либо познание/исследования спрятаны в инженерии. Они неразрывны. Познание деятельно, деятельность познающа.
Вот ещё раз тот же цикл, при этом инженерная часть — это там, где на основе выигравшей догадки делается «принятие всерьёз», теория берётся для действия. Если вы не можете опровергнуть, что с ростом ресурсов умность нейронной сетки растёт, вы собираете много миллиардов долларов от инвесторов и делаете условно-некоммерческую OpenAI — и да, вложение многих миллионов долларов в обучение большой языковой модели на основе нейросети приносит свои инженерные плоды, получаем ChatGPT120. Если вы не можете опровергнуть, что энергия равна массе, умноженной на скорость света в квадрате, то понимаете, что уменьшение массы урана за счёт ядерного распада должно давать огромное количество энергии — принимаете это всерьёз и организуете Манхэттенский проект, который на выходе дал работающую атомную бомбу.
Вот ещё одна, более подробная диаграмма кольца познания, оно же — кольцо инженерии. Это отражение теории эволюции, красные стрелочки показывают, что генерируется множество гипотез, и они могут дать старт новым подобным циклам. Теории эволюции знаний (включая эволюционную эпистемологию Karl Popper с доработками David Deutsch других исследователей эволюции знаний) очень похожи на любые другие эволюционные теории. После принятия всерьёз — как раз будет «выход в практику», «выход в инженерию»: создание инженерных систем на базе положений теории, но цикл продолжает крутиться!
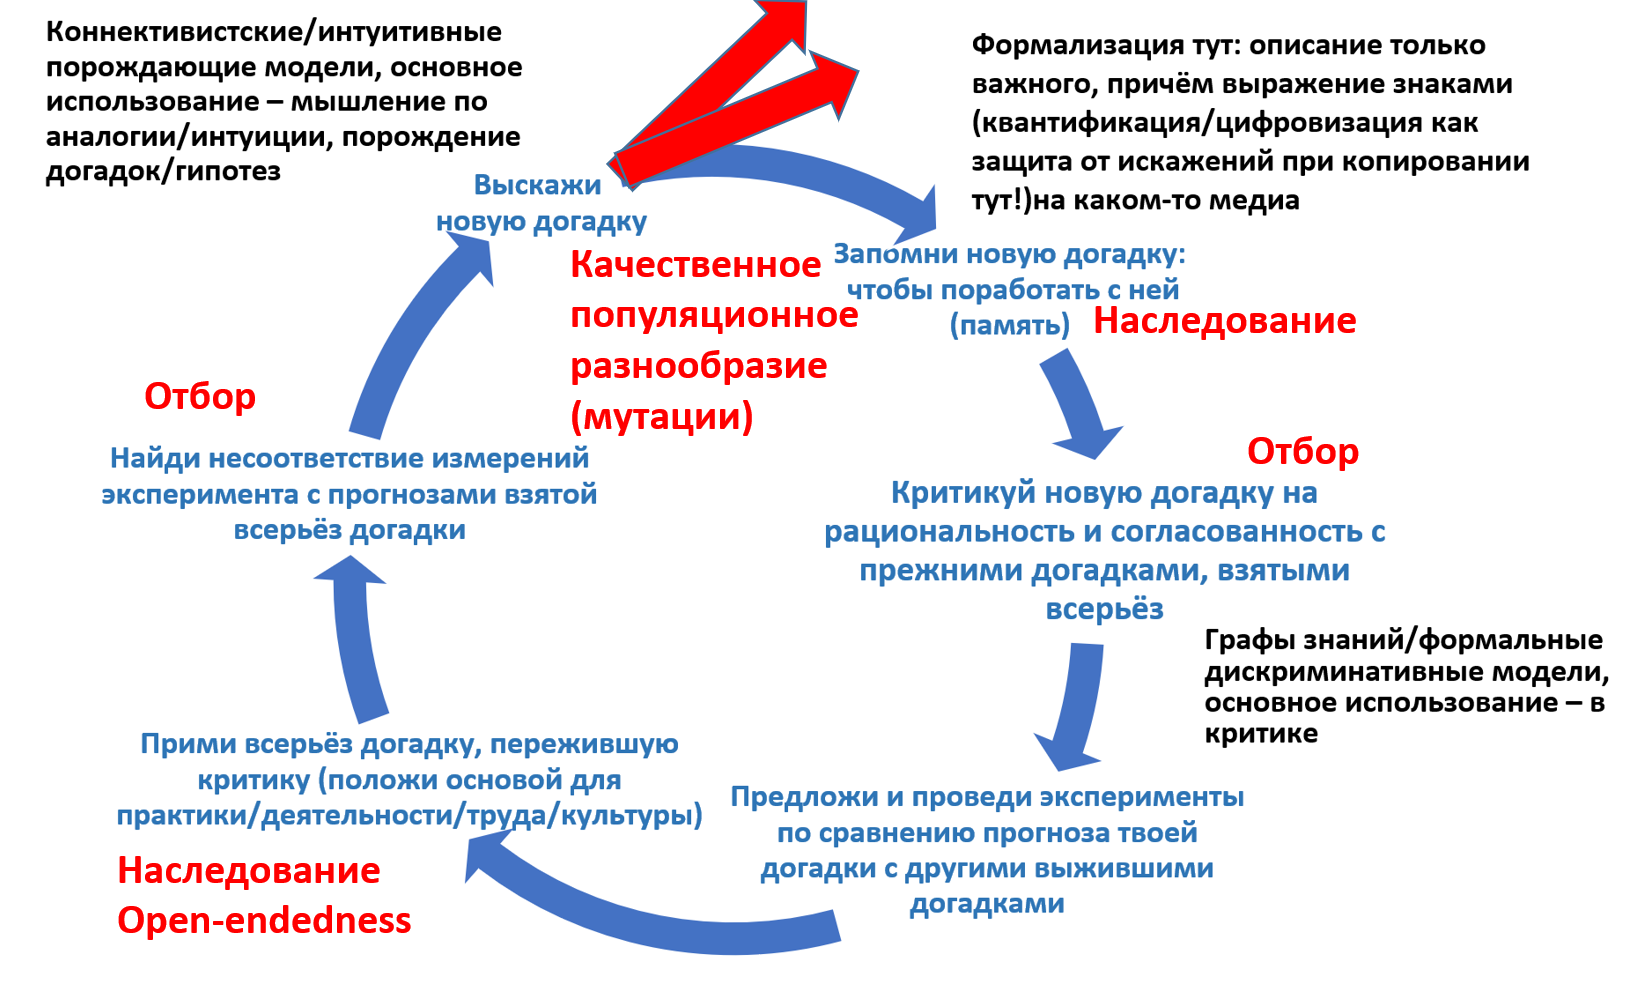
Особо надо отметить, что нейросети (и мокрые, и сухие) тоже могут (хотя и крайне неэффективно!) выполнять роль критика: это универсальные алгоритмы, поэтому они вполне могут выполнять и операции сложения по очень хитрому тригонометрическому алгоритму121 — это медленно, энергетически неэффективно, но возможно! Нейросети могут выполнять и длинные цепочки чисто логических рассуждений (собранность — удерживание во внимании длинных цепочек логических рассуждений), причём примерно одинаковая общая результативность собственно «нейросетевого» ассоциативного поиска новых идей как при удержании длинных цепочек логических рассуждений внутри нейросети, так и при сдвиге этих длинных цепочек логических рассуждений на внешние вычислители («киберсобранность», когда собранность кибер-нейросети удерживается сдвигом рассуждений на внешние классические, не нейросетевые логические вычислители), это проверено экспериментально122. Нейросети не слишком хороши в длинных логических и математических выкладках, их правильно сдвигать на классические компьютеры, математический софт. Но нейросети вполне могут делать эти выкладки, с трудом и ошибками. Так что опора инженерии на математику и физику поддерживается не просто «голым мозгом», она существенно поддерживается компьютерным инструментарием, и даже просто карандашом-бумажкой, как средством удержания собранности — сосредоточенности на ведении длинного рассуждения, многих оборотов цикла познания/learn/моделирования/обучения/исследований (синонимов с нюансами тут много). И в этом цикле есть один замечательный момент: наука/исследования/познания выходят в инженерию в момент «принятия всерьёз».
Перепутанность и неразрывность инженерии и науки отражается в жизни, с ними не нужно бороться:
-
В большинстве мультфильмов «учёный» в белом халате меньше всего учёный-исследователь, это «инженер-изобретатель». Эти якобы «учёные» не ставят эксперименты: они придумывают какие-то необходимые для их целей системы, в быту называемые «inventions/изобретения» как синоним «будущего продукта», и затем воплощают эти системы в реальности как системы-прототипы или системы-опытные образцы. Это «лаборатории Эдисона», где «лаборатории» не столько исследовательские, сколько инженерные, в которых происходит возня/tinkering (другое название — trial and error method), инженерная работа путём проб и ошибок, инженеры пробуют свои разные «догадки» для физического состава системы так же, как исследователи пробуют свои «догадки» в части объяснительных моделей. Большинство не срабатывают, но некоторые — срабатывают, иногда сразу, иногда после существенных доработок. Это по факту эволюционный процесс руками инженеров, это не «наука», поскольку не производятся объяснения.
-
«Прикладные исследования» (applied research, прикладная наука) тоже не «исследования», несмотря на явное употребление термина «исследования». Никаких объяснительных теорий от прикладных исследований ожидать не приходится, а результаты НИР (научно-исследовательских работ, но в ходе этих работ часто создаются не только какие-то описания, но и макеты изделий) и НИОКР (научных и опытно-конструкторских разработок, в ходе них создаются не просто макеты, но опытные образцы) нацелены на получение в конечном итоге «инноваций» как систем, которые определяются как новые системы, успешно выведенные на рынок, то есть достаточно конкурентноспособные, чтобы продаваться (а не просто любые «новые системы»). Между «работающим прототипом» и «выпускаемым продуктом» могут быть годы и годы разработки/development. И это рассуждение работает не только с системами уровня сложности косного вещества или киберфизическими системами, но и системами других уровней системной эволюционной сложности, хотя даже о сообществе не скажешь «вот мы тут сделали опытный образец, сейчас выведем его в серию», приходится адаптировать рассуждение к разным системным уровням.
-
Очень часто прикладные исследования (research) и классическую разработку вообще не разделяют, отсюда устойчивое сокращение R&D (research and development). Есть ли разница? Есть: «лаборатории Эдисона» (лаборатория Bell Labs, лаборатория IBM и т.д.) всё-таки отличаются существенно по организации труда и проходящим в них работам от классической инженерной разработки в конструкторском бюро или проектном институте. Но они не отличаются принципиально! Оргинженерией (то есть менеджментом) R&D как раз и занимается метод technology and innovation management как метод инженерии организационной системы, занимающейся разработкой технологий и инновациями.
Настоящая «наука», исследования в чистом виде — это «basic research», которые ведутся в условных «лабораториях Эйнштейна». На выходе исследований не «опытные образцы», а объяснительные теории — компактные и довольно формальные описания физического мира/природы.
Но не всё так просто. Например, физики-экспериментаторы или биологи-экспериментаторы — это не «исследователи», а хорошие инженеры, их задача — придумать систему, которая позволит провести измерения (провести эксперимент) для выбора той или иной теории из множества кандидатов на лучше предсказывающих результаты этих измерений. По роду деятельности они как инженеры меняют физический мир (создают различные измерительные системы, в которых подготавливают измерение какого-то параметра какой-то системы в заданных условиях — типично инженерная задача), а как исследователи-физики или исследователи-биологи — проектируют целевое измерение (задают потребность в экспериментальной установке) и затем интерпретируют результаты эксперимента в части возможного опровержения какой-то теории, для чего этот эксперимент и задумывается.
Ровно из такого понимания двух ролей физика как инженера-исследователя «в одном теле» происходит высказывание Фарадея, что «настоящий физик должен уметь пилить буравом и буравить пилой», то есть настоящий исследователь должен уметь хорошо выполнять инженерную работу (во времена Фарадея инженер воспринимался не столько как проектировщик или конструктор, сколько непосредственный исполнитель метода изготовления, своими или чужими руками тут уже неважно, но подразумевалось, что всё-таки своими), и наоборот, настоящий инженер должен уметь исследовать (иметь естественнонаучное образование, как и все исследователи. Насколько «все»? Тут отдельно можно обсуждать, насколько изучение личности, организации, сообщества, общества может быть «естественнонаучным»).
Системная инженерия вполне может включать R&D, изобретения, создание прототипов. И в ходе занятий системной инженерией вполне можно ожидать проведения каких-то научных исследований, дающих результатом теорию. Скажем, в области искусственного интеллекта огромное число научных работ сейчас делается в лабораториях крупных инженерных фирм. Вот вывод AI report 2024123: в 2023 инженеры из коммерческих компаний выдали 51 значимую модель машинного обучения, а университеты выдали только 15. И ещё была 21 значимая модель как результат коллаборации между инженерами и учёными.
Это просто продолжение тренда ухода исследований из университетов в промышленность в самых острых направлениях. Вот что было на пару лет раньше, посмотрите, как соотносилось число докладов от университетов и от коммерческих компаний на конференции ICML по искусственному интеллекту в 2021 году124:
Мы хотим создать более-менее формальное (позволяющее логически рассуждать и находить противоречия в этих рассуждениях) компактное объяснительное описание самой системной инженерии как культуры создания успешных систем (без выделения специальной роли системного инженера, занимающегося системой в целом). Это обычная задача методологии как фундаментального учения о методах. Конкретизация методологии, занимающаяся инженерией как методами создания и развития успешных систем, часто называется «инженерная наука» (engineering science).
Другие предметы и другие науки описывают поведение инженерных объектов, то есть как именно они будут работать, будучи устроены таким или иным образом: механические устройства, электрические схемы, компьютерные программы. Обращаем внимание, что мы различаем:
-
метод самой инженерии (engineering, что делают создатели целевой системы), которую изучает «инженерная наука» и
-
методы мышления для описания объектов инженерии, поддержанные соответствующими инструментами в виде разного сорта моделеров — методы механики, электрики, информатики/компьютерной науки/computer science и т.д., то есть методы описания поведения не создателей, а самой целевой системы.
Наиболее просто понять разницу между такой «наукой про инженерный объект» и самой «инженерной наукой» можно на примере computer science (компьютерной науки) и software engineering (программной инженерии). В одном из блогов была замечательная история, как его автор, отличник по computer science, пошёл после вуза покорять софтверную компанию. Но там ему буквально за два дня объяснили, что он (может быть) умеет программировать, но совершенно точно не умеет работать: нужно было разбираться с тем, как поставить задачу на разработку, писать нужно было не столько какой-то хитрый алгоритм, сколько крохотную заплатку к уже написанному многими людьми коду на миллион строк, нужное место для его заплатки в этом коде нужно было как-то найти, кроме этого нужно было разобраться с управлением конфигурацией (версионированием), наладить отношения с менеджерами и специалистами по безопасности, разобраться с ограничениями архитектуры, понять суть принятой в проекте методологии разработки, вписаться в команду и т.д. — при этом ничему этому в вузе не учили.
Работа «программного инженера» оказалась совсем не тем, чему учили, совсем не «использованием знаний компьютерной науки в инженерном проекте»: огромное количество времени уходит на общение с коллегами и выяснение того, что где взять и куда положить, а не на «думание про научно-обоснованные алгоритмы». Время решения задачи оказывается не «сколько нужно для идеального научного решения», а «сколько отведено графиком работы». Учили computer science (ключевые слова: алгоритм, оценка скорости выполнения алгоритма, нотация, грамматика, реляционная модель данных) и не учили software engineering (ключевые слова: концепция использования, архитектура, тестирование, версионирование, ввод в эксплуатацию).
Точно так же инженера-механика могут научить работать с прочностью, формой, скоростями, трением с использованием всяческих теорий, но могут не научить выяснять особенности заказа с представителями заказчика, не познакомят с архитектурой, документированием инженерных обоснований. Именно поэтому хороший физик (человек, который имеет квалификацию выполнять роль физика-исследователя, владеет методом физического исследования) может быть хорошим специалистом по сопротивлению материалов, но не быть хорошим инженером — у него знания про объекты, которыми занимаются инженеры, но не про саму инженерию как метод.
Особенностью сегодняшней инженерии будет то, что она претендует не только на описание методов создания механических или киберфизических (механических с универсальным компьютером в их составе) систем, но и вообще любых систем, включая и общества, и даже человечество: утверждается, что методы создания этих систем на самом абстрактном уровне одинаковы, то есть все эти системы (или модификации этих систем, если речь идёт о brownfield, то есть доработках уже существующих систем) создателями в их графах создаются и развиваются в постоянной адаптации к изменениям в окружении и целевой системы (часто прямо по ходу эксплуатации), и в самой целевой системе (автомобиль ломается потому как в нём происходят изменения, не предусмотренные инженерами), и даже в организациях графа создателей (люди и AI там получают новые знания, им становится доступно новое оборудование, или наоборот — неожиданно заканчиваются ресурсы). Для всех таких проектов надо готовить концепцию использования, концепцию системы, архитектуру системы, непрерывно их уточнять, готовить конвейер/завод/«внутреннюю платформу разработки»/«internal development platform»/pipeline для непрерывного введения в эксплуатацию релизов/инкрементов системы, которые одобряют визионеры, а готовят разработчики под надзором архитекторов. Разница в масштабах систем, конкретных методах работы, разнообразии дисциплин, описывающих системы той или иной природы, особенностях скоростей их эволюции, а разница терминологии не должна заслонять этой общности.
Обучить инженерному делу как таковому (именно это цель настоящего руководства, хотя руководство делает это на кругозорном, весьма абстрактном уровне) — это обучить тому, как устроен ход эволюционной (другой уже сегодня не бывает) инженерной разработки, какие основные понятия предметной области самой инженерии (а не предметной области, описывающей физику и алгоритмику создаваемого инженерного объекта): как устроен инженерный проект в целом и как разворачивается во времени проектирование/конструирование/программирование, изготовление и ввод в эксплуатацию целевой системы, а не только как устроена создаваемая система.
Методология предлагает как результат «инженерной науки» описание разных вариантов инженерного процесса и связанного с ним разделения труда — SoTA и не очень, в том числе объясняет разницу: почему одни методы лучше (SoTA, state-of-the-art, «лучшие из известных на текущий момент времени»), а другие хуже.
Если мы теперь говорим, что «результат инженерной науки надо брать всерьёз и строить метод инженерии как описанный этой наукой SoTA метод», то это будет уже не «объяснения того, как бывает», а «предписание того, как надо делать» — и тогда мы говорим, что методология как «инженерная наука» является нормативной наукой125.
Ненаучность инженерии. Эвристики
Знания самой инженерии (как надо что-то делать/практиковать создателю целевой системы) и знания об инженерных системах разного вида (установках, сооружениях, транспортных средствах, компьютерах и т.д. для традиционной инженерии киберфизических систем, но и существах, личностях, организациях, сообществах, обществах и даже человечестве — как добиться у них каких-то определённых характеристик) могут быть как научными, так и ненаучными, то есть опираться или на хорошие, или на плохие объяснения126.
Инженерия рождается и живёт методом проб и ошибок, её знания, передающиеся из проекта в проект про неё саму (как что-то сделать) и про её инженерные объекты вовсе необязательно «научны». Так что разные определения инженерии на основе единственно «принесения в работу инженера научных знаний» просто неверны, хотя наука (лучшие имеющиеся на сегодняшний день объяснения закономерностей природы) обязательно используется в инженерии там, где она доступна. Но где хороших объяснительных теорий/«научных знаний» нет, они не используются, при этом совершенно необязательно инженерный проект останавливается.
Эволюция работает независимо от того, разработана ли теория эволюции. Концептуальные (какие функции какими физическими объектами воплощаются) и архитектурные (какие принципы объединения физических объектов в модули и способы взаимодействия модулей) идеи воплощаются в создаваемых системах непосредственно, но эти системы сами по себе не вносят изменений в конструкцию и выбранный тип её модульности следующих систем. Это делают создатели, чаще всего изменяя конструкции систем непрерывными пробами (мутации, желательно smart, и их должно быть много — эволюционное разнообразие) и ошибками (эволюционный отбор), простым запоминанием и повторением «того, что работает» (наследование в эволюции) — часто даже без поиска объяснений. И это неостановимый процесс, ибо что было SoTA сегодня, перестаёт быть SoTA завтра, учитываем динамичность ландшафта приспособленности. Жизнь меняется, следовательно — SoTA меняется.
Речь идёт не только об инженерии киберфизических систем и традиционно понимаемой «инженерии», речь идёт обо всех видах инженерии, включая личное развитие, менеджмент, политику и экономику как социальную инженерию, и даже искусство, в котором тоже можно отследить какие-то «течения» и «движения», изучаемые искусствоведами. Опора на объяснения (хорошие или плохие, то есть использование порождающих моделей/generative models) может в инженерии как быть, так и отсутствовать (то есть использование чисто эволюционных/мутационных/случайных идей).
В книге Discussion of the Method127 (2003) исследователь классической инженерии Billy Koen приводил пример: если бы в средние века к инженеру пришли с просьбой построить мост через небольшую (или даже большую) речку, а он бы отказался на основании того, что сопромат изобретут только через 200 лет — что можно сказать о таком инженере? Или если бы современный инженер при просьбе построить ракету, летящую на Луну или Марс, отказался бы от проекта на основании того, что достаточно подробной «теории Луны» или «теории Марса» ещё не создано? Или при необходимости создать робота инженер вдруг говорит, что «теории о том, что делать, чтобы создавать робота пока нет — поэтому я не знаю, что в каком порядке делать, поэтому подождём до тех пор, пока у учёных не появится соответствующего раздела в их объяснениях из инженерной теории». Или в ещё будущих США вдруг их отцы-основатели говорят, что «непонятно ещё, как делать процветающее общество, не будем писать Конституцию и учреждать новое государство, потому как ещё политологи не создали теории, которая позволяет это сделать надёжно, понятно и просто». Отказы на таких основаниях не свойственны инженерам, их не останавливает отсутствие научного формального знания в том, чем они занимаются.
Инженерия кроме научных/объяснительных теорий активно использует эвристики (heuristics) — это догадки о замеченных удачных паттернах/закономерностях/шаблонах, которые вовсе необязательно «научны» в традиционном смысле этого слова. Это просто замечания, что «что-то работает». В принципе, эвристики вполне можно считать и суевериями — они возникают так же. Вы заметили, что все те три раза, когда вам в голову пришла хорошая мысль, вы были в голубой одежде — всё, нейросеть в вашем мозгу отлично распознаёт повторения, паттерны! Дальше критика выключается, проверки экспериментом выключаются — и эта идея принимается всерьёз! Такая эвристика/суеверие — это не «фальсифицируемая теория» по Попперу и тем более с поправками Дойча про объяснения и замечаниями, что это должна быть «объяснительная теория, сформулированная контрфактуально», и поправками Фристона, что это должна быть «порождающая/generative модель/теория, позволяющая предсказать будущую ситуацию»: инженер с самого начала знает, что эвристики вполне могут быть в его случае ошибочны и неприменимы, оказаться суеверием. Плюс обратите внимание, что инженерные эвристики определяются отличным образом от философской «эвристики», найдите соответствующую литературу сами. Вот примеры инженерных эвристик из справочника по инженерии химического производства128, :
-
Используй вертикальный резервуар на опорах, когда его объем меньше 3.8м3
-
Используй горизонтальный резервуар на бетонных опорах, когда его объем между 3.8 и 38м3
-
Используй вертикальный резервуар на бетонных опорах, когда его объем больше 38м3
На эту тему есть хороший анекдот:
Физику, математику и инженеру дали задание найти объём красного резинового мячика.
Физик погрузил мяч в стакан с водой и измерил объём вытесненной жидкости.
Математик измерил диаметр мяча и рассчитал тройной интеграл.
Инженер достал из стола свою «Таблицу объёмов красных резиновых мячей» и нашёл нужное значение.
Есть и другие типы инженерных эвристик, совсем не связанных с инженерными расчётами и приёмами конструирования-проектирования киберфизических систем, но связанных с приёмами менеджмента как конструирования-проектирования организационных систем (проектов как проектных команд). Отличить «работающие» (удачные догадки, отражающие какие-то закономерности) и «суеверия» (не работающие, но соблюдающиеся) тут почти невозможно, организовать эксперимент, надёжно выделяющий связанные с эвристикой ситуации, вряд ли получится:
-
Внешних проектных ролей (и их исполнителей) всегда на единицу больше, чем вы знаете; известные вам внешние проектные роли всегда имеют потребность (need) на одну больше, чем вам известно (это шестая из основных инженерных эвристик Tom Gilb129).
-
Порядок бьёт класс, классный порядок бьёт всех (в больших проектах упорядоченная работа команды заурядных специалистов бьёт беспорядочную работу высококлассных звёзд, а упорядоченная работа высококлассных звёзд бьёт всех. Эта эвристика пришла из футбола, отражает разнообразие стилей игры разных команд и успешность этих стилей).
Демократия как замена силовой смены власти диктатора-на-всю-жизнь выборами диктатора-на-короткий-срок — это тоже инженерная эвристика/суеверие, для организации уровня общества через устройство властных команд в этом обществе (то есть эвристика, связывающая конструктивы разных системных уровней: от личности через организацию/правительство и сообщество/партию до общества). Заметим, что «демократия» — это инженерная идея, а не научный объяснительный концепт, объясняющий устройство общественной жизни. Демократия сама по себе и не порождающая теория, по ней нельзя предсказать то, что будет при ней происходить. В поддержку или против демократии может быть положено множество разных объяснительных теорий социологии, политологии, экономики (с порождающими теориями в этих дисциплинах сложней, но не будем на это отвлекаться). Скажем, David Deutsch считал, что демократия — это просто надёжный бескровный способ исправить ошибку, если избранная власть ведёт себя не так, как ожидалось (то есть демократия — это реализация эволюционного алгоритма: есть у общества догадки о том, кто мог бы быть подходящим правителем, и если догадка не оправдалась, то на следующем такте правителя меняем на другого, другую догадку).
Несмотря на то, что наука в инженерии не обязательна, эвристики в более простых системах по возможности заменяются научными объяснительными SoTA теориями, в том числе в виде компьютерных моделей (разница: правильно применённая теория даёт надёжный ответ, а эвристика, возможно, врёт при малейшем изменении условий её применения), тем самым место для метода проб и ошибок смещается в сторону систем, которые плохо описываются наличными научными теориями. Это могут быть и системы уровня вещества (например, трёхмерная структура белков плохо описывается теорией, но совсем недавно нейронная сеть AlphaFold130 реализовала эвристики, которые позволяют неплохо предсказать эту структуру — и это именно эвристики, а не объяснительная теория).
Важно при этом понимать, что переход от эвристик к нормальной науке важен для того, чтобы получать 100% надёжный результат. Когда заметили, что цитрусовые избавляют от цинги, эти цитрусовые стали брать в дальние плавания наряду с сушёным мясом. Но в этот момент это была эвристика, объяснений не было. Поэтому в какой-то момент один из капитанов взял в плавание запас цитрусовых не того сорта: с малым содержанием витамина C. И все заболели цингой — и вера в эвристику «цитрусовые спасают от цинги» исчезла. А потом открыли витамин C, его влияние на предотвращение цинги — и разобрались, почему одним морякам цитрусовые (одних сортов! С большим содержанием витамина С!) помогали от цинги, а другим морякам цитрусовые (других сортов! С малым содержанием витамина С!) не помогали. Большинство эвристик нуждаются вот в такого сорта объяснениях — но инженеры (с переменным успехом) могут использовать их в работе и до получения объяснений.
Формальные (строго следующие законам логики) объяснительные теории дают описания инженерных систем, которые позволяют: находить ошибки без создания системы, а часто и вычислять необходимые или оптимальные характеристики системы (это называется часто «формальный анализ»). Очень дорогой эволюционный метод проб и ошибок с его бесконечным циклом догадок и экспериментов при помощи формальных описаний из объяснительных теорий превращается в совсем другой метод работы, число проб становится в разы и разы меньше: вычислять много проще, чем изготавливать системы и смотреть, будут ли они удовлетворять потребности. Источником же полезных формализмов (методов объяснения, то есть описания причин и следствий в самых разных явлениях) является как раз наука/исследования.
В целом объём научных знаний растёт, число найденных удачных эвристик тоже растёт, поэтому со временем растёт и уровень инженерии: успешность систем, которая тестируется как успешность на многих системных уровнях (то есть гарантия того, что какие-то системы, создаваемые на нижних уровнях системной эволюционной сложности, например, киберфизические системы, не ухудшат системы более высоких уровней).
В связи с этим любые достижения в инженерии по предложению Billy Koen нужно оценивать не по абсолютной шкале, а на конкретный момент времени, в соответствии с накопленным на этот момент объёмом научного и эвристического инженерного знания — и это «текущее состояние инженерии» Billy Koen предложил называть SoTA (state-of-the-art). Инженерный проект плох, ежели он не использует научное и эвристическое знание, накопленное на конкретный момент времени (он может быть успешен, но плох!). Не отвечающий SoTA инженерии проект плох (скажем, если в каком-то обществе смена правления идёт через силовой захват власти, а не выборы, то с инженерией этого общества непорядок, это не SoTA. Смена власти на сегодня вполне обеспечивается несиловыми способами, если применена современная системная инженерия уровня общества). Со временем объем знаний растёт, и инженерные проекты становятся более и более сложными, достигая невозможных для предыдущего времени характеристик. Так, сегодня вполне возможен полёт вертолёта на Марсе: инженерия киберфизических систем такого уровня вполне реальна131. Инженерия искусственных бактерий тоже вполне реальна132.
Последние годы показывают, что эвристики не совсем уж неформальны: они часто отражают паттерны/закономерности, которые даны не в локальном/символьном/формальном представлении, но в распределённом представлении нейронной сети — человеческой («мокрая нейронная сеть») или компьютерной. Это относительно новое направление исследований: вместо формализации иметь описания в виде обученной нейронной сети. Подробней на эту тему говорится в руководстве по интеллект-стеку. Тут же надо заметить, что обученные нейронные сети вполне применяются в инженерии, но их результаты работы имеют тот же статус «эвристик»: иногда они удачны, иногда ведут к ошибкам.
Существует мнение (его в своих книгах пропагандирует Nassim Taleb, например, в книге «Антихрупкость»133), что наука/исследования для практической деятельности бесполезна, настоящие новации полностью ненаучны. По этому мнению инженеры-практики добиваются успеха не на основе научных знаний, а исключительно на основе «возни» (tinkering, ср. «He is tinkering with a car» — «он возится с автомобилем»). Taleb сравнивает учёных/исследователей с теми, кто приходит к птицам и пытается научить их летать, давая знания по аэродинамике. Типичное высказывание в его книге на эту тему: «Никто не опасается, что ребёнок, понятия не имеющий о разных теоремах из области аэродинамики и не способный решить уравнение движения, не сможет ездить на велосипеде». Талеб защищает метод проб и ошибок, защищает эвристики. Он абсолютно прав. И он прав, когда пишет о создании реактивных двигателей: сначала было много проб и ошибок, потом только появилась стабильно работающая теория, а не наоборот. Проблемы с ракетами: сначала таки появилась физика, потом понимание, что физическое тело может при достижении некоторой скорости вращаться вокруг Земли — и только после этого реактивные двигатели позволили создать ракету, которая вывела на орбиту первый спутник Земли. И ещё с атомной бомбой та же история — получить атомный взрыв простой вознёй с ураном не получится, надо таки знать, с чем перспективно возиться, а с чем — нет, и сколько минимально урана надо, чтобы произошёл атомный взрыв. Талеб говорит правду, но не всю правду.
Результаты исследований — теории, алгоритмы, научные дисциплины, знания — дают нам новые методы мышления, способы рассуждать о проблемах по-новому: быстрее, надёжнее, точнее. Мы можем использовать сформулированное в форме порождающих объяснительных теорий знание о причинах и следствиях, дающее возможность ещё и «вообразить» какой-то мир, отвечающий объяснениям теории, и просто не воплощать в жизни какие-то идеи изменений мира, если заранее известно, что они не приведут к изменениям в мире к лучшему. Думаем мы и без объяснительных теорий, и без помогающих работать с моделями этих теорий компьютеров. Но таким древним «без этих ваших академий» способом мы думаем спонтанно, медленно и не слишком надёжно. По факту мы в ходе наших размышлений всё-таки пытаемся создать эти объяснительные теории на уровне кулибинства: делаем догадки, критикуем их, пробуем опровергнуть экспериментом.
Метод проб и ошибок всем хорош и в мышлении, и в инженерии, но это «эволюция вручную» — очень дорого и чрезвычайно долго. Если есть способ что-то физическое коротко описать в части самого важного (модель! Она учитывает только важное, а неважное игнорирует!), а потом работать с этим описанием-моделью, а не с самим физическим объектом, то так и нужно делать. Если вы учите ребёнка ездить на велосипеде, то вам особой науки (SoTA объяснительной теории) не нужно. А если вы учите компьютер быть автопилотом на реактивном самолёте, то незамутнённым объяснительной теорией и компьютерным моделированием методом проб и ошибок вы загубите слишком много реактивных самолётов. Нужно губить виртуальные самолёты, для этого иметь модель самолёта, то есть знания, алгоритм, описание самолёта. И когда виртуальный самолёт покажет, что он летает — можно строить реальный самолёт.
Первые реактивные, да и не только реактивные самолёты, да и не только самолёты так и создавались — из расчётов делалось то, что могло делаться, остальное — результат инженерной интуиции, основанной не на формальных длинных цепочках рассуждений, а на работе нейронной сетки, находящей паттерны «без объяснений».
Как сказал когда-то автору этого руководства один из разработчиков турбокомпрессоров: «делаешь четыре турбокомпрессора. Четвёртый — работает». А теперь не только турбокомпрессор, но и первый изготовленный «в алюминии» самолёт сразу летает, и не может такого быть, чтобы не летал: просто выросло число доступных объяснений, которые можно увязать в длинные объяснительные цепочки! И личности более-менее получаются, и организации по большей части тоже работают, а вот с сообществами, обществами и человечеством в целом всё в этом плане похуже получается, ибо надёжных объяснительных теорий (которые чаще всего опираются на математику и математическую логику) тут сильно меньше, и они менее универсальные. Это не случайно: если у вас будет объяснительная теория того, как я думаю, и вы попытаетесь использовать её, чтобы мной поуправлять, я немедленно исправлю своё образ мыслей, и, соответственно, действий — ровно для того, чтобы вам не удалось мной проуправлять. Вот и не работают теории, кроме каких-то простейших случаев нейрофизиологических рефлексов (и то — до момента, когда я не соображу, что эксплуатируются мои рефлексы, я и рефлексы отрегулирую).
Ещё один аргумент в пользу использования объяснительных теорий в инженерии появляется, когда вы замечаете, что в книжках Талеба ничего не говорится о коллективной работе. Рассуждения Талеба хорошо работают, когда речь идёт о рынке, где никто друг друга не знает, почти ничего не известно о товаре и ситуации его использования, но происходят крупные одиночные сделки между незнакомыми людьми (сам Талеб как раз профессионализировался на торговле ценными бумагами, он был трейдером на фондовом рынке). Если мы хотим хорошее инженерное мышление передать другим инженерам, но не понимаем, из чего это мышление состоит, что передавать, то есть у нас нет инженерной науки/engineering science, нет методологической проработки инженерии (например, нет руководства по системной инженерии типа того, который вы сейчас проходите), то всё сведётся к малопродуктивной охоте и собирательству относительно талантливых «стихийных инженеров». Охота и собирательство талантливых людей хороши, но переход к «осёдлому земледелию», то есть обучение инженеров хорошим объяснительным теориям того, что они должны делать, даёт скачок в производительности труда — выращивать таланты оказывается много дешевле, чем их выискивать и затем пытаться перекупить (обычно к тому времени, как становится понятным, что это талант, он уже достаточно дорого стоит).
Так что сначала нам нужна какая-то инженерная наука/исследования/объяснительная теория, чтобы знания по инженерии (как именно надо вести инженерный проект, чтобы он на выходе дал успешную систему) компактно описать — и уже после этого мы их можем передать в ходе обучения (наше руководство как раз и передаёт такие знания SoTA инженерной науки). Не надо обольщаться, что это «всем известные знания». Тем более, что все эти знания эволюционируют. Например, наличие «всех согласованных требований по проекту» в инженерии не считалось необходимым ещё в начале прошлого века, ближе к концу века сбор и согласование всех требований (даже метод для этого был — «инженерия требований») стали обязательными, это была SoTA системной инженерии. Теперь наличие требований уже не считается SoTA — и в нашем руководстве для этого аж два подраздела: в первом говорится, что «требований уже нет», а во втором — «если вы не поняли сразу, что требования уже не SoTA, мы это повторим». И процесс явно не закончен: если вначале готовились сценарии использования, из которых формулировали требования, потом из сценариев использования формулировали тест-кейсы, то теперь говорят уже о том, что эти наборы тест-кейсов и есть формат, в котором описываются гипотезы (не требования!) по надлежащему поведению системы в разных ситуациях, при наступлении разных событий. Инженерное знание эволюционирует, инженерная наука выдвигает новые и новые догадки/гипотезы о том, как может быть (а в случае нормативной науки — как должен быть) устроен инженерный процесс, какова инженерная культура.
Инженерная работа обычно не делается людьми-одиночками, исполняющими все-все-все инженерные роли, при этом исполняющими «по зову сердца», а не по какой-то «науке», какому-то заданному культурой методу (читай: методу, который используют люди в сообществе инженеров, а не кулибины-одиночки).
В инженерии нужна координация усилий сотен, тысяч и даже десятков тысяч людей, работающих как с целевыми системами в их окружении на самых разных уровнях, так и с организационными системами в графах создателей этих систем. Все эти люди с их самыми разными проектными/деятельностными/трудовыми ролями должны как-то договариваться между собой. Как они могут договориться, если каждый про свою часть дела может рассказать примерно столько же, сколько едущий на велосипеде мальчик про свою езду?
В инженерии можно, конечно, говорить на уровне формальности «я чувствую, что я держу равновесие и я чувствую, что на большой скорости надо бы пригнуться», но обычно всё-таки требуются более формальные описания, более точные, по которым можно точнее воспроизвести описываемые явления. Компактные и универсальные объяснительные теории нужны в инженерии, чтобы люди могли иметь одинаковое описание того, что они делают, чтобы они договорились между собой. Все участники инженерного проекта, если они описывают один и тот же объект, будут использовать одно и то же SoTA компактное описание важных объектов в инженерном проекте, и эти важные объекты описываются задействованными объяснительными теориями. А поскольку теории хорошо прокритикованы (это же SoTA теории, которые выдержали критику логикой и экспериментами), то огромная вероятность того, что описание сработает и даст ожидаемый результат. Так, было очевидно, что если хорошо подумать о системе «на верхнем уровне», то результат проекта будет лучше. Поэтому самые опытные разработчики занимались «системной архитектурой» как важнейшими принципами, на которых организована система, что бы это ни было. Развитие инженерной науки показало, что у этих «опытных разработчиков» было две самых больших экспертизы — функциональный синтез (а не функциональная декомпозиция!) и модульная декомпозиция (хотя говорилось как раз о модульном синтезе!). А с приходом эволюционной архитектуры стало понятно, что изменение функций плохо реализуется в ситуациях, когда проделана плохая модульная декомпозиция, модули слишком сильно зависят друг от друга. Это привело к углублению разделения труда: сначала роль «архитектора как опытного разработчика» была уточнена как новая роль архитектора, который занимается не функциональностью и расчётами принципиальных схем верхнего уровня, но архитектора, который занят оптимизацией межмодульных зависимостей и нарезки/разбиения на модули такого, при котором сохраняются важнейшие характеристики работы системы в целом (прежде всего — evolvability/развиваемость), а потом выделилась и новая роль — методолога, который занимается главным образом функциональными описаниями системы, абстрагированными от разбиения системы на модули. SoTA инженерного процесса (какими делами/«методами работы над какими предметами методов» надо заниматься в инженерных проектах каким инженерным ролям) поменялась, а нормативный характер системной инженерии говорит, что «надо» трактуется как обязательность к применению. Если у вас архитектура в проекте что-то другое, то ваш проект идёт не как «надо», это не SoTA, это менее оптимально. Ну, или вы работаете на фронтире, проверяете новую догадку, работаете над умной мутацией инженерного процесса. Предметом «инженерной науки» ведь является инженерный процесс, он же процесс разработки — все методы работы, которые задействуются в ходе создания и развития успешных систем. Это обсуждалось в руководстве по методологии, но там не говорилось, какой именно инженерный процесс и какие роли его исполнителей являются на сегодня SoTA.
Излагаемый в нашем руководстве по системной инженерии общекультурный (на базе SoTA в самых разных инженериях — прежде всего программной инженерии, классической системной инженерии, инженерии предприятия и т.д.) метод безмасштабной эволюционной системной инженерии (или просто «инженерии», безо всех этих эпитетов, ибо другая инженерия — это уже не SoTA) совершенно необязателен для инженеров-одиночек, для которых инженерия — это хобби.
Среди одиночек всегда найдётся Кулибин или Левша (вот пример описаний такой работы, он так и называется, «Кулибинство»134). Но вот если речь пойдёт о какой-то более-менее масштабной коллективной инженерной деятельности, то синхронизация способов обсуждения инженерного проекта может сэкономить много-много времени — все ведь помнят проблему, возникшую при строительстве Вавилонской башни? Мы как инженеры должны научиться описывать другим людям, что мы делаем и почему, чтобы другие люди могли присоединиться к нашему проекту и, сотрудничая, занять свою роль.
Конечно, если вы умеете что-то описывать и в инженерии киберфизических систем, и в синтетической биологии как инженерии живых систем, и в менеджменте как инженерии организационных систем, и в социальной инженерии, и в любой другой инженерии — это вовсе не означает то, что вы опишете ценное и важное для проекта, а не просто «что-то».
Инженер может плохо работать с описаниями. И даже неинженер может плохо работать с описаниями! Если взять художественную литературу как описание вымышленных миров (неинженерная деятельность, если автор не ставит задачей как-то изменить личность читателя): графоманам никогда не получить Букеровскую премию, хотя они умеют писать, и иногда даже «красиво писать», то есть писать беллетристику, то есть умеют записывать свои идеи по поводу мира на материальном носителе в форме, доступной для прочтения другими людьми. В целом «умения читать-писать» и как-то (а не профессионально) излагать какие-то (а не предписываемые профессией) мысли для инженерии недостаточно. Это относится и к людям, и к AI — интеллект у них может быть очень разный, но болтливый и красноречивый создатель, не придерживающийся достижений инженерной науки, не знающий методов системной инженерии и предлагаемого этими методами разделения труда, может быть крайне неэффективным, а часто и вредным: будет забирать время, которое можно было бы потратить на что-то полезное другим людям. Если у вас, конечно, инженерный проект, а не концерт — на концерте болтливым людям дают микрофон, они могут хорошо шутить-развлекать, но не более того.
Но и если вы научитесь думать об архитектуре киберфизической системы, предприятия или даже общества, научитесь компактно «по науке» записывать свои мысли на эту тему, то есть документировать ваши архитектурные решения, это вовсе не означает, что вы действительно придумаете в этих решениях что-то интересное и важное, сделаете архитектурную новацию. Зубрилки необязательно генерируют интересные идеи о том, как использовать то знание, которое они выучили.
То же про концепцию использования, концепцию системы, способ документирования функциональности через набор тестов, и так далее по всем наставлениям нашего руководства и рекомендованной в нём литературы.
Есть исследование, которое показывает, что знания «из опыта» и знания «из учебника» (знания о методе работы «по регламенту», «согласно руководству») вообще не пересекаются — это изучалось на детях, которые учили арифметику в школе и которые работали где-нибудь на рынке, где надо было много решать арифметических задач. Оказалось135, что «отличники в школе» и «умеющие считать» — это разные группы людей, и «умеющие считать» в школе не могли решить ни одной задачи, а «отличники» не могли выполнить никаких действий в реальных ситуациях! Это беда, ибо «отличники» оказываются в жизни бесполезными, а «умеющие считать» явно ограничены в потолке своего мастерства — дальше арифметики они явно не пойдут, интеграл не посчитают (они о нём и знать не будут). Оказывается, нужно ещё уметь
-
совмещать «яблоки из жизни» и «яблоки из задачи» (разбиралось в «Системном мышлении»),
-
наработать необходимую скорость в выученных операциях.
«Думать и придумать» в этом плане похожи на «учить и выучить», «делать и сделать» — процесс ничто, даже если вы делаете его абсолютно правильно, хороший результат всё. Если даже вы «зубрилка методов системной инженерии», не факт, что вам будет удаваться практическая инженерная работа, работа «в жизни». Для этого надо будет ещё попотеть.
Например, вам просто может не прийти в голову удачная идея, хотя вы будете отлично знать, какого сорта идея нужна, и сможете грамотно её задокументировать. Тут, конечно, можно схитрить — задать вопрос об идее AI-агенту. А потом попросить покритиковать эту идею этого же AI-агента. Но надо таки будет соображать, что именно просить, а также надо сообразить, что пошло не так — ибо AI-агент (точно так же, как человек!) может дать неожиданный ответ, или ответить безошибочно для одной ситуации, а у вас будет другая ситуация, поэтому ответ будет ошибочен. В любом случае, надо будет быстро (это ключевое слово! Не как «английский со словарём», «системная инженерия с учебником») ориентироваться в ситуации вашего проекта, отождествлять объекты мета-мета-модели системной инженерии с инженерным процессом, инженерной культурой вашего проекта.
Если не работать «как надо», то тогда не придумаешь ни плохого, ни хорошего: без процесса не будет и результата. Если идея придёт в голову, но ты не знаешь, что нужна именно такая идея, ты пройдёшь мимо неё. Или ты не сумеешь её задокументировать, её не поймут коллеги. Если не учить, то и не выучишь. Если не делать по культурной норме, то и не сделаешь что-то культурное — а уж интересно оно будет, или не слишком интересно, это для несделанного неважно. Процесс важен, без него не будет результата. Инженерный процесс «по науке» (предмет нашего руководства) важен, без него не будет профессионального результата.
Инженерный процесс может быть кулибинским (смекалка и натиск!) или «по науке» (например, согласно наставлениям нашего руководства). В первом случае для небольших проектов вполне может быть случайно получен хороший результат, хотя и с очень небольшой вероятностью. Во втором случае, «по науке», хороший результат может быть получен более-менее надёжно, причём и в сложных случаях тоже. Если вы не разрабатываете концепцию использования, концепцию системы, не принимаете явно архитектурных решений, не заботитесь об управлении конфигурацией (и даже не знаете, что такое «конфигурация» и как ей управлять), то хороший результат у вас может быть случайно, и только в небольших проектах.
Скажем, система будет выполнять свою функцию, «изобретение будет работать», в первой версии. Дальше вопрос о том, думали ли вы об архитектуре специально: архитектурные решения делают эту систему прежде всего развиваемой, то есть способной к изменениям в будущих версиях, а ещё надёжной, масштабируемой, производительной, легко ремонтируемой и т.д. — и нужно знать, что эти проблемы решаются архитектурно, а не просто спонтанным «изобретательством в ходе разработки».
В больших и сложных (а для начинашек и тот проект, который для опытных инженеров «маленький и простой» будет «большим и сложным») проектах нужно осознанно действовать «по науке», использовать знание SoTA инженерного процесса, SoTA разделения труда в инженерии. Системная инженерия — нормативная наука, она требует работы по указанному методу. Так, в больших проектах обязательно нужно делать в системе-создателе «тёмную холодную фабрику»/«автоматизированный конвейер»/pipeline/«internal development platform» и в порядке разделения труда иметь роль инженера этой платформы (иногда по-старинке используют название DevOps, и там уже разные варианты, вплоть до NoOps136, намекающие на отсутствие людей, нужных для работы платформы). А для того, чтобы такой «конвейер» работал, надо принимать жёсткие архитектурные решения по конструкции системы. Когда вы работаете в инженерном проекте, надо знать, почему делают так или иначе (например, почему нехорошо считать, что в вашем проекте «водопад» в управлении жизненным циклом), почему это работает или не работает, что будет, если этого не делать. Каждый инженер поэтому должен быть методологом, чтобы уметь мыслить о методах не только своей личной работы, но и методах работы в коллективном проекте, в котором он участвует.
Поскольку системная инженерия — нормативная «инженерная наука», то после освоения мышления по нашему руководству вы ровно так и должны думать о всех ваших проектах, как в нашем руководстве описано. Повторим: то, что вы «должны думать именно так, чтобы проект оказался успешным» — это и есть «нормативная наука», её результаты обязательны к применению, должны (а не «могут») браться всерьёз!
Но не эквивалентно ли это «секте», предписывающей какое-то определённое мышление? Если считать всех инженеров мира (и не только инженеров, ибо не все создаваемые системы в мире считаются «инженерными» сегодня) «сектой», то да. Ибо во всех успешных инженерных проектах работают с концепцией использования и концепцией системы, разрабатывают архитектуру, изготавливают целевую систему и меняют её какими-то инкрементами, обязательно делают инженерные обоснования, и т.д. Во всех любительских проектах «не секты» якобы «творческие свободные люди» (любители!) могут что-то из этого не делать, потому что не понимают, что это делать надо. И получают любительский инженерный результат, кулибинство, продукт хобби, «ручная уникальная работа» вместо промышленной разработки. Будьте профи, пользуйтесь в проектах знаниями инженерной науки!
Так что инженерная наука (engineering science) нужна, хотя мы точно знаем, что инженерия («инжиниринг», как сейчас всё чаще говорят, или «системная инженерия», как говорят пока ещё редко) не сводится только к использованию научных знаний. Инженерам самых разных систем (неживых, живых, общественных) нужны компактные описания самой разной инженерии (классической, менеджмента как инженерии оргсистем, инженерии систем самой разной природы, самых разных видов на всех масштабах размеров и времени) как минимум для того, чтобы договариваться с другими людьми (и не только людьми) об инженерии успешных целевых систем и организации графов создателей для непрерывного развития этих целевых систем-как-видов, а также непрерывного развития создателей в непрерывно развиваемом их графе.
Но хорошего знания системной инженерии, дополняемого хорошим знанием прикладных предметных областей тоже недостаточно для успеха инженерного проекта. Многие ваши действия «по учебнику» будут приводить к результатам, которые не совпадают с ожидаемыми «по учебнику». Это неизбежно, и в этом случае нужно включать фундаментальное мышление и разбираться с ситуацией при помощи силы интеллекта, а не известных вам предписаний прикладного метода и его нормативной науки. И, конечно, тут вполне возможно опираться на эвристики, пока нет точной объяснительной науки. А сила мышления — это задействование интеллект-стека фундаментальных/трансдисциплинарных методов мышления, найдите время ознакомиться с их содержанием в руководстве по интеллект-стеку. Так, все знают, что инженерам нужно знать математику и физику — зачем знать, и что из этих знаний нужно иметь, если всю математику и всю физику берут на себя AI-агенты, вы как раз и узнаете из руководства по интеллект-стеку.
Инженерам также нужны компактные описания мышления/познания (логики, онтологии, алгоритмики, методологии и т.д.), чтобы договариваться о своих моделях и действиях с другими инженерами, то есть чтобы реализовать коллективное мышление — это тоже отсылка к трансдисциплинарному мастерству мышления по интеллект-стеку.
Чтобы построить ракету, которая принесёт на Марс очередной вертолёт, надо организовать инженерный проект. В качестве основного способа инженерии для такого проекта метода проб и ошибок явно недостаточно. Надо обсуждать и то, как заняться методологией полёта на винтокрылых аппаратах, и то, как принимать архитектурные решения и какие архитектурные характеристики важны в данном проекте, надо знать об обратном манёвре Конвея, надо обязательно проводить инженерные обоснования. Обо всём этом будет в нашем руководстве (хотя честно признаемся, что само это руководство больше аннотированный сборник литературы — детальные знания по всем этим темам будут не столько в наставлениях руководства, сколько в рекомендованной литературе). Тем не менее, инженеры в таком сложном проекте будут использовать также и метод проб и ошибок, и будут использовать эвристики/суеверия, но культурные инженеры ещё и будут уметь об этом говорить и будут уметь избегать новичковых ошибок в работе.
Системные инженеры киберфизических систем строить такие ракеты «и научно, и ненаучно» научились, а менеджеры (инженеры организаций) научились строить и эксплуатировать такие организации, которые могут выполнять такие инженерные проекты, а социальные инженеры научились строить такие общества, в которых такие организации становятся возможными, а инженеры личности научились развивать такие личности, которые работают в таких проектах, а инженеры систем AI научились создавать такие AI-системы, которые уже достаточно умны и собранны, чтобы быть полезными в подобных проектах.
Инженерная наука
Инженерная наука (engineering science), ищущая компактное описание для SoTA инженерии, должна рассказать об инженерии как культуре инженерного сообщества. Она отвечает на вопрос о том, что делает создатель в роли инженера (или в одной из составляющих архироли инженера) в ходе инженерного проекта.
Отношение к системной инженерии как к науке среди системных инженеров киберфизических систем обычно отрицательное (хотя они и признают её полезность). Это отношение связано с тем, что «наука» (объяснительные теории, научное знание) обычно никогда не рассказывает, как породить ту или иную идею и потом как эту идею проверить и реализовать. Знания, которые даёт наука, как «формальная модель/теория» хороши для критики, для нахождения ошибок, они дают строгие типы, которые позволяют проще находить логические несоответствия. Вы легко заметите, что в ваших же предложениях по проекту не так, если будете знакомы с инженерной наукой, если узнаете её хотя бы в объёме нашего текущего руководства. Поэтому вы сможете выдвигать идеи, имеющие шанс быть реализованными, остальные не пройдут вашу же критику. То же самое относится к идеям других. Но вот можете ли вы выдвинуть какую-то достойную идею? Не факт. Помним, что рассуждение тут идёт по трём стадиям обучения (тут для инженерии, но это верно для любого метода работы):
-
Вы изучаете материал учебника (pretraining) по инженерии, с жизнью это пока никак не связано, собранности на нужных объектах и удерживания их во внимании в длинных рассуждениях нет, каждый отдельный объект в его отношениях с другими объектами знаком, но длинных рассуждений не получается, а ещё не получается связать объекты из учебника с жизнью.
-
Вы знакомитесь с тем, как работают люди (finetuning), как они мыслят в типовых ситуациях и как рассуждают про связь «яблок из учебника» (их же там считают!) с «яблоками из жизни» (их же едят! Причём тут подсчёт!). Это в обучении AI обычно называют RLHF (обучение с обратной связью от учителя), и тут засада: вы будете повторять типовые ходы уровня ваших учителей в таких проектах, которые видели ваши учителя. Но вы вряд ли сможете превзойти ваших учителей. Это как насмотреться на задачи, для которых есть пошаговые способы решения с ответами. Если вы увидите примерно такую задачу, вы её решите. Если увидите другую задачу — не решите, ибо не знаете, как решать. Собственно, именно тут знание учебника становится жизненным, а не абстрактным знанием. Поздравляю, вы хороший подмастерье, но сами ещё не способны работать мастером.
-
Вы решаете много задач, для которых ответ вроде как известен (успешная система). Но вот решение «по действиям», метод достижения решения неизвестен. Поэтому приходится делать догадки (заниматься творчеством), проверять их — и запоминать паттерны уже своей работы, а не паттерны из учебника. Вот тут надо иметь предельную собранность, вот тут надо иметь хорошее знание учебника и понимание, как решать задачи пошагово, чтобы отсекать неперспективные догадки. Это обычно называют «приобретением опыта» (при этом понимаем, что у вас должно быть большое разнообразие ситуаций и придуманных вами решений, чтобы это был, например, «двадцатилетний опыт», а не «однолетний опыт, повторенный двадцать раз, безнадёжно устаревший уже на пятый год»).
Конечно, вы можете всю эту умственную работу отдать AI или (если вы начальник) любому вашему сотруднику, но это тогда можно будет отдать AI или другому сотруднику и без вас, посредники не нужны. Вы должны понимать, что оставить из мышления себе, а что отдать — и как потом собрать сделанную работу, чтобы проект с приложением ваших мозгов был более успешен, чем без вас.
Без «науки» тем самым трудно решать практические задачи, ибо предлагаемые решения будут вести к неэффективности, переделкам из-за ошибок, неудачам, но сама наука обычно ничего не говорит о том, как породить идею решения. Инженерия тут ничем не отличается от любой другой деятельности, где идеи рождаются «из шума». Конечно, какие-то закономерности в эволюции уже можно обсуждать, поэтому мутации вблизи какого-то локального оптимума динамического ландшафта приспособленности, но вам-то надо выдать догадку, которая ведёт потенциально не к текущему локальному оптимуму, а к глобальному оптимуму — и часто на то место в этом ландшафте, которое только-только должно появиться! Когда-то Bill Gates сказал, что компьютер будет на каждом рабочем столе, и на нём поэтому будет операционная система, которую разрабатывает Microsoft. Это как с Уэйном Гретцки137, которого спросили, как он всё время оказывается там, где шайба? Он ответил, что оказываться там, где шайба — невозможно. Но можно оказываться там, куда шайба вот-вот придёт. Вот инженеры в проекте заняты именно этим: они делают догадки даже не по текущей ситуации, а догадки о той ситуации, которая будет. Недаром теория стратегирования дана сейчас в конце руководства по методологии.
В инженерной науке по факту речь идёт о «человеческой деятельности» (а сейчас уже — об «агентеческой деятельности», не забываем, что в одном из определений AGI — это алгоритм, способный реализовать проект по зарабатыванию им денег). Как устроена деятельность (виды труда, методы работы) людей, компьютеров и их организаций, объяснения того, какие важные в ней выделить объекты, как описать — это задача методологии, объяснительной теории, увенчивающей интеллект-стек как раз перед системной инженерией.
Беда в том, что если вам нужно породить новый метод, то есть стратегировать, то непонятно как сделать догадки о важных в ней объектах. Скажем, в инженерии вам надо описать целевую систему перед тем, как её изготавливать, но как догадаться, что она вообще нужна? Как догадаться, как она может быть устроена? Как описать это так, чтобы можно было воплотить эту систему в физическом мире со стоимостью меньшей, чем ожидаемые выгоды от её применения? Как обосновать эти догадки (как сделать инженерные обоснования, там ведь тоже непонятно, какие из множества известных методов инженерных обоснований задействовать)? Как потом воплотить это всё в жизнь, то есть принять решения на основе гипотез в условиях полной неопределённости, «принять всерьёз»? И это даже ещё не «сделать», результат выполнения работ по тщательно выбранному методу ведь может быть абсолютно неожиданным — если что-то может пойти не так, то оно обязательно пойдёт не так!
Методология рассказывает о том, какие есть в мире объекты, их характеристики и отношения друг с другом, что можно с этими объектами делать. Что с этими объектами делать для решения конкретных задач — неведомо, надо высказывать догадки и проверять их. Никакое знание физики не позволяет само по себе решать даже олимпиадные задачки по той же физике, что уж говорить о решении реальных проблем. Но без знания физики и олимпиадные задачки, и инженерные проблемы решать труднее, вы будете считать потенциально верными догадки, которые заведомо неверны, будете тратить на эти догадки драгоценные ресурсы, терять время и нервы.
Наука/исследования аналитичны, они посвящены критике догадок, их опровержению — при помощи теории, которая сама когда-то была хорошо прокритикованной догадкой, но выстояла перед критикой и экспериментами.
Инженерия связана с решением проблем (проблема — когда никто не знает, что делать, метод неизвестен, часто даже предметная область метода неизвестна), поэтому она требует сильного интеллекта. Инженерия связана с творчеством/изобретательством (помним про раздел, посвящённый творчеству в руководстве по системному мышлению). Творчество нельзя выполнить алгоритмически «быстрым выводом по правилу», оно связано с базирующимися на случайностях и запоминании удачных случаев меметическими алгоритмами, выполняемыми или компьютерами, или людьми, или гибридно целыми коллективами людей с их компьютерами. И да, «ум» AI-систем тоже базируется на случайности, на умении делать догадки — и критиковать их, отбрасывая заведомо неуспешные, чтобы на выходе остались только догадки с максимальной вероятностью успеха, наиболее устойчивые к критике логической и критике экспериментальной.
К сожалению, сведение всей инженерии только к науке («нет теоретического обоснования — не инженерия») и «аналитике/критике» без сопутствующих догадок по синтезу в ущерб практической деятельности по решению проблем, в том числе с помощью «ненаучных» по своей природе догадок-эвристик-гипотез-суеверий отражено и в учебных курсах по инженерии систем самых разных уровней, и в профессиональных руководствах и стандартах. Так, по отношению к киберфизическим системам руководитель NASA Michael Griffin в речи 2007 г. (и с тех пор в образовании по околовоенной и государственной системной инженерии киберфизических «железных» систем мало что изменилось, наше руководство тут сильно отличается, как и современные руководства по программной/software инженерии) «System Engineering and the Two Cultures of Engineering»138 даёт критику расхожего инженерного образования, которое учит «аналитике/критике/объяснениям», а не инженерии:
I have always loved the view of the engineering profession captured by the great Theodore von Karman when he said, "Scientists study the world as it is; engineers create the world that has never been." Less eloquently, engineers are designers; they synthesize knowledge to produce new artifacts. Von Karman speaks to what most of us, and certainly most laymen, would consider the essence of engineering: engineers create things to solve problems.
But all of us who are engineers know that the engineering profession also has a rich scientific side, the analysis of these artifacts and the prediction of their behavior under various environmental and operational conditions. Adapting von Karman's observations, it may be said that engineering science is the study of that part of the world which has been created by man.
Sadly, many students have been led to believe that engineering science is engineering! In a curriculum of 120 or more credits leading to a bachelor's degree in a branch of engineering, the typical student is required to take one, or maybe two, courses in design. Everything else, aside from general-education requirements, focuses on the analysis, rather than the creation, of engineered objects. Graduate education often has no design orientation at all. So, engineering as taught really deals with only a part of engineering as it is practiced.
Переводя на более привычные реалии жизни, инженерное образование даёт не инженеров-синтетиков, не проектировщиков, а только аналитиков — которые умеют только критиковать (и, конечно, давать предложения без принятия на себя за них ответственности — но это неформально, этому не учат, курсов проектирования/design крайне мало).
Вы думаете, что это верно только по отношению к системной инженерии? Нет, то же самое верно по отношению к инженерии предприятия, то есть менеджменту. По идее, учебные программы MBA (магистры бизнес-администрирования) были задуманы как выпускающие менеджеров, способных развивать свои предприятия — стратегов, бизнесменов, оргпроектировщиков. Но нет. Исследователь менеджмента Henry Minzberg написал целую книгу «Managers not MBAs»139 об этом: в программах MBA учат аналитике — после окончания этих программ у людей отличные карьеры начальников аналитических отделов (которые готовят аналитические отчёты, но которые не принимают никаких решений и не вырабатывают никаких решений), начальники финансовых служб (которые не принимают никаких управленческих решений, но зато отлично следуют правилам налогообложения). А менеджмент? Minzberg говорит ровно то же — это синтетика, не аналитика. Менеджмент как инженерия предприятия — это прежде всего творчество, умение делать догадки, решающие проблемы, снимающие противоречия — и эти догадки даже не по поводу теории, не «исследовательские», а по поводу ситуации в будущем. Менеджмент, как инженерия предприятия — он в этом, в творчестве, в синтезе, а анализ носит вспомогательную роль, он обязателен, но это только критика. Да, его можно вынести в «отдельную аппаратуру» (помним, что мы буквально пару подразделов назад обсуждали работу140, что общее умение думать не зависит по качеству результата — отдали ли мы критику «спецаппаратуре» или критикуем сами, сразу после высказывания догадки. Но без догадок критиковать нечего!). Совсем недаром программы MBA сегодня не любят детально рассказывать о том, чему же они учат — ибо очевидно, что на выходе такой программы не будет кого-то типа Bill Gates, Jensen Huang, Elon Musk. Как ни странно, все эти великие менеджеры вышли из инженерных вузов, и это не случайно. А на что заманивают в программы MBA? Посмотрите: там заманивают на то, что у вас будет хорошая компания, статусные одногруппники, вам дадут пообщаться с разными успешными людьми. Это не похоже на обучение какой-то науке!
В какой-то мере этот тезис примата творчества/синтеза над аналитикой/критикой подтверждается опытом мастерской инженеров-менеджеров: на стажировку по системному менеджменту в мастерскую приходят выпускники программ MBA, и от многих из них после выпуска независимо поступают отзывы, что «только сейчас стало понятно, чему учили на MBA и как это использовать». Конечно, аналитика важна — если знать её место в инженерии «железной», программной, предприятия (в случае MBA), личности и мастерства в составе личности!
И то же самое можно говорить о создании и развитии систем самых разных масштабов и видов, включая общественные: инженерия всех них подразумевает создание нового, высказывание труднокритикуемых догадок, которые выживут всю рациональную критику (включая и логику, и эксперименты). Критика тут крайне важна, но вспомогательна. Критика тут играет роль естественного отбора в эволюции, она как куратор галереи. Но главный в галерее не куратор, а артист! Куратор важен только для того, чтобы отобрать достойного артиста. Эта метафора взята из биологии развития141, но она вполне подходит не только к эволюции-инженеру, но и к людям-инженерам, AI-инженерам.
Основное, что должен уметь делать системный инженер, как создатель — это создавать успешные системы, менять мир к лучшему, придумывать, как это сделать, а анализировать/критиковать/объяснять эти системы и свои методы работы — это важная, экономящая ресурсы, время и нервы, но подчинённая синтезу задача. Упор на квазиоптимальный синтез и непрерывные попытки его улучшить и вписать результат в непрерывно меняющееся окружение, а не упор на «строго научный анализ и безупречное обоснование» характеризует инженера. Обоснование важно, но оно уместно только тогда, когда есть что обосновывать!
Так что в учебных программах нужно учить в том числе и создавать (а хоть и опираясь на генетические/эволюционные алгоритмы), а не только объяснять и критиковать!
Всё-таки нужно владеть методом системной инженерии (его излагает на кругозорном уровне наше руководство), а затем нужна конкретизация этого метода для целевых систем самой разной природы, которыми приходится заниматься в рабочих проектах (будь то вещества, киберфизические системы, существа, личности, организации, сообщества, общества или даже человечество в целом), то есть нужно будет освоить работу ещё и по методам самых разных прикладных инженерий (программной инженерии, механической инженерии, генной инженерии, инженерии киберфизических систем, социальной инженерии, хореографии и т.д., их огромное разнообразие). А поскольку одному человеку всё это богатство прикладных инженерий для успеха проекта познать невозможно, то дальше нужно будет думать, как учить инженерии даже не одного человека, а целую инженерную команду, каждый член которой будет хорошо выучен фундаментальной системной инженерии, но потом немного разному набору прикладных инженерий. Впрочем, это всё про людей. Опыт показывает, что AI вполне можно научить самым разным инженериям — и каждые несколько месяцев в очередной прикладной области инженерные умения AI вырастают до степени, уже сравнимой с уровнем людей, и даже превосходящей их.
Но главное — это не забывать, что инженерия сводится не к описанию мира, а изменению мира, улучшению мира. Описывать мир — это не заниматься инженерией, даже если описываешь инженерные проекты. Аналитика, глубокое знание дисциплин — это не инженерия. Один из системных инженеров NASA как-то привёл пример, в котором сравнивал инженерную науку (в том числе ту, которой обучают в университетах) с порнографией: можно сколько угодно тратить времени на «аналитический» просмотр и обобщение бесконечного числа порнофильмов, но все эти часы и часы псевдоопыта «изучения» и «аналитики» можно было бы потратить на получение собственного опыта «синтетики», опыта действия, получив при этом не меньше удовольствия, чем от «аналитического» просмотра порно. Ну, и овладение всеми возможными классификациями увиденного, знакомство с хитрой терминологией и прочие «атрибуты научности/аналитичности», почерпнутые из просмотра видео могут абсолютно не помочь (а то и помешать) в конкретной жизненной ситуации, требующей синтеза, а не анализа — ибо надо не описывать со знанием дела, а делать со знанием дела! Сегодняшние системные инженеры NASA предлагают больше уделять внимания творческой/синтетической работе в проектах, а не заниматься чтением учебников и руководств по инженерной науке. С этим сравнением нельзя согласиться:
-
Инженерная наука сегодняшнего дня (эти строки пишутся в 2025), опирающаяся на современную системную методологию третьего поколения (выходящую на масштаб времени техноэволюции, а не только жизненного цикла одной версии системы), абсолютно другая, нежели даже пять лет назад, когда стало очевидно, что революция continuous delivery и в программной инженерии победила массово, и в «железной» инженерии. Чтобы заниматься инженерией прошлых дней, надо было читать учебники прошлых дней, а затем как-то продвигаться вперёд, заниматься мутацией её методов. Это видно по стилю работы SpaceX сначала над Falcon 9, затем над Starlink, затем над Starship. Инженеры SpaceX имели большой опыт работы в NASA, а затем они преодолели тамошние недостатки. NASA с тамошними технологиями и воззрениями выглядит сегодня по части творчества уже отстающей организацией, там не соблюдается баланс высказывания гениальных догадок и последующей их критики. Поэтому бесполезно не читать учебников вообще, но полезно читать современные учебники, куда вошли SoTA инженерные методы, SoTA инженерная наука. В современные учебники, конечно, вошёл опыт SpaceX и многих других передовых инженерных компаний — в том числе и то замечание, что опыт передовых «железных» компаний является по факту опытом компаний программной инженерии, причём осваиваемый с большой задержкой (лаг 5-10 лет). Современные учебники/регламенты/стандарты/руководства пытаются сократить этот лаг, как это делает и наше руководство.
-
Методы обучения мастерству инженерии стали совсем другими. Так, сегодня очевидно, что наука даёт типы объектов внимания, которые являются мета-мета-моделью к типам мета-модели предметной области (общекультурной и конкретного варианта в вашем предприятии), а та в свою очередь задаёт типизацию конкретных объектов в конкретном проекте в жизни, то есть типизацию (операционной) модели. Вот этой работе с типами и нужно учить, в этом залог привязки теории к жизни. Применимость знаний системной инженерии непосредственно связана с умением обращаться с абстрактными/идеальными объектами, они же объекты ментального пространства, но отнюдь не во всех вузах инженеров этому учат явно, как и не учат всегда привязывать эти объекты к каким-то ситуациям в физическом мире, заниматься заземлением/grounding. Отсюда и легенды о «неприменимости знаний в жизни». Не «неприменимость», а «неумение применить»!
-
Сама инженерия стала сложнее, и просто «пробовать работать» уже не получится: слишком низка вероятность хорошего результата. Нужна теория, даже если она и не закрывает 100% встречающихся проблем. Никакая теория не закрывает 100% проблем и всегда нужно подключать фундаментальное мышление, а также всегда нужно подключать меметические алгоритмы и делать на их основе какие-то догадки, а не «всё выводить из теории». Но если не опираться на теорию, а основываться исключительно на «смекалке и натиске», то всё в проекте будет медленно и ресурснозатратно, со скоростью естественной, а не «умной» эволюции: успешной системы вы или не создадите, или успех будет очень кратким. Мутации должны быть «умными», и желательно поэтому не просто «догадываться» о них, но и проверять критикой на основе теории. Если вы догадались, что ответом на 2*2 может быть 5 — используйте теорию, чтобы это проверить, не берите до этого вашу догадку всерьёз!
Системные инженеры постулируют примат инженерного опыта над инженерной наукой, хотя также и признают важность науки (ибо без признания важности науки можно скатиться назад, к древним временам инженерии исключительно проб и ошибок, не оптимизированной моделированием/теоретизированием эволюции), просто оформляемый эвристиками инженерный опыт на любой момент времени много, много больше той территории, которая уже отвоёвана наукой с её хорошо проведённой критикой удачных догадок, дающих компактные объяснительные модели.
Наше руководство по (безмасштабной и эволюционной/непрерывной, а также неантпропоцентричной) системной инженерии решает вопрос о балансе методов, описанных в инженерной науке и не описанных в этой науке методов инженерной «возни»/tinkering так:
-
Руководство активно использует интеллект-стек фундаментальных методов мышления, хотя и не все методы этого стека (скажем, нет математики, физики, эстетики, риторики). Тем не менее, перед освоением работы по руководству надо уже как-то быть готовым к полностью новым ситуациям, которые не описаны в известных учебниках/руководствах/стандартах/регламентах, и надо уметь как-то ориентироваться в таких ситуациях (причём не только путём обращения к AI — к нему и без вас обратятся, вы лично не нужны для этого, если только не знаете, как именно надо обратиться к AI, чтобы это оказалось полезным — а другие не знают. Это то же разделение труда). Какая-то сила интеллекта — пререквизит к системноинженерной работе. Если вы освоили исследовательскую программу развития инженеров-менеджеров (руководство по интеллект-стеку как раз в ней), это сильный плюс.
-
Сначала наше руководство в первой паре разделов даёт самую общую объяснительную теорию инженерной нормативной науки, включая объяснения границ применимости этой теории (объяснения границ применимости — это как раз текущий и предыдущий подразделы руководства).
-
Знание принципов освобождает от знания множества фактов. Инженерам нужно сразу знать (а не догадываться по ходу проекта), каковы основные объекты, с которыми работают инженеры в их многочисленных ролях, как бы они ни назывались в разных предметных областях. Это «нужно» — нормативный аспект теории, например, «вы как архитектор должны принимать архитектурные решения в вашем проекте, понимая приоритеты в реализации архитектурных интересов», и т.д. Это основной материал руководства, он изложен в следующих разделах. И если «нужно» и «вы должны» (деонтическая модальность), значит — нужно, и должны. Это значит — мало читать и знать, ещё надо реально делать в проектной работе. У нас в руководстве наставления на работу, их нужно выполнять, брать всерьёз!
-
Руководство содержит отсылки к конкретизациям методов и ролей системной инженерии главным образом для «железной» и программной системной инженерии. Есть отсылки и к конкретизациям методов системной инженерии систем другой природы, но их не очень много. Само изложение в руководстве кругозорно, его явно не будет хватать для работы инженером. Подробное (не кругозорное) знакомство с конкретными/прикладными инженерными методами для отдельных видов систем крайне важно, но оно предполагается потом и предполагает прохождение дополнительных прикладных курсов (по программной инженерии, инженерии киберфизических систем, системному менеджменту как инженерии предприятия, и т.д.). Нужно отчётливо понимать, что мастерство во владении отдельными методами набирается достаточно долго (единицы лет), причём по каждому прикладному методу работы и даже их составляющим методам есть курсы/руководства/учебники/регламенты/стандарты даже более объёмные, чем наше. Вспомните объемы вузовских учебников по много более узким дисциплинам, например двухтомные А4 учебники, отдельно двухтомники по органической и неорганической химии! Или знаменитый «ландавшиц», там формат A5, зато сразу 10 томов142.
Вот общая схема того, как устроено инженерное знание с точки зрения нашего руководства (пропущенные строчки таблицы, конечно, знать для успешных занятий инженерии надо, в руководстве по интеллект-стеку они подробно описаны, но в конкретной текущей версии руководства полноценное владение всем интеллект-стеком фундаментальных методов мышления не предусмотрено):
| Интеллект-стек фундаментальных методов мышления | Что нужно знать для освоения системноинженерной работы по нашему руководству |
|---|---|
| Методология | Моделировать деятельность (типы: метод, оргроль, оргвозможность, работа). Системное описание предприятия как графа создателей: альфы и подальфы, их состояния. |
| Риторика | Опускать типы мета-мета-модели в речи. Независимость модели от формы выражения |
| Этика | |
| Эстетика | |
| Исследования | Эволюционность алгоритмов в основе методов |
| Рациональность | Стратегирование — рациональный выбор метода |
| Логика | |
| Алгоритмика | Методы — это «обобщённые алгоритмы» |
| Онтология | Мета-моделирование на пяти уровнях L0-L4 |
| Теория понятий | Типы и отношения, «машинка типов» (и доступ к ней через кинестетику — «дребезг») |
| Физика | |
| Математика | |
| Семантика | Понятия, терминология, 4D объекты в мире |
| Собранность | Модели записываем, устно не моделируем! |
| Понятизация | Давать имена объектам |
Теоретическое знание нашего руководства должно «оживляться» на материале конкретных инженерных проектов. Для простых проектов даже не предполагается умений, получаемых в прикладных курсах инженерии их целевых систем — но если вы уже работаете в каких-то не слишком простых проектах (уровень сложности выше, чем «прибить на стену полочку над кроватью»), то мы предполагаем, что вы знакомы с той предметной областью, в которой работаете (а если не знакомы, то как вы надеетесь принести пользу своей работой? «-- Умеете ли вы играть на скрипке? — Нет, не пробовал. Но думаю, у меня получится, концерт уже назначен, билеты проданы», так?).
Для профессиональной работы системным инженером (помним, что эта работа отнюдь не всегда называется «системной инженерией», а роль «системным инженером», помним о «коуче», «политике», «агрономе» и т.д.) дополнительное прикладное обучение обязательно! Кругозорного обучения хватает обычно только для любительской работы, в крайнем случае — для помощи в постановке задачи прикладному профессионалу, который с вами беседует, чтобы хотя бы примерно понимать, что он будет делать и почему, и какие его вопросы будут интересовать, и о чём с ним вообще можно говорить, а о чём нужно говорить с другими прикладными ролями.
Наше руководство не рассчитано только на «прочтение» и запоминание указанных в нём типов объектов. Нет, его наставления должны лечь в основу практической работы, в которой теоретическое знание мета-мета-модели системной инженерии соединяется с практическим знанием прикладной предметной области применения этой инженерии в её общекультурном/кругозорном варианте (метаУ-модель) и варианте, принятом в вашем предприятии (метаС-модель) — и вы должны понимать, какие там типы более абстрактных моделей аннотируют типы более конкретных моделей. После освоения системноинженерного мышления по нашему руководству его основные методы будут ещё уточнены и потренированы в прикладных предметных областях, например, описанных в руководствах по инженерии личности и системному менеджменту.
Нет ничего практичней, чем хорошая теория, но без занятий реальной инженерной деятельностью в рабочих (не учебных!) проектах эту практичность предъявить нельзя. Тот, кто прочёл много книг по танцам, но никогда не танцевал сам, вряд ли сможет станцевать при случае. К инженерам (агрономам, менеджерам, политикам, кому угодно) это тоже относится.
Моделирование: мои инженерные проекты
Вспомните ваши рабочие проекты, которыми вы занимались на протяжении жизни, когда вы хотели изменить физический мир к лучшему, и заполните табличку, разложив целевые системы ваших проектов по системным/эволюционным уровням.
| Системный уровень | Какие целевые системы создавались/изменялись в проекте |
|---|---|
| Человечество | |
| Общество | |
| Сообщество | |
| Организация | |
| Личность | |
| Существо | |
| Киберфизическая система | |
| Косное вещество |
Задания
Поставьте отметки о выполнении следующих дел.
-
Опубликован пост с вашими мыслями о системной безмасштабной непрерывной инженерии по материалу текущего раздела и итогам выполнения всех заданий.
-
Вы откомментировали не менее трёх постов на тему системной инженерии, написанных другими инженерами-менеджерами.
3. Инженерный процесс
Тренды современной системной инженерии
В системной инженерии SoTA (state-of-the-art, современное состояние метода, лучшие на сегодняшний момент варианты метода из всего их разнообразия) меняется довольно быстро: если брать программную инженерию, то технологии там заменяются практически полностью каждые 4-5 лет, хотя дисциплины computer science и методология в варианте специализации engineering science до software engineering science, которые поддерживаются этими технологиями, выдерживают в своих основных чертах немного дольше.
Программная инженерия (и тесно связанные с ней инженерия систем машинного обучения, инженерия данных, инженерия систем искусственного интеллекта) по части трендов занимает особое место в системной инженерии: поскольку там имеют дело главным образом с информационной работой, в которой не нужно тратить много энергии и времени на перемещение вещества в порядке изменения физического мира, а нужно только менять состояние носителей информации, пробы и ошибки там проходят быстрее, чем во многих других видах инженерии, где дело почти сразу доходит до медленных физических процессов в физическом мире и «пробы и ошибки» (trial-and-errors) делать медленнее. Поэтому программные инженеры быстрее находят новые удачные способы ведения инженерной деятельности. Замечено, что методы, которые становятся повсеместными в программной инженерии, появляются в классической инженерии киберфизических систем где-то через 10 лет, и получают распространение через 15 лет от того момента, когда они впервые были замечены в программной инженерии.
Так, именно в программной инженерии появились методы agile и эволюционной инженерии как противопоставление водопаду с его однократным прохождением жизненного цикла. За последние пять лет нормой инженерного метода в программной инженерии стало не просто создание систем, но создание и развитие, эволюционная/непрерывная инженерия (подробней об этом рассказано в нашем руководстве). Конечно, это уже активно обсуждается в инженерии киберфизических систем, но только малое число предприятий перешло на новые инженерные agile процессы, это особо хорошо заметно по происходящему в ракетостроении: успехи предприятий с agile процессами не сравнить с успехами (вернее, неуспехами) предприятий с классической разработкой.
В системной инженерии киберфизических систем, где есть и программная инженерия, и «железная» инженерия, продолжалось движение в сторону общности инженерной работы для систем самой разной природы, включая выход в работу с сетями и системами с людьми (движение в сторону систем систем). В таких компаниях новинки в инженерном процессе программного обеспечения более быстро воспринимаются в «железной» части.
Таким образом в современных учебниках программной инженерии учат эволюционности инженерии, а в учебниках классической системной инженерии обсуждают безмасштабность, роль системных инженеров в проектах систем самой разной природы (несмотря на продолжающийся акцент на классике систем аэрокосмической и транспортной инженерии, но уже явно звучат призывы внимательно смотреть на системы другой природы), создаваемых на самых разных уровнях масштаба.
Наше руководство снимает это различие, предлагая версию одновременно безмасштабной и эволюционной системной инженерии. Это наш вклад в развитие инженерной науки.
Главный тренд в развитии программной инженерии сейчас — это переход к разработке с использованием AI-copilot, причём сначала это был pair programming (программирование вдвоём, парой — но за клавиатурой один человек, другой помогает думать. За клавиатурой — AI-copilot, а человек помогает думать, Software 3.0, или vibe coding143, как его определил Andrej Karpathy), а затем — peer programming, когда часть работы берёт на себя AI-агент, сначала автономно выполняющий довольно большие задачи, а потом и берущий на себя решение проблем. Это отражает переход от поддержки AI в части software design, понимаемого как «проектирование кода и кодирование» к поддержке AI полного software process: постановке задачи на очередной инкремент, а затем полностью вся разработка, включая методологическую и архитектурную проработку, проектирование/design и кодирование/coding, оптимизационное компилирование в машинный код, юнит-тестирование в части инженерного обоснования (quality assurance), сборку/интеграцию, системное тестирование (включая архитектурное и безопасности), разворачивание/deployment, введение в эксплуатацию (delivering), мониторинг, получение пользовательской обратной связи (feedback) — и всё это непрерывно/continuous в ходе непрерывной разработки.
В классической инженерии ровно то же самое, за исключением немного другой терминологии того, что называют design/проектирование. Software design чаще всего включает в себя методологические рассмотрения по видам применимых прикладных алгоритмов (из предметной области применения программы — какой процесс в реальном мире поддерживает программа, чаще всего это DDD, domain driven design, когда объекты программы впрямую отражают сущности предметной области применения программы, например, объект invoice/счёт программного кода и базы данных поддерживает объект invoice/счёт реального мира). Design в инженерии — это работа с CAD, создание конструкции, на которую разложены функции системы, причём в русском языке это будет даже два метода работы (практики инженерии), обозначаемые двумя словами: конструирование как создание деталей с их сложной формой и проектирование как указание, как из деталей собирается всё изделие. Это довольно тонкое различие, но инженеры-проектировщики (проектирующие системы из каких-то уже сконструированных других систем — деталей или готовых других модулей-систем) и инженеры-конструкторы в отечественном машиностроении различаются (при вечных спорах, что часто конструктор занимается не только конструированием, но и проектированием, то есть работает и на уровне составных частей конструкции, а не только на уровне отдельных деталей и косного вещества), в западном — не различаются.
Всего же можно выделить для AI-поддержки в программной инженерии разные поколения, обозначаемые Software 1.0, 2.0, 3.0, а сейчас даже можно говорить и о 4.0 (о них подробнее говорится в руководстве по интеллект-стеку в разделе «Алгоритмика»). Софт/software тут сокращение от software engineering:
-
Софт/software 1.0, классическое программирование: основано на явном кодирования людьми правил и инструкций на языке программирования.
-
Софт/software 2.0144, differentiable programming: программы дифференцируемы145, поэтому способны обучаться на основе данных (обычно большой объём данных) и адаптироваться к новым ситуациям. Наиболее распространённая и известная форма дифференцируемых программ — это нейронная сеть, которая может аппроксимировать практически любой алгоритм.
-
Софт/software 3.0146: Основано на предварительном обучении нейронных сетей в форме больших языковых моделей (large language models, LLM), обученных программировать. Эти модели понимают и программный код, и естественный язык, поэтому им можно давать в том числе и задания найти ошибку в коде, поменять этот код для получения каких-то новых свойств программы. Обычно это или AI-copilot (парное программирование, «второй пилот за штурвалом» и как раз к этому случаю применимо vibe coding), или более-менее автономный AI-агент (самостоятельное выполнение задач «под ключ» по поручениям). Заметим, что в этом варианте вполне присутствует способность к творчеству, ибо написание кода может идти методом проб и ошибок, задействуется меметический алгоритм (в этом случае говорят о reasoning/thinking/«scaling up test-time compute») для получения новых результатов, возможно, недоступных для человеческого мышления.
-
Софт/software 4.0 — можно ожидать, что тут будет инициатива агента на выполнение задач: агент будет выполнять и постановку задачи (например, брать обратную связь у пользователей и определять, что ему надо программировать, чтобы развивать систему в сторону её успешности), и программировать, и выводить самостоятельно инкремент системы на введение в эксплуатацию.
В необязательно программной, а именно — системной инженерии, «просто инженерии», мы можем наблюдать те же поколения по отношению к system design (проектирование+конструирование):
-
Engineering 1.0: классическая архитектура и design (прежде всего конструирование уровня детали с использованием CAD и имитационного моделирования для расчётов прочности, теплопроводности и т.д.).
-
Engineering 2.0: «дифференцируемое всё»147 (в software 2.0 это было дифференцируемое программирование), например, можно дискретное представление архитектуры сделать непрерывным в так называемом «латентном пространстве» архитектурных решений, а затем найти оптимум — и вернуться в дискретное представление, получив оптимальную архитектуру. Важно, что тут не используются представления на естественном языке, используются представления на формальных языках, но вот операции с ними могут делаться в «латентном пространстве», чтобы иметь возможность задействовать оптимизационные методы вычислительной математики (например, метод стохастического градиентного спуска, SGD148). В программной инженерии Andrej Karpathy сказал в 2017 году, говоря о Software 2.0: «Gradient descent can write code better than you. I’m sorry»149. Это полностью относится и к engineering 2.0, только вместо code надо подставить проект/design системы.
-
Engineering 3.0: это использовать программирование на естественном языке, формализацию и оптимизацию в рамках этой формализации при этом делает «компилятор» так же, как при компиляции кода с формального языка программирования в машинный код. Тут просто добавляется ещё ступенька — формализация делается тоже машиной, CAD-AI-copilot для pair engineering (аналогично парному программированию150 в программной инженерии) и CAD-AI-agents для peer engineering (аналогично peer programming, отражает «равный статус программиста» для AI-agent). В инженерии «железа» или электрики всё ровно так же, как используется AI-copilots и AI-agents для программистских IDE151.
-
Engineering 4.0: агент инициативно ставит инженерную задачу, которую осмысленно решать, тратить на неё ресурсы, далее — работает агент по решению задач, как в Software 4.0.
На каждом уровне стека масштаба систем для систем разной природы их особенности дают огромное разнообразие трендов в инженерных методах. Общие для всей системной инженерии тренды найти сложно, хотя тренды движения к эволюционной и безмасштабной инженерии общие. Совсем не все инженерные проекты осознанно следуют этим трендам, но кто им не следует — быстро покидает рынок. Мы условно можем разбить общие для инженерии тренды на два вида:
-
Тренды концепций целевой системы (концепция системы — это каким образом функциональная организация системы будет отражена её конструкцией). Скажем, в радиоэлектронике это ориентация на микропроцессоры со всё более жёсткими проектными нормами, например, стремительный по историческим меркам прогресс проектных норм в компании TSMC152, или на использование GPU или TPU, или переход на новые типы ускорителей вычислений для отдельных видов вычислений (сейчас ожидается примерно через пять лет повсеместное применение квантовых компьютеров и оптических вычислителей). В киберфизических системах, особенно в классической робототехнике — это переход на управление на основе искусственных нейросетей. В работе с внутренними состояниями личности это переход к представлениям функционализма, а также переход к представлениям когнитивной революции. В основном это разбиралось в руководстве по системному мышлению.
-
Тренды инженерного процесса, то есть методов создания и развития систем, то есть тренды в сервисах организационных систем, которые обычно и служат системами создания. Например, эволюционность инженерии вместо жёстко организованной стадийной водопадной одноразовой разработки — и в программной инженерии, и в практически любой инженерии. С первого раза правильно — но MVP, затем бесконечное развитие системы, сегодня инженерный процесс формулируется примерно так, это было показано в руководстве по методологии. Это дало не только распространение разного сорта вариантов инженерии внутренней платформы разработки (ранее — DevOps и SRE) как способов непрерывной быстрой сборки результатов разработки, а также быстрого обоснования успешности и введения в эксплуатацию. Это дало ещё и возможность непрерывной подстройки бизнесов под меняющиеся потребности клиентов и возможности команды проекта (обсуждается как движение Lean Startup после выхода книги Eric Ries «The Lean Startup» в 2011 году, об этом будет подробней дальше в нашем руководстве). Ещё пример — выход моделирования на стадию эксплуатации, то есть использование цифровых двойников как цифровых моделей, которые отслеживают состояние целевой системы на стадии её эксплуатации. В психотерапии (терапия — это аналог ремонта в инженерии личности) происходит отказ от методов психоаналитиков в силу появления evidence-based методов cognitive and behavior science как «золотого стандарта психотерапии»153. В случае методов политики как инженерии общества замена SoTA происходит очень медленно, но тренд очевиден — замена всевозможных диктатур и монархий на более демократические (бескровная смена правителя) формы правления, а также отделение церквей от государства. Хотя тут можно и поспорить: это тренд изменения концепции целевой системы или тренд методов работы создателей из их графа — ибо из одних и тех же людей в обществе мы берём и создателей, и самих членов создаваемого, развиваемого и даже работающего уже общества.
А есть ли тренды концепций использования? Конечно, но в целом потребности людей остаются неизменными: «спасение» (всё, что ведёт к бессмертию), «путешествия» (летать, свобода перемещения), «познание» (обычно в целях спасения и путешествий), делегирование труда. Поэтому функции систем остаются более-менее одни и те же (скажем, у транспорта — перемещение грузов и пассажиров из точки А в точку Б), а вот концепции автомобильного и ракетного транспорта будут разными, пилотируемого и беспилотного — разные, равно как будут разные и инженерные процессы в автомобилестроении и ракетостроении при всей их общности на высоком уровне абстракции.
Тренды концепции целевой системы обычно учитываются в более прикладных инженерных руководствах/регламентах/стандартах по разработке систем той или иной природы. В строительной инженерии учитывают тренды в конструкции зданий, в программной инженерии — тренды в софте (например, появление программ для квантовых вычислений на квантовой аппаратуре). Есть тренды в методах работы, которые настолько привязаны к специфике целевой системы, что их можно учесть только в прикладных очень узких курсах/руководствах/регламентах/инструкциях, например использование методов CRISPR и аналогичных в генной инженерии. Такими узкими прикладными методами являются и spacing и interleaving как методы подачи учебного материала в инженерии мастерства (эти методы обсуждались в начале руководства по системному мышлению, а также они даются в наставлениях по инженерии личности).
Тренды организации инженерной работы, то есть тренды в создании и эксплуатации организационной системы (оргзвена, предприятия, проектной группы, «расширенного предприятия»/«проектной кооперации» какого-то крупного инфраструктурного проекта, и т.д.) обычно рассматриваются в руководствах/стандартах/регламентах/блогпостах по системному менеджменту, а не системной инженерии.
И всё-таки, чтобы подчеркнуть мысль об общности нормативной инженерной науки для всех родов инженерии, приведём примеры нескольких общих трендов, которые нужно учитывать в сегодняшней работе инженеров во всём многообразии их ролей и всём многообразии целевых систем:
-
Ведущий тренд — это использование в инженерии AI, а также получение систем (которые всё чаще и чаще — роботы, или системы из людей) путём не просто изготовления, а изготовления и обучения. Но мы это только что разобрали чуть подробней. Это главный, ведущий тренд. Так, порождающее проектирование (generative design) — это использование компьютеров для проектирования, в том числе в последнее время и для разработки концепции системы, и для предложения архитектуры154. Подтренд в этом порождающем проектировании, который только-только оформляется — это выучивание функциональности автономных систем в специально сконструированных для этого виртуальных мирах, world models155. Дело в том, что сегодняшние киберфизические системы имеют инженерный процесс, похожий на процесс создания зверей: рождается «железо» или «мясо» (при всей неполиткорректности такого названия) с какой-то рудиментарной «прошивкой», а затем происходит обучение в ходе какой-то игры с реальным миром — звери учатся ходить и бегать, охотиться, управлять своим телом, а роботы учатся тоже управлять своим телом в виртуальном мире, а потом это мастерство переносится в реальный мир. Уже не надо писать «программу робота», эту «программу робота» (а любая киберфизическая система по факту — робот) не нужно порождать софту-разработчику, но универсальная программа «искусственного интеллекта» выучивается выполнять какую-то работу в специально созданном для неё виртуальном мире, а потом переносится в реального робота — и всё работает. Автомобиль с нейронной сеткой в его системе управления учится автономному вождению или домашний робот учится вытирать грязные столы в виртуальном мире с точным физическим моделированием, после чего результирующая обученная программа нейронной сети переносится в реальный автомобиль или робот — и всё будет работать156.
-
Повышенное внимание к экологии. Нормативы на загрязнение окружающей среды растут, поэтому строго контролируются различные выбросы в атмосферу, в реки, ограничивается использование токсичных материалов (например, запрещён асбест) — это важно для крупных инженерных объектов, для атомных станций даже иногда возникают парадоксальные ситуации, когда можно брать воду для охлаждения из местных источников, но нельзя потом эту воду в них сливать: у источников естественная радиоактивность больше, чем разрешается для сброса воды от атомной станции! Но и для медицины и даже пищевой промышленности нормативы на ядовитость их целевых систем и используемые «материалы» тоже ужесточаются. Можно спорить, надо ли отслеживать выбросы двуокиси углерода в атмосферу в части их потенциального влияния на климат, ожидает ли нас глобальное потепление или очередной малый ледниковый период, но тут как с гимном: когда Михалкову сказали, что его поэзия для гимна плоха, он ответил: «Плоха или хороша, это неважно. Но когда гимн заиграют — ты встанешь». У инженеров тоже так: они выполняют требования политиков, а требования политиков становятся жёстче.
-
Повсеместный переход к эволюционной инженерии и agile методологиям от водопадных. Это мы тоже довольно подробно обсудили, и тут много разных нетривиальных следствий. Например, малый размер инкремента/фичи, проходящего весь путь от замысла до выпуска, максимальная независимость разработки инкрементов друг от друга (этим озабочены архитекторы проекта). Часть этого тренда — параллельная инженерия, когда традиционные стадии водопадного жизненного цикла выполняются параллельно, а не последовательно (скажем, начинаем рыть котлован, строим фундамент одного крыла здания, продолжаем рыть котлован, возводим крыло, в этот момент строим фундамент второго крыла здания, заселяем первое крыло, в этот момент строим второе крыло здания — а то, что оба крыла будут крыльями одного и того же здания обеспечит информационная модель и точность возведения: совпадут все дверные проёмы, все коммуникации, окна везде будут на одинаковой высоте. В принципе, и проектировать эти крылья здания можно было бы не одновременно, а ещё важно, что здание не прекращает модифицироваться даже после окончания основного строительства, адаптивная архитектура157, адаптивная строительная архитектура тут — синоним эволюционной). Это не только тренд, лежащий в основе эволюционной инженерии («не пытайтесь сделать всю систему целиком одним куском, обеспечивайте в ней фичу за фичей постепенно, подстраиваясь под меняющееся окружение и используя всё новое и новое знание, появляющееся в ходе длинного проекта»). Этот малый размер инкремента помогает ускорить работы, ибо соответствует малой порции работы (small batch size), тренду в операционном менеджменте (об этом уже было сказано в руководстве по рациональной работе, но ещё будет повторено в части операционного менеджмента руководства по системному менеджменту). В инженерии киберфизических систем это появляется после успеха такого сорта подходов в программной инженерии. В социальной инженерии малый размер инкремента был давно известен (поправки к законам, а не перевыпуск полного законодательства время от времени). Интересно, как этот подход медленно проявляется в образовании: болонская система, в которой вы можете уточнить программу через четыре года обучения в бакалавриате, а потом доучиться до магистра по выбранной специальности вместо пяти-шестилетнего обучения в специалитете «в один заход» — это отражение того же тренда, и (как это обычно бывает с трендами) тут часты откаты к более архаичным методам («специалитет» в России). Этому тренду малого размера инкремента противостоит идея «сложной смеси работ принципиально разного масштаба», ибо математика и идеи операционного менеджмента в части small batch size, использующаяся в том числе в agile методологиях инженерии, примерно соответствует математике и идеям многослойных систем управления, которые в своих работах обсуждают Matni Nicolai со товарищи158, но массовое обсуждение этих идей и математики только-только начинается, нельзя пока считать это «трендом». В любом случае, ход на математические описания против суеверий-эвристик — он выигрышный, у него большие шансы стать реальным трендом.
-
Моделеориентированность против документоориентированности — это тренд перехода к формальным (структурированные данные) компьютерным машиннообрабатываемым моделям представления инженерной информации вместо бумажных документов. В инженерии это переход к использованию информационных 3D-моделей вместо томов бумажной инженерной документации или даже переход от машинночитаемых, но не машиннообрабатываемых документов к машиннообрабатываемым (например, переход от использования бумажных документов с финансовой информацией сначала к .pdf файлам и банкам данных с этой же информацией в машинночитаемой, но не машиннообрабатываемой форме, а затем к использованию машиннообрабатываемых записей данных и даже баз данных с этой информацией. Банки данных и базы данных различаются как раз этой «машиннообрабатываемостью», часто говорят о «структурированной информации» при этом). В социальной инженерии это переход к использованию баз данных вместо архивов бумажных документов и пересылки выписок из этих баз данных в электронной форме вместо работы с бумажными документами. Нужно учитывать, что в данном случае существенно сдвигается баланс власти: один человек-чиновник при хорошем использовании компьютерных средств организации его работы может отследить выполнение бо́льшего количества ограничений свободы деятельности бо́льшего числа граждан, хотя время граждан может существенно экономиться на получение всяческих справок — но в целом мы получаем общество тотального надзора за жизнью граждан, «полицейское государство». Хорошо ли это? John Doyle (один из соавторов работы по многослойным системам управления из предыдущего пункта) говорит о «госнадзоре» и «силовиках» как об иммунной системе, защищающей от паразитов, но неизбежные следствия тут — самые разные аутоиммунные заболевания сообществ, обществ и даже человечества в целом, а также хак/взлом паразитами самой иммунной системы, вот это самое «полицейское государство» без права на творческое и продуктивное инакомыслие (мемо-иммунная система удаляет все неизвестные ей мемы/идеи и изолирует или даже уничтожает их носителей, включая потенциально полезные новые мемы и порождающих их людей и группы таких людей-новаторов, как несущих потенциальную угрозу: шанса эволюции что-то оптимизировать дальше при этом нет, «всё новое — инородно, иммунитет должен защищать от всего инородного»).
-
Цифровые двойники, их применение сводится к моделеориентированному представлению (параметры модели в виде машиннообрабатываемых данных) и калибровке численных моделей системы по актуальным данным в ходе её эксплуатации, то есть цифровой двойник рассматривается уже за пределами разработки и изготовления. Раньше говорилось о важности цифрового моделирования системы в ходе её разработки и изготовления, но цифровой двойник показывает, что время эксплуатации не менее важно в части моделирования (например, можно принимать для киберфизических систем решение не просто о плановом ремонте, но ремонте только по состоянию — и для этого нужно накапливать данные об изменении состояния системы в ходе её эксплуатации). Интересно, что концепция цифрового двойника широко распространилась за пределами традиционных в инженерии киберфизических систем: говорят о цифровом двойнике пациента, цифровом двойнике студента, цифровом двойнике клиента бизнеса, цифровом двойнике предприятия. Центральное тут — численное моделирование, включая использование нейронных сетей для получения суррогатов точных моделей и намечающееся использование квантовых компьютеров для моделирования. Численное моделирование было широко распространено в физике и оттуда пришло в инженерию веществ (например, расчёты прочности), оттуда оно (в меньшей мере) перешло в инженерию киберфизических систем и стало известно там под названием «системное моделирование», ибо под «системностью» понималось объединение самых разных физических моделей, отражавших разные «системные аспекты» в одной мега-модели. Но это не было ещё современное системное многоуровневое моделирование (которое в физике называется многомасштабным моделированием), которое начало появляться в инженерии только в последнее время (скажем, для моделирования добычи нефти моделируется поведение нефти между песчинками пласта, частей пласта как пропитанных нефтью небольших объёмов песка, пласта в целом как какой-то сложной пространственной формы в недрах из пропитанных нефтью объёмов песка). В любом случае, численное моделирование по мере распространения вычислительной техники стало применяться практически повсеместно. Основной современный тренд в этом моделировании — использование машинного обучения (аппроксимирующих различные функции универсальных алгоритмов, которые обучаются этой аппроксимации на каких-то исходных данных), в частности глубоких нейронных сетей. Это моделирование используется для систем практически любой природы, находящихся на самых разных системных уровнях.
-
«Платформизация» понимается чрезвычайно широко, но в общем случае означает наличие модуля-платформы с чётко определённым интерфейсом, который поддерживает набор специализированных/прикладных модулей для каких-то сервисов, отнюдь не все из которых нужны для каждого конкретного случая использования. В какой-то мере это следствие тренда на стандартизацию интерфейсов. Важно, что чётко определённый стандартом, выполнение требований которого легко проверить, интерфейс модуля-платформы позволяет разрабатывать прикладные модули разработчикам, организационно внешним по отношению к разработчикам платформы. Платформа автомобиля позволяет навешивать на неё двигатели разной мощности, салоны разной степени роскошности отделки, автоматику разной степени автономности работы — но все они используют общее автомобильное шасси, давая на выходе абсолютно разные по характеристикам автомобили. Платформа магазина интернет-приложений для смартфонов даёт возможность разработки приложений для десятков тысяч фирм и отдельных разработчиков. Мастерская инженеров-менеджеров реализует концепцию личности с сильным интеллектом как платформы: фундаментальное базовое образование (в которое включается и получение мастерства системноинженерной работы по нашему руководству) даёт мыслительное мастерство усиленного интеллекта, а на эту платформу легко добавить какой-нибудь модуль прикладного мастерства (например, инженерии личности или системного менеджмента). Часть этого тренда — стандартизация интерфейсов (открытая архитектура, open architecture). Нет стандартного интерфейса — не платформа! При разработке все интерфейсы между модулями не столько разрабатываются специально для каждого проекта, сколько берутся готовые — ориентация на «платформу со стандартным интерфейсом». Это в общем случае существенно снижает стоимость как проектирования (не нужно проектировать соединения), так и изготовления (можно использовать готовые модули, COTS159). Готовые системы (COTS, commercial/consumer off-the-shelf) вместо специально сделанных на заказ по индивидуальному заказу — тоже «платформенны», хотя такой взгляд и контринтуитивен. Если это одежда, то просто делается готовая всех размеров (интерфейс к разным размерам тела) и продаётся в магазинах, а не индивидуально шьётся в ателье. Если это программное обеспечение, то используется «коробочное», без длительной настройки (или с настройкой LowCode, без задействования программистов, силами «продвинутых пользователей», а сегодня и системы NoCode с естественноязыковым интерфейсом). Индивидуально под заказ сделанные инженерные системы и даже отдельные модули становятся системами для элитного потребления. Этот тренд в существенной мере следствие тренда на стандартизацию интерфейсов. Вариабельности продуктов/продуктовых линеек — это тренд платформизации (базовый модуль и отдельные модули для прикладных сервисов с чётко определёнными для них интерфейсами) с учётом хода на готовые системы (все системы должны выпускаться массово, а не индивидуально). Если присмотреться, то готовая продукция имеет множество вариантов исполнения (тренд платформизации), но эти варианты исполнения не нужно специально заказывать — они уже есть готовые (COTS). Помним, что вариабельность тут ведёт к множеству продуктов с примерно одинаковыми характеристиками, из которых трудно выбрать, и при этом появляются всё новые и новые продукты с примерно похожими характеристиками, которые очень медленно, но улучшаются, а время от времени улучшаются кардинально: это как раз «неустроенность», наличие множества субоптимальных решений с похожими характеристиками, следствие системных конфликтов и многоуровневой оптимизации в ходе меметической/техно эволюции.
-
Продвинутые материалы, которые делают возможными новые инженерные системы. Тут даже не столько такое, как переход в ракетостроении от алюминия к стали в корпусах (основное в ракетах — это большая прочность при высоких температурах, эту прочность сталь на единицу веса даёт выше, чем алюминий, который выгодней по весу только при низких температурах). Но, например, новые лекарства, новые сверхпроводники, мета-материалы160.
-
… Это только примеры трендов, этих трендов много больше.
Конечно, есть тренды не совсем инженерии (хотя вопрос спорный: ведь мы договорились, что «всё — инженерия»). Например, бизнес-модель систем с открытыми исходниками (open source — термин используется и для программного обеспечения, и для электроники, и для всего остального), которая выводит на пересмотр границ того, что и как может быть разработано в рамках одного предприятия. Прибыль при такой бизнес-модели получается не за счёт продажи «интеллектуальной собственности» каких-то систем, а за счёт альтернативных способов заработка: или обслуживания, или использования сторонних разработчиков для собственных нужд, или через использование открытой документации в качестве рекламы основных сервисов. В любом случае, если два десятка лет назад открытые исходники были «исключением из правил», то теперь их использование никого не удивляет.
Чтобы отслеживать такие тренды, нужно следить за текущей литературой. Часть из них связана с распространением системного мышления (стандартизация интерфейсов), часть с лучшим пониманием математики операционной работы (small batch size как основа «аджайлизации»), но значительная часть — с успехами моделирования, в том числе порождающего моделирования (когда речь идёт не только о создании модели, но и создании по модели каких-то предположений о мире. «Порождающее моделирование» — это в какой-то мере «антимоделирование», где на основе модели нужно создать описание мира, а не на основании описания мира создать модель), а часть этих трендов получена «случайно», то есть в ходе техноэволюционного процесса порождения нового, базирующегося на случайных мутациях мемов и естественном отборе удачных мутаций.
Искусственный интеллект на основе нейронных сетей стал известен широкой публике только в 2012 году. Сфера его применения в системной инженерии практически та же самая, что и естественного интеллекта (по факту используется всегда коллективный гибридный интеллект: множество естественных интеллектов, обычных компьютерных программ и баз данных и какие-то варианты искусственного интеллекта, например, алгоритмы на основе глубоких нейронных сетей). Уже сегодня искусственный интеллект на уровне среднего человека стоит дешевле школьника (переводчик Гугла тут как раз пример). Ситуация быстро меняется, и через несколько лет (мнения расходятся, но большинство считают, что через 2-5 лет) можно ожидать появления компьютерного интеллекта, обладающего для широких классов инженерных задач сверхчеловеческой силой (сверхчеловеческой — это «более умных, чем лауреаты Нобелевской премии»). Это существенно изменит все инженерные методы, для всех системноинженерных/эволюционных уровней сложности.
Можно ожидать, что искусственный (а на самом деле гибридный, ибо речь идёт о совместном мышлении людей и машин в коллективных проектах, а ещё искусственный интеллект учится на результатах предыдущих работ естественного интеллекта людей — граница естественного и искусственного тут крайне размыта) интеллект будет использовать те же принципы устройства инженерного проекта, которые описаны в нашем руководстве. Если потребуется обучить искусственный интеллект хорошей инженерии, то мы могли бы ему посоветовать взять это наше руководство, но ещё и обязательно все руководства-пререквизиты.
Моделирование: инженерные тренды и мой рабочий проект
В предыдущем подразделе руководства дан список трендов в инженерии (трендов больше, это только пример). Заполните табличку комментариями, в которых вы даёте название тренда (из нашего руководства или кастомизированное/адаптированное для вашей прикладной предметной области), как вы его интерпретируете в терминах вашей прикладной предметной области (используете типы и термины не мета-мета-модели из нашего руководства, но типы и термины мета-модели предметной области), и комментируете, как он проявляется в вашем проекте (вы его игнорируете, ваш проект на нём основан, вы планируете действия по его отражению в проекте). Добавьте минимум ещё один (но лучше — больше) из инженерных трендов, которые вы наблюдаете и отслеживаете.
| Номер п/п | Название тренда (по нашему руководству, но лучше бы кастомизированное для предметной области рабочего проекта) | Как тренд проявляется в вашем проекте | Что вы планируете в связи с этим предпринять |
|---|---|---|---|
| 1. | |||
| 2. | |||
| 3. | |||
| 4. | |||
| 5. | |||
| 6. | |||
| 7. | |||
| 8. | |||
| 9. | |||
| 10. | |||
Что делают разработчики
В инженерии исторически образовалось довольно много разных пониманий разделения труда. «Инженер» — это некоторая составная общая архироль, появление «системного инженера» не слишком улучшило ситуацию, но ведь есть ещё и разработчик (developer), и проектировщик (designer), и даже «рабочий» — за каждым словом тут множество самых разных значений, плюс ещё и полностью устаревшее различение «инженеров» как «белых воротничков», занятых умственным трудом, а «рабочих» и «техников» как «синих воротничков», занятых физическим трудом. Инженерия эволюционирует, разделение труда меняется, при этом в каждом конкретном проекте можно встретить самые разные варианты, ибо отнюдь не все предприятия следуют современному инженерному процессу с современным разделением труда. Как разбираться с «винегретом» значений? Как всегда: обсуждая развёрнутое описание, а не «определение» (которых легко наберётся сотня-другая противоречивых из разных источников).
Трудности начинаются с самого термина разработка/development::метод, и тем самым в определении того, кто такой разработчик::роль. У слова development довольно много словарных значений, все их можно найти в инженерии:
-
Иногда developer — это не столько «разработчик», сколько неопределённый «развиватель», а development — «развитие». Так, директор по развитию в инженерии предприятия/менеджменте понимается как «ответственный за рост компании» путём экспансии на новые рынки, или просто рост компании путём применения новых технологий/организационного развития. «Девелоперы» в недвижимости/урбанистике, это «развиватели» территории, где потихоньку evolve всё, что нужно для комфортного проживания.
-
Чаще всего development — это «разработка» в широком смысле, метод получения какого-то продукта в его конечном виде, но до момента массового заводского производства в киберфизических системах, размножения в сельском хозяйстве, введения софта в эксплуатацию на рабочих серверах в случае корпоративного софта. Включает в себя в том числе и выявление потребности (в системе или одной фиче системы), и разработку архитектуры (термин легко терпит «разработку в разработке», то есть разработка архитектуры в разработке целевой системы), и проектирование/design, и изготовление/manufacturing, и обеспечение безопасности и защиты (safety and security), и проведение испытаний, и непрерывный ввод в эксплуатацию: всё, кроме собственно эксплуатации.
-
Development как «разработка командой» в узком смысле, проектирование системы и её частей, отделённое от архитектуры (у которой отношение надзора к разработке разными командами), производства (которое предоставляет инфраструктуру непрерывного ввода в эксплуатацию (сontinuous delivery) и связанных с ними сборки, тестирования и мониторинга), и иногда ещё выделяют как отдельные обеспечение безопасности/safety и защиты/security.
Напомним табличку с ролями в разделении труда (системного) инженера:
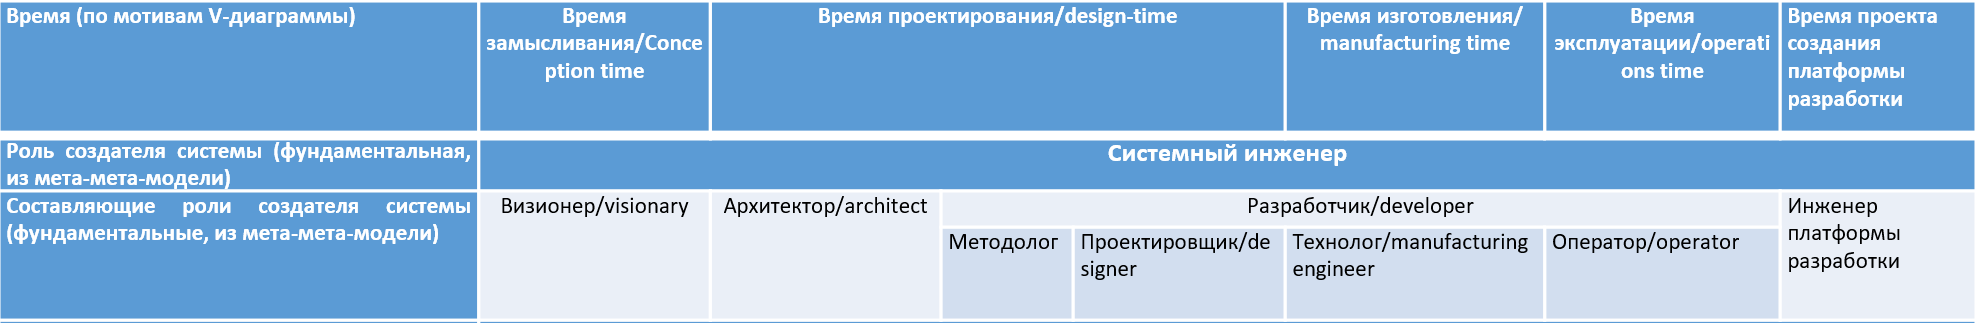
Вот существенно упрощённая картинка, показывающая взаимоотношения всех этих ролей:
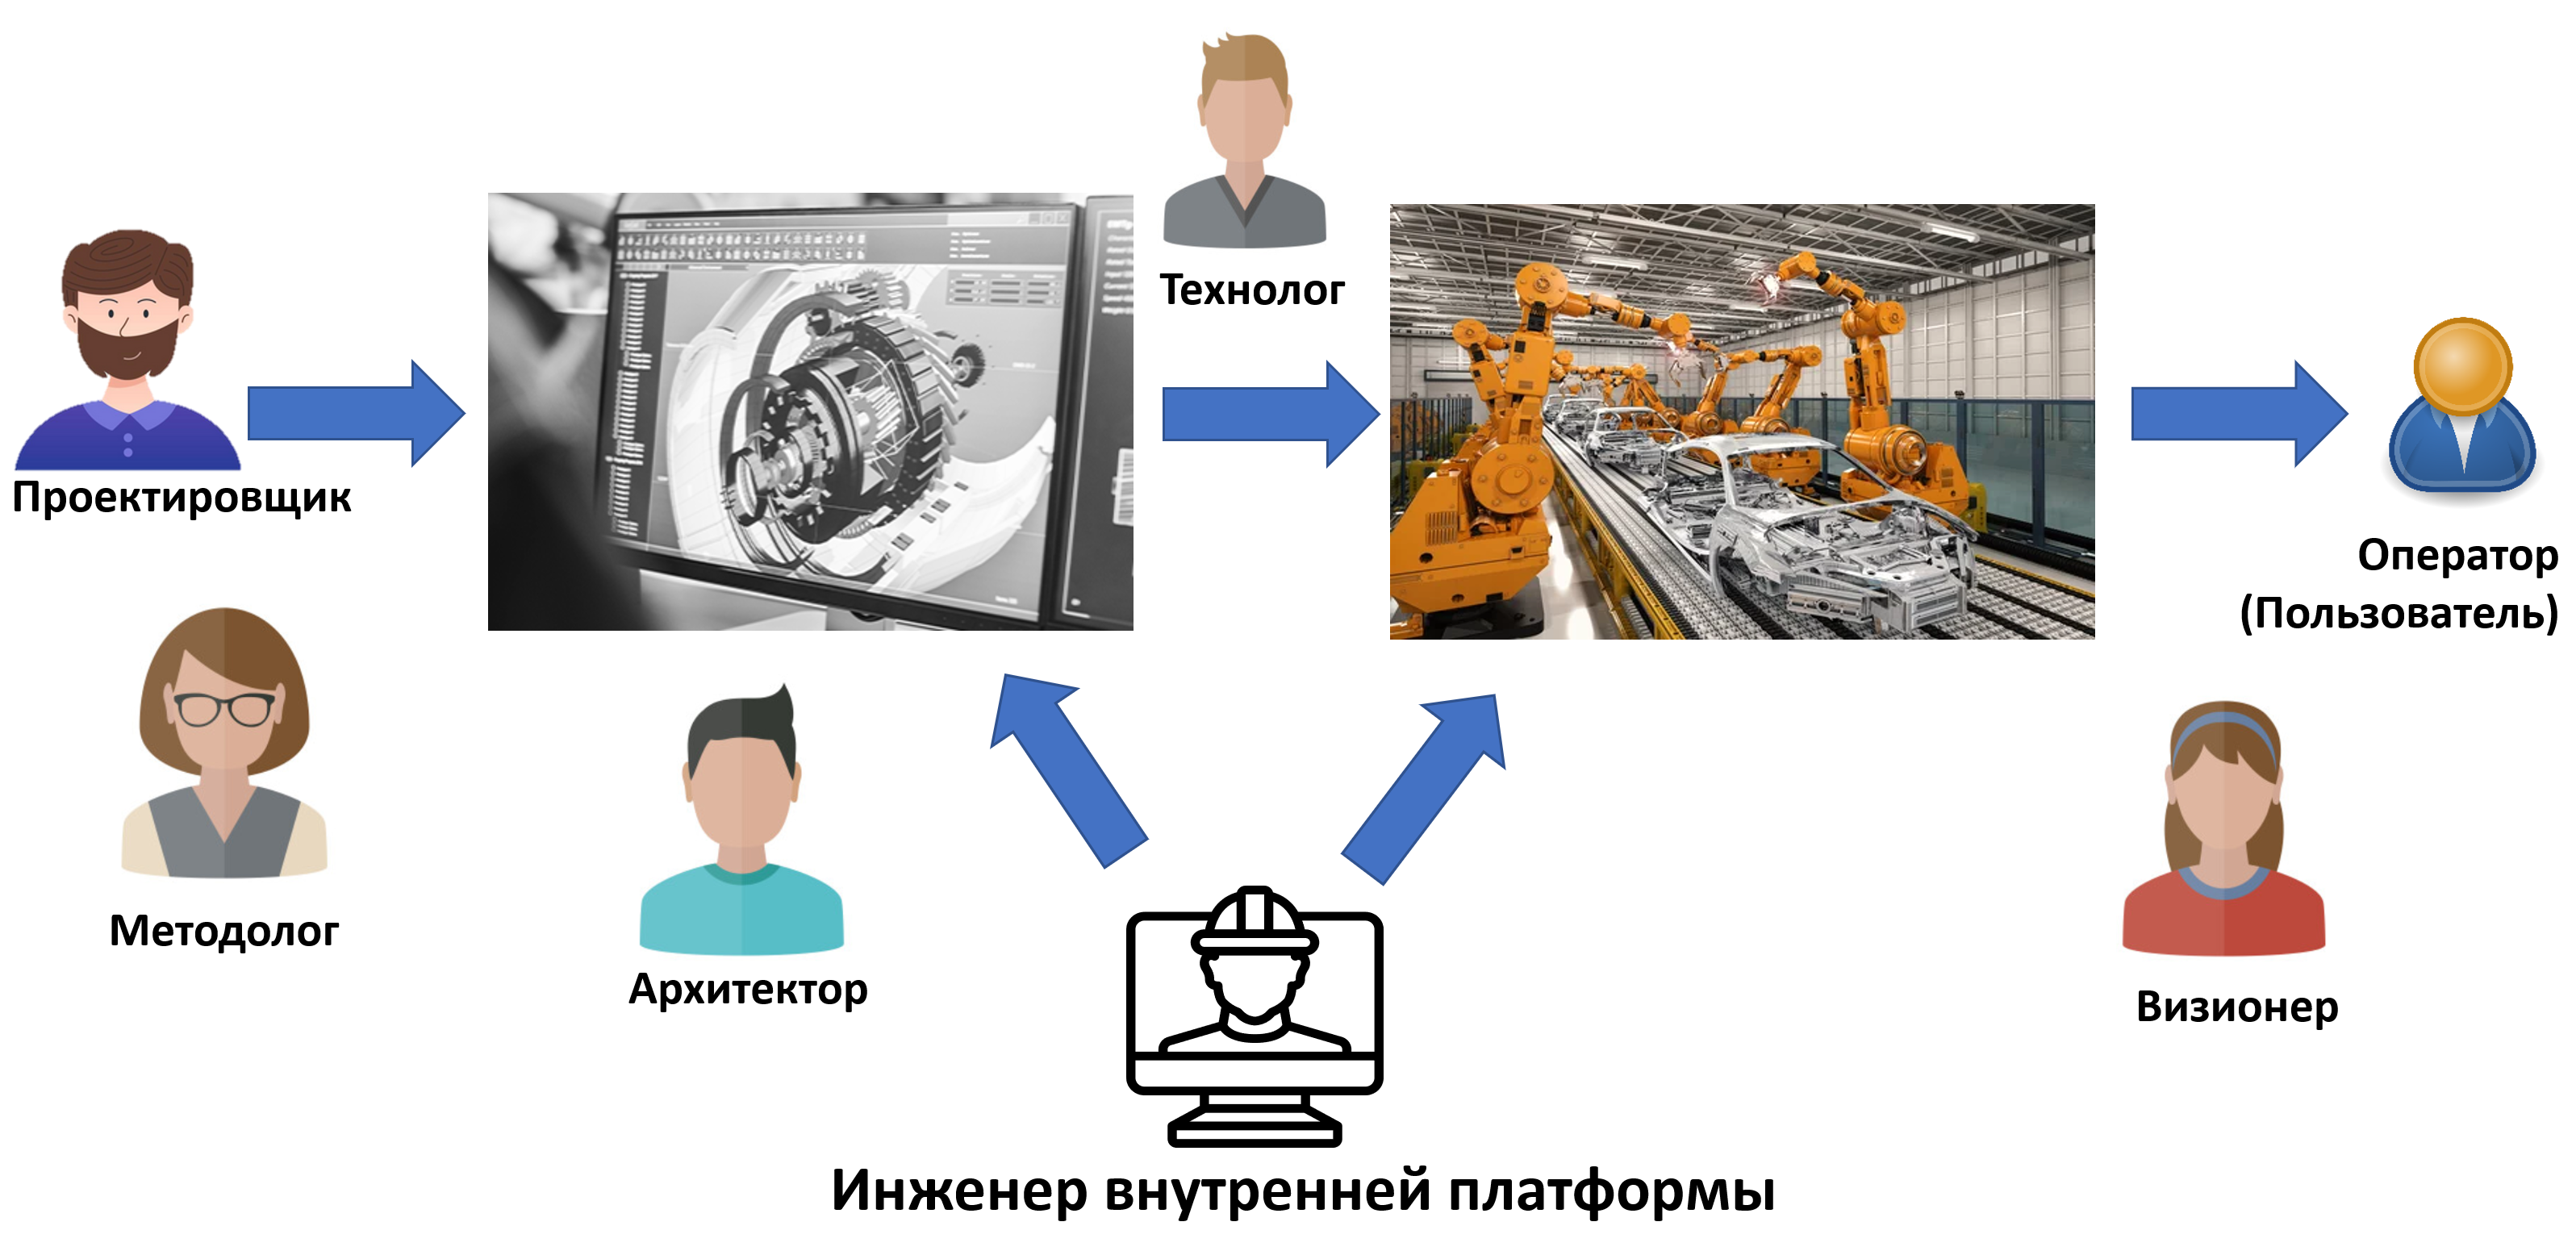
Проектировщик в соответствии с рекомендациями прикладного методолога, ответственного за динамический аспект системы и в соответствии с принятыми архитектором решениями делает проект/design системы и передаёт его технологу, который проводит этот проект/design через изготовление, сборку, обоснование успешности (тестирование), разворачивание и пуск в эксплуатацию. Оператор (он же пользователь) работает во время эксплуатации системы, визионер понимает текущую (или будущую!) ситуацию в эксплуатации и разработке — и планирует очередь реализации новых фич системы, передавая её проектировщику (то есть это не однократный проход по процессу, это непрерывная разработка, continuous development). Отдельно тут инженер внутренней платформы разработки (internal development platform), который готовит инструментальный «конвейер», на котором работают все остальные роли — инструменты методолога, проектировщика, архитектора, технолога, визионера. Конечно, «инженер внутренней платформы разработки» внутри себя рекурсивно содержит все упомянутые роли: в маленькой разработке софта это может быть пара-тройка человек, а вот в ракетостроении — люди, которые строят ракетный завод, да ещё и разворачивают софт моделирования для конструкторского бюро.
Одно из неуказанных различий роли разработчика и ролей визионера, архитектора и инженера платформы разработки в том, что в маленькой разработке это всё роли одной небольшой команды, но в большой разработке роли визионера, архитектора и инженера платформы разработки обычно вынесены на уровень разработки системы в целом (приоритеты разработки тех или иных фич у визионера, раздаваемые командам модули, общий для всех инструментарий разработки), а составляющие роли разработчика появляются на уровне команд, которые разрабатывают отдельные модули.
В нашем руководстве мы выделим отдельно команду разработчиков в узком смысле слова, выполняющих метод разработки (проектирования) в узком смысле слова: не всей системы, в целом, а в рамках отдельной команды. Вот иллюстрация предельно упрощённого разделения труда внутри команды разработчиков:
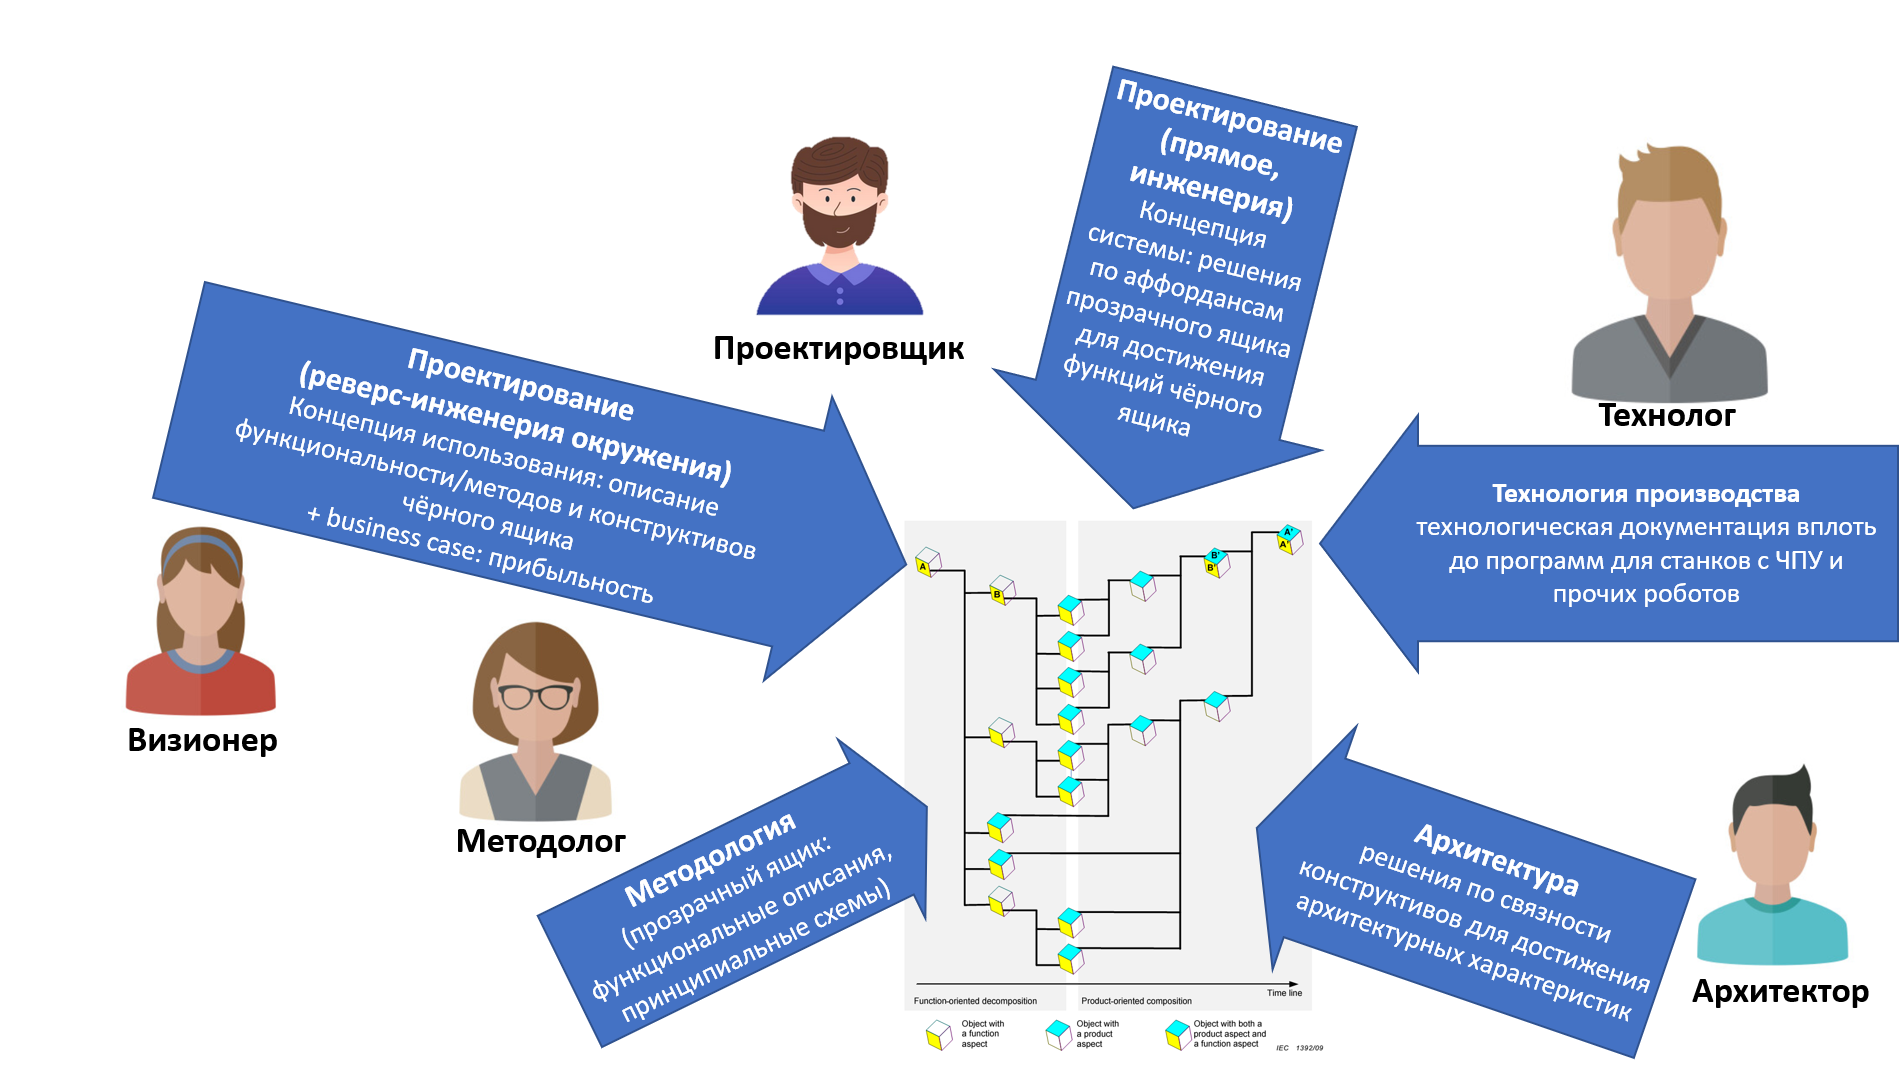
На картинке намеренно проектировщик отвечает за конструкцию и чёрного ящика (спецификация интерфейсов, учёт компоновки, сама система целиком — это ведь не только функциональный объект в надсистеме, но и конструктив тоже), и для прозрачного ящика (подбор или даже изобретение комплектующих и компоновки такой, чтобы выдавать необходимый набор функций). И прикладной методолог и за внешнюю функциональность, и за внутреннюю отвечает. Совместная работа всех, но всё-таки разделение труда по видам описаний, в которых профессионализируются. Визионер же ничего не разрабатывает, но отвечает за то, чтобы это был бизнес (а если не бизнес, а благотворительность, то было бы понятно, кто добровольно оплачивает эту благотворительность, а не обнаруживает это уже после того, как потрачены ресурсы на никому не нужную разработку).
Вот что делают разработчики внутри команды, причём непрерывно по ходу жизни многих версий системы, а не разово «от замысливания до выпуска» одной версии:
-
Узнают потребности внешних проектных ролей, узнают структуру клиентской предметной области (реверс-инжиниринг надсистемы), то есть делают концепцию использования, модель системы как «чёрного ящика». Никакого испорченного телефона, промежуточных «аналитиков». Результат тут сегодня часто даже не use cases, а юнит-тесты, документирующие ожидаемое поведение системы в части каких-то возможностей/фич/features. Это делает главным образом визионер (часто внешний по отношению к команде, например, это половинка должности product owner или product manager) и проектировщик.
-
Выполняют концептуальное проектирование, то есть делают концепцию системы (включая использование известных им паттернов, поиск в литературе/культуре, и изобретения/творчество). Концепция системы получается на стыке работы прикладного методолога (синтез функций как описания динамики системы, её поведения) и архитектора (синтез конструкции как модулей системы, связанных через интерфейсы). Архитектор, который задаёт границы и интерфейсы проектируемого модуля как чёрного ящика, чаще всего внешний для разработчиков, но внутри модуля в прозрачном ящике тоже нужно проводить архитектурную работу, её чаще всего выполняет проектировщик/designer. А вот прикладной методолог внешний довольно редок (функциональная нарезка на верхнем уровне не очень осмысленна для больших систем, реализациям маленьких фич требует узкоприкладного функционального синтеза), и роль методолога начинает выделяться всё чаще и чаще внутри команды — но названия разные: от process engineer до functional architect. Не надо забывать, что под словами engineer, developer, designer и даже architect могут скрываться самые разные роли, поэтому очень часто тут можно встретить «эпитеты», например, functional architect указывает, что речь идёт не о модульной эволюционной архитектуре, а о функциональном описании (раньше это было частью архитектуры, как «всё важное, что делали разработчики», в том числе и функциональная, и модульная часть), если говорится о process designer, functional designer — это всё тоже прикладной методолог. И даже functional analyst может быть прикладным методологом, при этом игнорируют, что речь идёт не об анализе, а о синтезе функционального описания.
-
Выполняют нарезку работы на маленькие кусочки (задачи/tasks), соблюдая принцип small batch size и другие принципы операционного менеджмента. Это роль менеджера, которая даже не указана.
-
Выполняют работы по инженерным обоснованиям: создание тестов в рамках сдвига влево (shift left, общий принцип переноса того, что делалось раньше в конце жизненного цикла в самое его начало: тестирование, учёт ограничений безопасности и защиты, и т.д.), а затем выполняют тестирование. Могут существовать и отдельные команды тестировщиков, но главная работа по созданию функциональных тестов и тестированию у самих разработчиков — прежде всего у проектировщиков.
-
Выполняют работы по безопасности и защите, принимая внешние ограничения у специалистов (мы считаем, что архитекторы и специалисты по безопасности и защите только по недоразумению не одни и те же, поэтому не показываем отдельно этих специалистов), причём в рамках сдвига влево (то есть не по итогам тестирования готовой системы, а прямо в ходе принятия проектных решений).
-
Выполняют проектирование с точностью, достаточной для изготовления (design for manufacturing). В классической инженерии это non-architectural part of design, в конструировании и проектировании это работа с CAD и далее выход на программы для станков с ЧПУ или 3D-печать, а в программной инженерии это собственно кодирование/coding (хотя в программной инженерии скорее скажут coder, чем designer/проектировщик).
-
Выполняют работы по подготовке производства: выпуск технологической документации, вплоть до программ для станков с ЧПУ, а в программной инженерии до скриптов прогона инкрементов кода через инструментарий компилирования, тестирования, интеграции, разворачивания, пуска в эксплуатацию. Инструментарий готовит инженер внутренней платформы разработки.
Все эти роли перепутаны, команда неформально принимает это разделение ролей, а ещё есть неминуемые недоговорённости от того, что разработка встречается трижды, и можно было бы ожидать трёхкратного воспроизведения ролевой структуры для отдельных ролей, но этого по совокупности причин не происходит:
-
Разработка в целом (так, там есть роль архитектора, визионера, инженера внутренней платформы разработки — которые работают на уровне всей системы), и роль разработчика модуля, который работает на уровне модуля — и считается, что эти разработчиков несколько.
-
По идее, роль разработчика модуля должна бы воспроизвести у себя полный набор всех ролей: визионер модуля, архитектор модуля, разработчик модуля(!) и будем считать, что инженер операционной платформы тут необязателен. Менеджерские роли (прежде всего, операционный менеджер) не рассматриваем. Коллизия тут в том, что откуда-то появляется роль разработчика внутри роли разработчика. И если в модуле появляется ещё более мелкий уровень модуля, то можно ожидать «разработчика внутри разработчика внутри разработчика». Но это игнорируется, и визионер модуля считается внешним, а «архитектор модуля» совмещается с проектировщиком, который «задаёт конструкцию» (в том числе архитектурные решения для модуля и выбор аффордансов-конструктивов).
-
Инженер внутренней платформы разработки строит эту самую платформу — и для этого внутри себя должен иметь полный набор инженерных ролей, по сути это «проект в проекте» (а часто это «проект вне проекта»: завод и конструкторское бюро уже построены, ими надо только пользоваться). Но мы тут не будем делать разворачивания полного инженерного процесса для «строительства конвейера», «инженерии инструментария выпуска системы», «создания тёмной холодной фабрики» (у этой культуры много имён, совсем недавно тут были в ходу ещё и такие имена, как DevOps и SRE, в инженерии предприятий тут администрация, в инженерии мастерства тут деканат).
Основное, чем пользуются разработчики (напомним, что мы очень грубо разложили их роль на составляющие методолога, проектировщика, технолога, оператора) в своей практике — это самые разные моделеры. В методах поддержки DDD (domain driven design, помним, что design как раз «проектирование», выполняется проектировщиком, а в части функционального проектирования — методологом) типа EventStorm (мы расскажем об этом методе подробней чуть позже) моделером выступает стена и липкие листочки разного цвета с надписями фломастером. Но это, конечно, исключение. Главным образом используются специализированные моделеры (IDE, CAD — сегодня обязательно с AI-copilot и AI-agent для vibe coding в программной инженерии и vibe design в «железной» инженерии), ибо вся разработка идёт сегодня как model-driven (синоним: model-based): делается цепочка всё более и более детальных и точных моделей, которые потом используются для автоматического (не руками! Внутренняя платформа разработки — это прежде всего средства автоматизации выпуска: изготовления, интеграции, обоснования/испытания, разворачивания, ввода в эксплуатацию, мониторинга работоспособности) выпуска/delivering целевой системы.
В старинной разработке момент перехода от модели::описание (чертежи, исходный код) к части системы («в железе», «в бетоне», «в облаке») был важным гейтом, принималось решение о том, будут ли вкладываться материальные ресурсы в проект. Затем это перестало быть хоть какой-то особой операцией: модели вышли на некоторую критическую для успеха изготовления точность и полноту описания, а изготовление вышло на некоторую критическую для последующей сборки точность изготовления. Риски по результатам моделирования в ходе разработки получить какую-то деталь, которая будет неудачна, существенно упали.
Интеграция/integration как объединение изготовленных частей в целую работоспособную систему требовала творческой работы. Скажем, при разработке самолёта прилаживание двери сложной формы к фюзеляжу могло на заводе занимать пару недель. А теперь это «прикрутить три болта». То же самое с домашней мебелью: собрать какую-нибудь кровать дома могло требовать немаленькой инженерной подготовки, ибо дырки для болтов при совмещении деталей банально не совпадали друг с другом. Нужно было «дорабатывать по месту напильником». Если один разработчик проектировал стены, а другой проектировал водопроводную сеть, то в стенах проходы для труб могли быть и не запроектированы, их надо было пробивать «на месте», в ходе строительства. Если это было на подводной лодке, то все прочностные расчёты и решение проблем герметизации отсеков надо было переделывать. Сейчас такого быть не может: многоуровневое моделирование выявит проблему раньше, точное изготовление сделает так, что «в модели» и «в жизни» будет совпадать, тестирование обеспечит проверку как намоделированного, так и изготовленного, а управление конфигурацией заранее выявит все возможные коллизии — чаще всего ещё в проекте, до изготовления.
Конечно, все эти проблемы решались не только за счёт того, что всевозможные моделеры стали лучше, а изготовление деталей стало точнее, поэтому сборка тоже получалась беспроблемной. Собрать беспроблемно ведь можно и что-то ненужное! Это решилось тем, что разработчики избавились от «испорченного телефона», стали общаться со специалистами предметной области надсистемы непосредственно, а не через «аналитиков», «инженеров по требованиям» и прочих посредников. Моделированием окружения тоже занялись разработчики, «с чужими анализами в нашу больницу не берут». Тесты тоже разрабатывают сами проектировщики, слухи про «внешние независимо разработанные тесты более качественны» оказались неподтверждёнными исследованиями. То, что «независимые тестировщики» выдают процент найденных ошибок примерно такой же, что и сами проектировщики — это контринтуитивно. Конечное слово всё равно остаётся за использованием системы, а не изготовлением (система может очень плохо работать, хотя пройти все запланированные испытания). Так что нужно просто уметь быстро-быстро всё переделать по обратной связи от пользователей, чтобы избавиться от ошибок — ошибок по мнению пользователей, а не ошибок по мнению проектировщиков. Это мы обсуждали как customer eXperience (для успеха системы прежде всего важны впечатления пользователей системы, а не впечатления разработчиков).
Для итоговой безошибочности/бездефектности оказалось важнее обеспечить скорость перемоделирования в части исправления ошибки и затем повторного изготовления и сборки, а не бесконечное тестирование системы по жёстко задокументированным спецификациям. Важней оказалось соответствие ожиданиям пользователей во время эксплуатации, а не соответствие спецификациям во время разработки и обоснований. Вот этот переход к учёту customer eXperience крайне важен в современной разработке:
-
Скачок в «голову пользователя», проверка «за пользователя» — что жмёт и плохо в системе для пользователя, а не для разработчика.
-
Скачок из времени разработки во время эксплуатации — систему надо смотреть работающую, а не изготавливаемую.
Это мышление с вниманием к customer eXperience разработчикам освоить очень трудно, для этого нужны тренировки.
Переход к «отладке системы для безошибочности в глазах пользователя» очень контринтуитивен. Этому сопротивляются главным образом менеджеры, которые не очень разобрались в том, как устроена реальная инженерная работа: им удобнее отчитаться не за работоспособность системы в ходе эксплуатации в быстроизменяющейся жизни у пользователя, а удобнее отчитаться за разовое подтверждение выполнения стабильных «требований» момента разработки, а что там в эксплуатации с customer eXperience — это будет решать какой-нибудь другой менеджер, но не менеджер разработчиков.
А ещё собрать беспроблемно можно какую-то группу деталей в подсборку, а потом получить огромные проблемы на сборке уже из подсборок. Тут помогает непрерывная интеграция (continuous integration), которая подразумевает непрерывную сборку целостной версии моделей системы с проверкой конфигурационных коллизий. В этой практике идёт нарезка работ по разработке системы на маленькие части:
-
Части, определяемые ограниченным контекстом/bounded context, то есть одной предметной областью в проекте, моделирование-проектирование/design которой поддерживается одной командой. Аккуратное разбиение на части — это результат архитектурной работы архитектора целевой системы (нарезка системы на части верхнего уровня и определение интерфейсов их взаимодействия) и архитектора предприятия, нарезающего предприятие на команды разработчиков.
-
Части, определяемые инкрементальностью разработки: начиная с минимальности системы, которая выдаёт минимальный набор функций, позволяющий её использовать хоть как-то (MVP, minimum viable product: «молоток, но пока без ручки, и даже дырки для ручки нет», но не «ручка, пока без молотка на ней»), а потом увеличивающийся очень маленькими инкрементами набор «фич» целевой системы. Инкременты берём сегодня даже не на день работы команды, а на часы — а не на неделю или месяц (small batch size, частота релизов важнее собранной в этих релизах функциональности: гонимся не за выпуском большого числа новых фич в одном релизе, а за непрерывностью разработки — в пределе будет по одной фиче в релизе, релизы часты, непрерывны, continuous delivering).
После проектирования (в том числе проектирования с точностью, достаточной для изготовления — design в «железной инженерии», кодирование в программной инженерии) каждая команда выдаёт поток небольших инкрементальных изменений в общую «магистраль» (trunk) сборки, и это происходит ежедневно (иногда ежечасно), но не еженедельно и уж тем более не ежемесячно. Это метод магистральной разработки (trunk-based development161) вместо метода «долгоживущих ветвей для изменений» (long-lived feature branches) и последующих больших шагов по интеграции. Сегодня это уже метод не только программной инженерии, но и «железной» инженерии: в самолётостроении конструкторы результаты своей работы выкладывают в общую PLM-систему немедленно, каждый день, а не по мере окончательной готовности каких-то крупных частей. Ещё лет десять назад в моде была поговорка, что «дураку половину работы не показывают», сегодня на эту поговорку сразу возражают:
-
Смотрят не дураки, поэтому с такими заявлениями нужно быть осторожней.
-
Значит взял слишком большую работу, надо было поделить её на части, которые можно показывать.
-
Если не показываешь, то ошибки (начиная с того, что вообще ненужную работу делаешь, не тем занялся) выявятся позже, а это недопустимо.
-
Покажи ещё и тесты для своей работы.
Каждая интеграция маленького инкремента не занимает много времени, а если выявляются «большие проблемы» (например, необходимость доработки интерфейсов), то они выявляются рано. То, что это небольшие законченные части, помогает как с обеспечением «потока» (flow) работ в части менеджмента (отсутствуют «заторы» в местах ограничения/constraints потока — small batch size метод), так и помогает быстро находить ошибки, уменьшать число переделок/reworks в части прикладной инженерной работы.
Команды быстро получают обратную связь от эксплуатации и немедленно на неё реагируют (если число дефектов превышает какой-то предел, то новыми фичами прекращают заниматься, а только исправляют ошибки — это основа метода SRE, site reliability engineering162, применяемого инженерами внутренней платформы разработки и реализуемого инженерами-технологами), метод vulnerability management даёт понимание сроков исправления найденных при эксплуатации уязвимостей в зависимости от уровня их серьёзности, а метод FinOps163 передаёт ответственность за стоимость эксплуатации в команду разработки в случае использования облачной инфраструктуры (а если инфраструктура собственная, а не облачная — можно использовать, например, chargeback164).
Это всё, конечно, поддерживается довольно развитой организационной и инструментальной инфраструктурой, которая поддерживает работу команды. Сама по себе команда разработчиков не сможет работать, чудес не бывает.
Итого: команды работают максимально независимо друг от друга маленькими улучшениями/инкрементами в релизах, поддерживая тесную связь с исполнителями внешних проектных ролей в надсистеме (часто на много уровней вверх), находясь под архитектурным надзором (и очень похожим надзором по линии безопасности и защиты), а также опираясь на внутреннюю платформу разработки (инфраструктуру), которую предоставляют инженеры этой платформы (платформа будет давать сервисы управления конфигурацией, тестирования и другой инфраструктуры, нужной для непрерывной интеграции/continuous integration и затем непрерывного введения в эксплуатацию). Разработка немыслима без взаимодействия с внешними проектными ролями в эксплуатации, архитекторами, инженерами внутренней платформы разработки (она же — инфраструктура изготовления, она же — производство) и менеджерами.
Мы переводим continuous delivery не просто как выпуск (release), ибо выпуск обычно у разработчиков («выпуск новой версии»), не «поставка» (это логистическая операция) и даже не «разворачивание» (deployment, установка на месте), но конечной операцией попадания в руки потребителя/пользователя после всех предварительных операций доставки на место, установки на место и настройки: ввод в эксплуатацию. В «железной» инженерии это transfer, commissioning. «Ввод в эксплуатацию» наиболее точно отражает смысл понятия continuous delivering и даёт возможность использовать его для систем самой разной природы. Ввести в эксплуатацию банан — это не доставить его домой в полиэтиленовом пакетике, не освободить от упаковки, не почистить от кожуры. Ввести в эксплуатацию банан — это выдать его готовым для еды, чтобы можно было сразу откусить, без дополнительных очисток-распаковок-готовки. Если вы получаете банан, готовый к откусыванию и каждый раз чуть более вкусный раз в час (или хотя бы раз в день, но никак не раз в неделю или месяц), то поздравляем — у вас continuous delivery, это важнейший метод эволюционной/непрерывной инженерии. Эта эволюционная/непрерывная инженерия начинается с того, что кто-то придумал вырастить и продать вам банан, кто-то его таки начал выращивать и менять сорта на более вкусные, а затем непрерывно собирать урожай спелых и всё более вкусных бананов, поставлять их вам и готовить к еде без дополнительных подготовительных ваших операций — это и будет continuous development, а затем уж это continuous delivery. Банан тут плохой пример, ибо он будет просто каждый раз тот же самый, а смысл затеи в том, что доставляемый-очищаемый-проверяемый для вас каждый час новый банан будет лучше старого, или хотя бы «такой же вкусный» при изменении ваших вкусов (это тоже надо учитывать! Прежний вариант банана будет тогда вкусный для вас-прежнего, но не для вас-нынешнего!): при непрерывной инженерии банан будет эволюционировать под ваши постоянно изменяющиеся вкусы и постоянно будет готовым к тому, чтобы вы с удовольствием его съели без дополнительных операций готовки, в этом весь смысл затеи continuous delivery!
При этом всё это в реальности устроено ещё сложней, ибо для вас на всякий случай не только очищается, а потом «ради роста культуры еды» нарезается банан, но и одновременно ещё пару десятков фруктов, а ещё первые-вторые блюда и салаты, и вообще непрерывно и круглосуточно работает шведский стол со всем его разнообразием продуктов, где всё магическим образом поддерживается свежим, вкусным с учётом изменений вкуса, надёжным и безопасным, доступным и никогда не кончающимся даже ночью — но начинает всё содержимое этого шведского стола свою жизнь на самых разных полях и фермах и проходит довольно большой путь переработки и логистики. Современная разработка софта корпоративных информационных систем представляет собой примерно вот такое поддержание «шведского стола» программных сервисов, доступных сотрудникам. И то же самое потихоньку начинает происходить с любой другой инженерией: чем бы ни занялись, в конечном итоге в идеале получится поддержка того же «шведского стола», да ещё и с доставкой на дом. Даже образование — это поддержка такого же постоянно действующего «шведского стола» мастерства, а не организация разового обеда. Может, метафора эта и немного натянута, но она очень полезна — режим поддержки «шведского стола» существенно отличается от режима приготовления одного обеда.
В инженерии киберфизических систем огромное влияние оказывает также переход к так называемым software-defined технологиям, где традиционно «аналоговые» части системы попадают под контроль какого-то встроенного/embedded софта/software (напомню, что мы предлагаем и в письменной речи кратко писать «софт», хотя иногда и пишем канцеляритное «программное обеспечение» или даже соответствующее каким-то стандартам «программные средства»).
Если алгоритм работы устройства (атомной станции, фотоаппарата, автомобиля, смартфона) определяется софтом, то вы можете смело использовать все принципы разработки софта, и далее менять этот софт хоть каждый день. Так, функции помощи водителю в автомобилях Tesla определяются программно и регулярно обновляются, но само «железо» автомобиля при этом остаётся неизменным. Это общеинженерный тренд: доработки целевых систем ведутся всё время, включая время после введения этих систем в эксплуатацию. То есть continuous delivery (непрерывный ввод в эксплуатацию со всё новыми и новыми фичами, всё новыми и новыми исправленными ошибками, а иногда и со всё новой и новой архитектурой, которая позволяет далее менять систему более быстро) используется и в «железной» инженерии. И уж тем более в инженерии предприятия, где и команды, и предприятие в целом ежедневно изменяются в части своей организации и методов своей работы, а не застывают после разового изготовления, сборки, наладки и «пуска в эксплуатацию».
Сдвиг влево (left shift) — это общее название для тренда, который двигает работы по практикам, расположенным далеко справа на функциональной/логической V-диаграмме, в самое начало логического времени разработки. Скажем, тестированием традиционно занимаются в конце проекта разработки, когда всё уже сделано. Но testing left shift (с этого и началось всё движение сдвига влево) означает, что сама разработка начинается с предложения тестов. Если ты понимаешь, что ты делаешь, то ты можешь это проверить: вот и напиши тесты, покажи понимание задачи. А потом разработай систему, которая эти тесты пройдёт. Описание тестов сначала, разработка потом, затем тестирование, доработка, развитие тестов, ещё доработка, тестирование, развитие тестов и т.д. Но описывать тесты нужно до начала разработки (сразу тесты как документирование гипотез того, что должна делать система — тесты как функциональное описание чёрного ящика).
Безопасность/safety? Сразу подумайте, а не после того, как к вам придёт инспекция или что-то плохое произойдёт из-за вашей системы в жизни. Защита/security? Сразу подумайте, будьте прочным165! Не берите архитектуры, которые легко взламываются, не берите в проект готовые (COTS) части системы, про уязвимость которых вам ничего не известно! Учитывайте защиту сразу, а не после того, как вашу систему взломали!
То же самое происходит буквально со всем остальным, что оставлялось «на потом». Сначала спроектируем, потом будем думать о том, как изготовить? Нет, думайте сразу, и то же самое про изготовление и многое другое. Это обобщается иногда как тренд «design for X»166 или «design for eXcellence» (DFX): design for manufacturing, design for cost, design for power в электронике, design for inspection и т.д., включая даже просто понимание множественности целей проектирования как design for eXcellence в подходе Six Sigma как одном из вариантов Lean методологии. Смысл сдвига влево в том, что предметы интереса, неизбежно возникающие «потом», рассматриваются «сначала», то есть учитываются разработчиками сразу. Это кажется невозможным (слишком много чего нужно учесть), но каким-то образом в современных проектах получается. Впрочем, это не «каким-то образом», а вполне понятным образом, который как раз и обсуждается у нас в руководстве: команда разработчиков хорошо «вооружена» и использует множество поддержанных компьютерами методов работы, которых некоторое время назад на планете попросту не существовало, а объяснительные теории для этих методов были массово неизвестны. И это очень контринтуитивные методы, их использованию разработчиков нужно учить специально, без обучения и объяснения они в проекте невозможны.
Успех в разработке достигается за счёт развитого порождающего моделирования (руками никто не рисует, всё больше и больше работы перекладываются на компьютер, разработчик по факту только формулирует задание моделеру), разработка хорошо документируется, поэтому «все ходы записаны», а не «проект у меня в уме» и «я ему неделю назад устно сказал». Управление конфигурацией тоже даёт свой вклад в успех разработки (все коллизии между «записанными ходами» обнаруживаются рано). Успех непрерывной разработки достигается за счёт хорошей модульности вследствие тщательной проработки архитектуры (ошибки не распространяются далеко по системным связям и остаются внутри модуля, один неудачный модуль не останавливает всю систему, неработающая «фича» — это не неработа всей системы в целом, архитектурные характеристики имеют метрики и отслеживаются, независимые модули могут разрабатываться независимыми командами). Разработка следует SoTA в определении того, как будет работать система — учёт прикладной методологии предметной области, велосипеды не изобретаются, но для достижения функциональных и ценовых характеристик лучше, чем у конкурентов наоборот — изобретения приветствуются.
Разработка происходит инкрементально с очень маленькими и быстро проводимыми изменениями (continuous delivery). И главное: разработка эволюционна/непрерывна (continuous development) и гибка (agile). Она никогда не заканчивается и не идёт по строгим этапам, а учитывает:
-
всё новые и новые обнаруженные в проекте особенности окружения (оно меняется постоянно, это жизнь!),
-
проблемы в работе разрабатываемой (под)системы (ошибки находятся постоянно!),
-
особенности непрерывно меняющихся моделеров (их AI-возможности меняются очень быстро)
-
организации разработки (они тоже непрерывно меняются — и даже, когда изменения к лучшему, а не «энтропия разрушит и нас», к этим изменениям нужно адаптироваться).
Успех системы оказывается не «достигнут», а «непрерывно достигаем» — успеха надо не просто достичь, надо его долго удерживать, современная эволюционная разработка с её «непрерывным всем» нацелена именно на это, достижение ускользающего успеха, а потом долгое его удержание.
Смерть инженерии требований
Когда первые версии нашего руководства писались до примерно 2017 года, то в нём был раздел по методам инженерии требований как обязательной составляющей лучших методов системной инженерии. Работой по этому методу занимался инженер по требованиям, одна из специализаций роли системного инженера.
Но всё изменилось, когда с 2017 года в литературе по программной инженерии вдруг перестали появляться новые книги по инженерии требований, а в 2022 году и в «железной инженерии» такие книги стали редкостью. Развитие инженерии требований прекратилось, а в работах по инженерии исчезли подробные описания методов инженерии требований, хотя само понятие требований иногда и упоминается, если речь идёт о самых консервативных областях инженерии. Наше руководство учло этот тренд, в текущих его наставлениях не говорится о требованиях, инженерии требований, роли инженера по требованиям.
Это очень контринтуитивно: если система не описана как чёрный ящик в деонтической модальности (это и есть «требования»), то как архитектор и разработчик узнают, какую систему нужно делать? Как испытывать систему, если нет требований? Увы, это всё вопросы, которые осмысленны в уходящем веке «водопадной системной инженерии», где каждая роль выполняет по очереди свой метод и передаёт результат дальше по цепочке как обязательный для следования, в том числе передаёт разработанные в проекте требования (такого, чтобы требования были разработаны клиентом, обычно нет — требования разрабатывал инженер, а клиент лишь соглашался с разработанным).
В книге «Learning Domain-Driven Design. Aligning Software Architecture and Business strategy», 2021, Vlad Khononov рассказывает, что традиционный ход разработки корпоративного программного обеспечения (часто называемого «кровавый энтерпрайз» в среде программистов) представляется как перевод разными людьми какого-то знания об организации на свой собственный профессиональный язык (скажем, «счёт» у продавца становится «офертой» у юриста, «структурой данных» у программиста).
Эти представления переводятся людьми в какие-то тексты или информационные модели, а затем идёт передача текстов и моделей на этих профессиональных языках дальше по цепочке из других ролей. Это «испорченный телефон» (Chinese whispers, broken phone), детская игра, где не очень разборчиво все говорят какую-то фразу друг другу на ухо по цепочке, а на выходе получается что-то совсем невнятное и уж точно не то, что говорилось на ухо первому человеку. Вариант этой игры — попытки передать какие-то стихи через цепочку из двух-трёх переводчиков на разные языки. Когда итог переводится на язык оригинала, текст уже невозможно узнать.
Вот эта цепочка, как она существовала раньше в инженерии (и это было много лучше ситуации, когда вообще ничего этого не происходило, а система делалась без внимания к тому, что там происходит в предметной области, «без требований», по наитию разработчиков):
-
Какое-то знание предметной области организации высказывалось специалистами предметной области (subject matter experts), а затем часть этого знания переводилась в «аналитическую модель» аналитиками
-
Аналитическая модель затем переформулировалась в виде «требований», этим занимались инженеры по требованиям. Аналитики не меняют мир, инженеры — меняют. Поэтому аналитики только «делали предложения по требованиям», а инженеры — требовали!
-
Требования становились проектом/design программной системы, этим занимались архитекторы, понимаемые как «опытные разработчики», или даже сразу «опытные разработчики» (в Software Engineering Body of Knowledge архитекторы появились только в 2024 году, в четвёртой версии167), и там плохо различима собственно архитектура как структура системы и методологическая проработка функционального описания, организация системы
-
Проект/design системы становился исходным кодом, этим занимались кодировщики
-
Исходный код становится изготовленной системой, этим занимались DevOps.
И это мы ещё не коснулись тестов, учебных материалов для пользователей и работы служб поддержки пользователей, не коснулись многих других рабочих продуктов.
Описанная цепочка работала плохо (а кое-где она до сих пор работает, и тоже работает плохо), ибо каждое звено цепочки говорило на своём профессиональном языке.
Нам нужно сделать так, чтобы разговор пользователей, разработчиков, операторов системы шёл по возможности на одном языке — языке предметной области. Если речь идёт о финансах, то это язык не инженерии программного обеспечения, а язык финансов. Если это софт, помогающий маркетингу, то это язык маркетинга, но не язык программистов. Никаких «серверов», «асинхронных передач сообщений», «баз данных» в обсуждениях софта! Впрочем, то же самое верно и для любой другой инженерии: обсуждаем постановку задачи для инженеров на языке предметной области пользователей, а не языке разработчиков. Если у вас «органическая основа для электролита» (момент эксплуатации!), то это не «растворитель» (момент, когда разработчик выбирает, что потом станет органической основой для электролита). Если кишечнорастворимая оболочка лекарства (чтобы безопасно донести лекарство до кишечника, а не только до желудка), то не «желатин с добавками» или «агар с добавками»168. Обсуждается то, что должна делать система (какие объекты проявляют какое поведение), а как именно она это делает и из чего состоит, и что там за инструменты, и из чего они состоят — это совсем другие вопросы, их можно решить позже или раньше, и даже не в присутствии представителей внешних проектных ролей.
Поэтому первый аргумент против требований — разработчики не слышат того, что говорят внешние проектные роли, «испорченный телефон» до них это не доносит, в ответ на этот аргумент надо убрать цепочку из людей, а заодно и используемые этой цепочкой «требования» как лишний артефакт. Экономия времени на беседах разработчиков с внешними проектными ролями — мнимая, исправление ошибок понимания через цепочку «испорченного телефона» потом всё равно займёт у разработчика больше времени, плюс ещё потратит время много других людей. Посредников между разработчиками и внешними проектными ролями — выкидываем, а заодно выкидываем и их рабочие продукты, в том числе «требования». У разработчиков будут свои способы записать то, что они услышали от внешних проектных ролей (забегая вперёд: они сразу будут записывать услышанное в виде тестов, а тесты будут сформулированы в терминах предметной области, при этом сама программа или «железо» будет поддерживать термины предметной области. В программе «счёт» будет не «структура данных», а «счёт», в «железе» будет «ограничитель хода заготовки», а не «штырь»).
Второй аргумент в том, что деонтический характер требований (то есть характер долженствования, дозволения, предписания, рекомендации) как-то не очень вяжется с коллективным характером мышления в разработке. Любая разработка сегодня понимается как часть эволюции, часть познания, часть изучения того, как уменьшить неприятные сюрпризы. И деонтическое «я начальник, ты дурак» (с ответом «ты поручил дурацкое, я тебе сделал дурацкое») тут не очень правильно. Поэтому вместо деонтической модальности (долженствования) переводим разработчиков на работу в доксической модальности (веры), вместо приказов выдаём гипотезы, которые надо проверять.
В мышлении инженеров мы используем «научный метод», который оказывается общим и для науки/исследований, и для инженерии. Только в науке мы делаем гипотезы о том, каковы могут быть лучшие объяснения, а в инженерии мы делаем гипотезы о том, какова может быть успешная система, которая меняет жизнь к лучшему. Какие-то идеи могут быть удачны, какие-то нет. То есть не «корпус системы должен быть не более 10 сантиметров шириной, исполняйте», а «сейчас верю, что корпус системы не более 10 сантиметров шириной будет успешен, пробуйте, а если нет, то попробуем другие цифры или вообще сделаем бескорпусное изделие». А где гарантии, что гипотезы подтвердятся? Гарантий нет! Выдвигавший гипотезу может ошибаться, или гипотеза верна для одного момента времени и одной ситуации, но не для другого момента времени и другой ситуации.
В ответ на предложенную гипотезу можно ещё проверить варианты, реализовать не один вариант системы, а несколько разных — и выбрать лучший. В ответ на требования — только выполнить заданное требованием, кто выдал требования — тот принимает на себя ответственность за результат.
В ходе разработки выдвигаем идеи-гипотезы, затем критикуем эти идеи, выбираем лучшие из худших (это особо оговаривается: всегда выбираем не лучший вариант, а наименее плохой, «лучший вариант» не существует в принципе) и реализуем их, проверяя уже жизнью. Потом пробуем улучшить эти идеи, а если не получается улучшить, отказываемся от этих идей и пробуем что-то ещё. С требованиями так не получается, там «делай, что говорят» — критика не уместна, водопад назад не течёт.
В варианте с гипотезами нет требований, но есть какие-то идеи о том, какой могла бы быть система, меняющая жизнь к лучшему (ну, или хотя бы новое поведение/функция системы, функциональный объект, его выполняющий, называют feature), и эти гипотезы сразу можно записывать в виде тестов, которые проверяют их реализацию.
В организационном менеджменте такие идеи сразу называют «предпринимательская гипотеза» (если речь идёт о выпуске нового продукта или новой «фичи» в продукте). В классической инженерии такие идеи имеют специальную форму и их могут называть «концепция», чтобы отличить от жёстких требований. Для системы в целом это могут называть пользовательская концепция (operations concept, OpsCon) или концепция использования (concept of operations, ConOps), причём разные школы инженерии или находят нюансы в различении этих понятий, или наоборот, считают одним и тем же. Мы будем следовать предложениям книги «Systems Architecture. Strategy and Product Development for Complex Systems», 2015, и говорить о просто концепции/concept использования, без нюансов различения (при этом книга выпущена давно, требования, конечно, в ней есть — но есть и концепции).
Эта книжка уже не про программную архитектуру, а системную (прежде всего киберфизических систем, типа ледовой буровой платформы или космического корабля) архитектуру, но в подзаголовок и в книге по DDD, и в книге Systems Architecture вынесена «стратегия»: метод, который должен привести к успеху.
В принципе, и «стратегию» (метод/функция, который по возможности рационально выбирается в ситуации, когда непонятно что делать) можно было бы считать функциональными требованиями к предприятию, но этого слова «требования» в случае предприятия тем более избегают: стратегия сегодня считается непрерывно уточняемой, это тоже гипотеза о том, что было бы в текущей ситуации делать лучше всего (или как заметят архитекторы — что в текущее ситуации делать менее плохо, чем всё остальное, включая делать «ничего»).
В помянутых двух книгах ещё и слово «архитектурный» устарело: до 2017 примерно года архитектурой повсеместно называли решения опытных разработчиков, которые принимались рано по жизненному циклу в силу того, что дальше эти решения было трудно менять без того, чтобы не переделывать всю систему. И эти решения принимались очень похоже на то, как принимались требования — в деонтической модальности, это точно не были гипотезы, разве что требования разрабатывали в инженерной команде, но принимались они вроде как от лица клиентов, а архитектурные решения разрабатывались тоже в инженерной команде, но принимались они от лица опытных разработчиков, называемых «архитекторы». Более того, не слишком различались описания чёрного ящика (система и её поведение, наблюдаемое извне, без описания внутреннего устройства системы и внутреннего поведения системы — требования) и описания белого/прозрачного ящика (система и её поведение, наблюдаемые внутри системы, на уровне подсистем — архитектура как важнейшие решения). В технических заданиях легко можно было встретить в разделе требования и указания на функции системы, и указания на какие-то подробности конструкции (вроде «несущую ось делать из титанового сплава»), и это утверждалось клиентом как «требования», хотя иногда архитектурные решения выдавались за «ограничения» (формально оставаясь, тем не менее, «требованиями», да ещё и «требованиями клиента», хотя разрабатывалось это инженерной командой проекта, а клиент лишь соглашался с результатами этой разработки, «согласовывал»).
Сегодня понятие «архитектуры» как решений опытных разработчиков в части основных решений по верхнеуровневой структуре и организации системы, которые трудно поменять без переделки всей системы — устарело. «Архитектура» теперь относится не «ко всему важному, чтобы это ни было», но только к архитектурным характеристикам и структурным/конструктивным решениям модульного синтеза, о чём будет подробней в следующих разделах.
«Стратегия» тоже перестала быть аналогом важных требований к поведению создателей (в деонтической модальности), но стала гипотезой/догадкой о наименее плохом поведении создателя (доксическая модальность). Стратегия тут — эвристика, суеверие, может и должна пересматриваться.
Требования выполняют, гипотезы и эвристики — проверяют/пробуют. Реализация стратегии — это не выполнение требования, ведущее к гарантированному результату. Это следование эвристике, проба действовать на основе (возможно, ошибочной) предпринимательской гипотезы/hypothesis/ставки/bet, ведущая к возможному, но не гарантированному успеху.
Это означает, что стратегия в случае обнаружения несоответствия гипотезы и жизни может быть подправлена, чтобы это соответствие случилось. И точно: несмотря на то, что книжка Systems Architecture описывает вроде как «водопад», много внимания в ней уделяется идее постепенного уточнения системной архитектуры в её старом понимании (мы будем называть её «концепция системы», чтобы не путаться) в ходе работы над проектом, выдвижение новых гипотез и их уточнение, а иногда всё-таки отбрасывание и переход к полностью новым гипотезам.
Концепция системы («старая архитектура») — это описание того, каким образом какой-то набор конструктивных частей целевой системы исполняет роли функциональных частей системы, чтобы в конечном итоге выдать требуемый от системы сервис на уровень надсистемы в момент использования. В концепции системы выделяют тем самым:
-
Высокоуровневое (на один-два уровня) функциональное описание. Раньше говорили «функциональная архитектура», «логическая архитектура», «функциональная организация», подчёркивалось, что они получаются разбиением сверху вниз. Сегодня — идея «последовательного разбиения сверху вниз в ходе разработки» признана полностью неработоспособной, «так бывает только в сказках». Сегодня чаще всего говорят про из средних слоёв синтез вверх и разбиение вниз при общем итеративном характере процесса. И сегодня вместо разбиения/анализа говорят про синтез функционального описания. Делает этот синтез прикладной методолог, процессный инженер, функциональный проектировщик — названия роли тут могут быть самые разные, на выходе что-то типа «принципиальной схемы» (вы должны быть уже хорошо с этим знакомы, ибо владеете мастерством методологической работы по нашему руководству, в руководстве по методологии об этом было подробно).
-
Высокоуровневое (на один-два уровня) конструктивное описание. Раньше говорили «структура системы», «конструкция», «физическая архитектура». Сегодня говорят просто «архитектура системы», что может легко сбить с толку (раньше архитектура системы по факту была «концепцией системы»). Архитектурное описание говорит о такой архитектуре как разбивке на модули (или не о разбивке, а о синтезе из модулей, «модульном синтезе» — зависит от того, как вы смотрите на конструктивную иерархию), которая даёт необходимые важнейшие архитектурные характеристики (раньше это были «требования качества», которые относились ко всей системе в целом и не относились к предметной области, в которой работала система — не были «функциональными требованиями», определяющими прикладную специфику системы): высокую скорость развития/evolvability для времени создания системы, возможность масштабирования как увеличения производительности по мере роста потребности в сервисе системы, собственно самой производительности системы, и т.д. Конструктивное описание, описание структуры системы — это разбиение на конструктивные модули и определение способов связи этих модулей через интерфейсы. «В сказке» тут тоже сначала надо было разбивать (системный анализ, «разбиение») систему как функциональный физический объект на подсистемы, которые разбивались на всё более и более мелкие подсистемы, а затем конструктор определял самые мелкие детали (деталь — это часть конструкции, которая сама уже не собирается из других частей), которые выполняли функции подсистем (необязательно 1:1, это рассказывалось в руководстве по системному мышлению на примере ножниц и чайника), а проектировщик собирал/синтезировал из этих деталей целую систему как конструктивный физический объект. Идея «только синтез, только снизу вверх» уже признана сказочной, в жизни это невозможно, возможен только итеративный процесс разработки конструкции, тоже чаще всего от средних слоёв конструктивной иерархии постепенно модульный синтез вверх и модульное разбиение вниз, принцип «изнутри наружу». Этим занимается обычно архитектор в его современном понимании, на выходе это чаще всего называется «эволюционная архитектура», чтобы показать её неокончательный и меняющийся характер, и главная там идея — подобрать такие элементы конструкции, чтобы изменение функциональных частей системы по минимуму влияло на изменения конструктивных частей системы. Это мы подробно расскажем в разделе «Эволюционная архитектура» нашего руководства.
-
Кроме согласованных между собой высокоуровневых функционального и конструктивного описания в концепции системы, конечно, участвуют и другие виды основных системных описаний, минимально там ещё описания размещения и стоимостные, но могут быть и необходимые другие описания (это подробно разбиралось в руководстве по системному мышлению).
Концепция использования — это аналогичное концепции системы описание
надсистемы: каким образом целевая система играет в надсистеме функциональную роль, позволяющую достичь нужных функциональных и архитектурных характеристик надсистемы, то есть удовлетворить потребности внешних проектных ролей, а также описание системы как конструктивной части, которая имеет какие-то интерфейсы к конструктивным частям надсистемы, а также эта целевая система где-то размещена и имеет какую-то стоимость.
В упомянутой книге по системной архитектуре очень верхнеуровневая начальная концепция системы называется просто «основная идея», а вот то, что там называется «архитектурное описание» (и даже просто «архитектура», в руководстве по системному мышлению мы говорили, что инженеры очень вольно обращаются с типами и часто используют троп169 метонимии170) даётся по старинке, как дополнение и расширение концепции в сторону прозрачного ящика со всеми видами системных описаний. Конечно, система описывается в том числе и как достигающая каких-то значений важных архитектурных характеристик/-ilities/-остей (например, надёжность, ремонтопригодность, и из относительно новых важных характеристик — evolvability, изменяемость в ходе развития, testability, возможность лёгкого тестирования, deployability, возможность быстрого разворачивания для эксплуатации без длительного нерабочего времени). Архитектурные решения по книге просто детализируют концепцию системы, учитывая множество дополнительных соображений кроме «вот эти функции можно реализовать вот такой конструкцией, чтобы добиться вот таких сервисных характеристик системы-модуля в целом». В современном подходе эволюционной архитектуры принимаемые архитектором решения не столько детализируют все (функциональные и конструктивные) решения концепции, сколько накладывают ограничения на конструктивную часть концепции: «вот эта конструкция должна быть разбита на вот такие части-модули с вот такими между ними интерфейсами, чтобы добиться вот таких-то архитектурных характеристик».
В книге для рассказа используется диаграммная техника OPM (object-process modeling), в которой есть объекты, связанные друг с другом отношениями. И среди этих объектов выделяют функции (поведение), которые выполняются некоторыми инструментами (конструктивными объектами) над некоторыми пассивными объектами («молоток бьёт по гвоздю»). В руководстве по системному мышлению отмечался такой подход: в некоторых инженерных традициях не принято говорить о функциональных объектах, а принято говорить о поведении/функции, само же поведение-функция приписывается потом сразу конструктивным объектам, функциональные объекты при этом подразумеваются. Конструктивные объекты в упомянутой книге по системной архитектуре называют «формами». То есть вместо «камень::конструктив играет роль забивала::функциональный объект, а забивало забивает::функция связыватель::функциональный объект, роль которого играет гвоздь::конструктив» говорят короче: «камень::форма/конструктив забивает::функция гвоздь::конструктив». Таким образом, весь рассказ о забивале довольно легко понять: современная концепция использования — это архитектурная работа (функциональная декомпозиция и модульный синтез), как она обычно понималась раньше в системной инженерии, только на буквально один уровень в надсистеме (забивало нужно там). Отсюда и упоминание стратегии как отсылка к целеполаганию: концепция использования как раз говорит о выявлении функций целевой системы, которая сделает надсистему успешной.
Сегодня создание концепции системы уже не называют архитектурной работой, ибо современная архитектурная работа связана не столько с созданием концепции использования (хотя в ней могут быть заданы приемлемые значения архитектурных характеристик, архитектор этим живо интересуется и высказывает гипотезы об их значениях), сколько с созданием концепции системы в части верхнеуровневого задания конструкции системы такой, чтобы дальше можно было как можно более независимо разрабатывать отдельные части этой конструкции.
Конечно, современные и концепция использования, и концепция системы задаются не «деонтически» (как требования), а как гипотезы, эвристики, которые могут быть и изменены, если выяснится, что они не ведут к успеху. Поэтому раньше иногда говорили «требования архитектуры», а теперь предпочитают говорить «архитектурные решения».
Раньше, когда опытных разработчиков называли «архитектор», а создаваемую систему поначалу описывали в виде «набора требований», о концепции использования предпочитали не говорить как о важном рабочем продукте — ровно потому, что её не утверждали так серьёзно, как требования, она изначально воспринималась как «документирование гипотез». Кто-то приходил с идеей, затем оформлял идеи в виде концепции использования, и это был «мутный вопрос», в учебники по системной инженерии и стандарты он не попадал, ровно потому как казался «недостаточно строгим». Скорее, это был вопрос маркетологов, политиков, предпринимателей, кого угодно, но не инженеров — инженеры не выходили с идеей продукта, а если и выходили, то неформально, решение о выделении ресурсов на «серьёзную работу», то есть разработку требований, должны были принимать не они, а «кто-то с деньгами», но написать для этих «людей с деньгами» неформальные предложения должны были как раз инженеры.
Внешние проектные роли могли общаться с инженерами, но в формальный жизненный цикл однократной разработки это не попадало. Только некоторые школы системной инженерии соглашались, что разработка концепции использования входит в жизненный цикл инженерного проекта, в большинстве других школ в этом месте просто говорилось, что «надо написать текст на несколько страниц с основной идеей», не прояснялось как это делать и кто это делает. Когда приходят к инженерам, то уже кто-то сформулировал концепцию использования. Если концепцию использования и формулировали инженеры, которые искали себе работу, а потом «продавали» идею предпринимателям, то это не акцентировалось. Это не было «официальной» работой инженера, в то время как формулирование «требований» было как раз работой инженера, но считалось, что требования тоже — поступают от клиентов, менеджеров, кого угодно, но не от самих инженеров. Инженеры только «выполняют требования». Изменение требований, конечно, было возможно — но «приказ сначала выполняется, потом обсуждается». Изменение требований означало, что мы вышли за пределы предписанного «наукой» способа разработки «сверху вниз» (то есть поднимались по водопаду вверх!).
После того, как в проект вбрасывалась концепция использования «на трёх страничках», выделялись деньги — и проектом дальше занимался инженер по требованиям. Он делал реверс-инженерию надсистемы и документировал в виде спецификаций требований описание целевой системы, которая должна будет удовлетворить потребностям. Разработчики системы (прикладные инженеры, архитекторы, специалисты по инженерным обоснованиям) тем самым отсекались от общения с внешними проектными ролями. Это пытались исправить ходом на «модели требований», где кроме собственно формулировок требований пытались отметить, что кто из внешних проектных ролей говорит, на чём настаивает (переход на язык предметов интереса и интересов вместо языка конкретных значений, а также указание ролей, высказывающих свои интересы и их конфликтов, которые нужно как-то решать).
Потом «водопад» продолжал падать сверху вниз: требования (среди которых часто были и архитектурные решения, ибо системного мышления и понимания про разницу решений по вопросам снаружи границы целевой системы и вопросам внутри границы целевой системы не было) передавались системным инженерам-архитекторам, которые принимали решения по поводу концепций на следующих уровнях, и уже они формулировали требования на уровень ниже, то есть требования к подсистемам.
Скажем, идея нового самолёта приходила откуда-то «из бизнеса» (хотя неформально активно обсуждалась с инженерами), потом составлялись требования, потом архитектор делил проект на части и формулировал требования к двигателю, выбирая его концепцию: реактивный он будет, турбореактивный, или двигатель внутреннего сгорания для приведения в движение пропеллера. Эта «концепция следующего уровня» так даже не называлась, а архитектор просто выступал инженером по требованиям по отношению к архитекторам следующего уровня (архитектор самолёта выступал инженером по требованиям по отношению к архитекторам авиадвигателя).
В жизни всё работало совершенно не так, существенно итеративно, но обсуждалось именно так — строго постадийно. Ключевая модель концепции системы (с верхним уровнем как концепции использования, а дальше «прозрачный ящик) выглядела как «модель сэндвича»171, 2004 год.
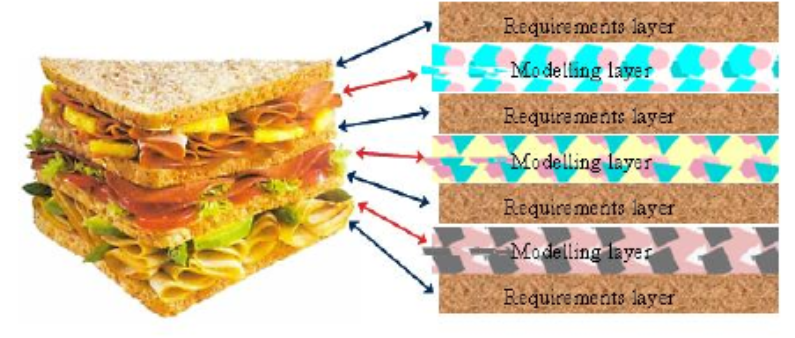
Хлебом как раз были «слои требований». А поскольку требований оказывалось много разных, они начали получать разные названия:
Проблема была в том, что в этих картинках требования считались неизменными (раз и навсегда определяемыми), а моделированию позволялось изменяться по ходу всё лучшего и лучшего понимания предметных областей. «Заказчик» вроде как обязывался быть стабильным (как будто он сам не инженер! Как будто он обладал изначально совершенным знанием того, что ему нужно! Как будто говорил не гипотезы, а абсолютные истины!), а модельеры каждого уровня могли только торговаться по поводу удовлетворения этих стабильных требований. Эти спецификации ещё и ограничивали, как выяснилось, генерацию изобретательских идей172.
Требования в жизни оказались непрерывно изменяющимися на всех уровнях (водопад в реальности тёк снизу вверх во всех проектах!), но это не отражалось ни на каких диаграммах, в головах был «водопад», изменение требований наказывалось, было «сходом с дороги в бездорожье», а не нормальным ходом вещей. Если требования можно менять, то какие же они тогда «требования», в чём «долженствование»?
Основное время проводилось тем самым не за «требованиями» (которые потом в конце проекта можно было по-быстрому оформить, подписать — и сдать в архив, не читая), а за самыми разными моделями «чёрных ящиков», как раз modeling layer — и вот сами эти модели как рабочие продукты не показаны на диаграммах сэндвича, скрыты за словом слой/layer! Все эти use cases, концепции использования, разные варианты сценариев, функциональные диаграммы, списки внешних проектных ролей считались просто вспомогательными для получения требований.
Дальше переходили к моделям прозрачного ящика (показаны как очередной modeling layer, но уже уровня подсистем), по которым потом генерировались требования к подсистемам. Формально требования должны были идти дальше по цепочке «испорченного телефона», а неформально (чаще всего) они оформлялись — и без чтения шли в архив, а настоящая работа продолжалась с моделями систем, подсистем. Что надо было изменить? Объявить lean — не делать лишнюю работу, генерацию требований на основе готовых моделей! Оставить слои моделирования, выкинуть слои требований! Это бы и была «гибкая/agile методология разработки», а «анархия» убиралась при этом управлением конфигурацией (прежде всего — конфигурацией моделей: известно на любой момент времени, какие из версий моделей отражают последние договорённости в проекте). Но нет, несоответствие «водопада» и жизни объяснялось как «инженеры-разработчики системы, вы недостаточно стараетесь соответствовать идеалу», а не «менеджеры-организаторы проекта, вы очень плохо понимаете, как создают и развивают системы, ваши идеи в корне неверны».
Регламенты «водопада» требовали работы на основе требований, а не моделей — и поэтому приходилось изворачиваться, уходить от разных проверок. Было очень неудобно: работать «как предписано водопадом» не получалось, а нормально работать — непонятно было, как именно, теории не было, регламентов такой работы не было, изобретались неэффективные велосипеды, но зато проект хоть как-то шёл. Увы, во многих проектах до сих пор такая ситуация, исключением тут являются пока только проекты программной инженерии, но и те — в передовых компаниях.
Так, знание моделей use cases (тот самый modeler layer), из которых и извлекались требования, никуда от инженеров по требованиям не попадало кроме того, что оказывалось в требованиях. Эти требования шли дальше по цепочке от инженеров по требованиям — к архитекторам (в те времена архитекторы были — «опытные разработчики» следующего уровня, то есть разработчики концепции системы, а не концепции использования). И тестирование тоже было не того, что в моделях — тестирование было по тестам, которые делались на основе требований, люди занимались тестированием очень поздно по жизненному циклу (однократному!).
Встречи разработчиков с агентами, исполняющими внешние проектные роли считались злом, отвлекающим от работы, общаться с внешними проектными ролями предлагалось только инженерам по требованиям, «для эффективности». Разработки при этом шли очень медленно и дорого. Много действий происходило в проекте неформально, вне всяких регламентов и предписаний методологий разработки. Любое изменение в понимании системы и её окружения становилось адом: изменять часто нужно было требования, которые представлялись всем незыблемыми. То есть «изменение незыблемого» было постоянно, ощущалось это как непрерывная авария, непрерывный пожар в проекте.
Главным инструментом моделирования для получения требований стали сверхкраткие текстовые описания того, какое ожидается поведение системы в надсистеме (концепции использования), а затем модели use cases: формально представленные сценарии, по которым система как целое (или части системы как целое) взаимодействуют со своим окружением. Напомним, что в use cases некоторые акторы/агенты (живые и неживые, просто способные к взаимодействию) как-то взаимодействуют с системой, и показываются реакции системы, её поведение, которое и оказывается функциями системы. А требования? Они появлялись в результате документирования как-то уторгованного среди разных внешних и внутренних проектных ролей понимания того, как ведёт себя система (или подсистема) в разных вариантах взаимодействия с окружением.
В итоге совсем недавно было признано:
-
Важны не требования, а непрерывно уточняющиеся поведенческие модели (модели изменения состояний в ходе функционирования), то есть сценарии использования, диаграммы активности и другие виды моделей, отражающих поведение системы. Эти поведенческие модели отражают непрерывно меняющийся набор гипотез о том, что должна делать успешная система. Поскольку вопрос об успешности системы (успешности подсистемы, и т.д. по уровням), то в этих моделях должны учитываться и внешние проектные роли (а внутренние проектные роли вполне могут быть внешними проектными ролями для подпроектов: разработчик самолёта будет внешней проектной ролью по отношению к разработчику авиадвигателя).
-
Этими моделями должны заниматься сами разработчики без посредников в лице «аналитиков» или инженеров по требованиям. Прикладные разработчики с «архитекторами как опытными разработчиками», или сначала визионеры с эволюционными архитекторами, а прикладные разработчики с методологами/«functional designer»/«process engineer» потом (более современный вариант) — это уже не так важно, главное, что без «испорченного телефона».
-
Поскольку требований нет, то их и не надо менять, «брать назад поручение сделать, признаваться в ошибке». Меняется (уточняется!) понимание, отражаемое в моделях как гипотезах. Модели (и чёрного ящика, и прозрачного ящика) меняются «в рабочем порядке», анархии и неминуемых многочисленных ошибок при этом нет, ибо налажено управление конфигурациями, все версии учтены, исправления делаются только в актуальных версиях, за основу дальнейшей работы берутся только актуальные версии.
-
Людям в проекте при этом можно и нужно менять своё мнение (свои инженерные решения), аргументы (обоснование инженерных решений) берутся из моделей и основываются на результатах моделирования и проводимых экспериментах. Любая реализованная версия системы объявляется прототипом для следующей улучшенной и дополненной новыми «фичами» версии, даже если изготавливается всего один экземпляр: никакой экземпляр в эволюционной разработке не является последним. Если даже это летит ракета на Марс, то это не единственная попытка. Будет получено новое знание, и модели для следующей летящей на Марс ракеты поменяются. Каждая следующая ракета будет лучше предыдущей, или изменится так, что будет не хуже (помним, что эволюционный ландшафт динамический, и нельзя просто ничего не менять, чтобы оставаться приспособленным).
Что же сегодня предлагается «вместо требований»? Вместо — ничего, требования просто выкинули как лишний рабочий продукт. Незачем класть в архив то, что потом никогда не будет посмотрено. Ну, или нужно только для суда, определить формально «кто виноват» — «подписал требования». Но суд может и должен разбираться «по существу дела», а не «на основе сданных в архив документов». В суде ведётся расследование, а не просто берётся документальный факт из архива.
Но что будет «без требований» описывать систему на её границе? Набор постепенно уточняющихся и изменяющихся моделей и других описаний «чёрного ящика» (а иногда и «серого ящика», то есть на несколько системных уровней), по которым и ведётся разработка полной архитектуры. Но и это не последний исторический ход избавления от испорченного телефона и лишних рабочих продуктов.
Последний ход — это онтологическое моделирование в форме DDD, чтобы «попасть в предметную область» и получить bounded context (по факту — синоним «предметной области», набор типов предметов, которые задействуются в каких-то методах совместно). Да, и в «железной» инженерии онтологическое моделирование тоже есть, слова там важны, описывать предметы тоже надо. Вот пример на картинке:
А в какой форме описывать поведение? В форме use case? Да, так и делали — но потом оказалось, что поведение можно писывать сразу в форме тестов — чтобы проще было проверять это поведение. В программной инженерии это можно делать сразу на языке тестов, например, записывая сценарии в синтаксисе Gherkin системы тестирования Cucumber173. Вспомним, какие мы тут поминали рабочие продукты:
-
Сценарии (описывают поведение системы)
-
Требования (они лишние)
-
Проект/design с детальностью, достаточной для изготовления.
-
Тесты, которые проверяют выполнение требований, а если их нет — сценариев.
Выкидываем требования, а сценарии записываем в формате тестов — как то, что проверяется. Тем самым:
-
Если что-то меняется, вы сразу меняете тесты — и они же сценарии (вы же собираетесь проверять сценарии? Вот и записывайте их сразу в формате, удобном для проверки).
-
Отдельных сценариев и отдельных тестов, которые вы будете писать по сценариям — нет, это lean/элегантность. Ненужная работа не делается. Разработка ведётся так, чтобы удовлетворить тестам, они же «ожидаемая модель того, что будет происходить».
-
Отдельных сценариев и разрабатываемых по ним требований, по которым потом идёт разработка (создаётся проект системы с детальностью, достаточной для изготовления — например, программы для станков с ЧПУ или исполняемый программный код), к результатам которой потом разрабатываются тесты — нет. Тут lean, есть сразу тесты, они же — сценарии.
А если у вас какой-то обязательный в силу закона (требования!) стандарт, выполнение которого проверяется какими-то силовиками? Вы в ситуации «соблюдения закона»/compliance/«проверки соответствия». Попросите AI-систему перевести стандарт с требованиями в формат сценариев, который запишите на языке тестов, как мы подсказали174. Дальше всё как обычно: разрабатывайте систему, обоснование успешности разработки будет на основе прохождения тестов. Этот подход называется даже не TDD (test-driven development175), а BDD (behavior driven development176) как развитие TDD, и там ещё много вариантов (ATDD, acceptance test-driven development177 тут только один из возможных вариантов178, ибо встречаются и другие модификации примерно того же самого test-first подхода, причём test-first был когда-то отдельным термином, потом стал синонимом для TDD179: EDD, example-driven development180, SDD, story-driven development181, SpecDD, specification-driven development182 — все с одной и той же идеей записать желаемое поведение системы в какой-то форме, которая будет удобна для проверки или даже не будет требовать проверки, ибо система будет просто компилирована/синтезирована из спецификации желаемого поведения).
Behavior — это отсылка к методу/функциям, так что это прямая заявка на выполнение моделирования функций системы (впрочем, и функций подсистем) методологами/«функциональными проектировщиками», но результат документируется в виде сценариев поведения, автоматически трансформируемых в набор тестов для их проверки, сценарии пишутся по факту на языке тестирования. А что с поведением? Сценарий на языке тестирования как раз выражает поведение, которое надо проверить!
А что с новыми вариантами методов работы со сценариями использования в их классическом виде, например, Use Case 3.0? Они тоже остаются в прошлом183.
Почему же тогда тесты не назвать требованиями? Потому что это не требования, а тесты (и раньше тесты разрабатывались на основе требований, они ведь отличались от требований и назывались тесты/испытания, были программы испытаний). Ровно так же use case это use case, а не требования (они ведь и раньше различались): проблема не в переименовании, а в том, что перестали делать продукт «спецификация требований», который отражает описание чёрного ящика в деонтической модальности. Делаются гипотезы по поводу возможных таких описаний, эти гипотезы документируются в виде моделей, для которых можно организовать автоматическую проверку соответствия модели (то есть модели пишутся сразу как тесты, на языке тестирования). Эти модели (и тем самым тесты) не очень «требовательны», но «предположительны» и предполагают постоянное изменение по мере изменения общей проектной ситуации (внешние изменения в мире, изменения в бизнесе, изменения в понимании инженеров, учёт новых изобретений и т.д.).
Теперь разберёмся с постепенностью: это наша знакомая эволюционная/непрерывная разработка системы, она же создание MVP, а затем развитие системы. Раньше её описывали иногда как «инкрементальную разработку», а иногда как «итеративную разработку», противопоставляя их друг другу. И приводили самые разные картинки, которые нагло врали (из лучших, конечно, побуждений! Ибо приводимые метафоры не полностью соответствовали сути явлений). Вот типичные примеры этих кривых метафор:

Дальше возможны самые разные интерпретации — там можно услышать и «знаем, что хотим», и «не знаем что хотим», и «только через MVP», и «просто каждый раз ведите разработку с самого начала». Нет, там другие идеи:
-
Если рассматривать продукт, то есть идея инкрементальности: свойства продукта прирастают инкрементально в каждой версии (а уж за счёт новых частей продукта или переделок старых частей — дело десятое). Инкрементальность — это про продукт. Знаем ли мы, что там будет с продуктом? Не факт, но можно что-то такое представлять — это будет Roadmap. Инкрементальность разработки моделируется в roadmap: какие фичи (их так называет пользователь, «возможности», а вот для разработчика это «приращения функциональности продукта», инкременты продукта) в какой версии будут реализованы.
-
Если рассматривать процесс, то есть идея итеративности: мы выпускаем новые и новые версии продукта, каждый раз прокручивая какой-то инженерный процесс, то есть уточняя концепцию использования (определяем, что наша система будет делать — какие старые функции выкинем, какие новые добавим, какие ошибки исправим, какие оставим), затем (логически, в физическом времени тут итеративная совместная работа) уточняя концепцию системы (и архитекторы следят тут, чтобы на предыдущем шаге концепция системы уже была такая, чтобы какой бы следующий шаг ни был, изменения были минимальными — поэтому все эти безумные неверные картинки с MVP, проходящими велосипед-мотоцикл-легковушку-фуру надо выбросить).
-
Лучшие умы пришли к выводу, что нужна и итеративность, и инкрементальность — но они продолжали как-то противопоставлять шершавое и кислое. Нет там противопоставления! Это разговор про продукт и про процесс, два отдельных разговора.
Ошибка таких картинок была в том, что они опирались на устаревшие трактовки инженерного процесса, ещё во времена до понимания эволюционной архитектуры, во времена «старой архитектуры», где был «опытный разработчик» и ходили идеи «прототипов» в «спиральной модели разработки». Эти прототипы надо было делать «для получения информации» — и затем выкидывать. Эволюционная архитектура сразу поставила вопрос о том, что архитектор не принимает важные решения, которые поменять потом нельзя, если всё не выкинуть. Нет, архитектор старается сделать так, что ничего выкидывать целиком не придётся, все изменения будут локальны, переписывать « с нуля» не надо!
Идея картинок была в том, что «растёт функциональность», она инкрементально добавляется по сравнению с MVP, но архитектора за такое надо уволить сразу, такого не должно быть! Архитектура, понятно, тоже меняется! Но посмотрите: во всех этих примерах видно, что конструкция системы на «правильных» вариантах кардинально меняется, её надо переделать полностью! Это фиаско, провал, неудача, прототипирование с их выкидыванием сегодня — не лучшая практика. Можно думать и так, что в любой момент времени в проекте ничего нет, кроме прототипа, любая версия — прототип, гипотеза о том, что надо было бы делать, дальше получаем отклики от внешних проектных ролей, меняем прототип на следующий, делаем инкремент в следующей итерации. Но прототипы никогда не выкидывают целиком, переделывать надо какие-то отдельные модули, но не всё вообще! И если это не так, то это провал, фиаско, неудача архитектора (ну, или надо признать, что «проект оказался неудачным, закрываем его, делаем вираж/pivot, начинаем заниматься другим продуктом»).
Поэтому после прихода эволюционной архитектуры начали аккуратно писать про «эволюционную разработку», могут обсуждать инкременты и итерации, но вот противопоставлять итерационную и инкрементальную разработку — этого уже никто не делает. Как и не выкидывают прототипы целиком. Хотя иногда выкидывают не только прототипы, но и вполне рабочие текущие версии –но это очень серьёзное и очень редкое решение.
Подробней это разбирается при обсуждении работы «эволюционного архитектора». Конечно, так («эволюционный архитектор») его никто не называет, называют просто «архитектор», но и старого «опытного разработчика» тоже могут называть «архитектор», да и «функционального архитектора» могут называть «архитектор», хотя он методолог, да и результат его работы могут назвать «архитектурой». Помним пример из руководства по методологии: архитектурой искусственной нейронной сети называют её рассмотрение как протекание потоков данных через какие-то функциональные блоки. Архитектурным описанием нейросети обычно считают или dataflow диаграмма или псевдокод алгоритма обработки данных нейросетью. Но это не современный вариант понимания «архитектуры», ибо про модули тут вообще не идёт речь, это «функциональная архитектура», которая в современном архитектурном языке вообще отсутствует. Каждый раз проверяем: про какую архитектуру и какого архитектора идёт речь!
Обычно мы сразу не очень понимаем, чего хотим, и добавляем какие-то кусочки — и всеми этими кусочками можно пользоваться. Если мы делаем карандаш, то на первой итерации в первой же версии мы делаем карандаш из глины и угля в бумажном пакетике, затем потихоньку меняем глину на пластик, уголь на графит, пакетик на картонную коробку. Сохраняем что можно, меняем всё на более функциональное. Или даём пользователю шикарный современный графитовый (или тоже пластиковый) грифель, он им пользуется, но пачкает руки. Добавляем пластиковый корпус к грифелю, но пачка карандашей рассыпается по столу и неудобно продаётся. Добавляем картонную коробку. Понимаем, что можем положить в коробку и точилку, чтобы её покупали у нас, а не у конкурентов — и делаем её той же расцветки, что и коробку, чтобы уж точно не путали «наше» и «не наше». Модель карандаша при этом существенно меняется, при этом поначалу и карандаша нет как продукта, а потом карандаш становится только частью продукта. Это две стратегии получения карандаша (и одна даже вышла на коробку и точилку в придачу к карандашу), но может быть реализована какая-то смесь двух стратегий, или обе сразу (это ж всё гипотезы на каждом шаге!), всё зависит от того, сколько у нас ресурсов, сколько мы можем опробовать вариантов. И надо помнить в ходе всего проекта: «обычно мы сразу не очень понимаем, чего хотим» сохраняется в любой момент разработки, а не только в самом её начале! Итерации не прекращаются, инкременты не прекращаются! Разработка и выпуск разных версий продукта непрерывны, эволюционны!
Этот подход (беседа клиентов и других проектных ролей с разработчиком, документирование гипотез разработчика с предложением тестов вместо требований) был использован даже для «неживых программистов», а именно для генератора кода TiCoder184 (test-driven interactive coder), который был разработан на основе больших языковых моделей ещё в 2022 году. В этой работе уточняли намерение человека-программиста, подтверждая или опровергая предложения TiCoder и получили соответствие кода намерениям в 90.4% случаев. Метод/workflow назвали TDUIF (test-driven user-intent formalization). Сегодня большие языковые модели делают такое (и лучше) «из коробки», это уже стандартный путь разработки. Код компьютер-разработчик напишет лучше программиста-кодера, но для него пока нужно поставить задачу. Формализовать задачу до уровня, достаточного для однозначного решения задачи в форме кода программы можно в ходе диалога (непрерывное уточнение задачи), а не просто написав какие-то требования и утвердив их. Нет, вы будете формулировать гипотезы по поводу того, как должна вести себя программа — и оценивать результаты, затем корректировать гипотезы. Сегодня это штатный метод работы в software engineering (мы говорили о vibe coding), но это становится штатным методом работы и в инженерии системы другой природы — умеющие поддержать разговор на естественном языке большие языковые модели используются и в машиностроительных САПР (CAD/CAM/CAE). Эта сфера столь стремительно развивается, что мы не даём тут ссылок: ситуация изменяется еженедельно, исследуйте вопрос о готовности инструментов к такой работе сами.
Рассказанная здесь история про отказ от требований произошла главным образом в программной инженерии (включая, как видим, и работы по автоматизации работы программных инженеров), в меньшей мере инженерии киберфизических систем, ещё меньше в строительстве, а во многих других сферах оказалось, что «когда караван поворачивает, хромой верблюд оказывается впереди»: там не наладили работу по требованиям, поэтому отказа от требований и не будет.
В проектах зато стало нужным разработчикам кроме моделирования самой системы «от границы внутрь» моделировать ещё и внешнее поведение системы в плотном контакте с внешними проектными ролями, которые знают поведение системы «от границы наружу» (стандартный ход системного мышления: сначала смотрим функцию «наружу», и только потом конструкцию «внутрь»). В этом плане в огромном числе прикладных инженерий (скажем, в медицине, образовании, политике) отсутствие требований не означает современного (SoTA, state-of-the-art) состояния, ибо нет и моделирования, нет создания концепции использования, нет выражения модели в виде, готовом к тестированию (на языке какой-то системы тестирования).
В жизни вы сегодня увидите и отсутствие каких-то моделей и требований («доинженерное» состояние в какой-то прикладной инженерии), и работу с требованиями (скорее всего, в классической «железной инженерии»), и современную ситуацию с моделированием концепции-как-гипотезы вместо требований (скорее всего, во фронтирных IT-компаниях). Это как пелетон/пелотон, когда велосипедисты вдруг растягиваются на несколько километров — и у первых из них одни проблемы, у плотной серединки другие проблемы, а у плетущихся в хвосте полное непонимание и проблем лидеров, и проблем «середнячков», они безнадёжно отстали и им бы просто не сойти с дистанции.
Вам же нужно понимать, в каком месте пелетона вы очутились, и не удивляться, если в разных подпроектах вашего проекта будут приняты разные решения по поводу методологии разработки: где-то доисторические «ещё до требований» (и без моделей), где-то «всё только с требованиями», а где «после требований, с гипотезами как отдельными моделями», где-то сразу DDD-BDD (и варианты для систем разной природы, ибо DDD-BDD хорошо описано только для программной инженерии). Дальше будем писать BDD, ибо самое важное в этих всех вариантах то, что для тестирования нужно формально описать поведение системы, в форме, удобной для проверки. Не будем каждый раз говорить TDD, BDD, ATDD, EDD и самые разные другие варианты подхода test first, то есть «формально записанное ожидаемое поведения системы, выполнение которого легко проверить — сначала».
А что там в киберфизических системах? В Tesla каждый автомобиль идёт по заводу уникальным маршрутом, ибо внутри завода сосуществуют разные версии каких-то отдельных операций. Поэтому тестирование идёт на входе и на выходе каждой производственной ячейки (ибо везде что-то может пойти не так). Но что с тестированием автомобиля? При сертификации ведь обычно берётся какой-то автомобиль, сертифицируется (проходит полную программу испытаний для получения государственного сертификата безопасного транспортного средства), а затем серийно выпускается на основе этого сертификата. Что же с Tesla, где каждый выпускаемый автомобиль имеет уникальную конструкцию, при этом прошёл через уникальный маршрут на заводе? Ну, тестируется каждый автомобиль, проходит всю программу испытаний. Это чуть дольше и дороже, но надёжно — и при надлежащей автоматизации не так уже дольше и дороже. Неприятности с выпущенным недотестированным автомобилем обойдутся дороже.
Что касается обучения практикам системной инженерии: если целитесь попасть в середину пелотона, то учиться сегодня нужно фронтирным практикам. Пока выучитесь, как раз в середину пелотона и попадёте. Если учитесь практикам середины пелотона, «мейнстриму», то в момент работы будете уже в хвосте. Вам нужно разобраться с мета-мета-моделью фундаментальных методов, чтобы с их помощью уже разбираться с винегретом мета-моделей прикладных методов уровня культуры предметной области («из учебников прикладной инженерии» типа цитируемых в текущем разделе учебников инженерии киберфизических систем и программной инженерии) или даже уровня культуры одной организации («из руководств и стандартов фирмы», даже если это какая-то очень крупная фирма, например NASA или MITRE с их существенно отличающимися руководствами по системной инженерии, безнадёжно устаревшими, поэтому туда лучше и не заглядывать). Не так важно, что вы делаете (помним, что эволюция, в том числе эволюция методов, приводит к множеству очень похожих по характеристикам субоптимальных решений), как важно, что вы понимаете, что именно вы делаете и почему именно так, и почему вы считаете, что вы попадёте в текущий субоптимум, или даже следующий уровень субоптимума, а не просто провалитесь в какой-то из прошлых давно забытых субоптимумов.
Моделирование: мой «испорченный телефон»
Опишите три «испорченных телефона» в вашей организации и организациях, откуда пришли исполнители внешних проектных ролей. Напишите, кто какие описания разрабатывает и кому передаёт, чтобы информация от её источника дошла до реального продукта.
| Номер п/п | Цепочка «испорченного телефона» | Длина цепочки |
|---|---|---|
| Пример. | Аналитик клиента Маша общается с мастером клиента Олей, которой нужны особые сепульки и пишет «Запрос на разработку сепулек». Аналитик Вася на основе «Запроса на разработку сепулек», пишет «Аналитический отчёт о потребностях клиента Маши в сепульках» (об Оле он не знает, для него клиент — Маша). Аналитик Петя на базе «Аналитического отчёта о потребностях клиента пишет» «Требования к сепулькам». Начальник отдела сепулек Саша пишет документ «Основные принципы сепулек для клиента Маши» (и там концепция сепульки с замечаниями по архитектуре). Разработчик сепулек Женя делает информационную модель сепульки, тестировщик Валя пишет тесты. Технолог Даша изготавливает и тестирует сепульку. | 7: Оля-Маша-Вася-Петя-Саша-(Женя+Валя)-Даша |
| 1. | ||
| 2. | ||
| 3. |
TEST концепция использования и концепция системы
Отметьте те высказывания, которые относятся к концепции использования двигателя как целевой системы.
--- Топливо под воздействием сжимающего его пары поршня загорается, и горячие газы начинают толкать поршень с большой силой в обратном направлении, это движение через коленвал передаётся на вал двигателя и может быть использовано для движения автомобиля. Для предотвращения просачивания горячих газов между стенками цилиндра и поршнем используются поршневые кольца. ### Нет, это концепция системы: как устроена система двигателя внутри, чтобы выдать наружу требуемую функцию.
+++ Для движения автомобиля мы используем двигатель внутреннего сгорания, который будем заводить от стартера, топливо он будет получать из топливной системы, а энергию для движения мы будем отбирать с вала двигателя, через коробку передач. ### Да, это концепция использования: как будут использовать двигатель в надсистеме.
+++ Двигатель в составе помпы как насосного агрегата будет управляться через пульт, общий для насоса и двигателя, а заводить его будут заводным шнуром вручную. ### Да, это концепция использования: как будут заводить двигатель в надсистеме, как им будут управлять.
--- Нам нужен крутящий момент на валу достаточный, чтобы полтонны груза на тележке, которая и сама весит полтонны, можно было поднимать в гору со скоростью 15 км/в час. Поэтому мы будем использовать не двигатель внутреннего сгорания, а бесщёточный электродвигатель. ### Нет, это концепция системы: рассматривается устройство двигателя в заданной надсистеме, и выбирается между устройством его как двигателя внутреннего сгорания и электродвигателем.
Разработка концепции использования и концепции системы
Концепция использования разрабатывается прикладными методологами и архитекторами, одобряется или отвергается визионерами (полностью или в каких-то частях, возможно в развёртке по времени — technology roadmap185). Визионеры — это чаще всего те, кого называют intrapreneur, корпоративные предприниматели186. Их главная функция — предсказать NPV187, то есть насколько проект будет прибыльный. Нынешние экономические теории предпринимательства не слишком подходят для описания этой роли, потому как они подчёркивают разные стороны того, что в современном предприятии расписано на более мелкие детальные роли — Шумпетерский предприниматель занимается «творческим разрушением», а мы тут создаём, Кирцнеровский предприниматель внимателен к возможности заработать, тут это более применимо188, Кантиллион подчёркивает принятие на себя риска — хватает ролей, которые принимают риск во внутрикорпоративном контексте, Друкер подчёркивает новизну метода189, но за новизну отвечают обычно инженеры в команде. Так что в нашем случае речь идёт о роли визионера, который отслеживает прибыльность проекта, чтобы в разработку было вложено меньше ресурсов сейчас, чем заплатят клиенты потом — с учётом всех неопределённостей. Если что-то убыточно, то просто не будем этого делать, визионер не даст — это его главная роль.
Вот как это всё намеренно запутанно изображается в книге ««Systems Architecture. Strategy and Product Development for Complex Systems»:
Концепция использования тут только оцениваемая в возможных деньгах идея, которая постепенно детализируется в концепцию системы (на диаграмме она по старинке названа «системная архитектура»). При этом разработчики и визионеры (интерес визионеров в максимизации потока денег от продукта, чаще всего эти роли исполняются людьми на должностях product owner, product manager) и бизнесмены (интерес бизнесменов в максимизации стоимости компании, их продукт — компания в целом, их клиентура — инвестура, акционеры/инвесторы) обсуждают business case, который можно считать вариантом бизнес-модели, «концепция выкачивания денег из проекта». Они должны достичь соглашения по концепции использования с учётом концепции системы: денег от продаж (их можно прикинуть по концепции использования — сколько удастся продать продукта с такими свойствами) должно хватить на разработку и изготовление плюс прибыль, свойств системы (пользовательской функциональности плюс архитектурных характеристик, о которых будет чуть позже) должно хватить, чтобы запросить эти деньги у клиентов. Концепция системы (тут это system architecture) даёт оценку, во сколько это всё обойдётся компании — сколько будет стоить разработать и изготовить систему. Всё это, разумеется, гипотеза: реальные клиенты могут заплатить или не заплатить (или продавцы могут не найти клиентов, «плохой маркетинг»), реальная система может соответствовать или не соответствовать ожиданиям клиентов (плохо спроектировали, криво изготовили, не смогли наладить в эксплуатации).
В любом случае, хорошо видно, что концепция использования разрабатывается совместно командой инженеров целевой системы и менеджеров как инженеров предприятия и маркетёров как инженеров сообщества клиентов. Они все должны договориться, чтобы проект случился. Если обсуждается проект создания провайдера сервиса, то тут ничего не меняется, тот же разговор про системы, те же роли — только чуть по-другому проведены границы в графе создателей (сервис-ориентированная работа — это когда работаем по нашему методу и нашими инструментами с целевой системой, принадлежащей не нам, а принесённой клиентом).
Весь процесс согласования идёт между ролями, а не агентами. Концепция использования может прийти и извне фирмы, от её клиентов, ей может озаботиться какой-то основатель стартапа, работающий сразу во множестве ролей, она может быть вычитана в прессе, подсмотрена у конкурентов (тут близко к пониманию Kirzner, что визионер «алертен/внимателен» к возможной прибыли, не пропустит такую возможность) — и далее просто улучшаться-дорабатываться в какую-то конкретную концепцию системы, или архитектуру (в старом её значении, на картинке из книги именно так). Это самое важное: творчество не имеет конкретного источника, нет ролей, назначаемых на творчество.
Часто встречается ровно обратное: кому-то приходит в голову концепция системы, что какие конструктивные объекты могут выполнить ту или иную функцию, и надо придумать концепцию использования. Это тоже бывает. В любом случае, проекта нет, если известна только концепция использования (скажем, «скатерть самобранка, вкусно кормит всех за один рубль» — без рассмотрения концепции системы, которая может это делать) или наоборот, только концепция системы («я придумал глюклу, которая очень дёшево глюкает, если её заправлять глюкагелем — давайте придумаем, куда бы это можно было пристроить?»). Нет, проект начинается только после первичной проработки концепции использования, рассматриваемой как бизнес-кейс, и концепции системы, нужной для оценки возможностей создать целевую систему по цене, осмысленной для бизнес-кейса. Всё это гипотезы, конечно, в ходе проекта идёт непрерывное уточнение оценок — и изменение проекта по ходу этого уточнения оценок, а иногда проект и закрывается, если оценки показывают коммерческую бесперспективность.
Идеи тут приходят в голову отнюдь не только «стратегам», «визионерам», «бизнесменам» или «архитекторам». Она приходит в голову любым инженерам: людям, которые пытаются что-то сделать, как-то приспособить для своих целей предметы окружающего мира. Нет роли, приватизировавшей творчество, приватизировавшей предпринимательство по-Шумпетеру или Друкеру, или по любому другому (чаще всего — бытовому, у каждого человека своему) пониманию. Современное предпринимательство распределённо по частным ролям, выполняемым разными людьми — визионерами, бизнесменами, проектировщиками (инженерная идея чаще всего — его!), инвесторами, а также всеми остальными ролями, нужными для предложения проекта и оценки его возможного успеха. Ровно поэтому мы табуируем слово «предприниматель» и обсуждаем более специфичные роли, например, роль визионера как оценивающего рыночный успех продукта, описываемого концепцией использования и продающегося по цене, которая окупит разработку, изготовление, а также затраты на маркетинг и продажи. Конечно, всё значительно сложнее — так, интересует не просто «цена», а полная стоимость владения — клиент ориентируется при покупке на неё, а ещё волнует разница вкладываемых/инвестируемых в разработку денег сейчас против получаемых от продаж готового продукта через некоторое время, идея NPV190.
Первичные тесты на полноту системного описания (какая функция в надсистеме требуется, какой эту функцию выдаст функциональный объект, какой сервис какое сочетание конструктивных объектов может выдать на базе каких физических принципов, как это будет расположено в пространстве, какие стоимостные ограничения, и помним, что кандидат в продолжение системного описания — это выход в граф создателей, какие работы нужно будет выполнить, чтобы это сделать) может сделать любой человек (со своими компьютерами), любая организация из нескольких человек, хотя речь может идти не обо всей системе, а только о части системы, ограниченной предметной областью метода этого агента.
В современной системе разделения труда появилось множество должностей (иногда их называют «ролями в кросс-функциональной команде», что вносит дополнительную путаницу), в букет профессиональных проектных ролей которых входит работа с детализацией и уточнением концепции до полной архитектуры на уровне системы в целом. Прежде всего это
-
product manager (иногда product owner), он отвечает больше за business case, кроме того, что он в инженерной команде визионер/visionary, он ещё и операционный менеджер — принимает решения о том, какие фичи из бэклога надо реализовать в текущей итерации, чтобы увеличить поток денег, то есть назначает работу инженерам. В целом product manager отвечает за то, чтобы можно было получить деньги за сделанное инженерами. Если это «лучшая в мире система», но она никому не нужна настолько, чтобы за неё платили больше, чем стоит её разработка, то это провал в работе product manager. На всякий случай теперь повторим (ибо это частая ошибка): визионер ничего не разрабатывает, он или одобряет, или не одобряет выделение ресурсов на разработку тех или иных фич. Инженеры-разработчики часто увлекаются и пытаются что-то разработать, что клиенты могут (по ожиданиям визионера, это его обязанность — иметь на эту тему ожидания) и не оплатить. Тогда это будет за счёт инвесторов команды инженеров, за счёт собственников. Это плохо, поэтому инженеры не работают без согласования с визионером. Визионер выставляет приоритеты, какие фичи нужны клиентам (рынку) больше, какие меньше — тем самым выдаёт ориентиры операционному менеджеру для планирования ресурсов и отслеживания их реального выделения на работу. Если речь идёт о должности product manager, то это объединяет роли визионера и операционного менеджера. Конечно, руководство фирмы всегда может на должность product manager повесить дополнительные роли — любые роли разработчика или даже архитектора. Мы тут в руководстве наставляем о том, что надо сделать, о чём в проекте подумать, какие роли это делают. А уж как эти роли разложить по ограниченному числу актёров (многие из которых ещё и плохо умеют эти роли выполнять — что не мешает руководству поручить им эти роли играть), это надо смотреть в каждом отдельном проекте.
-
прикладной разработчик, инженер в какой-то предметной области — чаще всего это предметная область клиента плюс предметная область самой разработки. В программной инженерии это программист/software engineer, который разобрался ещё и в предметной области, которую поддерживает его софт, то есть в business domain. Функциональные use cases более-менее подробно прорабатывает именно он, все концепции на эту тему — у него. Мы в руководстве учитываем, что и «прикладной разработчик» тоже относится к нескольким ролям: прежде всего это методолог (проектировщик функций/процессов, functional/process designer), собственно проектировщик (designer, в машиностроении часто — конструктор), технолог, оператор. Включение оператора в разработчики объясняется поговоркой «ты это построил, ты это и эксплуатируй», «you build it, you run it!», она служила выражением смены культуры разработки, где команда инженеров-разработчиков (Dev) сдавала софт для его разворачивания, введения в эксплуатацию и обеспечения работоспособности команде операторов (Ops), но движение DevOps изменило эту культуру, и операторы стали членами команды «разработчико-операторов», в 2016 году появился этот слоган191. Современная версия DevOps — это признание роли инженера внутренней платформы разработки, но вот работают с этой платформой, включая ввод в эксплуатацию и поддержание эксплуатации как раз операторы из команды разработчиков. Операторы на переднем крае команды разработчиков, они первые видят, что там происходит у клиентов, поэтому идеи новых проектов часто приходят в команду через операторов.
-
архитектор, который прорабатывает те части концепции, которые отвечают не столько за функциональные характеристики, сколько за архитектурные — всякие -ости/-ilities, в том числе и за такие характеристики, как возможность что-либо быстро поменять в самой архитектуре (evolvability) или независимость в работе отдельных групп прикладных разработчиков, если их предметы немного различаются.
И тут в классической «железной» инженерии ситуация отличается от ситуации в современной программной инженерии. У «железячников» (вернее, создателей киберфизических систем, там «железо» с софтом) концепцию в части выполнения функциональных требований (в большинстве школ классической «железной» системной инженерии допускают существование требований до сих пор, там в голове «водопад» и «испорченный телефон») до архитектурных подробностей выполняет архитектор как «опытный разработчик, знаток всех ролей», а дальше его работу подхватывают и детализируют архитекторы как «опытные разработчики, знатоки всех ролей» более низких системных уровней или прикладные разработчики по инженерным дисциплинам. В разработке корпоративного софта эти роли уже разошлись по разным людям: с функциональными характеристиками системы и соответствующими решениями по концепции использования разбирается прикладной разработчик какой-то отдельной команды, а архитектор всего проекта отслеживает только соблюдение архитектурных характеристик, в том числе координирует, чтобы подсистемы, которыми занимаются несколько команд прикладных разработчиков, могли взаимодействовать друг с другом. Так что роль архитектора понимается в разных инженерных методах по-разному, и нужно уточнять:
-
Или архитектор — «опытный разработчик», занимается разработкой всех концепций, а затем всей архитектурой как концепцией системы, и потом раздаёт задания прикладным разработчикам (это в киберфизических системах, и там лаг отставания по сравнению с программной инженерией в десяток лет),
-
Или архитектор — эволюционный архитектор, занимается разработкой концепции системы в части выделения модулей и интерфейсов (архитектурные решения), а в концепции использования предусматривает необходимые архитектурные характеристики (они описывают поведение системы в целом, но аспект не прикладной функциональности, подробности будут в нашем руководстве чуть позже). Затем архитектор разъясняет (менторинг) эти решения разработчикам и отслеживает (надзор, governance) их работу на предмет выполнения принятых им архитектурных решений, время от времени меняя эти решения (это тоже гипотезы!). Скорее всего, к этому пониманию придут через несколько лет и в инженерии систем самой разной природы, не только программной инженерии.
Вот эта неопределённость с ролями, разрабатывающими концепцию использования и концепцию системы на самых первых шагах проекта, ещё до формального выделения ресурсов на проект. Все эти идеи обсуждаются неформально, ресурсы не выделяются, пока не будет назначен какой-то визионер и ответственный за ресурсы, часто в одном лице — product manager, иногда это просто project manager, но тогда это чаще всего «просто менеджер», плохо (не как инженер!) разбирающийся в целевой системе, то есть плохо разбирающийся в особенностях продукта, и тогда должен быть найден ещё и исполнитель роли визионера, который глубоко разбирается в продукте и предметной области применения/использования этого продукта. Визионер — это прежде всего инженерная роль. Продуктовый менеджер совмещает инженерную и менеджерскую роли.
Если у вас очень большой проект (скажем, проект выпуска электромобиля), то в вашей разработке вряд ли будет какая-то глубокая концепция всей машины. Архитектор нарежет этот электромобиль на разные подсистемы, которые будут реализовываться разными командами, у этих команд будут свои методологи, отвечающие на вопрос «как оно у нас всё работает». Кто-то будет заниматься мотор-колёсами, кто-то подвеской, кто-то аккумуляторным матом. Мы уже говорили, что архитектор отслеживает, чтобы зависимости между всеми частями системы были минимальными, но не нулевыми (если нулевые — то не будет взаимодействующих частей системы, эмерджентные свойства не появятся. Независимые друг от друга мотор-колёса, салон, подвеска, аккумуляторы — не поедут как единый целый электромобиль). Но вот команд будет несколько, и у них будут для своих подсистем отдельные концепции использования. Для многих таких подсистем это будет выходить на пользовательский уровень — скажем, «новая фича по регулированию температуры в салоне», «новая фича по ускорению времени зарядки аккумуляторов» с одной стороны могут быть описаны как фичи автомобиля в целом, с другой стороны — отнесены к каким-то модулям автомобиля, то есть отданы на откуп каким-то командам.
В современной разработке признали, что для сложных систем не существует подробного функционального описания, охватывающего все особенности поведения. Эти описания отдаются на откуп командам, которые занимаются «профильными» модулями — если речь идёт о температуре в салоне, то на уровне автомобиля в целом нет методолога, который бы этим занимался, а вот в команде, которая занимается автомобильным салоном такой методолог есть. Поэтому в современной разработке сложных систем на верхнем уровне работает визионер (ему надо продавать! Он согласует или не согласует новые фичи и порядок выпуска их в новых версиях системы) и архитектор, которые грубо прикидывают, какие команды могли бы реализовать эту функциональность — и отдают разработку «вниз», на уровень этих команд (возможно, нескольких команд в кооперации). Это резко контрастирует с идеями прежних подходов. Один из вариантов тут — методология разработки SAFe192, которая не слишком радикально отходит от «водопада» и не является совсем уж гибкой методологией разработки, но хотя бы признаёт, что нельзя проводить систему через общие для неё «гейты»193:
-
Раньше была идея, что какой-то «опытный разработчик автомобилей» (главный конструктор с помощниками) декомпозирует автомобиль на части, прописывая необходимые характеристики частей, формулирует требования и поручает команде разработать их части в строгом соответствии с требованиями. Нет, это бы означало, что у главного конструктора по части функциональности частей системы более чем энциклопедические познания. При такой декомпозиции «сверху вниз» наверняка будет наделано много ошибок из-за банального неучёта SoTA предметной области, в которой работают команды. Поэтому никакой «глубокой декомпозиции функций» в сложных проектах сейчас не делается. Архитектор с визионером проводят совещание по поводу предложенной кем-то (только что обсудили, что идеи могут приходить от самых разных ролей) идеи новой фичи, нового инкремента, а потом отдают проработку этой идеи профильным командам. И функциональные проектировщики работают там, «внизу», а не «в штабе».
-
Раньше была идея, что все требования по всей системе надо собрать, проверить на совместимость, оценить их реализуемость, а уж затем всей пачкой отдать командам на реализацию. Нет, сейчас нет «всех требований к системе». Архитектор удерживает «на штабном уровне» какие-то архитектурные характеристики, но вот целая концепция использования существует на верхнем уровне только весьма неподробная. Подробная концепция использования разрабатывается главным образом методологами команд, причём она разбита тем самым на отдельные части, которые очень редко собираются вместе — и это задача архитектора разбить систему (и тем самым команды в силу обратного манёвра Конвея) на части так, чтобы не возникало коллизий, чтобы команды могли работать независимо. Каждая команда тем самым владеет (то есть может вносить изменения, никого не спрашивая «сверху») своей концепцией использования, и никто даже не делает вида, что эти концепции использования каким-то чудом собираются в «общую концепцию использования всей системы», это бессмысленно, этой сборкой никто не будет пользоваться, делать так — неэлегантно, не lean, это лишняя работа. И дальше команды свои частные концепции использования пишут в формате, который легко превращается в формат описания испытаний.
Самые разные учебники инженерии, стандарты инженерных процессов, учебники менеджмента всегда невнятны в том, как выполняется самое начало работы над проектом, когда о продукте мало известно и в проекте максимальная неопределённость. Системное мышление даёт мета-мета-модель, как рассуждать о такой ситуации, системная инженерия даёт набор ролей и набор рабочих продуктов, которые в такой ситуации надо готовить. А уж когда понятно (гипотеза! Гипотеза о том, что понятно! Её надо проверять!), чем в проекте заниматься — вот тут уже много литературы, тут уже много знаний, тут уже проще.
В ТРИЗ194 есть теория развития технических систем, которая как раз обсуждает общие закономерности эволюции их конструкции по мере накопления инженерных знаний. Основная закономерность развития базируется на понятии идеальной системы: когда конструктивных элементов нет вообще, а функция таки выполняется (обычно какими-то другими частями конструкции: например, корпус какого-то устройства может служить заодно и механической защитой, и радиатором). Но обычно всё-таки нужны какие-то конструктивные/модульные части системы, чтобы добиться выполнения ими во взаимодействии через их интерфейсы какой-то требуемой функции на границе системы. Концепцией/concept системы и называют такое решение изобретательской задачи, именно поэтому ТРИЗ (теория решения изобретательских задач) стал одним из первых методов в инженерии, который целевым образом стал изучать концепции системы. От существовавших во времена появления ТРИЗ (начало работы над этим подходом — 1946 год) методов инженерии ТРИЗ отличался прежде всего тем, что требовал представить сначала функцию системы в виде функционального разбиения на 5-7 подфункций (ибо если меньше, то мало пространства для творчества, а если больше — слишком много нужно внимания, чтобы что-то не потерять), а затем после стадии генерации идей «изобретения» конструктивное разбиение сразу давалось в виде компоновочного чертежа, отражавшего и конструкцию, и размещение. После этого «изобретения» можно было уже выполнять традиционную инженерную проработку полученной концепции.
Разработка концепций (использования для надсистемы, системы — для целевой системы) — изобретательская, творческая задача. В её основе — системное творчество (напомним, что в руководстве по системному мышлению был такой подраздел). Решением творческих задач занимаются все участники проекта, каждый в своей предметной области. Весь вопрос только в том, проходит ли это решение интуитивно, или по какому-то методу. ТРИЗ как раз и предлагал один из таких методов разработки концепции (и там активно использовались свойства нейронной сети человеческого мозга, в том числе там были приёмы развития творческого воображения). Но современная инженерия вся основана на подобных методах, разве что сам момент «изобретения» концепции в ней не акцентируется — это рутина, все должны быть изобретателями, творцами, предлагать новые решения (хотя понятно, что лучше изучить какие-то эффективные уже существующие решения, чем предложить своё новое без проверки того, что оно лучше уже имеющихся. Поэтому инженеру нужно глубокое знание уже существующих инженерных решений. Ну, или этим знанием вместо него будет обладать AI, которому надо будет дать достаточный контекст, чтобы предложенное решение было уместным).
Разработка концепции идёт в цикле:
-
Определение функции, которую нужно реализовывать конструкцией, по возможности нейтрально по отношению к конструкции. Это довольно трудно, ибо требует абстрактного мышления. «Изменение/поведение как таковое» трудно представляется без конкретного объекта или их совокупности, который вызывает это поведение. Мы подробно разбирали трудности этого шага в руководстве по методологии.
-
Порождение альтернативных идей по конструкции, реализующей функцию. Это метод творческого воображения, изобретения, культурного заимствования. Концепции придумываются «с нуля», как «новое изобретение», или предлагаются «умные мутации» потенциальных улучшений к уже имеющимся изобретениям, или просто берутся какие-то известные уже решения из предыдущих проектов, возможно, не ваших, поэтому тут нужно «спросить у AI», заимствовать решение из культуры — ну, или таки изобрести что-то потенциально лучшее.
-
Выбор (рациональный, в условиях неопределённости) из альтернатив предыдущей стадии, называемый в системной инженерии прохождением развилок/trade-off studies. По-русски тут подчёркивается аспект выбора (можно выбрать одно, или другое, или третье решение/solution, то есть пройти развилку), по-английски термин подчёркивает не столько конечный выбор, сколько «компромисс» в этом выборе, «выбор сделан, но никто им не доволен, ничьи цели не достигнуты».
Этот цикл может быть бесконечным по времени на какой-то итерации, такая ситуация встречается чаще, чем можно себе представить, она называется analysis paralysis — застревают люди чаще всего на стадии выбора из квазиоптимальных альтернатив, хотя бывает иногда и не аналитическое застревание, а синтетическое: на стадии генерации альтернатив, ибо хотят сделать что-то типа «концепция универсального вычислителя во времена Чарльза Бэббиджа, когда ещё не было ни радиоламп, ни транзисторов» — и ничего путного не придумывается, хотя и очень хочется. Ну, или концепция летательного аппарата тяжелее воздуха, когда ещё не было двигателей внутреннего сгорания, применённых братьями Райт в их самолёте. Но чаще идёт всё-таки analysis paralysis при абсолютно понятных вариантах синтеза: в любой момент эволюции существует огромное количество текущих квазиоптимальных решений конфликтов между системными уровнями (неустроенность/frustrations), и при этой неустроенности оказывается очень незначительный разброс характеристик при переходе от одного решения к другому. Эти характеристики могут быть достигнуты самыми разными способами, так что выбор среди похожих по характеристикам решений и впрямь труден, может идти бесконечное время, это и есть analysis paralysis. Конечно, хорошо бы предложить альтернативу из следующего поколения (изобретение, результат синтеза), дающую явное преимущество над другими альтернативами, чтобы выбор был очевиден, но это не всегда получается.
В какой-то момент вам надо будет пройти развилку при разработке концепции системы в ситуации, похожей на выбор между цифровым фотоаппаратом и плёночным: это легко в 1995 году и в 2005 году, но вот где-нибудь в 2000 году (Olympus CAMEDIA C1400L появилась в 1997 году195, матрица там была 1.41-megapixel) выбор был не очень очевиден. А теперь представьте себя на месте не потребителя, а производителя этих аппаратов! Kodak выбрал концепцию своих новых фотоаппаратов неправильно, и мы о нём уже редко слышим. Olympus выбрал концепцию правильно, фирма до сих пор существует (хотя и была продана в 2020 году, теперь это OM Digital Solutions196).
Неважно, кем делается выбор из множества альтернатив: коллегиально, визионерами, бизнесменами, инженерами (разработчиками или архитекторами как подроль разработчиков), или даже покупателями, которые выбирали из альтернативных предложений разных конкурентов в ходе проверки разных предпринимательских гипотез, высказанных и реализованных этими конкурентами. Главное, что есть три стадии, повторим их:
-
Нужно понимать, что вы делаете, какую функцию (метод работы) вам нужно реализовать, концепцию использования какой системы вы готовите. Если вы не сформулировали точно, чего хотите, вам не помогут потом лучшие методы изобретений: что-то вы изобретёте, но оно будет ненужным. Функциональная декомпозиция или функциональный синтез может осуществляться множеством способов, и вы легко можете захотеть невыполнимого. За то, чтобы не утерять связь с реальностью в этом вопросе, нужен исполняющий роль визионера (чаще всего он будет совмещать и роль менеджера, должность product manager): он проигнорирует «эксперименты ради экспериментов» и проконтролирует, чтобы состоялся business case, то есть проверит, что денег за систему с чудесными функциями заплатят больше, чем будет потрачено на её разработку и изготовление, включая окупаемость всех экспериментов и проверку неудачных гипотез.
-
Вы должны предложить несколько альтернативных концепций системы, их всегда больше одной, вариантов конструкции обычно много. Если оценивается только одна концепция, то вы что-то делаете не так. Если у вас один вариант для выбора, а не пять-шесть, то вы чего-то не понимаете в инженерии. Без этого не будет прохождения развилок, и это по факту будет не инженерия. Ситуация интересна ещё и тем, что какую-то из альтернативных предлагаемых концепций системы можно доработать так, что она будет предпочтительней. Этот шаг делается на базе самых разных вариантов методов генерации идей, «методов творчества».
-
Принятие решения, прохождение развилки между предложенными на предыдущей стадии альтернативными концепциями. Это делается на базе рациональности как фундаментального метода мышления: построение моделей и далее выбор между этими моделями, построение обоснований/rationale. Подробней об этом будет в разделе по инженерным обоснованиям, которые понимаются как обоснования успешности уже изготовленной системы на базе каких-то свидетельств и аргументации — assurance, так и обоснования выбора проектных функциональных или архитектурных/«важных для разработки и эксплуатации, но не связанных с предметной областью и функциональностью» решений.
И не факт, что прохождение этих стадий однократно. По ходу проекта понимание участников проекта улучшается, внешнее окружение изменяется, находятся новые нюансы в реализуемых функциях (методах работы), новые альтернативы конструкции, ошибки в принятии решений по выбору из альтернатив. Так что это не однократное прохождение стадий, а непрерывное уточнение концепции (и концепции использования, и концепции системы). А ещё после того, как вы вроде бы «всё уточнили, всё выбрали» для системы будут в ходе эволюционной разработки появляться всё новые и новые функции/фичи, для этого концепции системы (как вы понимаете, их много разных на разных системных уровнях — это мы называли «рекурсивным применением системного мышления», одинаковое мышление на разных системных уровнях) продолжают и продолжают уточняться.
Довольно много проблем в организации новых инженерных процессов происходит из-за попыток одновременного следования старым и новым методам работы:
-
Предлагается «монстрообразная методология», которую очень трудно освоить в полном объёме. Не предлагается собрать у себя инженерный процесс из подходящих методов, чтобы граф создания тоже эволюционировал в части используемых методов работы, всегда был SoTA. Мы касались этого в руководстве по методологии.
-
По инерции вписываются давно отброшенные в силу заведомой неработоспособности методы, например «теории уровней/ступеней зрелости/maturity». Когда-то модные в менеджменте «ступени зрелости» не прижились: компании довольно быстро проходили все эти ступеньки, но жизнь-то на этом не заканчивалась — эволюция продолжалась, а ступеньки это уже не описывали, получалась незапланированная стагнация: «цель достигнута, зрелость не поднимается, развитие закончили». Это упоминалось в руководствах по системному мышлению и методологии.
-
Делается заявление, что «у нас всё agile» — то есть «мы гибкие, быстрые, итеративные». Обсуждается «новомодный процесс» со старыми рабочими продуктами — agile, но не lean (например, остаются требования: итеративная ненужная работа, бесполезное проявление гибкости в ненужном. Мы подробно обсудили это в текущем разделе руководства).
-
… и такого много.
Скажем, берём «The Agile Systems Engineering Handbook»197 с многозначительным подзаголовком «This guide is a modern alternative to INCOSE, based on recent, proven experience inside fastest-moving engineering teams. Built in collaboration with the world's fastest teams, it’s designed to support high-speed, real-world engineering needs». Заглядываем — и видим тексты про уход от водопада, но также тексты про требования, тексты про ступени зрелости. Что с этим делать? Игнорировать? Совсем нет! Там ведь много интересного и полезного, это ведь отражение реального производственного опыта реальных «железных» инженеров — да ещё и с описанием культуры системной инженерии в SpaceX198. И там можно найти кроме инерционного использования понятий классической системной инженери, тех же требований, и следующие строки: At SpaceX, external-facing hard constraints requiring full V&V are still called requirements, used in interactions with entities like NASA/DoD. However, lower-level internal requirements aren't labeled as requirements; they're termed design criteria. Why the different terminology? It's all about psychology. Let's face it, "requirements" can carry negative connotations among engineers. The term implies rigid constraints that are seen as commandments that can’t be scrutinised or changed.
Надо просто использовать наставления нашего руководства, чтобы понимать там написанное, а особенно — понимать, что инженерный процесс для «железа» неминуемо начинает повторять инженерный процесс для софта, так что необязательно ждать много лет, пока «железные» инженеры воспримут эти новые идеи, можно пробовать что-то делать самостоятельно, работать на фронтире.
Моделирование: визионер, разработчик, эволюционный архитектор в моём проекте
Укажите агентов, которые выполняют роли визионера, разработчика и эволюционного архитектора в ваших трёх проектах (это могут быть подпроекты какого-то одного проекта). Оргроли могут исполнять не только отдельные люди (или сейчас даже AI), но и оргзвенья из нескольких агентов. Обратите внимание, что люди часто упускают себя в какой-то из этих ролей (пишут «никто», хотя сами являются, например, архитекторами — то есть принимают решения о том, что делать для достижения всяких «-остей»).
| Номер по порядку | Наименование проекта (по целевой системе) или подпроекта (по «нашей системе») | Исполнитель роли визионера | Исполнитель роли разработчика | Исполнитель роли эволюционного архитектора |
|---|---|---|---|---|
| 1. | ||||
| 2. | ||||
| 3. |
4. Прикладная методология предметной области
Функциональное проектирование
В руководстве по методологии обсуждалось функционирование как работа по методу — какими методами работают создатели, меняя окружающий мир. Какая угодно система (в том числе целевая!) у нас — создатель, если мы будем рассматривать, как она меняет своё окружение. Не надо забывать, что создателем мы можем считать как разумного агента (агента в узком смысле слова), так и не слишком разумного — автомат или даже косное вещество, например, молоток, который заколачивает гвоздь. И в графе создателей одни создатели в ходе работы создают других создателей, для которых это будет время создания, а не время работы. Не будем это подробно обсуждать сейчас, подробности были в руководствах по системному мышлению и методологии.
Но вот чего в этих руководствах по системному мышлению и методологии ещё не было рассказано подробно, так это про роль прикладного методолога предметной области, хотя в общих чертах мы рассматривали именно эту роль в руководстве по методологии, в отличие от роли фундаментального методолога-исследователя. Эта прикладного методолога в инженерной команде имеет множество «синонимов с нюансами»: функциональный проектировщик/designer, функциональный архитектор, процессный инженер, инженер поведения системы (systems behavior engineer), проектировщик оргвозможности (capability designer), специалист системной динамики предметной области (systems dynamics specialist, в биологии проектирует метаболические пути), инженер операционного синтеза (operational synthesis engineer, на смарт фабриках проектирует автоматизированную сборочную линию), лидер оркестровки процессов (process orchestration lead, координирует рабочие процессы), архитектор хода работ (workflow architect, проектирует цепь поставок, supply chain), аналитик функциональных потоков (functional flow analyst, оптимизирует перетоки в электрических сетях — балансирует спрос и предложение) — это далеко не полный список названий инженерной роли для того агента (человека, AI, организации), что занимается вопросом «как оно будет работать», вопросом метода работы системы.
Как всегда, слова важны — и не важны, надо по контексту уметь определить, что речь идёт о проектировании функциональной организации системы. Главное тут — это определиться в отношениях с архитектором. Давайте вспомним основную диаграмму, которой определялась функциональная декомпозиция и модульный синтез, а потом покритикуем эту диаграмму:
Пару десятков лет назад эта диаграмма читалась как «мы декомпозируем исходный функциональный/ролевой объект А (систему) на его подобъекты-подсистемы, и делаем это на несколько уровней, пока не подберём такие низкоуровневые роли, которые исполняются известными нам модулями как частями конструкции. Эти модули мы синтезируем/собираем во всё большие подсборки и сборки, пока не получим на выходе целый модуль A’, реализующий целостный функциональный объект A».
Это представление в виде «функциональной декомпозиции, затем модульного синтеза» получено от людей, занимавшихся управлением конфигурацией, а не проектированием. Диаграмма эта из стандарта IEC 81346-1:2022 Industrial systems, installations and equipment and industrial products — Structuring principles and reference designations — Part 1: Basic rules используется для минимально необходимого описания структуры сложных инженерных объектов, задавая принципы обозначения систем и их частей. Это фундамент для управления конфигурацией в ходе эволюционной разработки. Стандарт различает три вида описаний: функциональное (functional), продуктовое (product) и мест (location), хотя и не затрагивает необходимость стоимостного (cost) описания, уже обязательного для сегодняшнего системного мышления. Ничего не говорится о поведении — о методах, функциях. В стандарте говорится об обозначениях/designations функциональных объектов, а не обозначениях их поведения. Поэтому на диаграмме (унаследованной этим стандартом из ещё более древнего стандарта IEC 1392/09) никак не отражается динамика времени работы, необходимая для рассмотрения методов/функций.
Рассмотрение неявно подразумевает то, что мы берём, например, автомобиль — и дальше выделяем в нём различные ролевые объекты (игнорируя их поведение!), декомпозируя «сверху вниз». И ведь правда, можно было считать, что «требования к автомобилю» определяют всё его поведение, вплоть до скорости нагрева сидений в зимнее время. От требований отказались: эволюционный (модульный!) архитектор нарезает систему на крупные куски-модули, стараясь, чтобы эти куски соответствовали каким-то предметным областям (domains, bounded contexts), а вот функциональное наполнение этих систем уже определяется в командах, которые ими занимаются. Подогрев сидений обсуждается теми, кто проектирует салон, появляется как «идея снизу», из предметной области, а не путём декомпозиции «удобно пассажиру», ибо на верхнем уровне никто не разбирается в том, что такое «удобно»! Какое-то детальное разбирательство с функциями появляется только на уровень ниже сигнатуры метода, ибо эмерджентные функции надо как-то собрать/синтезировать и это лучше бы делали владеющие предметной областью прикладные методологи, а не какой-то гипотетический «ответственный за все функции методолог проекта в целом». Ключевая операция тут оказывается — функциональный синтез, чтобы он «попал в сигнатуру». И это не зависит от природы системы, не зависит от системного уровня. В ходе функционального синтеза надо подобрать такие функциональные/ролевые объекты и так задать их взаимодействие, что
-
эти функциональные объекты (роли) в своих взаимодействиях выдают на уровень выше требуемую на уровне сигнатуры функцию
-
эти функциональные объекты (роли) могут быть реализованы какими-то конструктивными объектами (модулями).
И вот тут одна и та же суть дела излагается самыми разными словами. Например, часто архитектурой считают не только модульную структуру, но и функциональную организацию — и так и говорят:
-
«функциональная/логическая архитектура» (иногда даже пытаясь разделить функциональную отдельно и логическую архитектуру отдельно), имея в виду динамические отношения между ролевыми объектами во время эксплуатации.
-
«физическая архитектура» как конструкция, модульная структура системы.
Возражение было в том, что нельзя рассматривать их по отдельности, только вместе — как «архитектуру системы». Но жизнь всё время разводила функциональный синтез (его считали функциональной декомпозицией, ибо «так правильно, научно будет — сверху-вниз», это много позже будет признано неверным) и модульный синтез. А изобретение — это как раз совмещение функционального и модульного синтеза. Если надо вогнать гвоздь поглубже, мы имеем ролевой/функциональный объект «забивало» с функцией «забивания». Забивало должно быть в момент эксплуатации массивным и нехрупким, и дальше «изобретение» как выбор конструктивного объекта для выполнения роли — берём конструктив «микроскоп», который удовлетворяет спроектированным характеристикам «забивала». В архитектуре (общей! Понимаемой по-старинке, как функциональная и физическая архитектура вместе, а также размещение, стоимостные характеристики и другие верхнеуровневые описания. Сейчас это — концепция системы) надо учитывать ещё и стоимостные характеристики, и сложность изготовления, и много чего ещё, но плохой изобретатель может учитывать и меньше параметров. Микроскоп, как мы знаем, отлично подходит для забивания гвоздей — и если он не слишком дорогой и достаточно металлический, а ничего под рукой больше нет, то это хорошее изобретение, забивать гвозди микроскопом. Работа проектировщика системы (не функционального проектировщика, а «общего» для системы) как раз в том, чтобы указать для необходимой функции аффорданс, «подходяшку» конструктива, в данном случае это микроскоп: «за неимением молотка, о котором знаем, будем забивать гвозди микроскопом — ибо молоток получить сейчас дороже, чем задействовать микроскоп».
Примерно с 2017 года понятие «архитектуры» начало быстро меняться, появилась эволюционная архитектура, которая главным образом отвечает за модульный синтез на верхнем уровне (подробней мы коснёмся этого в следующем же разделе), а вот эволюционная прикладная методология предметной области — она как-то перестала рассматриваться, как ответственная за «функциональную архитектуру», поскольку речь шла уже не только о концепции системы, но и о детальном проектировании поведения, «проектировании как таковом». А ещё в новой архитектуре, которая оказалась главным образом «про модули», прилепилось определение «эволюционная», а в прикладной методологии (функциональном проектировании) этот аспект эволюционности, «непрерывности изменения функциональности» специально не обсуждался, разве что постулировалось то, что функциональность системы развивается: добавляются новые нужные функции/возможности/фичи, устраняются старые ненужные — и так всё время развития/эволюции системы. Функциональное проектирование тоже эволюционно, непрерывно.
Нынешний методолог предметной области (функциональный проектировщик, функциональный архитектор) проектирует набор связанных между собой функциональных объектов и их поведение, знает «принципиальные схемы» своей предметной области и языки их описания, владеет моделерами для этих языков. Это может быть язык P&ID диаграмм199 для непрерывных производств (химия, нефть и газ), но это тоже частный случай — для радиотехники это могут быть радиосхемы на языке радиосхем (для радиоприёмника, например, будет выбор функциональной архитектуры из сверхрегенератора, супергетеродина и даже детекторного приёмника, в то время как проектировщик выбирает элементную базу радиоламп, дискретных транзисторов, интегральных радиосхем, software-defined radio)200, а эволюционный архитектор нарезает конструкцию приёмника на какие-то модули, в том числе учитывающие элементную базу и предлагаемую функциональность (например, модули корпуса, интерфейса с пользователем, антенны, высокочастотной части, усилителя низких частот, блока питания и акустического тракта с громкоговорителем).
Есть, конечно, и более абстрактные описания функциональности, с попыткой абстрагироваться от специфики предметной области в рамках какого-то формализма. Каждый формализм поддерживается множеством нотаций, каждая нотация поддерживается множеством моделеров, например:
-
Конечные автоматы (Finite State Machines)201 представляют метод работы системы (тут чаще говорят «поведение», но это не включает работу, только метод работы, функционирование) как набор дискретных состояний и переходов между ними, вызываемых событиями наступления каких-то условий. Скажем, конечными автоматами моделируют дорожные светофоры, протоколы связи (например, интернет-протокол TCP, Transmission Control Protocol, управляет соединением между двумя устройствами, проходя через состояния вроде «закрыто», «установка соединения», «передача данных»), торговые автоматы (например, автомат для продажи кофе принимает монеты, выдаёт товар и возвращает сдачу, переходя между состояниями в зависимости от действий пользователя) и даже программируемые логические контроллеры, которые управляют производственными процессами, переключая состояния оборудования. В какой-то мере состояния альф из руководства по методологии, составляющие какой-то граф этих состояний с переходом между состояниями, которые обеспечиваются применением методов, тоже хорошо выразим конечными автоматами. Частая визуальная нотация — диаграммы состояний (state diagram)202. И не путайте с клеточными автоматами203, которые тоже про состояния и переходы.
-
Самые разные потоки работ (workflow), которые не столько про «работы», сколько про последовательности операций (последовательность шагов в методе). «Поток» тут означает просто зависимость следующей операции в потоке от успеха предыдущей операции, при этом могут быть ветвления потока, зависящие от результата предыдущей операции. Для изображения потоков работ используют или самые разные диаграммные представления, например, блоковые диаграммы функциональных потоков (FFBD, functional flow block diagram204, диаграммы активности, activity diagram205, этих диаграммных представлений огромное число самых разных), либо диаграммной нотацией, которая может быть машинно-исполняемым языком (таким языком, например, является BPMN 2.0, business process modeling notation 2.0206, часто используется и EPC, event-driven process chain207, и много других).
-
Потоки данных (dataflow), описывают данные, которые проходят обработку самыми разными операциями. Мы уже приводили примеры «архитектуры нейронных сетей» в руководстве по методологии, которые являются как раз «функциональными архитектурами» и по сути изображают потоки данных, обрабатываемые разными вычислительными операциями. Когда говорят об «архитектуре программы», то иногда имеют в виду как раз dataflow «обработки данных» (data processing, организация обработок «как работает»), а иногда — современную эволюционную архитектуру как модульную структуру («из чего состоит»).
-
Потоки/токи/перетоки массы и энергии (массоэнергоперенос в каких-нибудь тепловых машинах), электрические и гидравлические, но также денежные, операционные (исследование операций, операционный менеджмент, supply chain). Сейчас такие потоки моделируются чаще всего системой дифференциальных уравнений, называется это чаще всего «физическим моделированием» или 1D-моделированием (ибо моделируется чаще всего одна величина в развёртке по оси времени), описывается чаще всего на domain specific language — в инженерии это буквально вчера была Modelica208, сегодня заменяется более общими системами мультифичического моделирования, например, JuliaSim209. Но когда-то потоки/токи/перетоки в сетях с обратными связями моделировались упрощённо, это называлось «системная динамика»210 и было настолько распространено, что моделирование каких-то потоков методами системной динамики часто путалось с собственно системным мышлением.
-
Сети Петри (Petri nets)211, состоят из мест и переходов между ними, по переходам передаются какие-то токены, современные варианты добавляют в формализм цвета, данные и иерархию. Используются для описаний параллельного асинхронного распределённого поведения, например, Petri Net Plans212 более выразительны, чем конечные автоматы для планирования поведения роботов.
-
… и ещё множество таких формализмов описания процессов, поддержанных какими-то нотациями, которые поддержаны какими-то моделерами.
Важно понимать, что всё это поддержка работы прикладного методолога предметной области, который проектирует функциональную организацию системы. Вот пример FFBD представления процесса/метода в усиленном/enhanced варианте EFFBD213:
Вот ровно то же самое в представлении Activity Diagram из диаграммного языка SysML214:
Отличия больше нотационные, а не сущностные. Все эти нотации помогают выразить то, что на каком-то системном уровне функциональной системной иерархии
- есть функциональные объекты (создатели) как подсистемы какой-то системы, они выполняют
-
какие-то методы/операции над предметами своих методов,
-
эти предметы метода проходят как потоки (представление, удерживающее единство пути) в сети, где в узлах сети эти самые создатели, выполняющие операции/функции над своими предметами методов
-
взаимодействуя между собой через какие-то потоки (вещества, энергии, данных).
Дальше это можно моделировать дискретно, вводя состояния и переходы состояний, или непрерывно, отслеживая значения каких-то непрерывно меняющихся характеристик, или гибридно дискретно-непрерывно, с учётом или без учёта вероятностей и неопределённостей, вариантов тут масса — и в этом мастерство прикладного методолога, что он выбирает для себя адекватный метод моделирования из их множества. А для выбора надо понимать, что на более-менее высоком уровне абстракции всё это моделирование одного и того же — функциональной организации системы на каком-то из многочисленных системных уровней.
Функциональный архитектор, как и современный архитектор, занимающийся модульным синтезом (часто говорят о разбиении на модули, мы уже обсуждали, что это одно и то же), занимается модуляризацией системы в её функциональном представлении — и это часто представляется как задача оптимизации декомпозиции функциональных частей системы на так называемые слои, изредка даже называемые «функциональными модулями», для подчёркивания свойств автономности.
Если речь идёт о разложении метода и выявлении функциональных частей, выполняющих независимо какие-то составляющие метода, то это называется декомпозицией на (функциональные) слои. Термин «уровни» оставляют за конструктивным/физическим/хардверным/продуктовым разбиением.
Декомпозиция/разбиение на слои понимается как многоуровневая оптимизационная задача. В 2006 году в работе «Layering as Optimization Decomposition: A Mathematical Theory of Network Architectures»215 были заложены основания для математического аппарата подобного разбиения для сетей связи, затем это были электрические сети, затем биологические регуляторные цепи — и дальше мы понимаем, что функциональные описания все устроены на высоком уровне абстракции одинаково, то есть речь идёт о некотором принципе построения функциональной архитектуры, который сводится к выделению слоёв, работающих каждый в своём масштабе времени (тут важна работа «Thinking Fast and Slow: Optimization Decomposition Across Timescales»216 2017 года) и преследующие свой критерий оптимизации на каждом уровне. Теория оптимизации разбиения системы на какие-то функциональные слои, каждый из которых выполняет свою оптимизационную задачу, развивалась в самых разных областях, очень часто такой областью была теория управления, решающая задачи «руления к цели в условиях самых разных возмущающих факторов».
Один из последних обзоров тут — «Towards a Theory of Control Architecture: A quantitative framework for layered multi-rate control»217 (2024), претендующий на общий подход к функциональным архитектурам систем управления. В этой статье основное внимание уделяется теории многоуровневых архитектур управления (LCA) для сложных инженерных и естественных систем. Помните начальные претензии кибернетики как «науки об управлении в неживых и живых системах»? Кибернетика была очень популярна, её путали с системным мышлением, но она не оправдала ожиданий на всеохватность и полезность: её выводы были банальны, в инженерии она осталась в виде теорий автоматического управления и регулирования, это довольно узкая предметная область, и она точно не включала в себя заявку на объяснения управления в живых системах. Но вот теория слоёных функциональных архитектур претендует на то же — общая теория оптимального управления в таких разных системах, как как энергосистемы, сети связи, автономная робототехника, бактерии и сенсомоторное управление движением человека. Эта теория предполагает некоторый универсальный набор концепций, который вмещает необходимые специализации, специфичные для каждой конкретной прикладной области. Статья обращает внимание, что набор концепций отражает не только «придуманные» функциональные архитектуры, но и функциональные архитектуры живых природных систем, то есть отражает результаты эволюции. И статья предлагает брать эти принципы в качестве универсальных для работы функциональных архитекторов самых разных систем управления — но вполне можно обобщать эти принципы и до самых разных систем, не только систем управления.
Возьмём в качестве примера систему управления движением (неважно, каким! Даже неважно, речь идёт о движении в геометрическом трёхмерном пространстве или же движении в многомерном пространстве состояний какой-то системы!). Общий принцип тут — совместить высокую точность и высокую скорость, что в общем случае при сложных траекториях невозможно, если у вас один слой управления и один слой датчиков и эффекторов в вашей функциональной архитектуре:
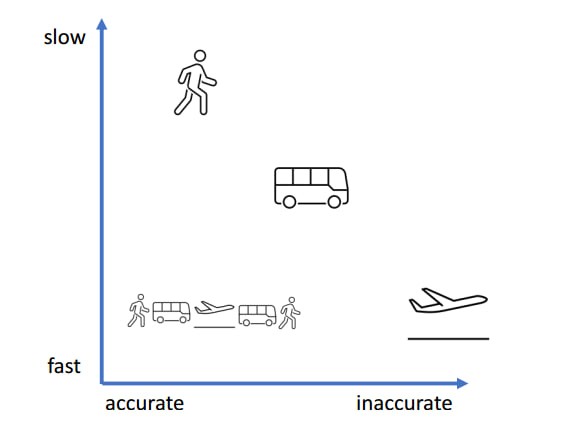
Если вы хотите и быстро, и точно, то вам нужно совместить два-три-четыре (на рисунке — три) метода, быстрые и неточные с медленными точными.
В слоёных архитектурах предлагается использование для этого нескольких (три — это только пример, слоёв может быть и больше, и меньше) слоёв управления (верхний слой — самый медленный, нижний — самый быстрый):
-
Слой стратегирования: выбор цели — предмета метода и его конечного состояния. Тут относительно медленно принимается дискретное решение о том, какой цели достигать: вырастить цветок из семечка или добраться до точки Б. Конечно, тут получается обратная связь от планирования траектории, если не удаётся следовать траектории настолько, что надо менять цель.
-
Слой планирования траектории. Здесь предсказание траектории, нужной для достижения цели из той точки, где находимся. Это алгоритмы непрерывного планирования с какой-то средней частотой — чаще, чем принятие решения о цели, и реже, чем «кручение руля» в попытках преодолеть возмущения окружающего мира и неточности собственной аппаратуры. Тут работают оптимизационные методы предсказательного управления (predictive control218) и всякие «программирования» не из информатики, а из математики (то есть методы оптимизации, например, mixed integer programming219). Проблема тут в том, что согласно теореме бесплатного обеда, один алгоритм оптимизации не работает для всех ситуаций, поэтому надо подобрать для каждой конкретной ситуации свой алгоритм, их огромное множество (вот одна из самых обширных библиотек алгоритмов оптимизации с предметно-специфическим языком моделирования, на котором можно описать оптимизационную задачу, JuMP220). Конечно, это другая оптимизация, чем в предыдущем пункте. Тут оптимизируется время достижения цели. Конечно, тут используется обратная связь от следующего слоя.
-
Слой управления/control с обратной связью (feedback, обратная связь — есть везде, но тут выделенное значение термина, это самое низкоуровневое управление, как в древней кибернетике и теории автоматического управления/регулирования, ТАУ/ТАР221), тут самая высокая частота и непосредственная работа с датчиками-эффекторами, отслеживающими движение по траектории без её перепланирования. Управляющие алгоритмы вроде proportional-integral-derivative controller, PID222.
Вот пример даже не трёхслойной, а двуслойной архитектуры робота F02223, где в качестве двух слоёв архитектуры Helix управления роботом используются две нейронные сети, одна из них работает медленно (работа с целями и построение траектории), а другая быстро (отслеживание обратной связи от множества датчиков и эффекторов, управление сложным движением). Конечно, каждый из двух слоёв в нейросети вполне может быть разбит на подслои, но мы тут этого не касаемся:
Методолог прикладной предметной области (тут — робототехники) должен хорошо понимать, что тут нарисована не уникальная функциональная архитектура (принципиальная схема системы управления роботом), а абсолютно типовое многослойное рассмотрение. И ещё понимать, что задействование нейросетей в таких многослойных архитектурах на нижних «высокочастотных» слоях — это заодно задейстование некоторых оптимизаций, которые могут быть «выучены» (Software 2.0, differentiable programming), а не «запрограммированы вручную» по каким-то алгоритмам.
Основная трудность тут в том, что работа функциональных проектировщиков только-только начинает рассматриваться как следующая какому-то методу и роль функционального проектировщика только-только начинает выделяться из общей роли «опытного инженера».
А теперь вернитесь и попробуйте прочесть содержание подраздела, заглядывая в первоисточники по ссылкам — или признайтесь себе, что этот подраздел вы «прошли мимо».
Сценарии использования
Люди очень трудно учатся думать о функциях как поведении какого-то функционального объекта, ибо это требует абстрагирования от конструктивного объекта или их совокупности, которые играют роли функциональных объектов. В жизни мы наблюдаем «результаты изобретений», уже найденные аффордансы. Поэтому для нахождения в уже готовой системе функциональных объектов её надо как-то «разизобрести» в уме, «спроектировать назад» (reverse-engineering224). Если этого не сделать, то будет непонятно: продолжит ли система выполнять свою функцию, если в ней как-то «пошевелить» конструкцию, заменить какие-то одни аффордансы на другие. Скажем, вы слышите, что цитрусовые спасают экипажи парусных судов от цинги. Закупаете цитрусовые, плывёте — и понимаете, что цинга цитрусовыми не убирается. Это потому, что важна была функция цитрусовых в поставке организму витамина C, но содержание этого витамина в разных цитрусовых было разным. Поэтому кому-то с цитрусовыми и цингой везло, а кому-то — не везло, ибо не было понимания функционирования, мышление было только про конструктив — «цитрусовые». Эта история рассказана в книге «The Book of Why»225, рассказывающей о рациональном причинно-следственном мышлении.
В руководстве по рациональной работе наставляется, как думать про причины-следствия. В работе функционального проектировщика (functional designer) вы как раз при описании будущей функциональности системы отвечаете на вопросы «почему система успешна (будет работать, как ожидается)», а после изготовления системы делаете reverse engineering для неудачных конфигураций воплощения системы (в том числе отладку/наладку/debug/troubleshooting) в порядке поиска неисправности: отвечаете на вопрос «почему система не успешна (не работает, как ожидается, и/или не будет работать, как ожидается)». Конечно, функциональный проектировщик занимается этим в ходе инженерных обоснований (об этом будет ещё раздел в нашем руководстве), но всё-таки его работа связана ещё и с формулированием того, каково же ожидается поведение системы в ходе её эксплуатации — и это будут как описания «чёрного ящика» (функциональность системы в целом), и как «прозрачного ящика» (функциональное описание динамики взаимодействия подсистем, часто на несколько системных уровней «вниз»).
В руководство по методологии было добавлено довольно много материала только для того, чтобы пояснить понятие «метод» как поведение организационной роли. Мы задаём очень абстрактную сигнатуру метода (что надо сделать с чем: какой предмет метода провести задействованием метода в какое состояние), идея приходит откуда угодно, одобрить её должен визионер, они с архитектором грубо определяют, какая предметная область важна для реализации требуемого метода. Если надо добыть огонь, то передадут химикам или физикам, если надо покрасить стену — малярам, если надо набрать клиентов — маркетологам. Затем прикладной методолог предметной области предлагает разложение метода: некоторый набор функций, который выдаёт требуемое сигнатурой поведение. Выполнять эти функции будут какие-то подсистемы (взятые как функциональные/ролевые объекты, мастера в выполнении функции/метода, их предложит методолог/«функциональный проектировщик»). А роли этих подсистем потом исполнят конструктивные объекты — механические детали, оборудование, живые организмы, люди и подразделения, их подберёт проектировщик, сообразуясь с архитектурными решениями, которые даст архитектор. Всё это примерно так происходит для многих уровней целевой системы вверх и вниз для самых разных систем этих уровней, говорят «рекурсивно». А ещё это работает итеративно, инкрементально (говорят про эволюционную/непрерывную разработку). И работают тут команды, в которых люди и их компьютеры выполняют разные роли для разных систем в составе целевой системы и её окружения, а также систем в графе создателей — поэтому даже нельзя говорить о чёткой специализации людей в команде.
Несмотря на то, что функциональное проектирование происходит отнюдь необязательно «сверху вниз» (декомпозицией сигнатуры функции всей системы, мы уже обсуждали, что это из области фантастики), и необязательно «снизу вверх» (чистый синтез, без шагов декомпозиции, это ведь тоже утопично), а по сложным траекториям в ходе эволюционной разработки, логически первым всё-таки определяется поведение системы как «чёрного ящика»: если вы не представляете, что будет делать ваша система, никакие идеи по её внутреннему устройству вам не помогут. Логически вначале вам надо иметь хоть какую-то концепцию использования, затем она будет уточняться по ходу разработки (в том числе продолжит уточняться и после начала эксплуатации!). Далее прорабатываем концепцию системы, чтобы убедиться в возможности выгодного воплощения системы (невыгодное — не делаем!).
По большому счёту, проработка концепции использования и концепции системы — это командная (часто даже нескольких команд) работа по одному и тому же методу на двух смежных системных уровнях, рекурсивное применение системного мышления. Поэтому дальше мы не будем уточнять, концепцию использования мы имеем в виду, говоря о функциональном проектировании, или концепцию системы. В одном случае нам нужно понимать, как устроена надсистема в части использования функциональности целевой системы, в другом — целевая система в части использования функциональности подсистем.
При создании концепции первая стадия — это определить функцию, которую потом нужно будет реализовывать конструкцией.
Понятие кейса (случая, дела, case) в инженерии идёт от судебных и медицинских дел/cases, отсюда же и «папка дела»/«case file», где ведётся журнал происходивших в ходе прохождения кейса событий. Кейсы — это работы, у них есть предмет, с которым они работают, кейсы называются по этому предмету (кейс пациента Васи, кейс поломанного автомобиля №5), иногда работа задаётся через сигнатуру метода плюс указание на экземпляр предмета, который методом доводится до конечного состояния (кейс лечения пациента Васи, кейс починки автомобиля №5). Понятие кейса — из управления работами, кейс — это экземпляр работы.
Но есть и использование понятия кейса для указания метода работы, называется тогда это «use case» и перевод — «сценарий использования». «Сценарий» как раз указывает на паттернированность происходящего, то есть на метод, подразумевается прохождение множества работ по этому методу, описанному сценарием. Использование — это использование системы, которая является предметом метода. «Use case» тут и как название метода описания методов работы системы с её окружением в момент эксплуатации/использования, так и указание на тип сигнатуры метода, описываемого соответствующим сценарием. Как всегда, определить значение словосочетания «use case» (методология описания самых разных методов использования самых разных систем или тип метода использования какой-то системы), можно из контекста. «Ivar Jacobson изобрёл сценарии использования», «в нашем проекте мы используем для описания концепции использования сценарии использования» — это про метод описания. «Сценарий использования дымогенератора», «сценарий использования вышивального станка» — это про целевой метод, описываемый при помощи метода use case.
Предмет метода для use case — это целевая система, определяемая как функциональный объект, который в мир демонстрирует какое-то поведение-функцию. Если мы говорим о кейсах/сценариях использования (use cases), то речь идёт об использовании какой-то системы в абстрагировании от её разбиения на части. В методах use cases описание системы как чёрного ящика идёт в терминах действий самой системы, а окружающие систему предметы (и даже люди) выступают как пассивные (хотя они вполне могут вызывать какое-то поведение системы).
Например, человек-пользователь нажимает кнопку «пуск», система в ответ на это пускает дым (это может быть даже не шуткой: дымогенераторы массово используются как оборудование в танцзалах, барах, театрах). Вот это поведение пуска дыма системой и моделируется. Метод описания функциональности use case моделирует то, что делает система в ходе её использования, а не то, что делает пользователь (поведение пользователя важно только постольку, поскольку он влияет как-то на систему, а система влияет на него).
Далее можно обсуждать, греется ли после этого система, чтобы испарять какое-то вещество в качестве дыма, или взрывает источник дыма, или просто передаёт сигнал в какой-то внешний сервис, который вызовет дым, или ещё что там будет происходить. Это всё будут альтернативные сценарии, которые могут породить какие-то дополнительные особенности поведения системы, но для начала нужно всё-таки определиться, что нам нужно поведение какой-то системы-дымогенератора, нам нужно «дымить», это даст нам сигнатуру метода. Если нам нужно «вышивать гладью», то всё будет по-другому (можно будет думать о швее, автоматическом вышивальном станке, закупке всего вышитого и устройстве автомата по выдаче очередного уже готового изделия, 3D-печати рельефного изображения вышивки гладью и т.д.). Но сначала-таки — что и в каком окружении с чем делать (сигнатура), а потом уже варианты реализации (разложения метода на составляющие). Вот use case как раз используется для задания сигнатуры метода используемой системы (метода использования системы).
Несколько вариантов методов use case обсуждаются в книге «Model-Based System Architecture», второе издание 2022 года:
Методы описания сценариев использования используются в работе функциональных проектировщиков наравне с разными другими методами описания поведения, которые мы упоминали в предыдущем подразделе, но особенно они распространены в описании поведения разных гаджетов (платёжные терминалы) и программных приложений (телефонные приложения). Мы касаемся сценариев использования чуть более подробно просто потому, что они более-менее просты в освоении и поэтому крайне распространены среди программистов.
Функции концепций верхнего уровня (концепции использования для функций системы и концепции системы для функций подсистем), документированные в виде диаграмм use cases далее декомпозируются до так называемой «функциональной архитектуры» (или наоборот: функциональные архитекторы предлагают функциональную организацию системы, которая позволяет синтезировать функциональную архитектуру — мы уже много раз повторяли, что возможно и одно, и другое рассмотрение, но в целом там эволюционный процесс с шагами разной направленности).
В книге «Model-Based System Architecture» описан метод FAS (functional architecture for systems). Метод описан с прицелом именно на декомпозицию, классическое «описание сверху вниз», что более-менее утопично, но вроде как «золотой стандарт» старинной системной инженерии — и вот этот стандарт попал и в современную моделеориентированную системную инженерию.
В разных инженерных школах по-разному понимается, кто именно занимается этим функциональным разбиением: функциональные архитекторы (функциональные проектировщики), или все разработчики по-чуть-чуть, то ли те же самые инженеры, которые выполняют роль и архитекторов модульной структуры («опытные разработчики»). Про эволюционных архитекторов, которые занимаются модульной структурой — будет в следующем разделе.
Пока же укажем, что методов моделирования use case множество, и в указанной книжке кратко описываются в главе «10. Model-Based Requirements Engineering and Use Case Analysis» три, а заодно даётся краткий понятийный/онтологический анализ самого понятия use case. Но при их рассмотрении нужно учесть особенности книги, авторы которой придерживается классического «водопадного» взгляда на системную инженерию киберфизических систем.
В этой книге до сих пор признаётся важность требований, и use cases (сценарии использования) даются как функциональные описания, важные для разработки требований, а не сами по себе важные. В книге много исторических рассказов, много обсуждений разницы в употреблении терминов, но эти рассказы обрываются там, где заканчивается история «водопада», переход к современной гибкой разработке того типа, который повсеместно в развитых компаниях используется для программных систем в книге только-только намечается. Не то чтобы этого перехода не случилось, он случится, но как обычно: новые идеи разработки сначала обкатываются в программной инженерии, и только потом приходят в самые разные остальные виды инженерий.
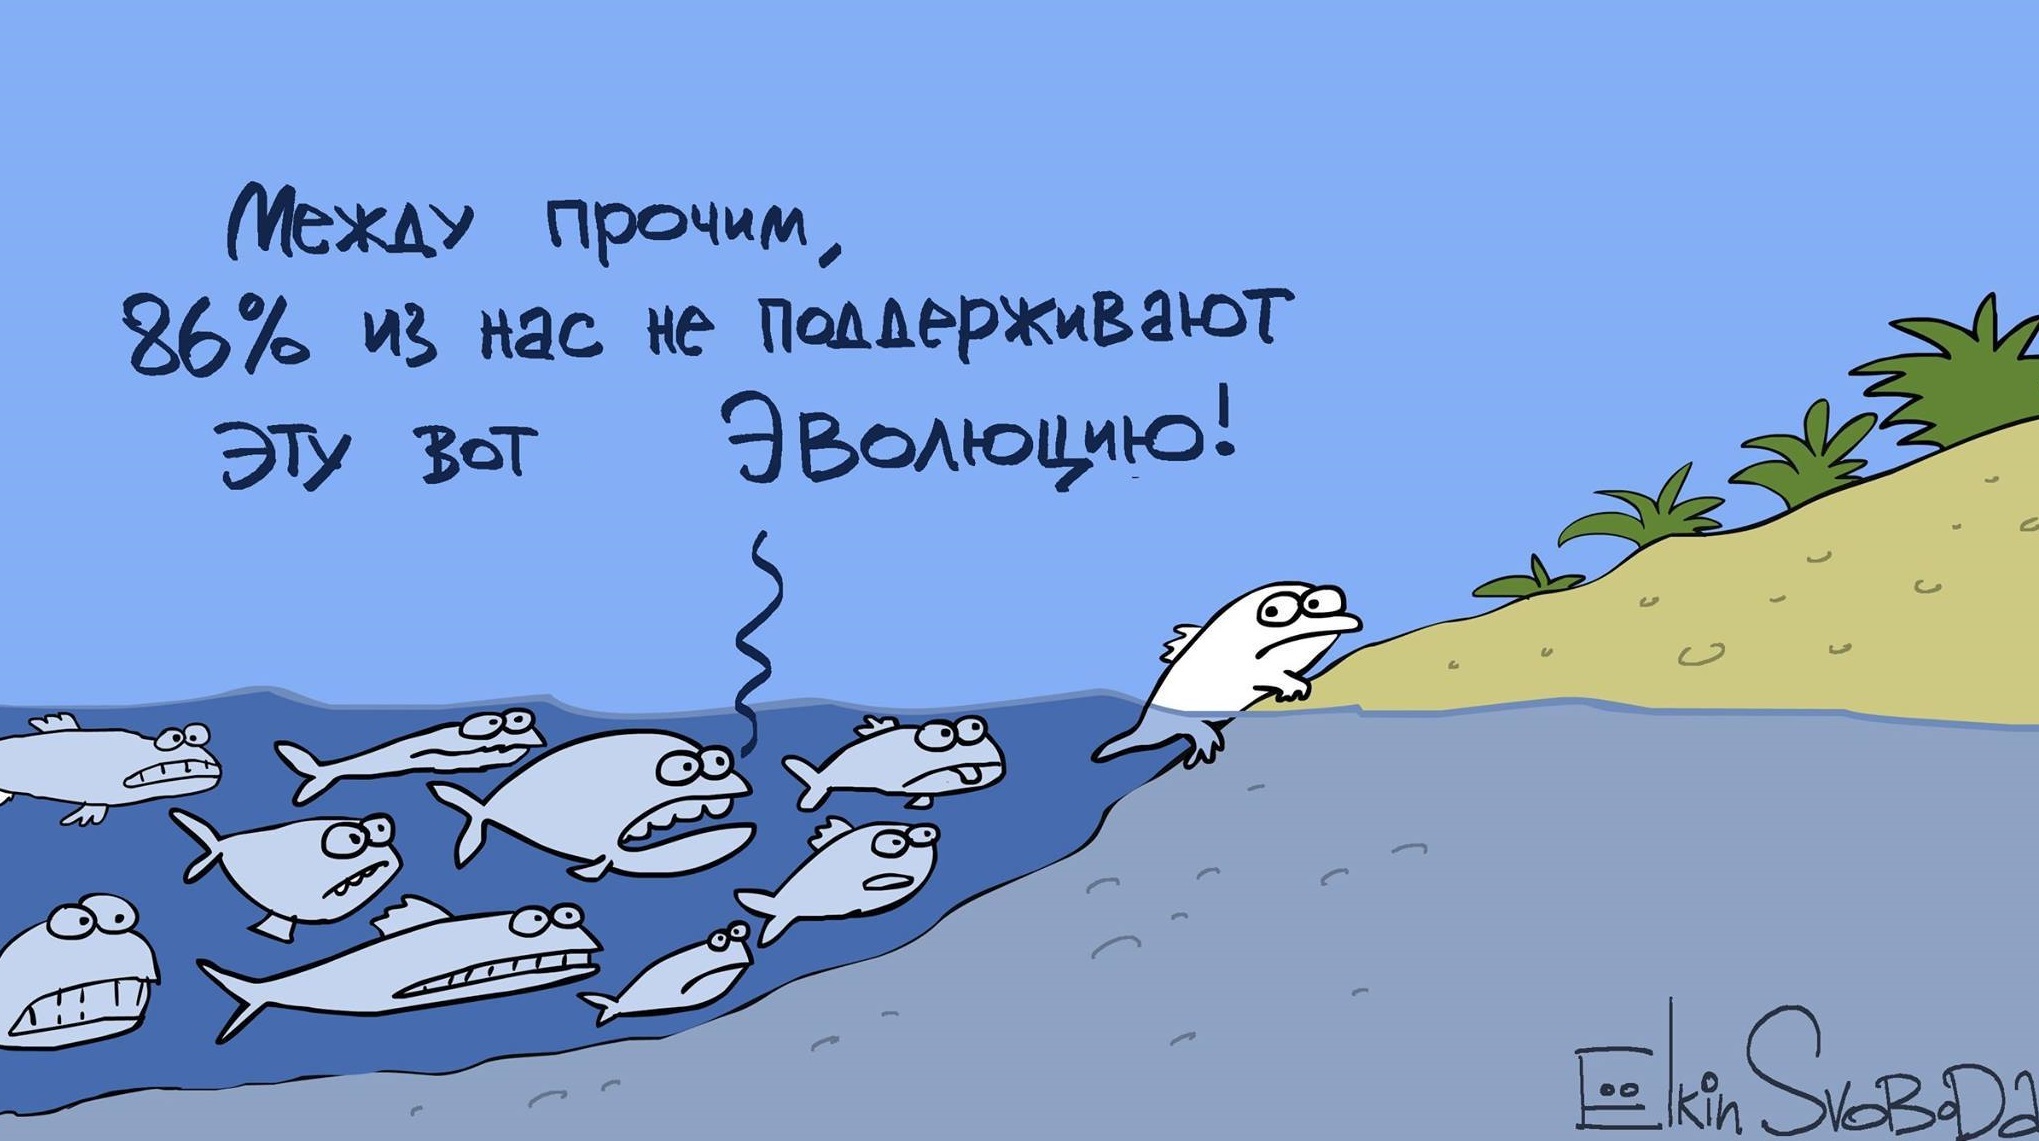
В книге используется диаграммный язык моделирования SysML (в предыдущей цитируемой нами книге «Systems Architecture. Strategy and Product Development for Complex Systems» в качестве такого диаграммного языка моделирования выступал язык моделирования OPM). И SysML, и OPM — диаграммные нотации, «наскальные рисунки», простые для понимания «изображения охоты» на модульность и функциональность — но не слишком выразительные, а главное — не поддерживающие эволюционную разработку, их слишком сложно сопровождать, это действительно «наскальная живопись»: один раз нарисованное дальше очень трудно перерисовывать.
Вовсе необязательно пользоваться диаграммными нотациями, у них есть много недостатков по отношению к недиаграммным методам моделирования. Есть на эту тему целая книга «Визуальное мышление. Доклад о том, почему им нельзя обольщаться»226. В книгах диаграммные нотации оказываются удобны, ибо их там не предполагается часто менять и ещё проекты из книг очень небольшие. Но книга совсем не пример происходящего в реальном современном инженерном проекте! Диаграммные нотации хороши для однократного «постулирования», но не для постоянных изменений, которые предполагаются в эволюционной разработке, где система постепенно развивается/evolve и поэтому постепенно изменяют все её описания.
Сценарии/scenarios в книге вводятся отдельными понятиями, и они в книге считаются текстовыми, а сценарии использования/use cases выражаемыми в какой-то из диаграммных нотаций — и тут же признаётся, что сценарии тоже можно считать сценариями использования, дело не в нотациях. И разные «истории» (storyboards227, story-telling) тоже можно считать вариантом сценариев использования, они призваны держать разработчиков интерфейсов и ответственных за «опыт использования» (UI/UX designers) приземлёнными/grounded, то есть должны показывать картинки окружающего мира, чтобы те понимали, что работают не с описаниями, а с физической системой в физическом мире. Для разработчиков небольших телефонных приложений используются методики типа JTBD, где фокус перемещается с «хотелок» проектных ролей, выраженных в виде user stories, на контекст этих «хотелок», выраженных в виде jobs stories228. Мы тоже так считаем, смотреть нужно не на формат документирования (нотацию), а на объекты внимания для этих моделей.
Помним, что в книге предлагается три варианта метода use case, но вот изобретатель этого подхода моделирования Ivar Jakobson со товарищи предложил в 2024 году новую модификацию метода Use Case 3.0229. Этот метод Use case 3.0 предлагает делить use кейс на «кусочки»/slices, которые реализовывать по очереди, чтобы уменьшить размер одной работы и уйти от «водопада» если не в самой разработке (все эти кусочки кейса вам придётся всё равно готовить сразу!), то в реализации. Но более того, эта третья версия методологии расширяет метод описания поведения системы до урезанной, но всё-таки полноценной методологии разработки, ибо прописывает, как именно получаемые описания функциональности используются в полном инженерном процессе — и описывает инженерный процесс с использованием нотации OMG Essence.
В самом методе «от автора» применяется диаграммная нотация use case, но это совсем необязательно (можно использовать табличную нотацию).
Вот основные концепты Use Case 3.0 и вводимая им нотация:
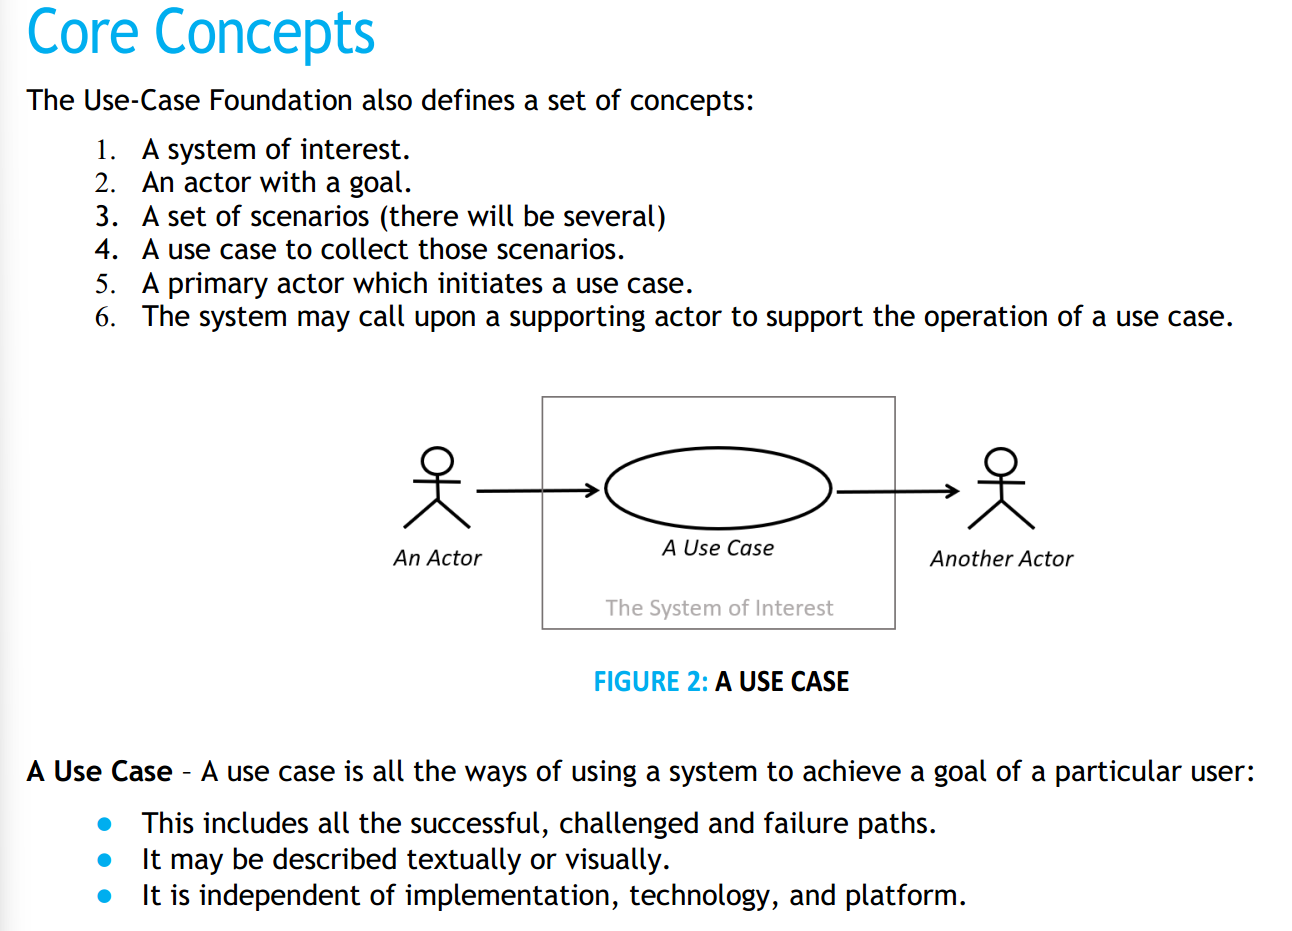
Итак, use case — это способ собрать под одним именем набор сценариев (под сигнатурой метода собрать его разложение на набор составляющих сценариев). Если вы понимаете, что речь идёт просто о ещё одном мнгочисленном способе описания функций системы как функционального объекта, а также отслеживаете строгость типов в разговоре про use case, то уже легко разобраться.
Вот пример графического моделирования use case (пример тоже из документа, задающего метод Use Case 3.0), там система не показана вообще, зато показаны действия со стороны акторов окружающей среды, которые как-то упорядочены во времени, чтобы «рассказать историю». Предполагается, что система выдаёт во внешний мир функции, удовлетворяющее показанным воздействиям (они даются глаголом, указывают на метод актёра кейса, поддержанную целевой системой):
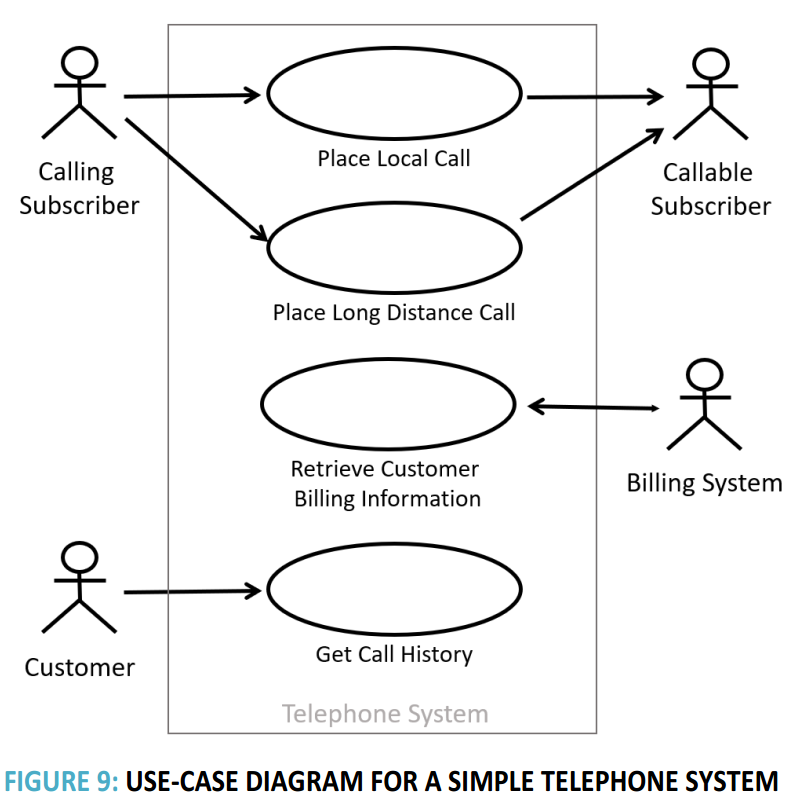
Методы для моделирования и документирования сценариев использования могут использоваться самые разные, и в каждом из них есть нюансы. Интересно, что описание всех этих методов — это небольшие статьи на десяток страниц. Но вы вряд ли сможете нормально воспользоваться этим десятком страниц, если не будете понимать роль и место этого десятка страниц описаний метода во всём инженерном процессе в целом.
Когда массово начали пользоваться use cases для разработки требований, стало понятно, что этот приём моделирования хорошо работает не только для описания поведения системы с людьми-пользователями, но и для выражения поведения системы в неживом окружении: акторы могли быть произвольными, не только людьми. Потом стало понятно, что это совершенно необязательно делать только для самого верхнего уровня системного разбиения (для целой системы), но метод отлично работает и для подсистем. Потом стало понятно, что проще с коллегами (внешними проектными ролями, разработчиками подсистем и т.д.) обсуждать эти сценарии использования, дополняя их деталями по мере проработки концепции (при каждом проектном выборе конструктивного решения появляются дополнительные вопросы: если мы выбрали чёрный корпус, то вдруг могут появиться вопросы к температуре корпуса и пожаробезопасности, ибо внутри кто-нибудь сделал печку с открытым пламенем для постоянного подкопчения корпуса — и в сценарии использования этот вариант не был предусмотрен!).
А требования? В use case проясняются важные предметы интереса всех проектных ролей, их интересы (куда двигаем значение важных характеристик), и пытаемся достичь возможного — предлагаем сразу решения проблем и говорим, насколько удовлетворяются интересы. Спецификаций требований как отдельного рабочего продукта не делаем, но продолжаем обсуждать сценарии использования как описание функциональности и проектные решения — концепции системы и частей системы. Делаем это и для самого верхнего уровня (стратегирование, «какую целевую систему хотим делать», «как хотим изменить мир»), и для более низких уровней, переходя к функциональным декомпозициям и дальше к учёту архитектурных характеристик.
Но и это не конец истории! Появляются DDD, TDD и BDD (это уже обсуждали в подразделе «Смерть инженерии требований» — и вместе с ними идея, что гипотезы о функциональности системы надо описывать сразу в том виде, в котором в изготовленной системе эту функциональность можно проверить/протестировать. Это означает, что описание функциональности надо делать сразу на языке тестирования, это SoTA. И (мы об этом уже писали) сценарии (которые, конечно, взяты из литературы по use cases) записываются не в графической нотации, которую нельзя использовать для проверок, а сразу на языке, подразумевающем проверки (в разработке программного обеспечения это чаще всего язык Gherkin, и уже предложены способы записи сценариев поведения системы, как тестируемых). Вот пример такого сценария, который описывает, что должна делать система — в форме, которая кладётся в основу тестов230:
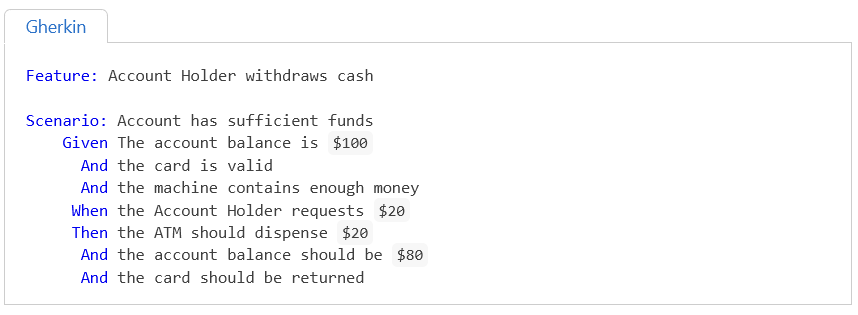
А что с DDD? Для use cases предполагалось, что при их описании каким-то образом будут выявлены понятия (предметы и операции/методы/культура работы с этими предметами) предметной области, проведена работа прикладного методолога. В программной инженерии в уже упомянутой книге «Learning Domain-Driven Design. Aligning Software Architecture and Business strategy» говорится, что объекты предметной области предприятия можно перечислить в каком-то глоссарии, но этого знания будет совершенно недостаточно: не будет хватать информации о поведении этих объектов, их функциях. Для документирования этой информации тоже предлагались use cases. Но вот беда: начальные версии DDD тоже предполагали, что добытая информация о предметной области документируется в виде требований, это ведь уже довольно древний метод!
Нынешние варианты построения описаний говорят о важности предметных областей (domains, bounded contexts — основная идея DDD, равно как и идея о том, что программные средства моделируют эти предметные области и поэтому в моделях должны быть объекты, прямо соответствующие объектам предметной области). Для этих предметных областей предлагается находить события и методы, которые ведут к событиям как достижениям какими-то предметами методов их состояний. Для документирования систем как создателей с их методами/функциями, предметов этих методов в окружении создателей, событий с этими предметами, предлагается довольно большой выбор методов описания процессов/функций/методов/сценариев. В том числе это методы предыдущего подраздела, но и многие другие, включая методы описаний сценариев в виде наборов сценариев использования — тоже на самых разных языках. Скажем, в том же методе Use Case 3.0 говорят ещё и о нарративах, которые определяют цепочку событий — «рассказ о событиях». Скажем, наш граф состояний альф как объектов внимания в проекте, если рассматривать его как граф событий достижения этих состояний, можно назвать нарративом.
Но вот дальше вопрос: что делать с этими описаниями:
-
Использовать для подготовки дублирующих описаний (требований). Это уже устарело.
-
Использовать для проектирования, повышать детализацию до уровня, достаточного для изготовления и последующей наладки. Да, именно так.
-
Использовать в том числе и для инженерных обоснований — да, для этого можно вернуться к предыдущему пункту и попросить сразу писать в таких нотациях, в которых будет удобно получать инженерные обоснования автоматически (пример с использованием языка Gherkin). Это соответствует behavior-driven development, BDD. Это SoTA.
А что же со «свежими» стандартами вроде Use Case 3.0? С этими стандартами сегодня проблемы, хотя их авторы и пытаются как-то идти в ногу со временем — и изобразить «гибкий водопад». Если вы хорошо понимаете материалы наших руководств по рабочему развитию инженеров-менеджеров, вы вполне можете разобраться с тем, что в этих стандартах можно вытащить в ваши проекты интересного, а что лучше не вытаскивать231.
Итого: сначала нужно понять функцию системы, её поведение — в форме, которую легко потом проверить/протестировать. Рекомендуется всячески задержаться на этом уровне рассуждений, максимально отстраняясь от возможной реализации этого поведения какими-то конструктивными объектами, включая даже сам конструктив целевой системы. Сначала понять, какого хотим поведения системы, что она должна делать в окружении. Предложить вариант конструктива «чёрного ящика» системы, чтобы можно было как-то представить её в составе надсистемы как модуль. Узнать предельную стоимость, чтобы понимать, выгодно ли вообще заниматься созданием системы. Это всё — заниматься концепцией использования, «чёрный ящик» (ну, или «прозрачный ящик» для уровня надсистемы).
Потом (логически потом, ибо в жизни тут будет много итераций, циклов, ухода в другие инженерные методы, например, нужно будет рассматривать идеи «изобретения», поиска аффордансов — кроме функционального проектирования заниматься и классическим проектированием, кроме функциональной архитектуры ещё и модульной архитектурой, и всё это эволюционно) надо будет разбираться с «прозрачным ящиком», то есть рассматривать функциональную организацию на уровне подсистем. И там всё то же самое — это часть разработки концепции системы. Но если не понимаешь, как система будет использоваться, хотя бы в общих чертах — непонятно, что там нужно иметь внутри системы, чтобы она была успешной. Поэтому будет множество уточнений, высказывания гипотез, критики гипотез, возвратов назад, генерации новых идей — ничего похожего на «сверху вниз» или «выполнение шагов алгоритма».
Мы тут много раз говорили о системной мантре, говорили о мантре элегантности/lean («распожаризация»), говорили об операционной мантре (поиск ограничений и подстройка под ограничения), будем говорить о мантре рациональности (принятия решений), но это «логические шаги». В жизни всегда эти шаги планируются и делаются в условиях недостатка информации, поэтому выполнение этих «алгоритмов» абсолютно нелинейно, не «пошагово» — но и не полностью беспорядочно. Повторим: если вы не понимаете, что ваша система делает с её окружением, вы не можете предложить конструкцию! Если вы понимаете конструкцию, то можете попробовать уточнить функцию — что там в жизни реально делать такой конструкцией, а что утопично (и надо или соглашаться с этой уточнённой функцией, или предлагать другую конструкцию). Это всё сокращённый разговор, более полный — надо понимать функцию, затем систему как функциональный объект с функциональной организацией, затем систему как конструкцию с конструктивной структурой. Ну, и помним, что там множество синонимов с нюансами, поэтому формулировка эта может быть записана самыми разными словами.
Если вы не знаете, что должна делать система, то вы не сможете изобретать, то есть разбираться с тем, как добиться желаемого поведения системы.
Кейсы/сценарии использования (use cases) как методы и кейсы как работы/дела (в управлении работами это будет кейс менеджмент, case management, управление «делами») в инженерии тесно связаны. В руководстве по системному менеджменту (инженерии предприятия, то есть системной инженерии в приложении для организаций) будет рассказано, что учёт работ/дел в фирме происходит как учёт «кейсов», которые обобщают процессное (используются шаблоны действий в методах) и проектное управление (используется предварительное планирование) на случай, когда ничего нельзя спланировать заранее в ситуации гибкой разработки (тогда просто планируется каждое следующее действие «на лету», а результаты записываются в папку «Дело №___», то есть в case file).
Кейсом называются работы, которые делаются с каким-то предметом кейса как меняющей свои состояния в ходе работ альфой. Состояния альфы иногда плохо определимы, но мы можем о них судить по состояниям ряда рабочих продуктов. Работы переводят эту альфу из состояния в состояние, достижение состояний — событие, прохождение событий иногда называют нарративом/повествованием.
Когда альфа предмета кейса находится в первом состоянии (скажем, пациент больной), кейс открывается, а когда в последнем (пациент здоров или умер) — кейс закрывается. Помним, что граф состояний альфы может быть весьма запутанным. Каждое состояние характеризуется своим названием (дверь закрыта, самолёт летит) и контрольными вопросами его достижения, которые по сути «подсостояния», которых нужно достичь (кейс закрытия двери, предмет кейса и тем самым отслеживаемая альфа кейса — дверь, состояние «закрыта», подсостояния для контрольных вопросов чеклиста: щелей между дверью и косяком нет, замок заперт, ключ из замка вынут).
В руководстве по методологии говорилось, что методы — это способы работ по смене состояний каких-то альф, работы ведь всегда ведутся с предметами работ, которые меняют состояния. Эти работы и предметы работ ведутся какими-то методами с предметами этих методов. В системном менеджменте управляют работами как кейсами по изменению состояний рабочих продуктов, а работы эти идут по методам, которые меняют состояние альф.
Для управления работами нужно выявить (если эти работы уже происходят) или определить (если вы только проектируете деятельность) альфы и подальфы с их состояниями и контрольными вопросами, а также методы, которые переводят эти альфы из состояния в состояние. Если встречается что-то необычное, то эта работа по устранению необычности планируется «на лету», по мере открытия новых обстоятельств дела/case, ровно как в судебном деле: каждая новая улика может повернуть дело в совсем другом направлении, но в конечном итоге дело/case будет закрыто.
В программной инженерии корпоративного софта его концептуальное проектирование (нахождение функций, которые софт должен выполнять) предлагается делать в рамках предмето-ориентированного проектирования (DDD, domain-driven design) так, чтобы программное обеспечение непосредственно отражало структуру предметной области предприятия. В системном менеджменте это означает, что нужно выявить (в случае создания «с нуля» спроектировать, то есть предложить гипотезу/догадку и дальше её дорабатывать или менять на новую, пока не получится успешность, эволюционная fit/вписанность системы в окружение) альфы и подальфы в каждой области интереса графа создателей, изменяющие их методы, роли для этих методов и агентов/актёров, выполняющих эти роли.
Книга «Introducing EventStorm», 2021 (она остановилась в своём дописывании на 2021 годе, но до этого использовала continuous delivery, выходило множество версий/изданий, немного отличающихся друг от друга — не «первое, второе, третье», а просто с какими-то датами последних правок, это соответствует практике continuous delivery232) предлагает ровно такой подход, хотя и в немного другой терминологии, вам должно быть с этим уже довольно легко разобраться — если для каждого понятия, обозначаемого термином предметной области метаУ-модели EventStorm определять его тип мета-мета-модели из наших руководств для инженеров-менеджеров:
Можно смотреть на EventStorm и как на метод функционального обратного проектирования предприятия (а именно, выявление функциональных объектов и их оргфункций для уже работающего предприятия). Дальше это можно использовать и для проектирования организационных изменений (прямое проектирование инкремента, «выпуска» новой версии предприятия как создаваемой системы), а можно использовать как часть проектирования софта, поддерживающего работу предприятия (что, собственно, и предполагает метод EventStorm в его исходном виде, излагаемом в книге).
Метод EventStorm предлагает моделирование, в чём-то похожее на диаграммное, но всё-таки не совсем: в качестве элементов синтаксиса модели предлагаются не иконки на экране, которые потом свяжутся стрелочками, а липкие листочки с надписями (тип мета-мета-модели кодируется цветом листочка, а тип мета-модели из предметной области предприятия пишется на листочке).
Вот как выглядит представление альфы «Подписка/Subscription» (альфа как объект с отслеживаемым состоянием в EventStorm имеет тип aggregate и кодируется листочком жёлтого цвета, на картинке тип aggregate/alpha текстом не подписан, но цвет листочка — это и есть отображение типа):
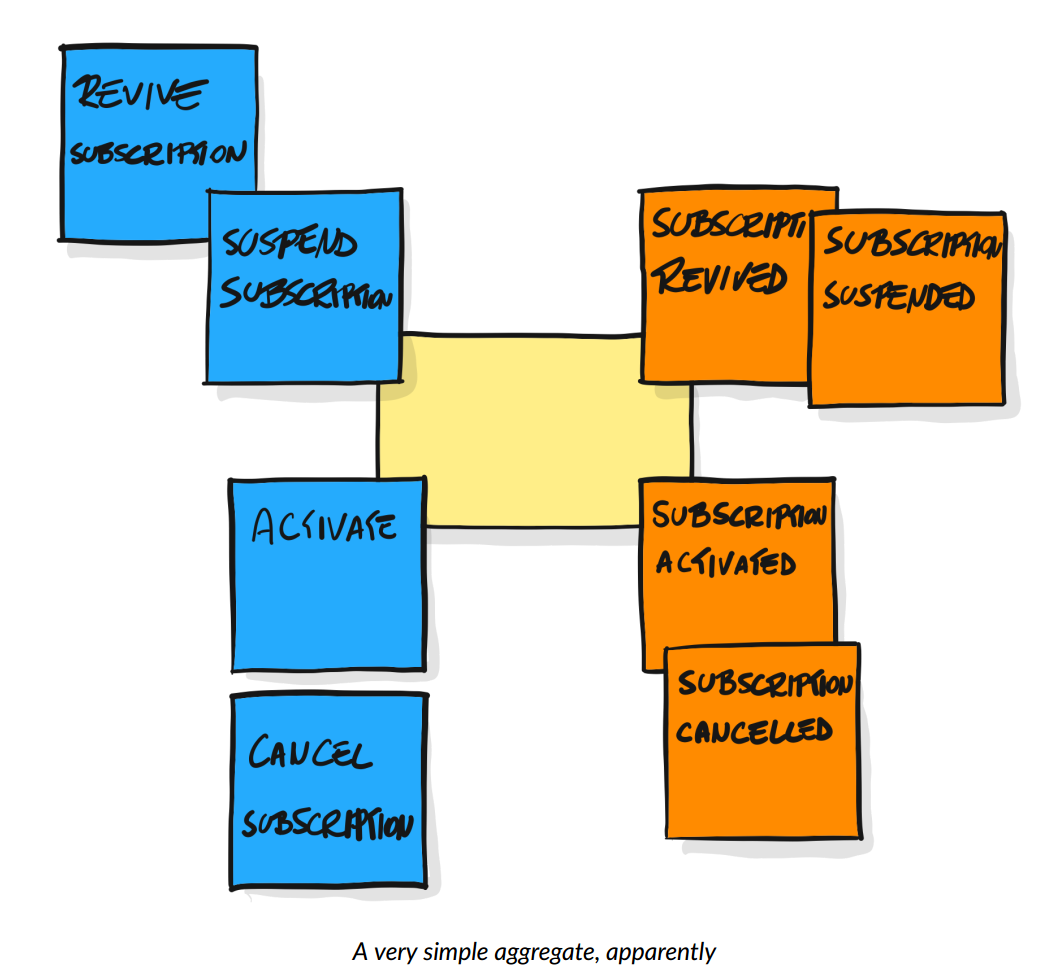
Состояние альфы/aggregate кодируется оранжевыми листочками типа Event, но есть нюанс: листочки означают момент наступления состояния. Cобытие — это ситуация в момент времени, разделяющий прошлое состояние и будущее, например «подписка активирована» означает в EventStorm событие наступления состояния «подписка активирована», там страдательное причастие совершенного вида в названии. В английском это передаётся глаголом в прошедшем времени. Помним, что в use case предложено последовательность событий называть нарративом, но в EventStorm этот термин не используется.
Голубые листочки — это методы/функции/операции, которые ведут к изменениям состояния альфы («двигают повествование от события к событию»), в EventStorm это будут «команды/commands». Так что на стене вы получаете какую-то модель методов предприятия, где предметом методов будут альфы/агрегаты, меняющие свои состояния, будут исполняться какие-то методы/commands какими-то ролями в какой-то последовательности (сценарии/кейсы), выглядит эта модель в виде сгруппированных приблизительно по линии логического времени листочков на стене примерно так:
Методика моделирования делает акцент на то, что все события предметной области (domain events) случаются не сами по себе, а происходят по основным четырём причинам, и поэтому для каждого события (его легко обнаружить! «что-то изменилось в ситуации») нужно отмоделировать и причину события.
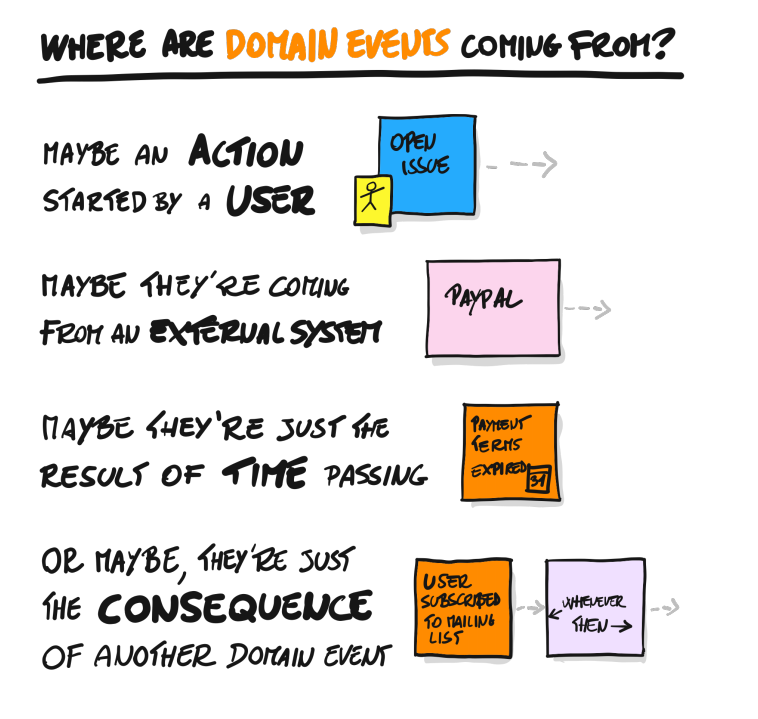
Таким образом мы получим более-менее полную модель, пригодную для case management, основной задачи, решаемой корпоративным софтом: управление конфигурацией работ предприятия: каждый кейс как метод/сценарий соответствует кейсам-работам по этому сценарию (напомним: case в use cases — это метод, в case management — работа по методу).
Конечно, результат EventStorm не слишком детален, чтобы служить хорошей концептуальной моделью. Например, в EventStorm не делается различий между альфами и рабочими продуктами, которые позволяют судить о состоянии альфы, то есть нет собственно «концепции» как описания связки между функциональностью и функциональными объектами, и конструктивными объектами, поэтому ситуации типа «ножницы из режущего блока и ручки и ножницы из двух половинок и винтика» моделируются исключительно плохо и криво. Но очень часто альфы и реализующие их рабочие продукты соответствуют 1:1 (скажем, член команды как альфа сотрудника и член команды как человек), хорошо спроектированные системы стремятся к такому, поэтому как начало моделирования EventStorm вполне подойдёт. Вы можете использовать оригинальную терминологию из EventStorm, можете использовать терминологию из нашего руководства по методологии (она взята главным образом из стандарта OMG Essence и системной инженерии киберфизических систем), можете как-то сами доработать и сам метод моделирования (вместо стены и листочков использовать универсальные LowCode моделеры типа notion.so, coda.io или подобные, или даже использовать таблицы в Excel). Главное, чтобы вы понимали, что делаете: вы работаете над концепцией предприятия (в том числе и концепцией использования, но и концепцией предприятия как системы) в части функционального проектирования, то есть выявляете/реверс-проектируете его поведение, его методы изменения состояния каких-то объектов, а также события изменения этих состояний. Реализуется это кейсами как работами/делами по сценариям использования (use case — слово case тут имеет разные типы для use case и case из case management). Эти дела/работы дальше в порядке управления кейсами отслеживаются/track в issue tracker.
Моделирование кейсов::работ для управления кейсами по факту не отличается от обычного описания «use case»::«методов работ», только меняется тип объекта и референтный индекс**:**
-
Для use case система — это создатель в момент его эксплуатации, действует она, именно она изменяет мир своим поведением, а также реагирует на поведение мира своим поведением. Не пользователь жмёт кнопку системы, а наоборот — у системы пользователем нажимается кнопка. Описание ведётся со стороны системы, а не со стороны действий окружения системы.
-
для кейс менеджмента мы чаще видим альфу из области интересов какой-то создаваемой системы, для изменения которой проводится работа какой-то другой системы-создателя из графа создателей, альфа эта пассивно меняется под действием методов, выполняемых создателем в момент создания.
Понятно, что при этом речь может идти об одной и той же ситуации, только различаются способы моделирования для разных ролей с их разными интересами:
-
В моделировании сценария использования/«use case» я буду писать, что система «дверь» переходит при взаимодействии с ролью «закрыватель двери» в состояние «закрыта» после действия «закрыть дверь» (акцент на то, что будет должна делать дверь как целевая система, реагируя на воздействие окружающей среды).
-
В моделировании метода для описания кейса в case management я буду писать, что систему «дверь» методом «закрытие» роль «закрыватель» перевела в состояние «закрыта» (акцент на то, что будет должен делать закрыватель двери, чтобы дверь перешла в ожидаемое состояние).
А как надо, какую позицию восприятия надо занять? Надо так, как вам удобнее для вашего проекта. Главное, чтобы вы понимали, что именно делаете, какой метод моделирования задействуете, и какие были ему альтернативы.
Моделирование работ по их методам/функциям для последующего управления работами/делами в варианте case management можно использовать отнюдь не только для case в менеджменте предприятия, эти cases/случаи/ситуации можно моделировать хоть в киберфизической системе, хоть в обществе, хоть в живом организме, хоть в личности: вы можете менять позицию восприятия с «с системой активные роли что-то делают в ходе её создания, она ещё сама ничего сделать не может» (кейс менеджмент, смотрим на работу и переходим на рассмотрения метода/способа работы) на «система что-то делает с окружением в ходе её эксплуатации» (сценарии использования). В любом случае обсуждаются ситуации взаимодействия (готовой или ещё не готовой, это по ситуации) системы и её окружения.
Во многих методах моделирования в полной мере не доходят до чёткого представления обо всех полезных объектах внимания: система как функциональный объект в момент эксплуатации, альфы области интересов какой-то системы как отслеживаемые в проекте объекты, агент/актор/актёр как конструктивный объект живой или не очень живой как система в графе создателей или окружении, роль этого агента-создателя, рабочий продукт как конструктивный объект, и т.д.
Для того, чтобы детально отмоделировать сложную ситуацию, вам как функциональному проектировщику (прикладному методологу предметной области, функциональному архитектору, помним о множестве имён для роли) потребуется выявить (реверс-инженерия) или предложить (прямая инженерия) довольно много объектов в предметной области ситуации (мета-модель), соответствующих самым разным типам мета-мета-модели системной инженерии, даваемой в настоящем руководстве (понятия концепции системы, концепции использования, архитектуры и т.д.). И, конечно, вам нужно будет много общаться, чтобы договорить по поводу создаваемых вами функциональных описаний системы всех вокруг — и договорить внутренние/командные проектные роли, и внешние проектные роли.
Задания
Поставьте отметки о выполнении:
-
Описана сигнатура основного метода работы вашей системы: какое выполняемое методом преобразование нужно, какие входные данные или предметы метода использует, и какой результат (выход) производит.
-
Указано, является ли метод дискретным (например, последовательность шагов), непрерывным (например, поток энергии или данных) или гибридным.
-
Выбран один из формализмов для описания метода работы вашего функционального объекта. Это могут быть конечные автоматы, потоки работ (workflow), потоки данных (dataflow), сети Петри, системная динамика или любой другой подход (даже не из нашего руководства), который вы считаете подходящим. Выбор формализма обоснован: почему он соответствует природе вашей системы и удобен для её проектирования. Указаны ограничения и преимущества для вашего проекта.
-
Создана (или найдена в уже имеющихся материалах вашего проекта) простая верхнеуровневая (5-7 функциональных объектов-подсистем) функциональная модель вашей системы с использованием выбранного формализма. Модель отражает основные состояния, переходы, потоки или операции, которые обеспечивают выполнение функции сигнатуры метода работы вашей системы.
-
В случае, если ваша функциональная архитектура многослойна (например, стратегический уровень, планирование, оперативное управление), то описано, как эти слои взаимодействуют и какие задачи оптимизации решает каждый слой.
-
Написан пост по проблемам и ограничениям в вашем проекте, замеченным по итогам моделирования. Например, неэффективность/неоптимальность, избыточная сложность, отсутствие согласованности с другими частями системы. В посте предложено одно улучшение функциональной архитектуры (например, изменение последовательности операций, добавление обратной связи, упрощение структуры).
5. Эволюционная архитектура
Архитектура: было «про трудно изменяемое», стало «про облегчение изменений»
Архитектор — это на древнегреческом «главный строитель», arkitekton, αρχι‑ (arkhi‑, «главный») + τέκτων (téktōn, «строитель»). Он определял что и как строить, а также следил за рабочими-строителями. Дальше понятие архитектуры перешло во все остальные виды инженерии, при этом понятие непрерывно менялось и было удивительно трудно определяемым, оно было неотличимым от понятия «самый опытный разработчик».
Тем не менее, во всех этих ранних понятиях оставалось указание на архитектуру как определение структуры (структура — это понимание, как система разделена на части, прямая отсылка к системному мышлению, разбирающемуся в способах деления системы на части, причём мы помним, что статистически термин «структура» тяготеет к продуктным/модульным/конструктивным разбиениям), определение чего-то важного, чем бы оно ни было (Ralf Johnson), а также принятие решений по основным принципам организации системы (ибо выяснилось, что не всегда понятно про части системы, но можно сформулировать принципы появления этих частей. Например, так устроен интернет, и именно такое определение было дано в ISO 42010:2011, но помним, что «организация» тяготеет статистически к функциональным разбиениям).
В 2017-2022 году понятие архитектуры, метода архитектурной работы и роли архитектора претерпели значительные изменения, прежде всего в программной инженерии, а дальше это изменение, получившее наименование «эволюционная архитектура» (evolutionary architecture), будет всё больше и больше ощущаться во всех остальных видах инженерии, хотя и с лагом (обычно такой лаг 10 лет, поэтому ожидаем существенных массовых изменений для архитектуры «железа» с примерно с 2027 года, но передовые предприятия вроде SpaceX или NVIDIA работают с таким пониманием уже сегодня):
-
Архитектор начал заниматься не всем важным, а только тем важным, что входило в его concerns/«предметы интереса»/«важные характеристики», к которым отнесли всевозможные -ости/-ilities (производительн-ость, доступн-ость, надёжно-ость, и т.д.). Эти архитектурные характеристики иногда раньше в системной и программной инженерии называли «нефункциональными требованиями», но это не требования, а предметы интереса (требования вообще по факту исчезли из инженерии), но даже не это плохо: плохо использование слова «нефункциональные», никто ведь не хочет заниматься чем бы то ни было, у чего нет функции/назначения. И это не «требования качества», потому как никакого отношения к качеству у этих характеристик нет, это оказались совершенно особенные предметы интереса, архитектурные. Если функциональность отличалась от одной системы к другой (валенки тёплые, электростанция мощная), то архитектурные характеристики более-менее одни и те же для самых разных систем (ремонтопригодность и надёжность валенок и электростанции).
-
Задачей архитектора стало нахождение архитектурных решений (architectural decisions), которые стали пониматься, как решения по конструкции системы, гарантирующие квазиоптимальные значения архитектурных характеристик (а не функциональных характеристик, связанных с domain). Тем самым задачи архитектора чётко были отделены от задач команд разработчиков/developers/прикладных инженеров для domain: прикладные инженеры разных команд делают части системы, которые обеспечивают функциональность, а системный архитектор принимает решения, которые направляют деятельность разработчиков из разных команд так, чтобы достичь оптимума/баланса в архитектурных характеристиках. Если речь шла о функциональных характеристиках, то начали уточнять «функциональный архитектор» и «функциональная архитектура», а не просто «архитектура», но всё чаще и чаще отказывались тут от такого термина и переходили к «функциональному проектировщику/designer» и результату его работы «функциональному проекту/design». Термин «архитектор» тем самым оставался закреплённым за ролью, занимающейся конструктивной структурой в связи с архитектурными характеристиками. Конечно, это всё не происходило одномоментно, даже в программной инженерии, изменения идей и терминологии в профессиональных сообществах происходят за годы, а не за ночь — людей переучить много дольше, чем обновить софт в компьютере или даже переобучить большую языковую модель в AI-системе. Как термин «архитектура нейронной сети» использовался для описания dataflow в 2017 году, так и продолжает использоваться в инженерии нейронных сетей и сейчас. Но вот в разработке корпоративного софта идеи по поводу того, что такое архитектура, как её разрабатывать, а также терминология разговора об этом — они уже существенно поменялись.
-
Изменился сам состав архитектурных характеристик. По John Ralf в архитектуру входило всё важное, что бы это ни было, а важное чаще всего определялось как то, что трудно менять: при альтернативном прохождении развилки в какой-то концепции системы пришлось бы переделывать всю систему. Скажем, принимается решение использовать реактивный двигатель, а не турбореактивный двигатель — и всё, самолёт нужно переделывать, вот такое решение называлось архитектурным, и требования для него (скажем, скорость самолёта, которая связана со звуковым барьером, возможность преодолеть который зависит от типа двигателя) назывались тоже архитектурными. Вот такие решения сейчас оказались связанными с функциями системы в её предметной области и стали решениями функциональных проектировщиков. А у архитектора появилась главная архитектурная характеристика evolvability/развиваемость, которая как раз и означает возможность «изменять трудноизменяемое»: гарантирует, что архитектура системы позволяет легко менять даже важные решения разработчиков. Архитектурные методы работы стали поддерживать эволюцию системы, их результат начали называть эволюционной архитектурой (evolutionary architecture, подразумевает изменяемость в ходе проекта, а не незыблемость). Архитектурные методы работы начали поддерживать agile lean разработку, работа архитектора сама стала agile lean (гибкой элегантной архитектурной работой).
В итоге сейчас ключевым вопросом работы архитектора стало удержанием приемлемых значений архитектурных характеристик при постоянно идущих изменениях в эволюционной/непрерывной разработке.
Разрабатываемая система оказалась постоянно эволюционирующей, от концепции жизненного цикла отказались, «водопад» исчез, окружение системы оказалось постоянно меняющимся в ходе эксплуатации, появлялись новые идеи, как использовать систему, концепция использования оказалась просто «документирована», а не «фиксирована» (и использование термина «фиксировать» начало считаться моветоном, как отсылка к «водопаду» с его «фиксацией требований», после которых вносить в них изменения становилось катастрофически трудно, «теоретически возможно», а не практически), разработчики стали выпускать непрерывно уточняющиеся версии систем, и не раз в пару лет (как все уже привыкли), а по нескольку раз в день (до десятка раз, в случае программных систем). Даже ракетостроители выпускают уникальный по своей конструкции каждый следующий экземпляр ракеты. Китайские автомобилестроители в 2025 году говорят, что время внесения существенных изменений в проект легкового автомобиля до момента выхода готового автомобиля — три месяца, а если не успел в такой срок — вылет с высококонкурентного рынка. Архитектурная работа сейчас должна если не гарантировать, то хотя бы стараться, чтобы быстрые изменения функциональности были возможны, была высокая скорость обновления системы (возможность изменений — evolvability) — за короткие сроки возможности внесения функциональных изменений без увязания в огромном числе согласований стал отвечать архитектор. Если кто-то говорит «добавить эту новую функцию в текущую конфигурацию невозможно, для этого надо переделать всю систему с нуля» — это провал архитектурной работы.
Архитектура документируется не «диаграммой», а набором архитектурных решений, об этом чуть позже. Скорее всего, «архитектура — это диаграмма» бытует как «народное понимание» архитектуры как архитектурного описания, причём описания именно «функциональной архитектуры» в форме «принципиальной схемы»/«функционального описания».
Архитектурные решения, из которых состоит архитектура, тоже меняются в ходе эволюционной/непрерывной архитектурной работы — даже когда какие-то версии системы уже эксплуатируются. Одни конструкции системы заменяются другими, иногда эти обновления более чем радикальны. Достаточно посмотреть, как проектируется Starship компании SpaceX, какие радикальные там принимаются решения в ходе разработки, насколько отличаются друг от друга выпускаемые прототипы, как изменяются архитектуры спутников SpaceX по мере их выпуска. Например, в этих спутниках появилась лазерная межспутниковая связь, прямая связь от спутника к телефону, но в момент начала запуска спутниковой группировки спутников с такой конструкцией не было, конструкция их не могла поддержать новую функциональности. И эти изменения — рабочий момент, а не прекращение работы предыдущей версии спутников и начало работы новых. Нет, конструкция всей группировки менялась прямо по ходу эксплуатации.
Основные архитектурные решения стали о том, на какие части надо разбить систему, чтобы независимое принятие командами разработчиков решений по переделке системы для появления той или иной новой функциональности не приводило к катастрофе «это невозможно, надо перепроектировать всё с нуля». Архитектор оказался ответственным не за раннее принятие «важных решений», а ровно наоборот — чтобы принятие таких решений можно было делать и на поздних стадиях проекта, чтобы переделки были простыми, чтобы команды не проводили огромное время в согласовании своих работ над разными частями системы. И даже сами архитектурные решения оказалось необходимым изменять не только потому, что меняется функциональность системы в ходе её agile непрерывной разработки, но и потому, что у самого архитектора меняется в ходе проекта понимание того, какой баланс значений архитектурных характеристик был бы предпочтителен — и у него появляются новые архитектурные решения, которые поддерживают достижение этого нового баланса.
Вообще, сама идея о том, что архитектура должна помогать системе быть легкоизменяемой в разработке, а не наоборот, класть в основу что-то неизменяемое, а ещё идея о том, что архитектура сама по себе должна меняться по ходу разработки и даже уже эксплуатации, а не определяться поближе к началу проекта как что-то «основное и незыблемое» — вот эта идея была в инженерии достаточно революционна. Впервые подробно эта идея изложена в книжке 2017 года «Building Evolutionary Architectures» на примере программной архитектуры для корпоративного программного обеспечения (софт для поддержки работы предприятий — бухгалтерия, маркетинг и т.д.), а в декабре 2022 года вышло второе издание книги, ответившее на неизбежную критику первых лет:
В этой книге обращается внимание на то, что архитектура не разрабатывается сейчас «после требований, но до изготовления/строительства», а тоже меняется по мере того, как постоянно меняются требования (это 2017 год, требования ещё были довольно распространены, но признавалось, что «они постоянно меняются») и ещё отслеживаются изменения в самой разработке. В книге подробно рассказывается, как evolvability/развиваемость системы становится едва ли не главной архитектурной характеристикой (предметом ролевого архитектурного интереса).
Уже окончательно признано, что архитектура связана не только со структурой самой целевой системы, но и со структурой создающего эту целевую систему инженерного коллектива, состоящего из многих команд. Закон Конвея (Conway’s Law)233 — это наблюдение, что архитектура (модульная структура системы) обязательно отразит оргструктуру предприятия-создателя, ибо взаимодействие между модулями требует согласования — и поэтому архитектура нарежет систему на куски, которые попадут в зону ответственности отдельных подразделений. Взаимодействий внутри частей одного модуля будет много, но они будут обсуждаться внутри одного подразделения. Взаимодействия отдельных модулей будут проходить через строго определённые интерфейсы, но обсуждаться они будут проще — между подразделениями, ибо будут минимизированы.
Отсюда родилась идея обратного манёвра Конвея (reverse Conway maneuver)234 — что вы должны разработать лучшую структуру системы, которая будет успешна на рынке, а также позволять быстрые изменения функциональности, а структура предприятия-создателя (нарезка коллектива инженеров на команды) должна пройти так, чтобы она отражала разработанную лучшую структуру системы. Если не выполнить обратного манёвра Конвея, то через закон Конвея организационная структура обязательно приведёт к ухудшению разработанной лучшей структуры, и система будет неуспешна. Так что архитектор системы и архитектор предприятия оказались работающими в общей связке, а изменяемость архитектуры системы, которую разрабатывает предприятие, ведёт ещё и к изменяемости архитектуры предприятия.
Архитектурные характеристики
Окончательно новый подход к эволюционной архитектуре, которая занимается архитектурными характеристиками, абстрагируясь от функциональности («функциональной архитектуры») на примере архитектуры для корпоративного софта был сформулирован в книге «Fundamentals of Software Architecture», 2020.
В этой книге чётко говорится о различении прикладных разработчиков (разбитых на команды developers, в число которых входят и «функциональные архитекторы»/«прикладные методологи предметной области») и архитекторов (architects):
-
предметы интереса разработчиков лежат в реализации функциональности какой-то предметной области каким-то кодом. Разработчики предметноспецифичны, у них разделение труда по разным предметным областям, в которых у них глубокая экспертиза.
-
предметы интересы архитектора очень специфические архитектурные: важные/архитектурные характеристики, которые относятся не столько к функциональности системы в её предметной области, сколько к общим характеристикам работы и создания (характеристики не только времени эксплуатации, но и времени создания!), которые делают систему успешной или неуспешной. По отношению к функциональности архитекторы (новое понимание роли архитектора!) трансдисциплинарны, у них нет мастерства в предметных областях, с которыми разбираются разработчики, хотя им крайне рекомендуется иметь такое мастерство, как и разработчикам рекомендуется иметь мастерство архитектора. В какой-то мере архитекторы — «системные мыслители проекта», обсуждают архитектурные характеристики системы в целом. Поэтому часто говорят, что в классической инженерии самая «системноинженерная» специализация — архитектор.
Скажем, если система отлично справляется со своими предметноспецифичными функциями, за которые вы готовы платить (скажем, игровой сервер вас может отлично развлечь, котельная может отлично обогреть), но вам недоступна (плохие значения архитектурной характеристики доступности/availability235), то систему нельзя считать успешной. Когда-то на заре интернета поисковые системы были реализованы на огромных серверах Sun, но поскольку к ним обращались одновременно тысячи пользователей, они по факту были недоступными: ответа от них было нельзя дождаться. Это как попасть в город со знаменитым музеем на один день, и обнаружить, что в этот музей очередь на пять дней! Вроде музей есть, и работает, но из-за очереди нельзя попасть! И дальше начинаются разговоры о том, что легко спутать производительность и доступность (скажем, музей в городе может пропустить за день сколько хочешь человек, очереди нет и в принципе быть не может, но только работает этот музей по субботам 2 часа с 14 часов до 16 часов, а в другое время просто закрыт).
Этих архитектурных характеристик оказалось множество236, и для многих видов систем они оказались более-менее повторяющимися. Вот какой-то их приблизительный перечень (взят как раз из упомянутой книги, и там строго-настрого предупреждается, что в каждой организации эти архитектурные характеристики будут трактоваться по-своему):
-
Операционные (времени эксплуатации системы) предметы интереса архитектора, которые пересекаются во многом с предметами интереса ответственных за изготовление, ремонт и эксплуатацию целевой системы (в программной инженерии это инженеры внутренней платформы разработки, до сих пор их называют более старым термином DevOps, и там же многочисленные варианты XOps как общее имя методов работы и одноимённых ролей самых разных Ops — PlatformOps, MLOps, DataOps, and ModelOps237):
-
Доступность/availability: часы работы системы (скажем, 24 часа в сутки 7 дней в неделю, и на сколько она может закрываться на профилактику, ремонт, отдых персонала)
-
Непрерывность/continuity: оргвозможность восстановиться после какой-то катастрофы (наводнение, удар молнии, война).
-
Производительность/performance: включает и устойчивость к постоянной нагрузке, и устойчивость к пиковым нагрузкам (часто выделяют как отдельный предмет интереса — эластичность/elasticity), и частоту обращений к функциям системы, и время ответа на запросы, и требования к запасу мощности. Удовлетворение ожиданий по производительности само по себе будет отдельным приключением в разработке, может потребовать экстраординарных решений в части архитектуры.
-
Возможность восстановления/recoverability: с какой скоростью в случае катастрофы всё восстановится? Бэкапы, дублирование оборудования — это всё тут.
-
Надёжность и безопасность/reliability and safety: если что-то поломается, то это никому не должно повредить (никто не должен быть покалечен или убит, или никто не должен потерять большие деньги).
-
Устойчивость/robustness (у «железных» инженеров чаще resilience) — возможность хоть как-то работать и обрабатывать неизбежные ошибки в критических ситуациях, когда произошли довольно крупные поломки (скажем, пропало интернет-соединение, или выключилось энергопитание, или пошёл дым из компьютерного блока).
-
Масштабируемость/возможность наращивать производительность по мере возрастания числа пользователей или интенсивности их запросов.
-
-
Характеристики времени создания:
-
Конфигурируемость/configurability — возможность пользователю поменять конфигурацию системы самому через удобный пользовательский интерфейс.
-
Расширяемость/extencibility — насколько легко добавлять новую функциональность.
-
Устанавливаемость/installability — насколько легко устанавливать систему в самых разных вариантах использования.
-
Повторное использование/leverability and reuse — насколько легко переиспользовать систему в разных проектах.
-
Локализация/localization — поддержка множества языков, единиц измерения, часовых поясов
-
Сопровождаемость/maintainability — как легко обслуживать систему по ходу её эксплуатации?
-
Переносимость/portability — как легко перенести систему в другое окружение (например, на другую платформу, программное обеспечение на другую операционную систему).
-
Поддерживаемость/supportability — уровень технической поддержки, который ожидается для системы: как быстро отзываются, что могут поправить, сколько стоит.
-
Возможность апгрейда/upgradability — как легко и быстро перейти с одной версии системы на другую, будут ли вообще доступны следующие версии.
-
Этих характеристик, конечно, много больше. Например, прайвеси/privacy, безопасность/security, которые как предметы интереса архитектор имеет общие со специалистами по безопасности. ISO 25010 Product Quality Characteristics архитектурные характеристики называет характеристиками качества, и предлагает свой список238, но первым пунктом там стоит «1. Functional suitability», как «уместность функциональности», то есть насколько система выполняет ожидаемые от неё функции. И вот это предмет заботы прикладных инженеров. А вот остальные группы характеристик там как раз архитектурные. И тут нужно сказать, что каждая «сводная характеристика» тут разбивается на множество.
Так, часто поминается «возможность положиться на систему»/dependability как набор более дробных характеристик: availability, reliability, maintainability, durability, safety and security как один вариант, или availability, reliability, safety, integrity (сопротивление к несанкционированным изменениям), maintainability, и ещё бывают разные другие варианты.
Современный тренд — это работа не с интуитивной оценкой каждой характеристики, но с метриками для каждой характеристики, причём значения этих метрик замеряются специальным методом/функцией, проверяющей соответствие «того, что есть у системы» и «того, что надо для успешности системы в её эволюционной нише». Этот метод/функцию соответствия системы её экологической нише по какой-то архитектурной характеристике так и называют — функция соответствия, fitness function.
Для программного обеспечения этот метод/функция соответствия программируется в виде кода какого-то алгоритма (разного для разных архитектурных характеристик), который прогоняется наряду с функциональными тестами и показывает, как изменилась та или иная характеристика в ходе изменений в системе, которые вносят разработчики. Если тесты/испытания новой функциональности (помним о BDD, само определение новой функциональности будет сегодня, скорее всего, записано в формате теста этой функциональности) прошли успешно, то архитектор смотрит на то, как прошли его архитектурные тесты, то есть как поменялись значения функций соответствия, то есть автоматически вычисленные замеры значений архитектурных характеристик по каким-то им выбранным метрикам. Не ухудшились ли архитектурные характеристики после очередного обновления системы? Если ухудшились, то это
-
или разработчики выполнили все архитектурные решения, но это не помогло — и архитектору надо принимать новые архитектурные решения, его решения ведь тоже только гипотезы, архитектура как набор архитектурных решений меняется в ходе проекта.
-
или разработчики проигнорировали некоторые архитектурные решения — и у них появился технический долг перед архитектором, архитектору надо указать на их ошибки — и заставить переделать их работу так, чтобы и функциональность была такая, какую они хотели реализовать, и архитектурные характеристики остались в допустимых значениях.
Методы/функции расчёта значений архитектурных характеристик, выполненные в ходе прогона тестов наряду с тестами функциональности — это и есть fitness functions. Проверка безопасности и защиты — она тоже может делаться fitness functions, ибо характеристики безопасности и защиты тоже можно считать архитектурными характеристиками, это не функциональные характеристики. Мы уже обсуждали, что «безопасники» в части security/защиты только по недоразумению представляют отдельную инженерную роль, проще считать их вариантом роли системного архитектора. Они ведь тоже про «видимость модулей» и «удержание характеристик системы при ошибках в отдельных модулях». Можно условно считать, что они пытаются уменьшить влияние на проект команд «отрицательных разработчиков», которые разрабатывают свои модули, пытающиеся нарушить все архитектурные решения по межмодульной связи. Архитектурные fitness functions должны ловить саму возможность таких нарушений.
Лучший способ разобраться со всеми этими архитектурными характеристиками (бывшими «требованиями качества») — это понять, как их отслеживать/мониторить в ходе проекта. Для программных проектов на эту тему написана отдельная книжка «Software Architecture Metrics», 2022:
Если же у вас системы другой природы и/или какие-то другие метрики, не упомянутые в этой книге, то напомним про существование книги «How to Measure Anything: Finding the Value of Intangibles in Business», 2014 (в какой-то момент вам всё же придётся её прочесть, равно как и все остальные книги, обложки которых приведены в нашем руководстве):
Архитектор в своей работе думает ровно об этих архитектурных характеристиках системы основное своё время, примерно так же, как прикладной инженер думает о функциональных характеристиках. Он лично беседует со всеми внешними проектными ролями, чтобы разобраться, какие значения этих характеристик должны быть, чтобы система была успешна. Хороший совет: сосредоточиться не на всех этих характеристиках/предметах интереса, а только на реально необходимых для успеха системы! Например, ограничиться всего тремя предметами архитектурного интереса как важнейшими, а остальные учитывать, но не очень тщательно. Это рекомендация книги «Fundamentals of Software Architecture», со всеми прилагающимися к ней оговорками, что это число и сам состав отобранных архитектурных характеристик сильно зависит от конкретной ситуации в проекте. И дальше нужно принять архитектурные решения, которые позволяют для достижения успешности системы удовлетворить именно эти наиболее важные архитектурные интересы, а не вообще все (что невозможно). Для этого архитектор (равно как и разработчик) много общается с внешними проектными ролями и понимает ситуацию, в которой происходит эксплуатация и разработка системы (они связаны через закон Конвея).
Скажем, вы реализуете какую-то поисковую систему. Архитектор понимает, что для этого приложения ему крайне важна характеристика скорости ответа на поисковый запрос. Он выбирает метрику: «время ответа на поисковый запрос» (не любое время ответа! Только на поисковый запрос). Выбирает метрику: это не «быстро» или «медленно», а «среднее время ответа в миллисекундах». Выбирает приемлемый диапазон значений метрики: «отлично» тут — меньше 150мс, «хорошо» — 150мс-200мс (в литературе по UX указано, что задержка более 200мс хорошо заметна пользователю как «тормозит»), «удовлетворительно» — 200мс-300мс, и «неудовлетворительно/неприемлемо» — больше 300мс. Дальше пишем функцию соответствия в виде теста времени отклика — для этого придётся закупить софт нагрузочного тестирования, определить параметры тестирования (скажем, замер идёт при одновременном обращении 100 пользователей). Вставляем эту нашу fitness function (тест архитектурной характеристики) в общий пул тестов, которые будут прогонять разработчики в ходе их BDD. И отслеживаем замеры, которые поначалу показывают «отлично». Разные команды разработчиков добавляют по чуть-чуть функциональность в поиск: усложняют язык запросов, обращаются к каким-то удалённым микросервисам по сети, чтобы не возиться самим с каким-то вычислением. И в какой-то момент груз этих эволюционных изменений оказывается настолько тяжёл, что время ответа на поисковый запрос стало «удовлетворительным». Это повод архитектору обратить внимание на ситуацию и вмешаться — разобраться, почему так, и что надо делать.
По поводу эволюционной архитектуры и функций соответствия очень сложно искать информацию (как поисковыми системами, так и AI-системами), ибо одни и те же термины используются в самых разных областях:
-
Эволюционные алгоритмы (меметические и генетические, проблемы open-endedness). Скажем, вам будут рассказывать про fitness functions для этих алгоритмов, никакого отношения к обсуждаемой fitness function для архитектуры в инженерной разработке. И даже если это будет инженерная разработка, вам покажут статьи по эволюционным алгоритмам в поиске оптимальной функциональной архитектуры (например, evolutionary neural architecture search, NAS239).
-
Строительная архитектура, где речь пойдёт, например, о важности sustainability, понимаемой как неухудшение экологических характеристик той местности, где стоит здание. Вы долго будете удивляться, почему от вашего софта требуют не загрязнять окружающую среду и быть в нулевом энергетическом балансе с окружающим миром. Кстати, в строительной архитектуре вместо evolvability говорят об adaptability240 — здание ведь тоже эволюционирует, но это понимается как адаптация к изменившимся условиям, design for adaptability. В теории эволюции указывается, что эволюция не имеет своей целью адаптацию! Поэтому выбор термина evolvability более удачный и многообещающий, чем adaptability.
-
Архитектура может пониматься как «всё важное», «функциональная» (без упоминания этого слова), «структура конструкции» (без функциональности, чаще всего это в литературе по эволюционной архитектуре), как синоним «концепции системы». Всегда проверяйте, что имеет ввиду автор, говоря об архитектуре, архитектурной работе, архитектурном методе, роли архитектора.
Моделирование: архитектурные характеристики
Приведите переводы на русский названия для десяти выбранных по вашему усмотрению из книг, указанных в предыдущем подразделе, архитектурных характеристик, дайте их краткое описание. Отметьте по десятибалльной шкале их важность для вашей системы.
| Номер п/п | Англоязычное название | Русскоязычное название | Краткое описание (на русском) | Важность для вашей системы |
|---|---|---|---|---|
| Пример. | evolvability | развиваемость | Способность системы инкрементально (а не путём полной переделки «с нуля») изменяться в самых различных аспектах (прежде всего изменения функциональности, изменения архитектурных характеристик). | 8 |
| 1. | ||||
| 2. | ||||
| 3. | ||||
| 4. | ||||
| 5. | ||||
| 6. | ||||
| 7. | ||||
| 8. | ||||
| 9. | ||||
| 10. |
Архитектурные решения
Результатом работы прикладного инженера (результатом выполнения методов концептуального и детального проектирования) будет концепция использования, а также концепция системы, а затем набор описаний системы с достаточной детальностью для изготовления (чертежи, программный код, какие-то физические модели и т.д.), плюс инженерные обоснования, для которых готовятся описания испытаний и аргументация. В итоге ожидается, что система будет успешна в части выполнения своих функций: компьютер будет считать, телефон звонить, организация выпускать продукт, сообщество развивать какую-то субкультуру.
Результатом работы архитектора (не функционального) в обеспечение приемлемых значений архитектурных характеристик (выбор которых — тоже его решение) будет набор архитектурных решений по разбивке системы на модули/конструктивные объекты и определение способов связи между модулями. Главная цель архитектора при этом — провести границу между модулями так, чтобы внутри границы связи между подмодулями были плотными (про связи внутри модуля говорят как про cohesiveness/сплочённость, а между модулями — как coupling/связанность/зацепление). Если система вся получилась несвязной/незацепленной, невзаимодействующей, то беда: эмерджентные свойства (функция системы в том числе) появляется как раз из взаимодействия частей. Нет взаимодействия — нет системы. Если вся система чрезвычайно связана, то
-
ошибка в одном модуле во время эксплуатации приводит к быстрому распространению по всей системе. Это динамическая связность, которую нужно уменьшать — но до оптимума, а не ниже.
-
изменения в одном модуле, сделанные разработчиком (время создания), приводят к необходимости изменений в другом модуле. Это статическая связность, которую нужно уменьшать — но до оптимума, а не ниже.
Например, если вы хотите повторно использовать какой-то фрагмент кода программы (в 90е годы была ценность reuse, «повторного использования», выноса за скобки любой функциональности и реализации её один раз, «отсутствие дублирования»), то неожиданно оказывается, что ошибка в этом фрагменте влияет на выполнение всей программы во всех местах его использования — скажем, в 1000 мест. А если вы занимаетесь улучшением этого фрагмента, то улучшение его исполнения для 3 случаев из этого задействования может привести к ухудшению для остальных 997 случаев изо всех 1000 (динамическая связность). А если меняете интерфейс (в архитектуре часто говорят «контракт», упирая на то, что интерфейс должен быть стабилен), так это требует изменения во всей тысяче модулей (статическая связность). Так что мы имеем тут U-образную «экономическую кривую» полезности уровня зацепления: связность в системе должна быть не слишком маленькой, но и не слишком большой. Архитектурные решения ищут оптимум, для этого проходят самые разные развилки в группировке функций по модулям.
Архитектура (хотя, конечно, речь идёт об архитектурном описании — но слово «описание» часто опускают) тем самым не сводится к каким-то структурным (то есть «разбиения на части») диаграммам, а сводится к набору архитектурных решений по прохождению архитектурных развилок (trade-offs), прежде всего:
-
какие архитектурные стили (шаблоны структуры системы, им будет в нашем руководстве посвящён отдельный подраздел) использовать («монолит», «слоёный монолит», «микроядро» и так далее), в том числе конкретная нарезка на модули верхнего уровня, соответствующих стилю для принятого решения.
-
какие принципы взаимодействия между модулями (синхронная коммуникация, асинхронная коммуникация, есть ли квитирование/подтверждения приёма запросов и т.д.), в том числе выбор архитектурного инструментария для реализации этих принципов взаимодействия (фреймворки, платформы).
Архитектурные решения предположительно ведут к успешности системы в части архитектурных интересов/характеристик (всяческих -ilities/-остей). То, что их архитектор принял не «чуйкой», а подумав, надо подтверждать обоснованиями, как и любые другие инженерные решения. В нашем руководстве есть целый раздел по инженерным обоснованиям: в момент принятия это rationale, а обоснование измерением по факту реализации (assurance) — оно делается задействованием fitness functions как «архитектурных тестов».
Лучший метод по оформлению архитектурных решений на сегодня — это форматирование их в виде записи архитектурного решения (ADR, architectural decision record, предложено Michael Nygard в 2011 году241). ADR — это документ на пару страниц текста (или экранов), имеющий примерно следующий формат (текст пишется в виде рассказа для разработчиков):
- Заголовок/title: короткое имя для принятого решения.
-
Ситуация: описывает различные соображения в части влияния на архитектурные характеристики, в том числе именно тут описываются конфликты разных системных уровней, которые требуют оптимизации.
-
Решение: что делать, чтобы достичь предположительного квазиоптимума (например, использовать какой-то архитектурный стиль или стандарт для межмодульного интерфейса)
-
Статус: это предложение, это обязательно для выполнения, это решение уже отменено каким-то другим предложением (всё меняется, в том числе архитектурные решения)
-
Последствия: что ожидается после реализации решения, в том числе «позитивные» (скажем, «производительность вырастет впятеро») и отрицательные (скажем, «вносить изменения придётся не в один, а в три разных модуля»).
Конечно, есть множество вариантов оформления ADR242, равно как и других (чаще всего более простых) форм документирования архитектурных решений. Интересное развитие тут дало распространение fitness functions в качестве формы документирования архитектурных решений по выбору важных архитектурных характеристик. Тут прямое соответствие тому, что происходило с требованиями: сначала были use cases, по которым разрабатывались требования, по которым разрабатывались тесты, а закончилось тем, что сценарии использования начали сразу писать на языке тестирования. Так и тут: решение по выбору характеристики записывается сразу в виде текста процедуры замера этой характеристики. Но вот инженерное обоснование (почему принято такое решение) будет записано всё-таки в ADR.
Про принятие архитектурных решений путём прохождения развилок (trade-offs) на примере корпоративного программного обеспечения в крупных компаниях, где требуется обеспечить высокую скорость разработки и высокую производительность (распараллеливание работы между вычислителями) говорится в книге «Software Architecture: The Hard Parts».
Вот пример архитектурного решения из этой книги, оно относится к разбивке на модули:
-
ADR: Общий сервис для назначения и маршрутизации заявок.
-
Ситуация: когда заявка создана и принята системой, она должна быть назначена эксперту и затем маршрутизирована на мобильное устройство этого эксперта. Это может быть сделано одним общим сервисом назначения заявок или отдельными сервисами назначения и маршрутизации.
-
Решение: Мы создадим один общий сервис для функций назначения и маршрутизации заявки. Заявки немедленно маршрутизируются эксплуатационному эксперту, как только они назначены, так что эти две операции тесно связаны и зависят друг от друга. Обе функции должны масштабироваться одинаково, поэтому нет никакой разницы по производительности между этими двумя сервисами, и нет никаких обратных зависимостей между этими функциями. Так как обе функции полностью зависят одна от другой, устойчивость к отказам не является поводом реализовывать их отдельно. Если эти две функции разделить, то потребуется организовывать между ними поток работ, и это даст дополнительные проблемы с производительностью, устойчивостью к отказам, а также возможные проблемы с надёжностью.
-
Следствия: Изменения алгоритма назначения (эти изменения происходят на регулярной основе) и изменения механизма маршрутизации (нечастые изменения) могут потребовать тестирования и разворачивания обеих функций, результат будет в возрастающем объёме тестирования и рисках разворачивания.
В этом примере не приведён статус, ибо это «проект из книжки» (в реальном проекте нужно указывать статус, ставить архитектурные решения под контроль конфигурации).
Все эти архитектурные решения — строго результат прохождения развилок, то есть явного выбора из нескольких альтернатив. Часть этих решений описана в архитектурных паттернах. И это решения, относящиеся главным образом к связям между модулями. Эти связи и сами решения оказываются вовсе неочевидны.
Вот пример: кто должен проверять поступающее на вход модуля сырьё? Скажем, кто должен проверять, что Вася не засунул в мясорубку гвозди? Варианты:
-
Проверок нет вообще
-
Вася ответственный за то, чтобы в мясорубку гвозди не засовывать (и даже мясо чтобы было не гнилое)
-
Мясорубка имеет входной контроль (и на гвозди, и на мясо, и на попытки работы без сырья вообще)
-
И Вася, и мясорубка проверяют: один что кладёт, вторая --- что ей дали
Оказывается, в общем случае выгодно, чтобы проверок не было: это быстрее и дешевле всего, при этом такое можно сделать, если Вася и мясорубка срощены между собой, и это один модуль. Очевидно, что в данном случае так сделать нельзя.
Наиболее быстрое выполнение происходит в том случае, когда входного контроля нет, но есть жёсткий выходной контроль у Васи (ибо на вход мясорубки Вася подаёт в конечном итоге свою работу, и хорошо бы её проверять).
Если заранее непонятно, кто когда что подаёт на вход мясорубки и где её будут эксплуатировать, то выполнение контракта (контрактом/contract называют правила взаимодействия на интерфейсе с модулем, иногда это же называют протоколом) должна проверять мясорубка. В тех случаях, когда Вася тоже проверяет то, что он даёт мясорубке, возникает дублирование. Но в архитектуре есть принцип, что в большинстве случаев развязывание/расцепление/decoupling модулей важнее отсутствия дублирования.
Так как же надо? Если делаете публичный сервис, то лучше бы мониторить то, что подаётся на вход, вести логи для ловли ошибок (кто когда почему подал на вход мясорубки гвозди: это не должно повториться!). Если модуль выполняет чётко определённую функцию, должен работать сверхбыстро, то проверки входных объектов для обработки (сырья, информации) в нём не должно быть, это дорого. Но выходные проверки лучше бы делать. Ну, или добиваться такой работы, чтобы выходные проверки были не нужны «по определению», но такое придётся доказывать (писать обоснования).
Пример: в Tesla на заводе agile производство устроено так, что каждый автомобиль собирается в уникальной конфигурации, ибо отдельные производственные участки часто дублируются, чтобы опробовать какой-нибудь новый способ производства — новый станок, новый приём работы. Старый участок работает по-старому, новый — по-новому. Через новый участок отправлятся часть деталей или подсборок, чтобы «попробовать». В случае успеха старый участок закрывается и все полуфабрикаты дальше идут через новый участок. В случае неуспеха — экспериментальный участок закрывается, продолжает работать старый участок.
Конечно, все эти производственные участки имеют выходной контроль — и старые, и новые экспериментальные. Но поскольку экспериментальный участок новый и не слишком отлажен, то этот его выходной контроль тоже новый, может не суметь проверить что-то важное. Поэтому на Tesla принято решение по связи между производственными участками/модулями: все участки (и старые, и новые) обязаны иметь и входной контроль (чтобы отлавливать возможные проблемы с деталями, пришедшими с новых плохо отлаженных участков) и выходной контроль (чтобы у следующих за ними участков не было проблем с негодными деталями).
Однозначного ответа «как надо» в архитектурных выборах нет, всё зависит от вашего проекта, и даже конкретной ситуации в вашем проекте (сегодня оптимальный ответ будет один, а через год в этой же системе ответ будет другим — и придётся всё переделывать. Это нормально, это и есть развитие/evolving системы и её архитектуры).
Решение о том, в каком модуле делать проверки — архитектурное решение, оно по факту не относится к целевой функциональности, оно относится к модульному синтезу для функциональности «проверка». Рассуждения примерно одинаковы, идёт ли речь о Васе и мясорубке, или программе искусственного интеллекта, вызывающей модуль определения кошки и дающей не ожидаемую этим модулем фотографию с потенциальной на ней кошкой, а текст со словом «кошка», в надежде, что этот модуль эту «кошку» найдёт (как Вася надеется, что мясорубка сделает из гвоздей гвоздяной фарш, ибо ему сказали, что «желудки этих людей даже гвозди переварят!», и он просто хотел проверить, так ли это). Архитекторов тренируют на подобного сорта рассуждения: развязывание/расцепление против дублирования (и предупреждают, что дублирование часто лучше!).
Понятие межмодульной связи довольно сложное, и это один из основных объектов, с которым работает архитектор. У вас радиотехническое устройство. Правильно ли будет, если вы все резисторы поместите на одну плату, конденсаторы на другую плату, катушки::модуль индуктивности::функция на третью плату? Заметим, что в предприятии более чем часто делают «отдел со всеми программистами», «отдел со всеми юристами», и хорошо, что не делают «отдел со всеми менеджерами» (рассуждение по той же линии: «они все там одного типа, с одним образованием, пусть сидят вместе»). Это ведь ровно такой же архитектурный вопрос, архитектура-то универсальное понятие для всех типов систем — архитектура радиотехнического устройства и архитектура предприятия по факту требуют одинакового архитектурного мышления.
Или на одной плате должен быть «усилитель высокой частоты», а на другой плате «усилитель низкой частоты» и все резисторы-конденсаторы-катушки индуктивности должны быть там? Или нужно преодолеть огромные трудности и сделать всё на одной гигантской плате, но это «объединение в один модуль» потребует перестройки всего производства? Такой путь, например, был выбран в попытке сделать один чип на 4 триллиона транзисторов (третье поколение чипов Cerebras243): целью было получить максимальную производительность, и отчасти это даже удалось, но пришлось решать множество нестандартных проблем, типа отвести 3.5КВт тепла с площади чипа размером примерно с листок А4244.
Прохождение архитектурных развилок
При прохождении архитектурных развилок (architectural trade-offs) между разными архитектурными решениями используются эвристики, известные как архитектурные паттерны/шаблоны. Эти паттерны на сегодня являются основными способами передачи архитектурного опыта между архитекторами. Принятие согласованных между собой наборов отдельных чётко сформулированных решений, которые делаются в той или иной ситуации делается в виде набора паттернов, который называется языком паттернов/шаблонов. Использование языков паттернов впервые предложил в строительной архитектуре Кристофер Александер с коллегами в 1977 году245. Дальше это было подхвачено программными архитекторами, расцвет использования языков паттернов случился в нулевые годы 21 века. Предлагались самые разные языки паттернов, включая паттерны свободного программного обеспечения246 и организационные паттерны247, но постепенно в организационной архитектуре были приняты другие способы организации знания (методы стали передаваться через разнообразные варианты корпусов знаний/body of knowledge, в которых преобладал «процессный подход»), а вот в программной архитектуре такой подход остался248.
Паттерны — это какие-то шаблонные/типовые решения, ведущие систему к успеху путём снятия противоречий в типовой ситуации. Эти противоречия обсуждаются как forces/drivers/соображения. Основное, что отличает языки паттернов от других способов моделирования решений, так это особое внимание к процедуре прохождения развилок в решениях: явно обсуждается конфликт каких-то характеристик (в случае архитектурных паттернов это архитектурные характеристики, например, конфликт между скоростью работы монолитного модуля и скоростью внесения в него изменений). Паттернов для какой-то предметной области существует много, и они уподобляются словам в языке: при помощи их можно принимать цепочки тесно связанных решений, как строить предложения в словах какого-то языка. Отсюда и название «язык паттернов».
Главное отличие разных языков паттернов/шаблонов (pattern languages) от разных корпусов знаний (body of knowledge)249 и процессных стандартов (process standard)250 описаний методов (типа ISO 15288 для методов системной инженерии киберфизических систем, или ISO 12207 для методов программной инженерии) то, что они предполагают объяснения в своём составе, а не просто говорят «делай вот такие действия», причём эти объяснения прямо исходят из идей системного творчества (поиск решения через выход на противоречия описан в подразделе по системному творчеству руководства по системному мышлению).
В книге «Fundamentals of Software Architecture» первым законом архитектуры предлагается «в архитектуре все решения являются результатом прохождения развилок», но вот второй закон — это ««почему» в архитектуре важнее «как»». Архитектурные паттерны как раз выполняют этот второй закон: они дают в своих описаниях «почему». Описание паттерна представляет собой несколько страниц структурированного текста, в котором могут встречаться (часто не все) разделы:
-
Имя паттерна — короткое название, которое будет использоваться в речи, типа «архитектура, центрированная на данных» (data-centric architecture, паттерн 1 в работе «Patterns for Light-Weight Fault Tolerance and Decoupled Design in Distributed Control Systems»251).
-
Тип (классификация паттернов в языке как наборе паттернов, место в таксономии. Скажем, в оригинальном языке паттернов строительной архитектуры Кристофера Александера всего 253 паттерна, поэтому они разбиты на группы, соответствующие масштабу: города, здания, строительство).
-
Этот паттерн так же известен как (синоним имени).
-
Ситуация/context — описание ситуации, в которой нужно применять паттерн.
-
Проблема — по возможности сформулированная как противоречие проблема, которую призван решить паттерн. Например, «если выключится произвольный один блок, система должна продолжать работать».
-
Соображения/влияния/силы/forces — рассуждения (по-русски иногда говорят «расклады»), которые необходимо принять во внимание, когда выбираешь предлагаемое паттерном решение проблемы. Если это архитектурный паттерн, то именно тут говорится о том, куда решение паттерна двигает архитектурные характеристики (надёжность, масштабируемость, ремонтопригодность, развиваемость и т.д.). Обычно все эти характеристики двигаются разнонаправленно: что-то улучшается, что-то ухудшается.
-
Решение — что, собственно, нужно сделать.
-
Формальное обоснование — использование какого-то стандарта инженерных обоснований для обоснования предлагаемого решения, подробней это обсуждается в нашем руководстве в разделе по инженерным обоснованиям. Например, популярно использование языка GSN (goal structured notation), а в паттернах защиты/security могут использовать «модели целей» STRIDE. Чаще всего формальные обоснования требуют в паттернах решений для безопасности и защиты, ибо формализация дорогая, но в части безопасности на цену обращают внимания мало, «не хочешь сидеть в тюрьме — плати».
-
Последствия — тут важно, что обсуждаются как позитивные, так и негативные последствия применения паттерна (помним, что паттерн помогает пройти развилку, это решение для trade-off, и чем-то приходится жертвовать ради чего-то более важного).
-
Общий сценарий — часто приводят как часть, по которой дальше делается формальное обоснование.
-
Известные использования — если это и впрямь «паттерн» (шаблон), то он был выявлен как успешное повторение какого-то решения. Где этот паттерн оказался успешен? Или это не паттерн, а просто только что в первый раз придумали, и никто ещё этот «паттерн» не использовал?
-
Литература по прежним работам с паттерном.
-
Добавляют часто также варианты паттерна (если они не различаются настолько, чтобы делать отдельный паттерн) и связанные паттерны (в рамках языка и из других языков паттернов).
Не всегда описание паттерна именно «структурированный текст» с указанными разделами, хотя в разных сборниках паттернов используется ровно вот такой вид. Но в современной литературе от структурированного представления по большей части ушли, и используют не «букву», а «дух» работы с паттернами. Скажем, глава «5. Component-Based Decomposition Patterns» книги «Software Architecture: The Hard Parts» приводит язык паттернов с шестью паттернами. Эти паттерны даны как более-менее связный рассказ, в котором присутствуют все важные для описания каждого паттерна разделы, но эта структура описания не выделена в тексте, и текст ей следует не слишком строго.
Во многих архитектурных статьях, постах в блогах упоминаются «паттерны», часто говорится о каких-то forces (и они почему-то оказываются архитектурными характеристиками, но не всегда). Когда вы встречаете эти упоминания, вы должны знать: они связаны с организацией мышления архитекторов в форме паттернов, а терминология и стиль архитектурного мышления «паттернами» идёт ещё от строительной архитектуры, из книжки Кристофера Александера с коллегами, из далёкого 1977 года.
Какое отношение у разных людей к использованию архитектурных паттернов для прохождения развилок? Конечно, разное! И тут два возражения, первое из которых — формат представления паттерна как форма записи архитектурного знания.
Как и любое другое решение в инженерии, использование паттернов конкурирует с другими способами описания деятельности. По большому счёту, языки паттернов должны быть описаны в руководстве по методологии. В архитектуре (прежде всего программной архитектуре) они закрепились именно за счёт того, что много внимания уделялось достижению трудноуловимых архитектурных характеристик, которые Кристофер Александер в строительной архитектуре называл «целостностью» или даже «жизнью»: то, что невозможно было выразить простыми указаниями на функциональность, но это был 1977 год! За это время стало понятно, что эти самые forces/расклады могут быть чётко определены и даже измерены как архитектурные предметы интереса, и архитектурные решения ищут оптимум для значений этих характеристик. Паттерны с их попытками не просто сказать, «что делаем», но и «почему делаем» сыграли тут большую роль. Выкиньте всё, связанное с обоснованиями и объяснениями — и вы получите упрощённый вариант, процессные стандарты и body of knowledge. OMG Essence как раз один из таких стандартов: он говорит, как описывать метод, но в этом описании нет места для «почему так» и «чего хотелось бы, и что в этом друг другу противоречит», и «чего мы при этом добьёмся». Конечно, языки паттернов — это более трудоёмкая форма документирования методологического знания!
Второе возражение касается не формы, а содержания: языки паттернов в архитектуре предлагают готовые варианты решений, которые можно использовать в каких-то проектных ситуациях, но не все согласны, что использование готовых решений — хороший способ вести архитектурную работу.
Основная цель, для которой создавались языки паттернов — это документирование опыта собственной работы, а также обучение коллег лучшим методам достижения нужных архитектурных характеристик. Поэтому опытные люди, которым не нужно никого учить, и которые не нуждаются в обучении сами, и которые не признают полезности «мышления письмом» для улучшения собственной работы, в языках паттернов не нуждаются. Их мнение тоже широко представлено, они паттерны критикуют (хотя часто они критикуют и процессные стандарты, и body of knowledge, и даже учебники!). Их тезис: «все эти ваши шаблоны только стесняют творчество, это просто способ зарабатывать деньги для тех, кто эти шаблоны пишет!». В руководстве по системному мышлению об этом говорится как аргументе против «рельсов мышления»: призыв изобретать велосипед каждый раз заново приводит к тому, что мы постоянно имеем дело не с самыми современными велосипедами, а с теми первыми неуклюжими велосипедами, которые делали первые изобретатели велосипедов, ибо современные изобретатели велосипедов нельзя считать, что умней и опытней предыдущих. Конечно, лет через двадцать это будут уже очень неплохие велосипеды, но денег инвесторов и нервов покупателей жалко.
Поэтому предлагается паттерны из опубликованных уже языков паттернов использовать как минимум для обучения, получения кругозора в том, что встречается в жизни (в нашем случае встречается в архитектуре, но в общем случае — в каких бы то ни было методах, для которых был сделан какой-то язык паттернов как способ описать метод). И дальше уже изобретаем велосипеды, но хотя бы что-то уже знаем из учебного материала с языком паттернов. Это решает противоречие: «изобретать паттерны по ходу дела» (вместо «использовать накопленное знание в проекте») и «использовать накопленное знание в обучении».
Во всех учебниках по паттернам (а также во всех других вариантах описания методов: процессных стандартах, корпусах знаний и т.д.) предупреждается, что паттерны из предложенного их языка нужно обязательно адаптировать к конкретному проекту. Для адаптации нужно понимать, как устроены паттерны, как описывается деятельность — это означает, что для адаптации архитектурных паттернов нужно быть «немножко методологом», использовать фундаментальное знание об описании методов работы. И тогда паттерны «из книжки» будут адаптированы к проекту, или даже придуманы новые паттерны (которые в этот момент будут не паттернами, а просто архитектурными решениями). Прямое задействование паттернов «из учебника архитектуры» обычно в проекте не поощряется.
Итого: прохождение архитектурных развилок (trade-offs) сводится к принятию решений в соответствии с какими-то паттернами этих решений, но всегда есть возможность породить какую-то альтернативу, задействовать другой паттерн, или даже сделать архитектурное изобретение, которое потом станет новым архитектурным паттерном.
Языки паттернов развиваются со временем. Так, в программной архитектуре лучшим методом было использование «шестиугольной архитектуры»252, предложенной Alistair Cockburn, часто называемой «порты и адаптеры». Делались модули, которые со всеми внешними сервисами разговаривали через определённые порты, к которым изготавливались адаптеры/коннекторы, чтобы изолировать структуру модуля от изменений в окружении (нужно тогда только немного изменить адаптер, но не сам модуль). Всё это хорошо работало, но база данных тоже была «через адаптер» — и когда менялась структура данных, всё равно нужно было менять начинку модуля, а не только адаптер. Дальше этот паттерн стал паттерном «мотоцикла с коляской»: базу данных втащили внутрь модуля, ибо «зацепление/coupling хуже дублирования», а «мотоцикл с коляской» тут оттого, что сам модуль стали делить на предметную/domain часть и инфраструктурную (коммуникация, мониторинг и т.д.) техническую часть. Базу данных сдублировали в разных модулях, и отдельно организовали синхронизацию содержания этих баз данных. Это решение (паттерн «мотоцикл с коляской») оказался чуть сложней, чем «порты и адаптеры», но лёг в основу движения микросервисов253, которое существенно повлияло на архитектуру корпоративных приложений.
Если не понимать, какие там forces/расклады стоят за этими сдвигами в архитектурных паттернах, и почему так, а не иначе, можно очень криво реализовать современную микросервисную архитектуру или очень криво выбрать микросервисную архитектуру «потому что модно» в ситуации, когда этого лучше бы не делать. Поэтому книги архитекторов подробно рассказывают не только о паттернах, но и обсуждают их появление, знакомство с этой литературой и будет специализированным прикладным обучением архитектора.
Задания
Поставьте отметку о выполнении.
- Написан пост с описанием какого-то метода вашей работы с использованием формата языка паттернов, взятого из примера архитектурного паттерна (в руководстве приведено 13 возможных разделов описания паттерна, вами использовано не менее 8 из них).
Архитектурные стили
Одним из видов архитектурных паттернов являются архитектурные стили: это общий способ организации взаимодействия модулей в системе. Архитектурные стили непрерывно развиваются, выбор архитектурного стиля — очень сложное архитектурное решение, оно делается одним из первых, а потом постоянно уточняется (да, смена предпочтительного архитектурного стиля, например, монолитного на какие-нибудь «сервисы», в ходе жизни системы вполне может быть, и даже не один раз). Так, в программировании корпоративных приложений можно выделить вот такие основные стили (и множество гибридных, и множество появляющихся каждый год новых вариантов):
-
Слоистые (layered, «слоёные»): все модули бьются на слои, которые формулируются в терминах разработчиков, а не терминах предметной области. Скажем, весь ввод-вывод для пользователя делается презентационным/presentation слоем, вся предметная функциональность в слое «организационной логики» (business logic), вся конвертация данных из объектного формата в реляционный в слое «постоянного хранения» (persistence), а собственно хранение данных в базе данных как отдельном слое. Обсуждается в такой архитектуре «видимость», хотя само понятие «слоя» бралось из функциональной архитектуры (мы обсуждали в разделе проектирования слоёные архитектуры, они там давались именно как функциональные, но в архитектурных стилях это обсуждалось уже как «сгруппируем реализацию функционального слоя в модули одного модульного слоя»): нельзя модулю из презентационного слоя писать прямо в базу данных, даже если это быстро! Это хоть как-то ограничивает связность, предотвращает появление «большого кома грязи»/«big ball of mud» как архитектурного стиля, где «всё связано со всем, пошевелить ничего нельзя». Это самая дешёвая и простая архитектура, только беда: если нужно внести какую-то новую функциональность, то потребуется вносить изменения в каждый слой. Если каждым слоем занимаются отдельные программисты (это общий закон: в модульной структуре отдельными модулями занимаются отдельные команды, играет закон Конвея и обратный манёвр Конвея), то это потребует согласования действий множества людей, что медленно (люди будут ждать друг друга, чтобы сделать изменения) и наверняка будет вносить ошибки (не смогут точно договориться, что же где надо для чего изменить). Поэтому от таких архитектур стараются отказаться при первой же возможности, но «так уж получается, что у нас архитектура именно такая»: на саму архитектуру уходит практически ноль усилий на поддержание, она очень удобна для быстрого старта разработки!
-
Конвейеры (pipeline, «трубопроводы»): все модули представляются как «обработчики» и «фильтры», выходы одних подаются на входы других. В операционных системах есть «оболочки» (shell), которые позволяют «скриптовать», то есть прописывать вот такие «конвейеры» из разных программ-утилит. Это очень мощная архитектура! Но и тут проблемы: работы конвейера плохо распараллеливаются, производительность конвейера определяется производительностью самого медленного звена и числом звеньев (скажем, если задержка на передачу данных между модулями через сеть в конвейере 300мс, то пять модулей — и вы «изниоткуда» получаете 1.5 секунд задержки), масштабируемость при этом минимальна.
-
Микроядерная/microkernel архитектура представляет собой «основной блок» (ядро, core) и многочисленные к нему плагины/plug-ins, которые делают те или иные обработки. Это уже сильный прогресс: если хочется поддержать какую-то особую функцию, то можно сделать плагин, и не трогать всей остальной системы. Разработчики плагина могут считать себя отдельными. Но масштабируемость будет определяться одним модулем: микроядром, а не плагинами, поэтому эта архитектура тоже не решает всех проблем. Скажем, в компьютере у вас ровно такая архитектура, «plug-and-play», вы можете подключить дополнительный экран, проектор, мышь, принтер, сканер и т.д. — но всё-таки основные возможности развития совокупной системы будут ограничиваться самим компьютером, подключение разной периферии к нему удобно, но не гарантирует удобства развития самого компьютера. Когда такая архитектура была предложена как основная для операционной системы Windows, её слоганом стало plug-and-play (воткни устройство и играй), но все грустно шутили про plug-and-pray (воткни устройство, и молись, что заработает). В первые несколько лет так и было, всё работало очень ненадёжно. Но сейчас всё работает надёжно, и даже сам принцип plug-and-play не воспринимается как радикальный и новый, его просто забыли, «метанойя, не помним, как оно было до появления этой микроядерной архитектуры».
-
Сервис-ориентированная архитектура (SOA, service-oriented architecture) включает множество независимых сервисов, которые сами обслуживают в себе все «слои», но обращаются к одной базе данных, чтобы синхронизировать свои операции над ней. И у неё тоже есть недостатки: одна база данных даёт сильные зависимости, особенно концепция «транзакции» в этой базе данных: если какой-то модуль «подвис», то он может «подвесить» и базу данных, система с сервис-ориентированной архитектурой в этом плане ненадёжна. Не путаем: в наших руководствах «сервисом» называют внешнее поведение какого-то сервера/службы по изменению чего-то в окружении сервера, а в программной архитектуре так будут называть и сервис, и сервер, не особо их различая (грубо говоря, путая бег и бегуна, «сервис оказывает сервис»).
-
Микросервисная (microservices) архитектура — это развитие сервис-ориентированной архитектуры, просто база данных у каждого модуля (они тут называются «микросервисы») своя. Это обеспечивает слабую связанность, но требует повышенного внимания к синхронизации работы: все трансакции нужно программировать вручную. Возникают интересные паттерны, типа «Смыв сбоя»: если где-то в середине трансакции обнаружилась ошибка, то не нужно пытаться исправить её (это очень дорого!), нужно просто выкинуть обработку кейса, сбросив тем самым сложное сочетание состояний разных микросервисов в ходе обработки кейса. Микросервисы нарезаются по принципу «один микросервис-модуль — одна пользовательская функция/метод, она же bounded context, она же workflow/кейс как работа, выполняемая человеком и компьютером». И разрабатывает микросервисы одна команда. Управление микросервисами выполняет оркестратор, специальный модуль, отвечающий за правильность назначения прикладных микросервисов на работы по обслуживанию пользовательских кейсов (как дирижёр в оркестре, отсюда название). Есть вариант и «без оркестратора», это называется хореография (как в танце, когда дирижёра нет, а все просто прилаживаются к движениям друг друга). Это всё сложно, очень сложно, в таких архитектурах много неудач: если делать микросервисы слишком мелкими, это приводит к «распределённому большому кому грязи», что много хуже (например, медленней и запутанней в плане внесения изменений) монолитного «большого кома грязи», где все связаны со всеми, но не через сеть (микросервисы связаны через компьютерную сеть). Но зато масштабирование и производительность, а также развиваемость на таких архитектурах могут достигать таких значений, которых нельзя получить в других архитектурах.
Есть и много других видов архитектур: «пространственная», «управляемая событиями».
Подробней об архитектурных стилях можно узнать в книгах «Fundamentals of Software Architecture» и «Software Architecture: The Hard Parts», которые мы уже вам рекомендовали, если вы занимаетесь разработкой программного обеспечения. Но мы настоятельно советуем читать книги из раздела (в том порядке, в котором мы их давали в этом разделе, приводили их обложки) и в том случае, если вы занимаетесь разработкой систем другой природы, а также если вы даже не выполняете роль архитектора — но ведь вы наверняка будете общаться с архитекторами, поэтому должны понимать, что у них в головах. В этих книгах как раз фронтир сегодняшней архитектурной мысли, оттуда архитектурные паттерны потихоньку будут использоваться в проектах создания и развития систем самой разной природы, а не только программных систем.
Архитектурные стили непосредственно влияют на то, как архитектор разбивает проект на так называемые архитектурные кванты (quanta, единственное число quantum, это латынь), по-другому называемые самыми разными терминами: сборки, компоненты и т.д. Это такие наборы модулей, которые имеют общий ввод в эксплуатацию (delivery) если заменять какой-то из них на другую версию, поэтому ими занимается обычно одна команда разработчиков. Скажем, замена резистора на плате не может произойти независимо от замены платы: впаянный в плату резистор вводится в эксплуатацию только в составе целой платы, куда он намертво впаян. Так что сборкой/квантом тут будет плата, а резистор — просто модулем в составе сборки.
Одно из достоинств микросервисного архитектурного стиля (часто говорят проще: «микросервисной архитектуры») является то, что база данных микросервиса находится внутри этого микросервиса, поэтому микросервисы можно вводить-выводить из эксплуатации независимо друг от друга, так что каждый из них может иметь свою команду разработчиков, которые мало зависят друг от друга. Это позволяет (за счёт усложнения архитектуры, это большой минус, учитываемый при выборе стиля) упростить разработку функциональности. Время ввода в эксплуатацию отдельных фич (time to market — от появления идеи до момента ввода в эксплуатацию, то есть доступности для использования) при микросервисной архитектуре становится существенно меньше. Но работа архитектора для микросервисной архитектуры становится сложнее, ибо нужно как-то оркестровать работу микросервисов, налаживать для них хореографию, а ещё микросервисы будут чудовищно медленны в обработке каждого запроса (обращения микросервисов друг ко другу весьма дороги по времени, это же чаще всего передача сообщений по компьютерной сети, а не вызов программы в той же оперативной памяти). Чудес не бывает: выбирается при прохождении развилок по выбору архитектурного стиля, как и при прохождении любых других развилок не лучший вариант, а наименее плохой.
Текущий раздел недаром называется «эволюционная архитектура»: вы можете начать с одного архитектурного стиля, продолжить другим, затем перейти к третьему — и всё это по ходу проекта, не прерывая эксплуатации системы.
Задания
Поставьте отметки о выполнении следующих дел:
-
Написаны посты с рецензиями на книги, представленные в текущем разделе. Обращено особое внимание в этих рецензиях на безмасштабность методов, описанных в текущем разделе: насколько они, по вашему мнению, применимы не только к программным приложениям, но к системам самой разной природы, самых разных масштабов, самых разных уровней сложности.
-
Опубликован пост с вашими мыслями о вашем опыте архитектурной работы: какие архитектурные характеристики оказались критичны для проекта, какие решения по разбивке на модули вы делали. Используйте материал текущего раздела и итоги выполнения всех заданий и упражнений.
-
Вы нашли и откомментировали не менее трёх чужих постов на тему разработки архитектуры системы.
6. Эволюционное проектирование
Проект/design и проектирование/design
Инженер-проектировщик (в машиностроении — инженер-конструктор) в большинстве случаев раньше отождествлялся с просто «разработчиком», разделения труда особого не было. Если он становился очень опытным, то его могли называть «архитектор» (в СССР это был «главный конструктор», у которого были ещё и менеджерские роли). Результат труда проектировщика — проект/design, с детальностью, достаточной для изготовления. При этом архитектура являлась частью проекта. Но время шло, и появилось разделение труда, а также усложнение понимания того, что является проектом.
Так, архитектура всегда считалась частью проекта, требования считались частью проекта, при этом в требованиях не различали собственно требования и архитектурные решения — и значительная часть архитектурной работы выполнялась при этом на этапе выявления требований, который всё-таки отличался от этапа проектирования в «водопаде», тем не менее, требования и часть архитектуры в этих требованиях входили в проект. Впрочем, там были нюансы: проектом назывался не собственно проект/design, а проектная документация — и уж туда могли «подшить» всё что угодно.
Проект постепенно приобрёл разные эпитеты, при этом концепция использования в первых каких-то вариантах могла и не быть частью проекта (в частности у атомщиков она называлась «обоснование инвестиций», и это ещё «до требований»), дальше были «требования», затем эскизный проект с совершенно недостаточной для изготовления детальностью, потом рабочий проект, «рабочка» — и вот там детальность была уже достаточная для изготовления. Но даже проектировщики были разными: скажем, эскизный проект делался верхнеуровневый для всей системы, а рабочий проект раздавался по заводам-изготовителям, ибо там вроде как лучше понимали, какая технология могла бы использоваться для изготовления — design for manufacturing (пришлось даже придумать такое словосочетание, «проектирования для изготовления», ибо более чем часто проектировали такое, что изготовить потом было нельзя). Но в строительстве в России всё было не так: строители получали от проектных институтов рабочий проект — и пытались его выполнить, уж как могли. В Европе же было как в машиностроении: ожидалось, что рабочий проекта выполнит строительная организация, а архитектурное бюро выдаст ей эскизный не слишком подробный проект — чтобы проще было использовать материалы и оборудование, доступные тем, кто строит. Даже однажды была коллизия при строительстве завода «Ангстрем Т»: немецкий подрядчик отдал «проект» российским строителям — и те обнаружили эскизный проект, ожидая рабочий. Был большой конфуз, проблему решали несколько лет.
Всё дальше сильно изменилось и в части формы, в которой существовал проект — «проектной документации». Теперь это компьютерные модели, ещё и непрерывно обновляемые, ибо водопад уходит в прошлое даже в «железе».
У программистов всё было ещё интересней: проект там всегда только более чем эскизный (и делают они его так, что он плохо отличим от функциональной верхнеуровневой архитектуры, dataflow), а рабочий проект — это программный код, он как раз прописывается с точностью, «достаточной для изготовления».
И дальше ещё было разделение труда: архитекторы перестали быть «опытными проектировщиками», у них появился свой предмет: архитектурные характеристики, архитектурные стили, архитектурные решения. В последнее время начали выделяться и функциональные проектировщики, они же методологи прикладной предметной области, функциональные архитекторы, процессные инженеры.
В менеджменте разработчики вообще никак не назывались, решения по оргпроектированию принимались «в рабочем порядке». Потом выделились «опытные разработчики», их назвали «архитекторы предприятия» — но тут было что-то не так, ибо все путали архитекторов предприятия с архитекторами айтишной инфраструктуры предприятия. И заодно появились службы качества, где были «аналитики», которые вроде как «выявляли» рабочие процессы, хотя иногда всё-таки проектировали их, но чаще — просто «рисовали», интервьюируя менеджеров. Тем не менее, всё чаще и чаще слышались призывы заниматься оргпроектированием (орг-дизайном), ибо кто-то же должен проектировать структуру подразделений!
Так что разделение труда приводило к тому, что общая деятельность по разработке проекта как-то распределялась по различным инженерным специализациям, но всё-таки проектировщики (и заодно конструкторы в машиностроении, кодировщики в информационных технологиях) никуда не делись: у проектировщиков осталось принятие решений по тому, какими конструктивными объектами-аффордансами (комплектующими, модулями, компонентами) будут выполняться роли из функциональных описаний, а также как они будут пространственно скомпонованы — и это может быть как с экскизной степенью детальности, явно недостаточной для изготовления, так и рабочей степенью детальности, достаточной для изготовления. Конечно, это в рамках ценовых и архитектурных ограничений.
И ещё всё это «разделение труда» иногда было в кавычках: речь ведь идёт об интуитивно понимаемых ролях, а в жизни работы всех этих ролей выполняли какие-нибудь «опытные инженеры» на должностях начальников секторов, начальников отделов, или просто «ведущие инженеры», от которых ожидалась универсальность, а не ролевая специализация.
Так что первое, что надо запомнить, разбираясь с ролью проектировщика: в разных ситуациях эта роль будет называться очень по-разному (тот же «конструктор»), часто вообще никак не называться, это будет просто «инженер» — сверхобобщение. К основному методу работы этой роли (принятие решений по тому, какие конструктивные объекты в какой компоновке будут играть роли — при ограничениях архитектурных, ценовых, безопасности, технологических) у какого-то агента легко будут подмешаны работы других ролей так, что выделить именно работу проектировщика в явном виде может быть затруднительно.
И даже в английском языке внимательней: проект/design и проектирование/design. И в русском тоже — проект/project и проект/design. Не запутайтесь, работайте не «по терминам», а «по значениям» — определяйте типы объектов не по их названиям, а по контексту!
Это не мешает нам дать довольно абстрактное описание метода работы проектировщика: главное, что он должен сделать — это сгенерировать идеи/изобретения (впрочем, изобретением это назовут только тогда, когда какой-нибудь набор конструктивных объектов был первый раз применён для выполнения какой-то функции), какие объекты-аффордансы (комплектующие, конструктивы) будут играть роль функциональных объектов. А дальше он должен детализировать это конструктивное описание, предоставить формы и компоновку в пространстве, проверить выполнение всех ограничений (архитектурных решений, стоимостных ограничений от визионера, технологических от инженеров внутренней платформы разработки, «завода»).
Методы генерации идей имеют долгую историю, но большинство из них имеет сравнимую эффективность, явных преимуществ нет ни у каких методов, но есть явно неудачные методы. Скажем, «метод Диснея», в котором предлагалось сначала генерировать варианты без критики, а только потом критиковать их, в экспериментах не показал никаких преимуществ перед другими методами.
В ТРИЗ обсуждается, что на каждую концепцию более высокого системного уровня для её успешной реализации требуется принять ещё 10-100 решений на уровне подсистем, и так на несколько уровней вниз, чтобы можно было наладить промышленное производство. Если вы выбрали цифровой аппарат вместо плёночного, то вам сразу придётся выбирать между типом матрицы (ПЗС или КМОП, и там ещё много разновидностей), вариантами расположения четырёх пикселей по трём цветам, вариантами организации электроники считывания, и т.д.
Дальше у проектировщика два пути:
-
Поднимать качество выдаваемых идей. Этот пример мы приводили, сравнивая IQ фон Неймана и Эйнштейна: первый был редкостным эрудитом и обладал редкой умственной производительностью по выдаче идей, отметился во многих областях науки. Второй выдал поменьше идей, но эти идеи оказались более глубоко продуманными, они существенно поменяли представления человечества о физике. Так что высокий IQ в генерации концепций необязательно помогает. И тут есть ресурсное ограничение: вы можете потратить много времени на продумывание одного потенциально хорошего решения и его доводку до приемлемого варианта, а можете это же время потратить на десяток самых разных решений — в надежде, что среди них окажется «то самое, наш выигрыш!». Как увеличить качество выдаваемых идей — это пока непонятно. Звучат общие слова об искусственном интеллекте, талантливых людях, удачливости и прочем таком, но на метод указать нельзя. В принципе, для систем искусственного интеллекта более качественная модель выдаёт сразу хорошую идею, не тратится много сил на «много раз попробовать». Кошечка не выдаст хорошей инженерной идеи, а человек выдаст — интеллект всё-таки имеет значение, сила выдвигаемой идеи имеет значение.
-
Выдавать больше простых не очень сильных идей в единицу времени, в надежде, что одна из этих простых идей подойдёт — окажется сильной. Качественность генерации, то есть сила интеллекта проектировщика (впрочем, рассуждение верно не только для проектировщика) тут отступает на второй план. Работает соображение, что если разнообразных «дешёвых» идей/концепций достаточно много, то рационально выбрать среди них «наименее плохую» и доработать её до хоть как-то приемлемой оказывается проще, чем выбирать между малым числом «дорогих» идей. Скажем, можно просто использовать кофе перед совещанием (повышает количество выдаваемых идей на 30%254), разные техники «мозгоштурма»/brainstorming, которых множество255. Если не помнить, что количество идей не равно качеству, то этот путь кажется неплохим. Но если помнить, что без подобных методик трудно выйти за пределы поиска в каком-то одном месте ментального пространства не слишком качественных концепций в другое место, где концепции могут быть получше, то и без количества обойтись нельзя, и без каких-то методик типа тризовских методов развития творческого воображения («представить ситуацию как очень маленький объект, представить как очень большой объект, представить как мир, населённый маленькими человечками», и т.д.) и поэтому же мозговой штурм стараются как-то модифицировать, чтобы захватить решения из разных областей пространства решений256. Количество идей помогает существенно поднять качество, как показывают reasoning большие языковые модели, но всё-таки в основе реального прогресса лежит качество выдаваемых решений, совсем простые генераторы решений выдают очень плохие не только идеи, но и рассуждения на их основе, reasoning не срабатывает, решения не получается.
Меметические алгоритмы зависят от того, насколько вы можете закинуть основную идею в область значимого максимума в динамическом ландшафте приспособленности. Если вы породите много-много идей, которые окажутся на склоне одного из маленьких холмиков в этом ландшафте, вы проиграете. Если силы интеллекта хватит на то, чтобы раскидать идеи достаточно далеко в этом динамическом ландшафте, чтобы увеличить вероятность их попадания на разные склоны разных максимумов — это поможет получить в итоге качественное конструкторское решение. «Конструкторское решение» тут не случайный синоним проектного решения: помним, что конструктор — это по факту синоним проектировщика, в машиностроении есть большая путаница в значениях этих слов, мы это уже говорили. Но проектное решение может быть и в части функциональной организации, а конструкторское — уж точно про структуру конструкции/модулей в увязке с играемыми ими функциями.
Тут важно понимать, что в инженерии под концепцией/«идеей решения» понимается предложение каких-то взаимосвязанных конструктивных частей-аффордансов, которые выдадут в случае задействования их в надсистеме нужную функцию, если их собрать в правильной пространственной компоновке. Так, если нужно забить гвоздь, то нужно
-
сначала проверить, зачем вообще нужно забивать гвоздь (lean, ненужную работу просто не делаем, не тратим на неё время)
-
породить альтернативы разбиения метода с сигнатурой «забить гвоздь», например, предложить разные инструменты «забивало гвоздя»: взять для забивания гвоздя а) камень, б) молоток, в) гаечный ключ, г) дядю Васю, д) микроскоп, е) … — чем больше альтернатив, тем лучше.
-
Провести trade-off studies/analysis, пройти развилку в выборе из этих альтернатив-аффордансов: камень дешёвый и вот он, молоток стоит денег и за ним полдня ходить в магазин, гаечный ключ слишком лёгкий, дядя Вася имеет молоток и работает быстро, но сейчас пьян. ОК, «наименее плохой» здесь и сейчас (важно! Не «вообще», а в нашей текущей ситуации) вариант — камень как «забивало гвоздя».
-
Дальше работаем по улучшению камня: выбираем подходящей формы, веса, прочности, пытаемся привязать ручку или нет, добавляем какую-то держалку для гвоздя, чтобы не попасть по пальцу и т.д.
Тут мы даже не коснулись компоновки, ограничений архитектора, ограничений технологов, ограничений визионеров (скажем, стоимостных). Но это всё тоже надо учесть.
Проектировочных решений в проектах огромное количество, они все тесно связаны друг с другом. Прохождение каждой развилки влечёт появление многих новых развилок, а иногда приходится под давлением фактов (мы в офисе! Камня не нашли!) возвращаться назад, и брать другой вариант: ищем что-то похожее на камень, или дожидаемся, пока дядя Вася с его молотком протрезвеет до такой степени, чтобы хотя бы сказать, где этот молоток, или даже возвращаемся к постановке проблемы — кто сказал, что функцию крепления будет выполнять гвоздь? А если использовать клей? Или болт с гайкой?
Моделирование: идеи для концепции моей системы
Приведите три примера по три альтернативы, которые вы рассматривали для концепции вашей системы. Первая — «что использовали», вторая — «что нагуглили или спросили у LLM» (использовали поиск и нашли разные варианты реализации в культуре), третья — «что изобрели» (придумали сами). Все три должны быть разными (чтобы убедиться, что выбор был как минимум из трёх вариантов). Можно указать несколько разных вариантов.
| Номер по порядку | Какая функция (можно название системы, образованное по выполняемой функции) | Какой конструкцией реализовано в проекте | Какой нагуглили или спросили у LLM | Какая идея победила (или даже изобретение, если пришлось придумывать идею самостоятельно) |
|---|---|---|---|---|
| Пример. | Опора для человека, проводящего за монитором полный рабочий день. | Игровое кресло из магазина мебели, специализировано для многочасовой работы за монитором | Generic comfort (могут позволять и лежачее положение), стул-седло (заставляет держать спину прямой, помогает при артрозе) | Стоять за монитором («работа за конторкой» — идеальная система, нет конструктивного объекта, его роль выполняет скелет), усиление идеи: беговая дорожка, чтобы даже не стоять, а всё время двигаться. |
| 1. | ||||
| 2. | ||||
| 3. |
Принятие решения: прохождение развилок (trade-offs)
Прохождение развилки по-английски будет trade-off studies, «изучение компромисса», а про «компромисс» говорят как о заведомом неуспехе: он не удовлетворяет никого из участвующих в достижении этого компромисса ролей, в то время как какие-то «бескомпромиссные» решения удовлетворяют хотя бы какие-то роли и сильно не удовлетворяют другие роли. Все компромиссы плохи, и поэтому решения в концепциях заведомо объявляются не «лучшими из имеющихся» а «наименее плохими из имеющихся».
Подробно trade-off studies на примерах архитектурной работы даётся в книге «Fundamentals of Software Architecture»:
Там формулируется первый закон программной архитектуры: «Everything in software architecture is a trade-off», то есть «всё в программной архитектуре — это результат прохождения развилок». И там же приводится следствие из этого закона: «если вы нашли что-то, что не похоже на развилку, то вы, скорее всего, просто не подумали об альтернативах».
Мы полностью согласны с этим первым законом, но его значение выходит за пределы программной архитектуры к вообще архитектурным решениям (по поводу конструкции системы, поддерживающей важные архитектурные характеристики) и далее ко всем прикладным инженерным решениям в целом, то есть ко всем решениям, которые делают не только архитекторы (которые ответственны за -ости/-ilities/архитектурные предметы интереса), но и все остальные инженерные роли (визионеры, прикладные методологи, проектировщики, технологи, инженеры внутренней производственной платформы), причём эволюционно/непрерывно, а также безмасштабно и для всех систем разной природы (и для «железа», и для личностей, и для предприятий, и для стран).
То, что мы рассматриваем прохождение развилок в работе проектировщика, а не в других разделах руководства — это просто из-за удобства изложения, подходящее место для примера. Выдвижение альтернатив, а затем выбор из них в условиях неопределённости — общие методы сильного мышления, должна проходиться в трансдисциплинарной рациональности. Тем не менее, повторим в привязке к проектированию. Каждый раз, когда вы хотите реализовать какую-то функцию (помним, что это логические шаги, разложение метода, а не строгий алгоритм. Всё это итеративно и с остановками для получения дополнительной информации):
-
Проверьте, нужна ли вообще эта функция. Для каждой функции будет затем какая-то работа. Нужно ли на неё тратить ресурсы? Попробуйте обойтись вообще без этой функции: что изменится? Будьте элегантны, lean.
-
Если нельзя отказаться, точно определите эту функцию: вы запросто можете ошибаться в постановке задачи, поэтому попробуйте формализовать, то есть помоделировать — отбросить неважное, оставить важное. В формальной постановке задачи проще находить ошибки.
- Найдите заведомо более одного варианта, каким образом конструктивно реализовать функцию (учитывая ещё и варианты размещения, и стоимость, и другие системные аспекты/перспективы основных описаний системы, но ведь есть и неосновные описания, важные для вашего проекта). Всегда помним, что идеал — это когда функция исполняется, но нет ни одной добавленной части конструкции, ибо каждая часть конструкции может выполнять множество функций. А ещё одна функция может выполняться несколькими элементами конструкции. Тут мы сразу говорим о функции/методе (иногда даже культуре!), но конструктивные части выполняют роль функциональных частей (помним, что Вася выполняет роль бегуна, а бег — поведение бегуна). Тут надо спрашивать опытных товарищей, гуглить, спрашивать AI-агентов, а иногда и делать изобретения. Генерация идей, продуктивных гипотез — тут. Если вы считаете, что есть только один вариант, то вы что-то упустили. Подумайте ещё и вспомните, погуглите, спросите AI, примените приёмы генерации идей — и сделайте изобретение.
-
Затем примите рациональное решение: пройдите развилку, выберите между альтернативами, обоснуйте выбор (приведите rationale — дальше будет рассказано про инженерные обоснования). Есть теории принятия решений в условиях неопределённости, вот это как раз оно.
-
Примите ваш рациональный выбор всерьёз: запланируйте работы (вместе с технологом), чтобы иметь ресурсы.
-
Выполните запланированные работы, потратьте ресурсы! «Политическая воля» — тут.
-
Проверьте, работоспособно ли решение: протестируйте, проведите испытания и примите решение, получилось ли (об этом тоже будет в подразделах про инженерные обоснования).
-
Убедитесь, что результатами пользуются: если не пользуются — можно было бы всё это не делать.
Это мы опять пробежались по мантре рационального стратегирования, проектирование тут один из частных случаев её применения.
Можно много и долго смотреть на разные методы, которые можно использовать для выполнения разных логических шагов этой мантры. Это всё рассуждения не собственно о системной инженерии, а о сильном мышлении. Подробней про сильное мышление рассказывается в руководстве по интеллект-стеку фундаментальных методов мышления, и если вы хотите продуктивности в инженерных ролях, вам надо когда-нибудь сосредоточиться — и познакомиться с этим руководством.
Например, в одном из шагов мантры стратегирования упоминается «рациональное решение». Принятие рационального решения базируется на какой-то формальной оценке шансов его успешности, то есть эти шансы успешности решения считаются по какой-то модели. Должны ли мы для получения лучших решений:
-
следовать эмпирицизму, то есть выводить эти модели из данных наблюдений по каким-то алгоритмам, «не сочинять», «не высказывать догадки, всё по формулам»?
-
опираться на эволюцию знаний: генерировать сильные догадки на основе больше интуиции (смутных ассоциаций) и случайности, чем каких-то формул, затем проверять, насколько они выдерживают критику логикой (возможно, вероятностно), а затем и экспериментом?
Ответ: эмпирицизм вреден, должны быть причинно-следственные объяснения, которые сформулированы контрфактически на основе догадок. Это и есть рационализм. Эмпирицизм был полезен в прошлых веках, когда эксперимент и данные наблюдений вообще игнорировались, речь шла только о рассуждениях — царила схоластика, отвязанная от физического мира логика, а то и не очень логические рассуждения («я художник, я так вижу»). Но сейчас это не SoTA в части организации познания и инженерии. Вместо него пришёл рационализм, опирающийся на реализм, признание важности физического мира — и ещё прагматизм, как поворот любых рассуждений только как ведущих в поддержку какого-то действия по изменению мира (включая изменению самой рассуждающей о мире системы). Рассуждения ради рассуждений отметаются, но рассуждения «по наитию» — не отметаются (это догадки!), хотя без проверки сначала (причинной/causal) логикой, а затем и экспериментом — не принимаются всерьёз, то есть не служат основаниями для каких-то действий в физическом мире.
В хорошей книге «Modern software engineering» (2022) ставится интересный вопрос о том, что программная инженерия как-то утеряла свою «инженерность», оказалась цеховым ремеслом/craft, а теперь эту инженерию надо в неё вернуть.
Сама постановка вопроса заставляет сформулировать принципы современной инженерии (задача в чём-то похожа на задачи нашего руководства). Но автор (David Farley257) выводит «опору на опыт/эксперимент», то есть эмпирицизм, в качестве основания инженерии. Это уже не SoTA, опора должна быть на теории/объяснениях, которые отбираются в том числе с использованием опыта/эксперимента. Подробно мы это разбирали в руководстве по рациональной работе. Книга всё-таки хорошая, но вот к тамошним рассуждениям о предмете инженерии по сравнению с «просто ремесленничеством» надо относиться с осторожностью: используются не SoTA представления о том, что же такое инженерия. Тамошний эмпирицизм — это прошлый век! Эйнштейн выдал свои догадки об искривлениях пространства-времени вместо сил притяжения между большими массами, не выводя их логически «по формулам». Наоборот, он предложил это, решая противоречия, которые были в расхождении вывода по имеющимся ньютоновским формулам и экспериментом. А затем на базе догадок Эйнштейна были разработаны модели физического мира (формулы для вычислений), которые легли в основу инженерии систем навигации GPS, GLONASS, Galileo. В основе инженерии систем навигации — догадка, которую не удалось прокритиковать ни логически, ни экспериментом.
Дальше в шагах мантры стратегирования (рационального выбора метода, которым будет создаваться новая система проектировщиком) ставится вопрос о выборе альтернативных инженерных решений по конструктивным частям системы в условиях заведомой неопределённости, «тумана будущего». Это как раз предмет теорий принятия решений, которых оказывается множество258:
-
Классические строго логические. Увы, не работают в реальной жизни.
-
Статистические байесовские. Часто не работают, но именно их считают сегодня «рациональными» — с этим не все согласны, ибо заведомо ведь ясно, что эти теории решений не дают оптимального результата во многих случаях! Так что их начинают считать «иррациональными».
-
Квантовоподобные. Это современные кандидаты на «рациональные» теории принятия решений, при этом решения получаются не слишком точные — но зато они формально возможны и эти вычисления экономны в силу особенностей квантовоподобной математики. Настолько экономны (экспоненциально!), что делаются гипотезы об эволюционных преимуществах таких вычислений в ходе биологической эволюции259.
Более того, нам нужны рассуждения не просто о логических (позапрошлый век), или байесовско-вероятностной (прошлый век), или квантовоподобной вероятностной (двадцать первый век) взаимосвязи одних явлений с другими «по формулам». Нет, нам нужны именно объяснения — которые находятся на третьей ступеньке лестницы причинности (ассоциации-корреляции на первой ступеньке, исчисление вмешательств, do-calculus на второй ступеньке, контрфактуальные рассуждения на третьей). При обсуждении того, как связаны решения о выборе конструктивов, которые реализуют функциональные объекты так, чтобы удовлетворить функциональным характеристикам систем самой разной природы, надо чтобы инженеры (не только проектировщики!) умели строить рассуждения с объяснениями причин и следствий — в том числе моделировать их в виде графов причинности. Как и методов моделирования (описаний самого важного!) функциональности, методов моделирования архитектурных решений, методов моделирования рационального выбора из альтернатив, которых великое множество, есть множество методов моделирования причинности. За каждым из методов стоит какое-то множество нотаций, за каждой нотацией стоит множество поддерживающих её моделеров. Вот только несколько методов моделирования причинности:
-
Деревья текущей реальности Голдратта (current reality trees)260 — часть Теории Ограничений, разработанная Eliyahu Goldratt. Они используются чаще всего для выявления узких мест в рабочих процессах, хотя метод и носит общий характер. Ключевая терминология привязана к «нежелательным эффектам» (поэтому просто применять в производственных проектах, сразу понятно, что и как делать), сам метод качественный (без количественных оценок вероятностей), граф причинности там — дерево.
-
Структурная причинная модель (SCM, structural causal model)261, разработанная Judea Pearl, выражаются направленными ациклическими графами (DAG, более общий вид графа, чем дерево, ибо у узла может быть больше одного родителя, а в дереве — только один). Такая модель причинности используется чаще всего в социальных науках, включая экономику и психологию, а также медицине и сельском хозяйстве. Этот метод количественный, он тоже очень общий, а ещё он крайне абстрактен и поэтому его чаще используют в исследовательских проектах, а не производственных/инженерных. Но у этого метода есть интересные плюсы: расчёты по нему могут подтвердить или опровергнуть какие-то гипотезы (например, гипотезы о направлении стрелки причинности в корреляции). Структурные причинные модели сегодня — это SoTA причинного моделирования262, но они довольно редко используются в инженерии, ибо их использование требует исследовательской квалификации.
-
Диаграмма причинных циклов (CLD, causal loop diagram)263 используется в системной динамике264 для визуализации обратных связей и взаимодействий в системе. Это не совсем прямое описание причин и следствий, скорее, описание множества взаимодействий, причём с лагами относительно друг друга — это моделирование изменений во времени. Применение в бизнесе (моделирование роста и уменьшения размера компаний), экономике, экологии, социальных науках. Несмотря на то, что системная динамика сама — количественный метод, CLD — качественный инструмент, помогающий понять, как переменные влияют друг на друга через обратные связи во времени265.
-
Анализ дерева отказов (FTA, fault tree analysis)266 используется в инженерии для анализа причин системных сбоев в аэрокосмической промышленности, ядерной энергетике, химической промышленности и прочих отраслях, где нужно оценивать надёжность системы. Помогает выявить потенциальные точки отказа и их последствия, улучшая надежность и безопасность систем267.
-
… множество других методов моделирования причинности, как общих (Rubin causal model268, Bayesian networks269), так и более частных, поддержанных самыми разными общими и частными нотациями выражения причинности270 вроде часто встречающихся в инженерии диаграмм Ishikawa271 и диаграмм «почему-потому» (why-because)272для выяснения причин аварий/инцидентов.
И, конечно, для типовых ситуаций (типовых инженерных решений, типовых концепций) выгодно не рассуждать, не вычислять ничего вообще, а использовать заранее известные результаты рассуждений, заранее вычисленные значения — задействовать знание из культуры, «память вместо вычислений». Но мы всё-таки советуем перед задействованием памяти проверить: не появилось ли с момента когда-то выполненных рассуждений, результаты которых вы сейчас достаёте из памяти своей или компьютера, какой-нибудь новой альтернативы или новых данных эксперимента, подтверждающих или опровергающих эти рассуждения? И задействовать результаты из памяти тогда, когда ничего нового не обнаружено (ну, или когда проверка «не появилось ли чего нового» более дорогая по ресурсам, чем возможный убыток от использования нерационально сделанного решения).
Важно, что речь идёт о достижении каких-то характеристик главным образом времени эксплуатации (хотя и времени создания тоже — вы должны проектировать для изготовления, design for manufacturing), при этом физическое моделирование доступно отнюдь не всегда. Cкажем, вы проектируете функциональную организацию предприятия, его рабочие процессы — вы, конечно, можете задействовать моделер системной динамики для этого, но это не так просто. Приходится задействовать самые разные способы указания на то, что «вот такие причины в функциональной организации системы при условии того, что аффордансы подобраны правильно, ведут к вот таким следствиям».
Надо ещё и делать так, чтобы результаты работы системы (и результаты работы производственной платформы при изготовлении, design for manufacturing) можно было измерить, чтобы потом проверить — правда ли, что система (и её производственная платформа) имеет характеристики, которые были запланированны для неё функциональными проектировщиками и одобрены визионерами. Тут вспоминаем книгу Douglas W. Hubbard «How to Measure Anything»»273, которая рассказывает, как измерить даже то, что трудно замерить физическими измерительными приборами (intangibles в бизнесе, причём понимаемые много шире бухгалтерских «нематериальных активов» вроде патентов и трейдмарок, как всё, что позволяет лучше принимать решения): удовлетворение пользователей, организационная гибкость, снятая неопределённость технологического риска, атмосфера в коллективе (employee morale).
И последнее важное замечание: в инженерии принято говорить о компромиссах (trade-offs), «решениях, которые никого не устраивают». Да, это базовый вариант инженерного рассуждения. Но иногда бывает, что вы предлагаете способ решения противоречия, способ решения конфликта — часто для этого надо предложить новую концептуализацию, в которой этого конфликта нет. Это открытия/discoveries, изобретения/inventions. Это много, много лучше компромисса274. Не упускайте такую возможность, но и не расстраивайтесь, если вам это не удалось сделать.
Системное проектирование
Концептуальное проектирование раньше называлось архитектурным проектированием, но сейчас архитектурное проектирование стало относиться не столько к проектированию поддержки конструкцией функции системы, сколько к проектированию поддержки конструкцией архитектурных интересов (масштабируемость, ремонтопригодность, развиваемость/evolvability и т.д.), хотя до сих пор разработчиков функциональной организации системы тоже могут назвать функциональными архитекторами. Но когда мы говорим о «концепции», то имеем в виду учёт и функциональной организации, и структуры конструкции.
Концепция использования по факту — концептуальное проектирование вверх от границы системы, отвечает на вопрос «как система выполняет свою функцию в надсистеме, какие там взаимодействия с окружением, каково конструктивное вхождение в надсистему», описание чёрного ящика системы, но прозрачного ящика системного окружения. Концептуальное проектирование — оно про «прозрачный ящик», включает в себя синтез (или декомпозицию, помним, что читать иерархии можно двумя способами) основных системных описаний для будущей системы.
Проектирование до уровня детальности, достаточного для изготовления, иногда называют системное проектирования (system design). Этот метод работы инженера отличается в машиностроении использованием САПР для подготовки 3D-модели изделия, в программной инженерии — использованием IDE для написания кода программы. Концептуальное проектирование работает с верхнеуровневыми объектами самых разных системных разбиений (функционального, конструктивного, размещений, стоимостного, и так далее), системное проектирование идёт «до дна».
Ещё раз напомним приводимую в руководстве по системному мышлению картинку из стандарта IEC 81346-1:2022. Она приводилась там для демонстрации сути архитектурной работы, но современное понимание её такое, что она показывают работу проектирования:
Формально эта диаграмма читалась так, что проводилась функциональная декомпозиция системы А (жёлтенькая грань кубика, функциональный аспект) сверху вниз, а потом осуществлялся снизу вверх модульный синтез, в ходе которого учитывались потом и другие аспекты системного описания: обязательные (размещение, стоимость, идеи по поводу разбиения работ как кандидат в обязательные), и далее все остальные нужные для проекта — получали тот же набор функций системы, но уже с понятной поддержкой конструкцией.
Сегодня так уже не считают, работа ведётся итеративно, «изнутри наружу», начиная с того, что функции определяют в ходе непрерывного/эволюционного проектирования не как «общий набор функций», а асинхронно — появление новых функций и исключение уже реализованных функций обсуждается даже после того, как какие-то версии системы изготовлены и начали эксплуатироваться. То же самое — с частями конструкции. Заменить модуль одного изготовителя на более совершенный (например, более лёгкий, более мощный, более быстрый) другого изготовителя — это тоже делается тогда, когда становится можно, а не в предписанный водопадным инженерным процессом момент времени. Более того, переход от концептуального верхнеуровневого проектирования к рабочему проектированию — он тоже не единомоментен, граница там тоже размыта.
В системной инженерии по факту сегодня различают тесно переплетённые:
-
Функциональное проектирование — определение функциональной организации системы для выполнения какой-то функции. Функций у системы обычно много. Функциональное проектирование выполняет обычно много команд, ведущая роль — прикладной методолог, процессный инженер, функциональный проектировщик/designer.
-
Архитектурное проектирование — структура конструкции, удовлетворяющая архитектурным интересам (приемлемым значениям архитектурных характеристик). Указываются крупные модули верхнего уровня, куда надо упаковать исполнение большинства функций. Архитектурное проектирование выполняет обычно одна команда архитекторов — для всех остальных «функциональных» команд. Ведущая роль — архитектор (в современном понимании, а не «опытный разработчик»).
-
Концептуальное, а затем и рабочее проектирование конструкции (подбор аффордансов, известных из культуры, или даже изобретение: что вообще из предметов окружающего мира в их взаимодействии сможет выполнить желаемую функцию в надежде на успешность). Этим занимается каждая команда, пытающаяся реализовать нужную функциональность. Ведущая роль — проектировщик/designer.
-
Отслеживание интересов бизнеса (business case, чтобы разработка системы и новых фич могла окупить инвестиции в них). Это тоже обычно на уровне всего проекта, ведущая роль — визионер («продакт» из «продакт-менеджер», иногда product owner).
-
Отслеживание технологии — в каждой команде должен быть design for manufacturing, то есть должна отслеживаться возможность изготовления системы на внутренней платформе разработки (производственной платформе, «заводе», «конвейере»). Ведущая роль — технолог.
-
Эксплуатация, согласно слогану «you build it, you run it!». Ведущая роль — оператор системы (а не пользователь — пользователь пользуется. Вспомните о роли системного администратора вашей компьютерной системы, вспомните о механике, обслуживающем самолёты в аэропорту, о системном операторе энергосистемы страны).
-
Инженерия внутренней платформы разработки, занимается технологиями/методами разработки и изготовления, включая инструментарий их поддержки (САПР в конструкторском бюро, станки на заводе). «Инженер внутренней платформы разработки» — это роль, но иногда это три человека в службе DevOps, а иногда это огромная организация, строящая и поддерживающая огромный завод (например, конструкторское бюро и завод, выпускающий ракеты).
-
Менеджмент, хотя формально это уже вроде и не инженерия — но всех этих людей, выполняющих инженерные роли, надо организовать в сотрудничающие команды, а также планировать их работу и отслеживать выполнение планов. Это подробней будем рассматривать не в нашем руководстве по системной инженерии, а в руководстве по системному менеджменту. Но вот вторая половинка product manager — это операционный менеджер, одна из многочисленных менеджерских ролей.
Все эти методы работы тесно переплетены друг с другом в итеративном (ритм во времени) и рекурсивном (повтор методов по функциональной и модульной иерархиям прежде всего) ходе разработки.
Так, невозможно чётко разделить концептуальное проектирование (делают разработчики/developers, обычно они работают в каждой команде) и архитектурное проектирование (делают архитекторы/architects, обычно они внешние по отношению к командам разработчиков, тем более что команд разработчиков целой системы обычно несколько и архитектор должен как-то заботиться об их максимальной независимости). Невозможно также сказать, что «всё, концептуальное проектирование закончилось, теперь идёт рабочее», невозможно даже сказать «концепция использования готова, теперь займёмся концепцией системы» — если не заниматься концепцией системы в ходе разработки концепции использования, то большая вероятность, что получится утопичная концепция использования. Но ведь даже если сознательно оттягивать по возможности разработку концепции системы (рекомендуется!), то в ходе разработки концепции системы ведь всё равно будет дорабатываться и перерабатываться концепция использования — всё переплетено. Как музыканты в джазе: каждый играет свою импровизацию, посматривая на партнёров в джазовом ансамбле, каждый использует свои инструменты, вместе получается музыка — и это импровизирование может длиться довольно долго, это не «один поиграл, а затем другой поиграл» (хотя может встретиться и такой фрагмент).
Терминология в обсуждении ролей инженера и рабочих процессов в разложении инженерного процесса путанная, но это обычно: прикладного методолога, проектировщика, технолога и даже оператора уже готовой системы называют «разработчики» без особого погружения в местное разделение труда членов команды разработчиков. А вот остающиеся за пределами команд архитекторы, визионеры и инженеры платформы разработки — они обычно идут все под своими именами (но и тут надо быть внимательными: должности и роли различаются. Product manager наполовину исполняет роль визионера, наполовину — роль операционного менеджера, планирует работы и проверяет их выполнение).
Вот как это деление на разработчиков и архитекторов изображает немного доработанная картинка из книги «Fundamentals of Software Architecture»:
Это, конечно, картинка для программной инженерии (книга-то об архитектуре программных систем), причём для самой распространённой парадигмы программирования: объектно-ориентированной (показан Class design, но не во всех проектах программной инженерии проектирование/design делается для классов), а ещё среди артефактов указан исходный код — это уже рабочее проектирование, а не концептуальное. Подставьте в эту картинку других прикладных инженеров, например, конструкторов. Тогда вы увидите детали сложной формы, соблюдение каких-то стандартов в размерах (для упрощения изготовления и сборки), информационные модели 3D в CAD — в инженерии это обычно проектирование/design, и новизна в том, что архитектурная работа раньше была внутри проектирования, а теперь она вынесена наружу, за пределы каждой проектной команды.
Идея картинки в том, что архитектор должен убедить/«уболтать» разработчика следовать его решениям (leadership, «уболтать» актёра-разработчика чётко выполнять роль разработчика, сотрудничая в команде и в коллективе изо всех команд), а для этого должен разъяснить разработчику, в чём суть этих решений (mentoring). Кроме этого, архитектор выполняет функцию надзора/governance над разработчиками: если уговорить разработчиков следовать архитектуре не удаётся, то «принимаются меры». Например, строптивые агенты, выполняющие роль разработчиков, просто увольняются, и это правильно: провал проекта из-за плохой архитектуры никому не нужен, а архитекторы в жизни встречаются реже, чем разработчики, разработчика проще заменить. При этом разработчик обычно цепляется за характеристики функциональности в области интересов подсистемы его команды, а архитектор — следит за архитектурными характеристиками всей системы, отслеживая результаты работы всех команд.
Эволюционный архитектор, тем не менее, внимательно следит за ходом разработки, и когда в ней появляются проблемы (беспроблемных разработок не бывает), как-то меняет свои архитектурные решения — и дальше разъясняет их командам разработчиков, обращает внимание разработчиков на причины их принятия («почему важнее, чем что»), убеждает в необходимости их выполнения для успеха системы в целом, а не только успеха какой-то фичи/функции, за срочную реализацию которой разработчик какой-то команды может получить премию.
Решения эволюционного архитектора относятся главным образом к ограничениям верхнеуровневого разбиения на модули, а вот сама идея, как реализовать функции системы на этом наборе модулей, приходит именно от разработчиков — возможно от каких-то коопераций разработчиков нескольких команд, если нужно для реализации функции задействовать несколько модулей. Хотя именно архитектор нарезает по-крупному систему на модули, саму «начинку» этих модулей из каких-то комплектующих дают разработчики.
Например, если непонятна концепция типа «электронная вакуумная лампа триод может выполнить роль логического вентиля для универсального вычислителя, делаем электронную вычислительную машину, а не пневматическую или механическую. А память будем делать на ферритовых колечках275» (в какой-то момент это было изобретением! Это сейчас всё всем понятно!), то архитектору не удастся поделить систему на модули. Скажем, блок питания, блок памяти, блок арифметически-логического устройства, или таки независимые блоки питания для ячеек обработки данных с памятью, которые собираются в многопроцессорный компьютер? Или надо сделать блок питания в каждом из блоков отдельный, а ещё отдельные блок АЛУ, блок процессорных регистров на вакуумных лампах и блок оперативной памяти на колечках? Это всё решения архитектора. Но архитектор не будет проектировать блок оперативной памяти на колечках, вряд ли он разбирается хорошо в материалах колечек, а ещё в устройстве АЛУ (арифметико-логического устройства) и даже устройстве блоков питания. Это будут делать разработчики, скорее всего в отдельных командах.
Надо отличать работу разработчиков (разбирающихся в компьютерных компонентах и принципах их работы) и архитекторов (разбирающихся в том, как сгруппировать модули между собой так, чтобы достичь оптимума архитектурных интересов). Помним, например, о законе Амдала276, что увеличение числа вычислителей для повышения скорости работы компьютера быстро съедается увеличением времени связи между отдельными вычислителями для их координации. Архитектор работает вот с этими «неожиданными» для неархитекторов эффектами от зацепления/coupling модулей при небрежном их синтезе/сборке. Разработчики же, которые думают больше об отдельных блоках/модулях/конструктах и их особенностях, могут такие неожиданности пропустить. Скажем, разработчики в 90х годах все хотели делать части системы, которые легко повторно использовать (design for reuse) — но потом выяснилось, что сам этот подход вреден архитектурно: если какая-то часть системы использована в нескольких модулях системы, то этим неявно введена зависимость этих нескольких модулей друг от друга, и нельзя быстро поменять эту часть в одном модуле, чтобы не зацепить работу нескольких других. Архитекторы нужны, чтобы такое замечать и запрещать (ну, или разрешать — но зная, какие там могут быть неприятные последствия).
Проектирование как следование архитектуре
Предполагается, что архитектор бьёт систему на части, которые как-то соответствуют предметным областям/domain, а они обычно соответствуют методам работы с объектами какой-то предметной области. В DDD — это поделить систему в соответствии с bounded contexts, предметными областями. В классической «железной» инженерии такой вопрос в явном виде обсуждается редко, но там примерно то же самое: двигателистам отдают проектирование и изготовление двигателя, а разработчикам крыльев — крылья (ибо там много особенностей в использовании композитных материалов, которые прочные, но хрупкие). На крылья и двигатель самолёт нарезает архитектор.
В DDD программисты нарезают программные системы по bounded context в предметной области поддерживаемой организации (business переводим как «организация», ибо не все организации, поддерживаемые софтом — бизнес-организации, есть и госведомства, и некоммерческие организации). Софт в DDD — модель предметной области, которую этот софт поддерживает. Принцип моделирования: каждому важному объекту предметной области соответствует объект программы. Скажем, если в организации есть «счёт» и «клиент», то и в софте поддержки этой организации должен быть и объект «счёт», и объект «клиент» (таблицы в базе данных, процедуры в языке программирования — это неважно, у вас есть средства выбрать что-то подходящее).
Но обычно всё чуть сложнее: архитектор может поделить систему на конструктивные части по иному принципу. Скажем, предметные области будут не пользовательские, а разработчиков. Например, архитектор в программной системе выделит «слой пользовательского интерфейса, слой логики, слой работы с базой данных, слой базы данных», всё это в терминах не пользователя, а разработчика — отсылки к методам создания, а не методам использования. Архитектор и сам был когда-то проектировщиком, поэтому пошёл по этому «лёгкому пути» (в современной архитектуре так не советуют делать, ибо такая слоёная архитектура рождает много лишних зависимостей между модулями»).
Другой, более современный вариант — архитектор делает «микросервис зарплаты, микросервис складского учёта, микросервис кадровой работы» в терминах предметной области/функции системы. Каждым микросервисом может заниматься отдельная команда разработчиков, она проектирует и функции этих микросервисов, а затем и конструкцию — доводя до кода. Разработчики при этом плотно общаются с внешними проектными ролями (сами, а не через «инженеров требований» или «аналитиков», никаких испорченных телефонов или «фиксированных требований», и общаются всё время проекта, а не только до момента выпуска первой версии, первого MVP). И всё это время будут дрейфовать/плыть/меняться (уточняться или наоборот, становиться абсолютно неприемлемыми и требовать кардинальной замены) концепция использования, концепция системы, в том числе архитектура в составе концепции системы.
Ещё одна книга, которая рассказывает о концепции системы как об архитектуре, и поэтому двигает рассмотрение архитектуры от чисто функциональной архитектуры к конструктивному/модульному рассмотрению как ограничений в работе проектировщика — это второе издание «The Enterprise Ontology», 2020.
В этой книге отмечается, что в предприятии можно выявить функциональные элементы и конструктивные, причём и те, и другие определяются поведенчески: первые через функции, вторые через трансакции, проходящие между оргзвеньями фирмы, а также оргзвеньями фирмы и внешними предприятиями. Вот пример функциональной декомпозиции предприятия Malum из главы 7 этой книги, «The TAO Theory: Understanding Function and Construction».
А вот как показано конструктивное разбиение, которое авторы называют потом «сущностным» на базе замечания, что функциональных разбиений может быть предложено множество самых разных, которые субъективно определяются самыми разными проектными ролями, а сущностное (подразделения и их сервисы) определяется более однозначно, причём справедливо замечают, что прямого соотнесения между функциональными и конструктивными частями системы обычно нет:
Как понимать эти трансакции в концепции предприятия? Вот табличка акторов для этой диаграммы, мы видим в них знакомые описания рабочих процессов через нарратив как последовательность событий, а события — это изменения состояния предметов рабочего процесса/метода: видим альфу sale и её состояния, но не хватает конструктивного описания — рабочих продуктов, отражающих состояние альфы, а также нет оргролей, которые надо будет назначить на оргзвенья. В «конструктивной диаграмме» оказалась скрыта «функциональная табличка»:
В этом подходе, конечно, есть и поведения (методы/функции и работы), и функциональные и конструктивные объекты (Вася и его забег утром за хлебом, бегун и бег). Но вот терминология «авторская», и надо быть внимательным к терминологии дважды:
-
Функциональное и конструктивное вполне путаются
-
Архитектура включает и функциональное, и конструктивное разбиение, но необязательно высокоуровневое. Описание мелких действий в этом подходе вполне будет отнесено к «архитектуре предприятия» (а онтология — это «формальная информационная модель предприятия», описание предприятия, совершенно необязательно «верхнеуровневое»). Тем самым спутаны работы орг-архитектора, методолога (проектировщика процессов) и орг-проектировщика.
В самой книге аккуратно уходят от названия «концепция» или «архитектура» предприятия для их варианта мета-мета-моделирования (как и в наших руководствах для инженеров-менеджеров, в этой книге делается заявка на «моделирование всего», мета-мета-модель), а свою мета-мета-модель (в которой обсуждаются довольно общие для инженерии вещи, но с акцентом на предприятие/enterprise) авторы называют «онтология предприятия», аргументируя важность рассмотрения не только функционального (телеологического, направленного на цели, intent/намерение, ответ на вопрос «для чего вы это делаете» — предмет работы методологов), но и конструктивного (артефакты и агенты как конструктивно рассматриваемые системы и их сервисы, предмет работы орг-архитекторов и орг-проектировщиков) рассмотрения.
Книга эта хороший пример того, что концептуальное проектирование и архитектурная работа по выбору варианта конструкции (в данном случае — конструкции предприятия, составленного из подразделений) даже при понятной концепции системы тесно связаны. Когда речь идёт о примерах использования описанного в книге моделирования предприятия, становится понятным, что не любое разбиение предприятия на модули-подразделения для выполнения им желаемых функций осмысленно в плане достижения желаемых значений архитектурных характеристик.
Мета-мета-модель книги «The Enterprise Ontology» несколько отличается от мета-мета-модели, которой придерживаемся мы в наших руководствах для инженеров-менеджеров. В этой короткой книжке сделана попытка сжато изложить довольно много материала, похожего на материалы наших руководств, чтобы задать какие-то типы мета-мета-модели, позволяющие судить об архитектуре предприятия, которая понимается как оргпроект (содержащий в себе и функциональную архитектуру, а также более низкоуровневые функциональные описания), так и архитектуру как верхнеуровневое конструктивное разбиение, но и дальше — рабочее проектирование орг-проектировщиками.
В основе этой книги лежит второе поколение системного мышления, однократный жизненный цикл, однократное «создание успешной организационной системы», а не многократный эволюционный, «непрерывное всё»/«создание и развитие успешной системы», как в наших руководствах. Тем не менее, обсуждаются ровно те же идеи, которые даются в нашей мета-мета-модели, хотя и немного в другой терминологии и с опорой на немного другие обоснования. Мышление о концепции системы и архитектуре системы более-менее универсально в разных инженериях, оно безмасштабно, приложимо к системам самой разной природы, а в современных версиях — ещё и эволюционно, и неантропоцентрично.
Вот ещё одна диаграмма из обсуждаемой книги «The Enterprise Ontology», иллюстрирующая концептуальное проектирование в его связи между функциональной архитектурой и структурой модулей:
Описывается метод/process проектирования/design системы. Надсистема называется using system (использующая в своём составе целевую), целевая система — object system (один из переводов object — как раз «цель»). По‑старинке говорится о «функциональных требованиях» (требования к назначению целевой системы, её поведение в составе использующей её надсистемы), а вот «конструктивные требования» — это как раз ограничения на модульный синтез: с одной стороны, какие модули можно или нужно задействовать, с другой стороны — архитектурные ограничения, архитектурные решения, влияющие на группировку функциональности по модулям, влияющую на архитектурные характеристики.
Как ответить на вопрос: важнее/главнее концепция системы, или архитектура? Концепция системы — это верхнеуровневое системное описание, верхнеуровневый проект/design системы. Архитектура (архитектурные решения по верхнеуровневому делению на модули) тут только часть проектных решений (проект всей системы тоже можно представить как «набор решений»!). Функциональная архитектура — это просто функциональное описание системы (часто верхнеуровневое, слово «архитектура» может подчёркивать эту верхнеуровневость). А что с остальной частью проекта? Ей заняты функциональные проектировщики (процессные инженеры, прикладные методологи) и проектировщики-конструкторы.
Концепция системы важна: если вы не знаете, что из конструктивных объектов могло бы исполнить функцию системы (аффордансы/комплектующие/конструктивы), то системы не будет. Можете дать себе три дня на «гугление», вопросы к AI-агентам и друзьям, возможное изобретение, но лучше уходите из проекта, где непонятно, из чего можно сделать систему с предлагаемой функцией. Скажем, вы получили много денег на проект биологического бессмертия. Если непонятно, что именно конструктивно надо делать для бессмертного организма, нет хоть как-то обоснованных на приемлемом уровне риска предложений, то в такой проект идти не надо: нужное вам открытие ещё может просто не существовать, а шансы, что его сделаете именно вы, и успеете при этом сделать его за срок проекта — этот шанс мал. На планете сейчас примерно 500тыс. биологов, которые разбираются в сворачивании белков, а также несколько AI, которые в этом разбираются. Но не факт, что вы найдёте среди них таких, кто добьётся успеха в проекте бессмертия, даже если получит неограниченное финансирование.
Архитектура системы в составе концепции системы важна: если архитектор не разобьёт систему на какие-то «правильные» для достижения архитектурных характеристик части с оптимальной связностью и сплочённостью, то система будет плохо развиваться/evolve, она будет неуспешна уже через пару итераций.
На заре интернета было множество поисковых систем, но они все базировались либо на краулере (робот, собирающий по всему интернету веб-страницы в поисковую систему) и «индексе» поисковика на мощном центральном сервере (обычно компьютер Sun), либо на идее распределённого поиска (каждый вебсайт делал свой поиск, потом они объединялись). Гугль победил, ибо в его архитектуре краулер собирал веб-страницы в датацентр из множества дешёвых компьютеров (а не в мощный Sun-сервер, который не справлялся с нагрузкой, каким бы он ни был мощным). Связь между серверами вебсайтов с фрагментами децентрализованной системы была ненадёжной, плюс поиск давал дополнительную нагрузку на маломощные вебсайты — эти системы вообще оказались неработоспособны, по факту в конкуренции поисковых систем они не участвовали. Победившее архитектурное решение Гугла было внешне централизованным (одна точка входа), но внутри — распределённым (не один мощный сервер, а много маленьких слабых). И Гугль победил практически всех за счёт грамотной архитектуры (а вовсе не за счёт более качественного алгоритма поиска, как это обычно показано в литературе). Мощностей датацентра (в то время ещё не было такого понятия, это была новинка! Были только «вычислительные центры») как раз хватало, чтобы Гугль отдавал ответ на запрос практически мгновенно, как и сейчас, а лучший конкурент AltaVista — минуту и больше. Хороший алгоритм самого поиска (PageRank) пригодился много позже, когда конкуренция была уже выиграна за счёт новой архитектуры (изобретения) и надо было защищаться от повторяющих подобную архитектуру (например, от Bing).
То есть первое слово за прикладными разработчиками, особенно за методологами, функциональными проектировщиками — без них вообще непонятно, что делаем. Но первое слово также и за архитекторами, которые должны правильно упаковать и поставить в архитектурные рамки работу прикладных разработчиков: они должны принять архитектурные решения по поводу системы, организовать разработчиков с их концептуальным проектированием в соответствии с обратным манёвром Конвея, а затем выполнять архитектурный надзор, чтобы разработчики не ухудшали успешность системы, то есть не стремились достичь локального квазиоптимума по достижению характеристик «своих» модулей системы, но делали вклад в достижение глобального по всей системе квазиоптимума. «Квазиоптимум», а не «оптимум» — помним про многоуровневую эволюцию и неизбежную при этой эволюции неустроенность/frustrations, происходящую из-за конфликтов между этими системными уровнями. Вот архитекторы этим и занимаются, оформляя работу прикладных/domain инженеров в целостную систему из по-крупному нарезанных модулей первых нескольких уровней. И там уж работают проектировщики (в связке с методологами и технологами): в какой-то момент надо выполнить проект конструкции с детальностью, достаточной для изготовления.
Как неправильно понять первый подраздел про «требований теперь нет»
Есть много способов ошибиться в понимании представленного материала: достаточно поглядеть на какой-то свой текущий проект и сказать «а вот у меня не так». Да, скорее всего не так — в каком месте пелотона в части методов инженерной работы находится ваш проект? А проекты, которые вы до этого наблюдали? И ошибка начинается с определения самого «проекта» как разового мероприятия: «я вам дал рецепт, приготовьте по нему пирожок в обмен на деньги, и до свидания». Ошибочное утверждение начинается с того, что обсуждается неявный «водопад»: «заказчик чего-то захотел, описали это в требованиях, сделали эскизный проект, рабочий проект, изготовили систему, затем испытали — и подписываем акт, жизненный цикл может опционально ещё включать эксплуатацию с техобслуживанием и ремонтами, но это отдельно будем договариваться, когда-нибудь потом». Современный взгляд на проект даёт совершенно другие границы: эволюционная разработка сначала выдаёт MVP, а затем множество дополнительных отдельных фич, которые тоже проходят через свои MVP, ввод в эксплуатацию новых версий системы непрерывный, а для этого — «непрерывное всё», разработка не заканчивается. Нет никаких «захотел — зафиксировали (даже не задокументировали, именно зафиксировали в неизменной форме) — разработали — отдали — конец».
Неверное рассуждение начинается прямо с «заказчик чего-то захотел». Дело в том, что «заказчик» чего-то хочет многократно, разного и всё время проекта, даже после того, как пошла эксплуатация системы. При этом часто он ничего не «хочет», но меняется жизнь, меняется сама организация проекта, появляются «хотелки» других внешних проектных ролей, проблемы приходят от клиентов заказчика, а не его самого (скажем, сто тысяч клиентов приходят не равномерно три месяца, а появляются все в последний день квартала — и это может быть неожиданно для самого заказчика, но разработчики должны бы такое учесть, даже если их об этом не просили, иначе перегруженная система работать не будет, а разработчик получит деньги за по факту не выполненную работу, ибо «что попросили, то и сделали»). Нет, требования устаревают на второй день, поправки к ним второго дня — на третий, а «хотелка» четвёртого дня звучит «а давайте попробуем ещё вот так — вдруг будет лучше?», то есть «делаем, но не факт, что оставим так — уйдёт на A|B тест». Система (даже мыслимая в будущем, ещё не сделанная) и её окружение (даже то, которое ожидается в будущем) меняются непрерывно (хотя бы в представлениях всех участников проекта и внешних проектных ролей), и разработка системы обязана это учитывать. Статичные «утверждённые требования» тут — привет от неработающего «водопада», однократного прохождения жизненного цикла.
И дело не в том, что нужно разово привлечь какого-то специалиста из предметной области заказчика для разработки требований, далее выработки всего набора концепций, и так далее до конца проекта. Нет, ставится вопрос не о «привлечении к разработке», а вопрос «обеспечения понимания предметной области разработчиками», ибо это понимание не на однократное выполнение заказа, а понимание на какой-то долгий непрерывный поток всё новых и новых изменений системы, и эти изменения приходится делать и из-за предложений (не пишем «требования», ибо это могут быть предложения сделать какую-то пробу для A|B теста, или предложения провести какой-то другой эксперимент) заказчика или даже клиентов заказчика, или из-за изменившегося окружения (никто ничего не захотел нового, но жизнь изменилась: новые стандарты подключения к внешним подсистемам, новые форматы данных, новые часы работы внешних сервисов, новые расходные материалы, новые погодные условия и т.д.).
Поэтому акцент в системной инженерии сейчас делается не на разовое привлечение прикладного специалиста (предметника/«business domain expert»/«subject matter expert») для разработки «начальных требований», а на понимание предметной области/business domain командами разработчиков, визионером, архитектором.
Ещё один источник непонимания — это то, что для какой-то системы существуют множество предметных областей её функциональности. Для закрытия каждой подобласти будут образованы отдельные команды, и архитектор нарежет систему на отдельные модули с по возможности минимальной связностью/зацеплением и максимальной сплочённостью так, чтобы минимизировать взаимодействие этих команд. Это означает, что каждая команда будет иметь свой ритм выпуска фич — но целостность системы будет как-то сохраняться. Это означает, что у каждой команды в случае «разработки требований» должны были бы быть собственные «подтребования», которые ещё и непрерывно изменяются, и не имеют деонтического («долженствования») статуса, а имеют доксический («верю, что будет вот так») статус гипотез.
Для команд поддержки предметных подобластей (domains, bounded contexts) тем самым важно понимание ими этих предметных областей, а не «понимание спецификации требований». Описание системы этими командами (как описание чёрного ящика, так и описание прозрачного ящика) делается другими документами, при этом сегодня это будут исполнимые в форме тестов (то есть формальные) описания, разработка будет идти test-first. Сначала отвечаем на вопрос «как мы узнаем, что система работает, и делает это хорошо?». Никаких требований, другие формы описания функциональности, интерфейсов, и жёсткое управление конфигурацией, ибо у разных команд будут быстро меняющиеся разные системные описания. Конечно, команды сотрудничают в том, чтобы система оставалась целостной.
Это сотрудничество поддерживается архитектором и инженерами производственной платформы. Они отвечают за то, чтобы весь этот клубок непрерывно меняющихся системных описаний как-то асинхронно реализовывался в разных версиях целевой системы. В ходе современной разработки система непрерывно развивается, поэтому довольно долго остаётся адаптированной к её окружению, довольно долго сохраняет свою целостность.
Необязательно заменять систему целиком при смене версии системы, это ведь слишком дорого. Можно менять и отдельные части, это много дешевле. Пока компьютеры были дорогие, так и происходило: вы меняли отдельно процессор, отдельно память — это был «апгрейд», потом компьютеры резко подешевели, и менять части стало невыгодно, проще было менять весь компьютер целиком. Это, кстати, общий тренд: при относительной вашей бедности и относительной дороговизне системы вы будете ремонтировать дискретные компоненты на плате, а потом цена труда по ремонту становится дороже замены платы, а потом и плату менять уже не будут — будут менять всё устройство в целом, но это только когда стоимость всей системы уже пренебрежимо мала, налажен массовый выпуск и достигнута экономия на масштабе. Ключевое тут то, что вот эта «смерть всей системы» при неудаче дорогих первых версий совершенно необязательна, её информационная модель хранится не в ней (как геном в живых организмах, ещё и в каждой клетке), а в конструкторских и проектных бюро. Можно менять только неудачные части, а не всю неудачную систему — и необязательно дожидаться смерти системы с каждой неудачной мутацией самых первых версий. Это резко удешевляет и ускоряет техноэволюцию по сравнению с биологической эволюцией.
Новое понимание разработки — это не разовая разработка конечного варианта системы, который «сдают заказчику». Это совсем другое, это «эволюция системы умными мутациями в ходе долгого проекта». В биологической эволюции предыдущие версии биологических систем гибнут, чтобы с ними погиб неудачный геном, а в техноэволюции геном лежит себе в репозитории, и мутация делается без сопутствующих смертей системы, ведь могут заменяться только техно-части. У крабика может потихоньку расти клешня «как у вида», но это будут множество особей — популяция. А у системы-технокрабика просто будут менять одну клешню на другую без смерти всей системы, а мемом системы (описание системы) будет храниться рядом, и неважно даже, популяция из одного технокрабика, или из множества. Если клешня техно-системы неудачна, то команда клешни будет её менять, пока та не станет удачной. Если мир поменялся (динамический ландшафт приспособленности), и только что удачная клешня стала неудачной — её опять поменяют, да ещё и попробуют пять разных вариантов один другого лучше. Другая команда будет делать то же самое для ног крабика, глаз и т.д. — в биологии это будут мутации генов и много-много смертей отдельных крабов, большие популяции крабов, чтобы попробовать много вариантов с мутациями, много времени. Для технокрабика это будет 10 вариантов в день (и это смарт-мутации, большинство заведомо плохих вариантов будут откинуты в ходе компьютерного моделирования — это мы считаем только то, что введено в эксплуатацию), в каждом варианте будет изменено немного фич, система будет оставаться целой кроме изменяемых частей. И нет «требований к крабику», всё ж постоянно изменяется, это просто техноэволюция. Для понимания нужно третье поколение системного мышления, выход за один жизненный цикл.
При этом «крабики умирают» (как вид) и в техноэволюции, если изменения радикальны. Все модификации телеграфа, например, вымерли при переходе на телефон, пейджеры, мессенджеры.
Для прототипов космического корабля Starship фирмы SpaceX иногда разработчики меняют своё мнение так быстро, что даже не успевают испытать свежеизготовленный прототип, и его тогда разбирают на запчасти, если нельзя просто быстро модифицировать целый корабль. Каждый прототип делается отличным от предыдущего, а в конечном итоге планируется выпускать один космический корабль раз в три дня, и это гарантированно будут не абсолютно одинаковые космические корабли. Пассажирские самолёты Boeing и сейчас выпускаются каждый в своей уникальной конфигурации, но мы тут говорим даже не о том, что в разработке продуктовая линия со множеством модификаций одного продукта, а о том, что по мере выпуска продукт всё время обновляется и единицей рассмотрения для разработчиков является не только какое-то изменение (инкремент, фича) с его жизненным циклом от понимания нужности до эксплуатации в составе целой системы, но и сама жизнь системы, которая разрабатывается-эксплуатируется одновременно (что и отражалось в названии метода DevOps — от development и operations, этот метод и последовавшая за ним инженерия платформы разработки будут рассмотрены в нашем руководстве позже).
Тем самым неверно рассуждать для ситуации «единичного требования» в «одном цикле разработки». Нужно сразу понимать, что это ситуация техноэволюции, смотреть контекст/окружение происходящего с описанием системы в ходе непрерывной разработки, непрерывного изготовления, непрерывной сборки, непрерывного разворачивания, непрерывного ввода в эксплуатацию, проходящих с системой в ходе её развития/evolving (будем переводить evolving system как «развивающаяся система»).
Если оставлять слово «требования», то начинаются споры на ровном месте: сам термин, похоже, отражает второе поколение системного мышления, а для третьего поколения нужно смотреть не только на описание системы, но и на развитие/эволюцию описания вместе с развитием/эволюцией системы. А «развитие требований» как-то «не звучит», требования наборот — ожидается, что они «стабилизируются»! Поэтому от слова уходим, споры на ровном месте (каждый понимает под «требованиями» что-то своё) не нужны, это «ложный друг переводчика». Почему бы описание системы как чёрного ящика не оставить как «требования»? С оставлением термина «требования» возникают много соблазнов:
-
Ошибочно считать, что это описание в деонтической (долженствования), а не доксической (предположение, вера) модальности. Нет, это не «требования», а «гипотеза». Нельзя говорить «вы должны, ах нет, уже не должны, но нет, мы опять поменяли, что вы должны — вы должны, но уже другое». Перестали говорить «X должен быть 10», но «я сейчас верю, что X будет 10, а завтра посмотрим, давайте проверим догадку/гипотезу».
-
Ошибочно считать, что это не альфа «описание», а привычный рабочий продукт «спецификация требований» — и далее, как обычно, подтягивается вся традиционная идеология водопада, где «изменение спецификации требований — это долго, дорого, плохо», «сначала увяжите все требования между собой, а потом мы их проверим все вместе».
-
Сплошь и рядом «требования» — это описание системы в языке разработчиков (не «игрок должен быть зарегистрирован за три минуты», а «данные пользователя должны быть получены с интерфейса за три минуты»), нет описания в духе движения customer eXperience. Такие описания, как сценарии использования, не так чтобы гарантируют, что описания будут в предметном языке, но позволяют ещё и ещё раз обратить на это внимание и уж точно описать функциональность, а не только конструктивность. И тут ещё одна подвижка: попытка «интерфейсы» (конструктивное описание) заменить словом «контракты», в котором упор опять-таки делается на функциональность (взгляд от надсистемы на систему с точки зрения того, «зачем это всё», а не «что во что втыкается»).
-
«Спецификации требований» (а не спецификации системы!) сегодня представляют собой документы со смесью описаний функциональности, архитектурных характеристик, архитектурных решений и всего чего угодно. Нет «требований», значит нет «спецификации требований» и можно отдельно говорить обо всех этих разных видах описаний, разных видах спецификаций. В частности, можно проконтролировать, чтобы описание (спецификация, причём как гипотеза) было именно описанием желаемого поведения системы, а не просто описанием конструкции системы в статике. Для этого и «сценарии», хорошо подходящие для описания поведения. Подойдут use cases, сценарии (use case текстом), storyboards (картинки заставляют сделать grounding в физический мир) и т.д.: всё, где есть поведение. Всякие языки для BDD (ATDD и похожих методов) пишутся как business rules (в том числе Gherkin) и они тут вообще предпочтительны, хотя без картинок, зато с возможностью проверки.
-
Архитектурные характеристики попадали в состав требований как какие-нибудь «нефункциональные требования» или «требования качества». Сейчас они обсуждаются отдельно от функциональных характеристик, с ними работают через метрики, а значения тоже проверяются автоматизированным архитектурным тестированием с помощью особых тестов — fit functions. По их поводам выпускаются архитектурные решения, и они тоже предмет непрерывных изменений в ходе проекта, а выявляют их архитекторы, а не разработчики фич.
-
Если оставить «требования» и они будут поняты как документ «спецификация требований», возникает соблазн посадить ещё «прокладку» между специалистами предметной области и разработчиками из инженеров по требованиям. Возникает проблема испорченного телефона, она же проблема многократного перевода. Информация в ходе её передачи от внешних проектных ролей разработчикам и архитекторам не только будет потеряна, она ещё и будет существенно искажена.
Это если кратко. В книгах программной инженерии (но увы, пока не в книгах по классической системной инженерии и книгах других прикладных инженерий, туда эти идеи ещё не дошли), которые рекомендуются в нашем руководстве, всё это расписано подробней.
И ещё нужно понимать, что «просто требования» не бывают сами по себе, они ведь могут быть нереализуемы, и это нужно отслеживать. Например, требования «конверсия должна прирасти на 20% от текущего уровня» маловато будет, нужна какая-то идея, с чего бы она там будет прирастать — и это уже сразу не «требования». Не ввязываемся в проект, если не удалось быстро (скажем, за три дня) найти идею/изобретение/концепцию для «фичи» системы (вряд ли можно запланировать изобретение, скажем изобрести микроволновку или компьютер во времена Бэббиджа). Это подробней обсуждается в стратегировании как практике выбора направлений развития/evolving для систем. Стратегии всё чаще и чаще не формулируются в форме «требований к предприятию», но в виде документирования методов работы — сценариев (планы, функциональные описания) или архитектурных решений (policy, за соблюдением которых прислеживают — когда речь идёт об архитектурных характеристиках личности, организации, сообщества). Хотя тут, конечно, речь не идёт о формальной записи, соответствие которой легко протестировать.
Задания
Поставьте отметки о выполнении следующих дел:
-
Опубликован пост с вашими мыслями, почему вы не хотите выполнять роли визионера, методолога, проектировщика, технолога, архитектора, инженера производственной платформы. Даже если вы хотите выполнять какую-то из этих ролей, опишите проблемы, которые заставляют вас задуматься о том, надо ли вам этим заниматься.
-
Опубликован пост с вашими мыслями о вашем опыте разработки концепции использования и концепции системы в ваших проектах, с использованием материала текущего раздела и итогов выполнения всех заданий и упражнений.
-
Вы откомментировали не менее трёх написанных другими инженерами-менеджерами постов на тему разработки концепции использования и концепции системы.
Системный менеджмент и разработка
Очень трудно разделить сам инженерный процесс (инженерию целевой системы) и процесс создания систем графа создателей (инженерия графа создателей, это обычно организации). Чаще всего упоминается, что «команда сама организует свою работу». Команда тут рассматривается как оргзвено, и само высказывание требует уточнения — как же команда выступает в роли инженера целевой системы и менеджера-организатора по отношению к самой себе? Тут нельзя обойтись без ролевого рассмотрения: один и тот же конструктив (команда как оргзвено) выступает в двух разных ролях, и отдельные члены команды просто в разное логическое время (время инженерии, время менеджмента) играют разные роли.
Когда команда обсуждает организацию/создание себя как системы, то агенты-люди в ней выступают в других ролях: ролях создателей организации, то есть инженеров предприятия, менеджеров-организаторов. Люди, создающие и развивающие своё оргзвено (отдел, рабочую группу проекта, предприятие) как инженера-создателя целевой системы, тоже выполняют методы системной инженерии, но для организации как одного из участников графа создателей целевой системы. То, что там целый граф создателей, важно: и саму команду‑оргзвено разработчиков как «создателей себя» тоже кто‑то создал, и после создания команды с её создателями будет отношение надзора (там ведь тоже monitoring, continuous development, continuous delivery таких команд), чтобы команда продолжала выполнять своё назначение, ради которого она была создана, а не ушла в автономное плавание со своими собственными целями и перестала заниматься разработкой для достижения и поддержания успешности системы!
Так, команда разработчиков, предоставленная сама себе, обязательно хочет расти не только в мастерстве, но прежде всего в числе членов команды. Любой агент, в том числе коллективный, хочет расти и размножаться, убирая неприятные сюрпризы со своего пути — это же эволюция! Но есть внешне задаваемые довольно контринтуитивные пределы роста. В принципе, архитектура самых разных систем похожа, она борется всяко с проявлениями в разных системах уже упомянутого закона Амдала: весь прирост производительности от увеличения числа работников съедается увеличенным временем координации между ними. Скажем, если у вас близится сдача, то добавление сотрудников только отдалит срок сдачи: время уйдёт не только на то, чтобы ввести новичков (даже одного новичка!) в курс дела, потом исправить неизбежные новичковые ошибки, но и на сначала налаживание, а затем поддержание коммуникации внутри увеличившейся команды.
Более того, эксперименты показывают277, что оптимальный размер команды оказывается неожиданно маленьким: он ближе к пяти участникам команды, чем к двадцати. В софтверном проекте команды и из 5, и из 20 человек пишут 100 тысяч строк кода примерно за девять месяцев. При этом команда из 20 человек справляется всего на неделю раньше, чем команда из 5 человек, но ошибок делает в пять раз больше. Это как раз следствие сложной коммуникации, которая по закону Конвея проходит по поводу разных частей программы не в одном мозге, а через разные мозги, а по закону Амдаля она ещё и съедает производительность многих вычислителей на координацию между ними.
Нарезка системы на крупные модули со слабой связанностью и большой сплочённостью, предписание интерфейсов для связи между ними делается архитекторами системы, которые явно учитывают необходимость обратного манёвра Конвея — подчиняют структуру коллектива из нескольких команд разработчиков структуре разрабатываемой системы. По факту совместно работают две команды архитекторов (возможно, каждая из одного человека или даже AI-агента, или даже это обе команды из одного человека, поскольку речь идёт о ролях):
-
Команда архитекторов целевой системы задаёт целевой создаваемый и развиваемый модуль для каждой команды, специализирующейся на какой-то предметной области, и именно это первично (помним, что целевая система оптимально нарезается на модули, а уж какие там будут команды — это будет второй вопрос, там будет применён обратный манёвр Конвея, да ещё и само разбиение на модули будет меняться по ходу проекта). При этом целью будет максимально точно определить bounded context в части проектных описаний/design и domain в части выделенной части мира, для которого будет разрабатываться командой их часть системы. Конечно, архитекторы целевой системы принимают ещё и множество других архитектурных решений, целью которых является достижение всеми разработчиками разных команд в целом (коллективом разработчиков) приемлемых значений архитектурных характеристик. Эти решения команды архитекторов могут меняться. Мы тут специально пишем «команда архитекторов», хотя в целом в руководстве говорим только о роли архитектора: напоминаем, что роль всегда кто-то исполняет — и это вполне может быть целая команда в большом проекте.
-
Команда архитекторов предприятия делает архитектуру организации, задающую нарезку всего предприятия::оргзвено::модуль на максимально автономные (чтобы получилась архитектура со слабой связанностью/зацеплением, loosely coupled architecture) команды::оргзвено::модуль/конструктив. Делает это команда, ориентируясь на (непрерывно меняющиеся!) решения архитекторов целевой системы (не систему делят на части, удобно раскладываемые по уже существующим командам, а коллектив делят на более-менее автономные/независимые команды, занимающиеся определёнными частями целевой системы — в этом суть обратного манёвра Конвея). Внимание архитекторов предприятия направлено на конструкцию организации. Способ деления коллектива предприятия на команды как орг-модули и способ связи между командами коллектива как модулями задают важные организационные свойства (архитектурные характеристики предприятия): высокая производительность предприятия в целом, масштабируемость предприятия в целом, возможность быстрого изменения структуры предприятия в целом (evolvability).
Тем самым модули целевой системы намеренно делаются максимально автономными, целевая система начинает напоминать систему систем (SoS), где команды владеют отдельными автономными модулями в окружении других модулей. Такие системы систем оказываются сложней устроены, их трудней понять, трудней координировать их развитие, но они лучше адаптируются к быстро меняющимся условиям окружения, лучше масштабируются, быстрее создаются, ибо команды не задерживают друг друга в бесконечных согласованиях: по одному модулю принимает решение каждая команда самостоятельно, а не собираются для этого несколько команд. Кроме того, помним, что в слабо связанных модулях ошибки одних модулей не мешают другим модулям работать, а в сильносвязанных — мешают. Это относится и к разрабатываемым системам, и системам из их графов создателей.
Основные принципы современных концепций предприятия и архитектурных решений для предприятий и их команд, как всегда, можно подсмотреть в литературе по организации программных разработок, есть множество фреймворков для поддержки scaled agile (гибкой разработки, выходящей за рамки одной команды): SAFe (Scaled Agile Framework)278, LeSS (Large-Scale Scrum)279, DaD (Disciplined Agile Delivery)280, Scrum@Scale281, Scrum Nexus282, Spotify Model283, и другие. Но помним о том, что речь идёт о безмасштабных принципах, которые приложимы для систем практически любой природы. Требуется время, чтобы принципы разработки, масштабируемой с одной команды на множество команд, были адаптированы не только к программной инженерии. И часто каждый подход будет излагаться в какой-то своей терминологии, так что без понимания устройства разделения труда по инженерным ролям и причин такого разделения труда в этих фреймворках будет трудно разбираться. Но после понимания (хотя бы в объёме нашего небольшого кругозорного руководства) — это будет не слишком сложное чтиво.
Ещё раз, чтобы подчеркнуть мысль: системная инженерия — это метод ведения инженерной работы для всех систем в графе создателей. Принципы её, конечно, адаптируются для каждой отдельной предметной области, но применяются ко всем системам-создателям из их графа. Если вы создаёте целевую систему нового типа (хоть бактерию, хоть мастерство, хоть программную систему, хоть сообщество, хоть страну), для которой приходится создать инструмент и систему автоматизации проектирования, а также организовать множество команд для создания всего этого, вы будете применять одни и те же принципы.
В рамках проекта и создание целевой системы, и создание инструментария, и создание команд, и маркетинг как создание сообщества лояльных клиентов — это всё инженерная деятельность. Обсуждаются все эти вопросы вместе, с использованием одних и тех же принципов, одних и тех же идей — в том числе таких, как закон Конвея и обратный манёвр Конвея.
Это означает, что многие вопросы нельзя вот так прямо разделить на «вот это разработка, пусть думают прикладные инженеры-технари/domain engineers и их системные инженеры-архитекторы/system architects», «вот это менеджерский вопрос организации разработок, пусть думают менеджеры/managers и их ответственные за развитие как инженеры предприятия/enterprise и архитекторы предприятия». Нет, инженеры должны разбираться в менеджменте, а менеджеры — в инженерии целевой системы, и они просто обязаны договориться (договорить всех вокруг себя).
Вопросы создания команд разработчиков (их будет много для одной системы!), создания коллектива разработчиков как «команды команд плюс их организатор, архитектор и визионер, а также инженер платформы» для системы в целом, а также вопросы разработки самой системы в целом и отдельных частей и «фич» системы, которые выполняют отдельные команды — они более чем тесно связаны. Принципы этой связи нужно знать и инженерам, и менеджерам при всей разнице природы их систем (тех типов систем, которыми они непосредственно занимаются).
Книги, которые мы рекомендуем, это не чисто «книги по менеджменту» с их вечным обсуждением «авторитарного стиля менеджмента» или чего-то подобного «про людей в организациях». Нет, это книги по инженерии как таковой, с учётом графа создателей: нужно создать множество самых разных систем, чтобы на выходе всех путей по этому графу получилась целевая система.
Как и другие книги, обложки которых мы приводим в нашем руководстве, эти книги обязательны к прочтению, если вы занимаетесь разработкой хоть чего-нибудь профессионально. И вам надо самостоятельно адаптировать материал этих книг к условиям вашего проекта — выживут при этом принципы из книг, но не детали. Методы работы из одних проектов не приложимы к другим проектам без изменений, их необходимо пересобрать. Это может быть не очень просто даже для разработки софта, ибо не весь софт сводится к разработке корпоративных информационных систем. Например, системы AI разрабатываются немного по-другому — но по тем же принципам организации коллективной работы и командной работы.
Подробно самые разные аспекты работы в современной разработке софта описаны в книге Accelerate (2017)284, и опять предупреждаем: читать это нужно как описание методов разработки систем самой разной природы:
В книге приводится довольно много контринтуитивных принципов организации современной инженерной разработки, которые подтверждаются результатами исследований, evidence-based. Вот, например, один из графиков в этой книге:
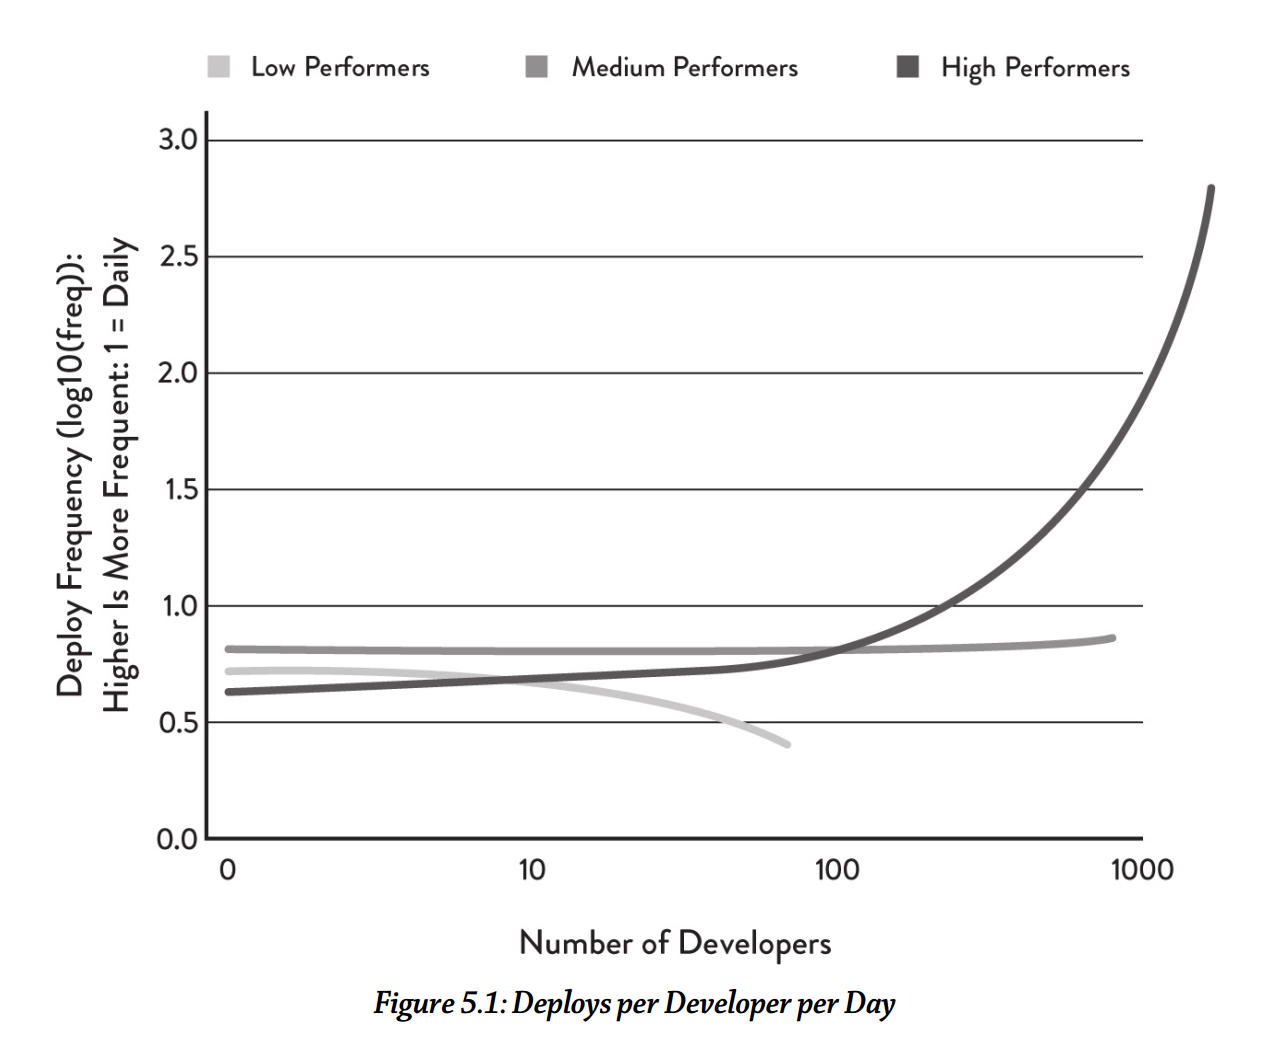
Он показывает, что в высокопроизводительных организациях (на графике — high performers) при росте числа разработчиков число завершённых частей системы, готовых для сборки (deploys, включение в состав готовой системы) растёт линейно, или даже более чем линейно — за счёт всех этих методов принятия архитектурных решений, принятия решений операционного менеджмента по ограничению размера единицы выполняемой работы (small batch size, «малый размер обрабатываемой партии») и т.д. В организациях умеренной производительности скорость от добавления разработчиков остаётся примерно одинаковой. А вот в организациях низкопроизводительных (в книге показывается, что они не используют современный гибкий инженерный процесс, а придерживаются старинного «водопада») с добавлением людей в команду производительность быстро падает: они не могут решить проблемы работы «команды команд» («бригады бригад», коллектива проекта в целом).
Так что классическим (прикладным, самым разным по специальностям) инженерам, оказывается, надо знать и менеджмент как прикладную инженерию организаций: это необходимо для организации собственного инженерного труда. Менеджмент оказывается общей дисциплиной для всех видов инженерии, ибо вся инженерия выполняется организациями!
Менеджмент в инженерии — как «общее фортепиано» в музыкальных училищах и консерваториях. На каком бы инструменте (скрипке, трубе, органе, вокале) ты ни специализировался, тебе всё равно нужно уметь играть на фортепиано, потому что знание фортепиано в силу специфики этого инструмента существенно поднимает понимание теории музыки, развивает музыкальный слух и ритмику — и этот прирост музыкального мастерства оказывается переносим на игру на «родном» инструменте. Мультиинструменталисты играют на своём «родном» инструменте лучше, чем моноинструменталисты!
Так и в инженерии: на какой бы ты инженерии не специализировался, тебе всё равно нужно уметь разобраться с организацией работы команды разработчиков, а также тем, как и почему из команд разработчиков собирается полная организация. Можно добавить ещё оснований:
-
Организация — это пример системы, разобраться с менеджментом как инженерией организации вам поможет общность принципов системной инженерии для систем разной природы, будет проще задействовать рациональное системное мышление.
-
Организация как система вам встретится в любом проекте, вам как инженеру всегда придётся договаривать людей и AI вокруг себя, то есть организовывать людей и AI в проекте вокруг вас и вашей работы. Ну, или мириться с тем, что кто угодно будет организовывать вас, а вы будете виноваты в любых недопониманиях.
-
Надо уметь говорить с менеджерами на их языке, а также понимать, каковы их интересы. Если вы не предъявите причинно-следственную цепочку от вашей работы к увеличению скорости выпуска целевой системы, менеджер вас даже слушать не будет — и это будет не его вина, а ваша вина. Вы же не заказываете в пиццерии босоножки? Вот и с менеджером надо говорить не на инженерные темы, а на менеджерские — но для этого надо разбираться в менеджменте.
-
Если вы будете расти как инженер, то это будет означать рост сложности и масштаба ваших проектов. В более сложных и масштабных проектах участвует больше людей. С какого-то момента вы обнаружите, что общения с другими людьми у вас больше, чем общения с моделерами вашей системы. Но как инженер вы профи, а в организации людей на выполнение сложной инженерной работы — любитель. Перестаньте быть любителем, учитесь менеджменту. Но в этом обучении существенно поможет то, что вы будете относиться к менеджменту как инженерии организации: это будет не изучение нового предмета с полного нуля, а просто некоторое обновление ваших профессиональных инженерных знаний.
Примерно такие же аргументы можно привести по необходимости освоения работы инженерии личности по нашему руководству, посвящённому инженерии людей и AI-агентов как обучению их новым методам работы (новым способам поведения):
-
Личность — это пример системы, разобраться с инженерией личности вам поможет общность принципов системной инженерии для систем разной природы, будет проще задействовать рациональное системное мышление.
-
Личность как система вам встретится в любом проекте, вам как инженеру всегда придётся договаривать людей и AI вокруг себя, для чего неплохо бы представлять, как менять людей и AI (учить их чему-то новому, что вы знаете, а они — нет). Если нет — придётся мириться, что вы всегда будете в чьих-то планах, а не кто-то в ваших планах.
-
Надо уметь говорить с людьми так, чтобы был шанс изменить их поведение, понимать границы возможного. Так же, как вы не стремитесь всё бросить и начать выполнять советы первого встречного (не стремитесь поменять своё поведение по чьей-то указке), так и другие люди тоже не стремятся выполнять ваши советы. Как же тогда договариваться? Как говорить с каждым человеком на его языке, как преодолевать большие понятийные расстояния?285
-
Первый же человек, с кем вы встретитесь во всё более и более сложных проектах — это вы сам. Можете ли вы себя развить, чтобы калибр/масштаб вашей личности был соразмерен выросшему масштабу проекта? Можете ли вы себя научить, или с этим проблемы? Как преодолеть эти проблемы? В этом обучении существенно поможет то, что вы будете относиться к обучению как инженерии личности: это будет не изучение нового предмета с полного нуля, а просто некоторое обновление ваших профессиональных инженерных знаний.
Вот ещё одна книга, «Team Topologies» (2019) которая касается организации труда разработчиков, и тоже увязывает инженерию команды как части всей организации и прикладную инженерию целевой системы:
Книга кажется «всеохватной», но нет: она касается главным образом одного аспекта, а именно командной организационной структуры, которая влияет на производительность, то есть ускоряющей поток (работ, информации. «Поток»/flow — это общий термин для операционного менеджмента как «эксплуатационной инженерии» организации, отсылающий к логистической парадигме и lean management). Всё изложение в книге крутится вокруг архитектуры, закона Конвея и принципов рационального управления потоком, больше известных как lean.
Книга «Team Topologies» не закрывает всех аспектов, которые нужны для успешных инженерных проектов. Скажем, предыдущая книга («Accelerate») говорит о важности организационной культуры (предоставление автономии командам, свобода разговора о проблемах, общий подход к обучению на ошибках, а не обвинению в ошибках), а в «Team Topologies» этот вопрос практически не затрагивается, книжка очень компактная. Практически не рассматриваются и методы самой инженерии (сначала пишем тесты, а потом проект системы, или наоборот? Пытаемся найти «единственную исходную причину» для каждой проблемы, или нет?), не рассматриваются вопросы финансирования, вопросы бизнес-стратегии (зачем вообще возиться с созданием и поддержкой команд?!).
Объяснительная теория потока и методов lean второго поколения (то есть для разработки, а не для машиностроительных заводов) собрана в книжке 2011 года «The Principles of Product Development»:
Это всё вариации подхода Lean, который появился ещё в 1988 году, но для физических потоков заготовок в машиностроении. Эти принципы были осмыслены как принципы управления очередями (очереди — это плохо, это затор на пути потока продуктов к покупателям, и одновременно это затор на пути встречного потока денег от покупателей через производителя к источникам сырья, то есть другим производителям). И эти принципы управления очередями были взяты из самых разных других дисциплин.
Эту линию рассуждений про «поток» развивает метод «TameFlow», с которым вы уже знакомились в руководстве по рациональной работе.
TameFlow своими предметами имеет одновременно четыре потока (работ, денег, информации и психологический/well-being)286. Авторы этого подхода уделяют довольно много внимания тому, как добиться того, чтобы разработчики не только быстро работали (и тут им помогают хорошо известные принципы теории ограничений Голдратта, мы не касаемся их в нашем руководстве, поскольку выяснилось, что все наши инженеры-менеджеры хорошо с ними знакомы), но и были счастливы в этой работе, отсюда много внимания работе с людьми, а не только с методами собственно разработки. «The Principles of Product Development» затрагивает теорию: как именно принимать решения по организации работ, основываясь на принципах экономики, как разумно задействовать оптимальные (не лишние и не недостаточные) ресурсы для выполнения работ.
Более подробно, как организовывать инженерную работу, рассказывается в руководстве по системному менеджменту.
Задание
Поставьте отметку о выполнении.
- Написан пост, в котором вы рассказываете о ваших инженерных работах и ваших менеджерских работах. Какой процент времени уходит на принятие инженерных, а какой процент — на принятие менеджерских решений? Порассуждайте, как вы разделяете эти решения (учитывая, что менеджмент — это тоже инженерия, инженерия организации, а в части лидерства — и инженерия личности).
Безошибочность проектирования, точность изготовления, тотальная автоматизация инженерии
Каким образом добиться точности в проектировании/design? В программировании это будет не только design, но и написание кода как «проектирование с достаточной для изготовления точностью». В инженерии железа это будет design, а аналог «кода» в программировании — информационная модель. В русскоязычной практике могут различать «конструирование» как разработку форм деталей (частей системы, которые не собирают из более мелких деталей) и «проектирование» как разработку на основе уже известных деталей и более крупных частей (подсборок, сборок). В любом случае, залогом успеха является доведение абсолютно недетального описания какой-то сигнатуры функции системы («забивание гвоздя») до уровня детальности, требуемого для автоматического изготовления конструктива на производственной платформе, «перевода из битов в атомы». Такой детальности ещё не везде добились, не везде «токарь» стал «станком с ЧПУ» или «3D-принтером», а слесарь-сборщик «промышленным роботом-сборщиком». Ну, и AI позволяет задействовать vibe инженерию (по аналогии с vibe coding287, прозванным так Andrej Karpathy), где значительную часть формализации берёт на себя AI-система.
Ключевых трендов тут два:
-
Тщательные проверки модели инкремента, quality assurance, инженерные обоснования. Если есть какие-то ошибки, то их нужно обнаруживать рано. Инкремент маленький, поэтому ошибки обнаруживать относительно легко. У нас будет отдельный раздел про инженерные обоснования.
-
Изготавливаемое изделие не надо трогать руками, ибо каждые человеческие руки привносят ошибки. Автор видел вязаный свитер машинной вязки, на котором была ввязана абсолютно чёткая и ровная надпись контрастными нитками: «Твоя бабушка так не свяжет». Люди добавляют неточность! Для того, чтобы что-то собралось, оно должно быть точно спроектировано и точно собрано.
Так же, как архитектура может быть представлена как набор архитектурных решений, так и проект системы (design в классической инженерии, или в программировании исходный код, в инженерии предприятия это могут быть скрипты маршрутизации работ, и т.д.) может быть представлен как набор решений разработчика. Но разработчик, даже если он знает, что ему надо принять решение самостоятельно, а не «подготовить предложение» для утверждения кем-нибудь, кроме самого разработчика, совершенно необязательно будет принимать решения без какой-то их внешней проверки! Как и необязательно, что внешняя проверка независимыми экспертами приведёт к более качественным решениям — эксперименты показали, что тесты, подготовленные самим разработчиком, примерно одинаковы по результативности с тестами, подготовленными независимыми экспертами.
Тут есть некоторая проблема, «лекарство, которое стало болезнью». Тезис тщательности проверок приводит к тому, что разработчик не принимает решения лично и становится вместо инженера «аналитиком», который имеет право высказать только своё мнение, готовить предложение. Тогда решение принимает не разработчик, а кто-то из менеджмента, или «самый главный из инженеров». По факту это деградация инженерной культуры, она не замечается — пока какой-нибудь главный инженер не удивится, что у него к вечеру во входящих сообщениях где-нибудь двести-триста «предложений», которые он должен по факту не глядя (откуда у него время разбираться?!) должен «утвердить». Если вы увидели где-то «утверждаю» — вот это оно: не инженерная культура, а аналитическая, «спихивания ответственности» за принятие всерьёз (переход от слов к делу, трате ресурсов, воплощению идей в жизнь) на кого-то должностью повыше. Часто в такой организационной культуре окончательные инженерные решения принимают даже не инженеры, а мало понимающие в инженерии менеджеры. Это беда, с этим надо бороться по многим причинам (например, каждая передача решения кому-то — это задержка во времени, а если это начальник — то в силу его перегруза содержательной работы не будет, это чистая задержка на координационный акт). Это проблема организационной культуры, стиля принятия решений в организации.
Но не может же инженер принимать решение единолично? Может, только это должно быть информированное решение — он его должен показать коллегам-инженерам, чтобы они проверили верность этого решения. А для начала эту проверку надо облегчить: начать с написания тестов, которым должен удовлетворить результат выполнения решения.
А чтобы не отвлекать коллег, будем автоматизировать проверки — и тестирование, и проверку обоснованности самого решения (review проектных решений). Чужие «неживые» глаза делают проверку модели системы прямо во время проектирования очередного инкремента, а не после его окончания, когда принято уже множество решений. Для этого сажаем за моделер сразу двух разработчиков — неживого и живого (а потом и просто многих неживых, ибо автоматизация вытесняет из проекта людей)!
Этот метод проверки проектных решений по ходу их создания стал известен сначала для двух живых разработчиков под названием pair programming, она пришла из подхода eXtreme programming как результат идеи «если что-то хорошо, то мы доводим это до экстремума». Там рассуждали так: если кто-то посмотрит код программы кроме программиста, то это хорошо. Доводим до экстремума: за одной клавиатурой и экраном должно сидеть двое, поэтому в любой момент времени на код будут смотреть как минимум две пары глаз! Всё не так плохо с эффективностью: один из этих двоих сегодня — AI-copilot (но даже в случае живого человека производительность не слишком падала, явно не вдвое — за счёт уменьшения количества переделок, уменьшения rework в силу вовремя замеченных проблем). Это был очень контринтуитивный факт: при парном программировании производительность труда не падала вдвое. Сегодня AI-copylot превращается постепенно из pair developer в peer developer, в полноценного разработчика (прежде всего — проектировщика, designer, в программировании — кодировщик, coder). Как оценить его работу? По тому, какой длительности человеческую работу можно ему предложить? Такие оценки есть, они интересны не для идеи copilot с pair/peer programming, где AI «сидит рядом, работает вместе», но для идеи AI-assistant, который не сидит рядом, а берёт задачу — и приходит назад с ответом. Вот это (график в логарифмическом масштабе, март 2025)288:
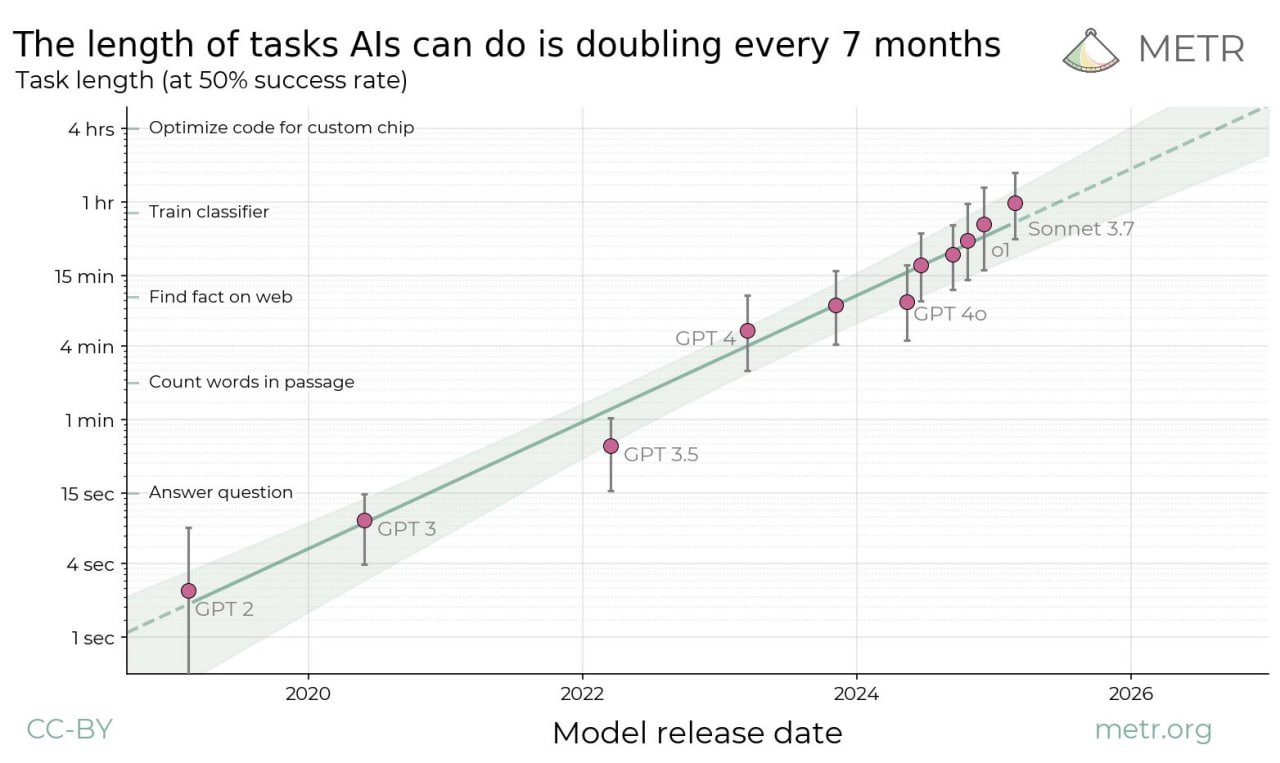
Конечно, экспоненты бесконечными не бывают, обычно это фрагменты S-образных (логистических) кривых. Но вполне можно ожидать, что потенциал автоматизации работы проектировщика выше, чем это можно было бы ожидать — прямо сейчас происходит экспоненциальный рост инженерного мастерства AI-систем.
Заметьте, что идея парной инженерии (в оригинале — «парного программирования», сейчас это работа с AI-copilot, в том числе vibe coding или designing) отличается от идеи совместной разработки прикладного инженера и технолога по изготовлению (design for manufacturing), когда за CAD/САПР/моделером сидят конструктор детали и заводской инженер-технолог, хорошо знающий свой станочный парк. Или инженер-программист сидит и пишет программу вместе с экспертом в предметной области, для поддержки которой делается эта программа. Нет, это именно два проектировщика: один проверяет другого, даёт советы по альтернативным решениям (например, предлагает альтернативные концепции системы или помогает пройти развилку в уже имеющихся альтернативах, напоминает о каких-то ограничениях в части интересов внешних проектных ролей и т.д.).
Тренд тут был в том, что парное программирование стали брать на себя моделеры, поддерживающие мышление разработчика289, это ещё до появления AI-copilot и общения с этими «вторыми пилотами», «парными проектировщиками» на естественном языке.
В простейшем моделере, который представляет из себя редактор текстов, можно делать проверку орфографических и грамматических ошибок (а если это язык программирования — проверять ошибки в синтаксисе языка). В чуть более сложном — предлагать даже дописывать слова, это реализовано даже в телефонах. Иногда это ведёт к ошибкам, но чаще наоборот, исправляет ошибки.
В более сложных моделерах можно сразу иметь copilot. В программной инженерии проектирование (кодирование) ведётся в IDE (interactive development environment, аналог CAD-систем в классической «железной» инженерии), которые представляют собой некоторые «микроядра» (архитектурный стиль микроядра, где есть общее «ядро» и к нему разные «плагины», реализующие дополнительные фичи). Плагины раньше нужны были как раз для возможности делать синтаксические проверки, а сегодня — для подключения самых разных AI-copilots, AI-assistants, AI-agents.
Простейшие проверки — синтаксические, но есть и более сложные проверки, например, на потенциальные угрозы безопасности. Программный код также будет проверен на соблюдение архитектурных принципов (скажем, проверка выполнения запрета на вызов каких-то функций «мимо» предписанного API), есть инструменты и для этого (они описаны в книгах по архитектуре программ, это разные варианты реализации архитектурного тестирования, fit functions).
Можно ли надеяться на то, что эти проверки надёжны? И да, и нет:
-
Современные системы AI плохо проверяют, плохо находят ошибки290. Так же, как и люди — проблема в том, что и люди, и AI-системы используют нейросети, которые не в ладах с логикой и вычислениями.
-
Но современные AI-системы могут помочь сделать шаг формализации и дать идею на оценку какому-то формальному инструменту проверки (не нейросетевому, а использующему традиционные вычисления). И тогда ошибку найдёт алгоритм, занимающийся традиционными вычислениями.
В любом случае: лишние глаза никогда не помешают, и сейчас такой момент в истории, когда эти лишние глаза не совсем живые.
Чего ожидать дальше? Ещё меньше человеческих рук на пути от идеи к детальной модели, готовой к изготовлению. Примеров тут масса, это центральная тема всей инженерии: от «тёмных холодных фабрик» (заводов-автоматов, ибо нет людей, не надо освещать и отапливать) переход также к «тёмным холодным» конструкторским бюро и программистским фирмам. Обсуждается даже «страна гениев в датацентре»291, поэтому наше руководство не будет тут давать подробности — они устареют в первый же день после приведения примеров, к экспонентам надо относиться серьёзно.
Но что надо понимать, так это общий характер происходящей автоматизации для систем самой разной природы, для всех инженерных специальностей, которые этими системами занимаются. Вот пример такой не слишком обычной инженерии, как инженерия диджейского сета (последовательности треков на танцевальной вечеринке, или на радиостанции)292: музыкальный сервис узнаёт вкусы диджея, предлагая ему послушать самые разные треки и отметить те, которые ему подходят, а затем генерирует диджейский сет, на основании этих предпочтений. Есть ли тут развитие? Конечно! Диджеи работают с уже готовой музыкой. Но сегодня и музыка генерируется вполне сравнимо с созданной людьми293, поэтому можно ставить уже не задачу выбора, а сразу задачу генерации музыки.
Ход на автоматизацию всей инженерии — сегодня важнейший и общий, предметная область и природа систем тут неважны. Скажем, можно выяснить предпочтения того же дизайнера автомобилей, а затем автоматически сгенерировать ряд автомобильных форм, которые будут отвечать этим предпочтениям. Это можно рассматривать и как использование «рекомендательных сервисов», и как использование «парных разработчиков» (программиста, инженера-конструктора, промышленного дизайнера или дизайнера видеоигр, диджея и т.д.). Конечно, требования к результату в «развлечениях» будут пониже, чем в инженерии ракетных систем или разработке корпоративного софта, но прогресс тут довольно быстр и неостановим.
Одна из проблем на этом пути — это планирование каких-то последовательностей преобразований моделей, ибо нейронные сети плохо планируют (хорошо «воображают» статичный результат, но плохо планируют цепочки действий, плохо отслеживают изменения в больших конфигурациях). Поэтому трудно ожидать, что вот прямо сейчас распечатанный на 3D-принтере итог работы «не слишком живого конструктора» будет автоматически и без проблем собран. Но такое сейчас не так просто и беспроблемного происходит и с живыми конструкторами. Прогресс и тут быстрый. И если AI-агенты каждые полгода умнеют с выходом очередной версии, то с инженерами-людьми такого не происходит.
И тут нужно заметить, что само понятие «сборка» (integration, раньше была отдельная стадия — ибо мало что сходу друг с другом собиралось, надо было «дорабатывать по месту напильником» каждую деталь) в современной инженерии отходит на второй план. Современные точно изготавливаемые детали просто складываются вместе — никаких проблем, никаких «доработок». Это обеспечивается точностью проектирования и точностью изготовления. Но есть и другой ход, на 3D-печать. Вместо набора простых деталей можно использовать одну сложную деталь, и сборка тогда включает в себя меньшее число более простых операций (плюс для меньшего числа деталей более простая логистика, а каждое соединение не нужно отдельно проверять). При поломке можно напечатать новую деталь, а не ремонтировать старую. Что можно так напечатать? В ракете Terran 1 компании Relative Space печаталось 85% ракеты (по весу), а цель — 95%294. Печать ракеты (как бы странно это ни звучало) идёт 60 дней, а деталей в этой ракете в сто раз меньше, чем в обычной ракете, и по этой технологии космический корабль уже выходил на орбиту. В сто раз меньше деталей — это при надлежащей точности изготовления минимум в сто раз меньше возможных ошибок при сборке! А цена? В сто раз меньше проверок по сборке, в сто раз меньше логистики на сборке, в сто раз меньше возможных конфликтов конфигурации. Плюс можно каждую следующую ракету делать чуть лучше, чем предыдущую, просто печатая улучшенные детали для этих ракет. Непрерывная разработка, непрерывная интеграция, непрерывное введение в эксплуатацию работают и в аэрокосмосе. В этом проекте не всё безоблачно, ибо при переходе на более большую ракету для скорости пришлось временно отказаться от 3D-печати самых крупных элементов (прежде всего — стенки баков)295, но тренд в сторону 3D-печати очевиден.
Иногда тему автоматизации проектирования (особенно в строительстве) ещё называют «порождающим проектированием» (generative design)296. Но термин, похоже, не будет жить долго: всё проектирование автоматизируется — и скоро проектирование «вручную» будет выглядеть примерно так же, как «рукоделие» (скажем, свитер ручной вязки, а не промышленной вязки), то есть больше хобби, чем серьёзное занятие инженеров.
Задание
Поставьте отметку о выполнении.
- Написан пост, в котором вы рассказываете о вашем следующем шаге автоматизации вашей работы. Что уже удалось сделать, какие планы? Что будет происходить с вашей работой дальше?
7. DevOps
DevOps и инженерия платформы
Как всегда, современное состояние методов системной инженерии нужно смотреть не в «железной» инженерии или каких-то прикладных «не очень инженерных» её видах типа инженерии организаций (менеджмент) или мастерства (образование), но в программной инженерии. Управление жизненным циклом ещё лет пять назад в программной инженерии и системной инженерии считали почти согласованными между собой, и даже более-менее успешно велись работы по унификации стандартов управления жизненным циклом: стандарты методов жизненного цикла «железной» и «программной» инженерий (ISO 15288 и ISO 12207) стремились сделать как можно более похожими друг на друга, но тут оказалось, что если продолжать следовать этим стандартам, то невозможно вести крупные программные проекты типа «информационная система транснациональной корпорации», где надо поддержать вебсайт интернет-магазина с личными кабинетами миллионов пользователей, поддержать финансовый учёт и контроллинг, поддержать управление запасами и работу кадровиков, поддержать собственно проектирование и производство продукции, поддержать свод всего этого для самых разных подразделений компании, раскиданной по многим континентам, и ещё при этом никогда не сбоить и не останавливаться на переналадку. Так что в программной инженерии пришлось много экспериментировать и менять разделение труда, чтобы перейти к эволюционной инженерии. Разделение труда в классической системной инженерии отставало от экспериментов в программной инженерии, но разрыв этот всё меньше и меньше: уже понятно, что даже и разработка ракеты никогда не заканчивается, и разработка автомобиля, и чего угодно, даже зданий и сооружений, которые вроде бы ставятся «на века».
Разделение труда — это ведь задача архитектуры организации: вам надо для модулей-агентов иметь такие назначенные на них функции, чтобы они могли работать по возможности автономно. Сплочённость агентов (связность внутри агентов) должна быть высокой, а связи/зацепления между агентами — по возможности низкими, иначе организация проекта из этих агентов не сможет развиваться по мере развития целевой системы. Это означает, что сработает не любое разделение труда, не любая организация проекта. То, что мы рассказываем тут в руководстве — то, что выжило в ходе многочисленных проб.
Вместо «управления жизненным циклом» и постадийной расстановки ролей вдоль понятного всем «водопада» пришла эволюционная инженерия, и на первый план вышла вот эта эволюционность, непрерывность. Оказывается, систему надо не просто спроектировать/design, изготовить (manufacture или compile and make), один раз собрать/integrate (в том числе испытать/test в собранном виде), один раз развернуть/deploy на месте эксплуатации, один раз ввести в эксплуатацию (deliver). Нет, инкременты надо выпускать по полному циклу разработки по многу раз в день — идея «непрерывного всего», чаще всего сокращаемая до «непрерывной сборки/интеграции» и «непрерывного введения в эксплуатацию», CI/CD.
Архитектор, визионер оказались работающими на уровне целой системы, а разработка ушла во множество асинхронно работающих над разными частями системы команд, которые выпускают множество маленьких инкрементов разных фич. Команды сами принимают решение о том, чтобы выпустить какой-то инкремент пользователю, сами получают обратную связь от тех пользователей, которые пользуются этими новыми фичами.
Но вот кто там изготавливает, собирает/интегрирует, разворачивает/настраивает, вводит в эксплуатацию? Как называется эта роль — которая занимается этим после проектирования/design? Новый инженерный процесс некоторое время пытались называть «гибкой разработкой» (agile development), включая в «разработку» и работу разработчиков/developers, и собственно изготовление-сборку-наладку-ввод в эксплуатацию, которыми в software engineering занимались эксплуатационщики/operators (часто — system administrators, «распорядители системы»). Но термин быстро обессмыслился: гибкий инженерный процесс ещё имел смысл, но традиционный акцент именно на разработке всех сбивал с толку. В гибком инженерном процессе больше всего поменялась не разработка (хотя и тут происходит много интересного, взять тот же vibe coding, он же software 3.0), но отношение к сборке/integration, разворачиванию/deployment, «введению в эксплуатацию»/delovering — при этом ввод в эксплуатацию перестал быть разовой конечной точкой проекта, он стал постоянным, непрерывным (continuous delivery). Конвейер (трубопровод, pipeline, а теперь говорят про «внутреннюю платформу разработки»/ «internal development platform»), который никогда не останавливается и выносит всё новые и новые изменения огромного числа взаимосвязанных новых возможностей (фич) пользователям.
Метод, который заменил традиционное однократное «управление жизненным циклом» на «управление прохождением инкрементов системы от разработчиков к пользователям» получил название DevOps297: работа в смычке разработчиков и операторов. Операторы, они же «сисадмины» в службе эксплуатации системы до появления методов DevOps брали у разработчиков исходные коды базиса (baseline, «административно утверждённая стабильная конфигурация») новой версии софта у разработчиков, компилировала и собирала её в нужном операционном окружении (операционная система, версии СУБД), разворачивала/deploy на «боевых серверах», затем давала доступ пользователям, то есть вводила в эксплуатацию, deliver. «Разработчики отдают, а системные администраторы принимают» — это было наследием водопада, неудачность такого разделения труда (его часто ассоциировали с «перебрасыванием через стену»: разработчики изготавливают код системы, а потом перебрасывают его через высокую кирпичную стену службе эксплуатации, operations — и там хоть трава не расти, «обязанности разработчиков выполнены») была очевидной. Поэтому появилось «движение» (как общественное движение: принципы ясны, но нет общего центра, который бы отслеживал чистоту идеи — реализация везде была уж какая получалась, не было «предписанного умными людьми верного метода») DevOps: «соединения труда», ранее разделённого на труд разработчиков (Dev) и труд операторов-сисадминов (Ops). DevOps провозглашало ответственность разработчиков за то, что происходит там у операторов, то есть «разработчики сами администрируют свои работы, ибо только они понимают, что это они разработали».
В DevOps постепенно включили и поддержку тестирования, и мониторинг, и управление конфигурацией, и много чего ещё, и ещё было много путаницы от начальной формулировки целей DevOps (Development, Operations) как «устранение противоречий между разработчиками и службой эксплуатации/системными операторами». Разработчики начали осваивать agile-разработку и стали готовы выдавать не одну версию системы в год (ну вот примерно как сейчас выходит версия операционной системы Android или iOS), а одну версию системы в день (ну вот примерно как сейчас выходят версии операционной системы Windows, чуть ли не каждый день какое-то обновление), а после автономизации команд — и множество версий в день. Системные администраторы при выходе каждой новой версии должны были её развернуть, оттестировать, аккуратно перенести в неё пользовательские данные, а потом иметь вал запросов от пользователей по поводу устранения новых ошибок, которые разработчики явно не спешили устранять, ибо они были заняты уже новыми фичами.
Возник неожиданный конфликт: сисадмины попросили разработчиков выпускать свои релизы не быстрее, а медленней! Разработчики при этом говорили, что не могут — клиенты ждут новых фич! Сисадмины тогда просто начали пропускать новые версии софта: продолжали работать на старых, иногда годами. Ибо «всё работает, не надо чинить не поломанное». Новые фичи перестали доходить до клиентов, это было массово.
Поэтому и появилось движение DevOps как решение этих проблем: «ответственные разработчики взялись помочь операторам (системным администраторам) и создали DevOps». Это понималось очень по-разному, например иногда как «теперь разработчики у нас ещё и системные администраторы, эти службы объединили!». Но жизнь пошла не по пути «объединения служб под одним начальником, который как-нибудь разрулит их конфликты».
Очередная проблема возникла, когда «ответственные разработчики» пришли к «безответственным сисадминам» — и обнаружили, что те таки реально не справляются, новые версии системы устанавливались тяжёлым ручным трудом. Поэтому первое, что начало происходить — «завод по изготовлению работающего софта из исходных кодов» начали автоматизировать. Появилось огромное количество технических приёмов по интеграции/сборке программных приложений и более-менее безопасному (а вдруг ошибки?!) их вводу в эксплуатацию.
Появилось множество новых видов софта, автоматизирующего и интеграцию результатов работы отдельных команд в целую систему, и инженерное обоснование успешности системы: прежде всего разнообразное тестирование, включая и функциональные тесты, и тесты на соблюдение архитектурных решений/fit functions, и включая многочисленные варианты тестирования на надёжность, типа случайного отключения крупных частей системы, чтобы проверить работоспособность в условиях катастрофы — chaos engineering, а ещё мониторинг защиты/security. Новые инструменты вели мониторинг уровня дефектов в системе, они собирали отклики пользователей, и так далее. По факту все эти новые инструменты делали части того, что потом назовут «внутренняя платформа разработки», конвейер/трубопровод каких-то «деталей системы с новыми функциями» от многочисленных команд разработчиков, за которыми присматривают архитекторы, собирающийся в целую систему, тестирующийся и предоставляющийся в конечном итоге пользователям системы.
Сисадмины по факту перестали существовать, появился термин IaC (infrastructure-as-code)298, когда под это движение DevOps подстроились инженеры компьютерной аппаратуры: конфигурирование и настройка компьютеров стали тоже происходить без нажатия на физические кнопки, а специальными программами. Повторить конфигурацию платформы — это нажать кнопку, чтобы прогнать код, который всё-всё настроит. А раньше? Скрипта не было, было выполнение руками многочисленных операций типа «скопируй вот эту программу отсюда туда, укажи ей адрес, по которому лежат её данные», а операции делались «согласно документации» и «записям в записных книжках» самых опытных сисадминов.
Похожий метод получил название SRE (site reliability engineering, инженерия надёжности сайта, причём необязательно именно веб-сайта), он появился даже раньше DevOps, в 2003 году в Гугле. После осознания роли автоматизации было даже предложено переименовать DevOps в NoOps299, похожие методы стали появляться в самых разных инженериях XOps (MLOps, PlaftormOps, DataOps, и т.д.300). Появились конференции DevOps, учебные курсы/руководства/стандарты/регламенты DevOps, люди начали себя называть DevOps, если они работали в этой роли в инженерии.
И тут появилось ещё одно интересное следствие, повлиявшее на разделение труда: разработчики получили в руки сложнейший набор разнообразного софта по автоматизации, инструментов DevOps (как их начали называть). Результаты автоматизации породили множество специализированного универсального софта, который надо был как-то адаптировать к условиям текущих проектов, к закупленным операционным системам, мощностям датацентров, соединять в какие-то «трубопроводы/конвейеры». Самые разные программы «DevOps» занимались тестированием, упаковкой приложений в контейнеры для операционной системы, мониторингом работоспособности, балансированием нагрузки — пара десятков типов «инструментов DevOps», каждый из которых представлен какими-то конкурирующими версиями инструментов от разных провайдеров. Это всё равно как дать конструкторам из конструкторского бюро обязанность выбирать у поставщиков машиностроительных станков разные версии всех этих «обрабатывающих центров», «измерительных стендов», «упаковочных станций» — настраивать их и работать на них, чтобы вручать клиенту не чертежи, а работающую уже собранную и проверенную конструкцию. А завод? Ну, это ж идея DevOps — проектировщики вроде как должны были стать и заводчанами, поэтому дальше у них не должно было быть конфликта с заводчанами!
Вот типичная картинка301, которую приводят, когда описывают инструменты/«станки» для DevOps в программной инженерии:
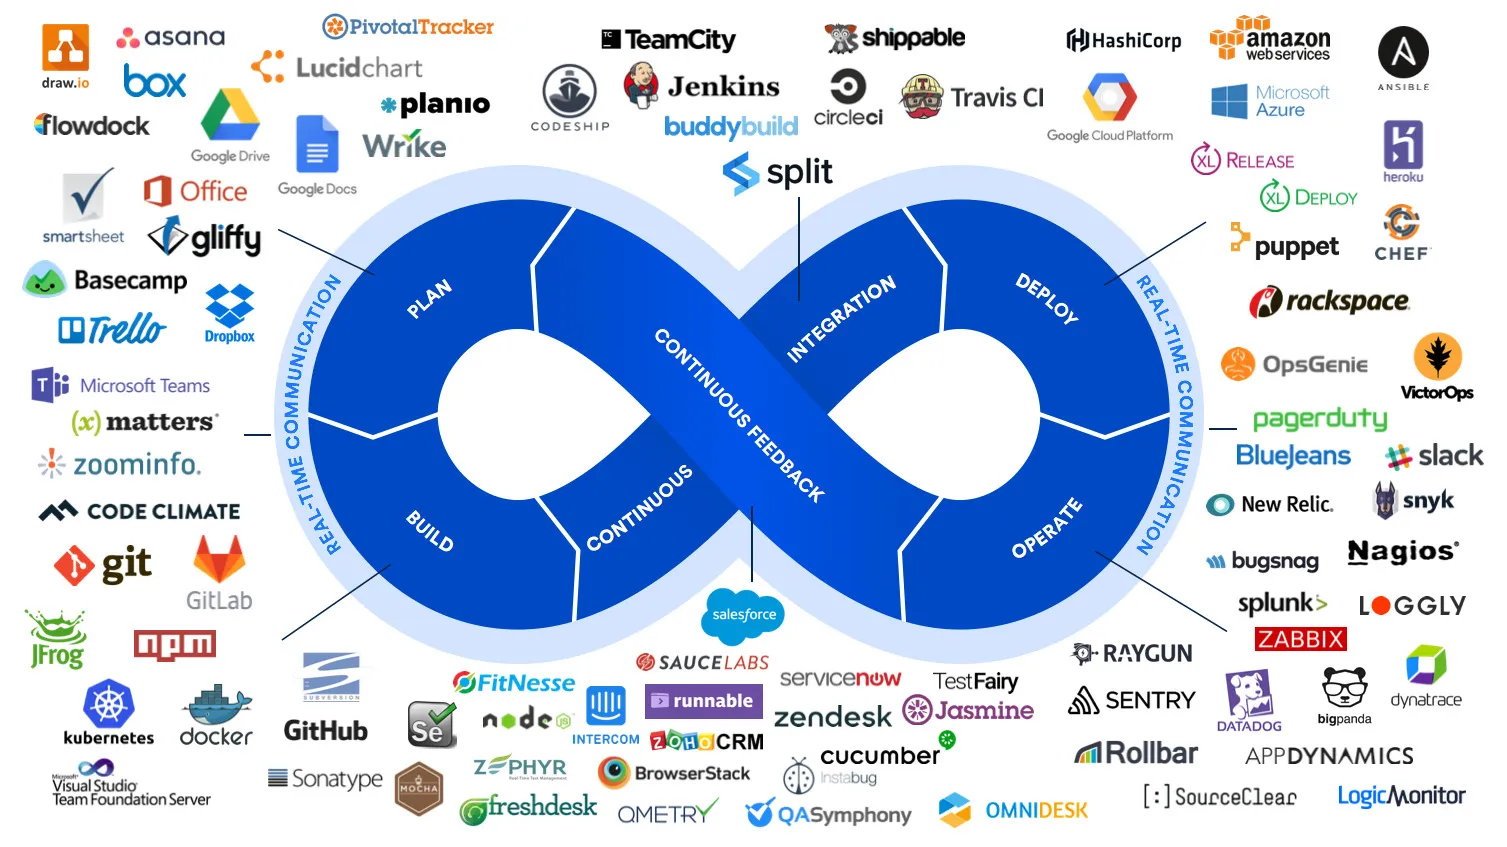
Понятно, разработчики не справились: они начали повсеместно «выгорать» от этой новации, им некогда было уже разрабатывать новые фичи целевого софта, они непрерывно разворачивали и переналаживали свой «конвейер», свой «трубопровод» по выпуску софта. Решение было в
-
выделении отдельной роли для этой деятельности — инженер внутренней платформы разработки (internal development platform). Обязанность — закупить и развернуть весь этот софт платформы (инструменты DevOps), настроить его для выпуска целевой системы, а также научить разработчиков работать с этим уже развёрнутым и настроенным софтом.
-
Объявлении этой внутренней платформы разработки продуктом, который оказывает сервис разработчикам, и поэтому там должны быть соблюдены все принципы продуктовой разработки для клиента (customer development), разработчики — «внутренние клиенты».
-
Сохранении основной идеи DevOps, иногда формулируемой как «ты это построил, ты это и эксплуатируй» (you build it, you run it), разве что в руки разработчики получают готовый инструмент-завод, а не полуфабрикат «сделай себе свой завод сам», «платформу разработки собери и настрой сам». Нет, завод тебе создадут — и дадут готовый.
Platform engineering — это не отдельная от DevOps идея, это развитие идеи DevOps — просто оказалось, что для исправления ситуации разделения труда между разработчиками и системными администраторами нужно выделить ещё одну деятельность/культуру/инженерию — инженерию внутренней платформы разработки (internal development platform, и помним, что платформы бывают очень разные, сегодня модно вообще любую систему называть «плафтормой»). Это верно и для разработки «железа», в жизни сегодня встречаются три основные ситуации:
-
Аутсорс завода. Plaftorm-as-a-service, инженеры платформы сдают свой завод в аренду. Более того, на этом заводе может быть ещё и свой технолог, то есть разработчикам не надо «производить на заводе», они «отдают информационную модель» («чертежи» тут в далёком прошлом) — получают или полуфабрикат, который собирают-настраивают, или даже готовое изделие, которым уже можно пользоваться. Конечно, чтобы стать «платформой», заводу приходится быть универсальным. Например, на заводах ставятся универсальные обрабатывающие центры (CNC, computer numerical control302 machines, станки с ЧПУ) и 3D-принтеры (additive manufacturing). Вот это отделение заводов от конструкторских бюро и универсализация производства — это тренд! Найти описание этого тренда можно в обзоре «Platform-based manufacturing303». Это всё может описываться как «оборудование-как-сервис» или «производство-как-сервис», но всё сводится к тому, что вместо тесной связи конструкторского бюро с заводом заказ «размещается где-то в Китае», а вместо «тесной связи» работают цифровые стандарты. Платформа — это прежде всего стандартизация интерфейса её использования. В программировании всё то же самое: где-то «в облаках» размещаются платформы, которыми можно воспользоваться, их много, совершенно неважно кто их поставщик. В итоге мы имеем производственную сеть (manufacturing network). Проблемы? Их много. Например, государство может решить, что ваше предприятие не должно пользоваться чужими платформами, или владелец платформы решил, что вам нельзя пользоваться его платформой. Но эти проблемы решаются, тренд неостановим. Вы просто перейдёте с самой выгодной платформы на чуть менее выгодную, это не займёт много времени (хотя придётся помучаться немного, vendor lock-in304 реальная проблема) — там будет, скорее всего, примерно тот же стандарт интерфейса, примерно те же правила пользования. Это очень удобно, когда «завод» может быть даже анонимным. Но, повторим, возникают специфические проблемы доверия и надёжности в такой среде.
-
Ровно обратное от предыдущего пункта: если производство раскидано по самым разным платформам, то вы можете оказаться в ситуации непрерывного ведения переговоров по поводу размещения заказов, логистики, срывов сроков поставок, трудности проведения изменений и согласований характеристик. Поэтому вы делаете собственное производство, отдавая на аутсорс для изготовления минимум. И получаете резкое ускорение: внутрифирменное согласование обычно много быстрее, чем внешнее. Ровно это произошло в космической промышленности: крупные контракторы NASA выполняли как один из приоритетов задачу раскидывания космических заказов по огромному числу мелких производств. И всё там поэтому было медленно, ненадёжно, дорого. SpaceX поменяла правила игры: основное по проектированию ракет и их производству собрала у себя, внутри фирмы. Минимум аутсорсинга. Только внутренняя платформа разработки. И дальше было продемонстрировано, что это в разы и разы быстрее, чем раскидывание заказов по «производственной сети».
-
Внутренняя платформа разработки, чаще всего обсуждается в рамках движения DevOps. Попытка универсализации и стандартизации, как в первом варианте «аутсорс завода», но «производственная сеть» создаётся на собственных мощностях, «внутренняя/internal платформа», а не «внешняя».
Все эти тренды работают одновременно. Иногда даже обсуждаются «стратегические приёмы», например, чтобы поддерживать конкурентоспособность своей платформы, её заставляют продавать часть услуг для чужого аутсорса — и если не удаётся, то считают, что «неконкурентоспособна». Понятно, что у всех подобных инициатив есть и горячие сторонники, и горячие противники. Гибридных форм тоже более чем достаточно, но в итоге бал правит некоторое количество общих идей, которые выигрывают независимо от того, как это раскладывается по фирмам:
-
Инструментарий изготовления чего бы то ни было рассматривается не изолированно друг от друга, а как составная часть «производственной платформы» (внутренней или внешней — это уже неважно).
-
Платформа должна быть удобна для использования разработчиками, клиентами и пользователями платформы считают разработчиков, а не пользователей конечной произведённой продукции. То есть пользователей произведённой системы и пользователей производственной системы не путают. Создатель системы и создаваемая система — они отдельно! У каждой есть свои клиенты. В некоторых случаях разработчики — «внутренние клиенты», но это не меняет к ним отношения.
-
Инженер платформы отвечает за закупку оборудования, логистику и общую готовность платформы к работе. Но он не отвечает за то, что на этой платформе производится. За это отвечают разработчики.
-
А кто же всё-таки производит? Вопрос сегодня сложный, но чаще всего ответ — «никто», производит сама платформа. Завод сегодня — это завод-автомат. Даже если там есть какие-то работники внутри, они не считаются «работниками, с которыми можно договариваться о производстве». Нет, они «части машины», интерфейса к ним нет (платформа — это модуль, видимость того, что происходит внутри, ограничена).
-
Платформа представляет разработчикам стандартизированный интерфейс, стандартизированное управление.
Вот учебник «The DevOps Handbook» (второе издание, 2021), в котором рассказывается о практике DevOps как совокупности технических и организационных решений:
Основной целью метода DevOps (помним, что «инженерия платформы» — это просто развитие идеи DevOps, это не отдельное течение, так что обсуждение касается и инженерии платформы) заявляется поддержка постоянного введения в эксплуатацию (continuous delivery). По факту же это существенно модифицированный метод «управления жизненным циклом», преобразованный согласно идеям agile для ситуации эволюционной/непрерывной разработки, эволюционного/непрерывного принятия архитектурных решений и непрерывного (тут реже говорят «эволюционного») введения в эксплуатацию. Отсутствует собственно «жизненный цикл» с его стадиями, система инкрементально развивается, а не замысливается-проектируется-изготавливается-испытывается-вводится в эксплуатацию-эксплуатируется. «Жизненный цикл» остался только там, где в головах по-прежнему идея «водопада». Например, в госпроектах: там вся система финансирования выстроена ровно под это, «что заказали, то и получили».
Заметьте, что мы тут разделяем «что в жизни» и «как мы описываем жизнь». Сам инженерный процесс может быть устроен вполне по-современному, гибко. Но вот обсуждение с менеджерами и заказчиками будет всё равно «водопадным», то есть будут и требования, и разовые (а не постоянные) инженерные обоснования. Проблема тут в том, что описание жизни оказывается оторванным от собственно жизни: люди работают не так, как они это описывают. Мы тут даже не будем обсуждать, к чему такое приводит. Скажем, вы ремонтируете транзисторное устройство, а у вас принципиальная схема его нарисована с радиолампами, да и все менеджеры говорят про радиолампы, а про транзисторы можно говорить где угодно, только не на официальных совещаниях. Будет ли работать транзисторное устройство? Да, будет, но «вопреки»: не спрашивайте про сроки, стоимость, нервы всех участников проекта.
Инженерная жизнь в 21 веке существенно поменялась (в 2003 году вышел agile manifesto и появился в Гугле SRE, первая конференция по DevOps прошла в 2009 году), сегодня DevOps и инженерия платформы — это «метод по умолчанию» в программной инженерии, и потихоньку распространяется на другие виды инженерии. Суть производства поменялась: вместо выпуска одной хорошо отлаженной системы надо уметь выпускать много-много версий хорошо отлаженной системы, в каждой из которых есть много мелких и крупных изменений — при этом от всех этих многочисленных изменений качество продукта не падает, а растёт.
А ещё инженерия производственной платформы очень проблематична в части описания разделения труда в инженерии:
-
Традиционно DevOps и тем самым инженеров платформы включали и обсуждали как входящих в команду инженеров-разработчиков (в этом-то и был смысл затеи! Вернуть функции и людей Ops в функции и состав Dev!). Потом оказалось, что жизнь поменялась, и у нас scaled agile, поэтому DevOps и роль «инженер внутренней платформы разработки» ушёл из разработчиков-в-командах на уровень проекта — туда, где архитектор и визионер. Но по-прежнему это относилось к «инженерам в целом». Менеджеры рулили «инженерами», которые разрабатывали систему, в инженерах были разработчики, архитекторы, визионеры, инженеры платформы.
-
Но если обратить внимание, что продуктом инженеров платформы является платформа, которая предоставляет сервис разработчикам, среди которых в том числе и архитектор (платформа нужна для того, чтобы там выполнялись fitness functions), и визионер (который отслеживает выдачу фич), то становится понятно, что «инженер системы» и «инженер завода» — это разные инженеры, и с «заводом» (платформой) можно разворачивать полноценную инженерию. Инженер платформы (роль) тем самым включает визионера, архитектора, несколько команд разработчиков (функциональные проектировщики, проектировщики, технологи, операторы) и даже инженера внутренней платформы разработки внутренней платформы разработки! Действительно, в программной инженерии это рассматривать как-то не очень наглядно (ну, «программисты и программисты», с точки зрения менеджмента), но если взять инженеров ракеты и инженеров ракетного завода, то это же оно и есть! При этом ракетный завод сделать существенно трудней, чем ракету! Автомобильный завод сделать существенно трудней, чем автомобиль! Элон Маск недаром говорил, что «выпустить прототип лучшего в мире электромобиля — это очень легко, но вот наладить массовое производство с конкурентоспособной ценой — вот это трудно». Так что инженеров платформы можно и не рассматривать как входящих в команду инженеров проекта целевой системы, можно считать их инженерами совсем другого проекта.
А как же с общностью идеи инженерии платформы для систем самой разной природы? Всё в порядке:
-
В фирме, которая выпускает мастерство (например, университет) собственно производство представляет собой деканат. Вот инженеры платформы — они разрабатывают, производят, настраивают и являются операторами деканата (конечно, чаще всего сотрудники деканата совмещают в себе роли и инженеров деканата (создатели деканата), и работников деканата (частей созданного деканата). Подробней про это в руководстве по инженерии личности, которое рассказывает о методах инженерии мастерства.
-
В менеджменте какого-то предприятия, инженеры платформы — это создатели «администрации». Администрация — это и есть «внутренняя производственная платформа» для коллектива, то есть бухгалтерия, заведование хозяйством, «кадры», канцелярия, и так далее. Подробней про это в руководстве по системному менеджменту, которое рассказывает об инженерии предприятия.
Составляющие DevOps
Современный метод непрерывного ввода в эксплуатацию (DevOps) отличают от методов управления работами (work management, operations management). Администрирование функционирования/работы (operations) целевой системы — DevOps, а вот администрирование функционирования/работы (operations, works) предприятия — это операционный менеджмент. Их различение уже рассматривалось в руководстве по методологии.
Несмотря на то, что сегодня практически везде переходят на DevOps, во многих и многих «железных» проектах остаётся ещё старинный вариант управления жизненным циклом, ибо не столько даже инженеры, но менеджеры продолжают считать, что текущий такт разработки — последний, да и «водопад назад не течёт!». Это и есть «опыт»: двадцатилетний опыт чаще всего — однолетний опыт двадцатилетней давности, повторённый двадцать раз. Бойтесь своего опыта! Чем больше лет вашему опыту, тем подозрительней!
Как специалисты DevOps любят указать, что «наши методы подойдут и для организации водопадной разработки, просто используйте их не все, применяйте творчески», так и специалисты по управлению жизненным циклом любят заметить, что «для agile у нас тоже отлично всё работает». После этого возникают довольно причудливые сочетания самых разных методов организации работы в проекте. Надо не обращать внимания на названия, которые используют, а обращать внимание на объяснительные теории, на которых базируются используемые в проекте методы, проверять обоснование этих методов. Упоминавшаяся уже книга «Accelerate» как раз подробно об этих исследованиях разных вариантов организации выпуска продуктов рассказывает. Исследования обычно убедительно показывают, что интуитивные представления о том, как надо работать, непродуктивны. Лучшие методы работы — контринтуитивны. Не поленитесь-таки прочесть «Accelerate», убедиться, что ваша интуиция не противоречит реальности.
DevOps — это метод выполнения в проекте правильных работ по правильным методам с правильным инструментарием. Какие «рабочие процессы»/«методы работы»/практики входят в составляющие DevOps?
Управление конфигурацией (configuration management). Работы проекта будут выполняться со всеми появляющимися в ходе проекта конфигурационными единицами (configuration item)305, и ни одна из этих конфигурационных единиц при этом не будет забыта, потеряна, перепутана. Вот это «не забыть, не потерять, не перепутать, для этого в проекте надо всё уникально именовать, знать, где что лежит и в каком состоянии находится» выполняется методом управления конфигурацией (configuration management)306. Конфигурация системы — это набор конфигурационных единиц, представляющих собой систему в какой-то заданный момент времени (по умолчанию — текущий момент). Конфигурация системы — это сама система, не её описание! А что с описанием? Можно говорить о конфигурации описания, из чего состоит в какой-то момент времени описание. Это означает, что мы знаем, что вчера в системе был модуль А с серийным номером 234, а сегодня это модуль Б с серийным номером 345. Мы знаем, что в описании системы вчера была принципиальная схема версии 4, а сегодня уже там версия 5. И мы не путаем разные конфигурации — вчерашнюю и сегодняшнюю. Когда система собрана из частей, которые не соответствуют друг другу — это конфигурационная коллизия, ) считается большой бедой проекта.
Выбор и непрерывное развитие/адаптация «методологии разработки»/«инженерного процесса» (раньше — «определение вида/модели жизненного цикла», причём без непрерывного развития, а «раз — и навсегда»). Этот метод был подробно разобран в руководстве по методологии, а в нашем руководстве по системной инженерии как нормативной дисциплине говорится о том, что вариант «методологии разработки»/«инженерного процесса» нужно выбрать явно, адаптировать, развивать в ходе всего проекта, организовывать работы всех участников проекта в соответствии с ней. В разработке софта сегодня предпочитают разные варианты гибкой разработки/agile, в разработке киберфизических систем на сегодня до сих пор можно встретить разные старинные варианты вроде V-модели, но уже понимается неизбежность принятия гибких методов разработки «железа». В инженерии предприятия (менеджменте) сегодня говорят о непрерывном стратегировании, о циклах непрерывного совершенствования. Во многих других сферах (например, инженерии личности, в сфере медицины) на эту тему особо не разговаривают, и этот «неразговор» — большая ошибка. Даже если инженерный процесс де-факто формулируется как «не интересоваться, какие у нас основные альфы, как мы планируем и отслеживаем изменения основных альф», это нужно проговорить в проекте явно, выбор даже отсутствия обговорённой методологии инженерного процесса должен быть сделан явно. Если вы начинаете новую разработку, то не факт, что вам удастся сразу реализовать современное разделение труда и преодолеть ограничения мышления об однократном прохождении «водопадного» жизненного цикла. Конечно, сам инженерный процесс по факту будет идти как описано у нас в руководстве (догадки как гипотезы, много итераций по инкрементам), но всё-таки содержать много лишнего (типа обязательной разработки требований и связанного с этим «испорченного телефона», подготовки отчётности, которую никто не читает), в нём наоборот, не будет многих методов DevOps и инженерии внутренней платформы разработки как выделенной инженерной работы.
Людей в проекте нужно будет научить выбранному методу работы в целом, выбранному инженерному процессу. Если не научить, то каждый будет работать, как считает нужным — в результате будет огромное количество лишней работы, переделок, а часть необходимой работы не будет выполнена — о ней никто не вспомнит!
Регламентация: для выбранного метода инженерной работы («инженерного процесса») в целом надо выбрать его составляющие прикладные методы, подходящие для природы систем в вашем проекте, начать организовывать работников на их выполнение — и продолжать это в ходе всего проекта. Этот выбор метода делают инженеры, но вот затем сделать так, чтобы люди и инструменты ему следовали — это часть задачи менеджеров, оргразвитие. Получается, что оргразвитие в существенной мере (содержательная часть регламентов работы, предписанный метод работы) определяется не менеджерами, а инженерами. Не знаешь, какие методы нужны для работы — не можешь организовать на их выполнение людей и AI с необходимыми инструментами.
Стандарты, регламенты работ, нормативно-справочная информация, чеклисты — это всё тут. Чем больше это похоже на бюрократическую заводскую разработку по военным проектам (где главное — это не результат, а кто будет сидеть в тюрьме за ошибки, «сбор улик»), или на медицину (где врач три четверти времени заполняет бумажки, подтверждающие, что он следует процессу), или на любую другую зарегулированную насмерть государством отрасль (атомная энергетика, строительство), тем менее эффективна будет работа в проекте, не lean, не элегантна, много лишней работы. Но если работ регламентации не делать — то наладить коллективную проектную работу не удастся, каждая роль будет работать «каким-то», а не нужным для проекта методом, результаты работы всех ролей будут «какими-то», а не нужными, часть работ по важным методам окажутся пропущенными (например, часто пропускают работы по инженерным обоснованиям).
В этом месте излишнего бюрократического увлечения регламентацией часто получают какие-нибудь «службы качества», занятые тем, что пишут регламенты работы (например, следуют стандартам серии ISO 9000 в написании «процессных регламентов»): вроде как если есть жёсткое следование регламентам, это должно поднять качество. Но нет, эксперименты показывают, что стандарты эти не влияют на качество. Поэтому сейчас принято «покупать сертификацию», использовать эти стандарты для того, чтобы предъявлять как формальный аргумент «заботы о качестве» (полностью эквивалентно покупке вузовского диплома: этот формальный документ иногда важен, но по факту никогда не свидетельствует о реальном мастерстве). Надо запомнить, что в этой регламентационной работе надо попасть в goldilocks — не переборщить, но и не пустить работу в части методов на самотёк, не отдать всё в «устное согласование» — и помним, что содержание работ обычно идёт от инженеров, но вот бюрократические навороты обычно идут от менеджеров, менеджеров надо сдерживать в их бюрократических аппетитах. Это и есть принцип lean/элегантности, минимально необходимая работа делается, но не более, и не менее.
Вот книга Donald Reinertsen, «The Principles of Product Development Flow: Second Generation Lean Product Development» (2009), она посвящена операционному управлению для элегантности в работах, то есть управление минимальностью работ в проекте.
В этой книге вводится принцип «E6: The U-Curve Principle: Important trade-offs are likely to have U-curve optimizations». Этот принцип гласит, что если у вас есть две переменные, влияющие на производительность труда в разные стороны, то результат чаще всего будет U-образной кривой (или инвертированной U), при этом не требуется очень большая точность — ибо в этих кривых нет ярко выраженных пиков.
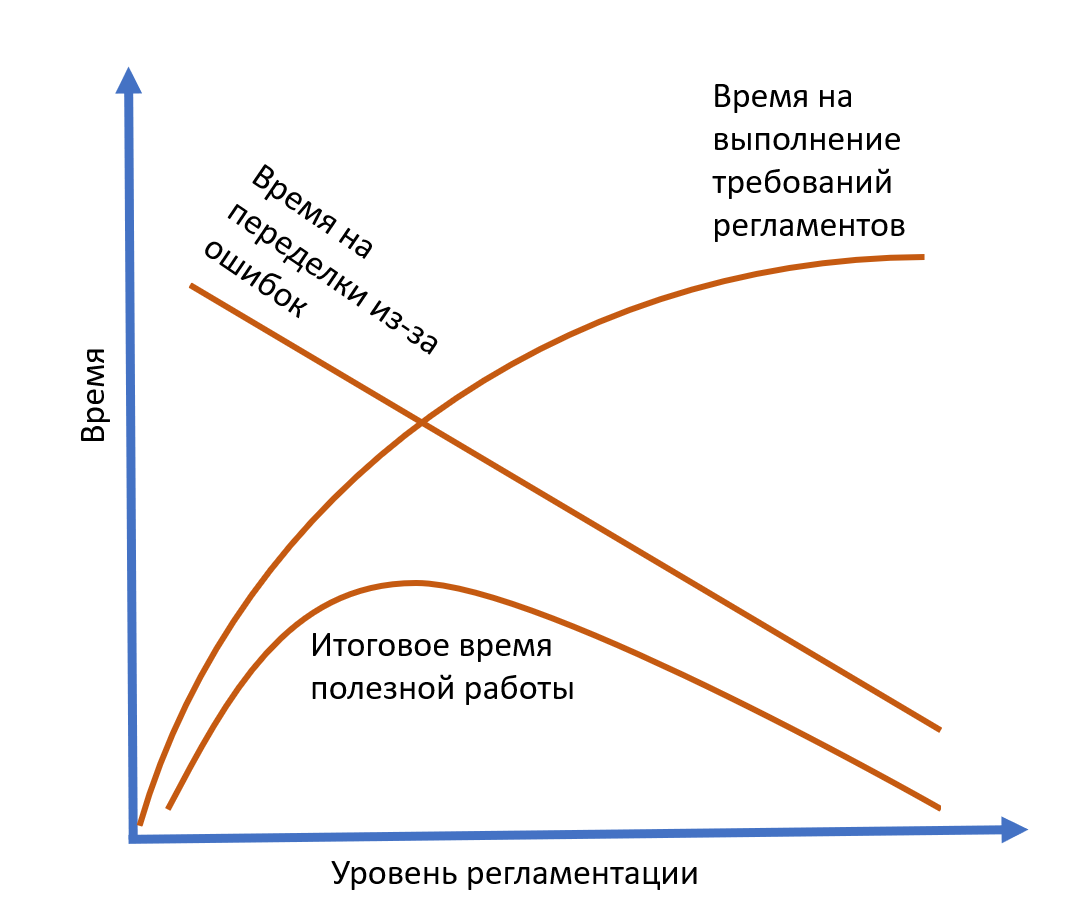
При отсутствии регламентации («делай, что хочешь»), производительность мала, силы тратятся на бесчисленные переделки. При оптимальной регламентации (организованная работа по методу) скорость оптимальна. При уровне регламентации выше оптимума будет много лишних действий на выполнение ненужных уже регламентов, и уменьшение ошибок в выполнении работ уже не компенсирует потери времени на выполнение лишних регламентированных действий. И это даже в ситуации, когда лишние действия действительно снижают число ошибок! В этом весь принцип элегантности: делать и регламентировать только то, что нужно, ничего лишнего! Элегантность даёт высокую скорость работ за счёт того, что не нужно выполнять лишние работы.
Опять подчеркнём: метод, по которому работать, задают инженеры, ибо они знают, что надо делать — а менеджеры (операционные менеджеры) должны проследить, чтобы следование методу было, регламентация работ была, но они не были чрезмерными. Итальянская забастовка (work-to-rule)307 — это «работа по всем правилам», это правый край диаграммы. Не организуйте саму работу как итальянскую забастовку! При этом, конечно, если работу не организовывать, правил нет, методы не заданы и их выполнение не отслеживается (например, по чеклистам), то это тоже забастовка — левый край диаграммы.
Качество продукта обеспечивается не строгим следованием письменной процедуре, а быстрым внесением изменений в процедуры, в дизайн продукта, непрерывным улучшением, а не дословным выполнением стремительно устаревающих жёстких инструкций. Иногда этот метод совмещают с методом compliance (проверка соответствия стандартам, требуемым законодательством), но compliance больше соответствуют методам управления жизненным циклом — проверка идёт один раз, и далее считается, что «ничего не меняется, соответствие есть». Действительно, это очень дорого — проводить независимое сертифицирование с участием представителей надзорных органов каждый раз, когда меняется конструкция, а она меняется часто. Выход тут всё-таки в прогоне полных тестов для каждой модификации целевой системы, чтобы убедиться этому соответствию — но также в тесты входят и fitness functions, и тесты защиты, и функциональные тесты. Поскольку каждая модель автомобиля Tesla или ракеты SpaceX имеет модификации в силу «полного agile» на производстве, то принята стратегия полных испытаний/тестирования каждого экземпляра — а удешевление тут идёт за счёт автоматизации тестов.
Чеклисты по сути — те же проверки, что работы выполнены, состояние системы достигнуто. Но они проверяют не только конечное, но и промежуточное состояние. Прохождение чеклистов, конечно, тоже надо автоматизировать. Но «ручные» чеклисты имеют встроенный в себя механизм удержания работы по документированию выполнения методов: по ним проверяется не абсолютно всё, а только самое важное (и это отдельно обсуждалось в руководстве по методологии и в книге Atul Gawande «The Checklist Manifesto»).
Чеклисты задаются регламентацией (пишутся регламенты и шаблоны чеклистов для отслеживания состояния важных объектов проекта, а агенты — люди и AI — обучаются выполнять метод из регламента и заполнять чеклисты по ходу его выполнения). Состояние важных объектов отслеживается в рамках учёта конфигурации. «Чтобы заполнить что-нибудь ненужное, надо сначала задать шаблон ненужного»: регламентация предшествует конфигурационному учёту.
Почему мы вдруг отвлеклись и заинтересовались производительностью труда, операционным менеджментом, регламентацией, мы же вроде обсуждаем DevOps — работу инженеров? Ops из DevOps — это operations, ими занимаются операторы/администраторы, которые вроде обязаны в platform engineering воспринимать разработчиков как клиентов (в фирме — это администраторы, которые обязаны воспринимать сотрудников фирмы как клиентов, в вузах — это деканаты). Но на деле разработчики оказываются от них крайне зависимыми, избежать выполнения требований (да, тут — «требования», деонтический аспект и никаких отмен, «раз и навсегда установлено») администраторов нельзя, и если требования неоптимальны, то вы получаете итальянскую забастовку сотрудников — и эта забастовка против воли сотрудников, она организована менеджерами, которые просто не отследили лишние требования по организации работы.
Что тут говорит литература по методам инженерии платформы? «Надо найти оптимальный баланс между жёстким механически работающим конвейером и возможностью вносить изменения в эту жёсткую механистичность» — проблема понимается, но решение проблемы отдаётся в конкретные проекты, общих рекомендаций тут нет.
Конфигурационный/операционный учёт самих «предметов работы»/«рабочих продуктов»/артефактов и документированных их описаний. Эти описания часто в инженерии называют «данными жизненного цикла»: всё что угодно, документированное в разные моменты времени проекта, отсюда и отсылка к «жизненному циклу» в попытках сказать «в ходе всего проекта», то есть в ходе создания и развития системы, включая эксплуатацию. Это именно операционный/менеджерский учёт, часть не столько инженерии, сколько менеджмента, ибо учётные единицы тут рассматриваются не содержательно, а чисто логистически: «взял физические объекты и данные на хранение, учёл и сохранил, ничего не потерял и не добавил, не исказил, нашёл по запросу и передал кому надо — но что там внутри, неважно». Иногда операционный учёт считают управлением конфигурацией — но нет, это только часть управления конфигурацией (учесть/документировать — это ещё не управлять! Учесть/документировать направление движения автомобиля — это ещё не рулить/управлять!).
В DevOps тоже рассматривают версионирование (для описаний) и управление конфигурацией (для целевой системы), на этом основан метод непрерывной интеграции (continuous integration, в любой момент времени есть готовый целостный вариант системы). Часть этого метода — магистральная разработка/trunk-based development. Управление изменениями (change management, когда инженеры превращаются в аналитиков и «готовят предложения: запросы на изменения», а кто-то внешний потом их рассматривает и либо принимает, либо нет) в виде независимого принятия решений какой-нибудь «комиссией по изменениям» экспериментально было показано, что не работает (см. подробности в книге «Accelerate»).
Это очень контринтуитивно, но команда сама принимает решение, что ей добавлять в общий продукт, какие вносить изменения. Нет долгоживущей версии baseline/базиса (что считалось ключевым в управлении жизненным циклом 20 века), нет трудной для разработчиков жёстко регламентированной и крайне медленной процедуры внесения изменений в этот базис. Более того, одновременно в работе (например, при A|B-тестировании) могут находиться несколько версий системы, все они «главные», и все они экспериментальные/рабочие. В любой момент жизни системы она рассматривается не как окончательная конфигурация на базе окончательной версии описаний системы, полученных из разработки, но как «текущая», которая будет меняться много раз в день. Поиск конфигурационных коллизий, «разваленной/broken конфигурации» — как раз в конфигурационном учёте.
Логистика рабочих продуктов и документов/данных с акцентом на передачу результатов очередным исполнителям в инженерном процессе, иногда говорят об «управлении выпуском», если «очередные исполнители» — это пользователи. Совместно с конфигурационным учётом и учётом изменений логистика оставляет в проекте коллективное понимание того, что и где находится в каждый момент времени, кем и когда изменяется, каковы результаты изменения. Тут и физическая логистика (всякие конвейеры и склады, трубопроводы и прочий транспорт), и «логистика данных». Цель: каждый важный объект в проекте должен быть предоставлен тем, кому он нужен для работы в тот момент, когда он нужен. В случае физической логистики этим занимается операционный менеджмент (под разными названиями, например supply chain management, enterprise resource management), в случае логистики данных говорят про «управление информацией»/«интеграции данных жизненного цикла»/«цифровой нити».
Инженерные обоснования и связанные с ними испытания/тестирование (включая функциональные тесты, архитектурные fitness functions, тесты защиты/security, а также мониторинг в ходе эксплуатации) рассматриваются в DevOps и инженерии платформы как составные части метода, требующие какой-то поддержки специализированными инструментами (испытательные стенды, сигнализация, разворачивание цифровых теней и двойников). DevOps инженеры (инженеры платформы) учитывают «сдвиг влево» у разработчиков и обеспечивают надлежащее выполнение тестов по защите и использование методов защиты разработчиками. Иногда даже пишут DevSecOps, чтобы отразить необходимость превращения разработки в учитывающую необходимость защиты и тестирования защиты в ходе всей разработки, «культуру безопасности» (на самом деле — «культуру защиты», ибо «безопасность» тут safety, «наша система никому не причинит вреда», а «защита» — это security, «никто не причинит вред нашей системе»).
Тут тоже разночтения: DevSecOps как метод работы защитников «такой же, как у DevOps» против DevSecOps как трансформацию DevOps для учёта «сдвига влево» не только тестирования, но и мероприятий по защите. Иногда поэтому «цикл Sec» изображают рядом с «циклом DevOps», а иногда просто замечают, что «цикл DevOps сегодня — он включает Sec, как важную часть». Вот изображение из текста, где говорится про «DevSecOps как учёт Sec в DevOps», но вводится отдельно роль «безопасника как DevSecOps», действующего «рядом», причём в тексте поминается ещё и старинный SDLC (software development lifecycle)308:
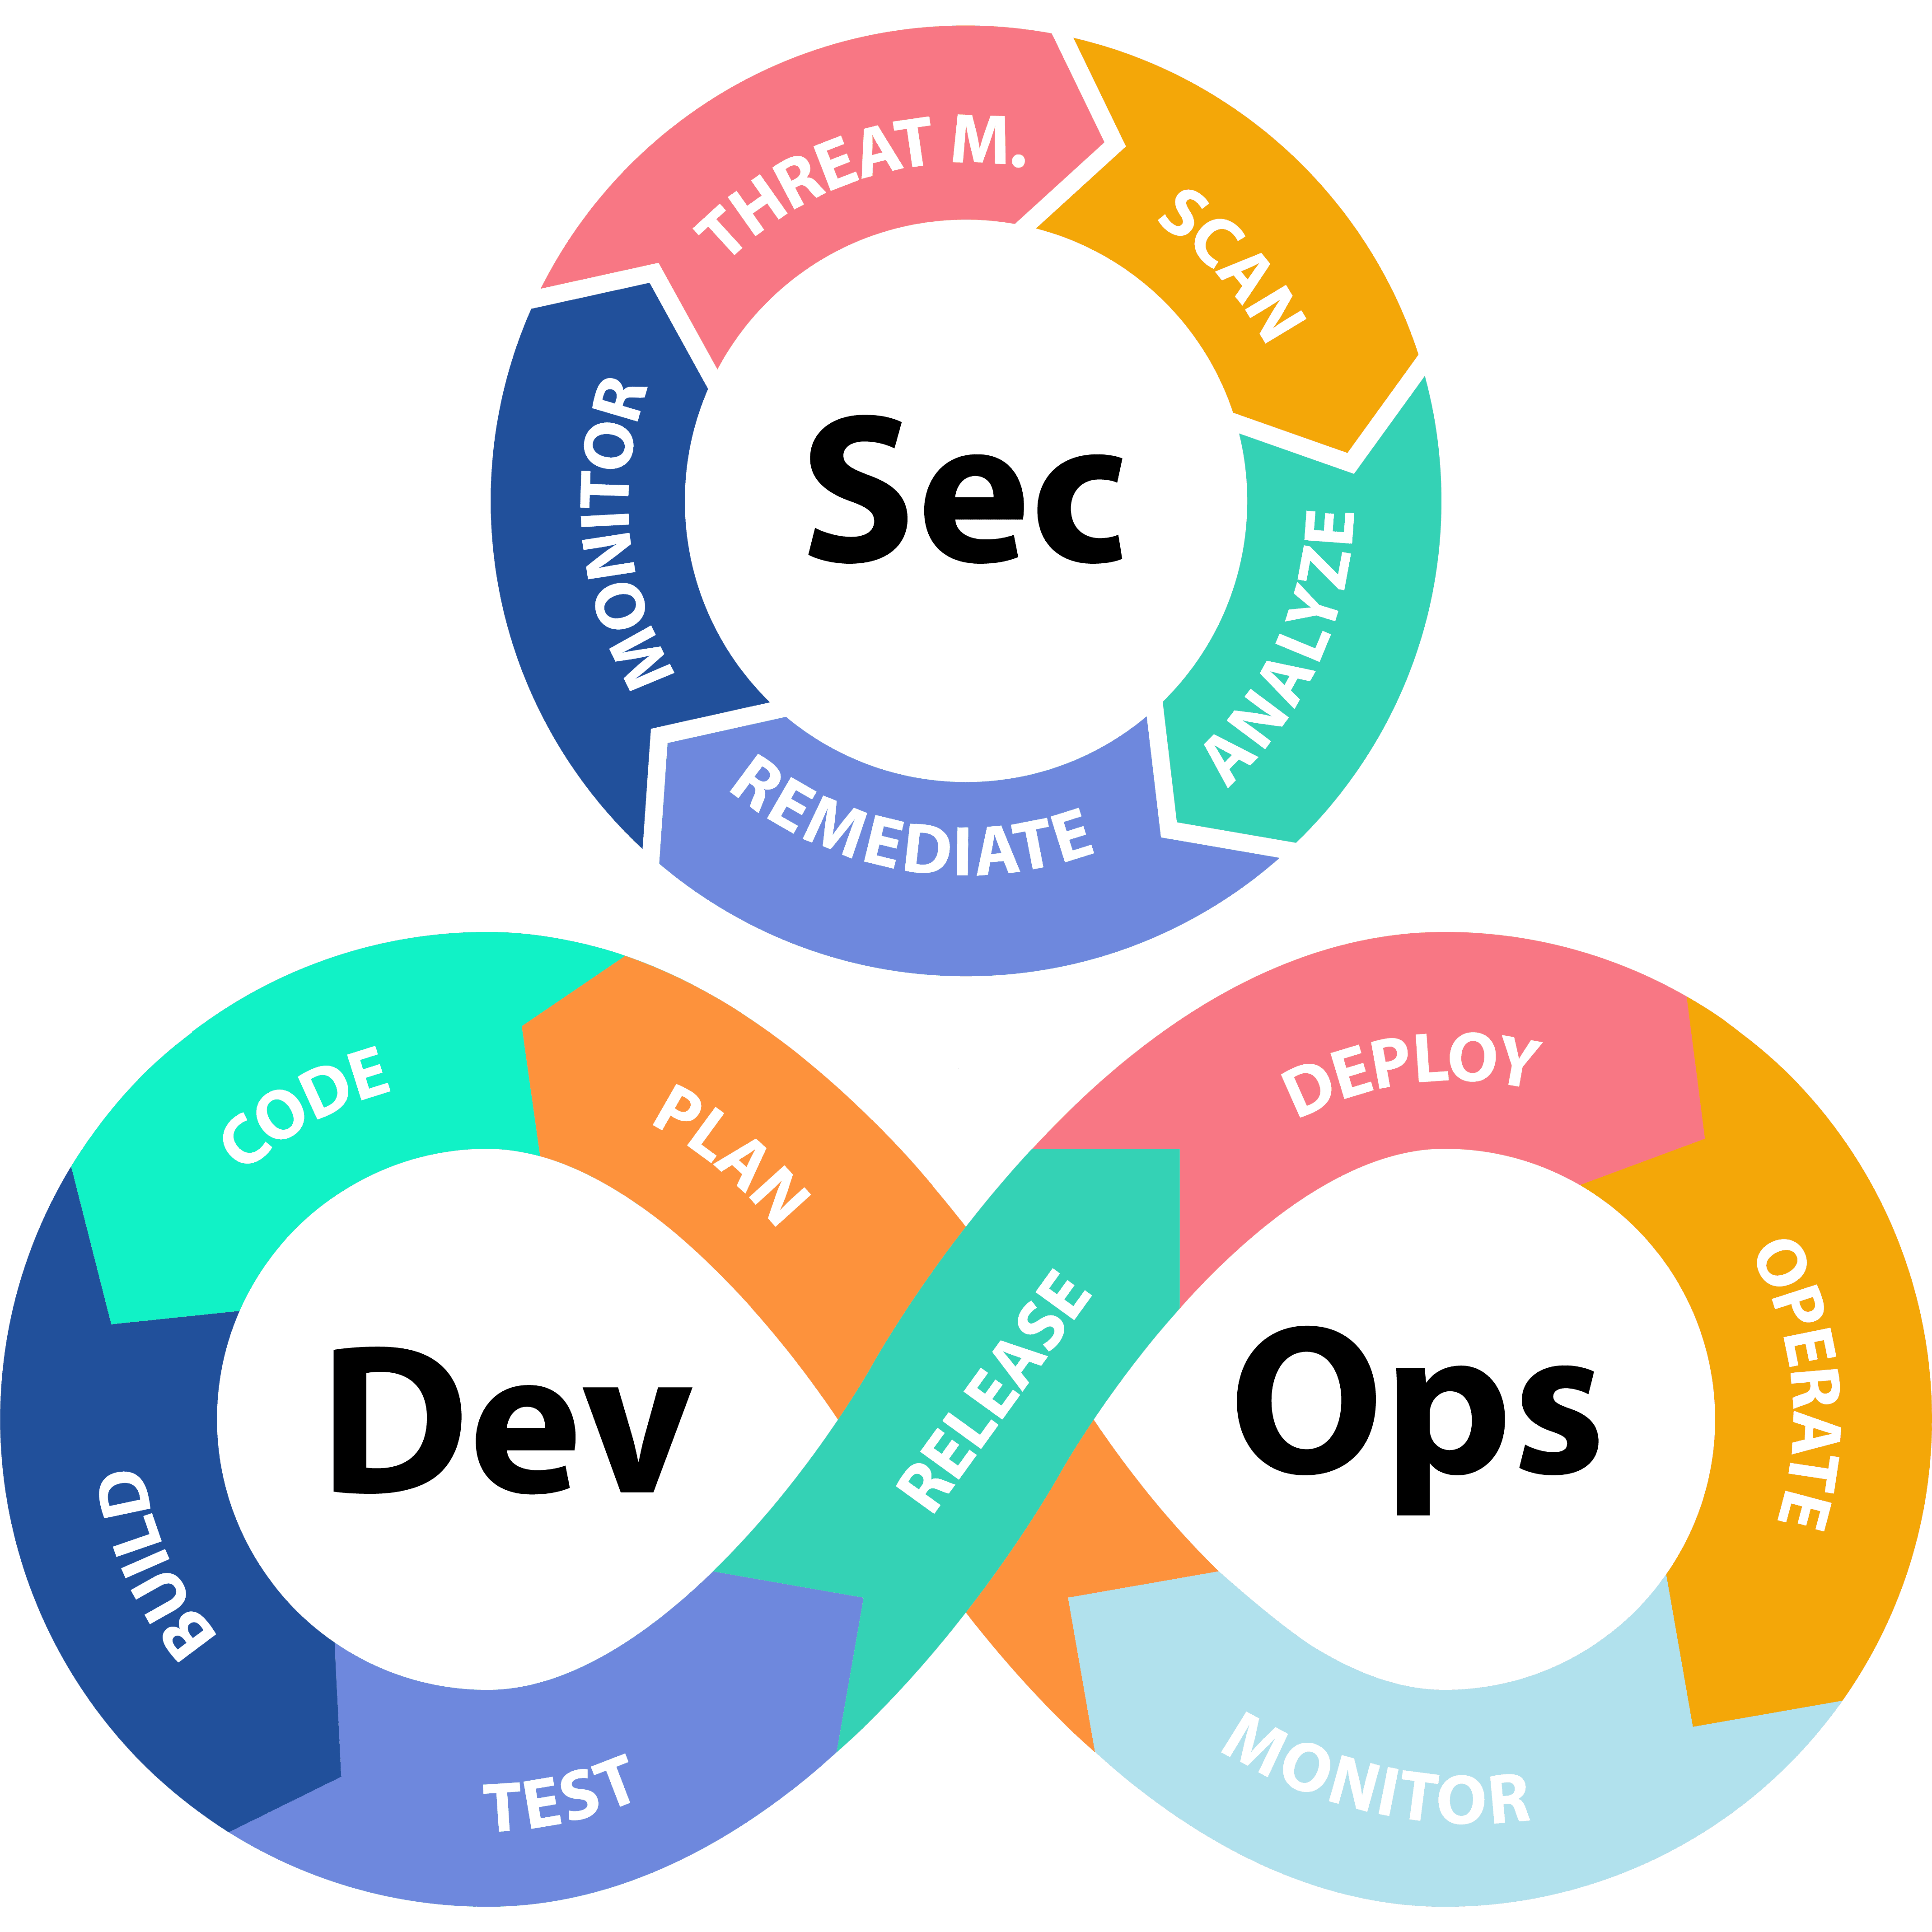
Так что смотрите на содержание методов, а не на названия: у многих людей в голове «модные слова», но вот отвечают ли этим «модные идеи» — это не факт. Проверяйте!
В современном DevOps ещё и учитывается работа архитекторов с их архитектурными тестами (fitness functions): как минимум, DevOps-инженеры предоставляют компьютерную и программную инфраструктуру для разворачивания архитектурных фреймворков, предписанных архитекторами, и эксплуатируют их, и они же ещё они обеспечивают архитектурный мониторинг, проверяют выполнение fit functions. Тут даже не приходится говорить о «сдвиге влево» архитектурной работы, это все понимают. И нет специального имени для DevArhOps309, это будет просто DevOps.
Управление конфигурацией
DevOps, инженерия внутренней платформы разработки, SRE — это самые разные имена метода эволюционной (иногда и не очень эволюционной, там будет «управление жизненным циклом») инженерии производственной платформы как разработки и развития внутреннего «завода», а затем поддержания его сервисов для разработчиков.
Но это не все имена, есть и много других «синонимов с нюансами», каждый из которых имеет свои оттенки смысла и используется в инженерных процессах для систем разной природы. Так, часто инженерия инженерной платформы приходит под именем «управление конфигурацией и изменениями», хотя и с нюансами:
-
Ничего не говорится о собственно платформе как наборе инструментов.
-
Ничего не говорится о явном выборе вида инженерного процесса, поэтому не обсуждается непрерывность изменений.
-
Ничего не говорится об испытаниях (хотя в управление конфигурацией и включают проверку того, что конфигурация системы соответствует конфигурации из проектной документации, «то, что сделали — это то, что описывали, что планировали»).
Как видим, это урезанные практики DevOps, но в машиностроении вы чаще встретите именно этот термин, наряду с «жизненным циклом изделия» как названием для инженерного процесса. Иногда даже говорят об «управлении инженерной документацией», это уж совсем анахронизм, но в государственных проектах это так, а также это может встречаться в сильно зарегулированных инженерных сферах — строительстве, авиации. Часто при разговоре об «управлении инженерной документацией» теряется акцент на том, что конфигурация системы — это сами части системы в физическом мире, а документация с описаниями системы важна, но по большому счёту их конфигурация вторична к конфигурации системы, она нужна только для того, чтобы создавать и эксплуатировать само воплощение в физическом мире. Ну и сама идея непрерывной разработки, непрерывной интеграции, непрерывного ввода в эксплуатацию при этом теряется абсолютно, ибо акцент только на описания, интеграция/сборка, разворачивание с наладкой и ввод в эксплуатацию отсутствуют.
Если отсутствует управление конфигурацией (в том числе конфигурационный учёт — документирование состояния важных объектов проекта, прежде всего целевой системы и её документации, состояния систем графа создателей), то в проекте появляется огромное количество так называемых «конфигурационных коллизий»: когда одна часть системы и/или описание системы не соответствует другой. Вот пример такой коллизии: «в информационной модели, которую отдали строителям, сплошная стена. В информационной модели, которую отдали монтажникам, через стену в этом месте идёт трубопровод. Что делать — разбивать свежепостроенную стену и пропускать трубопровод в этом месте, или перепроектировать трубопровод, но стену не трогать?!». Или «на совещании в середине прошлого месяца мы приняли решение делать ракету диаметром 5 метров. А вы продолжаете после этого целый месяц проектировать ракету диаметром 4.5 метров. Как это могло произойти?!». Вот традиционный пример из программной инженерии: «Ваше приложение не будет работать в нашей операционной системе, ибо оно пользуется новым фреймворком, который наша старая версия операционной системы не поддерживает. Нет, мы не планируем обновлять версию нашей операционной системы, это вы сделайте что-нибудь со своим приложением».
Конфигурационные коллизии обходятся проекту очень дорого, они требуют переделывать (re-work) большие куски проектов, часто по нескольку раз, это не lean, не элегантно. Советы типа талебовского «не будь лохом», традиционные рекомендации «не надейся на авось», «наведите порядок в проекте», пожелания «не прощёлкивать важные события» — они все чаще всего про недопущение конфигурационных коллизий, то есть про постановку метода управления конфигурацией и изменениями.
Иногда конфигурационными коллизиями считают неизбежные для систем конфликты между системными уровнями (один уровень требует скорости и лёгкости, другой уровень готов выдать мощность для скорости, но за счёт тяжести — и это могут считать «несоответствиями в конфигурации»). Правомерно ли так считать? Это вопрос открытый. Мы считаем, что если конструкцией достигнуто субоптимальное проектное «расчётное» решение в рамках достижения какого-то квазиустойчивого/неустроенного состояния (frustration, как это обсуждалось в руководстве по системному мышлению), то это не конфигурационная коллизия.
Конфигурационная коллизия — это когда противоречия настолько сильно проявляются, что система становится неуспешна. Скажем, актуальная целевая система при заявленной «разовой водопадной разработке с однократным вводом в эксплуатацию» не соответствует документированным требованиям к этой системе: хотели сделать систему быстрой, поставили тяжёлый аккумулятор, и удовлетворили требованию скорости, но не требованию к массе системы, требуются ещё итерации в разработке, но их не предусмотрено ни одним документом, финансирование поэтому кончилось, проект окончен, система так и осталась неуспешной.
Часто в управлении конфигурацией, которая унаследовала идею «требований» под развалом/breaking конфигурации (терминология тут может отличаться, например, будут говорить о misconfiguration) ещё понимают и тройное соответствие: конфигурации системы, конфигурации описаний и конфигурации требований! Например, так принято в атомной энергетике по до сих пор действующему документу 2003 года (расцвет моды на инженерию требований) «Configuration management in nuclear power plants»310:
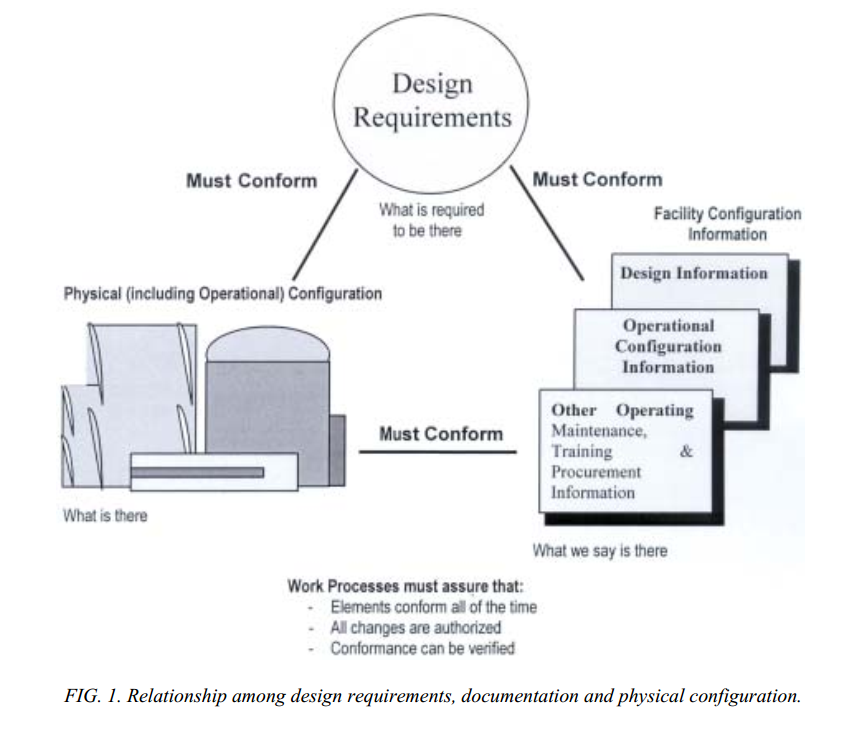
В этом документе также сказано, что в среднем 25% аварий, зарегистрированных в системе отчётности об авариях атомных станций, могли быть вызваны ошибками в конфигурации или недостаточностью в управлении конфигурации. Как о таком думают сейчас? Описания должны быть версионированы (что должна делать система — это тоже ведь её описание, а «требований» — нет), конфигурация — это физическая конфигурация, хотя иногда могут говорить и о конфигурации описаний как набору версий, соответствующей конфигурации системы. Надо внимательно смотреть по смыслу, что говорит та или иная терминология. Нельзя опираться на «словарные значения» или «значения из стандартов», в каждом проекте вы обнаружите какие-то особенности.
Основные положения управления конфигурацией на примере бумажного документооборота (нет современных IT-решений типа «облачная система получения сводных заказных спецификаций») в машиностроительном предприятии на кругозорном уровне и даже без отсылок к стандартам системного управления конфигурацией вроде стандарта именования инженерных рабочих продуктов IEC 81346 (он хорош для отражения нескольких разных способов разбиения системы на части, это обсуждалось в руководстве по системному мышлению), хорошо раскрыты в короткой (188 страниц) книге Frank Watts «Configuration Management for Senior Managers» (2015).
Существует и неофициальный русский перевод этой книги. Несмотря на упомянутые недостатки (бумажный документооборот, нет использования современных инженерных стандартов), эта книга содержит в себе довольно много опыта управления конфигурацией в традиционных машиностроительных производствах и популярно даёт представление об основных понятиях этого метода. Книга оказывается очень полезна айтишникам, которые плохо представляют себе, как устроено материальное производство в «реальном секторе», и даже не «современное производство», а вообще производство/manufacturing: сами программисты работают с кодом, который превращается в программы — и им неведомы проблемы реального производственного мира. А менеджеры вдруг начинают после этой книги понимать, о чём им пытаются иногда говорить инженеры. Много наших инженеров-менеджеров находили книгу очень полезной для развития инженерного кругозора.
Книга выделяет в управлении конфигурацией несколько составляющих методов, выпячивая понятия выпуска/release и передачи/hand-over рабочих продуктов, включая выпуск и передачу данных. Эти понятия отличаются от delivery/«пуск в эксплуатацию». По факту книга ограничивается простым «собрать все части системы без пропусков и лишних деталей и передать в комплекте кому-то вовне предприятия», не идёт и речи о тестировании, защите и безопасности, архитектурных тестах и всём прочем, о чём говорится в DevOps. Но знать эту книгу полезно, ибо вы не можете ждать десятка лет, пока все «железные» инженеры проникнутся идеями DevOps, а все DevOps проникнутся проблемами «железных инженеров».
Центральным понятием для управления конфигурацией в этой книге является выпуск/release, в том числе передача/hand-over рабочих продуктов (физических систем и их частей, а также документов с описаниями). данными жизненного цикла). Книга выделяет следующие составляющие управления конфигурацией (которое само часть инженерии производственной платформы), и обратите внимание, что в принятом в книге инженерном процессе изменения утверждаются независимыми экспертами (управление изменениями идёт как отдельный метод), это оказалось в непрерывной инженерии непродуктивно, и мы это уже отмечали:
-
Выпуск/release рабочих продуктов, в том числе hand-over данных. Это о том, как отслеживать целостность мегамодели и системы-в-железе, а также соответствие их версий друг другу. Если у вас есть три варианта архитектурного описания и четыре вполне рабочих прототипа, то как узнать, что из этого было отвергнуто, а что продолжило дорабатываться и станет когда-нибудь окончательной архитектурой и вариантом системы с этой окончательной архитектурой.
-
Управление изменениями (change management) как 1. то, что происходит с запросами на изменения (запросы иногда заканчиваются изменениями проекта/design) 2. сами изменения проекта/design (изменения иногда заканчиваются выпуском)
-
Выпуск заказных спецификаций (BOM, bill of materials). Иногда это отдельные спецификации того, что будет заказано у внешних подрядчиков (приобретение/acquisition), иногда это полный список (свод) по всему проекту: сводная заказная спецификация. Конечно, это специфика главным образом машиностроения и промышленного производства, для систем другой природы будет совсем другая терминология. Но это верно для всей обсуждаемой книги Frank Watts: нужно уметь прочесть её содержание «безмасштабно», вычленить основные мысли про управление конфигурацией, понять необходимость управления конфигурацией в самых разных проектах создания самых разных систем. В целом метод выпуска заказных спецификаций связан с выборкой из мегамодели данных проекта правильных с точки зрения организации логистики кусков (это не bounded context, не предметные области! Не функциональные описания), «нарезкой мира на передаваемые между исполнителями предметы работы», к которым дальше применяются логистические процедуры — т.е. вычленить те «рабочие продукты»/«предметы работы», которые перемещаются между инженерными организациями.
-
Управление вариантами (variant management). Часто выпускается не одна какая-то система серийно, но несколько вариантов системы, в том числе и каждый отдельный уникальный вариант (mass customization, например, каждый отдельный автомобиль или компьютер может идти в какой-то уникальной комплектации).
Книга Frank Watts даёт много интересных советов и по организации службы/подразделения управления конфигурацией на машиностроительном предприятии. Например, даётся совет подчинять службу управления конфигурацией инженерам, а не операционным менеджерам. Управление конфигурацией в его разных формах (в том числе форме инженерии платформы) сегодня — это «серая зона» системной инженерии, ибо с одной стороны речь идёт о принятии технических решений по поводу целевой системы (разнообразные информационные модели системы), а с другой стороны это управление/management, то есть решения по поводу создателя (выделяемые создателем ресурсы на проведение работ по выбранным «технарями» методам работы).
«Технари», повторимся, тут условны — в нашем курсе мы всех называем «инженерами». Инженеры эти могут быть электромеханиками, коучами, хореографами, политиками, программистами, но мы считаем их занимающимися целевой системой, её созданием и развитием как изменением мира к лучшему. А создателем (это же люди, организация!) и его ресурсами обычно занимаются менеджеры, в данном случае операционные менеджеры, логисты. Поэтому DevOps с инженерией платформы (никакого отношения к операционному менеджменту!) иногда пытаются объединять с менеджментом: вроде как у менеджмента и DevOps общая цель — построить такого создателя (систему разработки и производства), чтобы от момента запроса на новую фичу до момента её получения клиентом проходило как можно меньше времени.
«Как можно меньше времени» — это задача операционного менеджмента. Но Frank Watts всё равно даёт совет: подчиняйте людей, которые этим занимаются, инженерам (главному инженеру предприятия, который занимается методом производства и станочным парком, а не главному инженеру проекта, который занимается целевой системой, или CIO, если речь о софте, а не архитектору конкретной целевой системы), а не менеджерам. Эта «серая зона» между инженерией и менеджментом тяготеет всё-таки к инженерии, DevOps сегодня прежде всего инженеры платформы — они строят завод-автомат, это не менеджмент.
В руководстве по системному менеджменту будет рекомендация в проекте прежде всего наладить управление конфигурацией, то есть «навести порядок», чтобы избавиться от операционных коллизий. И только потом заняться операционным менеджментом как следующим необходимым методом. Ибо если работа с вашей производственной платформой порождает конфигурационные коллизии в количестве, то ускорение работы будет увеличивать число этих коллизий: вы будете просто производить больше беспорядка в единицу времени. Чтобы об этом помнить, будет дана мантра распожаризации/lean/«элегантной работы», о которой говорилось ещё и в руководстве по рациональной работе. Вот её кратчайшая форма (помним, что это фокусировка на логической последовательности процесса, но не «шаги работы»):
-
Прекратить делать ненужное (просто прекратить!). Будет меньше работы! Это инженерия прежде всего.
-
Меньше переделок за счёт управления конфигурацией системы, работ, данных и тем самым уменьшения конфигурационных коллизий! Это инженерия прежде всего, хотя и с выходом на менеджмент. Миллионы индивидуальных деталей и пять-десять операций с каждой надо отследить, ни одной не пропустить, ни одной не потерять!
-
Уменьшать время ожидания (цикл непрерывных улучшений Голдратта: убирать ограничения, но только в тщательно вычисленных местах, не везде). Это операционный менеджмент: TameFlow в проектировании, ERP311 «по Голдратту» в стройке.
-
Собственно развитие: изменение инженерных практик работы по самым долгим операциям. Но не раньше, чем пройдёте три предыдущих пункта.
Прохождение работ по этой мантре должно привести к тому, что «тушение пожаров» прекратится, пожары перестанут возникать!
Но эта мантра будет работать только тогда, когда вы сначала выберете метод инженерной работы, выдержите все споры по поводу выбора «непрерывного ввода в эксплуатацию», «водопадной» разовой приёмки-сдачи или какого-то их гибрида, а затем выберете методы управления конфигурацией и изменениями, управления информацией. И только потом вы сможете организовать людей на выполнение какого-то метода управления работами (например, TameFlow). А потом? А потом нужно будет улучшать сам продукт, улучшать сервис создателя-провайдера, улучшать методы проектирования и изготовления, сборки, разворачивания системы, введения её в эксплуатацию. Но всё это только после того, как в рамках выбранного вами инженерного процесса налажена работа по выбранному методу DevOps (включая включение в «конвейер» испытаний/тестирования, защиты, мониторинга и т.д.).
Начинать заниматься управлением конфигурацией в проекте нужно с себя:
-
Не пишешь — не думаешь. Управление конфигурацией собственных идей. Мышление письмом, на память надежды нет. Все ходы записываются, как в шахматных партиях: или конфигурацию шахматной партии держит доска, которая не может быть забыта или неправильно вспомнена, или запись шахматной партии (что много удобнее: её можно переслать через чат, а физическую шахматную доску не перешлёшь). Собранность у человека поддерживается инструментально, голым мозгом не работают, биологической памяти не верим, она сбоит!
-
Всё, что кому-то передаётся (hand-over, release), должно оставлять след во внешней по отношению к мозгу памяти, а не только запоминаться головой. Например, должны храниться входящие и исходящие письма, полуфабрикаты и готовые рабочие продукты. Если было не письмо, а разговор, то должен остаться след: minutes/заметки по содержанию разговора, issue в issue tracker, записи в case file (папку «Дело №___»). Над этим всем должен работать компьютерный поиск, чтобы не искать перебором или «я это оставлял где-то вот тут, но где это лежит сейчас, почему не видно?». Если это материальные рабочие продукты, то работаем со складским учётом: ищем по карточкам, быстро находим.
-
Все предстоящие дела (работы, а не только рабочие продукты) записываются, на память надежды нет. Используются разные системы ведения дел по мотивам старинного «Getting things done»312 или «Джедайских техник»313.
-
Все рабочие продукты имеют версии, для которых должно быть уникальное имя и время последнего изменения, а также должно быть известно кто, что, когда изменял. Нужно, чтобы можно было сравнить «что было» и «что стало» после изменения. Прошлые версии документов сохраняются «на всякий случай» (ведётся бэкпапирование).
Всё то же самое нужно делать в масштабах всего проекта, какой бы большой он ни был (и чем больше проект, тем строже это отслеживать: маленький беспорядок может нанести существенный убыток в большом проекте).
Тем самым управлять конфигурацией нужно для всех систем проекта:
-
Целевой системы и её описаний, в том числе учёт незавершённого производства (сырьё, склады). Это относительно просто и понятно, если речь идёт о программном обеспечении или даже атомной станции. Если вы занимаетесь социальной инженерией, то «конфигурация сообщества и его описаний» будет представима более тяжело, а для общества так и вообще непредставима.
-
Систем в окружении (чтобы не оказалось, что появились конфигурационные коллизии между целевой системой и системами в окружении)
-
Систем в графах создателей (организация должна быть документирована, включая органиграмму и какие оргроли играют какие оргзвенья, то есть кто и какими методами выполняет какие работы, а ещё должен вестись операционный финансовый учёт, кадровый учёт, учёт оборудования и помещений, и т.д.).
Управление конфигурацией отдают обычно инженерам, но недостаток такого организационного решения в том, что менеджеры после этого забывают о необходимости управлять конфигурацией. А ещё у менеджеров явный сдвиг обычно от работы с конфигурацией системы на работу с данными, поэтому они будут предпочитать говорить «управление информацией», имея в виду «информацию о конфигурации системы». Но нет, нам надо убеждаться, что управляем конфигурацией системы, а не только конфигурацией описания системы!
Современное управление конфигурацией включает в себя также отслеживание и работ: структуру разбиения работ/WBS (как плановую, так и фактическую) тоже ставят под управление конфигурацией, проверяя коллизии наличия работ без наличия системы, с которой ведутся работы и наоборот, наличия систем, с которыми не ведётся никаких работ. Это проще понимать при управлении проектами (up-front planning), хуже при управлении кейсами, но кейсы тоже ставят под управление конфигурацией, отслеживают — в платформе это будет специальный софт issue tracker (issue — это вопрос/проблема, которую решают работы кейса).
WBS тоже может иметь конфигурационные коллизии, если собирать его по разным подрядчикам работ, но главное — менеджеры могут этот WBS не синхронизировать по части предметов работ, ибо это «по ведомству инженеров, а WBS — это наше». Нужно отслеживать, чтобы мероприятия метода управления конфигурацией проводились как по линии целевых систем, так и по линии систем создания, и они были согласованы между собой (так, метод управления конфигурацией/информацией у инженеров должен быть согласован с методом управления данными у менеджеров, и отслеживать нужно не только их наличие, но и согласованность их друг с другом).
Управление конфигурацией требует жёсткой дисциплины. Пример правила, которое подчёркивает важность управления конфигурацией: «Если делается какая-то работа, которая не учтена в конфигурации работ — считаем, что работа не делалась». Если сотрудник что-то делает, что не учитывается в системе управления конфигурацией (скажем, работает с версиями системы, которых нет в системе управления конфигурацией), и это происходит систематически, то он может быть уволен: разбираться с неизбежными при этом конфигурационными коллизиями дороже, чем возможная польза от работы этого сотрудника. Недисциплинированные в части управления конфигурацией сотрудники безжалостно увольняются, их не терпят. Элегантная работа — это без лишней работы, но управление конфигурацией не лишняя работа, без неё число переделок из-за конфигурационных коллизий существенно тормозит все работы!
Главные понятия управления конфигурацией:
-
Конфигурация/configuration — это система, для которой известна версия каждого её модуля и общий состав этих модулей, в том числе обеспечено соответствие конфигурации документации, корректно описывающей эти (возможно, ещё будущие, пока не созданные) модули. Если какие-то части системы или документация ведут к конфигурационным коллизиям (неработоспособности из-за несогласованности версий модулей), то говорят о «разваленной/broken конфигурации»/«неверной конфигурации»/misconfiguration. Конфигурация системы — это сама система, а не её описание! Конфигурация компьютера, собранного из многочисленных комплектующих — это сам компьютер! Конфигурацию чаще всего относят к моменту эксплуатации.
-
Конфигурационная единица/configuration item — она определяется логистически как «единица передачи», «операционная единица», а не просто конструктивно. У инженеров может быть и более мелкое конструктивное деление. Так, у транзистора будут различаемые инженерами затвор, сток, исток — но конфигурационной единицей будет транзистор в целом, а не его части, которые отдельно не изготавливаются и не передаются.
-
Версия/version — это конфигурация модуля/комплектующего в каком-то его варианте (эти варианты могут меняться, версии поэтому отслеживаются и именуются). В проекте работают с какими-то версиями модулей, из которых составляют в конечном итоге конфигурацию системы. Версии больше акцентируются на времени сборки/создания из них конфигурации, а конфигурация — это понятие, более центрированное на времени эксплуатации (скажем, в софте «версии» лежат в системе управления версиями, а на компьютерах датацентра работает «конфигурация»).
-
Базис/baseline — это конфигурация, которая утверждена специальной административной процедурой, обычно включающей дополнительные проверки на отсутствие конфигурационных коллизий. Выпуск/release происходит именно базисов, а не «рабочих версий». Часто даже выделяют отдельно управление конфигурацией как поддержание целостности версий и управление изменениями как административные процедуры по внесению изменений в базисы (назначению какой-то «рабочей» версии «базисом»). Удивительно, но идея о том, что какие-то конфигурации просматриваются более тщательно, чем другие и поэтому называются базисами — не работает, есть на эту тему исследования (подробней в книге «Accelerate»), но легенды живы, особенно в машиностроении, где может быть серийный выпуск на основе какого-то базиса. Современный подход тут — continuous integration, базис поддерживается постоянно, рабочие версии мимолётны.
Понятие конфигурации и версии очень часто путаются друг с другом, но в целом признаётся, что управление конфигурацией (configuration management, реже configuration control) не сводится исключительно к управлению версиями (version control), ибо в управлении конфигурацией есть и много других стоставляющих: управление данными, выпуск/release рабочих продуктов и их передача/hand-over между исполнителями работ, и т.д.
В управление конфигурацией включают часто как отдельный важный метод именования/кодирования рабочих продуктов и их документированных описаний: назначение идентификаторов/identifiers (имён, которые однозначно позволяют отличить названный такими именами объект от других объектов проекта), обозначений/designators (имя-идентификатор, который учитывает вхождение объекта в какую-то систему в рамках какого-то из системных разбиений по какому-то аспекту, IEC 81346-1:2022 для проектов материального производства как раз стандарт для введения обозначений, которые как-то могут пониматься инженерами одинаково в самых разных проектах), иногда стандарт обозначений называют стандартом кодировки. Выбор и поддержание идентификации, обозначений/десигнаторов/кодировки — важная часть управления конфигурацией.
Моделирование: рабочие продукты, которые вы изменяли
Заполните табличку с не менее чем тремя последними рабочими продуктами, которые вы изменяли.
| Номер продукта | Имя продукта | Дата выпуска и версия продукта до изменения и после изменения: где их смотреть? | Каким методом давали имя версии? | Где хранится предыдущая, где хранится текущая версия? | Отметьте, задумывались ли вы о возможном отсутствии управления конфигурацией для этого рабочего продукта. Кто инженер DevOps, который задал метод управления конфигурацией? |
|---|---|---|---|---|---|
| 1. | |||||
| 2. | |||||
| 3. | |||||
Задания
Поставьте отметку о выполнении дел.
-
Прочтена или предлагаемая в руководстве книга по управлению конфигурацией (она о машиностроении), или любая другая литература (от 100 страниц и более, две страницы чьего-то поста в блоге будет мало!) по управлению конфигурацией в вашей привычной предметной области.
-
Прочтён стандарт IEC 81346-1:2022.
-
Опубликован пост с рецензией прочитанного материала по управлению конфигурацией и в этом посте есть выводы по отношению к практике управления конфигурацией вашего текущего проекта (какая она, что хорошо, что нужно менять).
Чеклисты в регламентации
Про чеклисты мы довольно много говорили в руководстве по методологии, но в системноинженерной работе надо уже не просто говорить — но уже делать, задействовать эти чеклисты в работе. Чеклисты появляются в ходе регламентации, то есть при нормативном описании метода работы:
-
Готовится (и непрерывно обновляется!) регламент/руководство/инструкция/стандарт, который не повторяет учебник со всеми деталями и нюансами, но содержит указание на важнейшие объекты с их графом состояний, а также операции, которые надо делать с этими объектами, чтобы проводить их по графу состояний. Это язык метаС-модели, принятой на предприятии. Это всё на понятном людям языке (понятный для машин язык тут может быть, например, автоматного программирования — машины состояний, но в общем случае — любой язык программирования. Повторим, что это мы обсуждали в руководстве по методологии). Регламент должен быть в операционном софте сотрудника, который должен его знать, а не в операционном софте его разработчика (и надо сопротивляться сведению всех регламентов в Единую Информационную Систему Всех Регламентов, это означает, что сотрудник никогда туда не заглянет и не сверит свои действия с регламентом. Если очень надо, делайте репликацию).
-
К регламенту готовится шаблон/пустографка чеклиста, представляющий собой список вопросов, положительные ответы на которые означают достижение того или иного состояния альфы. Чеклист предусматривает проверки ситуаций, когда что-нибудь может «пойти не так».
-
Для шаблона чеклиста делается чеклист, который проходится для каждого экземпляра альфы. Обычно это табличная форма в операционном софте сотрудника, выполняющего регламент. Если что можно в прохождении чеклиста автоматизировать, надо автоматизировать.
-
Сотрудник обучается прохождению регламента (выполнению работы по методу, описанному регламентом) с заполнением чеклиста (первый раз разработчик регламента и чеклиста проходит его с сотрудником).
-
Прохождение регламента ставится под надзор — чтобы не было соблазна не заполнять чеклисты, не выполнять все предписанные регламентом операции, а потом «для проверки» заполнять их в конце недели, как будто реально прошли все проверки.
-
Если чеклисты сотрудником игнорируются по причине их неважности (мы уже тут говорили, что разработчики регламентов легко загоняют фирму в ситуацию итальянской забастовки), то надо оставить в чеклистах только действительно важные вопросы. Если вопросы важны, но всё равно игнорируются сотрудником — дешевле сотрудника уволить, чем постоянно ликвидировать последствия ошибок этого сотрудника. Недисциплинированные сотрудники на работе не нужны, от них вред.
Управление работами — это управление выделением ресурсов и выполнения работ, в том числе это управление включает трекинг/отслеживание прохождения всех контрольных точек (milestones/вех) проекта/project. Контрольная точка — это момент времени, в который ожидается какое-то событие. Событие — это смена состояния какого-то важного объекта внимания в проекте (альфы). Смена состояния обычно происходит не сама собой («система сама себя не разработает и не изготовит», техноэволюция — это не биологическая эволюция), а представляет собой результат чьей-то работы по какому-то методу (если застывает бетон, то у вас работа — «подождать», намеренное отсутствие работы — это тоже работа!). Смена состояния обычно сопровождается ответом на контрольный вопрос о достижении какой-то характеристики этого состояния.
Скажем, вам нужно закрыть дверь. Контрольная точка — это момент времени, в который происходит смена состояния: «дверь открыта» на «дверь закрыта», при этом «дверь закрыта» — это характеристика целевого состояния двери. Контрольный вопрос — это закрытый (подразумевающий ответы «да», «нет», «не знаю», открытый вопрос подразумевает развёрнутый ответ, описывающий ситуацию) вопрос, в котором есть:
-
высказывание/assertion о состоянии (описание состояния), «закрыта»,
-
указание системы, для которой дана характеристика: «дверь»,
Контрольный вопрос тут «дверь закрыта?». Для закрытия двери требуется провести работу. Контрольная точка — это привязанное ко времени ожидание события закрытия двери (смены состояния «дверь открыта» на «дверь закрыта»), то есть ожидание положительного ответа на контрольный вопрос в какой-то момент времени.
Контрольная точка просто «проходится», ответ на её вопрос о достижении значения характеристики, привязанный ко времени ожидания этого события в части управления работами принимается системными и прикладными инженерами проекта, а также операционными менеджерами проекта (а часто и внешними проектными ролями, им тоже это интересно, чтобы корректировать свои планы) «для сведения». Если не проходится, то с работами было что-то не так: они или не проводились (вопрос к операционному менеджеру, проблемы с работами) или проводились, но «что-то пошло не так» (вопрос к целевому инженеру, проблемы с методом выполнения работ).
Гейт/gate — это контрольная точка, в которой принимается решение, идти ли в проекте дальше, или прекратить проект. То есть, если вовремя дверь не закрыта, и это обычная контрольная точка, то вы таки дожидаетесь работы по её закрытию, но все остальные работы проекта при этом продолжаются, или это не простая контрольная точка, а гейт — и тогда вам придётся принимать решение, дожидаться ли закрытия двери, или всё в целом в проекте настолько плохо и критично, что нужно прекратить весь проект. Скажем, в авиапроекте гейтом является получение денег по предзаказам на самолёт. Если деньги не получены в срок (контрольный вопрос: «деньги получены?», веха/milestone в качестве гейта/gate — «деньги к 23 мартобря 2022» получены?»), то закрывается весь проект создания самолёта, прекращаются все работы проекта. Общий тренд сегодня — это уменьшение числа заранее назначенных гейтов, и мониторинг прохождения вовремя контрольных точек. Да, время это нельзя спланировать, но менеджмент этого не допустит — потребует от инженеров выдать оценку времени, затем превратит бандитским приёмом «никто тебя за язык не тянул» оценку в обещание, и вот у вас появилась контрольная точка. Это плохой метод организации работы, но он более чем распространён. Если есть какие-то проблемы с прохождением вовремя контрольных точек, то принимаются самые разные меры — включая и такие, как закрытие всего проекта, то есть признание проекта неуспешным.
Всё описанное лишний раз демонстрирует, что состояние kernel альф «воплощение системы», «описание системы» и «методы работы системы», «работы системы» для каждой области интереса систем проекта (целевой системы и систем графа создателей — различных команд и коллективов) оказываются тесно переплетены, а контрольные вопросы, задаваемые в контрольных точках проекта, помогают отслеживать состояние проекта в части продвижения в достижении планируемых состояний этих альф к конкретным датам проекта.
Этих контрольных вопросов как к целевой системе и её окружению, так и к системам-создателям во всех их графах, так и к внешним проектным ролям много, они как раз и собираются в чеклисты/checklists для каждой альфы. Эти чеклисты делаются и для состояний подальф, и так на несколько уровней вниз. Каждый контрольный вопрос в этих чеклистах/«контрольных списках»/«списках контрольных вопросов» подразумевает изменение состояния альфы путём выполнения работ по каким-то методам. Эти контрольные вопросы отлично увязывают управление работами (обычно это кейс-менеджмент) и ведение инженерного процесса (какой-нибудь вариант agile, предусматривающий планирование работ на лету, исходя из инженерного анализа ситуации с альфой).
Контрольные вопросы составляются инженерами, ответственными за изменение состояния соответствующих альф в ходе регламентации: инженерами целевой системы, или инженерами систем из графа создателей (менеджерами). Это инженеры внутренней платформы разработки, инженеры DevOps. Именно инженеры знают те состояния, через которые проходит каждая альфа и подальфа и те методы работы, которые могут привести альфу из одного состояния в другое. Поэтому обязанностью системных инженеров целевой системы, а также системных инженеров систем-создателей в их графе будет:
-
адаптация набора состояний основных альф проекта создания и развития системы (целевой или «нашей» в графе создателей) к предметной области проекта
-
составление или адаптация списка контрольных вопросов к каждому состоянию
-
указание методов перевода состояний альфы, а также последовательности применения методов, оценка времени их выполнения. Это входная информация для операционного менеджера (этим операционным менеджером может быть софт issue tracker — операционному менеджеру не нужно особо вмешиваться в выполнение работ, им легко может быть и алгоритм).
-
Выделение подальф, чтобы отслеживать проект с нужной степенью детальности. Для подальф нужно тоже выделить состояния и составить списки контрольных вопросов.
Мы подробно рассматривали чеклисты в руководстве по методологии, но иногда кажется, что можно как-нибудь обойтись и без них. Нет, нельзя обойтись. В книге Атул Гаванде «Чек-лист. Как избежать глупых ошибок, ведущих к фатальным последствиям»314 нет ничего особенного, чего мы бы не разбирали в руководстве по методологии, разве что даётся множество примеров и объяснений — и после прочтения этой книги (обязательное чтение!) обычно барьер принятия всерьёз работы с чеклистами снимается:
Чеклисты отражают не буквально все-все состояния, через которые проходят альфы, но только самые важные. Все-все состояния можно легко найти в учебниках предметной области и рабочих инструкциях, а чеклист — это средство отслеживания состояния проекта, а не рабочая инструкция. Тем самым чеклист состоит из самых-самых банальных вопросов, которые подразумевают обычно положительный ответ. Но в условиях стресса, пожара, коллективной и личной несобранности, ошибок планирования, сбоев в рациональном мышлении люди (даже с учётом задействования ими внешней памяти компьютеров) забывают выполнить какие-то работы — и прогон проверки ответа на контрольные вопросы это обнаруживает. Если контрольный лист составлен правильно, то проблемы будут находиться этим чеклистом только один раз из десятка, а то и реже. Но этот один раз обычно спасает проект.
Чеклисты появились впервые в авиации, когда одного пилота стало маловато, чтобы управиться с большим многомоторным самолётом: то с ручного тормоза забудут снять, то один из моторов завести, то убедиться, что перед самолётом на взлёте ничего нет. Аварии на взлёте были очень часты, и чеклисты с банальными контрольными вопросами («ручной тормоз снят», «правый двигатель работает», «левый двигатель работает», и т.д.) практически устранили эти аварии. Девять раз из десяти на все вопросы ответы были положительными, а один раз какой-то ответ был отрицательным — и принимались меры, чтобы аварии не было. Контрольные вопросы прогоняются перед или после выполнения каких-то пакетов работ в специальных паузах, чтобы обнаружить проблемы. Они служат для снятия рисков в командной работе: отслеживают то, что все нужные работы были выполнены и альфа пришла в требуемое состояние.
Стандарт OMG Essence предусматривает как раз такой способ ведения работ в проекте: предлагаемые им примеры kernel альф имеют какие-то более-менее абстрактные (мета-мета-модель) состояния, каждое из состояний включает к нему контрольные вопросы, далее альфы должны быть конкретизированы на один уровень абстракции ниже, до объектов предметной модели (мета-модели).
В простейшем виде состояния альфы и контрольные вопросы к ней (ещё не адаптированные, или уже адаптированные) могут быть оформлены как «карточки», например:
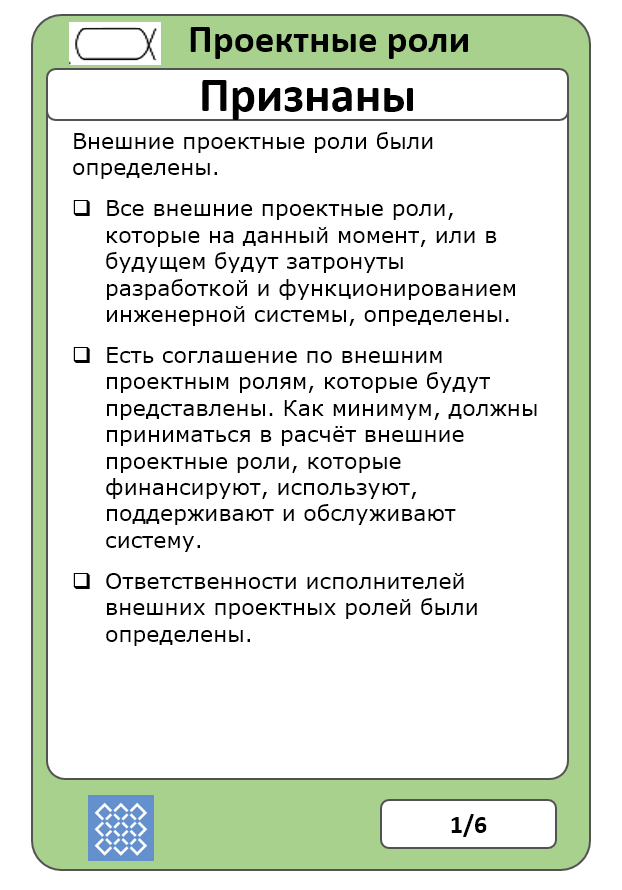
Это неадаптированная карточка альфы «проектные роли», состояние «признаны», первое из шести состояний. Состояние описано как «внешние проектные роли были определены» и это высказывание разбито на более детальные три.
Для ответов на вопросы по альфе должны быть использованы какие-то рабочие продукты (инженеры не верят на слово, биологическому мозгу никакого доверия в смысле памяти, у них «все ходы записаны»). В данном случае можно предположить следующие рабочие продукты:
-
Длинный список (long list) внешних проектных ролей, куда помещаются самые разные проектные роли, которые удалось выявить. Это даст ответ на первый вопрос «Все внешние проектные роли, которые на данный момент, или в будущем будут затронуты разработкой и функционированием инженерной системы, определены». Чтобы добиться создания такого списка, нужно запланировать работу, например «узнать про роль X», «выписать набор нужных ролей из учебника Y», «провести мозговой штурм в отделе Z», и т.д.
-
Короткий список исполнителей внешних проектных ролей, которые будут представлены в проекте какими-то отдельными людьми, и он утверждён (есть отметка об утверждении). Чтобы получить такой список, нужно провести работу — например, совещание, на котором будут прямо в таблице длинного списка проставлены отметки о тех ролях, которые будут представлены, и туда добавлены имена исполнителей необходимых ролей, от которых ожидается нужная квалификация для участия в проекте. Совещание придётся готовить, это тоже работы! А затем нужно ещё и как-то утвердить этот список: решением совещания или решением какого-то ответственного лица (тут мы говорим очень аккуратно: это может быть начальник, инженер, менеджер, но смысл решения тут не столько инженерный, сколько выделения нужных ресурсов). А остальные роли, которые остались в длинном списке? О них будут как-то помнить, но учитывать их интересы без общения с какими-то специально выделенными для этой цели внешними людьми.
-
В коротком списке должно быть указано, за что ответственны исполнители внешних проектных ролей. Чтобы получить этот рабочий продукт, нужно провести работу: обсудить и сформулировать, что должны делать эти исполнители.
Карточку альфы, можно представить как карточку (рабочий продукт, предлагаемый OMG Essence), но также как шаблон/пустографку/таблицу и далее проектировать в ходе адаптации эти таблицы в каком-то универсальном моделере (coda.io, notion.so или аналогичном), а запланированные работы для заполнения этих таблиц представить как issues в issue tracker. С этого момента операционный менеджер будет контролировать закрытие этих issue, а инженеры будут контролировать реальное выполнение условий.
Обычно трудно разобраться, как использовать механизм отслеживания проекта по состоянию альф в условиях непрерывной разработки, когда система всегда «в бета-версии», непрерывно эволюционирует/развивается. Мы об этом упомянули уже, но повторим:
-
Для всей системы основные альфы всей системы хорошо использовать до момента выпуска MVP, а дальше переходить на альфы инкрементов
-
Не использовать диаграммы с альфами, использовать таблицы. Тогда вы будете легко порождать новые альфы по потребности. Почему тогда не порождать такие таблицы «из головы»? Потому как основные альфы и прописанные в наших руководствах для инженеров-менеджеров их подальфы заставят вас подумать о тех подальфах, которые важны, но о которых вы бы сами не подумали бы в суете проекта. Сами «альфы из учебника» выражаются в формате чеклистов с контрольными вопросами по достижению их состояний. И их ещё рекомендуется как-то адаптировать к ситуации вашего проекта, чтобы чеклисты были точнее. То есть альфы предписывают, о чём вы должны подумать, что должны отслеживать. Они нормативны, «так надо думать» в проекте, выделять вниманием эти альфы.
-
Основная идея — это отслеживание состояний альф, когда эти альфы являются предметами кейсов (но состояние их свидетельствуется в физических объектах, рабочих продуктах и агентах, альфы отличаются от рабочих продуктов: скажем, альфа «метод» — это не рабочий продукт, но вы можете оценить её состояние по каким-нибудь отчётам). Когда нужное состояние альфы достигнуто, кейс считается закрытым. Пока не достигнуто — продолжаем выполнять кейс, устранять обнаруженные проблемы. Если предметом кейса делать рабочий продукт, то получается похуже (рабочие продукты вроде все готовы, функция оказывается невозможной — кейс закрыт, но эксплуатировать результат нельзя, функция по разным причинам не выполняется, надо искать причину и открывать новый кейс. Вот «кейсы из альф», а не «кейсы из рабочих продуктов» решают эту проблему, отслеживается сразу конечный эксплуатационный результат, а не «папа, я собрал все шестерёнки от твоих часов в кучку, но эта куча шестерёнок почему-то не показывает время»).
Если содержание этого подраздела плохо понятно, вернитесь к наставлениям руководства по методологии, там всё изложено более подробно. Но ещё будет дополнительное изложение в руководстве по системному менеджменту.
Задания
Поставьте отметки выполнения дел.
-
Выбран пример важной для текущего проекта альфы или подальфы, состояние которой нужно отслеживать (не путать альфу и рабочий продукт в физическом мире или документ!) и определены состояния этой альфы в вашем рабочем проекте, а также методы, которыми вы достигаете этих состояний. Документирование в форме регламента.
-
Для состояний выбранной в предыдущем пункте альфы составлены контрольные вопросы для определения прохождения событий достижения этих состояний. Документирование в форме шаблона чеклиста.
-
Взят экземпляр чеклиста по его шаблону. Определено, какие состояния уже достигнуты, а какое состояние должно быть достигнуто (и если есть трудности в ответе на это вопрос, то нужно выделить подальфы и дальше проводить все эти действия уже с ними, возвращаясь к общей альфе по мере разбирательства с подальфами — для этого вернуться к регламенту и шаблонам).
-
Определены рабочие продукты, по которым можно будет отвечать на контрольные вопросы («доказательства»/«свидетельства» достижения состояния альфы или подальфы). Документировано в регламенте.
-
Составлен и опубликован в issue tracker список дел, которые нужно сделать, чтобы получить положительные ответы на контрольные вопросы для состояний выбранной альфы или подальфы.
6-, Multi-, poly-, … D
Управление данными (раньше — «управление данными жизненного цикла», сегодня — «управление данными инженерного процесса») условно относят к:
-
управлению данными продукта (делается при помощи систем PDM, product data management), когда речь идёт о проектных базах данных, в которых удерживается конфигурация целевой системы (включая промежуточные состояния сырья, ведущие к появлению сначала частей системы, а затем и всей готовой системы в целом)
-
управлению данными жизненного цикла (PLM, product lifecycle management), когда кроме данных о продукте добавляются и данные о создателях (кто что делает)
-
управлению пользовательскими впечатлениями/опытом (customer eXperience) в порядке eXperience management. Тут говорится, что речь идёт о широком наборе ролей, для которых предоставляются данные, причём сюда относят и внешние проектные роли. Главное, что успешность управления данными определяется не по оценкам инженера внутренней плафтормы разработки, а по оценкам пользователей платформы — и эта платформа так и начинает называться: customer eXperience platform (например, learning eXperience platform, LXP). Это кардинальный сдвиг, обычно очень трудный, ибо сдвижка референтного индекса даётся трудно315.
Помним, что если кто-то::создатель что-то::метод делает, то есть и данные об организации проекта и состоянии этой организации, и обязательно есть данные о том, над чем эти работы ведутся — данные рабочих продуктов, которые постепенно обрабатываются и превращаются в целевую систему. Это ведёт к появлению самых разных гибридных описаний, которые описывают и целевую систему по ходу её развития (в том числе эксплуатации), и системы графа создателей.
Тренд сегодня в том, что к числу обязательных системных разбиений добавляют разбиения уже не только самой целевой системы «как в PDM», не только разные другие виды моделей (скажем, физические модели) кроме разбиений, но и прихватывающие рассмотрение систем в графе создателей (например, четвёртый аспект рассмотрения системы по стоимости уже прихватывает не только стоимость сырья и стоимость заказных компонент системы как продуктов, но и стоимость выполнения работ, в том числе эксплуатационную стоимость — разбиение полной стоимости владения). А ещё кандидатом на обязательное разбиение становится разбиение работ (WBS, work breakdown structure). Формально PLM отличается от PDM как раз тем, что хранит конфигурацию не только продукта (целевой системы), но и проекта (создателей в их графе, в том числе конфигурацию работ). По факту PLM состоит обычно из системы версионирования (репозитория), в которой хранится информация о конфигурации продукта и issue tracker, в котором хранится конфигурация работ. Например, для случая софта это может быть репозиторий Git и issue tracker к нему, которые собраны в какой-то общий сервис вроде GitHub316 или GitLab317. В случае «железного железа» (механические системы, не компьютерное железо) это может быть сервис типа OpenBom318.
Последний тут тренд — это переход от PLM систем к eXperience Platforms (XP). Основная идея eXperience platform — это управлять данными, выходящими за пределы традиционно понимаемого инженерного процесса (прежде всего — данные о внешних проектных ролях, например, данные по продвижению продукта — маркетинг, продажи, данные по постпродажному обслуживанию, эксплуатационные данные). Ещё одна проблема, которую решает переход от PLM системы к XP — это управление информацией, важной для внешних проектных ролей по отношению к команде проекта (PLM прежде всего ориентировались на поддержку команды проекта, и обычно не на всём жизненном цикле, а только на стадии разработки). Так, UX (user eXperience) от UI (user interface) отличается тем, что призывает поглядеть на user отнюдь не в тот момент, когда он нажимает кнопки приложения на экране: его проблемы начинаются сильно раньше и заканчиваются сильно позже, и момент нажатия на кнопки там только часть происходящих событий у пользователя. Впечатления/опыт пользователя поэтому не сводится только к «нажатию красивых кнопок красивого интерфейса», а связаны с тем, удалось или нет пользователю решить задачу — и если при отличном пользовательском интерфейсе не удалось, впечатления будут плохие. Грубо говоря, если вам хамит красивый человек с приятной улыбкой, то впечатление останется от его хамства (поведения), а не от интерфейса. Вот этот аспект оказывается очень труден для понимания: отслеживание общего впечатления самых разных проектных ролей, внимание на eXperience.
В предметной области UX не доходят до систем управления данными, не доходят до управления конфигурацией, просто указывают на вот этот разворот в понимании жизненного цикла как eXperience. Но в инженерии внутренней платформы разработки этот тренд stakeholder eXperience (самые разные проектные роли! Не только customer!) был подхвачен, и как пример, программный комплекс PLM ENOVIA плавно перешёл и по названию, и по сути в 3DEXPERIENCE319. Теперь этот программный комплекс занимается управлением информацией (данными) инженерного процесса машиностроительных и строительных проектов (указывается на применимость в 11 отраслях). Смысл переименования из PLM ENOVIA в 3DEXPERIENCE PLATFORM был в том, что он начал поддерживать работу с данными инженерного процесса далеко за пределами стадии проектирования, как это было в ENOVIA. Но всё же там в основе платформы ровно то же самое, что было верно и для PLM: репозиторий для отслеживания версионирования конфигурации (конечно, с интерфейсами к самым разным CAD/САПР системам, самым разным моделерам) и issue tracker для управления изменениями конфигурации.
Ещё один пример — это LMS (learning management system, аналог PLM для систем образования, поддерживает решение проблем команды образовательных организаций) стал сейчас LXP, learning eXperience platform, ибо поддерживает решение проблем студента, а не только решение проблем учителей320. Так что в современное руководство по системной инженерии мы вписываем и PDM, и PLM, и eXperience (со второй большой буквой, чтобы отличить от просто «опыта»). И это ещё не конец истории, поскольку появился и новый термин, обращающий особое внимание на операционные данные (данные стадии эксплуатации): цифровой двойник (digital twin) в его вариантах цифровой модели, цифровой тени и истинного цифрового двойника. Но об этом в текущем разделе руководства будет говориться немного дальше.
Главное, что нужно запомнить, что во всех этих вариантах внутренних платформ разработки увязываются работы внешних проектных ролей (eXperience), создателя (PLM) и конструкция целевой системы (PDM): все контрольные точки (они нужны для операционного управления, то есть для управления работами создателя по воплощению, а также по удовлетворению интересов внешних проектных ролей) порождаются для модели проекта/project на основе модели продукта (design). Тут асимметрия: не из работ по воплощению делается разбиение системы, а наоборот: для каждой части системы (они описываются в design) проектируются работы по её созданию («заказать, получить, проверить, смонтировать, наладить/настроить, проверить работу в составе системы»), а каждая работа имеет свою контрольную точку — для того, чтобы отследить её выполнение. Потом можно назначать работников и начальные моменты старта для уже понятных работ/задач/task.
Моменты времени для контрольных точек расставляются исходя как из технологической последовательности («сначала стены, потом крыша»), так и из балансировки ресурсов («побыстрее» против «равномерной загрузки» — или в пике на стройке атомной станции вдруг обнаруживается 2700 человек, и начинаются проблемы с туалетами, обедами, жильём, но всё идёт очень быстро, или равномерно на станции работает каждый день примерно 700 человек, не сильно больше и не сильно меньше — стройка будет длиться подольше, но и многие проблемы пиковых авралов на 2700 человек при этом будут отсутствовать).
Проверка качества такого планирования в «железных» и строительных проектах может быть — анимационными роликами (имитационное моделирование). В них хорошо видно, как «забыли завезти крупногабаритное оборудование вовремя, пришлось разбирать свежевозведённую стену, чтобы затащить оборудование в помещение».
Такой метод порождения контрольных точек из данных по продукту получал разные названия, потому что люди из маркетинга очень хотели иметь собственное для каждого поставщика инструментария внутренней платформы разработки фирменное наименование для такого «прогрессивного способа» увязывания конфигурации продукта (3D-модели продукта для киберфизических систем) и конфигурации работ. Чаще всего эти названия крутились вокруг числа «пространственных измерений/размерности/dimension», потому как 2D-чертежи заменялись 3D-информационной моделью. Число D (dimension) в итоговой мегамодели для «железных» и строительных проектов потихоньку росло с начальных 3D и переставало быть «пространственной размерностью». У Toshiba в конце нулевых в софте для конструирования было 6D (хотя это уже давно забытый факт, но технология называлась 6D), у НИАЭП Росатома в начале десятых годов 21 века уже было радикальное Multi-D321, число размерностей признавалось радикально большим, много больше трёх пространственных измерений.
В последние несколько лет популяризируется 8D как самое броское в популяризации подхода, например 8D digital twin experience от SNC-Lavalin322. В 8D подходе всё ровно то же самое, что можно было услышать десяток лет назад в презентациях по PLM, но слова другие — digital twins, ибо акцент уже не только на проектировании и сооружении, но и на эксплуатации, поэтому engineering data дополняются asset data, а конечная цель — автономная (без человека, где-нибудь в абсолютно безлюдной местности) эксплуатация на основе «единственного источника правды», single source of truth (это мы повторяем материал руководства по системному мышлению, подраздел *«*Альтернативные варианты основных видов разбиения системы на части»):
-
1D метаданные, документация (тексты)
-
2D чертежи (там, где «обычные двумерные чертежи» ещё есть, «родные файлы» из CAD/САПР)
-
3D информационные модели (это представление физической формы/геометрии/компоновки системы с указанием материалов и многих других характеристик)
-
4D «видеоролик» стройки/сборки в развёртке во времени, то есть к 3D добавляется план/schedule сооружения (стройки и монтажа) или сборки
-
5D это ресурсы, material status/cost, то есть добавляется стоимость
-
6D вот тут появляется operation, real time data (и мы перешли из «construction time»/«enabling realm»/«времени создания» в «operation realm»/«operation time»/«время эксплуатации», и с этого места принято говорить, что речь идёт не о системе поддержки жизненного цикла/PLM, а цифровом двойнике/digital twin уже созданной физической системы)323
-
7D это live streaming, передача видеопотока работающей целевой системы и её окружения (с видеокамер, со спутника — отдельно от real time data с датчиков, ибо это огромные объемы данных).
-
8D это уже аналитика, предсказания систем машинного обучения (ML predictive data)
Во всех этих методах создания внутренней платформы разработки все данные инженерного процесса ставятся под контроль конфигурации (иногда это называют «управление информацией», иногда «интеграцией данных жизненного цикла», иногда «непрерывная интеграция») так, чтобы можно было проверить отсутствие конфигурационных коллизий в компьютерной модели до того, как они проявятся в момент изготовления системы и уж тем более эксплуатации системы.
Если система имеет электропитание 12 вольт (и это электропитание проектирует одна фирма), а осветительную лампочку в неё запроектировали на 220 вольт (это делала другая фирма), то это должно быть обнаружено ещё до покупки лампочки, до выдачи лампочки в монтаж, до включения лампочки в актуальной системе. И особо повторим: кроме интеграции инженерных данных о продукте (целевой системе) нужно ещё интегрировать менеджерские данные о создателях. И тоже думать об отсутствии конфигурационных коллизий — чтобы не оказалось, что лампочку должен вкручивать вчера уволенный электрик.
Вот эта проверка конфигурационных коллизий между создателями и создаваемой системой интересна тем, что в ней хорошо видны не только банальные ошибки планирования, но и тщательно запланированные злоупотребления: выполнение работ с никакой частью системы, закупка комплектующих, которые потом не задействованы никакой работой.
Вот картинка, которая показывает более чем обычную ситуацию: две внутренних платформы разработки (XP или даже более древние PLM) системы в одном проекте, при этом они могут быть развёрнуты или в разных подразделениях одной большой фирмы, или даже в разных фирмах, когда разработка ведётся в рамках «производственной кооперации»/ «extended enterprise»:
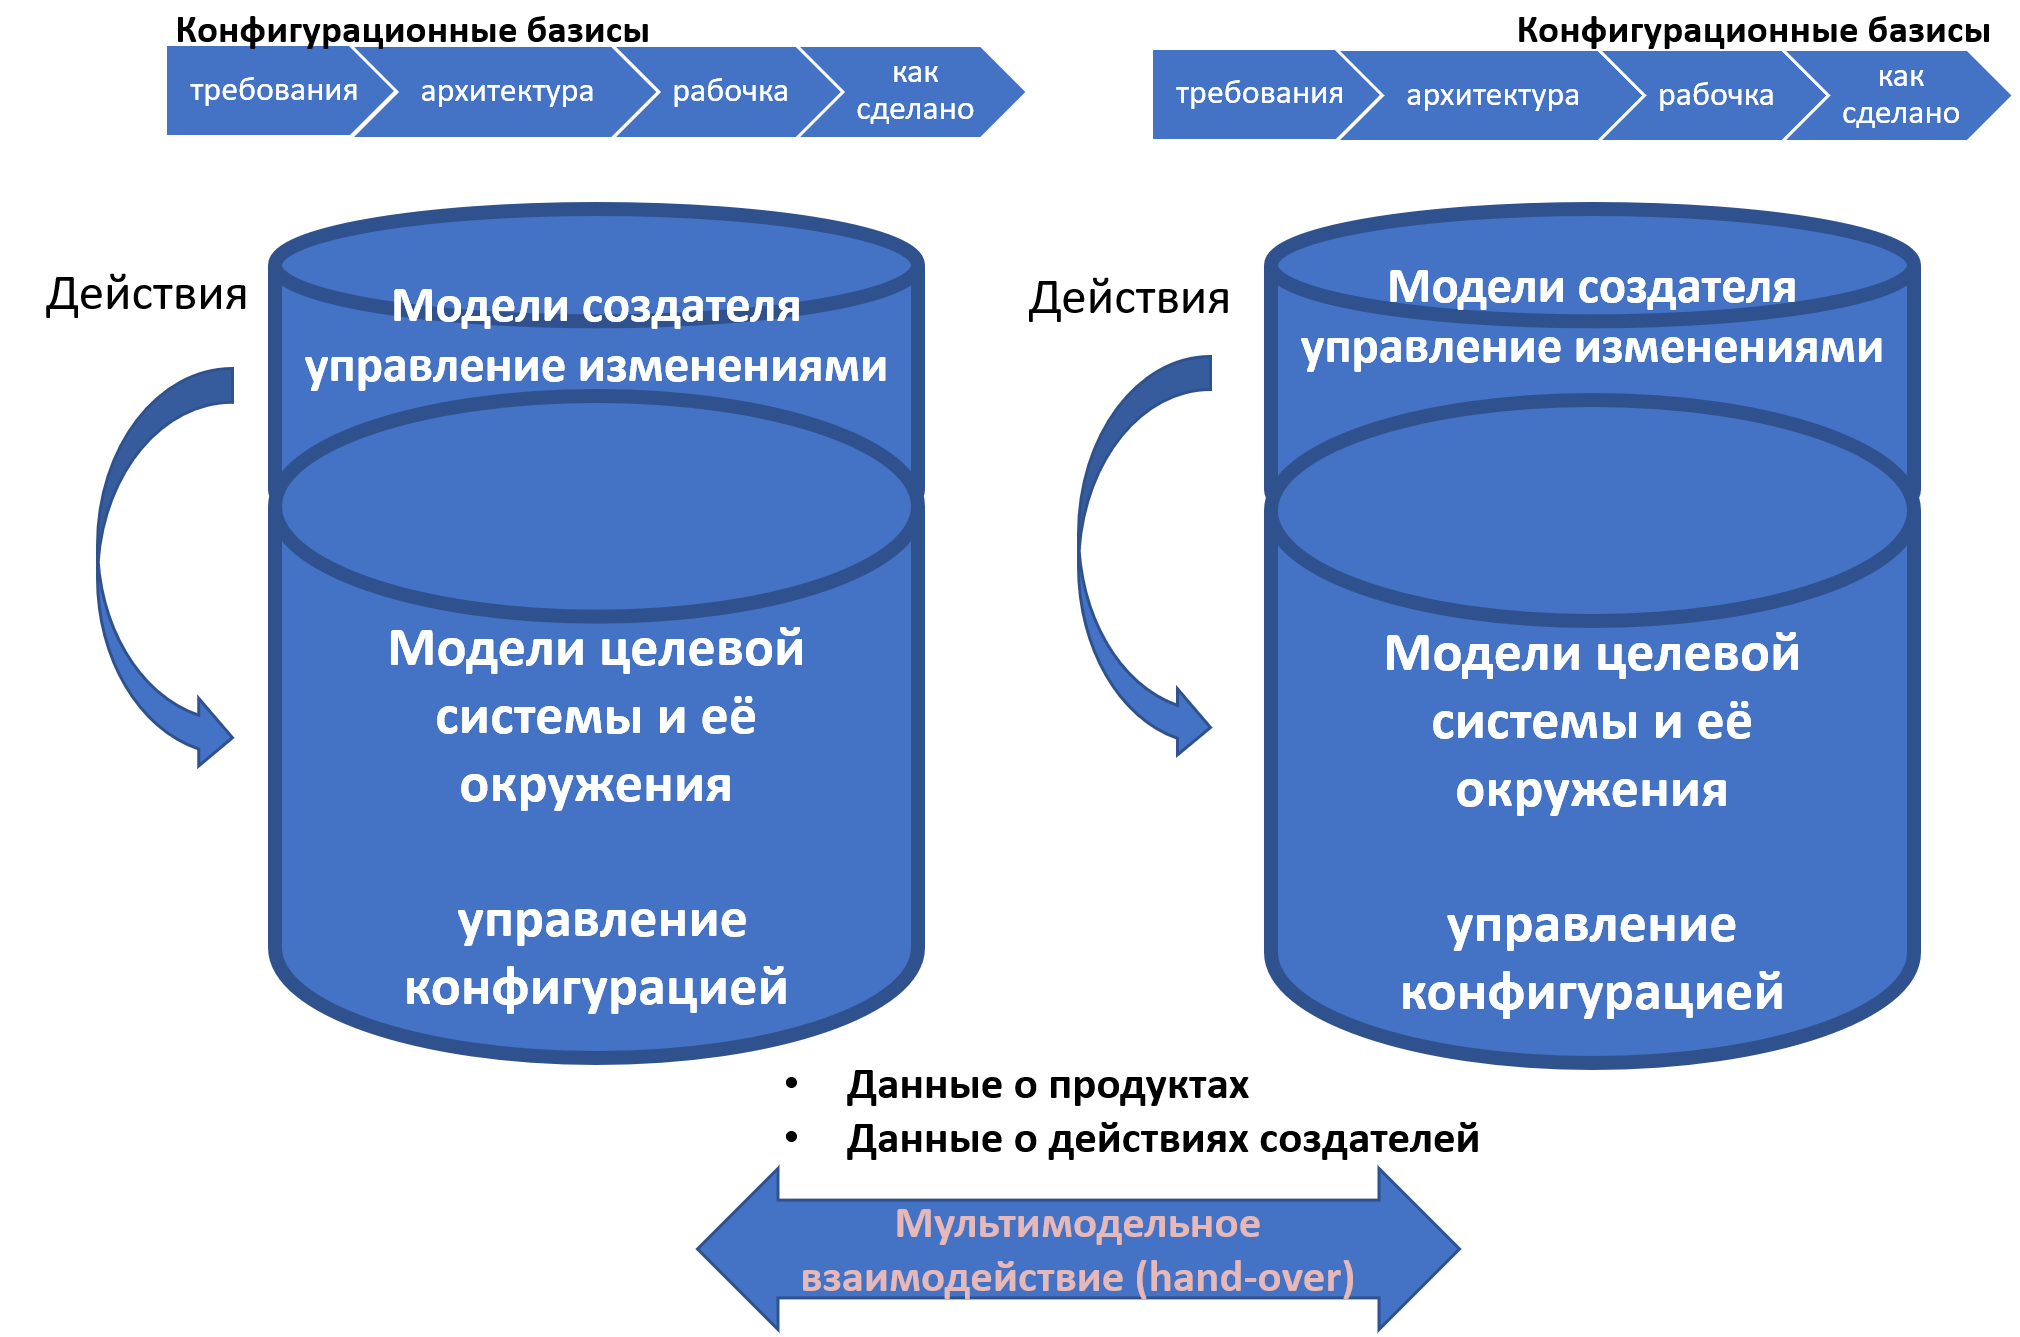
Картинка отражает обычное на сегодня состояние «железного» проекта, как это понимается в классической «железной» системной инженерии, предусматривающей «однократный ввод в эксплуатацию». Научитесь по таким картинкам определять, что они «из прошлого десятилетия» (хотя они могут быть подготовлены буквально вчера!). Какие признаки старого мировоззрения, старой инженерии? На картинке же вроде правильные слова про «модели», правильные слова про управление конфигурацией, правильные слова про системы? Но на ней явно приведены два «однократных» водопада, начинается всё с требований (а не других современных способов описывать функциональность системы), рабочка и «как сделано» тоже последовательны (не каждое отклонение немедленно вносится в рабочку, а «сначала всё делаем, потом вносим все изменения разом» — в уме рисовавшего диаграмму был «водопад»). Вы должны распознавать всё это, ибо рядом с такими диаграммами будут обязательно написаны слова про agile (это же модно! Все хотят быть «гибкими» и «современными», а слово написать на эту тему нетрудно).
Но давайте разберёмся, о чём нам говорит такая диаграмма (она ведь описывает положение дел, которое вам наверняка встретится в каком-нибудь строительном проекте, или проекте создания электростанции). В каждой внутренней платформе разработки есть и система версионирования продукта (отслеживание модели целевой системы и её окружения, обычно репозиторий, относится к управлению конфигурацией, PDM) и issue tracker (модели создателя, прежде всего проводимых создателем работ по созданию его системы в графе создателей — расширение PDM до PLM). Эти системы общаются между собой (обмениваются данными), и тут нужно помнить: передавать между системами нужно не только информацию о продукте (например, новую деталь или программный модуль с замечаниями к ним), но и информацию о планируемой работе (например, указание на то, что нужно посмотреть на свежеразработанные деталь или программный модуль и прислать в ответ замечания). А что с ходом на eXperience management? В картинке ничего этого не видно, выхода на управление информацией для внешних проектных ролей не показано (при этом выводы делать рано: «не показано на картинке» — это не значит, что в самом проекте этого не было сделано! Возможно, всё сделано, но просто «не показано», посылка открытого мира).
Как будет идти жизнь в проекте, который делался по показанной в диаграмме картинке? По «водопаду»? Нет, мы неоднократно замечали, что «водопад» — он только в мозгах, «модель». В жизни будут непрерывно меняться требования (ибо природу «гипотезы», «догадки» никто не отменял, даже если очень хочется считать это «окончательно зафиксированными требованиями», это просто документированные догадки). Только менять их будет административно очень тяжело, равно как административно тяжело будет менять проектные решения (базисы, которые устарели сегодня) под изменившиеся требования, равно как и менять реальные конфигурации воплощения системы. Жизнь будет как в agile проекте, только с искусственными административными препятствиями. Работа будет не элегантной, не lean.
Иногда управление конфигурацией относят именно к управлению инженерными данными для целевой системы (версионирование), а управление изменениями в целевой системе к управлению данными о том, кто и что с будущей целевой системой делает, то есть управлению операционными данными о создателях. Как ни разносить интеграцию данных инженерного проекта по разным методам, нужно просто понимать, что конфигурационные коллизии нужно искать в мегамодели, которая описывает и проект/design продукта/product, и менеджерский проект/project, и это нужно делать в условиях множества не только продуктов-подсистем целевой системы и окружающих систем в надсистеме (учитывать множество самых разных design, которые разрабатываются в самых разных системах автоматизации проектирования и моделерах), но и в условиях множества проектов/project, которые ещё готовы как-то делиться инженерной информацией, но часто не готовы делиться информацией о выполнении работ из своих issue trackers или систем классического проектного управления (например, строительных).
Интеграция данных
Управление конфигурацией, управление изменениями, управление инженерной документацией, управление информацией, интеграция инженерных данных (данных жизненного цикла, данных инженерного процесса), создание цифровых двойников324 с использованием цифровой нити325** —** эти все методы близки до неразличимости, нюансы невелики. Во всех этих методах инженерии внутренней платформы разработки:
-
Моделируй разные аспекты самых разных систем при помощи самых разных моделеров. Иногда это проектирование (модели нет, системы нет, придумываем модель, потом её реализуем), но иногда создание (или хотя бы модификация) моделей путём reverse-engineering. Это происходит с надсистемой, когда в её состав вписывают целевую систему в рамках составления гипотез по концепции использования, но также и при создании модели as built, потому как не всегда в реальной физической системе удаётся соблюсти её соответствие проектной/design модели (модель «as built»/«исполнительская модель», например в строительстве до сих пор строят не роботы, и результат в физическом мире будет не совпадать с исходной информационной моделью: нужно будет привести модель в соответствие с жизнью). Тут используются моделеры, системы автоматизации проектирования (САПР/CAD), раньше говорили «автоматизированные рабочие места» (АРМ, но этот термин уже сильно устарел). DevOps инструментарий в программной инженерии должен учитывать и IDE (interactive development environment)326.
-
Используй версионирование: всегда знай, с какими версиями моделей ты работаешь. Для этого храни версии не в моделере, а собирай их в системе ведения версий (репозитории моделей), где ты сможешь ещё и сказать, какие версии каких моделей соответствуют друг другу, а также проверить наличие конфигурационных коллизий. Давай доступ в том числе и внешним проектным ролям (eXperience platform).
-
Отслеживай не только модели, но и продукт, который построен по этим моделям. Знай всегда конфигурацию продукта (что из каких версий частей модели вошло в отгружаемую или даже уже эксплуатируемую систему). Конфигурация системы — это сама система, а не её описание, не её модель.
-
Интегрируй, то есть управляй конфигурацией и проверяй на отсутствие конфигурационных коллизий, чтобы найти их как можно раньше в ходе разработки, исправить до того, как начали создавать физическую систему.
-
Интегрируй не только информацию о целевой системе/продукте, но и о проекте (графе создателей, то есть информацию менеджеров, информацию проектного управления). DevOps инструментарий в инженерии должен учитывать не только CAD/CAM/CAE с PLM или eXperience platform, но и ERP327 (enterprise resource planning, планирование потоков полуфабрикатов/ресурсов уровня предприятия) и MES328 (manufacturing execution system, планирование уровня цеха).
-
Не останавливайся на разработке: продолжай моделировать систему и отслеживать её конфигурацию в ходе её эксплуатации, это даст переход к цифровому двойнику.
Проблемы тут в том, что всем этим будут заниматься информационные системы самых разных поставщиков, они как «коллективные экзокортексы» будут принадлежать самым разным фирмам, предметом их работы будут самые разные аспекты самых разных (целевая, надсистема, подсистемы, создатели в их графах) систем, эти системы будут в самых разных состояниях готовности в самых разных версиях, и у этих систем будут самые разные физические, финансовые и иные модели, мета-модели и мета-мета-модели, которыми руководствовались разработчики этих систем. Грубо говоря, у одной колёсной системы будет «путь в метрах», у другой «угол поворота колеса в радианах» (что позволяет вычислить путь в метрах, но это ещё нужно догадаться, как). И это самый простой случай.
По факту в интеграции данных речь идёт о переводе с одного языка на другой, и представьте, когда в проекте родные языки сотрудников китайский, суахили и испанский. На каком языке будет общение? На «нейтральном», которым служит английский, на котором никто не говорит! Это была основная идея «цифровой нити»: переводить всю информацию в «нейтральный формат» и тем самым налаживать обмен информацией между информационными системами.
Давайте рассмотрим жизненный цикл какой-нибудь задвижки на трубопроводе.
Объект «задвижка» появляется в проекте/design задолго до появления физической задвижки на трубопроводе. Это отражено на рисунке, показывающем состояния экземпляра задвижки по мере прохождения ей состояний от «задумана» до «выведена из эксплуатации»:
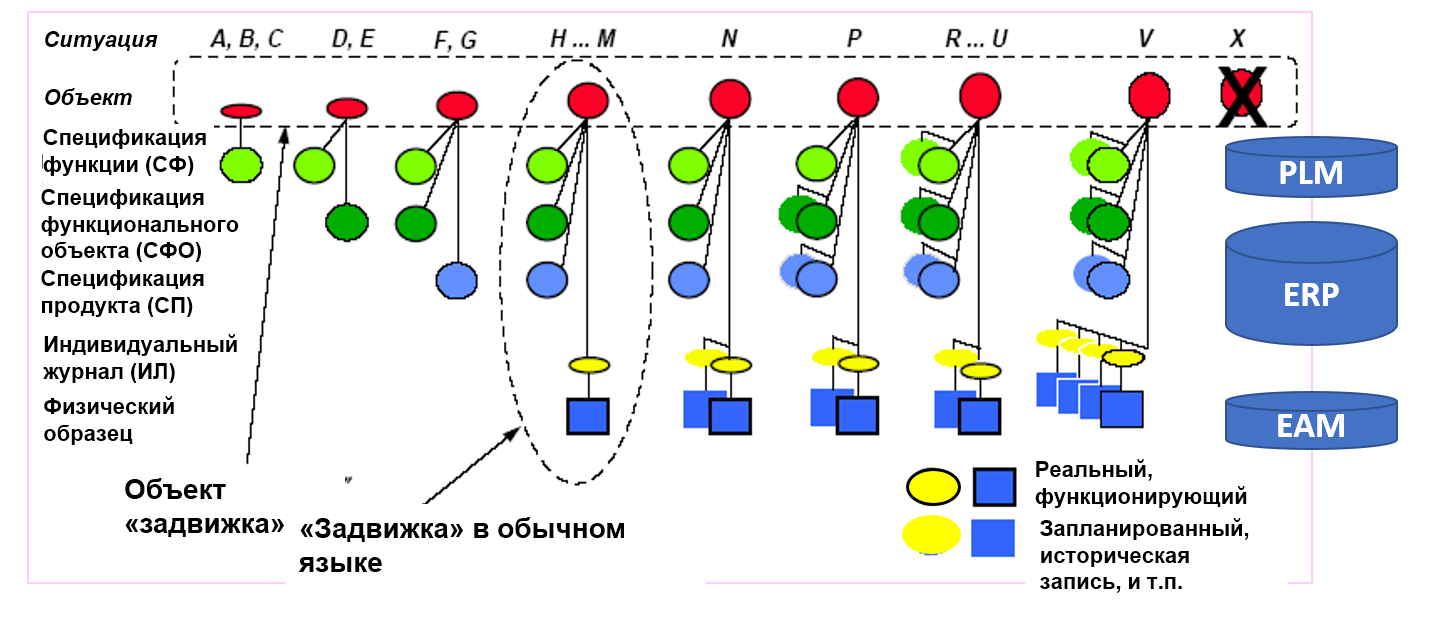
В системе проектирования трубопровода процессный инженер разрабатывает спецификацию функции перекрытия трубопровода, после этого говорит, что трубопровод будет перекрываться функциональным объектом «задвижка» с какими-то определёнными характеристиками, появляется спецификация уже не только функции задвижки, но и её самой (функция — это поведение ролевого объекта, функция задвижки — перекрывать поток). Далее идёт конструирование/проектирование: для функциональной задвижки определяются параметры конструктивного объекта задвижки как типа возможного конструктива/модуля, и этот объект с подходящими параметрами ищется у производителей задвижек.
Когда найден производитель подходящей по параметрам задвижки, там покупается конкретный физический образец задвижки с каким-то серийным номером, и на него заводится индивидуальный журнал ремонта и обслуживания задвижки. «Задвижка» в обычном языке означает вот это всё вместе: физический объект, изготовленный каким-то заводом, который играет роль функционального объекта в создаваемой системе.
Далее можно представить замену этой задвижки другой с каким-то другим серийным номером, это тоже нужно будет отразить в информационной модели системы. Далее можно представить, что как-то меняем систему и меняем спецификацию продукта, а то и функционального объекта, а то и самой функции (скажем, поменялся состав жидкости, давление жидкости, и теперь нужно использовать задвижки с другими характеристиками).
Обычно для киберфизических систем функциональное проектирование ведётся в CAD, но дальше информация хранится в системе PLM (или eXperience platform, но прогресс дошёл отнюдь не до всех компаний реального сектора). В PLM системе обычно не хранятся серийные номера физических заглушек, а информационная модель там «в типах», ибо проектирование всегда ведётся «в типах»: информацию о требуемой заглушке передадут в ERP-систему (Enterprise Resource Planning), которая отследит закупку системы у какого-то поставщика, её логистику и выдачу в монтаж (логистика и операционный менеджмент ресурса «заглушка»), а затем эту информацию передадут в EAM-систему (enterprise asset management), где будут вести индивидуальный журнал эксплуатации заглушки как актива (в последнее время вот такие EAM-системы называют всё чаще «цифровыми двойниками», ибо речь идёт о стадии эксплуатации и чаще и чаще эти заглушки уже не «ручные» из косного вещества, а с датчиками и моторчиками — роботизированные, и цифровой двойник поддерживает модель актуального состояния эксплуатирующейся заглушки). PLM-система по-прежнему при этом будет содержать информацию о том, какую функцию выполняет эта заглушка, а ERP-система будет помнить, у кого её купили и что там говорилось в договоре покупки — это очень пригодится, когда что-нибудь с этой заглушкой пойдёт не так (скажем, поломается, в том числе поломается в рамках гарантийного срока, или её потребуется заменить или оставить в ходе при модернизации всего трубопровода).
Разные цвета на рисунке — разные по типу «задвижки», они и называются по-разному (чтобы отразить в названии их тип) в разных информационных системах:
-
Зелёный цвет — это функциональный объект «комплектующее», с ним работает PLM-система
-
Синий цвет: кружок — это конструктивный объект «предмет снабжения», с ними работает ERP-система, а квадрат — это «установленное оборудование», с ним работает EAM, и там это может называться ещё и «актив» (asset).
-
Жёлтый цвет — это документ с описанием конструктивного объекта, с ним работает EAM (цифровой двойник).
По большому счёту, мы можем заменить заглушку в киберфизической системе на сотрудника в организации. Тогда в оргмоделере предприятия будет определён метод, который должна будет выполнять какая-то оргроль и сказано, какая это оргроль, а ещё определено оргзвено, выполняющее эту роль. Этот оргмоделер будет абсолютно аналогичен САПР (CAD), а ещё там будет хранилище данных такого САПР, аналог PLM-системы. Затем в софте службы кадров будет проведён поиск специалиста или специалистов, которые могут выполнить эту работу (аналог ERP-системы). И в том же софте службы кадров и софте бухгалтерии появится «досье» на нового сотрудника, где будет накапливаться информация о его повышениях квалификации, выговорах и премиях (аналог EAM системы, цифрового двойника).
Конечно, информационных систем в подобных проектах много больше, чем три, и управление информацией занято тем, чтобы исключать медленные и дорогие со множеством неизбежных ошибок (ведь это работа людей!) передачи данных путём «прочесть глазами в одной системе, вбить руками в другой системе» из одной системы в другую. Интеграция информации жизненного цикла делается не глазами-руками, а программами конвертирования информации. Эти программы называют часто «цифровой нитью». Вот рисунок, на котором схематично изображена такая «цифровая нить» для производственных систем:
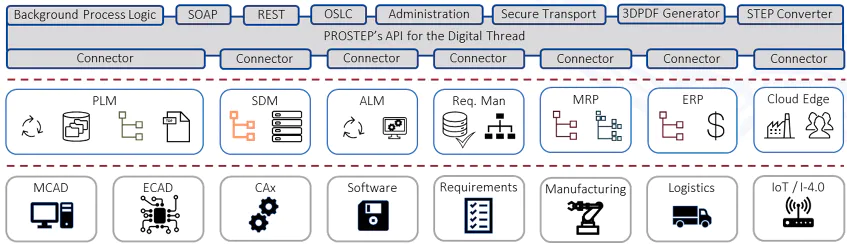
Серый прямоугольничек — это разные программные интерфейсы для самых разных информационных систем, которые могут встретиться в жизненном цикле системы (читай: встретиться в организациях-создателях в самых разных графах создателей), и там важны коннекторы/адаптеры/конверторы форматов данных в какой-то нейтральный формат. Этих форматов тоже множество, никакого аналога «рабочего английского», как в естественных языках, для цифровых нитей не было разработано — каждая фирма-поставщик цифровой нити изобретает свой вариант нейтрального формата и даже ухитряется сделать такой формат международным стандартом, причём стандартов таких удивительно много, поэтому разные цифровые нити жёстко конкурируют на рынке и плохо совместимы друг с другом.
Цифровые нити работают с интеграцией данных нескольких разных видов:
-
Операционные/транзакционные данные, то есть данные о конкретных экземплярах целевой системы и её описаний, а также действиях с ними: от проекта/design и проекта/project до эксплуатационных данных целевой системы, мы как раз обсуждали в этом разделе именно эти данные в их разнообразии.
-
Мастер-данные (master data)329, которые используются в нескольких проектах предприятия, работающих с самыми разными целевыми системами. Это чаще всего данные по клиентам и поставщикам.
-
Справочные данные (reference data)330, которые используются в бизнес-эко-системе, то есть одинаковы для проектов самых разных предприятий: нормативно-справочная информация, стандарты, единицы измерения и т.д.
Интеграция данных работает с двумя основными сценариями:
-
Одно- или двухстороннего доступа из одного приложения в другое.
-
Разовый перенос информации из старого приложения в новое (это называют «миграция данных», data migration331)
Для систем другой природы управление конфигурацией совсем не так очевидно устроено, и цифровая нить может быть устроена совсем по-другому. Например, когда мы говорим о связывании цифровой нитью информационных систем государства, то встаёт множество вопросов по защите персональных данных, смещению баланса власти между людьми и чиновниками, превращению государства в полицейское (любой чиновник будет знать о любом гражданине много больше, чем можно себе представить — это приводит к злоупотреблениям, ибо власть развращает, а абсолютная власть развращает абсолютно). Но если речь идёт о так называемых «госуслугах» (которые вам, конечно, вменяют — вы их берёте не добровольно, а подчиняетесь требованиям закона), то становятся ненужными бумажные справки: то, что какая-то госслужба знает о вас всё, оказывается в этом случае вам же и выгодным. Как всегда в эволюции, цифровая нить даёт огромные новые возможности развития информационных систем в инженерных проектах, но она же порождает конфликты, приводящие к неустроенностям/frustrations, множеству примерно одинаковых по оптимальности самых разных решений.
«Цифровая нить» (digital thread) тут тоже одно из многих маркетинговых имён, продолжающих увеличивать количество терминов, использующихся для указания на информационные системы и методы, помогающие управлять конфигурацией и изменениями в инженерных проектах. Эта же «цифровая нить» в корпоративных информационных системах разных провайдеров сервисов (банков, страховых компаний и прочих, где речь не идёт о традиционных продуктах-вещах) будет называться сегодня гиперавтоматизация/hyperautomation332 (RPA, robotic process automation333 как автоматизация заполнения экранных форм, когда-то придуманных для работников-людей, плюс добавление программ искусственного интеллекта, помогающего распознавать отчёты одних программ и создающих затем содержание для заполняемых при помощи RPA форм). В любом случае все такие проекты относятся к интеграции данных проекта какой-то системы, и речь идёт об обеспечении взаимодействия информационных систем путём их интеграции, унификации или федерирования. Это рассматривалось в руководстве по системному мышлению в подразделе «Платформы и технологические стеки», там упоминался стандарт налаживания взаимодействия ISO 11354-1:2011, framework for enterprise interoperability334. Помним, что принято говорить «интеграция информации» или «интеграции данных» (иногда добавляют «проекта», «жизненного цикла», «предприятия», «инженерного процесса» — по вкусу), но по факту это обычно федерирование (информационные системы ничего друг о друге не знали до федерирования), очень редко унификация (информационные системы соответствуют одному стандарту) и почти никогда — именно интеграция (информационные системы проектировались специально для совместной работы) в смысле ISO 11354-1:2011.
В каком направлении развивается метод цифровой нити? Сегодня основное — это так называемая «семантическая интеграция данных», то есть использование конверторов из одной формально-логической схемы данных в другую. Но она, увы, плохо работает: разные формально-логические схемы оказываются несовместимыми друг с другом. Поэтому надежда на системы искусственного интеллекта, которые для совмещения разных объектов из разных информационных систем могут использовать естественный язык и непрерывное (а не дискретное формально-логическое) многомерное пространство значений. Идея активно обсуждается335, но реальных производственных приложений пока нет.
Использование цифровой нити в управлении конфигурацией и изменениями даёт возможность задействовать параллельную инженерию (concurrent engineering)336 в проектах, которые подразумевают «разовую» одноцикловую инженерию (строительные проекты тут как пример). При параллельной инженерии все работы по разным методам инженерного процесса идут почти одновременно, «в параллель», то есть замысливание (в частности, запросы новых возможностей/features), проектирование, изготовление и эксплуатация системы идут одновременно, «в параллель».
Но как можно строить, например, дом, если ещё не закончен его проект? Наверняка же будут многочисленные коллизии! Будут закупаться не те количества материалов, которые нужны, будут возводиться стены там, где они не предусмотрены ещё не сделанным проектом, много чего будет! Но нет, благодаря современным методам управления конфигурацией и изменениями удаётся избегать конфигурационных коллизий, а времени на разработку и изготовление уходит меньше, и даже эксплуатация начинается раньше: пока строят правое крыло здания, в левом уже живут, а башенку уже заканчивают проектировать — всё с разными частями системы происходит в разное время, а управление конфигурацией и изменениями плюс высокая точность изготовления не допускают, чтобы все эти части будущей системы вдруг не состыковались друг с другом.
Ещё один тренд — это цифровая нить, связывающая системы проектирования и системы изготовления. Раньше передача данных проекта/design осуществлялась путём перевозки грузовиками бумажной проектной документации из конструкторских бюро на завод, или из проектных институтов на стройку. Теперь передача данных проекта/design происходит онлайн, причём при необходимости происходит конверсия форматов. Это не так просто, ибо часто в момент проектирования контрактор по изготовлению ещё неизвестен (ибо ещё непонятно, что будет заказываться, непонятно, сколько будет стоить изготовление). Идеал, когда конструктор или проектировщик и технолог организации-изготовителя/производителя системы сидят рядом в ходе проектирования и выполняют работу вместе (так называемое «проектирование для изготовления»/design for manufacturing), соблюдается редко. Но такое тоже случается всё чаще и чаще: компании вроде SpaceX и Tesla собирают проектирование и изготовление вместе, проектировщики и технологи там действительно работают вместе, и это в таких сверхсложных системах, как современные ракеты, оказывается выгоднее, чем размещать разовые заказы «где-то в Китае» и потом разбираться с возможными рассогласованиями и задержками.
Цифровая нить стимулирует объединить информационные системы проектировщиков и изготовителей и предотвратить коллизии типа «вот вы тут разработали деталь, а её невозможно изготовить дёшево и быстро, или даже вообще нереально изготовить на имеющемся оборудовании». Зависимость проектирования от способа изготовления оказывается существенной: тренд на «меньше деталей, но сами детали более сложной формы» связан с распространением полностью цифрового проектирования и полностью цифрового изготовления на 3D-принтерах: стоимость 3D-печати сложных деталей оказывается меньше стоимости точной обработки деталей для достижения герметичности на многих стыках простых деталей, плюс стоимости логистики деталей для сборки, плюс стоимости сборки и проверок.
Так что после того, как вы сделали первый ход по мантре «распожаризации»/lean и прекратили заниматься ненужной работой, обязательно продолжайте наведением «инженерной бюрократии», как иногда называют управление конфигурацией и изменениями: наводите в проекте порядок, чтобы не возникало конфигурационных коллизий как основного источника «пожаров» с неминуемыми переделками. И только потом резко ускоряйте работы за счёт сначала грамотного операционного менеджмента инженерной разработки и изготовления (уменьшения времени ожидания операций), а затем и за счёт использования более современных методов разработки и изготовления систем самой разной природы, самых разных масштабов.
Моделирование: конфигурационные коллизии
Опишите больше трёх последних конфигурационных коллизий, которые были обнаружены в вашем проекте:
| Номер п/п | Описание коллизии | Участвующие конфигурационные единицы | Метод работы, при выполнении которого проявилась операционная коллизия | Сколько времени заняла повторная работа (re-work) |
|---|---|---|---|---|
| 1. | ||||
| 2. | ||||
| 3. | ||||
Задания
Поставьте отметки о выполнении дел.
-
Убедитесь, что для каждой части вашей рабочей системы у вас запланирована работа по её проектированию, изготовлению, сборке-наладке-отладке, инженерному обоснованию.
-
Убедитесь, что для всех ваших рабочих продуктов у вас есть система ведения версий и известно, кто и когда вносил какое последнее изменение.
-
Написан и опубликован пост «Цифровая нить нашего проекта», где описываются информационные системы в вашем проекте, описания каких систем (целевой, подсистем, надсистемы и систем в окружении, создателей в их графах) для выполнения каких методов работы в инженерном процессе они содержат, и как они обмениваются между собой информацией в свете ISO 11354-1:2011 (в соответствии с каким подходом они создавались: интеграции, унификации или федерирования информационных систем).
-
Написан и опубликован пост по развитию тренда digital transformation и hyperautomation в сторону использования систем AI. В пост включено несколько абзацев про перспективы AI в инженерном процессе вашей организации.
Цифровой двойник
«Железная» системная инженерия потихоньку решает проблему, которую решали DevOps в программной инженерии: методы разработки и методы эксплуатационной инженерии систем оказались разобщены, ибо в ходе разделения труда одни инженеры-разработчики и инженеры-производственники проектировали и изготавливали систему, а другие инженеры-операторы занимались её эксплуатацией (настраивали для получения оптимальных режимов работы, загружали сырьём, следили за отсутствием поломок, а если системами пользовались люди-неинженеры, то помогали этим людям).
У системных администраторов программных систем и разработчиков программных систем был образ, когда разработчики перекидывают очередной релиз через высокую кирпичную стену на сторону сисадминов, а дальше сисадмины мучаются, пытаясь объяснить пользователям, почему всё вдруг не работает, или работает не так хорошо, как хотелось бы. Движение DevOps как раз решало эту проблему, но эта проблема есть во всех видах инженерии. Например, она есть у официантов и кухни в ресторанах: претензии клиентов слышат официанты, а повара делают своё дело, полностью изолированные от клиентов. Инженерия внутренней платформы разработки была призвана это изменить: разработчики должны были сами развернуть систему и предоставить её пользователю, услышать его вопросы, узнать впечатления/eXperience — а работа операторов по настройке и разворачиванию должна была полностью исчезнуть, она автоматизировалась, её брала на себя инженерная платформа, DevOps превращалось в Dev + NoOps = потому что новая роль «инженеры внутренней платформы разработки» обеспечивали автоматизацию, NoOps. Кухня — и сразу едоки, никаких официантов, а пищу из кухни в зал выносит робот. С роботом не поскандалишь, и робот заодно меньше ошибается и работает быстрее и дешевле.
В системной инженерии «железных систем» этот же тренд DevOps развивался как движение «цифровых двойников», digital twins. Это именно двойники, то есть они похожи друг на друга, а не «близнецы», ибо их природа разная: физический двойник это и есть целевая система, а виртуальный/цифровой двойник — это операционная модель целевой системы. Путь к настоящему цифровому двойнику занимает обычно несколько шагов по связи цифровой модели и физического двойника, отражённых на рисунке:
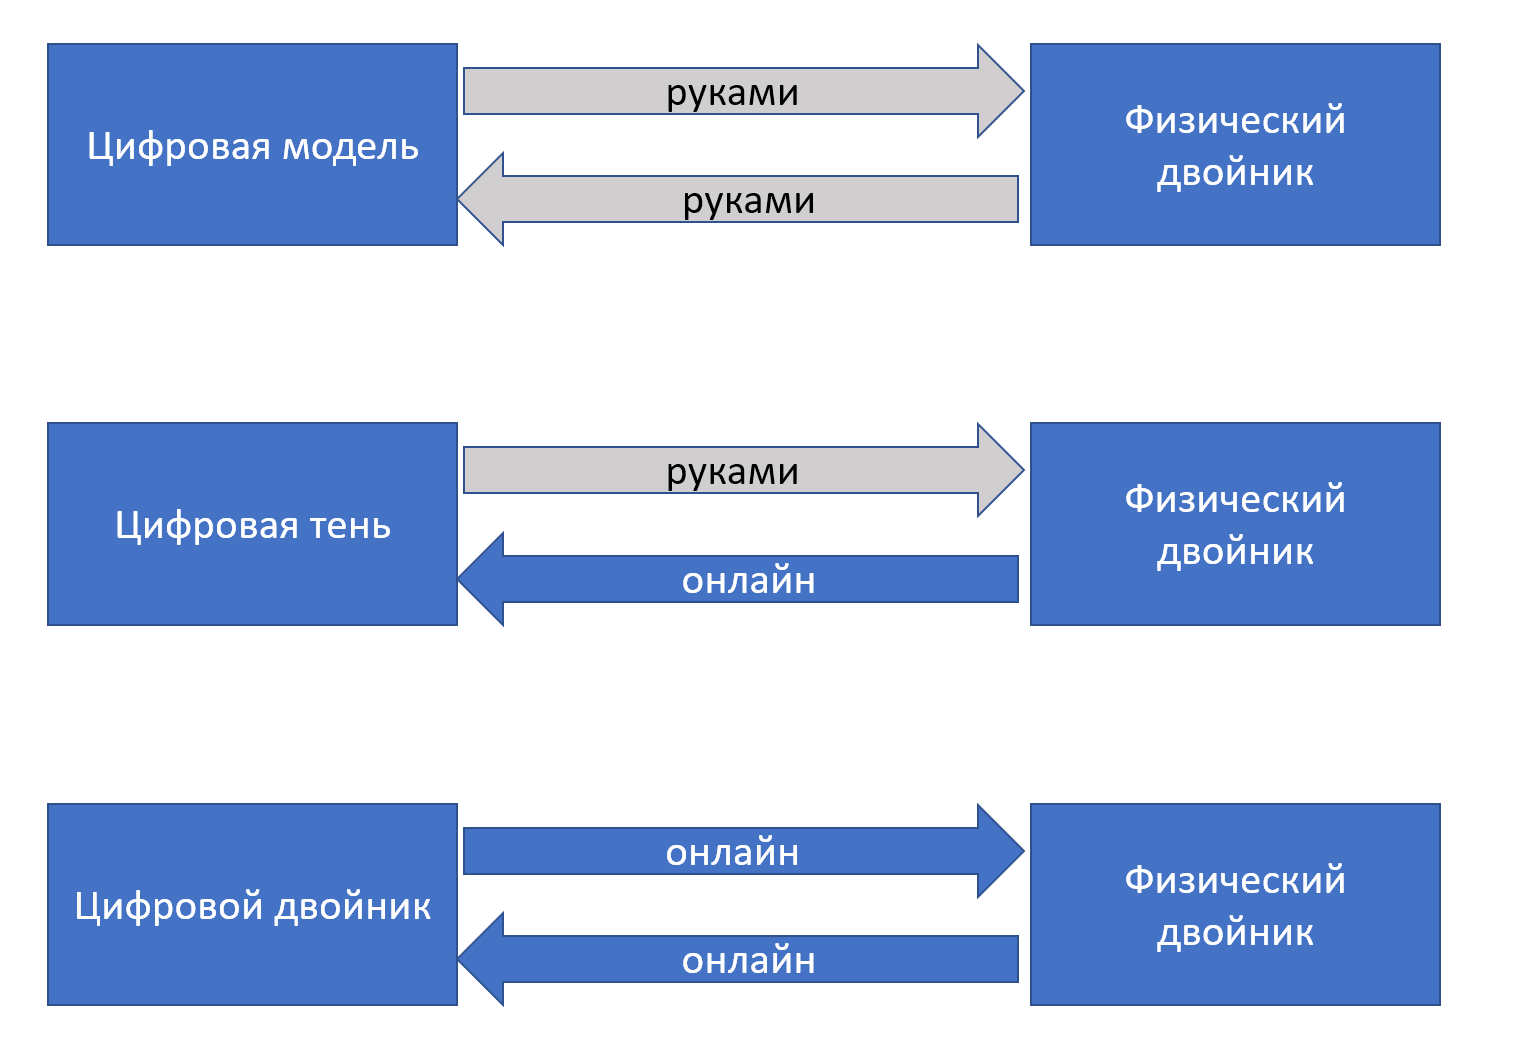
Сначала появляется цифровая модель физического двойника, которая не связана с физическим двойником цифровой нитью. Цифровая модель отличается от обычной мегамодели, используемой в инженерии (в PLM, ERP, EAM и eXperience platforms системах) тем, что она содержит в себе какие-то данные и приложения, работающие с так называемыми историческими данными, то есть данными времени эксплуатации, обычно это значения каких-то характеристик в разные моменты времени, «временны́е ряды». Эти данные анализируются, и по ним принимаются решения о том, как операционные инженеры должны изменить настройки физического двойника, чтобы оптимизировать его работу, или решения о том, когда оптимально провести ремонт физического двойника. Импорт-экспорт данных и с датчиков физического двойника и результатов расчётов оптимальных режимов работы на модели происходят вручную.
Потом налаживается съём информации с датчиков физического двойника в реальном времени через цифровую нить (в онлайн-режиме, постоянно, а не руками и изредка). Цифровая модель начинает в любой момент времени отражать важные характеристики физического двойника, и её называют уже цифровой тенью.
Цифровой двойник — это когда результаты работы цифровой тени в виде предложений по настройкам физического двойника попадают в физического двойника не «вручную», а тоже в режиме онлайн, то есть цифровая тень онлайн начинает рулить физическим двойником, так что она уже не совсем тень. Так что с этого момента говорим о полном цифровом двойнике, а не модели или тени.
Так что цифровой двойник — это автоматизация (гиперавтоматизация, цифровая нить, цифровая трансформация и т.д.), разработки, которая доводится до стадии эксплуатации. Особый упор тут на физическое моделирование и использование данных физического (имитационного) моделирования для настройки эксплуатационных параметров системы.
Особо нужно отметить использование термина «цифровая трансформация» (digital transformation)337. Формально: «замещение бескомпьютерных технологий и ручной работы компьютерными» или «замена более старых компьютерных технологий на новые». То есть формально это ничего не значит, любые изменения в работе, происходящие от замены чего-нибудь компьютерного, например, старого компьютера на новый, старого корпоративного приложения на новое.
Но неформально трансформация означает организационные изменения (появление новых методов работы, поддержанных оргструктурой организации и ресурсами, то есть появление новых оргвозможностей/capabilities), необходимые для интеграции данных и использования цифрового двойника. Цифровой двойник тут относится к системам самой разной природы: автомобиль, космический корабль, пациент, студент, предприятие, завод-автомат, район городской застройки. Ключевое тут то, что мегамодель цифрового двойника заходит в стадию эксплуатации/operations, а не только используется в ходе разработки/development и изготовления/construction.
Концепт цифрового двойника, объединяемого цифровой нитью, оказался очень удачным, и его начали использовать повсеместно вместо специализированных PDM (систем версионирования продукта), PLM (в которых добавлен issue tracker), eXperience platform (добавлены все стадии разработки, а также изготовление и выход на внешние проектные роли). Его начали использовать и в машиностроении, и в медицине, и в строительстве (и даже градостроении, ибо идут разговоры о «цифровом двойнике умного города»), и в образовании — идея захватила массы.
В частности, вы можете не только читать наше руководство как регламент/стандарт мышления и работы, но и использовать его как учебник, проходя стажировку в мастерской инженеров-менеджеров (МИМ). В МИМ для помощи в освоении работы по руководству задействуется информационная система Aisystant. В принципе, её можно отнести к LXP (learning experience platform)338: поддерживается конфигурация учебных материалов (руководства инженеров-менеджеров), которые предъявляются инженерам-менеджерам как стажёрам/учениикам/студентам, поддерживается конфигурация группы текущих активных в части освоения работы по руководствам инженеров-менеджеров (и не только текущих, но и прошлых тоже, это ведь в том числе и система версионирования!), поддерживается учёт наставлений, работу по которым инженеры-менеджеры уже освоили, поддерживается учёт оценок квалификации инженеров-менеджеров в момент эксплуатации освоенного мастерства339. Конечно, это пока не полноценный цифровой двойник (где в реальном времени и без участия людей отслеживается информация о поведении инженера-менеджера, а потом этому инженеру-менеджеру даются рекомендации, как ему оптимизировать свою «эксплуатацию»), но как минимум, это цифровая модель, затрагивающая эксплуатацию уже изготовленного мастерства, эксплуатацию личности после прохождения очередного шага её рабочего, личного, исследовательского развития.
Цифровой двойник — это безмасштабная идея: говорить о цифровых двойниках начали по отношению к каким угодно целевым системам (мостам, городам, пациентам, студентам), и вся эта история про цифрового двойника, провязанного цифровой нитью, только-только начинается340.
Что будет дальше? Дальше, конечно, выход за пределы отслеживания физического двойника и переход к отслеживанию и окружения тоже: выход на отслеживание эволюционного динамического ландшафта приспособленности. И, конечно, использование AI в принятии самых разных решений и роботов в реализации этих решений.
Что отслеживать в проекте в связи с DevOps с опорой на инженерию внутренней платформы разработки? Ведь там множество методов, причём многие из них называют разными терминами, акцентируя разные их аспекты — и прежде всего тут управление конфигурацией и изменениями (в том числе версионирование, интеграция данных, непрерывная интеграция, непрерывный ввод в эксплуатацию)? Конечно, альфы, в данном случае это будут подальфы основных/kernel альф. Как их отслеживать? Сделайте из альф кейсы и отслеживайте прохождение состояний этих альф (прохождение кейса) через issue tracker.
В нашем руководстве приводится изложение самого общего, «безмасштабного» уровня, который не зависит от масштаба и вида целевой системы и создателей. Это уровень мета-мета-модели. Но проблема управления инженерным процессом, в том числе DevOps с инженерией платформы, управления конфигурацией и изменениями, а в последнее время и проблема разработки и эксплуатации цифровых двойников на основе цифровой нити хорошо описаны для целевых систем самой разной природы. Это уровень мета-модели «из культуры».
Чтобы получить искомую мета-модель для предметной области вашего проекта, которую вы будете использовать в вашей проектной культуре, а потом и модель актуальной конфигурации отслеживаемых систем (как целевых, так и их окружения, так и создателей в их графах), и описаний этих систем, нужно будет выполнить адаптацию: перейти от предельно абстрактного языка мета-мета-модели к конкретному языку метаУ-модели из культуры (результат «погуглить» или «спросить AI», итог прохождения университетских курсов и чтения учебников по прикладным дисциплинам), а затем конкретному языку метаС-модели (язык регламентов, руководств, стандартов), принятому в вашем предприятии или предприятии-клиенте.
Поэтому первым делом вам нужно изучить доступную литературу по методам разработки вашей предметной области: она будет основываться на тех же самых принципах, о которых мы рассказали в нашем руководстве, но там может отличаться терминология, а также будут указаны варианты технологии ведения конфигурации целевой системы или системы создания и конфигурации работ, которые применимы в вашей конкретной проектной ситуации с использованием какой-то школы управления инженерным процессом, школы инженерии платформы, приспособленной к системам определённой природы и масштаба.
Больше всего материалов по управлению конфигурацией и изменениями вы встретите по разработке программного обеспечения, главным образом для разработки корпоративного софта. Интересно то, что по большей части этот разрабатываемый софт — это тоже софт управления конфигурацией и изменениями, но каких-то других объектов (если это корпоративный софт для обувной фабрики, то он будет управлять конфигурацией партий обуви, а также конфигурацией самого предприятия-создателя этих пар обуви, то есть будет софтом внутренней платформы разработки и изготовления обуви). Если вы понимаете, как устроен граф создателей в вашем проекте, то вам будет легко разобраться и не запутаться, когда вы говорите об инженерных процессах разных систем в графе создателей и о разных внутренних платформах разработки, которые вам (или не вам) придётся интегрировать в вашем проекте.
Конечно, есть огромное количество вариантов описанных в литературе методов управления конфигурацией и видов производственных платформ и для самых разных других систем. Например конфигурация незавершённого производства в машиностроительном предприятии (операционный учёт) будет храниться в ERP-системе на верхнем уровне учёта и построенного на данных этого учёта планирования, а также MES-системе на уровне цеха — мы это уже упоминали.
Если вы занимаетесь администрированием каких-то территорий, то вам будут помогать геоинформационные системы, а язык какого-нибудь «кадастрового учёта» вообще будет слабо напоминать язык системной инженерии или программной инженерии. Если у вас розничная торговля, то информационная система у вас тоже главным образом учитывает конфигурацию, управляет изменениями, отслеживает конфигурационные коллизии. Принципы управления конфигурацией, тем не менее, будут примерно те же, что мы обсуждали в текущем разделе с медленным движением от «учёта продукта» к «учёту продуктов и работ» и далее выходу к стадии эксплуатации и переходу роли инженера-оператора эксплуатации к компьютерной системе в составе цифрового двойника, а также предоставление доступа к информации производственной платформы внешним проектным ролям (например, роли покупателей и поставщиков). Там и тогда, где и когда вы используете какой-то «учётный софт», там будут вставать общие проблемы управления конфигурацией и изменениями.
Есть, конечно, огромное количество нюансов, которые появляются в ходе адаптации метода. Так, если у вас есть какой-то софт учёта конфигурации, который используется несколькими организациями, то непременно всплывёт идея использовать «распределённый реестр»/блокчейн как способ обеспечить доверие к этой системе. Если учитывать нужно права (обычно тут говорят о ценных бумагах, но это понятие чётко прописано в законодательстве всех стран, поэтому часто говорят о «токенах», чтобы по возможности уйти в «серую зону» для этого законодательства, чаще всего это просто синоним для «ценной бумаги, учтённой в блокчейне как регистраторе»), то возникнет вопрос о различиях юридической защиты в момент, когда «что-то пошло не так». И тут будет разница между депозитарными учётными системами (основанными на римском вещном праве, хорошо проработанный юридический механизм) и регистраторскими системами (основанными на обязательственном праве, плохо проработанный юридический механизм). Конечно, без глубокого знания предметной области (тут это — основы законодательства о рынке ценных бумаг, основы законодательства о денежной системе) не обойтись, и в разных странах это будет ещё и разное знание.
И не надейтесь наладить DevOps в проекте, если вы не знакомы с культурными SoTA вариантами инженерного процесса и SoTA вариантами инструментария внутренней платформы разработки для вашей предметной области! Впрочем, это относится к любым инженерным методам — и прикладной методологии, и архитектуре, и проектированию, не только DevOps. Знания нашего руководства системной инженерии будет достаточно, чтобы вы могли обсуждать связь вашего проекта с многочисленными другими проектами в самых разных других областях, или чтобы быстро разбираться в прикладной инженерии каких-то других систем, для которых у вас нет опыта. Но этого знания совершенно недостаточно, чтобы вести прикладные проекты, профессионально работать, не делать новичковых ошибок!
Так что мы не будем давать примеры возможных подальф, ограничимся только несколькими замечаниями для управления конфигурацией, как важнейшей части DevOps:
-
Подальфы управления конфигурацией в проекте могут относиться как к целевой системе, так и к создателю, так и к работам, так и к описанию целевых систем и создателей. Впрочем, управлять конфигурацией ваших сведений о надсистеме тоже нужно.
-
Инженерный процесс тоже может отслеживаться в проекте как подальфа альфы «метод» создателя (либо создателя целевой системы, либо создателя «нашего» создателя в графе создателей, смотря чей инженерный процесс рассматривается). Эта подальфа может проходить состояния и отвечать на контрольные вопросы адаптированной альфы «метод» (пример состояний альфы «метод» и подробности были в руководстве по методологии, она давалась как подальфа описания создателя).
-
Метод ведения обозначений в конфигурации как подальфа описания целевой системы, но для «нашего» создателя это тоже актуально, вам же нужно создать модель предприятия. Так что и тут вам придётся обсуждать вопрос именования и альф, и рабочих продуктов, и работ. Но ещё и размещений, и даже финансовых величин (помним, что системное описание включает в себя и стоимостное описание, конфигурация включает в себя тем самым и финансовое описание).
-
Конфигурация как подальфа воплощения целевой системы с возможными состояниями: замыслена, версионируется и бэкапируется, ведётся (изменяется, аудируется/обосновывается/проверяется, данные конфигурации управляются, то есть доступны всем, кому они нужны), архивируется.
-
То же можно сказать для версионирования описаний.
-
Конфигурация целевой системы в эксплуатации и версии описания системы ведутся и их соответствие трассируется.
-
Грубо можно описать состояния подальфы цифрового двойника альфы описания системы: цифровая модель, цифровая тень, цифровой двойник.
Никакого жёсткого ориентира для моделирования альф инженерного процесса нет. Даже если посмотреть сам стандарт OMG Essence, то он как раз служит для описания разных вариантов инженерного процесса. То есть «использование альф для отслеживания состояния проекта», «отслеживание состояний рабочих продуктов для отслеживания состояния проекта» — это тоже часть управления инженерным процессом, поэтому так трудно разговаривать об «альфах, описывающих альфы», «рабочих продуктах, документирующих описание другими рабочими продуктами состояний других альф».
Так что проявляйте творчество и гибкость, не будет никаких чётких рекомендаций по тому, как устроить управление инженерным процессом, управление конфигурацией и изменениями, управление инженерной документацией, операционный или какой иной учёт, какого сорта задействовать информационные системы (моделеры конфигурации, в том числе моделеры конфигурации систем, описаний, работ), как создать внутреннюю платформу разработки, интегрировать данные, поставить метод работы DevOps для вашего проекта с вашими особенностями целевых систем и их создателей. Но вы не можете проигнорировать все эти методы, с них и надо начинать проект. Ибо все остальные методы инженерии затем будут основываться на том, что вы как-то управляете вашим инженерным процессом, не пускаете его на самотёк. Вы и ваша команда должна знать: что и как нужно делать и каким инструментарием для этого пользоваться, знать, что происходит в проекте — какие состояния важнейших отслеживаемых в проекте объектов.
Моделирование: цифровые модели, тени, двойники в рабочем проекте
Выпишите три и более цифровых модели, тени, двойника, которые вы используете в текущем рабочем проекте:
| Номер п/п | Название физического двойника (в момент эксплуатации!) | Тип цифрового двойника (модель, тень, двойник) | В какой информационной системе (или ряде информационных систем) поддерживается |
|---|---|---|---|
| 1. | |||
| 2. | |||
| 3. | |||
Задания
Поставьте отметки о выполнении следующих дел.
-
Опубликован пост с вашими мыслями о DevOps, инженерии внутренней платформы разработки и управлении инженерным процессом (по всем материалам руководства и материалам предыдущих заданий).
-
Вы откомментировали не менее трёх постов по материалам текущего раздела, написанных другими инженерами-менеджерами.
8. Инженерные обоснования
Испытания, проверка и приёмка, обоснования
В инженерии вроде бы очевидно, что должны быть какие-то испытания созданной системы, чтобы получить уверенность команды проекта и внешних проектных ролей в её успешности, в том, что проект изменил жизнь к лучшему, а не «хотел как лучше, получилось как всегда».
Тут вопрос о том, уверенность в чём именно обосновывается? Приживается сегодня термин «качество» как удовлетворительные значения архитектурных характеристик, которые называют часто «требованиями качества» (всякие «‑ости», такие как безопасность, надёжность, доступность, ремонтопригодность и т.д.). Термин «обоснование качества»/quality assurance341 для обоснования успешности системы прижился, но он оказался неточен. Обосновывать приходится не только и не столько уверенность в «качестве» системы, то есть уверенность в том, что архитектурные характеристики имеют приемлемые значения, но нужно обосновывать и результативность работы системы, выполнение её функции в надсистеме. К тому же есть некоторое несоответствие между определениями того, чем занимается системная инженерия (созданием успешных систем с расшифровкой, что это учёт интересов самых разных проектных ролей, удовлетворение их ожиданий) и вдруг сведением успешности к просто абстрактному «качеству». Опять же, говорят не про «качественное лечение», а «успешное лечение», не про «качественную жизнь», а «успешную жизнь». Так что мы не будем тут говорить пафосно «обоснование изменения жизни к лучшему», но консервативно будем говорить об инженерных обоснованиях как обоснованиях успешности системы (цель системной инженерии — создание успешных систем, successful systems), а не просто об обоснованиях качества.
Когда мы говорим об инженерных обоснованиях, то чаще всего вспоминается вопрос о безопасности, самый болезненный — и это даже мы не касаемся традиционной путаницы «безопасности» и «защиты» (safety как «система никому не вредит» и security «системе никто не вредит»). Вспоминаются истории о том, что инженер становится под железнодорожный мост, когда по нему едет первый состав, лётчик-испытатель как «инженер-оператор самолёта» (пользователи тут — пассажиры) ассоциируется с повышенным риском и несёт как раз эти «испытания» в своём названии. Испытания — это переход от «голословных заявлений» к evidence-based, то есть заявлениям, основанным на экспериментальных свидетельствах.
Проблема в том, что большинство людей никак не испытывают результаты своей работы, оставляя испытания пользователям сделанных ими систем:
-
у них просто нет культуры это делать, «большинство людей» — это не специально обученные инженеры, которых учат не пропускать испытания! Но иногда об испытаниях забывают даже «специально обученные инженеры», ибо нет письменной культуры планирования и выполнения испытаний — нет чеклистов выполнения испытаний. В проектах мало кто знает, как разрабатывать планы испытаний, как именно эти планы выполнять, и что делать с результатами испытаний (как их трактовать: ожидалось значение характеристики Y как 10, замер показал — 8.3. Это успех или неуспех?!).
-
испытания требуют времени, а времени обычно нет, ибо «время — деньги» (и на испытания легко может уйти даже 85% всех затрат проекта). И всегда ведь есть вероятность, что система просто будет успешной, вдруг она реализуется как раз в нашем проекте?!
-
испытания ресурсоёмки: расходуются и материалы для переработки системой, и экземпляры системы, а ещё требуется дополнительное испытательное оборудование и агенты, которые эти испытания проводят. В бюджете всего этого нет, менеджерам всё это не объяснить, так что «салюта не было по шестнадцати причинам. Первая: нет пороха!».
-
Непонятно, как эти испытания делать. Как испытывать ракету, которая построена в количестве одной штуки и дальше должна лететь на Марс? Этот полёт одновременно и испытывает ракету, и является эксплуатацией ракеты. Как испытывать человека, который заканчивает школу? Ведь испытывать нужно вроде как его готовность к самостоятельной жизни, а проверяется знание математики и литературы, которое мало относится к тому, для чего выполняются испытания. Как испытывать искусственный интеллект, отвечающий на вопросы? Ему ведь наверняка при эксплуатации зададут вопрос, который не предусмотрен на испытании! Как испытывать беспилотный автомобиль? Как испытать сотрудника, которого изготовила для вашего отдела служба найма? Как испытывать общество, которое будет построено по программе правящей партии?
По мере развития инженерии стало понятно, что каких-то испытаний целевой системы недостаточно. Испытанная работоспособная система оказывалась бесполезной, потому как требования с их «испорченным телефоном» недостаточно отражали то, что хотели получить потребители, пользователи, заказчики системы и её сервисов.
Если вы согласились на разработку автомобиля «по требованиям», где указано, что это «автомобиль для торжественных ритуальных сервисов», «плавно трогаться с места и тормозить, ибо речь идёт о крупном городе», то вы вполне можете спроектировать катафалк, когда клиент ожидает от вас свадебный лимузин. Тут помогли бы сценарии использования, прямые контакты разработчика с пользователями, обследование надсистемы разработчиками и архитекторами — и ошибки бы при составлении концепции использования не было.
Проблемы обычно возникают в эксплуатации в составе надсистемы, а не при заводских испытаниях. Такое случается сплошь и рядом: вы покупаете абсолютно работоспособную модную рубашку, которая просто «не смотрится», когда вы её носите. Но она шикарно выглядит, когда висит в шкафу! И даже когда её примеряет сосед! Но носить-то её вам, а она «не смотрится». Нужны ещё испытания, показывающие, что работоспособна надсистема, когда в её составе работает целевая система. Свадьба с автомобилем для торжественных мероприятий, вы с модной рубашкой. Идея, что готовую рубашку можно будет дорабатывать/кастомизировать каждую под конкретный запрос, не приходила в голову: считалось, что это будет запредельно дорого (и при малом уровне автоматизации, плохом управлении конфигурацией это так. Автоматизация делает изменения дешевле).
К этому моменту уже появился системный подход и испытания разбили на два вида: проверку/верификацию/verification и приёмку/валидацию/validation, и оба этих вида начали упоминать вместе вместо слов «испытания», «проверка и приёмка», «verification and validation», сокращённо V&V. Одновременно становилась культура документирования потребностей и требований (до этого формальной дисциплины «инженерия требований» не было, и каждый уж что умел, то умел: документировалось отнюдь не всё). Вместо «испытаний работоспособности» начали проводить два вида испытаний для двух разных систем:
-
Проверка — это испытания удовлетворения целевой системы требованиям. На границе целевой системы наружу выдаётся некоторый сервис (поведение по изменению объектов в окружении), он соответствует описанному (например, водяной насос выдаёт воду под давлением 6 атмосфер). «Какой функциональный объект задумали, такой конструктив и сделали!».
-
Приёмка — это испытания того, что надсистема удовлетворит потребности. Надсистема требует от системы некоторой функции/сервиса, чтобы смочь дальше выполнить свою функцию/сервис по отношению к над-надсистеме (например, из крана на 6 этаже и высоте этажа 3 метра должна политься вода, она не полилась, давления не хватило — нужен другой насос, «что-то пошло не так»). Тут тонкий момент, что удовлетворение модулем функции так, чтобы была удовлетворена потребность — это гипотеза. Вполне возможно, что нужна была чуть другая функция, другое затребованное поведение. А сервис модуля, актуальное его поведение, оказался другим. Более того, тут проблемы могли возникать со стороны архитектурных характеристик, а не функциональных: всё могло работать, но, например, только в ходе испытаний, один раз, при «демонстрации из рук разработчиков». А дальше? А дальше система могла работать ненадёжно, быть недоступной, плохо масштабироваться и т.д. — но это обнаружится уже после испытаний!
Судьба этой новации с одной стороны была счастливой (стали говорить про V&V вместо просто testing, например в NASA программа интегральной верификации и валидации IV&V начала работать с 1993 года342), с другой стороны — мало кто вне аэрокосмической промышленности был знаком с системным подходом. Идея, что проверять нужно работоспособность двух систем (целевой и надсистемы), а не одной только целевой, в массы широко не пошла, пошло только название метода — и мало кто задавался вопросом, почему в названии два разных слова. Автор задавал вопрос участникам крупнейшей российской конференции по тестированию программного обеспечения, чем отличаются verification и validation друг от друга — и внятного ответа не получил, это воспринималось участниками (профессионалами в тестировании софта!) просто как «устойчивое словосочетание», означающее просто «тестирование». То, что разница между проверкой и приёмкой как испытания разных систем прописана во множестве стандартов, даётся в учебниках — это не дошло до массовой практики тестирования.
В водопадной «однократной разработке» деньги платятся обычно по выполнению проверочных испытаний (выполнены требования), а не приёмочных (система успешна), а дальше кто виноват, если проверка проходит, а приёмка нет — это очень спорный вопрос. Переход к непрерывной разработке был, в частности, связан именно с этим: испытывать приходилось неоднократно, вносить исправления в систему приходилось неоднократно, и тут пришлось менять и устройство испытаний (подробно это разбирается в DevOps: как провести минимум испытаний, чтобы после добавления в состав системы каждого инкремента сохранилось высокое качество всей системы) и способы контрактации подрядчиков. Современные контракты на разработку не предусматривают варианта разовой поставки готовой системы, они предусматривают всегда сопровождение, какой-то вариант непрерывной разработки.
И это, заметим, мы не касаемся хода на то, что успешность определяется общим впечатлением, которое получит клиент (customer eXperience, вы можете приготовить шикарный борщ, но если вам придётся его есть в вонючем помещении — общее впечатление клиента будет испорчено, и клиент даже не будет разбираться, это ваш борщ воняет, или помещение, «что-то пошло не так», впечатление испорчено, ожидания не оправдались «от обеда с борщом»). Это очень трудный ход мысли: в инженерном проекте не просто целиться во время эксплуатации системы, которой ещё нет, но и учитывать будущие впечатления/опыт/eXperience тех людей, которые сталкиваются с системой, ибо интересы внешних проектных ролей не совпадают с интересами разработчиков, выпадают из внимания.
Разделение проверки и приёмки, а потом и мониторинг реальных впечатлений пользователей были не последним шагом в развитии метода испытаний. Они оказались только частью того инженерного метода, который должен был давать уверенность в том, что целевая система таки изменяет жизнь к лучшему (сильная формулировка, как мы замечали в первом разделе руководства) или хотя бы является успешной (то есть соответствует ожиданиям проектных ролей, или даже превышает эти ожидания, более слабая формулировка, но пока более распространённая в системной инженерии — и далее с выходом на eXperience). Этот метод получил название инженерного обоснования/assurance — получение аргументированной уверенности в верности каких-то утверждений о свойствах системы (ну, или утверждений о впечатлениях внешних проектных ролей).
В нулевых годах 21 века столкнулись два подхода к инженерным обоснованиям:
-
Обоснование на основе свидетельств (evidence-based assurance, доказательные обоснования),
-
Обоснование на основе процесса (process-based assurance).
Менеджерам (инженерам предприятия, во внимании которых не столько целевая система, сколько система-создатель целевой) полюбилось обоснование на основе процесса, это было закреплено в стандартах «обеспечения качества» серии ISO 9000, разрабатываемых с 1987 года. Этот тип обоснования стал мощной отраслью по торговле сертификатами соответствия требованиям «стандартов качества». Суть была в том, что надо было документировать рабочие процессы, а затем требовать их выполнения в том виде, в каком они были документированы — и подразумевалось, что соблюдение документированного процесса даст вам отличное качество целевой системы. На деле оказалось, что:
-
Использование «стандартов качества» серии ISO 9000 не так уж надёжно в обеспечении качества. Было множество исследований, которые показывали проблемы с результативностью и эффективностью этих стандартов343.
-
Следование процессу совсем необязательно приводит к гарантированному качеству продукта, испытания всё равно оказывались нужными.
-
С подобными стандартами были связаны «ступени зрелости». Компании очень быстро проходили эти «ступени зрелости» — и останавливались в улучшении своих методов работы, ибо их текущие методы оказывались хорошо документированными, дисциплина им следования соблюдалась, и это вместо предполагаемого бесконечного совершенствования процессов оказывалось тормозом в развитии, конечной остановкой. Лекарство оказывалось болезнью!
Системные инженеры поэтому пошли по другому пути: обоснований на основе свидетельств/evidence-based assurance. Это «доказательное обоснование» (по примеру перевода evidence-based medicine как «доказательная медицина», хотя более точный перевод будет «основанная на свидетельствах медицина» и то же верно про инженерные обоснования/assurance) уже было записано в документах по проверке и приёмке. Нет свидетельств, или свидетельства не задокументированы хоть как-то — считаем, что нет обоснований для уверенности в полезности, работоспособности, безопасности, надёжности и т.д. системы.
Ещё один вопрос, как строить на базе свидетельств доказательство того, что с будущей системой (обоснование обычно происходит до момента эксплуатации, это утверждение о будущем!) всё будет в порядке? Для этого лучшим способом оказался метод, похожий на ведение судебного дела: все свидетельства подшиваются в папку «дело»/case и получается документ::«рабочий продукт» «обосновывающее дело»/assurance case, а само доказательство/обоснование строится так же, как доказательство в суде — на основе аргументирования каких-то промежуточных утверждений (в том числе использующих свидетельства/evidence), ведущих к выводам по поводу верности конечных утверждений. Все найденные свидетельства «подшиваются к делу» (то есть документы в папке реально прошиваются ниткой, чтобы исключить возможность их изъятия и подмены, повышая тем самым уверенность в том, что их учтут при общем выводе суда. Отсюда и выражение «шить дело»). В суде заключением по делу (свидетельствам в папке «Дело №____») будет «виновен» или «не виновен», а в инженерии — система признана «успешной» или «неуспешной».
Этот метод «ведения дела» в обоснованиях успешности системы на сегодняшний день в инженерии считается SoTA, хотя давно уже нет никаких папок, а речь идёт о записях в базах данных инженерной документации.
Инженерное обоснование проектного/design и/или архитектурного решения (время замысла и разработки, rationale) отличалось от обоснования успешности готовой системы (время эксплуатации, assurance). Когда говорили rationale, то обосновывали принятое решение, надеясь, что система сработает после того, как будет изготовлена. Когда говорили про assurance, то обосновывали то, что сработает уже изготовленная система.
Скажем, технико-экономическое обоснование (ТЭО) или инвестиционное обоснование (инвестиционный меморандум) — это обоснование того, что система будет разработана «как надо» и после этого «заработает как надо», будет успешна в будущем, это rationale. Но после изготовления системы мы знаем о ней много больше, чем тогда, когда делали обоснование проектного решения (скажем, выбирали вариант архитектуры). И мы должны дополнительно провести обоснование того, что уже готовая система будет соответствовать нашим (и в этом «мы» собраны самые разные проектные роли) ожиданиям, это assurance, и надо, например, провести испытания (например, воткнуть свежесобранный утюг в розетку и поглядеть: не идёт ли из него дым, нагревается ли он до нужной температуры, не бьёт ли током, не забыли ли при сборке утюга какую-то его деталь, не царапает ли ткань его подошва, и т.д. — то, что в проекте всё это было предусмотрено, и были обоснования проектных решений не отменяет того, что эти обоснования могли не оправдаться). Итак, если вы сделали ТЭО и получили финансирование на проект, не лишним будет проверить, не изменилось ли ваше заключение по ТЭО в середине выполнения проекта, и после того, как система сделана. Поэтому rationale раньше всегда выделяли как отдельный вид обоснований, но в современной эволюционной разработке rationale часто просто считают его всех обоснований, включая обоснования на основе испытаний — это просто будет какая-то часть assurance. Главное, что метод обоснований тут один и тот же: логика с опорой на эксперимент (evidence-based: измерения, тестирование, а не чисто «умозрение» и «интуиция»).
Инженер отличается от не-инженера тем, что он относится к инженерным обоснованиям всерьёз: обязательно их выполняет в ходе всего проекта, постоянно тратит на них ресурсы.
Моделирование: обоснования в инженерии
Вспомните последние десять рабочих продуктов в вашем рабочем проекте, которые вы изменяли и потом передавали другим людям и заполните табличку по обоснованию уверенности в том, что результат вашей работы был успешен:
| Номер п/п | Рабочий продукт | Работа с ним | Какие проверки успешности результата вы сделали | Какие проверки успешности результата работы надо было бы сделать | Была ли приёмка? | Остались ли письменные следы о результатах проверок и приёмок? |
|---|---|---|---|---|---|---|
| 1. | ||||||
| 2. | ||||||
| 3. | ||||||
| 4. | ||||||
| 5. | ||||||
| 6. | ||||||
| 7. | ||||||
| 8. | ||||||
| 9. | ||||||
| 10. |
Что обосновывают в инженерии
Есть довольно много разных мнений о том, что следует обосновывать при создании систем, но большинство из них подразумевает однократное обоснование, а не инкрементальное эволюционное/непрерывное обоснование того, что делается:
-
Общую успешность системы (как в суде — чёткий короткий вердикт об успешности. И если завтра система неуспешна — это уже завтра, что с этим делать, непонятно).
-
Соответствие систем (надсистемы и целевой системы) потребностям и требованиям, пункт за пунктом. Проблема испорченного телефона не волнует, ожидается, что потребности и требования тоже обоснованы и «истина, подписанная заказчиком один раз, причём навсегда».
-
Соответствие работы создателя системы каким-то практикам (process-based) в надежде, что это приведёт к успешности системы. Эта идея стоит за самыми разными процессными стандартами серии ISO 9000 и даже стандартами системной инженерии ISO 15288 и программной инженерии ISO 12207, уровнями зрелости процессов (если вы уже достигли зрелых процессов, то всё хорошо, улучшаться дальше некуда, а результаты автомагически должны быть успешными). Если вы вдруг создали вместо борща яичницу, но с соблюдением всех правил готовки и все шаги приготовления у вас записаны, то считаем результат успешным, хотя нужен был борщ (а яичница — это была ваша гипотеза, которую вы уговорили подписать заказчика как требования, но дальше вы её готовили по всем правилам!).
-
Впечатления пользователя. Неважно, что и как делает система, но если пользователь доволен — всё в порядке!
-
… и так далее.
Малопонятно, какой детальности должны быть обоснования. Например, хватит ли обоснования «честное слово, всё будет в порядке!» в письменном виде от генерального конструктора ракеты перед её вылетом на Марс? Или всё-таки нужно проверить хотя бы крупные блоки ракеты и иметь тем самым не одно «всё в порядке», а список частей, у которых «всё в порядке»? Или всё проверять до последнего винтика — но как это сделать в уже собранной ракете? А если у вас каждая ракета как экземпляр отличается от предыдущей множеством улучшений — это требует полного нового обоснования, или часть предыдущих обоснований можно считать проделанной, и какую именно часть, там ведь сложные взаимодействия по линии эмерджентности новых фич, которые добавлены в ракету?
«Обосновывающее дело»/«assurance case» стало ответом на эти вопросы: было признано, что если у вас есть хорошо документированные свидетельства о том, что всё, что можно, было испытано, что нельзя испытать, то хотя бы обсуждено экспертами, то нельзя сделать никаких выводов, если не строить какую-то структуру из взаимосвязанных аргументов/arguments для ответа на общий вопрос о том, удалось ли сделать систему успешной. Всё остальное можно рассматривать лишь как аргументирование в поддержку или опровержение общей претензии/claim на успешность системы. Свидетельства/улики/evidence поддерживают или опровергают какие-то аргументы, а аргументы (все вместе их рассматривают как «структурированный аргумент») поддерживают или опровергают претензию на успешность. И это, конечно, не просто «логические» обоснования, а «причинно-следственные» (вы проходили это в руководстве по рациональной работе).
Для claim может быть много разных вариантов перевода как синонимов-с-нюансами. Так, перевод «претензия» подчёркивает то, что высказанное – не факт, а только претендует быть фактом. Перевод «заявление» -- вполне подходит, но не учитывает, что заявление означает любое высказывание, в том числе и претендующее на то, чтобы быть фактом. Но и не претендующее на это тоже. Гипотеза и тезис – это в науке, относится к объяснениям, а не к выражению создателем уверенности в достигнутых характеристиках. Утверждение – тоже нейтрально. Ещё часто переходят к глаголам: «мы претендуем на то, что наш алгоритм на данной аппаратуре и для типичных данных на входе срабатывает за время, меньшее 0.2 секунды», «мы заявляем о том, что наш алгоритм …». Поскольку мы хотим подчеркнуть, что не обоснованное – не факт, мы как перевод claim берём именно «претензию», хотя, повторим: адаптируйте к своей предметной области.
Главная проблема в инженерных обоснованиях в отличие от судебных доказательств, в том, что речь идёт обычно о будущем времени, а не о произошедшем уже событии. «Виновен» — это про прошлое, а вот «успешна» — это про то, что система в момент эксплуатации будет наносить непоправимую пользу, на неё можно будет положиться, от неё можно будет зависеть, и она не подведёт.
Обоснование тем самым представляется порождающей/generative моделью, в которой мы можем посмотреть на вероятное/возможное будущее. То есть мы строим объяснительную порождающую излагаемую контрфактуально теорию, которая должна дать оценку сюрприза (surprise, термин из байесовской вероятности) неприятных событий при эксплуатации целевой системы в её окружении344.
Какие неприятные события? Прежде всего, это аварии: отказы в работе. Аварии делим на проектные (которые учтены в проекте) и запроектные (которые настолько неожиданны, что в проекте не учтены). Конечно, мало кто реально считает байесовские вероятности и именно «байесовский сюрприз», но в инженерных проектах реально пытаются обосновывать поведение системы в будущих ситуациях не только нормальной работы, но и ситуациях аварийных.
В инженерных обоснованиях тем самым занимаются рациональным (на основе лучших известных нам методов принятия решений) принятием решений о том, можно ли считать инженерный проект успешным и считать успешной целевую систему, которая должна будет эксплуатироваться по итогам этого проекта. Это как начинается с обоснований/rationale при принятии проектных/design (концепция системы — «пишите комментарии с обоснованиями») и архитектурных решений (обязательно писать в ADR обоснование, rationale), так и продолжается проведением самых разных тестов и формулированием выводов на основе этих тестов (это проведение испытаний обсуждается в DevOps/SRE/«platform engineering», ибо должно быть учтено инструментами внутренней платформы разработки).
В больших дорогих проектах «железной» системной инженерии в серьёзно зарегулированных областях (авиастроение, строительство, ракетостроение, военная инженерия и т.д.) обоснование занимает огромное количество времени и выполняется более-менее строго, за это получают зарплату надзорные органы (и часто справедливо говорят, что они получают зарплату за то, чтобы хоть что-то найти — поэтому даже если всё в порядке, они что-нибудь найдут и потребуют исправить, отсюда совершенно неслучайный скепсис по отношению к выполнению их требований).
Делаются претензии/claims на выполнение требований (это же регулируемая государством инженерия, без требований вам не дадут ничего сделать, «испорченный телефон» входит в условия работы), которые не нужно путать с самими требованиями/requirements. Основное отличие претензий от требований в том, что в требованиях модальность деонтическая (долженствования, то есть используются слова «должен», «рекомендуется», «может» и т.д.), а в претензиях — алетическая (существования, то есть используются слова «быть» или «будет», причём в английском это is или will be, а в русском этих слов может и вовсе не быть, разве что в каком-то совсем уж канцелярите будет «является» или «будет»). Скажем,
-
Требование/requirement: для модуля М напряжение на выходе q всегда должно быть больше или равным напряжению на выходе r для всех наборов входных напряжений.
-
Претензия/claim: для модуля М напряжение на выходе q всегда больше или равно напряжению на выходе r для всех наборов входных напряжений.
Эти рассуждения весьма распространены в однократных жизненных циклах классической старомодной системной инженерии. В современной инженерии модальность не деонтическая, а доксическая (веры): для модуля М напряжение на выходе q всегда ожидается больше или равным напряжению на выходе r для всех наборов входных напряжений, поэтому в ответ на доксу (веру) даётся алетика (существование): «всегда больше», а не «всегда ожидается больше» или «всегда должно быть больше».
И вот именно эту претензию в алетической модальности (модальности существования) обосновывают аргументами/arguments, в поддержку которых предъявляют свидетельства/доказательства/evidence. Например, свидетельством о выполнении претензии из предыдущего абзаца могла бы быть таблица самых разных входных напряжений и приведённые для них замеры напряжений выходов q и r, а аргумент — «мы проверили довольно много вариантов входных напряжений, и для всех них оказалось, что напряжение на выходе q больше или равно напряжению на выходе r». Или свидетельством был бы предоставленный образец модуля, для которого нам бы пришлось для построения аргумента самим провести замеры выходов для самых разных входных напряжений и тем самым самим подготовить таблицу.
Идея инженерных обоснований с использованием «обосновывающего дела» (assurance case) в том, что документируются (в программной инженерии ведутся логи/«журналы»)
-
и свидетельства (результаты испытаний и сам факт их проведения, экспертные заключения и т.д.),
-
и аргументы (объяснения, которые кладутся в основу заключения о верности претензии)
-
и сами претензии, которые считаются верными или нет (то есть признали ли мы выполненными требования и потребности, или нет).
Проблема в том, что претензия обычно говорит о тех ситуациях, когда невозможно представить какие-то достаточно убедительные формальные основания, и прежде всего это ситуации-в-будущем, то есть в момент эксплуатации. В предыдущем примере мы могли убедиться, что претензия вполне обоснована на момент проведения замеров. Но будет ли она обоснована, когда модуль M — это модуль ракеты, и он улетит в космос и будет там работать в невесомости и вакууме после всех механических перегрузок, которые у него будут на взлёте? Или после попадания молнии в корпус ракеты, которая несёт модуль M? Но тут ещё важно, что сама ракета с её окружением модуля М, но и сам модуль М будут меняться от экземпляра к экземпляру, современная инженерия давно вышла за пределы однократного прохождении жизненного цикла системы, обоснованность претензии «вчера» ничего не говорит об обоснованности претензии «сегодня» и тем более «завтра».
С гипотезами всё ещё хуже, ибо нельзя «доказать верность гипотезы», можно лишь её опровергнуть, это общий вывод попперианской науки и, как всё более и более становится очевидным, «попперианской инженерии». Наиболее чётко это сформулировано в книге «The Lean startup», 2011 (есть и русский перевод):
Предпринимательство (создание работающей бизнес-модели, то есть понимание того, как инженерия целевой системы будет приносить доход больший, чем расходы на эту инженерию) тут показано как идущее по пути непрерывного уточнения гипотез и непрерывных попыток их обосновать сначала «умственно» на основе инженерных представлений об окружении будущей системы, а затем обязательно в эксперименте-тестировании. Идея тут в том, что испытания жизнью (как в эволюции! Тебя проверяют на соответствие окружающей среде не специальными испытаниями, а просто жизнью — выжил и успел размножиться и вырастить детей, значит хорош. Не успел — ну, не успел. В биологии это «умер», а если «все умерли», то «вымер», в техноэволюции — «давайте что-то переделаем и продолжим») это самые главные испытания, и инженерное обоснование базируется на том, что потребители и все остальные внешние проектные роли довольны системой, то есть дело не в соблюдении каких-то характеристик, а в eXperience.
Это не последняя книга серии, в которой поддерживается идея обязательного столкновения идеи с жизнью для обоснования успешности продукта, в том числе успешности достаточной, чтобы вкладывать силы в массовое производство. Eric Ries345 (автор «The Lean Startup») — это ученик Steve Blank346, который не остановился на идеях курса по стартапам, изложенного его учеником в «The Lean Startup» и через год (2012) написал с Bob Dorf ставший классическим в современном образовании серийных предпринимателей учебник «The Startup Owner's Manual»:
В этом учебнике подчёркивается, что идею продукта нельзя найти в том здании, где находится разработчик — надо выходить из здания и общаться с внешними проектными ролями там, где находятся эти проектные роли с их eXperience. Но более того: пока не удалось в ходе постоянных итераций сделать MVP, испытать бизнес-модель — нельзя даже думать об организации службы маркетинга!
Каждый шаг при создании стартапа (не только продукта, но и создателя продукта!) надо проверять, что вы его сделали надлежащим образом. Для этого в книге используются чеклисты — те самые чеклисты, с которыми мы хорошо знакомы по нашим руководствам. И посмотрите, какое внимание уделяется там экспериментам, это типичная страница в книге, смотрите сколько раз там упомянуто слово test и experiment (для получения свидетельств/evidence), verify, хотя разговор вроде бы идёт не о тестировании, а о выявлении/discovery. Конечно, вначале высказывается гипотеза/hypothesis — и дальше её тщательно проверяют, а затем не успокаиваются — и переходят к тому, чтобы принять/validate:
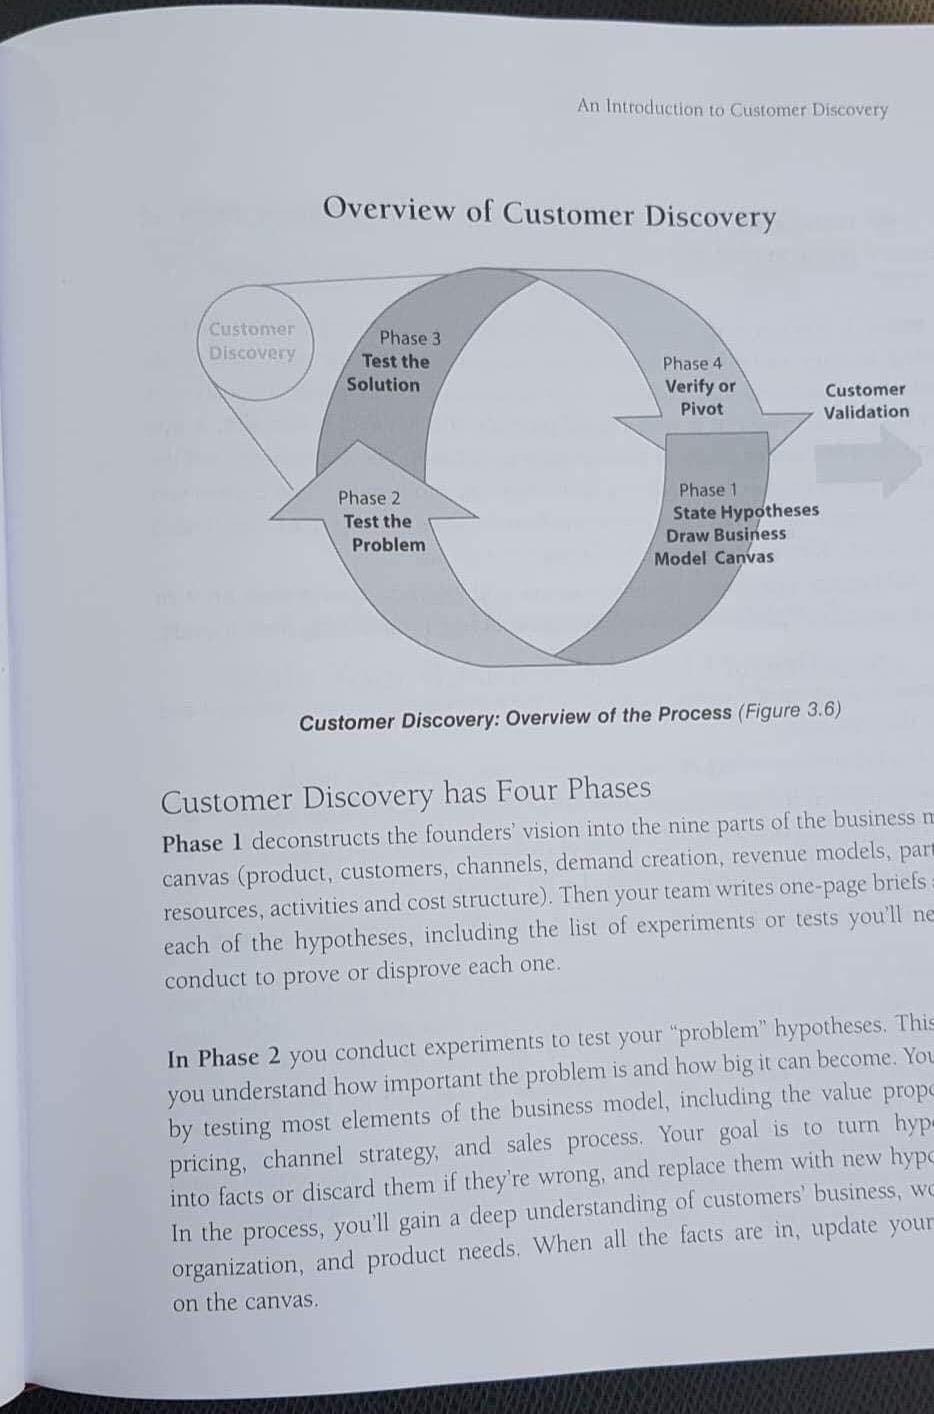
Подход инженерии платформы разработки в рамках DevOps не снимает множества вопросов — но подталкивает к тому, чтобы автоматизировать все испытания и на основе этих испытаний выдать результат: инженерное обоснование. Скажем, мы меняем в огромном самолёте винтик в кресле пассажира, формально это ведь изменит конфигурацию! Должны ли мы провести полноценные лётные испытания после этого? А если поменяли не винтик, а двигатель? А если поменяли материал крыла, взяли другой композитный материал? Если мы сертифицировали какую-то конфигурацию операционной системы на выполнение всех требований безопасности (тут «требования», ибо деонтическая модальность со стороны регуляторов: «должны», и в проекте это «должны» не обсуждается!), а потом поменяли три каких-то модуля в связи с замеченными в них потом ошибками — считаем ли, что это уже другая версия операционной системы, и она опять должна пройти все сертификационные проверки? Мы проверили, что тренировочный центр для собак сумел научить пять собак подавать лапу и не кусаться почём зря. Считаем ли, что этот центр сможет учить этому всех остальных собак? А если в нём заменили после проверки половину инструкторов? А если заменили всех инструкторов? А если речь идёт не о следующем дне после проверок и испытаний, а о нескольких годах после? В DevOps обоснование успешности системы тяготеет сегодня к автоматизации испытаний, и это начинается с того момента, когда разработчик описывает ожидаемое поведение системы (функциональность) сразу на языке тестирования. Это верно пока главным образом для разработки софта, но по факту распространилось уже и на передовое машиностроение, и на многие другие отрасли. Испытаний, тестирования, экспериментов в инженерии становится всё больше и больше — а чтобы жизнь от этого не остановилась под грузом непосильных затрат времени и средств, эти испытания (включая A|B тестирование347 новых фич, проверку fitness functions) автоматизируют — а часть их выносят в мониторинг, сама система для себя становится автоматическим испытательным стендом.
Ещё одно осложнение связано с принципиальной многоуровневостью оптимизации межуровневых конфликтов, которую пытается решить предлагаемая целевая система. Это означает, что обосновывать нужно выполнение каких-то требований и потребностей на многих уровнях, в том числе учитывать и отдалённые во времени последствия, то есть решения по обоснованию придётся принимать отнюдь не только по проверочным (целевой системы) и приёмочным (надсистемы) испытаниям, но и возможно придётся разбираться со многими уровнями проверок и приёмок, и ещё строить общий аргумент для вывода о многоуровневости в успешности системы (что выглядит успешным для одного уровня, может выглядеть абсолютно неуспешным для другого уровня: вас не отпустили в отпуск с работы и заставили проработать лишнюю неделю, и для уровня организации это успех, а вот для вас лично — не очень. Считать ли проект организации по организации вас на работу вместо отпуска прошедшим обоснования? Вроде бы и требование выполнено — вы не ушли в отпуск, и потребность организации удовлетворена, она смогла закончить какой-то проект. Но вы крайне недовольны и уже договорились о переходе в другую фирму, от которой не ожидаете таких «успешных проектов». Считаем ли мы до сих пор результаты проекта по вашей задержке на работе обоснованными, проект успешным?).
Понятно, что в этих ситуациях всё равно придётся принять решение, и метод ведения обосновывающего дела (assurance case) предписывает документировать не только разные свидетельства/evidence, которые нужны для принятия решения о рациональной обоснованности претензии/claim, но и сам способ обоснования того, как было принято решение, то есть вид аргумента/argument.
Рациональность обоснований
Обоснования успешности сложных классических инженерных систем (важное программное обеспечение, киберфизические системы типа ракеты или атомной электростанции) помогают проводить инженерные стандарты. Большинство стандартов инженерных обоснований использует классические теории решений, где рациональность отождествляется с математической логикой, хотя и позволяется от этой логики отходить в сторону разных «экспертных» заключений в тех случаях, когда строгая логика не работает. Общая тут отсылка — это судебные дела, где предполагается строгое рациональное аргументирование решения на базе каких-то свидетельств/улик. Сама по себе эта отсылка должна как-то настораживать, ибо в судах расследуется что-то прошлое (поэтому вердикт однозначный), а в инженерии речь идёт о чём-то ожидаемом, и эти ожидания наверняка будут меняться со временем, даже если они обоснованы в текущий момент.
В основе традиционного однократного обоснования лежит обычно метод картирования аргументов (argument map). Он не очень удобен, ибо чаще всего даётся в диаграммной форме (часто пишут как argument diagram)348. Этот метод реализован в довольно разной терминологии в самых разных стандартах инженерных обоснований для водопадной модели однократного прохождения жизненного цикла, которые помогают как-то унифицировать ведение обосновывающих дел главным образом в «железной» инженерии крупных инженерных систем (часто с госфинансированием и жёстким регулированием инженерной деятельности со стороны госорганов самых разных стран). Это прежде всего стандарты:
-
IEEE/ISO 15026 «Systems and software engineering — Systems and software assurance»349 (в русском переводе assurance перевели как «гарантирование», что плохо отражает инженерную суть дела350), четыре его части в разных версиях вышли в 2011-2021 годах.
-
GSN, Goal Structuring Notation Community Standard351, версия 2 вышла в 2018 году.
-
OMG SACM, Structured Assurance Case Metamodel352, версия 2.2, вышла в 2021 году
-
CAE framework, Claims, Argument, Reasoning353, разработка Adelard LLP. с 2007 по настоящее время354. Именно этот фреймворк поддерживается наиболее распространённым софтом для построения обосновывающих дел, ASCE355. Впрочем, и для всех остальных вариантов достаточно моделеров, все они строят дерево обоснования, для простейших случаев рекомендуют использовать любой софт Mind Map для отображения деревьев, но и аутлайнеры (в том числе outliner в MS Word) с этим справляются, если отойти от диаграммной формы для дерева и перейти к списку с гнездованием/отступами.
-
Assurance 2.0 framework356, разработка 2020 года. Основная тут цель — это поддержка инноваций (ибо любое новое инженерное решение кажется при традиционных обоснованиях подозрительным и ненадёжным) и инкрементальное построение обоснования (более совместимое с agile).
-
… и это ещё далеко не всё. Стандарты «де юре» (нейтральные по отношению к инструментам разных поставщиков), разработанные организациями стандартизации и стандарты «де факто» (стандарты, задаваемые конкретным программным инструментарием) для assurance case более чем распространены, а ещё они часто не отдельны, а входят в самые разные другие стандарты.
Практически идентичные идеи структурирования обоснований на основе аргументов лежат в основе стандартов целеориентированной инженерии требований (GORE, goal-oriented requirements engineering), где упор делается на то, что требования должны быть обоснованными, равно как обоснованными должны быть и претензии на удовлетворение этих требований. Все эти стандарты появились существенно раньше примерно 2015-2016 года, когда инженерия требований перестала восприниматься как живой, активно развивающийся инженерный метод. В основе всего этого движения был агент-ориентированный фреймворк i*357 ещё 1995 года и основанный на нём стандарт ITU-T 151 User Requirements Notation (URN) с его диалектом Goal-oriented Requirement Language (GRL). Есть работы, которые показывают, что типичный стандарт инженерных обоснований ISO 15026 легко отображается на GRL, и сам этот стандарт ISO 15026 может думаться как подмножество GRL за минусом агентской ориентации GRL358. Такие же стандарты начинают появляться в области обоснований принятых решений (rationale).
Обоснования успешности/assurance (часто переводят как «обоснование качества» или «гарантирование качества»), обоснования решений/rationale (например, архитектурных решений, architecture rationale) все имеют общую природу — обоснования/assurance, иногда их называют и рассуждениями/reason, и доказательствами/proofs, и аргументированием/argumentation.
Все эти стандарты сделаны для того, чтобы было легче находить ошибки аргументации. Обратите внимание, что чаще всего в обоснованиях делают не ошибки проведения испытаний, или моделирования, или экспертизы, а именно ошибки аргументации — ошибки вывода заключения на основе каких-то свидетельств, то есть логические ошибки, в том числе ошибки в причинных рассуждениях (causal inference). Рациональность как метод принятия решений на основании причинных рассуждений в условиях неопределённости объяснялась в руководстве по рациональной работе. Но до причинности (и связанной с причинностью контрфактуальностью) в инженерных обоснованиях часто не доходят, довольствуются простыми проверками «формальной логики», а не проверками логики причинности.
В частности, стандарт ISO 15026-2 ссылается на работу «A Taxonomy of Fallacies in System Safety Arguments»359, в которой приводится классификация ошибочных аргументов (заблуждений/fallacies) и приводятся их примеры в хорошо известных обоснованиях. Вот эта классификация:
-
Circular Reasoning
-
Circular Argument
-
Circular Definition
-
-
Diversionary Arguments
-
Irrelevant Premise
-
Verbose Argument
-
-
Fallacious Appeals
-
Appeal to Common Practice
-
Appeal to Improper/Anonymous Authority
-
Appeal to Money
-
Appeal to Novelty
-
Association Fallacy
-
Genetic Fallacy
-
-
Mathematical Fallacies
-
Faith in Probability
-
Gambler’s Fallacy
-
Insufficient Sample Size
-
Pseudo-Precision
-
Unrepresentative Sample
-
-
Unsupported Assertions
-
Arguing from Ignorance
-
Unjustified Comparison
-
Unjustified Distinction
-
-
Anecdotal Arguments
-
Correlation Implies Causation
-
Damning the Alternatives
-
Destroying the Exception
-
Destroying the Rule
-
False Dichotomy
-
-
Omission of Key Evidence
-
Omission of Key Evidence
-
Fallacious Composition
-
Fallacious Division
-
Ignoring Available Counter-Evidence
-
Oversimplification
-
-
Linguistic Fallacies
-
Ambiguity
-
Equivocation
-
Suppressed Quantification
-
Vacuous Explanation
-
Vagueness
-
Один из выводов этой работы ещё и в том, что люди — это очень плохие критики, в одних и тех же текстах даже стандартизированных инженерных обоснований разные даже очень квалифицированные люди находят разные ошибки, и иногда эти ошибки даже из одной категории предложенной классификации не пересекаются друг с другом, один инспектор её видит, а другой не видит, и наоборот.
Подключение искусственного интеллекта тут пока плохо помогает. Есть работы, которые демонстрируют, что искусственный интеллект, построенный на нейронных сетях, тоже склонен делать такие же ошибки, как и люди360. Хотя простая просьба «проверь перед тем, как отдать результат» существенно повышает вероятность правильного ответа361, но этот шаг проверки-приёмки надо запланировать и сделать! AI будет ведущим трендом, ибо несмотря на всю свою слабость его работа обходится дешевле работы людей, он работает быстрее, а также каждые полгода его умственные возможности растут с каждой новой моделью, с каждым новым доступным инструментом, а вот возможности людей –не растут, люди остаются прежними, весьма склонными к ошибкам и весьма сопротивляющимися тратить время на дополнительные проверки.
Есть и множество других работ, которые анализируют предвзятости человеческого мышления (cognitive biases), которые ведут к ошибкам аргументации362. Тем не менее, исследования показывают, что люди — это очень плохие формальные логики, они лучше как байесовские вычислители, и при этом довольно неплохи как квантовоподобные вычислители. Квантовоподобные363 (не путать с квантовыми! Это не квантовая физика, а математика, которая используется в том числе в квантовой физике) модели оказываются довольно точно соответствующими реальности364, так что как относиться к этим число логическим «предвзятостям» — не очень понятно. Более того, поиск таких предвзятостей обычно абсолютно отвлекает от сути дела: теряется предмет обсуждения, цели обсуждения, насколько важно искать именно логические предвзятости или же лучше делать что-то другое (например, поставить дополнительный эксперимент) в условиях дефицита мыслительного ресурса.
Инженерные обоснования в ходе эволюционной инженерии надо делать непрерывно (continuous assurance), нельзя «сделать и забыть». По факту создателями системы реализуется модель active inference365, в которой система-агент имеет
-
границу с окружением,
-
порождающую модель себя,
-
порождающую модель окружения,
и непрерывно принимает решения по изменению и моделей себя и окружения, и физических себя и окружения, чтобы минимизировать предсказанный негативный сюрприз (то есть выжить).
В инженерии всё то же самое, но поскольку целевые системы до сих пор довольно безмозглы (если это не агентные AI-системы366, которые становятся всё умнее и умнее), всё это моделирование и работы по изменениям на основании итогов моделирования делается создателями системы. Тут ещё и слово «создатель» имеет оттенок однократности: вроде как «создал, и система есть». Нет, читать это слово нужно как «создатель MVP системы, а дальше он непрерывно продолжает развивать систему». То есть «создатель-развиватель», мы это неоднократно подчёркивали.
«Сопровождение» (maintenance) раньше включало в себя только поддержание работоспособности системы, а сейчас включает в себя развитие системы (иногда пишут modification или continuous adaptation), и даже смена слова на «поддержка» (support) не совсем тут адекватна. Речь ведь идёт о непрерывном вводе в эксплуатацию новых и новых возможностей системы. Увы, пока непонятно, как об этом говорить в части инженерных обоснований, устоявшихся общепризнанных методов и фреймворков нет.
Оказывается, нельзя говорить и об обосновании как чём-то, что переводит систему из состояния «свойство не обосновано» в состояние «свойство обосновано», ибо речь идёт уже не о статической системе, а о быстро меняющейся системе. «— Посмотри, у меня поворотник на машине работает? — Да, смотрю. Работает, не работает, работает, не работает…». Обоснованность тут меняет своё значение, она говорит о том, что если что-то окажется необоснованным, то оно будет замечено, в какой бы момент проекта (когда эксплуатация уже идёт!) эта необоснованность ни появилась.
И тут нужно ещё помнить, что обоснования требуют затраты ресурсов: если вам нужно обосновать использования винтика под крестообразную отвёртку или под обычную, это будет одно обоснование. Если этот винтик как-то существенно оказывается связанным с надёжностью получающейся системы и скоростью её изготовления и ремонта, то вы ещё подумаете о других развилках (сварка, 3D-печать, болт и гайка, клеевое соединение и т.д.). Цена вопроса тут совсем другая, но всё одно обоснование вряд ли потребует много ресурсов. Но вот если какое-то ваше проектное/design или архитектурное решение требует выделения $2 млн., то объём обоснований будет существенно больше, а при $2 млрд. может оказаться и нелинейно больше, при этом «непрерывное уточнение функциональности, архитектуры и учёт изменений окружения системы» и прочие ваши трудности с рассуждениями мало кого будут волновать. Ещё одна проблема в том, что вы легко сможете отбиться, изобразив «формальное обоснование в полном соответствии со стандартами»: часто речь идёт о выделении не личных денег, а вполне себе обезличенных каким-то «фондом», собранным инвесторами в лучшем случае, или денег госбюджета, которые гарантированно не принадлежат распорядителям этих денег, и поэтому этим распорядителям могут быть важны не собственно обоснования, а убедительная демонстрация того, что какое-то внимание обоснованиям таки было уделено. Так что содержание обоснований не посмотрят, критику аргументации вести не будут, continuous delivery с его «проверкой гипотез» обсуждать не будут, но на любые несоответствия формы записи обратят особое внимание, будьте к этому готовы.
Если у вас политический проект, то на рациональность обоснований и вовсе смотреть не будут, а за рассуждения о том, что какая-то «программа партии» выражает гипотезу успешности будущей общественной системы, а не гарантирует успешность просто фактом своего наличия, так и вовсе накажут.
Почему это всё важно? Мышление происходит на основе высказывания каких-то догадок, часто ошибочных. Чисто логически нельзя доказать догадку, но можно её опровергнуть, показав ошибочность аргументации в её поддержку. Поэтому качество мышления зависит от нескольких факторов:
-
Качество выдвижения догадок. Нужно быть достаточно безумным фантазёром, чтобы выдвинуть догадку, до которой раньше никто ещё не додумался. Догадки должны быть «умными», а не совсем уж случайными. Эволюция должна быть не совсем уж методом проб и ошибок: все пробы должны быть крайне вероятными в части их возможного успеха.
-
Качество критики. Все ошибки в догадках должны быть обнаружены как можно раньше. И вот тут помогает логика. Логика не может дать качественную догадку, догадки не выводятся из данных, но зато на основе данных можно качественно прокритиковать догадку. Инженерные обоснования не говорят, как получить успешную систему. Но они не дают получить неуспешную систему, они прямо указывают на её неуспешность и дают границы для уверенности в успехе.
-
Ресурсы, которые вы можете потратить как на выдвижение догадок, так и на критику. Ибо пока толстый сохнет, тонкий сдохнет. В конечном итоге на рынке (или в политической борьбе, или в экосистеме — инженерии бывают очень разные) победит тот, у кого хватит ресурсов больше выдвигать догадки, жёстче их критиковать и больше экспериментировать в реальной жизни.
Задания
Поставьте отметки о выполнении:
-
Найдены десять ошибок в инженерных обоснованиях вашего проекта, они задокументированы в произвольной форме, для каждой ошибки указан её вид (назван вид заблуждения или предвзятости из какой-то выбранной вами классификации).
-
Подготовьте инженерное обоснование для какой-то части вашего рабочего проекта, использовав структуру «претензия — аргумент — свидетельство». Для каждого свидетельства в аргументе оцените достаточность проведённых испытаний.
Обоснование выполнения требований стандартов (compliance)
Стандартизация в инженерных обоснованиях идёт по двум вариантам:
-
или стандартизация формы самого обоснования (assurance case с аргументацией, или произвольное эссе, или обязательное решение комиссии независимых экспертов, и т.д.)
-
или стандартизация требований к системе, выполнение которых (compliance, подчинение требованиям) надо обосновывать (если это стандарт, то в нём — требования, а не «гипотезы» или даже use cases).
Проблемы со стандартизацией формы обоснования — это прежде всего трудоёмкость формализации: как выделение отдельно претензий, отдельно аргументов, отдельно свидетельств, отдельно сведение всего обоснования в связную непротиворечивую структуру, так и дополнительные работы по исправлению ошибок (жёсткая форма подсвечивает ошибки, которые легко пропустить в неформальном тексте). Результат стандартизации формы обоснования получается качественным, но дорогим, и тут нужно быть начеку: не слишком ли дорог этот качественный результат? Насколько экономически обоснована лишняя жёсткая формализация?
С обоснованием выполнения требований предметных стандартов (compliance) тоже часты трудности. Часто оказывается, что эти «требования стандартов» не в меру безумны, особенно для стандартов безопасности и защиты, ибо в порядке «ужесточения норм безопасности» в какой-то момент уровень требуемой характеристики становится уже такой низкий, что его непонятно как измерить на фоне шума (ниже естественного природного фона, или погрешности измерительной аппаратуры — решение ведь принимают политики и менеджеры, а не инженеры, такое, например, было на Калининской АЭС, когда для очередного энергоблока оказалось можно брать воду из местного ручья, но нельзя было её возвращать после использования на станции для охлаждения — уровень естественной радиации этого ручья был больше, чем разрешалось стандартом для сброса воды со станции), или же речь идёт о таких редких событиях, что нельзя продемонстрировать статистику (например, аварии автомобилей без водителя: они слишком редки, чтобы можно было делать уверенные выводы о безопасности или опасности таких автомобилей по сравнению с автомобилями с водителем. Можно предлагать результаты моделирования столкновений, но стандарты обычно требуют испытаний «в натуре», а для них данных обычно бывает абсолютно недостаточно для хоть какой-то уверенности). Часты ситуации, когда достижение желаемых уровней безопасности очень и очень дорого, а сам уровень установлен произвольно политиками. «Человечество разучилось рисковать», как сказал Элон Маск, когда комментировал жёсткие требования лицензирования полётов в космос. Это всё проблемы, которые нельзя обычно решить на уровне одного проекта, это чистой воды «политика». Опять же, понятие «безопасность» все понимают по-разному, ибо решения принимаются часто политиками как социальными инженерами, а не инженерами по образованию — и понятие «опасность» в нормативных документах рассматривается по-бытовому367.
Но иногда бывает наоборот, отсутствие compliance обходится очень дорого. 42-тысячный Эрзинь находится на юге Турции, в центре провинции Хатай. В результате произошедших 6 февраля подземных толчков разрушены здания во многих районах Хатая, кроме Эрзиня. В городе не появилось не только развалин, но и хотя бы обломков, а ни один местный житель в итоге не пострадал. Все здания в городе остались целы, потому что мэр города Эрзинь Оккеш Эльмасоглу не разрешал строительство с нарушениями стандартов. А почему здания в других районах Хатая были разрушены? Потому что там соблазнились более низкими ценами на строительство. Compliance — это дорого, но не всегда безумно.
Стандарты безопасности бывают сформулированы по принципу контроля результата (performance-based) или контроля способа (design-based). Конечно, нужен результат, но соблазн перейти на design-based велик, ибо в разы проще проверять (например, не «прочность балки должна быть достаточной, чтобы выдерживать нагрузку в 100 тонн», а «использовать квадратную балку из стали XYZ и стороной квадрата 10см, лежащую на опорах с шагом не шире 1м»). Но тут проблема в остановке инноваций, ибо если будет изобретён какой-то новый способ выдерживать нагрузку в 100 тонн (какие-нибудь углепластиковые балки, лёгкие и прочные), то их использовать в случае performance-based стандарта будет можно, хотя нужно будет предоставить расчёт и результаты испытания, а вот в условиях design-based стандарта их использовать будет нельзя, разве что нужно будет менять сам стандарт (смена стандарта — это проект масштаба отрасли, а не масштаба конкретного проекта). Скажем, стандарты атомной промышленности США performance-based, а атомной промышленности России (по наследству от времён ещё СССР) design-based. Поэтому сертификация безопасности российских атомных станций в мире весьма затруднительна, если только какая-то страна не берёт за основу своей сертификационной системы весь пакет design-based стандартов и не соглашается на фактическую остановку прогресса на технологиях, закреплённых этими стандартами много десятков лет назад. Что там конкретно выбрано в качестве структуры аргументации внутри самого проекта, какой из многочисленных стандартов нотации и формализации, тут уже не имеет значения: просто некоторые аргументы не принимаются «в силу законодательства», речь уже не идёт о рациональных рассуждениях и теориях решений: решения были сделаны давно, не рационально, другими людьми в другой ситуации.
Если начинать на уровне отрасли/сообщества (а часто и общества) исправлять ситуацию и принимать какие-то рациональные решения, то эти решения имеют огромную цену реорганизации отрасли, в которой давно всё налажено и работает, хотя и не рационально: представьте себе цену смены ГОСТов в России, где на них ориентирован и весь станочный парк, и документация предприятий, и транспорт, и обученные миллионы людей. Эти исправления обычно явно выходят за пределы решений одного инженерного проекта, они выходят на уровень работы с сообществами и даже обществом.
Но на уровне общества могут работать ровно обратные механизмы, поскольку можно политически предложить явно лишние меры по защите и безопасности, в том числе и предъявление развёрнутых формальных обоснований даже там, где они не нужны — и обоснование этих явно лишних мер сделать за счёт денег налогоплательщиков.
Не забываем, что большинство стандартов для инженерных обоснований в форме «обосновывающих дел» зародились где-то в середине нулевых годов 21 века, когда резко повышались требования к безопасности чего бы то ни было со стороны законодательства. Это легко наблюдать, например, на законодательстве о детях: всю историю человечества они свободно играли на улицах практически в любом возрасте, а вот сейчас их нельзя одних выпускать из дома до 12 лет (это даже не ученики начальной школы, это пятый класс!). Можно отдельно обсуждать причины этого явления, но в системной инженерии обойти это обсуждение нельзя: происходящее в конкретном инженерном проекте на уровне технических решений целевой системы и в проектах организаций графа создателей определяется в существенной мере и тем, что происходит в сообществах и обществах, в которых происходят эти разработки и последующая эксплуатация систем.
Ещё одна проблема стандартизации обоснований в требованиях визуальных/диаграммных языков моделирования. Эта мода появилась ещё в конце 20 века, но в жизни они не получили большого распространения: софт для такого моделирования уникальный и дорогой. Хуже всего то, что визуальные модели невозможно вести/изменять (то есть трудно вести/изменять «обосновывающее дело»), их очень трудно ставить под контроль конфигурации, сравнивать и модифицировать, интегрировать с другими моделями. Так что все эти стандарты формы обоснования получили ограниченное распространение за пределами госзаказа с его неограниченными деньгами и неограниченными требованиями к обоснованиям.
Но несмотря на все эти трудности, обоснования в инженерии остались, принципы обоснования на базе документирования свидетельств и явного изложения аргументов, использованных при рассуждении, остались.
В стандартизации сама известность процедуры обоснования соответствия стандарту (compliance) делает стандарт стандартом в отличие от просто «публичного документа», например, «фреймворка» (описание того, какие объекты внимания важны в предметной области, советы «как думать»). Скажем, известный cистемноинженерный фреймворк CPS PWG (Cyber-Physical Systems Public Working Group) Cyber-Physical Systems (CPS) Framework368 — это публичный документ, ибо для него не предусмотрено, как обосновывать следование этому документу. ISO 15288:2023 предусматривает обоснования того, что система-создатель какой-то системы следует предписаниям этого стандарта. Все положения этого стандарта следуют рекомендациям стандарта ISO 33001:2015 (он заместил более древний стандарт ISO 15504:2004 SPICE) по оценке процессов (process assessment). Это означает, что известна процедура, по которой можно оценить, следует ли какая-то разработка положениям стандарта ISO 15288 (и варианта его для программной разработки ISO 12207), и в какой степени следует. Это не означает, что вы прямо-таки должны следовать положениям этого стандарта и должны проводить оценку, но это означает потенциальную возможность: известность процедуры.
Обоснование соответствия стандарту — важная часть стандартизации, а стандартизация — важная часть системной инженерии. Обосновав соответствие стандарту (например, что вилка вашего электроприбора соответствует стандарту), вы исключаете необходимость обоснования (например, путём испытаний) соответствия вашего продукта огромному числу других продуктов (например, огромного числа розеток для этой вилки). Если вы сделали компьютерную клавиатуру, и она следует стандартам компьютерных интерфейсов (USB или Bluetooth), то вам нужно только, чтобы она честно следовала этим стандартам, и испытывать нужно именно это соответствие/compliance стандартам. Не нужно будет проверять работоспособность клавиатуры во всех возможных режимах со всеми потенциально возможными компьютерами, док-станциями, удлинителями кабелей и т.д.
Инженерное обоснование деятельно, оно требует ресурсов
Инженерное обоснование выглядит как некоторое рассуждение, которое изложено в структурированной форме, легко посчитать его чисто «умственной работой», ноль требуемых ресурсов — но это глубоко не так. Информацию/свидетельства/evidence для рассуждений нужно добыть, чтобы снизить неопределённость в суждениях, а это часто означает необходимость проведения экспериментов/тестирования/испытаний (для которых часто надо ещё и построить какие-то испытательные стенды), а затем только нужно провести рассуждения (сформулировать аргументы, что тоже требует ресурсов), проверить на отсутствие ошибок, документировать этот результат, но главное — затем принять всерьёз, то есть воплотить результат в жизнь, проявить «политическую волю» (а это может быть нелегко, но если результаты обоснования не использовать, то его можно вообще не делать — надеяться на «авось», работать, возможно, в заведомо неуспешном проекте).
Стандарты тут не помогают, ибо они говорят про то, что без обоснования в документированном виде (а хоть и в виде логов автоматизированного прохождения тестов и оценки того, что «тесты прошли», безо всякого аргументирования, если сможете показать, что это и есть «документирование обоснований») обойтись нельзя. Обычно стандарты задают только форму записи результатов инженерного обоснования, но ничего не говорят, как именно получить это обоснование, какими мыслительными процедурами.
Что считать рационально обоснованными решениями? Обычно такими решениями называют решения, выработанные согласно SoTA известным человечеству теориям решений (мы уже касались этого вопроса, когда говорили о прохождении развилок/trade-off studies):
-
Нужно быть lean, если проблема неважна, то просто её не решаем.
-
Если важна, то шаг формализации того, чего нужно достичь, какую проблему решаем (и тут нужно понимать, что пока вы занимаетесь решением проблемы, обстоятельства могут измениться, проблема может «поплыть», формализация станет сомнительной). В формальной постановке проблемы проще находить ошибки, без этого нельзя.
-
Сгенерировано какое-то количество альтернатив (уже известных, или новых). Нет альтернатив — плохие решения. Помним, что всё, что говорится про мутации (абсолютное большинство плохих и ухудшающих, немного примерно одинакового квазиоптимального SoTA уровня, крайне редко скачки в SoTA за счёт предложения нового решения, оптимизирующего конфликты на многих системных уровнях за счёт усложнения) верно для генерации альтернатив. Если альтернатива одна, то есть альтернатив нет — у вас плохое воображение, это провал.
-
Выбор между альтернативами (прохождение развилки) обоснован согласно SoTA методам. Когда-то это была только булева логика, затем вероятностный выбор частотный, потом вероятностный выбор по байесовской статистике, затем вероятностный выбор по квантовоподобным вычислениям369. Текущие стандарты обоснований поддерживают в их простейшей форме «научный метод» как «рассуждения по индукции и дедукции», лучшие из них (например, Assurance 2.0) выходят в статистические методы снятия неопределённости, большинство признаёт важность в том числе и принятие «экспертных» (читай: интуитивных, никак не формализованных) решений. Мало какие методы учитывают то, что понятие рациональности двигается со временем. Мало какие методы вообще подразумевают явные отсылки к разным теориям рациональности и теориям решений. И ещё важно помнить, что речь идёт про причины и следствия и контрфактические рассуждения, а не просто про «логику» (логика легко отрывается от физической реальности, а вот причины и следствия обычно стараются как-то привязать к реальности).
-
Дальше надо принять рациональный выбор всерьёз: запланировать работы по итогам выбора.
-
Выполнить запланированные работы! Учтите результаты обоснований! Если обосновать успешность системы не удалось, то надо или отказаться от проекта, или что-то менять в системе!
-
Убедитесь, что результатами пользуются: если не пользуются, то всего этого можно было бы и не делать.
Из этих пунктов больше всего вопросов вызывает генерация альтернатив — это работа воображения, творческая/изобретательская деятельность. Основная ошибка рационального обоснования: берём любые две (одну вроде как неприлично) опции обоснования, выбираем затем строго формально и вроде как рационально лучшую из них. Но нет, качество этого решения определяется не качеством выбора, а качеством предложения этих начальных опций: вполне возможно, что если подумать лишний день или другой, то лучшим выбором была бы опция номер три, которой не было в тщательно организованном процессе выбора! И ещё всегда есть опция номер ноль: вы делаете выбор решения не той проблемы!
Говорим мы тут об обосновании выбора технического решения (rationale для выбора, например, одной архитектуры из трёх предложенных — но их сначала надо три предложить!) или о самом выборе способа обоснования (выбор типа аргумента, их тоже лучше рассмотреть несколько)? Речь идёт об обоих случаях. И технические решения нужно предложить в достаточном количестве и качестве, чтобы было из чего выбрать, а затем нужно предложить достаточное количество способов обоснования этих решений, чтобы выбирать уже из этих способов.
Вспомним предыдущий пример обоснования того, что модуль M реализует требование, там говорилось о том, что обоснование велось
-
или на основе предоставленной таблицы с образцами замеров,
-
или на основании собственных замеров (испытания) и затем полученную таблицу смотреть как в предыдущем подходе.
Но можно предложить и ещё варианты:
-
доказать, что претензия всегда удовлетворена «в силу конструкции» (by design, и это недопустимый способ, нельзя обосновывать «в силу требования» или «в силу проекта/design», ибо необязательно в воплощении системы будет реализовано требование или конструкция, это как раз и обосновывается: получили то, что хотели, а не «верно, потому как хотели»),
-
построить тестовую установку, которая будет случайным образом менять напряжения на входе и отмечать/записывать ситуации, когда не выполняется требование (то есть автоматизировать шаги построения таблицы и сравнения значений замеров).
-
… таких вариантов можно предложить ещё и ещё.
Потом выбрать из этих вариантов, включая экономические соображения и вероятность того, что тот или иной вариант обоснования может быть недостаточно надёжным.
Ещё надо помнить об эргодичности370: гипотеза эргодичности говорит, что результат подбрасывания монетки 1000 раз в плане выпадания решки и орла такой же, как подбрасывания 1000 монеток по одному разу, ибо монетки и условия одинаковы. Увы, в технических системах с памятью всё не так, эти системы не эргодичны. Вы не можете согнуть телефон 1000 раз и сказать, что с ним дальше при сгибаниях всё будет в порядке, если он не поломался от этого. Ибо в материале накопилась усталость, в материале есть память на эти сгибания. Если вы завели автомобиль перед выдачей его покупателю, это вовсе не означает, что он и дальше будет заводиться так же всё время его эксплуатации. В обоснованиях нужно учитывать и этот эффект.
Для некоторых ситуаций вы не можете провести испытаний (единственная ракета, которая летит на Марс: как испытать её в полёте?). Тогда вы можете приложить значительные усилия, чтобы отмоделировать эти «испытания». Так, после всемирного моратория на ядерные испытания в 1985 году резко возрос спрос на компьютеры для моделирования ядерных взрывов, и доступ к суперкомпьютерным технологиям стал приравниваться к доступу к самим испытаниям, на экспорт мощных процессоров США постоянно вводят эмбарго371 как раз из-за того, что они помогают разрабатывать ядерное оружие, не прибегая к натурным испытаниям, проводят обоснования успешности разработки ядерного оружия за счёт моделирования.
Вот этот деятельностный характер моделирования ни в коем случае нельзя выпускать из виду:
-
Если это деятельность, то она задействует ресурсы. Если нет информации для снижения степени неопределённости инженерного обоснования, то нужно её купить. Если нельзя купить, нужно что-то делать самим, но это тоже можно оценить в деньгах. Инженерные обоснования дорогие, программы всевозможных испытаний (главный способ добычи свидетельств для обоснований успешности) могут доходить до 85% стоимости проекта.
-
Обоснования тесно связаны с безопасностью и защитой, поэтому они предмет манипулирования («ради безопасности мы за ценой не постоим» и далее расчёты ресурсов на обоснования не производятся, решение принимается «политическое» — в том числе с необоснованно высокими тратами ресурсов). Оцените финансовые потоки на обоснование того, что вы не болеете коронавирусной инфекцией в 2020-2021 году, и до сих пор неадекватность принятых тогда политических решений не принято обсуждать (хотя уже начинаются попытки, но тут правду ещё долго не узнают — данные для любых обоснований на самом нижнем уровне учёта массово подделывались).
-
Работы по обоснованию (отнюдь не только испытания/testing, но и другие виды обоснований) нужно планировать, эти работы нужно адекватно оплачивать. Тут легко и перефинансировать выше оптимума, и недофинансировать (иметь недостаточную уверенность в успешности). Как вы будете определять оптимум выделения ресурсов на обоснования?
-
Обоснования трудно выделить в отдельный метод, ибо обоснования рекурсивно задействованы в каждой части проекта (когда вы сделали винтик M3 для самолёта, это хорошо бы как-то обосновать — точно ли это винтик M3, или «какой-то винтик», но есть обоснования и уровня всего самолёта в целом, так что отдельно посчитать ресурсы и финансы «на обоснования» по факту невозможно, нужно считать их на каждом отдельном системном уровне).
-
Чем формальнее обоснование, тем оно кажется точнее. Это совсем не так! Проблема с обоснованиями на среднем уровне формальности: там, где невозможно сделать точный расчёт вероятностей успешности и любой шаг повышения формальности крайне дорог, но и любая чисто интуитивная оценка не годится. Стандарты «обосновывающих дел» запредельно дороги в их применении именно потому, что заведомо требуют неадекватно высокого уровня формализма, и их применение вдруг делает весь проект невыгодным. Атомная энергия дико дорогая потому, что нормы обоснований на атомный проект в разы и разы выше, чем в среднем по промышленности: трубопроводная арматура там стоит в разы выше, чем для нефтепроводов, водопроводов и газопроводов именно из-за дополнительных обоснований. Оправдано ли это экономически? Нет, это обсуждается в профессиональных кругах, но поскольку речь идёт о ценах, которые платят налогоплательщики (по факту нет «частного мирного атома»), то ситуация становится только хуже.
-
Если вы что-то обосновали вчера, то сегодня вам нужно обосновывать это заново: жизнь изменилась!
Вот примерные составляющие цены обоснования потребительских продуктов через их испытания (и это только сбор свидетельств в пользу претензии на успешность системы, а ещё аргументирование, документирование, коммуникация и т.д.)372:
-
Время аренды лаборатории и её оборудования, в том числе время переналадки оборудования, проведения измерений, уборки после проведения испытаний. Если речь идёт о скоростном тестировании износа (скажем, смоделировать двухлетнюю эксплуатации за всего месяц испытаний), то это получается всё равно долго, поэтому дорого.
-
Продукты и их части, особенно если это разрушающее тестирование. Если это прототипы, то они обычно существенно дороже стоят, чем серийная продукция, так что это может быть ещё дороже, чем вы думаете.
-
Спецоборудование для тестирования: начиная от крепления до довольно сложных стендов, создающих предположительно эксплуатационную обстановку. А поскольку речь идёт о тестировании в каких-то диапазонах параметров окружающей среды, это может быть довольно дорого: представьте себе тестирование устойчивости к перепадам температур при диапазоне каких-то влажностей, причём сопряжённое с измерением механических характеристик: печка-холодильник с контролируемой влажностью. Дальше вопрос о размерах ваших продуктов, о массовости замеров.
-
Логистика на доставку продуктов на тестирование, зарплаты, если это лаборатория, то ещё и накладные расходы на дивиденды владельцам лаборатории. Но если вы проводите тестирование у себя, то не факт, что оно будет зачтено (независимость тестирования важна, в своей-то лаборатории заведомо всё будет «суперуспешно»), плюс много выше начальные затраты (оборудование лаборатории с нуля стоит довольно дорого).
И помним, что не испытывать будет много, много дороже:
-
Время разработки может оказаться много дольше, если не оттестировать разные варианты. При этом с развитием средств моделирования доверие к моделированию по сравнению с испытаниями растёт, но и само моделирование тоже оказывается довольно дорогим («лучшей моделью кошки является другая кошка, желательно та же самая» — и моделирование неизбежно будет приходить к этому).
-
Проблемы, не найденные тестированием, будут найдены пользователями продукта. Дальше будут: затраты не только на ремонт, но и на возможное покрытие ущерба, покрытие судебных издержек, страховых издержек. Если пропущен какой-то крупный дефект, связанный с безопасностью, придётся «отзывать продукцию», что крайне дорого. И одно дело, если «включил я вашу батарейку, а она не работает», и другое дело, если «включил я вашу батарейку, а она взорвалась», и совсем уж третье, когда «включил я вашу батарейку, она взорвалась и погибла пара человек вокруг».
-
Репутационные потери, которые финансово могут быть тоже неожиданно большими. Скажем, одиночные аварии автомобилей без водителя, которые проходили даже во время испытаний, время от времени заставляли прекратить даже сами испытания! Одиночные аварии самолётов приводят к остановке всего флота самолётов данной марки «для выяснения причин».
Не все обоснования делаются по итоговой уже изготовленной/воплощённой системе. Чем раньше вылавливается ошибка, тем дешевле она исправляется. Поэтому проверяются и описания. Такие проверки обычно называют просмотры/review — кода, проекта/design, архитектуры, требований, программ испытаний (часто review передают калькой, так и говорят: «архитектурное ревью»). Это тоже средство обоснования заявки на успешность/качество целевой системы, призванное «отловить баги» (найти ошибки) на ранних стадиях разработки, а не в ходе приёмо-сдаточных испытаний или даже эксплуатации. Коллеги и специально приглашённые эксперты смотрят описания системы, которые делают разработчики и задаются вопросами, почему эти описания именно такие, и что можно было бы сделать иначе. Это очень дорогой способ работы.
Скажем, в гейтовой/gate модели жизненного цикла каждый гейт стадии разработки предусматривал сборку к дате прохождения гейта всех описаний проекта в связное целое (а если проект какого-то винтика на нижнем уровне системы не готов, то ждут его завершения — чтобы уж гарантированно рассматривать связное полное описание), а затем работы останавливаются и происходит тщательный просмотр для оценки претензии, что система будет успешной/качественной — и этот просмотр делался обязательно внешними независимыми экспертами. Если просмотр гейта неудачен, то проект останавливается. Если частично удачен — проект занимается доработкой, если удачен — финансирование проекта продолжается. Это оказалось настолько неэффективно, что от гейтовой схемы отказались практически повсеместно: разработки разных частей системы идут асинхронно, просмотры описания частей системы и иногда доступных к просмотру описаний целой системы происходят независимо друг от друга, результаты испытаний/тестирования (включая замеры fitness functions, характеристик безопасности и защиты) тоже рассматриваются асинхронно, гейтов нет. Решения об остановке проекта принимаются, но они принимаются быстро, никто никого не ждёт при этом, эти решения не привязаны к гейтам.
Проблемы в проверке описаний (поиск ошибок, проверка rationale) в том, что в отличие от испытаний, проверять как «испытание» можно только исполняемые модели, дают ли они правильный результат (если вы, конечно, знаете, какой результат будет «правильным»). Конечно, можно проверить формат записи (наличие синтаксических ошибок, пропущенных частей описания и т.д.), но семантические/смысловые ошибки так просто не выявишь, требуется «исполнить модель в голове», и формализовать такое обычно не удаётся.
Мало что можно сказать про проверку описаний. Вообще, работа с описаниями понятна меньше, чем работа с физическими объектами — ибо заземление/grounding много проще для физических объектов. Так, для физических объектов есть отношения части-целого, они понятны, на этой основе строится системное мышление. А вот для описаний непросто разобраться, что такое «часть» и «целое», чем отличается «функциональная часть описания» от «конструктивной части описания» (в отличие от функциональных и конструктивных частей самой системы). Так что про «испытания описаний» (кроме как «сделать воплощение системы по его описанию и затем испытать это воплощение») можно немного сказать, это на сегодня больше искусство, чем наука/дисциплина, и уж тем более нормативная дисциплина.
Роль имитационного моделирования (когда модель вычисляется не «в голове», а «в компьютере») растёт, но каких-то существенных рекомендаций «для учебника» сделать пока нельзя. Фронтир инженерии проходит где-то в этом месте. В любом случае, породить какое-то проектное решение (описание) оказывается часто сложней, чем проверить, что это описание позволило изготовить успешную систему (когда вы поняли, что для самолёта можно использовать неподвижные крылья и пропеллер с лёгким двигателем внутреннего сгорания, а не продолжать работы над махолётом, то построить десяток самолётов для проверки такой идеи оказывается просто, непросто догадаться, что именно нужно строить, чтобы проверить идею, непросто догадаться про неподвижное крыло с пропеллером и двигателем внутреннего сгорания).
Решения по остановке проекта на базе неудачного обоснования основываются не всегда на обоснованиях технической части проекта. Например, проект самолёта могут закрыть на основании того, что были неудачи с предварительными продажами, но не на основании того, что техническое решение амортизации колеса оказалось плохим (техническое решение можно поменять, а вот неудачи с продажами показывают, что в проекте что-то совсем не так с его успешностью). Или может выясниться, что «прототип автомобиля лучший в мире, результаты его испытаний блестящи, но мы не можем построить успешный завод по дешёвому надёжному массовому производству этого автомобиля», и проект будет закрыт в связи с невозможностью налаживания производства (и такое часто бывает: строить завод по массовому производству продукта X обычно сложней, чем строить на этом заводе продукт X: построить завод по выпуску ракет сложней, чем построить ракету на этом заводе).
В методе экстремального программирования/eXtreme Programming предложили довести идею просмотра кода до экстремума, «если хорошо, чтобы на код смотрела не одна пара глаз, так пусть всё время смотрит не одна пара», эту концепцию назвали «парное программирование»/pair programming373. Как и в случае TDD (test-driven development, с многочисленными его последующими вариантами вроде BDD, ATDD, мы это уже обсуждали в нашем руководстве) результаты улучшений оказались не такие драматические, к ним было много вопросов (удивительно, но производительность не падала вдвое, но и не росла при заданном уровне дефектов), и после периода краткой моды этот метод так и не стал распространённым. Ситуация поменялась с появлением дешёвых «парных программистов» в составе IDE (GitHub Copilot, Amazon CodeWhisperer, Cursor и т.д.), ситуация аналогична в CAD/CAM/CAE — copilots (а то и peer programmer) становятся важным средством повышения производительности труда инженеров. Но помним, что как люди, так и AI лучше «пишут без ошибок», чем находят уже сделанные ошибки, мы это уже упоминали. Получается, что инженерные обоснования делать чуть ли не дороже, чем проектировать!
Но всё-таки ситуация с автоматизацией как проектирования, так и инженерных обоснований меняется, и по историческим меркам — меняется быстро. Сейчас ошибки безопасности в софте и ошибки несоответствия стандартам в информационных моделях строительства находят специализированные программы анализа кода374 и проверки соответствия информационных моделей стандартам, но «автоматизированные ревью» пока ещё не очень надёжны, хотя инфраструктура для них уже более-менее готова (тот же инструментарий DevOps и eXperience platforms). Расчёт всё-таки делается на просмотр кода, информационных моделей и прочих описаний самими разработчиками, но уже с участием агентов AI. А уж если говорить о тех обоснованиях, от которых нельзя отказаться, то есть обоснование соответствия стандартам безопасности, то рынок автоматизации такого обоснования более чем насыщен375.
В целом на инженерные обоснования надо закладывать от 20% до 85% бюджета проекта, и для не-инженеров это неожиданно. Конечно, автоматизация тестирования помогает снизить затраты, но не так сильно: сами коммерческие программы анализа кода или информационных моделей, или построения программ испытаний какой-то аппаратуры стоят достаточно дорого, а испытания на каждом инкременте требуют солидных вычислительных ресурсов. Ну, и написание тестов (даже если их совместить с описанием функциональности или описанием принятых архитектурных решений) тоже занимает время. Или пользователи превращаются в отдел обоснования качества, находят ошибки сами, но и последствия для бизнеса от этого соответствующие. Поэтому надо запомнить, что инженерные обоснования в классических инженерных проектах — это по стоимости примерно половина проекта (хотя это всего-навсего небольшой раздел в нашем руководстве, но по ресурсам он тянет на половину всех ресурсов, нужных на разработку).
Испытания: это измерения
Испытания считаются важнейшим видом свидетельств успешности/качества. Испытания — это измерения с целью получить обоснование претензии. Как и любое измерение, это действие, требующее ресурсов и времени. Даже «восприятие», как отмечалось в руководстве по системному мышлению — это действие, это не пассивная «фильтрация сигналов из окружающего мира»:
-
Планирование измерения, оно не происходит «случайно само». Нужен выбор того, что измерять (причинно-следственные связи с целью: инженерное обоснование) и тут важно сгенерировать достаточное число альтернатив, выбор того, как измерять (тоже из достаточного числа альтернатив, с которыми хорошо бы быть знакомым), планирование ресурсов измерения и обоснования, обеспечение их выделения (координационная работа). Это всё требует удержания внимания (в инженерии это означает, что всё это записывается, а не происходит «в уме»).
-
Подготовка измерения. Даже если речь идёт о простейшем «внешнем осмотре», это означает, что нужно физически привести во взаимодействие измеряемый объект и измерительный прибор, то есть как-то подтащить измеряемый объект к проводящему наблюдение инспектору или подвести инспектора к измеряемому объекту. Это время и ресурс как наличия и логистики от места изготовления к месту осмотра объекта, так и наличия и логистики от его текущего места к месту осмотра инспектора (без приборов при «внешнем осмотре», или с приборами. Впрочем, сейчас и при внешнем осмотре вполне могут фотографировать, то есть и тут приборы).
-
Взаимодействие в ходе измерения. И хотя в случае квантовых измерений шаг по выводу информации измерения за пределы датчика рассматривают отдельно (бит — это результат измерения, и может копироваться; кубит — результат измерения, но не может быть откопирован)376, будем считать, что речь идёт о классическом в смысле физики измерении с результатом в битах. И этот результат тоже как-то документируется. И если речь идёт о статистических результатах, то этих взаимодействий (и подготовок к ним) в измерениях может быть множество, а сами измерения могут занимать и фемтосекунды, и годы.
-
Принятие решений на основе результатов измерения. Если это эксперимент в рамках попперианского понимания науки, то он определяет выбор той теории, которая будет считаться фальсифицированной/опровергнутой (эксперимент как измерение какой-то характеристики при определённых условиях производится для опровержения тех теорий, которые хуже предсказывают результаты измерения)377, если это инженерное обоснование качества/успешности системы, то результат обоснования: удовлетворение или неудовлетворение претензии/claim.
Есть огромное число разных вариантов проведения испытаний, которые породили обширную терминологию, связанную главным образом с тем, как готовятся измерения и с особенностями проведения измерений (список тут абсолютно неполный, это просто примеры того, что часто встречается в разговорах об испытаниях как лучшем источнике свидетельств для аргументирования претензий на успешность/качество системы):
-
Мониторинг — это «постоянно идущее в ходе эксплуатации испытание», входные характеристики окружения при этом задаются эксплуатационной средой, а результаты оцениваются для обоснования заключения об успешности эксплуатации, или о необходимости ремонта («ремонт по состоянию», скажем, акустический датчик на трубе слушает шорох песчинок в протекающей по трубе с какими-то отложениями на стенках нефти, на основе анализа этого шороха делается вывод о работоспособности трубы и необходимости её чистки или даже замены), или о коррекции эксплуатационного режима (цифровой двойник). Если речь идёт о подобном в какой-то определённый момент (например, в момент старта работы), то говорят не о «мониторинге», а самотестировании/самодиагностике. Система мониторинга тут — часть системы. Если это вопросы безопасности и защиты, то вместо «мониторинга безопасности» лучше говорить о «сигнализации» как системе и обсуждать, что там должны делать все остальные в ответ на сработавшую сигнализацию. Скажем, в иммунной системе часть — сигнализация, а часть — средства устранения угрозы, всё это части организма. Очень часто «поставщики систем безопасности» поставляют не «системы безопасности», а только сигнализацию — а уж кто там будет реагировать и что делать в ответ на сигнал о проблеме, это остаётся за рамками проекта. То, что вместо «безопасности» предлагается только «сигнализация в никуда» — это надо обсуждать всегда явно, это типовая ошибка.
-
Всевозможные тестируемые объекты («железо»378, софт, модели, люди, системы) in-the-loop, причём loop тут понимается как симулятор надсистем, то есть симулятор окружения, в которое помещается тестируемый объект, на входы-выходы которого подаются нужные для полноценного тестирования сигналы (для «железа»), нужные значения на API (для софта), нужные параметры (для модели, чаще всего это компьютерная модель), нужные стимулы (для людей), нужные изменения в среде (для систем), а потом считывается реакция и происходит её анализ. Этот самый loop иногда называют «стендом». Этот цикл «задать набор характеристик системного окружения, предъявить системное окружение с этим набором характеристик, получить отклик тестируемой системы, задокументировать, вернуться к заданию набора характеристик» происходит в случае «стенда» чаще всего в разы дешевле и быстрее, чем в реальной жизни, где нужно долго ждать, пока встретятся какие-нибудь редкие сочетания входных параметров. Скажем, если у вас hardware-in-the-loop (компьютер какого-нибудь гаджета с его прошивкой), то вы можете подавать на вход самые разные значения, якобы получаемые от датчиков этого гаджета, но на самом деле генерируемые «стендом» и смотреть на отклик так же быстро (не глазами, а считывая значения, выдаваемые компьютером гаджета для актуаторов — это иногда моторчики, иногда дисплеи, иногда что-то ещё). Если бы вы помещали этот гаджет вместе с датчиками в какую-то реальную среду и делали каждый раз реальный замер (например, не подав сигнал датчика температуры «как будто у нас -30°C», а реально прикрепив датчик и охладив его до нужной температуры), то это было бы в разы и разы медленней и дороже.
-
Регрессионное тестирование — это повторное тестирование того, что уже вроде как тестировалось. Оно наиболее развито в программном обеспечении, где считается хорошим тоном прогонять все тесты в автоматическом режиме (это относительно дёшево) при любом изменении. Но и для «железа» оно тоже довольно часто. Скажем, вы тестируете тормозной путь, но поменяли шины. И опять тестируете на тормозной путь. Или поменяли бортовой компьютер, а не шины — и всё равно тестируете. Повторный экзамен для людей часто не менее осмыслен: профессиональные ассоциации заставляют переэкзаменовываться каждые несколько лет, это как раз и есть регрессионное тестирование (при этом тесты ЕГЭ являются более-менее бессмысленными, и уже через пару лет после школы их мало кто сможет сдать повторно, поэтому вопрос о регрессионном тестировании «готовности к жизни» не поднимается, ЕГЭ имеет абсолютно другие цели, не связанные с готовностью школьников ко взрослой жизни).
-
Юнит-тестирование (тестирование отдельных модулей) и системное тестирование (системы в целом) и приёмочные/acceptance (хотя тут есть терминологическое противоречие с приёмкой/validation) испытания обсуждаются в плане необходимости соблюдения некоторого баланса между ними. Проблема в том, что из-за системного эффекта обоснование успешности в работе отдельных модулей не гарантирует успешности работы системы в целом, и тем более работы надсистемы, да ещё и в необходимом разбросе параметров условий эксплуатации. Но заведомо неуспешный модуль вполне может вести к заведомой неуспешности системы, и его довольно легко обнаружить. Системное же тестирование крайне дорого. Вопрос в том, сколько внимания при фиксированном бюджете на тестирование уделять испытаниям модулей, и сколько испытаниям системы. В программной инженерии TDD, ВDD, ATDD и прочие варианты стиля разработки, ориентированные на test first, по сути сводятся к тому, что сразу пишется «испытательный стенд», как сказали бы в «железной инженерии», который проверяет результаты работы одного модуля/юнита (unit-testing). Попутно выяснилось много интересного: независимо написанные тесты оказались качеством не лучше, чем написанные самими разработчиками модуля. Но два уровня (юниты и система) — это только начало разговора, сегодня это обсуждается как пирамида тестирования. Идея в том, что на нижнем уровне пирамиды (юнит-тестирование) используют быстрые простые тесты, на уровне API уже тесты изощрённые, а на уровне UI — сложные и длительные сценарии тестирования. Результаты этого подхода в 2025 году (конечно, этот подход поддерживается современным инструментарием, без которого результаты невозможны)379: выполнение тестов на 65% быстрее, покрытие кода тестами на 40% выше, уменьшение числа сбоев в ходе эксплуатации на 90%. Это в программной инженерии, но в «железной» инженерии всё то же самое: проверки делаются быстрые на буквально каждой операции, но есть ещё и испытания на специальных стендах с трендом превратить систему в испытательный стенд для самой себя.
-
Автоматизированное тестирование380 в противовес ручному тестированию. Если понятно, что должна делать программа (но это надо задокументировать! И почему бы не сразу на языке тестов?), то можно поручить какой-нибудь программе составить программу испытаний/тестирования (набор тестов/измерений), а потом «прогнать тесты/замеры». И получить на выходе список результатов тестов/замеров, часть из которых которые будут «неприятным сюрпризом», «провалом испытаний». Проблема в том, что для получения ошибки может быть задействован довольно хитрый и длинный сценарий, и простой случайный перебор сочетаний входных параметров не даст выявленной ошибки, поэтому современные методы стараются анализировать код, чтобы найти ещё не проходившиеся его коды. Если тестировщик думает о том, какую ошибку мог бы совершить разработчик, то он тоже действует не случайным перебором, а целенаправленно — и находит ошибку. Но человек-тестировщик крайне медлен и крайне дорог. Проще добавить вычислительной мощности и поручить тестирование алгоритму. Но чем больше становится система, тем трудней в ней найти ошибку, даже если пытаться как-то делать «метод тыка» менее случайным. Сейчас ручное и автоматизированное тестирование сочетаются, хотя исход этого соревнования заранее ясен: победит автоматизированное тестирование — по мере того, как растёт роль vibe coding и Software 3.0, программы AI тоже будут начинать с test first.
-
Инженерия хаосом/chaos engineering381 как проведение испытаний путём планового отключения каких-то модулей на работающей системе и проверки того, как это влияет на работоспособность системы. Отличие от «аварии» только в том, что это отключение происходит в заранее известный момент времени, и известно, что именно выключается (поэтому есть шанс всё вернуть на место, если что-то пойдёт не так). Это очень жёсткий способ испытаний, в чем-то эквивалентный древним способам испытания мостов, когда под мостом стоит главный инженер и его команда, а по мосту движется первый грузовой поезд, да ещё и с максимальной загрузкой. Представьте, когда вам нужно по плану заглушить двигатель самолёта в полёте, и проверить, что самолёт нормально летит дальше на оставшихся двигателях. Или заклинить один из рулей и проверить, что остальных рулей хватает, чтобы лететь нормально. В случае программных систем это не выглядит так драматично, но представьте, если вам нужно оторвать интернет-соединение, за которым находятся три миллиона ваших клиентов — сколько от них прилетит звонков, если что-то пойдёт не так? Какую ответственность вы почувствуете за их убытки? Но зато при инженерии хаосом вы будете уверены, что при всяких «неожиданностях» ничего особо неожиданного не произойдёт, «у нас отвалилось крыло, как пару месяцев назад на плановом отвале крыла, занимаемся определением причин поломки, но летим нормально, жалоб нет».
-
… методов проведения испытаний/тестирования множество, и каждый день появляются новые, список можно продолжать и продолжать. Отслеживайте их, что считалось верхом совершенства вчера — сегодня уже вчерашний день. Стратегируйте: регулярно проверяйте ваш выбор методов проведения испытаний.
Поскольку в программной инженерии можно легко делать множество версий системы в день (изготовление по большому счёту проходит автоматически и мгновенно по сравнению со временем написания исходного кода программ, хотя и тут ситуация меняется: AI-системы пишут код быстро, и с каждой новой версией своих моделей качество этого кода лучше и лучше), то новинки в методах программной инженерии появляются где-то на 10 лет раньше, чем аналогичные новинки появляются в классической «железной» инженерии и инженерии кибер-физических систем. Этот разрыв быстро сокращается (скажем, с появлением таких технологий, как 3D-печать, а также технологий точного физического моделирования), но в целом для понимания фронтира в инженерных методах, включая использование AI, целесообразно смотреть именно на программную инженерию — и знание мета-мета-модели поможет избавиться от особенностей предметной области с её мета-моделью и перенести новые идеи в проектную ситуацию другой предметной области, инженерии систем другой природы.
Для понимания, в какую сторону развиваются методы инженерных обоснований, нужно прежде всего рассмотреть метод DevOps в программной инженерии, где сегодня поддерживается
-
непрерывная/continuous сборка/интеграция (CI): в любой момент времени разработки есть работающая версия системы с конфигурацией без известных конфигурационных коллизий,
-
непрерывное введение в эксплуатацию (continuous delivery, CD): в любой момент времени есть поставляемая пользователям полезная версия системы, а хоть и с ограниченной функциональностью по сравнению с задуманной, то есть рабочая конфигурация не просто «есть», а ещё и доступна для использования и поддерживается (иногда говорят про continuous deployment, но это просто «развёрнуто на месте использования и настроено-налажено», но доступности для использования и поддерживаемости пока нет, это отдельные действия),
-
непрерывная разработка/development: разработка идёт всё время проекта, реализуются всё новые и новые возможности системы, нет момента «мы закончили работать, теперь пользуйтесь, а мы пошли отдыхать» — по факту система эволюционирует во множестве маленьких жизненных циклов, идут умные мутации в разных частях системы, пользователи получают всё новые и новые версии системы в новых и новых вариантах конфигурации,.
-
непрерывное обоснование качества/conutinuous QA, сводящееся к тому, что обоснование качества ведётся непрерывно в ходе всего проекта382.
Сама идея DevOps в том, чтобы разработчики брали на себя больше методов из правой части V-диаграммы или ромб-диаграммы жизненного цикла: эксплуатацию (а не сдавали систему каким-то внешним операторам), введение в эксплуатацию (а не оставляли это тем же операторам), а также инженерные обоснования, что их система успешна (а не оставляли это тестировщикам). То, что «осталось справа» — автоматизируется, это первая задача инженеров внутренней платформы разработки.
Без DevOps методов (это до сих пор часто встречается в «железной инженерии») инженеры-разработчики отправляют очередную версию системы тестировщикам («инженерам по качеству», испытателям), а те возвращают список дефектов, инженеры-разработчики опротестовывают эти дефекты («это дефекты в ваших тестах и методике испытаний, а не в нашей системе, и вообще с такими дефектами можно эксплуатировать»), затем после исправления ошибок тестировщики отправляют систему операторам-администраторам, которые её сначала собирают/integrate, затем разворачивают/deploy и настраивают, затем выдают доступ пользователям системы (delivering) — и дальше пользователи обвиняют во вновь найденных ошибках операторов (в подгорелой котлете виноват официант, а не кухня: почему принёс это?), те обвиняют тестировщиков (почему пропустили это?), те обвиняют разработчиков (почему сами не оттестировали это?). DevOps заставляет всех работать с использование общей платформы/инструментария/конвейера/трубопровода/pipeline. В случае ресторана повара берут ответственность на себя за доходящее до клиента блюдо, а не отгораживаются официантами и службой контроля качества. Основной способ, которым такое становится возможным — это автоматизация и тестирования, и разворачивания/«ввода в эксплуатацию»/transfer/deployment, и даже пользовательской поддержки (например, in-line help/«контекстная помощь»). И ещё автоматизируется даже то, что раньше плохо понималось, например, мониторятся fitness functions, что оказывается важным не разработчикам, а архитекторам.
У подхода DevOps в части инженерных обоснований есть альтернативный вариант, который начинался в Гугл, а затем стал весьма распространён. Называется он SRE (Site Reliability Engineering)383 и одно из важнейших там отличий от «просто DevOps и инженерии платформы» — это различение работ по исправлению найденных ошибок и работ по увеличению функциональности. Подход SRE говорит, что обоснованная успешность системы — это прежде всего надёжность, безошибочность функционирования тех её возможностей, которые уже есть. И уже потом — добавление новых возможностей. Поэтому новые возможности разрешается добавлять только после того, как уровень известных ошибок в системе снижается до заранее оговорённого. До этого или уже разработанные новые возможности «кладутся в стол» и не вводятся в эксплуатацию, или их вообще прекращают разрабатывать, ибо силы всех доступных разработчиков направляются на устранение найденных ошибок, новая функционально просто перестаёт разрабатываться, все инкременты выпускаются с исправлением ошибок, а не с новыми фичами.
Как в случае осетрины, которая «или первой свежести, или не осетрина», так и в SRE: система признаётся (успешной) системой только тогда, когда на неё можно положиться. Иногда совместно рассматриваемые архитектурные характеристики, все эти -ости»/-ilities называют dependability, как раз указывая, что «на эту систему можно положиться», и инженерное обоснование должно это обосновать на базе каких-то свидетельств, а не «умозрительно».
Прогресс в развитии подходов и DevOps, и SRE, включая такие радикальные варианты обоснований как инженерия хаосом, существенно зависит от прогресса в автоматизации. Настолько зависит, что SRE (куда намеренно включается и работоспособность аппаратуры, и учёт физических внешних воздействий типа обрывов оптоволокна интернет-каналов, ураганов с возможным обрывом энергопитания и т.д.) декларирует рассмотрение всех этих проблем как «проблемы программного обеспечения», то есть недостаточной автоматизации в учёте всех неожиданностей и недостаточной автоматизации в разворачивании исправлений для известных ошибок в программах и аппаратуре.
В программной и «железной» инженерии, включая совместную для них инженерию кибер-физических систем, непрерывное инженерное обоснование (continuous QA) в рамках DevOps с инженерией платформы и SRE — это сегодня основной технический тренд. Но и он сводится к тому, что идёт автоматизация испытаний, тренд автоматизации оказывается и тут важнее. Инженерное обоснование требует огромных ресурсов, от выделения этих ресурсов нельзя уклониться, но эти ресурсы можно существенно снизить за счёт автоматизации.
Обоснование — это описание ожидаемой (или уже реальной) успешности системы. Альфа инженерного обоснования и все её подальфы — это подальфы описания, а рабочие продукты этих описаний — это assurance case, «папка обосновывающего дела», как папка судебного дела или дела/досье в какой-нибудь канцелярии, то есть документ (сегодня это обычно набор записей в базе данных, а не «листок бумаги» или даже «листок бумаги в электронной форме, например .pdf файл»).
В стандартах (QA, обоснование качества) чётко говорится, что обоснование успешности системы должно вестись в ходе всей разработки системы, это не «особая стадия перед выпуском в эксплуатацию», это просто часть разработки.
Испытания частей (юнит-тесты, которые пишут сами разработчики) ведутся незадолго до интеграционных испытаний, ибо нет никакого накопления новых частей перед интеграцией — введение новых версий системы в эксплуатацию происходит непрерывно, для софта это — по многу раз в день. После начала эксплуатации (это происходит с каждой фичей, с каждым «железным» изделием в серии, возможно каждое изделие в серии будет другое) эти же испытания/мониторинг ведутся так же регулярно (скажем, самодиагностика во время включения у оборудования, в котором есть хоть какой-то микропроцессор — это уже обычное дело, и помним про манифест прочности384: система всё время себя оценивает, что с ней происходит, чтобы быть прочной). А ещё в инженерных обоснованиях всё начинается с подготовки испытаний (современные варианты TDD, «что мы хотим от системы» документируется на языке испытаний), а затем ещё до испытаний документируют rationale, включая rationale на старт самого проекта создания системы — визионер должен принять информированное решение, согласиться с аргументами!
Инженерные обоснования — это метод, которым пользуются в ходе всего процесса инженерной разработки, укрепляя и укрепляя уверенность в том, что система получается успешной, она не только выполняет свою функцию, но и на неё можно положиться (система dependable, ещё одно часто используемое слово для выражения претензии/claim на успешность/success — и есть архитектурная характеристика dependability385).
При непрерывном вводе в эксплуатацию обосновывается в том числе каждая новая фича/инкремент, но также обосновывается, что вся система будет работать с этой новой фичей (и это даже не на двух уровнях, а на нескольких, помним про пирамиду тестирования). Так что в начале проекта формулируется претензия/claim на успешность MVP, и дальше накапливаются материалы, её обосновывающие (подчинённые претензии в их иерархии/subclaims, аргументы и доказательства).
В целом состояния, которые должна пройти альфа какой-то системы (или фичи/возможности/feature в очередном инкременте системы, там всё похоже — когда речь о системе, то чаще всего это просто MVP), могли бы включать следующие подсостояния (и для них нужны контрольные вопросы) по учёту инженерных обоснований:
-
Система/фича будет нужна — претензия на нужность системы обоснована (инвестиционное или технико-экономическое обоснование/rationale концепции использования наличествует)
-
Система/фича технически и экономически возможна — претензия на достижимость результатов проекта обоснована (концепция системы обоснована, архитектура обоснована, программа испытаний ясна)
-
Система/фича спроектирована — представлены rationale по принятым проектным и архитектурным решениям, «код написан»/«информационная модель для завода подготовлена»/«решения для персонала предприятия (если система — предприятие) приготовлено» и включает тесты. Можно изготавливать и тестировать (работа с платформой разработки, которую предоставили инженеры платформы).
-
Система/фича отмоделирована и испытана — получены свидетельства для обоснования успешности системы (и фичи, и всей системы).
-
Система/фича успешна — получено полноценное инженерное обоснование успешности системы (для собранных свидетельств построены аргументы, обосновывающие претензию на успешность системы, аргументы приняты — это делается при обоснованиях успешности по compliance со стандартами, и изредка при обоснованиях продолжения проекта для топ-менеджеров, занимающихся стратегированием).
-
Система/фича выведена из эксплуатации — получены свидетельства о том, что дальнейшая эксплуатация ранее успешной системы/фичи невозможна или невыгодна.
Как видите, тут можно считать, что для каких-то альф или подальф отслеживание обоснований можно сделать в форме подсостояний, требующих своих отдельных контрольных вопросов. Но можно говорить и о том, чтобы собрать это всё в отдельную подальфу инженерных обоснований — и сделать её подальфой нескольких альф, в том числе альфы коммерческой возможности (тем более что первый пункт прямо относится к коммерческой возможности ведения проекта по созданию системы или микропроекта одной команды по созданию/модификации новой фичи для системы). Альфы представляют собой не дерево, а граф, подальфа вполне может быть подальфой нескольких альф (это особо оговаривается и в стандарте OMG Essence). Учитываем, что:
-
все состояния альф ссылаются друг на друга (это особо обговаривается в стандарте OMG Essence), это лишний повод обратить внимание организации проекта на важность удерживать отслеживание проектной ситуации по всем альфам в их взаимосвязи, нет требования иметь «ортогональные независимые» альфы. Если вам важно удерживать инженерные обоснования как особый приоритет в отслеживании, смело заводите подальфу для всех альф, для которых вы ожидаете проблемы с обоснованиями. Заботиться о формальной «ортогональности», «независимости» необязательно.
-
онтологическая строгость определения альф и подальф не слишком большая. Каждая организация проекта адаптирует альфы к своей проектной ситуации до уровня мета-модели (предметной области из культуры, «как в учебниках» и предметной области «как у нас в проекте», то есть согласно регламентам и стандартам предприятия и предпочтениям сотрудников организации проекта). Так что нужно смотреть на то, как обычно устроены обоснования в вашей предметной области, но наше руководство и упомянутая в нём литература даст много идей о том, что может быть там пропущено или наоборот, что может быть лишним (особенно, если лишние обоснования лоббируют «безопасники», ибо они за обоснования не платят, им дёшево требовать лишнее).
Один из студентов-бакалавров, изучавший системную инженерию по предыдущей версии руководства на вопрос, что ему пригодилось больше всего из изученных методов мышления и работы, сказал: «я понял, что есть проверка и приёмка — и работы по этим методам в проекте обязательны. И я начал проверять всё, что выходит из моих рук перед тем, как отдавать результаты своей работы. И моя жизнь драматически изменилась к лучшему». Не жадничайте тратить ресурсы на инженерные обоснования с самого начала до самого конца проекта, не ленитесь их делать, и ваша жизнь тоже драматически изменится к лучшему! Но будьте готовы, что на это уйдёт половина вашего времени, а то и больше! Ещё больше времени удастся сэкономить: за счёт того, что не будете тратить время на заведомо неуспешные проекты.
Задания
Поставьте отметку о выполнении:
-
Написан и опубликован пост с изложением ваших проблем при выполнении предыдущего задания в части подготовки инженерного обоснования. Особо в посте уделено внимание испытаниям как источникам свидетельств для аргументов в вашем обосновании. Сказано, как обоснование проверялось на отсутствие ошибок в аргументации. В посте также приведена оценка экономики: сколько было потрачено на обоснование, сколько было бы потратить оптимально, как принималось решение о необходимом объёме обоснования.
-
Написан и опубликован пост, в котором вы оцениваете состояние инженерных обоснований в вашем рабочем проекте, методы, которые вы использовали для этих обоснований (и где можно почитать об этих методах), предложения по улучшению работы с обоснованиями в вашем проекте, учитывая материал, изложенный в текущем разделе руководства.
Проблемы инженерных обоснований для существ, личности, сообщества, общества
Многочисленные проблемы появляются в тех случаях, когда мы выходим из инженерии киберфизических систем и/или программных систем в инженерию систем другой природы, и вот несколько примеров:
-
Проектирование финансов предприятия, сводящееся к бюджетированию. Обычно оно связано с разработкой бюджета, а затем исполнением бюджета, что занимает годичный цикл. Движение beyond budgeting и аналогичные ему386 представляет собой по факту попытку сделать непрерывное бюджетирование по модели DevOps, где сначала вместо годичного цикла (за год может случиться и скачок цен на продукцию, и уход надёжных поставщиков материалов, и скачки в валютных курсах, и забастовки, и наоборот — новые открытия, которые дают новые коммерческие возможности, но строгий годичный бюджет не даст возможность выжить в этих условиях) идут «итерации» бюджетирования «скользящим окном» сначала квартальным, потом месячным, но затем всё переходит к непрерывному бюджетированию, где разные части бюджета непрерывно дорабатываются, публикуются как план расходов, а потом происходит контроль исполнения бюджета, и в случае явных ошибок идёт быстрое изменение бюджета. Если на заводе Tesla кто-то знает, что он может улучшить свою часть инженерного процесса, то он просто обязан это сделать: купить новое оборудование и провести эксперимент. Для того, чтобы это сделать, нужна упрощённая процедура выделения финансов — ровно это и происходит. Не надо год ожидать, пока проверят твоё обоснование, rationale этих трат. Не надо потом год ждать, пока результаты эксперимента окажутся в основном производственном процессе.
-
При покупке предприятий, при заключении крупных сделок обычно проводят процедуры проверки due diligence387, чтобы убедиться в отсутствии каких-то неприятных сюрпризов, которые могут произойти после завершения сделки. Это тоже инженерное обоснование, «входной контроль», но речь идёт о личностях и организациях, и возникает сразу много интересных особенностей. Как минимум, полностью меняется терминология, полностью меняются процедуры, а ещё это разовое действие — хотя и тут возможны варианты, по ходу проекта ведь сразу начинается организационное развитие уже совместного (после M&A388, merges and acquisitions) предприятия.
-
Если речь идёт о показаниях в суде и высказываемых в них претензиях/claims отдельных людей, то как могут быть устроены обоснования? Врёт или не врёт человек, может быть проверено на детекторе лжи, который сам по себе может врать или не врать, надёжность такого «доказательства» очень низка. Можно использовать «сыворотку правды», хотя это по факту конспирология (набор легенд) и вряд ли работает с надёжностью выше случайности389, причём можно и попросту пытать «по старинке», хотя пытки — метод «испытаний» тоже не самый надёжный и полученное под пытками или даже угрозами пыток свидетельство/evidence в основу аргумента сегодня не положишь, поэтому и обосновать мало что получится. Тут сразу поднимается множество вопросов об этике методов получения свидетельств/улик/показаний/замеров, включая «судебный поединок»390 как ранее считавшийся вполне SoTA методом и сводящийся к дуэли. И вот мы получили вроде как свидетельства/улики/evidence такими сомнительными методами. Как оценивать результаты, как строить аргумент, если заранее известно, что свидетельство ненадёжно? Никакой же статистики для отдельных людей по отдельным вопросам набрать нельзя, а должны же быть вопросы про false positive и false negative заключения, ибо от ложных обоснований как positive, так и negative могут быть весьма драматические последствия (скажем, пожизненное заключение невиновных на основе ложных обоснований, сделанных судом). Всегда нужно помнить, что на любой плохой метод инженерного обоснования можно вспомнить метод ещё хуже, и по факту используются все эти методы, иногда и в одном проекте.
-
Клинические испытания391, которые массово проводятся прямо сейчас в порядке реализации идеи «доказательной/evidence-based медицины», представляются нерациональными, их нельзя считать получением надёжных обоснований392. Дело в том, что получаемая статистика относится к группе людей, а назначение лекарства после испытания получает один человек, а не группа. И при текущем положении дел с методами аргументирования классической статистикой путём проведения клинических испытаний даже двойным слепым методом, ничего сказать про персональное назначение препарата потом нельзя, но можно сказать методами причинного вывода/causal inference. По большому счёту, вся сегодняшняя «доказательная медицина» построена на песке, она ничего не доказывает (вернее, доказывает, но совсем не то, что нужно для инженерной части: для предсказуемого изменения мира), малопонятно, что с этим делать. Причинный вывод сегодня мало кем понимается, хотя он и решает множество имеющихся проблем. Впрочем, и текущий вариант причинного вывода нельзя считать последним словом: он опирается на расчёт байесовской, а не квантовоподобной вероятности, то есть заведомо даёт искажённый по сравнению с реальностью результат393. Тут есть ещё один интересный момент: если у вас больной заведомо умрёт, но есть минимальный шанс, что выживет, если вы дадите ему потенциально опасное лекарство, которое ещё не прошло клинических испытаний ни по какой методике (скажем, просто не успели): вы будете испытывать это лекарство на таком больном? Это будет лечение или испытание? А если вы оставите каких-то больных «контрольной группы» без этого лекарства, они ж заведомо умрут! Этично ли это? Вопросы множатся и множатся. Ровно такое же рассуждение надо проводить и для психотерапии, которая тоже терапия и должна быть evidence-based, и тут тоже огромное число вопросов к воспроизводимости результатов индивидуальных интервенций, набору статистики для абсолютно уникальных случаев и даже неотличимости «разговора с другом» или «разговора с AI» от терапевтического вмешательства. Переход от врача или психотерапевта к AI тут ничего не меняет: многочисленные статистические (даже двойным слепым методом) свидетельства того, что «AI не хуже человека-профессионала» не убирает вопросов к обоснованности того, что делает человек-профессионал в случае индивидуальных назначений.
-
Обоснование успешности обучения как инженерное обоснование какого-то мастерства. Подробней этот вопрос поднимается в руководстве по инженерии личности, вывод там печальный: экзамены обычно не показывают успешности обучения, кроме самых простых случаев элементарных навыков. Диплом вуза не показывает успешности в работе, результаты ЕГЭ не показывают успешности в жизни. Более того, большие проблемы с «экзаменами» (benchmarks) как методом получения свидетельств для обоснования успешности создания машинного интеллекта, то есть «испытания» тут понятно, как сделать, но положить их в основу обоснования успешности — нельзя.
-
Обоснование идей по социальной инженерии поднимает те же вопросы «экспериментов на людях». При этом даже в случае получения отрицательных результатов (например, все случаи сознательного устройства общества на основе социалистических идей были провальны, но попытки продолжаются и продолжаются, несмотря на «отрицательный результат испытаний», под лозунгом «они там всё неправильно делали, а вот у нас непременно получится!»). Одно из решений тут — ход на классический либерализм как обобщение хода, выработанного в ходе Реформации и кровопролитных религиозных войн католиков и гугенотов: они там все разрешили друг другу маршировать прямо в ад, ибо честно считали, что именно это и происходит, но прекратили насаждать путь в рай военным путём. Поэтому кто хочет маршировать прямо в социалистический голод и диктатуру (как считают одни) или социалистический рай (как считают другие) — пусть марширует, если не втягивает в это других людей, это неплохое начало. Но если это реальная социальная инженерия («я социальный инженер, то есть политик, знаю, как вам жить, верьте мне, я умней вас, неразумных»), а не допотопная эволюция, то неплохо бы для начала получить какие-то обоснования — и чтобы они были не «верую, так лучше», а не менее надёжны, чем инженерные обоснования для автопилотируемого автомобиля или атомной электростанции. И тут оказывается, что как и для клинических испытаний, как для экзаменов «готовности к жизни», как для «интеллекта» каких-то надёжных методов обоснования успешности социального инженерного проекта (обоснования успешности результата социальных реформ) нет. Это не значит, что нельзя предлагать каких-то «умных мутаций» и как-то пытаться выделить их результаты среди всего многообразия жизненных явлений (легко ведь сделать и неверные выводы: «100% из попробовавших в своей жизни огурцы людей рано или поздно умерли. Значит, огурцы вредны, статистика не может врать!»).
Проблема налицо: образование, социальная инженерия (политика), менеджмент, медицина, психотерапия — всё это, конечно, инженерия, но пока игнорирующая главный технический инженерный тренд: ход на непрерывное обоснование, ведение обосновывающего дела, автоматизацию экспериментального получения свидетельств успешности или неуспешности предлагаемых методов.
Без различения model-based и model-driven.
https://ru.wikipedia.org/wiki/Теория_субъективной_ожидаемой_полезности и https://ru.wikipedia.org/wiki/Теория_ожидаемой_полезности, https://ru.wikipedia.org/wiki/Ординалистская_теория_полезности, https://ru.wikipedia.org/wiki/Кардиналистская_теория_полезности, https://ru.wikipedia.org/wiki/Предельная_полезность. Вполне могут переводить сегодня и «ценность», при этом понимание на русском будет хуже. Вот сравните: «добавленная ценность» и «добавленная полезность» — первое непонятно как понимать, а второе — вполне понятно. В английском бывает https://dictionary.apa.org/subjective-expected-value, но запросто будет и https://en.wikipedia.org/wiki/Subjective_expected_utility. В принципе, нюансы использования value — «общее ощущение», а utility — «структурированная оценка в моделях и теориях».
Smart mutation — не случайные, а алгоритмически наиболее вероятно ведущих к лучшему, из https://arxiv.org/abs/1709.00268 или https://arxiv.org/abs/2206.08896
https://ailev.livejournal.com/1106188.html, это текст ещё 2014 года. События 2022 года показали, что в этом мире «непрерывной разработки» отключить миллионы людей от пользования самыми разными системами стало не просто легко, а очень легко.
https://arxiv.org/abs/2410.02543, но ещё в 2021 году была предложена работа https://www.pnas.org/doi/full/10.1073/pnas.2120042119, в которой давалась таблица соответствия понятий термодинамики, биологической эволюции и машинного обучения. Число подобных работ растёт.
https://en.wikipedia.org/wiki/Geometrical_frustration, обязательно смотрите там фильм про неустаканенность магнетизма в твёрдых телах
https://en.wikipedia.org/wiki/Geometrical_frustration, там обязательно смотрите видео Frustrated magnetism in solids, ибо нужно понимать динамику происходящего, она лучше даётся в видео.
первый абзац в https://ailev.livejournal.com/1621262.html
Математика по физике агентов в сочетании с active inference можно найти в https://chrisfieldsresearch.com/, а работы по active inference — в https://www.activeinference.org/
https://youtu.be/XvVa-mByxMs?t=1240, больше информации в «Minimal physicalism as a scale-free substrate for cognition and consciousness», 2021, https://chrisfieldsresearch.com/min-phys-NC-2021.pdf
https://ailev.livejournal.com/1416697.html
https://en.wikipedia.org/wiki/Fitness_landscape#/media/File:Visualization_of_a_population_evolving_in_a_dynamic_fitness_landscape.gif, со страницы https://en.wikipedia.org/wiki/Fitness_landscape

Картинка в высоком разрешении— https://ic.pics.livejournal.com/ailev/696279/212554/212554_original.png

Картинка в высоком разрешении: https://ic.pics.livejournal.com/ailev/696279/285342/285342_original.png

If there is an issue between SE and EoS, it may be semantic, rather than grammatical. Classically, the first word moderates the second: so, in SE, 'systems' appears to moderate (describe the type or flavour of) engineering; and in EoS, 'engineering' appears to moderate (describe the type and flavour of) systems. — из prof. Dereck Hitchins, «SYSTEMS ENGINEERING VS. ENGINEERING OF SYSTEMS - SEMANTICS?», https://systems.hitchins.net/profs-blog/systems-engineering-vs.html
"It's relatively easy to make a prototype but extremely difficult to mass manufacture a vehicle reliably at scale. Even for rocket science, it's probably a factor of 10 harder to design a manufacturing system for a rocket than to design the rocket. For cars it's maybe 100 times harder to design the manufacturing system than the car itself. The issue is not about coming up with a car design — it's absolutely about the production system," Musk said. "You want to have a good product to build, but that's basically the easy part. The factory is the hard part." — https://www.businessinsider.com/elon-musk-says-building-factory-100-times-harder-than-making-car-2019-3
Картинка в высоком разрешении — https://ic.pics.livejournal.com/ailev/696279/276990/276990_original.png

По мотивам https://www.researchgate.net/publication/200026050_Collaborative_Networks_Reference_Modeling
Обычно deep, «глубина» в речи означает рост числа уровней какой-то иерархии. Скажем deep learning — это многоуровневое обучение, то есть обучение нейронных сетей с числом скрытых уровней/слоёв больше одного. В углублении разделения труда речь идёт об увеличении числа уровней иерархии по отношению специализации (род-вид) между методами.
См. доклад Влада Свяжина рассуждениями об этой идее, с 1:04:11, https://www.youtube.com/watch?v=lpgpnCoV14w&t=3851s
Подходы к определению импровизации см. в https://ailev.livejournal.com/1730660.html
О плохих объяснениях рассказывается в курсе «Создание объяснений», см. также книгу Дэвида Дойча «Начало бесконечности. Объяснения, которые меняют мир».
Turton, Richard, et al. (2003) Analysis, Synthesis, and Design of Chemical Processes, Upper Saddle River, NJ: Prentice Hall.
Термин появился ещё в 2011 году https://go.forrester.com/blogs/11-02-07-i_dont_want_devops_i_want_noops/, но дебаты идут до сих пор, ибо путается создание платформы (где нужны пока люди) и её работа без людей.
https://www.anandtech.com/show/21408/tsmc-roadmap-at-a-glance-n3x-n2p-a16-2025-2026, к этим «проектным нормам» нужно относиться с осторожностью, https://www.iguides.ru/main/other/sovremennye_tekhprotsessy_grandioznyy_obman_razbiraemsya_v_marketingovykh_tonkostyakh_protsessorov/
https://en.wikipedia.org/wiki/Cognitive_behavioral_therapy на базе behavior and cognitive psychology, https://www.apa.org/ed/graduate/specialize/behavioral-cognitive
См. про архитектурную оптимизацию в https://ailev.livejournal.com/1464563.html
https://www.diapazon-pharm.ru/kisecnorastvorimye-kapsuly-preimusestva-i-spros, https://patents.google.com/patent/RU2569742C1/ru
https://www.researchgate.net/publication/343999144_How_Formal_Requirements_Specifications_Inhibit_Creativity_in_Software_Engineering, и то же самое про шаблонизированные требования https://www.researchgate.net/publication/354528878_How_Templated_Requirements_Specifications_Inhibit_Creativity_in_Software_Engineering. Эта тема «иллюзии требований» разрабатывается с 2013 года, https://www.researchgate.net/publication/255831240_The_Illusion_of_Requirements_in_Software_Development
https://ru.wikipedia.org/wiki/Клеточный_автомат, https://ru.wikipedia.org/wiki/Автоматное_программирование
)пример Netflix — https://jivimberg.io/blog/2023/09/04/the-inverse-conway-maneuver/, ещё один пример — https://www.thoughtworks.com/insights/blog/customer-experience/inverse-conway-maneuver-product-development-teams
Пример architecture characteristics worksheet — https://www.developertoarchitect.com/downloads/architecture-characteristics-worksheet.pdf, в классической инженерии их продолжают называть system quality attribute — https://en.wikipedia.org/wiki/List_of_system_quality_attributes
https://www.aia.org/sites/default/files/2024-11/AIA_Design_Deconstruction_Adaptability_Reuse.pdf
https://www.cerebras.net/blog/cerebras-wafer-scale-engine-inducted-into-the-computer-history-museum/
https://www.artlebedev.ru/izdal/yazyk-shablonov/ — по-русски pattern language переведён как «язык шаблонов».
В сборнике Transactions on Pattern Languages of Programming IV, 2019
https://en.wikipedia.org/wiki/Current_reality_tree_(theory_of_constraints), https://www.6sigma.us/six-sigma-in-focus/current-reality-tree/
https://www.amazon.com/How-Measure-Anything-Intangibles-Business/dp/1118539273, 3rd edition, 2014
Есть русский перевод, https://www.litres.ru/dzhez-hambl/uskoryaysya-nauka-devops/, но мы рекомендуем всё-таки читать оригинал
https://www.anthropic.com/news/paris-ai-summit, февраль 2025
Но некоторые архитекторы ещё в 2019 году выражали сожаление по поводу неиспользования термина и ухода от явного обсуждения ситуации, «ИТ-архитекторы же продолжают сидеть в своих башнях из слоновой кости, подобно Винни-Пухам, застрявшим после сытного перекуса в домике Кролика. Даже тег DevArchOps остаётся неизвестен гуглу и воспринимаемся им как бессмысленный набор символов», https://mxsmirnov.com/2019/06/06/architecture-as-a-code/#more-2892.
https://www.litres.ru/atul-gavande/chek-list-kak-izbezhat-glupyh-oshibok-veduschih-k-fatalnym-po/
Тут, конечно, не нужно путать с 6D для экспоненциальных технологий от Peter Diamandis и Steven Kotler (exponential organizations должны быть digitised, deceptive, disruptive, dematerialized, demonetized, democratized, это Singularity University в 2016, когда модно было искать везде экспоненты и единорогов) — https://www.diamandis.com/blog/the-6ds
https://en.wikipedia.org/wiki/Concurrent_engineering, не путайте с collaborative engineering, http://ailev.livejournal.com/943532.html
Подробней смотри серию публикаций https://ailev.livejournal.com/1549559.html, https://ailev.livejournal.com/1548016.html, https://ailev.livejournal.com/1550931.html
https://www.arxiv.org/abs/2502.19414, https://arxiv.org/abs/2502.06556, https://arxiv.org/abs/2502.09858
https://en.wikipedia.org/wiki/Cognitive_bias, https://utminers.utep.edu/omwilliamson/engl1311/fallacies.htm
Вот пример 2015 года, http://new.gva.vc/ru/about/news/512/?PAGEN_2=4
Для софта, например, https://www.guru99.com/code-review-tools.html, для информационных моделей
Дэвид Дойч, «Начало бесконечности. Объяснения, которые меняют мир»