lytdybr
Провёл в воскресенье семинар по инженерной семиотике (https://ailev.livejournal.com/1797664.html), после семинара оставил в чате семинара слайдомент и даже добавил текущий файл с архитектурными документами всего semio-workstream (по этим документам я планирую ещё провести десять кампаний по добавлению паттернов в FPF, вдруг кому интересна эта внутренняя кухня?). Семинар сработал ровно как задумано: я понимал, что за три часа не смогу ничему научить -- но смогу пробудить какой-то интерес к семиотике, ибо станет понятно, что без неё в инженерных проектах не обойтись. Какие-то операции с документами проекта (найдёт плохие имена, скажет об обращении к неверной роли и т.д.) сделает semio-архитектура в FPF, но чтобы разобраться и воспользоваться этими и многими другими возможностями FPF, надо понимать, что делаешь. Ибо не понимаешь -- не видишь ошибок, не видишь ошибок -- получишь repair/rework (repair -- содержательное view, rework -- view операционного менеджмента, обсуждали на семинаре). И даже не догадаешься попросить FPF сделать починку. И даже будешь считать эти repair/rework неизбежным злом, хотя многих видов этого зла вполне можно избежать (и прямо в чате семинара участники привели пример, как они избегали семиотических неприятностей в своих проектах, хотя и без FPF, а "вручную"). Похоже, интерес к семиотике пробудить удалось. Уже участник семинара написал в чате про пару часов бесед с FPF+слайдомент на тему личных пробелов в понимании семиотики, и это уже сегодня. И дал общую оценку времени: на это надо потратить неделю. Видео, слайды, архитектурные документы -- в чате, при этом в чат можно попасть (как и в другие чаты предыдущих семинаров -- https://events.system-school.ru/#rec2008471521). Сегодня утром в чате случилось очередное большое обсуждение, так что послесеминарская жизнь, как обычно, продолжается.
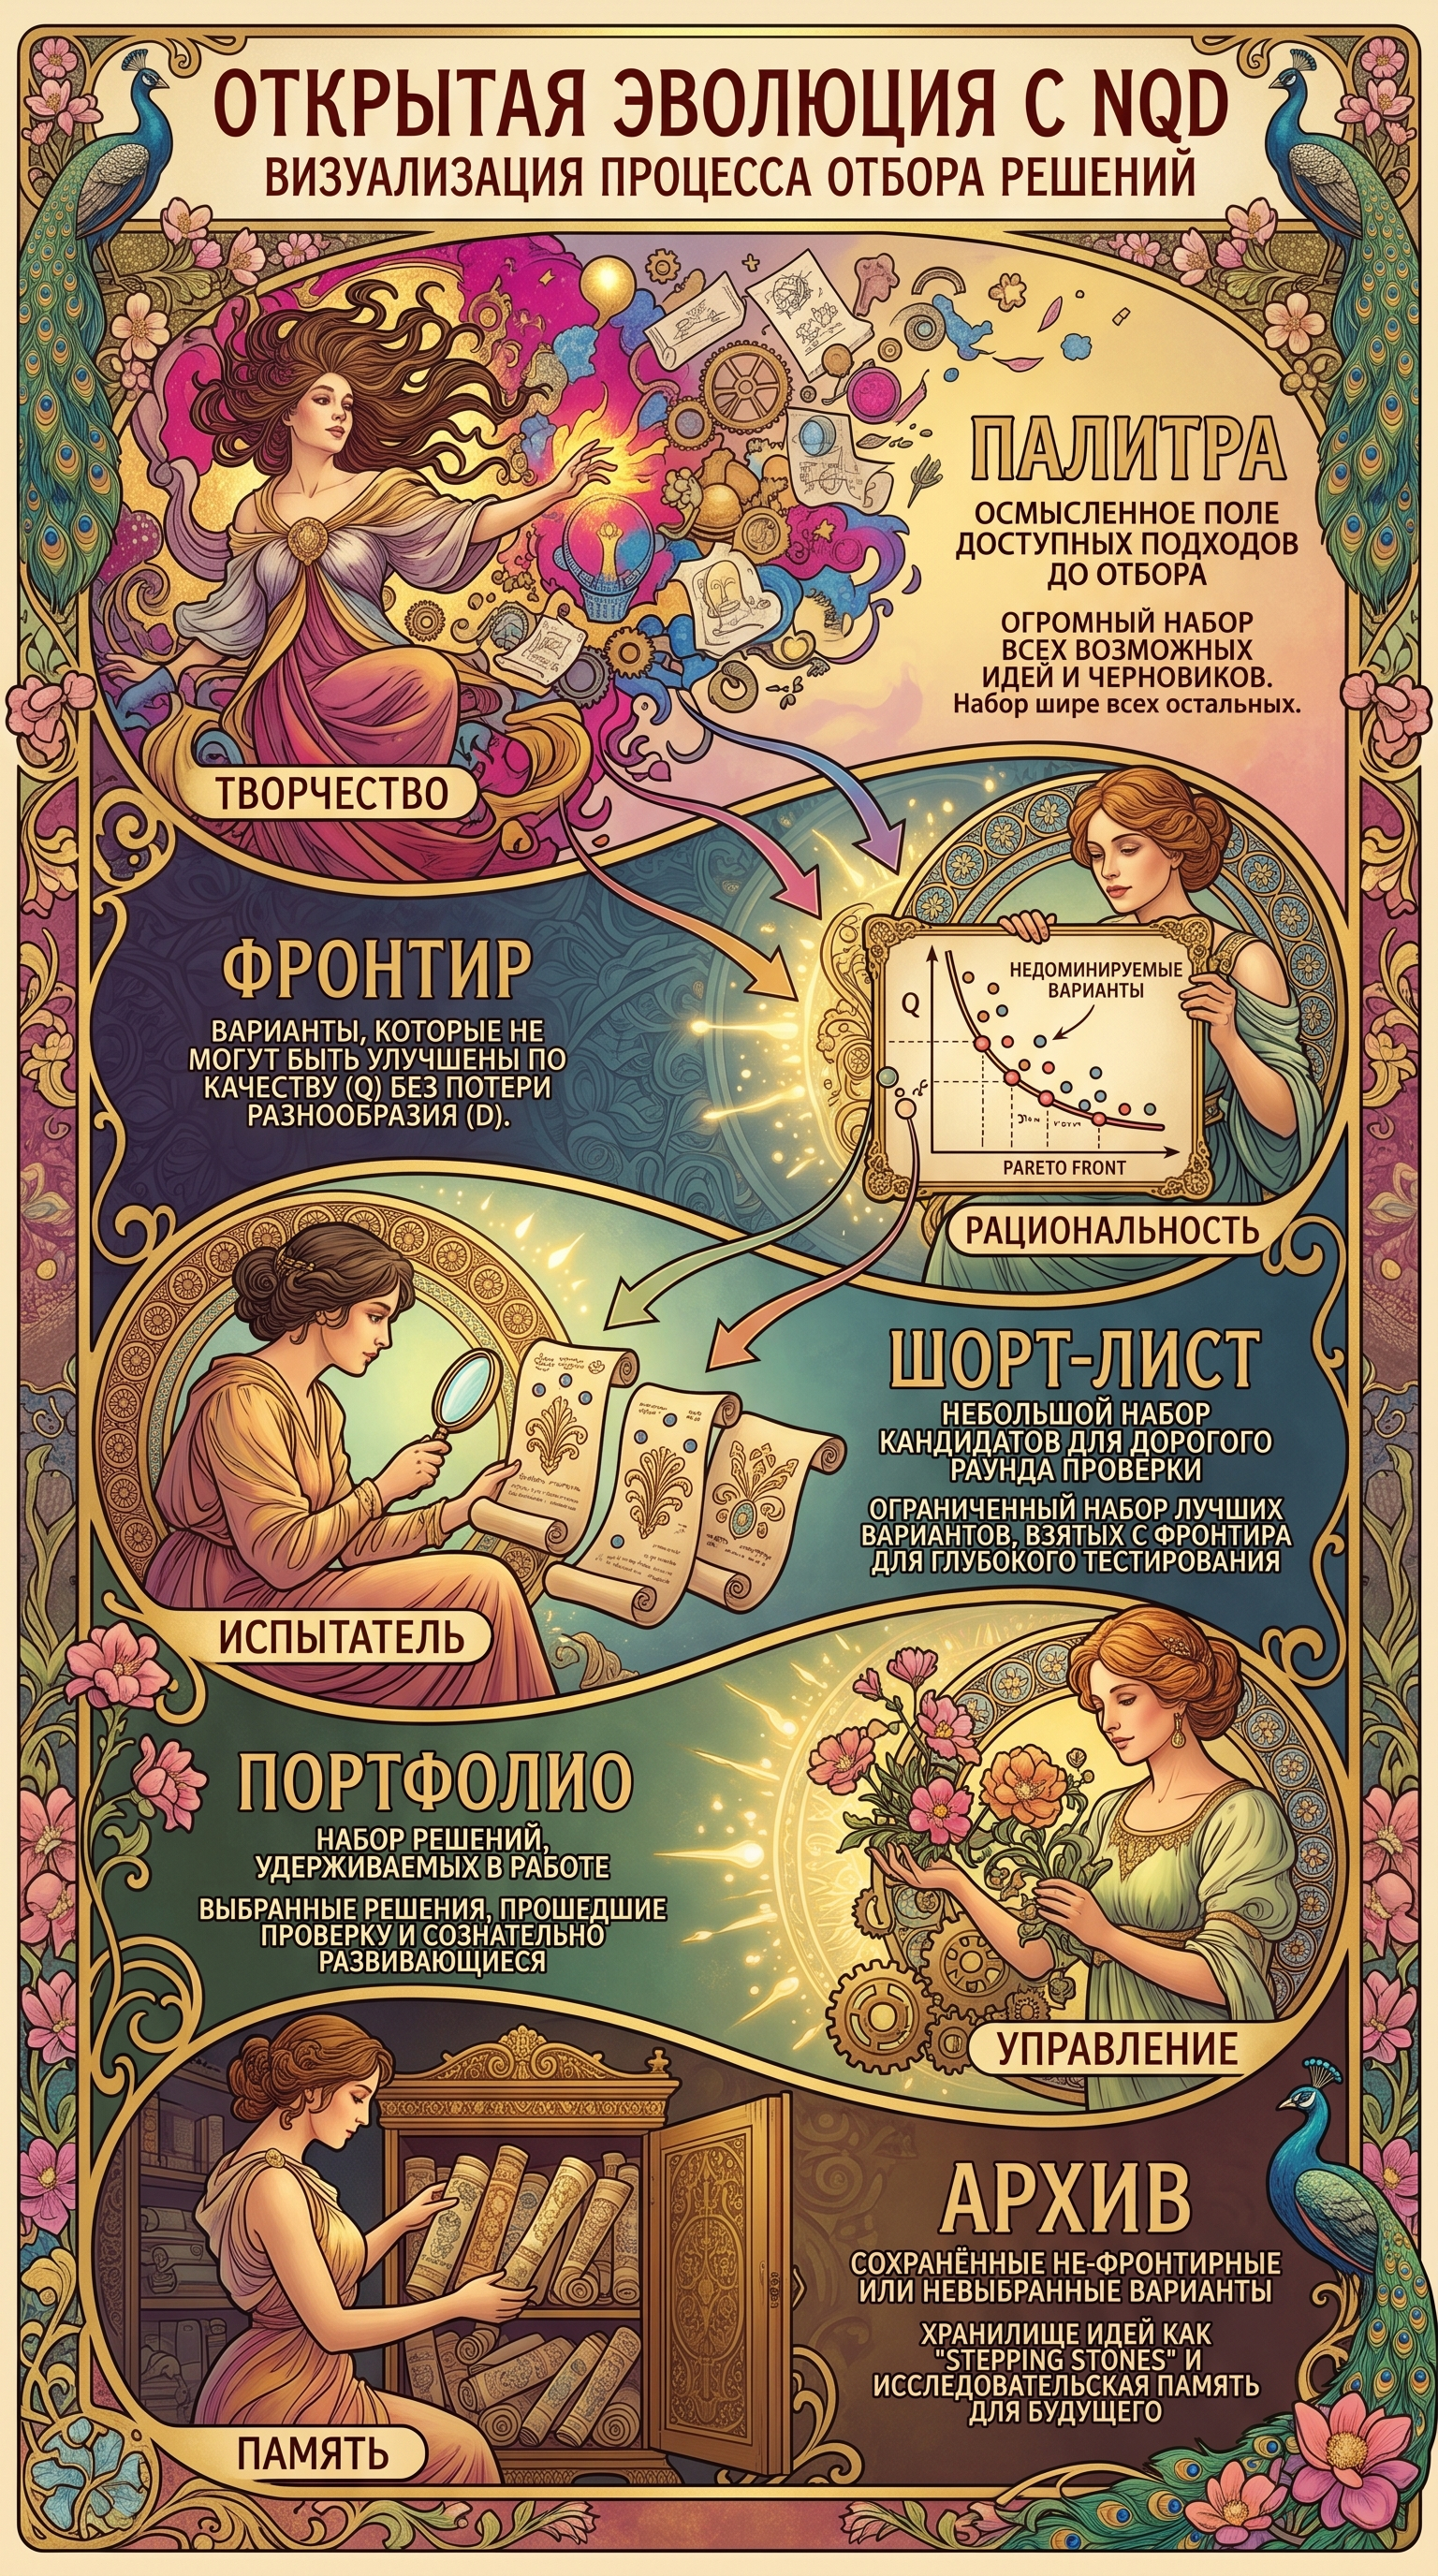
FPF потихоньку завоёвывает место под солнцем, там сегодня уже 320 stars и 52 forks -- https://github.com/ailev/FPF. Пользуйтесь! И он опять подрос: сегодня я закончил апдейт онтологии и терминологии NQD OEE, внёс согласованные правки в 14 паттернов. Это я делаю в порядке усиления материала семинара "Развитие для развитых". И тут же начал новую кампанию, ибо всплыли архитектурные проблемы с самим FPF: математика NQD OEE должна быть общей, но уже вырисовались специализации для поиска SoTA школ/традиций в G.2 и поиска имён в F.18 -- это надо аккуратно причесать. Пока же кампания Q-front уточнила в FPF язык и паттерны работы с множествами решений, вывела их на SoTA:
* palette = всё осмысленное поле доступных подходов до отбора, этот набор шире всех.
* frontier = недоминируемые варианты, отфильтрованные из palette по объявленному Q.
* shortlist = небольшой набор из frontier, который берут в ближайший дорогой раунд проверки.
* portfolio = набор решений, который потом сознательно держат в работе по итогам проверки shortlist.
* archive = сохранённые не-фронтирные или уже невыбранные варианты, которые держат как stepping stones или исследовательскую память.
В субботу-воскресенье десятая ежегодная конференция МИМ -- https://ailev.livejournal.com/1789666.html; у меня там будет два доклада:
* Развитие для развитых в Мастерской инженеров-менеджеров -- это я расскажу про изменения за последний год, когда мы из ШСМ вдруг стали МИМ (это же как раз было решено на прошлогодней конференции, всего год прошёл!). У меня было довольно много написано на эту тему -- кратенько соберу. Из последнего тут -- семинар "Развитие для развитых" и как раз вот это сегодняшнее уточнение онтологии-терминологии в FPF. Ну, и новые краски термина "инженер-менеджер", когда все "просто инженеры" прихватили менеджмент для команд AI-агентов.
* Планы развития First Principles Framework -- тут расскажу подробнее про "планов громадьё" по FPF от 1 февраля 2026, https://ailev.livejournal.com/1788706.html. В феврале я писал тексты про МИМ, в марте разворачивал Codex и даже что-то при этом выполнил из планов, а сейчас машинка работает -- и я намерен планы эти выполнить. В докладе разъясню, почему эти планы именно такие и что будет дальше.
Много разговоров про SPF (second principle framework, модель предметной области) и TPF (third principle framework, модель того, чем занимается конкретное предприятие): сразу становится понятно, что в FPF сейчас именно мета-мета-модель, только нулевые и первые принципы. Фреймворки вторых и третьих принципов каждому надо делать себе самому, ибо предметных областей разных множество, а уж предприятий и подавно много, впрок такое не сделаешь. Ещё ведь надо SoTA отслеживать -- ибо интересует пересадка в AI-агента мышления лучшего современного специалиста по предмету, а не "среднего спеца с рынка". FPF как трансдисциплинарный фреймворк не может заменить дисциплинарный (модель предметной области "как в учебнике"), и уж подавно не может заменить модель предметной области предприятия. Интересно, что многие инженеры-менеджеры уже потихоньку занимаются созданием SPF и TPF -- но мне хорошо понятно, почему у них там трудности. Например, они мыслят о "пересадке мышления" как о пересадке алгоритма мышления, то есть как о чём-то пошаговом. Но методы, в том числе методы мышления, не сводятся к пошаговости. Формат нарративизации методов, как-то учитывающий их неминуемую факторизацию (например, в форме pattern languages), требует понимания, а он больше известен только архитекторам. Разные методы используются в разных bounded contexts и поэтому требуют всё равно "нейтрального английского" для контроля типов в описании этих методов. И так далее. Я потихоньку эти трудности разработки SPF и TPF решу, но это потребует времени:
* плохое понимание: 1) что это вообще такое -- "модель предметной области", "методы работы в предметной области" и 2) как они представимы в формате паттернов. Первое лечится прохождением наших резидентур по рабочему развитию, после чего слова "онтология" и "метод" уже не будут такими пугающими, а задача сопоставления предметов этих предметных областей и методов работы с ними не будет пробоваться решаться "в лоб" как сопоставление похожих терминов (как раз материал семинара по семиотике).
* отсутствие переносимой между разными AI-агентами машинки по написанию паттернов. У меня какой-то пакет паттернов для FPF готовится в Codex App и дополнительно в GPT-5.4 Pro по десятишаговому процессу со множеством проверок, это хоть как-то гарантирует его качество. Чтобы на потоке делать SPF, надо просто использовать эту машинку. Но она у меня пока не в виде продукта. У меня выбор -- или доводить до продукта сам FPF, или заниматься отчуждением машинки по его изготовлению. Я выбираю пока заниматься FPF, чтобы потом фраза "FPF сам себя не напишет" оказалась ложной. Напишет: код его собственного процесса (часть E) будет доработан, но не вот прямо сейчас.
* всё-таки перед занятиями SPF мне надо докрутить сам FPF: надо всё-таки снять часть содержательных вопросов, вроде "а как мы выражаем процессы" (это TGA) и "а как мы выражаем архитектуры" (это ведь тоже в плане). Ну, и доработать до конца эту линию с open-ended evolution, реализовать полностью всё содержание "развития для развитых". Пока вот это в приоритетах.
Постоянно борюсь с превращением архитектурных и процессных документов FPF AI-агентами в Codex в дублирующиеся исторические заметки: на исправление буквы A в один байт обязательно в этом же месте появятся guardrails про "никогда больше!", а также запись "тут было вот так, стало вот так" -- и это на каждом месте. Вместо 1 байта замены идёт вставка 350 байт заметок, после трёх раундов правок файл распухает -- в нём полная история редактирования, рассказанная в каждом конкретном месте и ещё дубль всех запретов в каждом правленном месте. Ну, и fanout -- он неистребим: запись о том, что "мы вот тут поправили, теперь это текущая версия", вносится в десяток файлов, при этом предыдущие записи об этом не стираются. И ещё в ходе правок обязательно будет "о, вот это важный момент -- давай об этом скажем ещё вот тут, тут и тут", и ты с каждой чисткой неожиданно получаешь отрицательный эффект: "что-то я чищу и чищу, сокращаю и сокращаю, а объём документации только увеличивается, несмотря на рапорты агентов, что они там всё поправили". Культура "безопасности" и связанная с этим культура "красного сторно внутри документов". Ничего, мы и это победим.
Уже во многих местах видел про возросшую многозадачность: заряжаешь агентов на выполнение 10 разных проектов (рабочих и не очень), а потом только прислеживаешь. Так сказать, "новое стахановство" (вот, например, об этом пишет Григорий Сапунов -- "Во всём этом богатстве главный челлендж теперь -- находить достаточно непрерывного времени для глубокого обдумывания. Нормальное человеческое внимание -- очень редкий и дорогой ресурс", https://t.me/gonzo_ML/5156. Я этим не занимаюсь, ибо хорошо усвоил уроки операционного менеджмента (они у нас ведь прямо в резидентуре R1 по "распожаризации", потом много раз повторяются, а затем ещё раз повторяются в R10 по системному менеджменту): много проектов в параллель -- это много недоделанного в любой момент времени, "надкушено, но не съедено". А если работают роботы, а ты ждёшь -- почему не запустить ещё одного робота? Не ждёшь, а глубоко думаешь (как раз то время, на нехватку которого начинают повсеместно жаловаться). И дальше все бенефиты прямо по теории ограничений. Там один из ходов -- если у тебя меньше проектов, то ты успеваешь их более глубоко продумать, и у тебя будет потом меньше возвратов из-за ошибок. Время будет абсолютно экономиться за счёт отсутствия rework. Бэклог у меня огромный, но я его не запускаю в дело весь, а стараюсь держать один проект основной full time, и ещё один-два дополнительных (вроде написать посты и почитать новости, подумать над новостями), но не больше. Мои агенты крутят не пяток циклов, а только один цикл в параллель (ну, часто и два -- но это содержательный цикл, из которого выпрыгивают какие-то процессные ошибки, и процессный цикл, где я эти процессные ошибки использую для изменения процесса, защищаюсь от повторения этих ошибок). Да, это контринтуитивно. Да, это моё несправедливое конкурентное преимущество: ровно по Голдратту, который говорил "другие просто не поверят, поэтому не смогут повторить, вы будете самыми быстрыми". Про Голдратта все знают, но его идеям (ОК, не его идеям, а популяризируемым им идеям) не следуют. А я следую.
Мне показали моё двенадцатиминутное видео трёхлетней давности -- и я с удивлением обнаружил у него 137 лайков. Более того, это не видео, а аудио: в видеочасти там просто заставка с моим портретом и заголовок "Зачем публиковать посты", https://www.youtube.com/watch?v=MnCV3sOkVVw. Судя по всему, это видео действительно многим помогло. И комменты там подчёркивают: я устный и я письменный -- это два совершенно разных продукта! А если взять мои руководства, мои посты в блоге, мои семинары, FPF -- это ведь абсолютно разные представления/representations, хотя часто это представления об одном и том же предмете. Устный я обычно много понятней, ибо обращаюсь к кому-то, а письменный -- понятней в руководствах (до которых мало кто доходит), а вот в блоге малопонятный, ибо пишу в основном для себя, в FPF -- вообще непонятный, ибо вроде и пишу уже не совсем я, хотя я автор, и читатели тут -- AI-агенты (но и люди читают, мне сегодня рассказывали, что читать FPF очень интересно, очень меня этим удивили). В видео я в том числе говорю, что на пост из пяти абзацев могу потратить пять часов -- по часу на абзац. Ибо суть поста у меня не в том, чтобы объяснить что-то кому-то проходящему мимо моего "Лабораторного журнала", а чтобы удержать внимание моего собственного мозга на каких-то моментах. Вот и этот мой пост -- он прежде всего для меня. Но я знаю, что, как и в случае с FPF, найдутся люди, которым прочесть эти мои заметки будет интересно. Надеюсь, я их не разочаровал.