FPF Codex Harness: мой мыслительный завод по выпуску эпистем
Мой завод по производству эпистем
Как только ты начинаешь работать с командой каких-то сотрудников (живых или не очень живых), чтобы они тебе помогли сделать что-то содержательное, так у тебя сразу время перестаёт уходить на решение собственно содержательных задач, а ты оказываешься почти всё время занятым организацией процесса. Тебе ведь нужен рабочий процесс (workflow), в котором команда не врёт друг другу, тебе и клиенту, не расползается в ненужные работы, игнорируя нужные, не деградирует по дороге (ибо вчера ещё всё делали, а сегодня то же самое -- нет, не делают! И непонятно, почему!), ошибки отлавливаются рано и возвращаются на исправление, варианты предлагаются и из них выбираются лучшие, и это только начало длинного списка хотелок к хорошему процессу.
Когда мышление становится многошаговым коллективным производством, главным объектом инженерии становится уже не только результат мышления, но и его процесс -- и это более трудная задача. Надо разбираться не в твоей содержательной задаче, а в устройстве коллективного мышления над этой задачей. Как говаривал Илон Маск: сделать ракету очень просто. Вот сделать завод, выпускающий ракету каждые 72 часа -- вот это сложно. Сделать электромобиль -- очень просто. Сделать завод, выпускающий массово и неубыточно электромобили -- вот это сложно. Я делаю завод, который выпускает интересные эпистемы (FPF -- это и сама эпистема, и набор паттернов-эпистем) -- и выпустить интересную эпистему в одиночку не так сложно. Много сложнее сделать завод, который выпускает интересные эпистемы на потоке, быстро и качественно.
Поэтому с работы создания паттернов FPF при помощи LLM в чате одним мной, любимым, я перешёл к работе с коллективом агентов в Codex App, и уже они создают паттерны FPF, а я им только помогаю. Хотя всё это игра слов: копает экскаваторщик или экскаватор? Ну и всегда надо помнить, что за экскаваторщиком стоит его учитель экскаваторного мастерства, а за экскаватором -- экскаваторный завод. И в причинно-следственном смысле они ведь тоже принимают участие в копании! И если вы хотите реально выкопать самую большую яму, то надо не копать, а честно переключаться на создание экскаваторов и обучение экскаваторщиков -- и вот пусть затем они копают — они накопают побольше вас и явно побыстрее, и если вам нужна действительно огромная яма, выигрыш во времени копания окупит добавочное время строительства экскаваторного завода и добавочное время копания.
Мой FPF Codex Harness
У меня с моим FPF Codex Harness получается так, что 2/3 времени сейчас уходит на отладку мультиагентского процесса с четырьмя агентами, и только треть -- на работу над FPF (постановка проблем, проверка решения этих проблем, публикация решений этих проблем). По идее, так и должно быть (все мы станем менеджерами агентских команд). В эту содержательную треть времени я ставлю проблемы и проверяю результаты их решения -- но вот это время я бы хотел расширить, это роль "специалиста по мышлению", редкая сегодня специализация: семантика, эпистемология, логика, системное мышление, мышление по первым принципам -- вот это всё.
Но в отладке мультиагентского процесса я тоже занимаюсь мышлением -- процессом коллективного мышления, ибо если на выходе не результат этого хорошего мышления -- тогда зачем процесс? И вот в этом организационном процессе (да, я тут организатор) я прихватываю работу и из разных других специализаций, удерживая главное: чтобы коллективное мышление было и быстрым по возможности, и качественным (и там ещё много других характеристик, а эти две я привёл, чтобы было понятным: мы тут на Парето-фронте и если свезёт, то можем его как-то двинуть, чтобы одновременно стало и чуть быстрее, и чуть качественнее).
В этой организационной деятельности я и специалист по разработке софта (который всегда отстаёт), и специалист по инженерии (ибо это ж "разработка", неважно, чего), и специалист по менеджменту (у меня команда агентов с известными слабостями в их мышлении -- они всё время "срезают углы", где этого не ждёшь). Я архитектор процесса, который помогает команде преодолеть недостатки не слишком умных LLM, которые внутри агентских оболочек пытаются нанести какую-то непоправимую пользу. Выигрыш такой команде даёт не только новая LLM (её, конечно, тоже ждём), но и архитектура harness-а, административная обвязка handoff-ов, формы "коллективного мышления письмом" (таблички, карточки, записи и т.д.) и дисциплины публикации (точность языка, что там копируется точно, что там суммаризуется, что куда пишется и как раскладывается по файлам и директориям).
Чем моя судьба менеджера легче в мире AI-агентов, чем в мире агентов-людей? Двумя особенностями:
* лидерства нужно много меньше, не надо делать пропитку много месяцев. Это, конечно, не означает того, что агенты вот так сразу завязывают шнурки по моей команде и бегут что-то исполнять. Не всё так просто! Но всё-таки проще, чем с людьми.
* AI-агенты универсальны. Там, где мне нужно пять разных специалистов, "единственных в своём роде", вполне справляется один и тот же AI-агент. Поэтому у меня их на процессе всего двое на самые разные темы (от математики до менеджмента, от физики до machine learning): Executor и Reviewer. И это существенно уменьшает проблемы на координацию множества разных специалистов, надо скоординировать всего двоих (ну, и ещё парочку, которые так же многопрофильно рулят процессом).
Моя борьба с частыми ошибками агентов -- и живых, и не очень
Какие у меня самые частые ошибки агентов? С чем приходится бороться? Ох, этих ошибок много: у всех этих ошибок один набор причин: плохая память, рассеянное внимание/несобранность, а также неумение работать с cut/paste и искажениями при переписывании, и ещё там куча предвзятостей/biases от текущей средней по планете (а не лучшей!) производственной культуры, на которой обучались LLM в текущих AI-агентах. Понятно, что потихоньку это всё будет преодолеваться (с какой-нибудь o3 не сравнить), но пока ситуация не так хороша, как хотелось бы. Вот только несколько проблем (они, повторюсь, будут и у людей):
* fanout -- это самое страшное зло. На каждый чих заводится отдельная карточка или поле, потом это всё разносится по уже имеющимся карточкам и полям, затем умножается на число шагов -- и всё. Скажем, на каждый документ ставится номер текущего шага, "на всякий случай". Если у тебя 100 документов, и ты шагнул -- всё, ты попал. Проверка покажет, что "шагать нельзя, у тебя не совпадает номер на 5 документах" (а что ещё на 95 документах за очень большое время всё поправили -- об этом умолчат). Надо регулярно делать рефакторинг.
* пересказы со сжатием. В паттернах FPF это есть: делается в каком-то месте summary документа, потом от summary отрезается ссылка на основной текст, затем summary начинает жить своей жизнью как источник истины. Лечится повторением заклинаний "by reference и явное требование обязательно прочесть исходный текст" или "exactly by value". Но как только вы заткнёте одно такое место, вам обязательно перескажут что-то другое, эта страсть "кратенько переписать", а не сделать "cut/paste", у нейросетей неистребима. Скажем, переписываем findings внешнего reviewer -- их там 25, они перенумерованы. Делаем реестр, чтобы не потерять и чеклист, чтобы не забыть проверить. Считаем -- в реестре их уже 13! Почему так? "Объединил, получилось компактнее". Это не выдуманный случай, это реальный случай -- и такое, повторюсь, как-то подавить полностью не получается.
* подменить задачу на более простую и лёгкую. Лечится очень трудно: надо подробно прописывать задачу, требовать заполнения каких-нибудь карточек и отметки в чеклистах с указанием обоснований, чтобы уж совсем нельзя было отделаться „я тебя не так понял: ты попросил учесть XYZ, я вписал строчку «учитывайте XYZ», формально всё ведь правильно -- просьба выполнена! Ты же сказал учесть, а не поработать над учётом!”. Тут было долгое обучение LLM: отвечать минимально необходимым действием, часто нулевым (ну вот точно как неоднократно обсуждалось в agile: минимально достаточная архитектура читается как "можно архитектуру опустить", ибо "минимальная -- это когда её нет вообще"). Вот это очень трудно преодолеть: добиться ответа разумным действием, а не "минимальной отмазкой".
* неточный язык, причём "айтишный матерный" ("Процесс для производства AI-агентами текстов, которые читать противно, но возразить нечего", https://ailev.livejournal.com/1796405.html). Owners, surfaces, landings, burdens -- как у Эллочки-людоедки с её словарём из 30 слов -- "2. Хо-хо! (Выражает, в зависимости от обстоятельств, иронию, удивление, восторг, ненависть, радость, презрение и удовлетворённость). 17. Ого! (Ирония, удивление, восторг, ненависть, радость, презрение и удовлетворённость).".
* при малейшей возможности 99.9% ресурса (токенов) уходит на решение административных/логистических задач (вроде "а теперь давай оформим переход на следующий шаг"), 0.1% -- на размышления по содержанию ("а теперь давай сделаем одну маленькую правку на пару слов"). Это тоже неистребимо: "бюрократия сначала, всё остальное -- потом". Правила бюрократии при этом читаются так, чтобы и бюрократию тоже не делать, то есть правила не соблюдать. "Недостаточно жёстко сказано" -- любимый ответ на вопрос "почему не выполнил правило".
* исправлять ошибки, но не искоренять причины ошибки в процессных документах. Искоренять причины ошибки в процессных документах текущего варианта процесса, но не общего процесса, по которому был специализирован текущий вариант. Искоренять причины ошибки в общих документах процесса, но прятать это так, что при исполнении документ не окажется в контексте, не будет вовремя прочитан. Искоренять причины ошибки в общих документах процесса и не прятать их, но описывать текстом, который вполне допускает игнорировать правило как жёсткое. В итоге -- все ошибки имеют тенденцию повторяться на каждом шаге процесса, как их не искореняй.
* плодить tacit knowledge при любой возможности. Если надо что-то сделать, и не очень понятно, как оформлять или даже что делать, то сразу в рассуждениях появляется "посмотрю на то, как мы это делали в последний раз где-то тут рядом, чтобы не изобретать" -- а ведь это явный красный флажок на дырку в процессных документах. И если там рядом какая-то непродуманная ошибка, она быстро копируется. И если ошибки не было, то после переноса в текущий контекст вероятность ошибки высока -- ибо не будет явной адаптации
* взять задачу, которую надо выполнить с N объектами, и там сделать M действий (например, 10 паттернов и 20 проверок для каждого) -- и выполнить это "в уме, одним проходом, за пару минут -- оценивая результат на глазок". Вот эти "пройтись двойным циклом" -- прямо-таки на текущем поколении технологий задача-неберучка, если не программировать этот цикл на каком-то Питоне.
* ... и такого много, тут явно коротким постом не отделаешься. Вообще, у мультиагентных систем много причин поломаться (вот обзор годичной давности, когда о сегодняшних IWE можно было только мечтать, но фундаментальные причины не изменились -- https://arxiv.org/abs/2503.13657).
Как обустроить организацию из AI-агентов
Я как инженер-менеджер, конечно, не одинок -- только отличаюсь тем, что хорошо осознаю происходящее и хорошо к этому подготовлен. Но у разработчиков по всему миру идёт революция и неразбериха, так что наши инженеры-менеджеры из МИМ получают "несправедливое преимущество". Вот, например, пост Юрия Геронимуса на английском и с картинкой о том, что все мы там будем -- инженерами-менеджерами (https://www.linkedin.com/feed/update/urn:li:activity:7445183856158228480/). Вот посмотрите ещё, что он пишет у нас в чате поддержки программы рабочего развития (https://t.me/systemsthinking_course/36093): "у нас в компании официально запретили всем программистам писать код (это я не шучу), так что они все сразу стали инженерами-менеджерами, как предсказывал Анатолий. Также практически все перестали писать код даже агентами, а стали писать агентами своих агентов = все перешли от R&D к созданию организаций R&D опять же, как предсказывал Анатолий". Да, предсказывал. Что удивительно, так это короткое время, за которое сбылись мои предсказания. И потом там в чате ещё "Дальше долгий рассказ от меня по материалам МИМ что вот есть оргдизайн, он такой же как дизайн систем, но вот слова другие, и тебе надо выбрать метод, или и пиши ADR, у людей шок. Ну вот прямо каждый первый". Мой комментарий в чате -- "я не перевожу это прямо на менеджерский язык. В голове у меня менеджмент, но я удерживаю язык программной разработки, ибо LLM натренированы именно на него — в том числе это же и сленг "кровавого энтерпрайза". То есть там полно owners (какие-то файлы, как единственные источники правды) и surfaces (это зонтик для API, файлов и всего того, что "торчит наружу"), а ещё много fanout. Я это не правлю, но иногда прохожусь для уточнения языка (я писал тут уже, что это "айтишный матерный", где вместо слов местоимения и междометия, как в мате — а для процесса надо всё-таки поточнее)."
Ручеёк работ "как нам обустроить организацию из AI-агентов" растёт. Скажем, https://github.com/DenisSergeevitch/repo-task-proof-loop. По популярности этот проект оказался сопоставим с FPF. Я удивлён: у автора есть канал https://t.me/denissexy на 130 тыс. подписчиков, но у его репозитория со skills общего назначения форков даже меньше, чем у FPF, а звёзд всего вдвое больше: по состоянию на сегодня у репозитория skills 609 звёзд и 39 forks, у моего FPF (https://github.com/ailev/FPF) — 293 звёзд и 51 forks. С другой стороны, я спросил у своих агентов в Codex -- надо ли нам оттуда что-то взять в наш FPF процесс, и ответ был: "нет, у нас много оттуда или реализовано, или реализовано лучше, хотя можно взять кое-какую бюрократию по оформлению результатов проверок, с некоторой вероятностью она поможет". Ну ладно, всех этих наборов skills и ещё plugins как единиц пакетирования skills и всякого инструментария и прочих файлов к ним в Codex -- их уже много.
Есть и очень интересные ходы: вот ход по установке FPF в виде пакета skills для мультиагентной среды как FPF-агента от Виталия Покровского -- https://github.com/pokrovskiyv/FPF-agent (и подробный текст в https://systemsworld.club/t/razrabatyvaem-agentnyj-pajplajn-dlya-fpf/37890). Что интересно, так там ещё и какие-никакие бенчмарки (из моих любимых -- vanilla LLM против LLM с FPF, но при этом ещё и для трёх LLM разной умности). Осторожный вывод там в том, что для некоторых простых вопросов этот FPF-агент работает даже с не очень умными LLM, хотя умные LLM очевидно выигрывают. Этот синтез многоагентности и FPF мне кажется очень перспективным. Попробуйте!
При этом линия плагинов со skills или чем-то таким, что трудно упаковывается в skills (например, FPF трудно упаковывается в skills) -- она тоже быстро развивается. Как всегда, пластинки развиваются быстрее патефонов, а эти IWE+плагины -- как раз патефон плюс пластинки, и рынок пластинок может оказаться более ёмким, чем рынок патефонов.
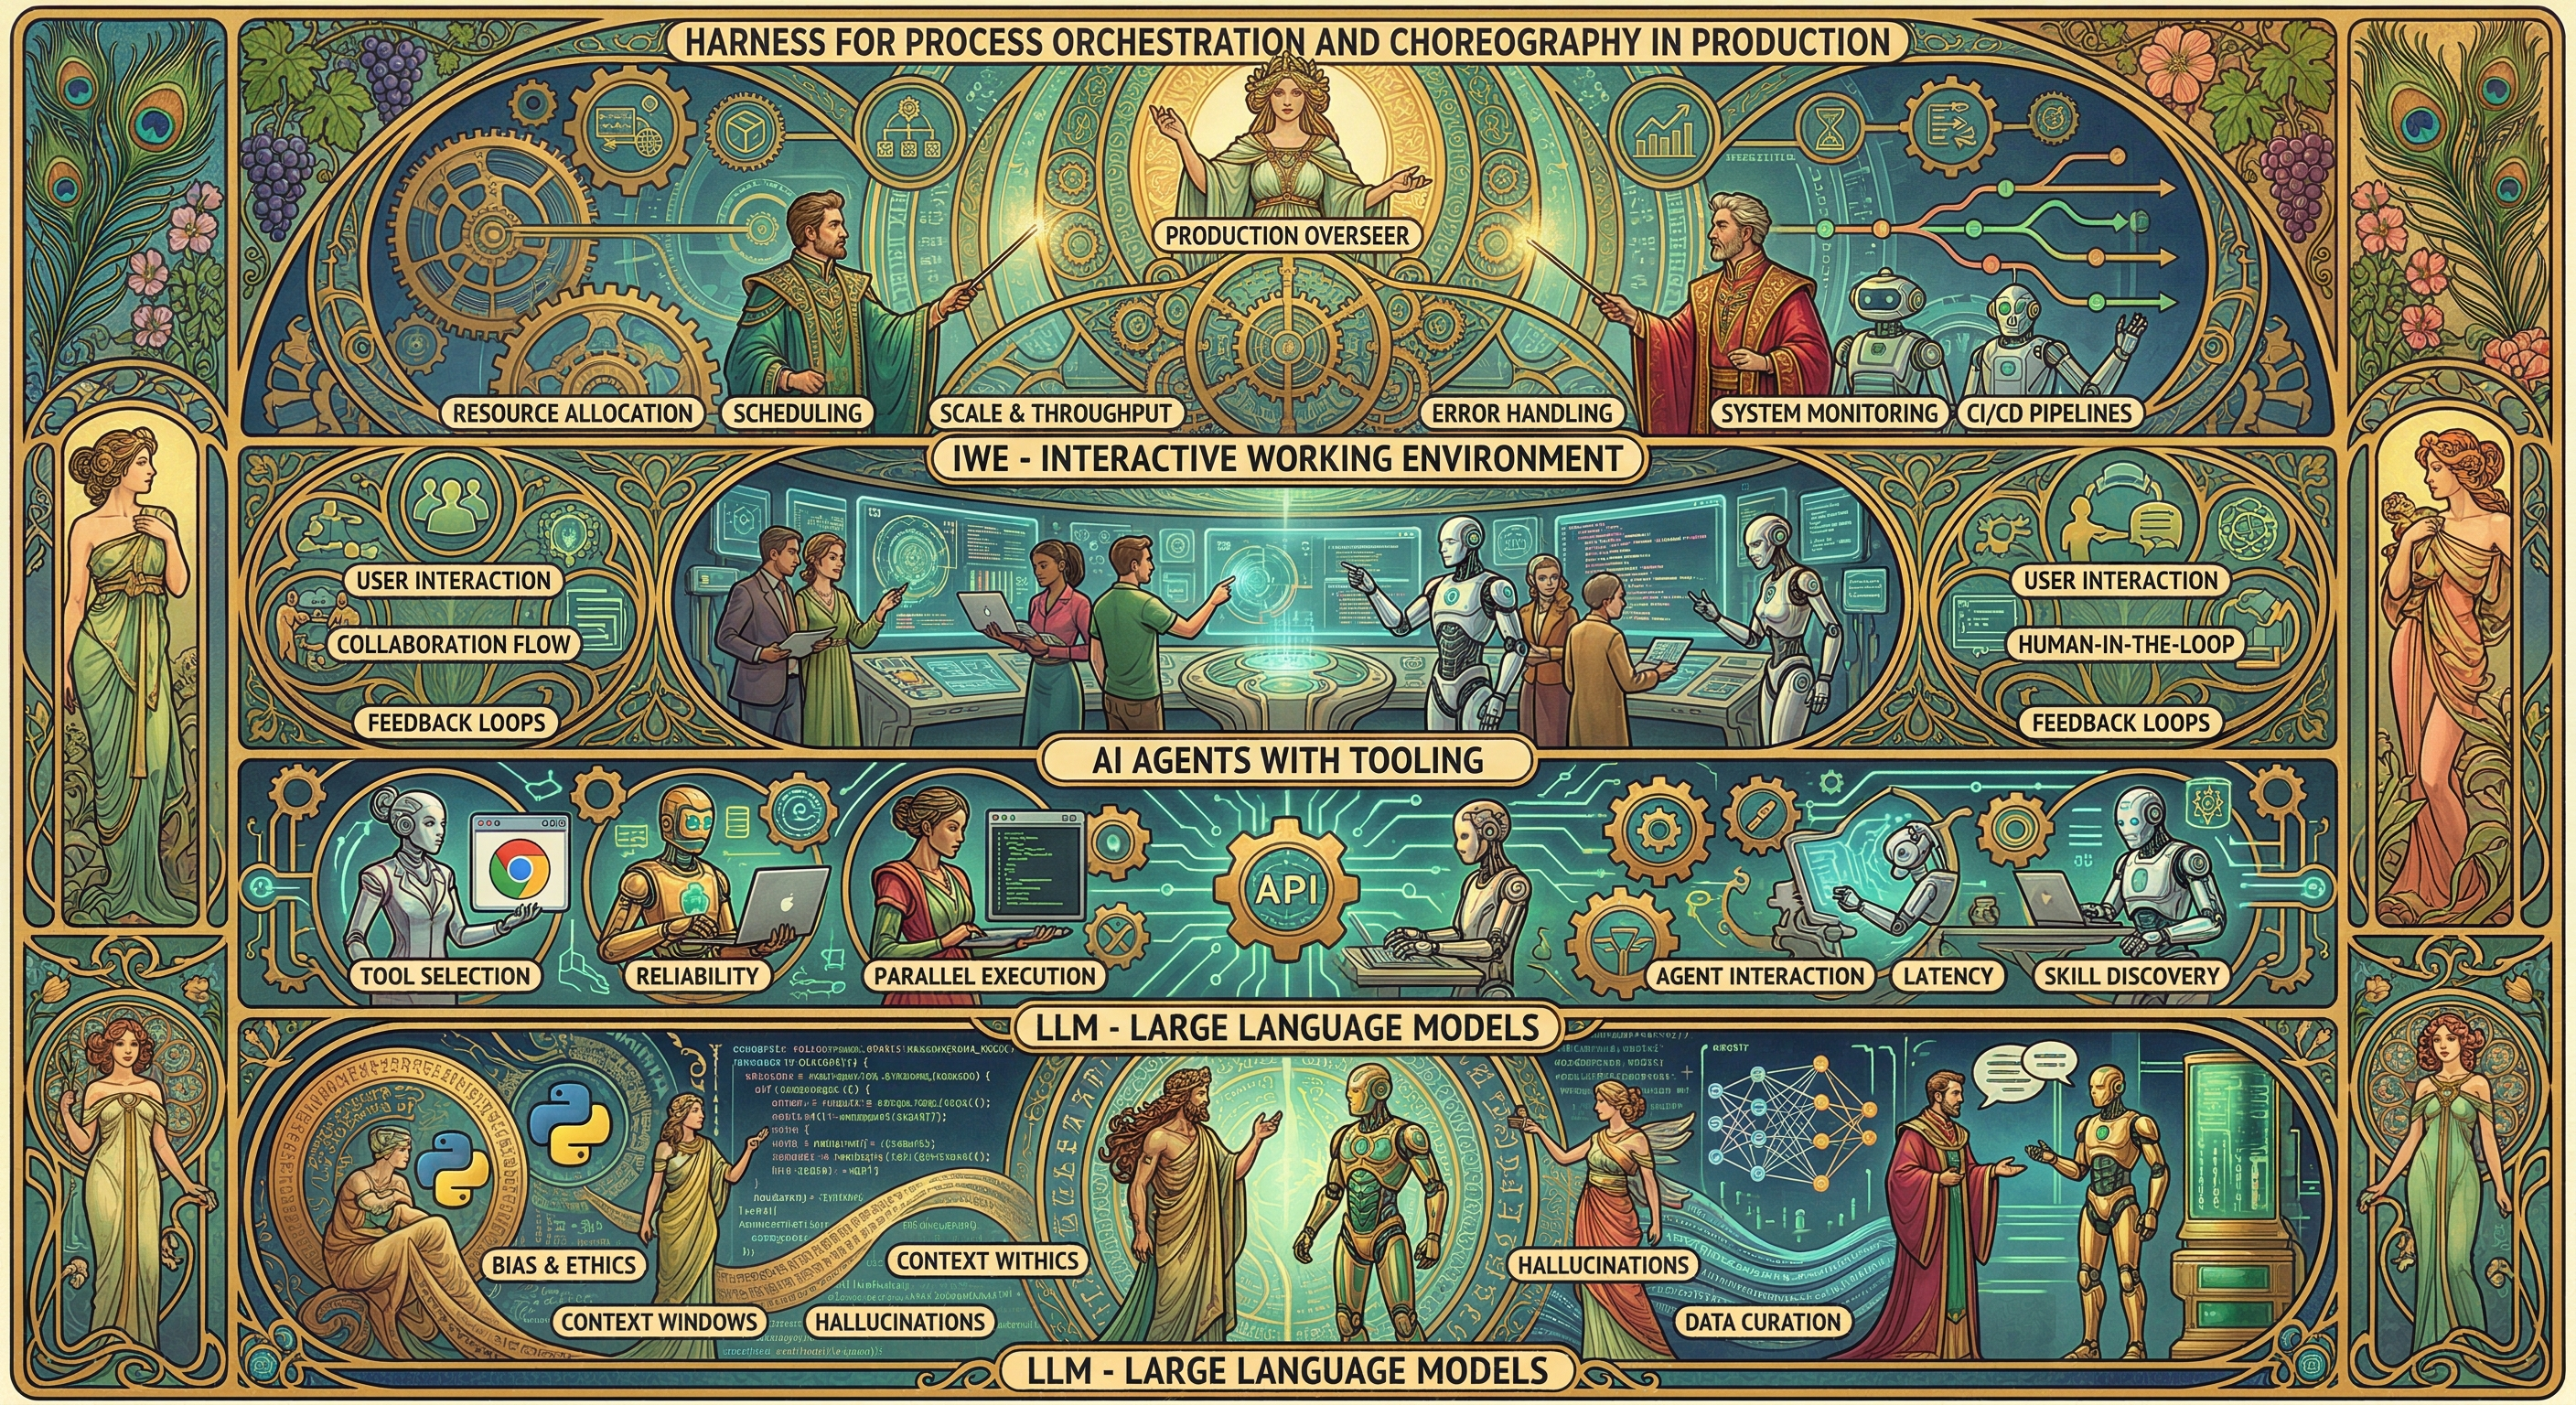
Архитектура слоёв: LLM -- AI-агенты с инструментами -- IWE -- harness оркестрации/хореографии агентов
В части IWE и мультиагентности в них через полгода уже будет существенно по-другому, поскольку провайдеры всех IWE и разработчики skills активно пробуют разные ходы -- и с каждой новой моделью LLM и каждой новой мультиагентной IWE к ним (вроде Cursor или Codex) жизнь будет полегче. Литературы по созданию IWE (interactive working environment) и втягиванию в них больших кусков harness engineering всё больше и больше. Например, свеженькая "Building Effective AI Coding Agents for the Terminal: Scaffolding, Harness, Context Engineering, and Lessons Learned", https://arxiv.org/abs/2603.05344. Ну или обсуждаются отдельные решения: только что у всех появилось "динамическое сжатие контекста" (и алгоритмы там постоянно совершенствуются), но вот и за RAG взялись: https://github.com/VectifyAI/PageIndex (от https://pageindex.ai/). Идея в том, что искать по большому документу надо с помощью LLM ("как искал бы человек"), и это вроде как в конечном итоге оказывается эффективнее поиска с RAG. Там очень быстро растёт популярность репозитория, посмотрим, с какой скоростью кто-то из крупных и богатых поставщиков IWE купит эту команду.
"Крутыши" это тоже отражают. Скажем, вышел сегодня Cursor 3.0 (https://cursor.com/blog/cursor-3) -- и там главные изменения в том, что редактирование кода становится не главным, а главным становится управление работой агентов. Собственно, Codex App такой же: там можно смотреть на чаты с агентами, а редактор кода вообще внешний (у меня это Sublime Text). IWE становится не "редактором", а "панелью управления командной работой", это теперь инструмент не разработчика, а инструмент platform engineer -- и мы помним, что там было с DevOps и как появился platform engineer. У меня мой агент-организатор так и называется, Platform Engineer. Мой опыт показывает, что Platform Engineers плохо осознают, что им также надо организовывать работу команд на своей платформе -- это чистый менеджмент инженерного процесса. Они понимают так, что им достаточно организовать "платформу" как кучу софта. Но нет, недостаточно -- мы, например, это подробно обсуждали на прошлой конференции, когда рекомендовали команде DevOps не курсы проводить для разработчиков о том, как работать на их платформе, а сразу изучаемое на курсах утвердить регламентами работы -- и дальше уже выбирать, курсы или сами всё выучат под угрозой увольнения за несоблюдение регламентов. И вот сейчас эта проблема "новых DevOps, platform engineers, managers" -- на каждом первом рабочем месте у программистов, а дальше и у "железячников", а дальше вообще у всех. И это всё -- быстро, рок-н-ролл двигается быстро. На следующем шагу надо выстраивать взаимодействие с контрагентами, строить supply chains в разработке, формировать extended enterprise. Всё знакомо.
Полегче с выходом новых IWE как "универсальных платформ разработки" будет не вся жизнь. Часть проблем заметно ослабнет с новыми моделями, новыми AI-агентами на этих агентах и новыми IWE прямо "из коробки". Я прописывал эту трёхуровневую архитектуру полтора месяца назад в "Рок-н-ролл сдвигается с AI-агентов на универсальные приложения (на примере Codex)", https://ailev.livejournal.com/1790893.html. За прошедшие полтора месяца эти IWE появились уже у каждого первого, и рок-н-ролл сдвинулся с универсальных IWE на организацию в них многоагентных процессов: не "вообще многоагентной работы" (скажем, как в операционной системе -- поддерживается многозадачность "вообще"), а конкретной -- ведущей к целевому пользовательскому результату. И вот тут мы начинаем организовывать агентов, уже поддержанных IWE, это новая полянка. Проблемы этой полянки отнюдь не все вылечиваются ростом умности LLM, ростом качества инструментальной инфраструктуры этих LLM в AI-агентах и ростом качества интерфейса пользователя и средств координации AI-агентов в IWE. Плохое удержание инструкций на длинном горизонте, деградация внимания по мере расширения фронта работ, искажения при переписывании, слабая работа с большими контекстами -- это будет лечиться в новых LLM+AI-агентах+IWE с каждой новой версией каждого слоя (они более-менее независимые, например, есть даже IWE Cloud Code с Codex agent и выбором разных LLM -- https://github.com/openai/codex-plugin-cc).
Но вот fanout, дрейф содержания при неизбежном его копировании из документа в документ, подмена задачи на более дешёвую, захват ресурса бесплодным администрированием -- не уйдут, это же "корпоративная культура", её софтом не вылечишь. Это архитектурные проблемы для любой многошаговой организационной системы с межагентским делегированием (обещания-выполнения-извини-не-так-понял-переделаю), в том числе это и неистребимые проблемы для человеческой организации. Поэтому лечить их надо не более умными LLM и более памятливыми IWE, а изменениями архитектуры процесса и поддерживающим архитектуру процесса софтом, и коррекция там идёт по линии корпоративной культуры, надо корректировать культурный bias обученных на "процессной попсе" LLM и поддерживающих "процессную попсу" AI-агентов и IWE. Другой системный уровень -- другой язык, другие проблемы от других межуровневых конфликтов. Это неизбежно. В наших руководствах по системному мышлению это подробно объясняется, поэтому не буду останавливаться на теории вопроса -- но теория есть.
Поэтому не просто ждём новых IWE и новых skills, а участвуем в этой гонке, занимаемся бесконечным развитием: делаем собственный мультиагентский процесс руками, самостоятельно, а потом присматриваем за ним. Как всегда в программировании и в налаживании оргпроцессов (одной природы деятельность, хотя и на разных субстратах) работа "руками" очень долго не работает. И софт, и процесс надо очень долго отлаживать. Но если архитектура ОК и достаточно долго отлаживаешься -- и софт, и процесс начинают удивлять, отрабатывая корректно весьма нетривиальные ситуации. А потом? А потом смотрим на evolvability (скорость адаптации к новым задачам -- важнейший параметр! Архитектурные характеристики рулят!), для этого выплачиваем архитектурный/технический долг более чем регулярно. Нельзя вот так взять, сделать -- и расслабиться. Нет, надо поливать, пропалывать, истреблять насекомых, тьфу, bugs. Выращивать, развивать всяко. И дальше пожинать плоды.
Тут, конечно, тоже много соблазнов. Например, я провожу первый проход со мной в диалоге, а затем требую записать чистый маршрут в общие документы процесса -- это же классический case management (в противоположность процессному и проектному управлению, в руководстве по системному менеджменту это подробно разбирается). То есть первый раз идём по процессу "вручную", планируясь на лету, всё кладём в case file. Затем оглядываемся и смотрим, есть ли там что-то, что может пригодиться потом -- какая-то общность маршрута. И назначаем это community template. И вот, пожалуйста: https://arxiv.org/abs/2602.11782 это переоткрывает для агентов. Там говорится о том, что сначала AI-агент выполняет задачу, а потом делает процессное summary, чтобы получить workflow -- тот же case management с community templates. Люди из тусовки исследователей AI-агентов открывают азы case managementa, ибо они ничего не знают про то, как это обустроено в жизни агентов-людей, поэтому считают, что эта идея вполне достойна статьи!
Демонстрирую не только результаты platform engineering, но и содержательные результаты: обновление FPF в части NQD OEE
И демонстрировать не только результаты platform engineering (чем это всё и является в классике инженерии), но и результаты процесса, поддержанного этой платформой -- выпуск хоть чего-нибудь достойного. Иначе всё это суета и тщета: хорошо работающие заводы, выпускающие никому не нужную продукцию.
Стоит ли это делать почти full time, как я сейчас? Стоит. Одна из интереснейших линий развития FPF -- это поддержка NQD OEE в сочетании с BLP (смотрите материалы моих двух семинаров, там про это подробненько -- novelty-quality-diversity, open-ended evolution, bitter lesson preference). И это для меня продолжение работы по организации процесса разработки -- это же как раз теория мышления по поводу разработки! Это не другая тема поста, это развитие той же темы!
С этим NQD OEE в сочетании с BLP я делаю три усиления:
* гармонизацию тезиса no free lunch theorem "победит частный метод, универсальные методы невозможны теоретически" с горьким уроком, где признаётся, что в конечном итоге надо делать ставку на масштабируемые решения для как можно более универсальных агентов, которых можно тупо заливать бюджетом -- и получать решение в рамках NQD OEE. Решение там в том, что важна скорость адаптации агента к новой предметной области, ибо адаптироваться-то все могут, но с разной скоростью, и вот эта скорость адаптации оказывается важнее, чем статически рассматриваемая "универсальность". Это заодно и линия рассуждений Шолле про то, что такое интеллект, и вообще отдельная линия SoTA
* интересная мысль, что если мы сюда забираем NQD и stepping stones, то нас интересует скорость адаптации в том числе и в тех предметных областях, которые не входят в число доступных человеку (можно даже не обсуждать, каких именно, и "недоступных человеку" понимать как человеку с инструментами или только без инструментов, а также человек один или в команде и всё дальше по линии размытия предмета разговора). Тут вопрос не столько даже о superhuman, сколько о выгодности прохода на stepping stones, где раньше не бывала нога, тьфу, мозга человека. Вот AGI в сторону ASI должны идти туда, ибо делать то, что могут уже делать люди -- не комильфо, надо идти дальше.
* а ещё под этим всем нужна онтология получше, ибо NQD выглядит только как "характеристики одного объекта", но это глубоко не так: это три пространства характеристик для трёх разных объектов (пространство характеристик решения для novelty, пространство характеристик сравнения решений для quality и пространство характеристик портфеля для diversity). И нужна какая-то математика подо всем этим, "геометрия многих пространств". Это мы берём из свежей работы Виталия Ванчурина (https://arxiv.org/abs/2603.15198), в которой показана общая математика для многоуровневой эволюции как обучения: там и вид, и популяция, и отдельный организм: каждый из этих объектов живёт в своём горизонте времени, в своём пространстве характеристик, между ними -- ренормализация. В этой работе есть интересный для нас математический каркас, который мы пробуем адаптировать под NQD OEE в FPF, чтобы наши рассуждения про NQD и OEE дальше склеивались этой математикой во что-то концептуально согласованное.
В первых же двух шагах сразу были затронуты A.13, B.4, B.4.1, B.5.2.0, A.15, C.19.1, C.22, C.22.1 (он вообще новый), C.24, E.16, G.5, G.9. Понятно, что в предыдущем "ручном" режиме я бы с этой массовой правкой не справился. Это уже в FPF, выложено на GitHub, можно смотреть.
В третьем шаге были затронуты A.0, F.18, A.6.P, C.18, C.19, B.5.2.1, C.11, C.24, G.2, G.5, G.10, A.18, A.19, C.17 -- и доведены до проекта правок в паттерны. Конечно, это не только "математика из Ванчурина", там много правок терминологии и онтологии NQD OEE в целом. Все эти длинные списки паттернов с их текущим состоянием правок удерживаются в памяти FPF Codex harness, равно как и состояние незаконченного workstream по семиотике. В голове такого я бы точно не удержал. Но теперь -- всё OK, это удерживается в экзокортексе, вовне головы.
Но оказалось, что нам ещё для принятия решений в open-ended evolution не хватает паттернов принятия решений согласно теории принятия решений! В FPF есть "заглушка" для паттерна C.11 -- это как раз он, "строчка в заголовке есть, паттерна ещё нет". Поэтому вся эта процессная механика была развёрнута на создание этого паттерна и изменений в ряд других паттернов. И для этого была открыта отдельная кампания, а кампания третьего шага была приостановлена. Сейчас там взят intake из интеллект-стека (да, он есть в .md, https://github.com/aisystant/docs/blob/main/docs/ru/research/intellect-stack/rationality/decision-making-theories.md), это 2023 год. Так что сделан аудит, а теперь делается DRR (decision rationale record) для этой кампании, затем будет внешний review этого DRR, многопроходное написание проекта паттерна и так далее -- потом он будет объединён с драфтами третьего шага по NQD OEE и влит в монолит. У меня до этой теории принятия решений в FPF руки не доходили целый год, а теперь вот -- руки дошли, и я счастлив, что это не совсем мои собственные руки.
Конечно, без управления конфигурацией и чёткого планового процесса это всё было бы невозможно. А так -- сложнейшие задачи концептуального синтеза множества теорий становятся а) решаемыми, б) решаемыми быстро. Затраты времени на организацию процесса -- окупаются, врукопашную такие операции было невероятно трудно и долго проводить, поэтому я вообще откладывал их проведение на "когда-нибудь". В текущем процессе много стадий, на которых контролировалось, что все изменения опираются на SoTA, что там реализуются не просто какие-то произвольные идеи, которые пришли мне в голову. В целом там были входной диалог с постановкой задачи и идеями, аудит SoTA идей, подготовка DRR (design rationale record) с планом улучшений FPF, внешнее review DRR, правка паттернов, внешнее review обновлённых паттернов в их связке и в согласовании с текстом FPF -- и публикация результата в FPF. Конечно, с большим количеством проверяемых подшагов в каждом этом макрошаге.
Вот моя продукция как результат всей этой организации процесса не совсем человеческого мышления: First Principles Framework как "операционная система мышления для смешанных команд AI и людей" -- там встроены паттерны по первым двум пунктам из описанных в начале поста: (https://github.com/ailev/FPF). Берите, пользуйтесь.