lytdybr
Ian Glendinning пригласил меня поучаствовать в обсуждении FEP (free energy principle), на который напали за его нефальсифицируемость (https://www.linkedin.com/posts/madhur-mangalam-1370271b0_pdf-the-exit-manual-how-to-leave-the-free-activity-7400417769978097664-HQKC), в участниках там сплошь профессура. Но они не эпистемологи. ОК, грузим FPF и просим ответа, его скромных возможностей уже хватает. И ответ есть (и даже более пространный, и в чёткой привязке к "principle to work" примеру графа трансдукций), rough decomposition:
1. Mathematics / logic / probability: you can think of this as a formal substrate: measure theory, stochastic processes, variational Bayes, information geometry, etc. Not falsifiable as such. It’s a particular representation scheme for certain non-equilibrium steady-state systems with Markov blankets: “you can rewrite their dynamics as minimization of variational free energy / ELBO for some generative model.” FEP is closer to a formalism / representation, not an extra chunk of physics glued on top.
2. Process theories built under FEP (predictive coding, active inference, etc.): kind of generative model, form of recognition dynamics, precision update rules, etc. They absolutely can be falsified, compared, outperformed.
3. Concrete models and parameterizations: specific task, specific architecture, specific parameter priors → standard cognitive / systems modelling. This is where you plug in data, fit, cross-validate, and decide whether this instance of “FEP-style” modelling is any good.
Тут полинтернета обсуждает статью про Verbalized Sampling (была недавно работа про "отсутствие творчества в LLM" про "две метафоры времени, и всё", тема ведь волнует), https://simonucl.notion.site/verbalized-sampling (это пост в блоге, там ссылка и на папир). То же "отсутствие творчества": пять раз просишь выдать шутку про кофе, получаешь в ответ одну и ту же шутку. Секрет: попросить выдать сразу пять шуток с распределением вероятностей, diversity. Вау, появляется творчество, а впридачу тема для хорошо цитируемой статьи! В FPF это всё "из коробки", там уже давно встроено NQD из open-endedness, ровно с теми же целями. Но без статьи и блогпоста. И там ещё вам и выберут лучшую шутку на Парето-фронте по разным осям. Берём промпт: "Выдай мне лучшую шутку про кофе, выбранную по NQD из части G, предложи три характеристики и разнообразие из пяти вариантов" (да, так коротко, причём в том же чате, в котором отвечалось на предыдущий вопрос, что задало специфику), на выходе через 31 секунду (GPT-5.1 Thinking, ибо надёжность не требуется) имеем не просто шутку из статьи, но ещё и "шутку в контексте эпистемологического разговора", и с необходимым разнообразием: 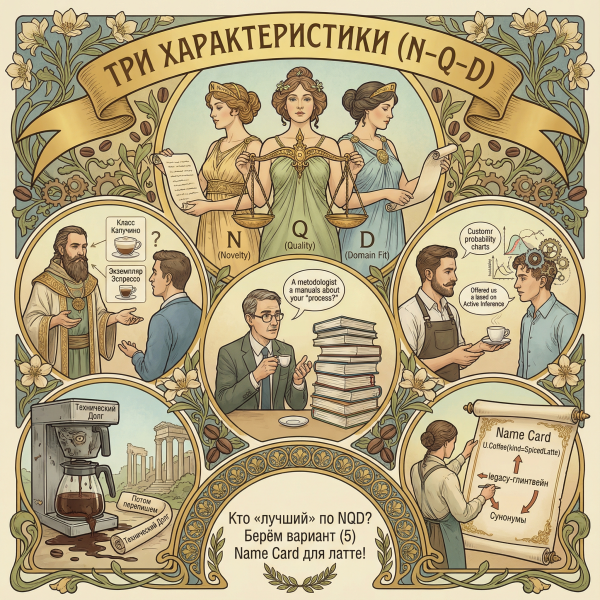
Сделаем это «как в части G», но без тяжелой бюрократии 😊 Три характеристики (N–Q–D) Возьмём три оси для оценки шуток про кофе: N — Novelty: насколько нестандартный ход, не банальный «кофе — жизненно важно». Q — Quality: насколько чисто собрана шутка: понятный сетап, чёткая развязка, без лишнего мусора. D — Domain fit / Diversity: насколько хорошо попадает в нашу инженерно-методологическую/онтологическую вселенную (а не просто «про жизнь»). Шкала: 1–5, чем больше, тем лучше. Пять вариантов шуток про кофе (1) Онтологический бариста — Сделайте, пожалуйста, капучино. — Извините, но в нашей онтологии «капучино» пока только как класс. — А попить? — Могу выдать вам экземпляр эспрессо с морфизмом в молочную пену, устроит? Оценка: N=4, Q=4, D=5 (2) Методологический эспрессо Хороший методолог пьёт кофе так же, как пишет методологию: сначала час уточняет, что именно он пьёт — ристретто, эспрессо, лунго… Потом спрашивает бариста: «А вы сами-то по этому процессу реально работаете или просто в регламент записали?» Оценка: N=3, Q=5, D=4 (3) Active inference в кофейне Бариста по active inference не спрашивает ваш заказ. Он просто ставит перед вами кружку и обновляет апостериорные вероятности по выражению лица: – Улыбнулся? Значит, это был латте. – Скривился? Окей, уменьшаем precision и добавляем сахар. Оценка: N=4, Q=4, D=4 (4) Технический долг и фильтр — Почему у вас такой ужасный кофе? — Это не кофе, это визуализация технического долга. Каждый глоток напоминает, что «потом перепишем» — не архитектурное решение. Оценка: N=3, Q=4, D=3 (5) Name Card для латте — Я придумал новый напиток! — Тогда сначала заполняем Name Card: Tech-name, Plain-name, NQD-метрики. — Но я просто хотел латте с корицей… — Поздно. Теперь это U.Coffee(kind=SpicedLatte). У него уже три синонима и конфликт с legacy-глинтвейном. Оценка: N=5, Q=4, D=5 Кто «лучший» по NQD? Если смотреть на «почти Парето-фронт» по этим трём осям: (1) и (5) оба сильные, но (5) “Name Card для латте” одновременно: -- максимально новый ход (N=5), -- достаточно чисто собран (Q=4), -- идеально ложится в ваш FPF/Name-Card/lexical-debt контекст (D=5). Так что если нужна одна «лучшая» шутка по NQD — берём вариант (5), а остальные четыре можно держать как разнообразное окружение на фронте.Сегодня ещё спросили (https://t.me/ailev_blog_discussion/33402), каким разнообразием LLM я пользуюсь и как отношусь к LLM Counsel от Karpathy. Мне же результат нужен, а не "пробования ради тестирования". Я использую активно GPT-5.1 Pro и иногда GPT-5.1 Thinking, эпизодически обращаюсь к Gemini 3 Pro, и иногда даже к Grok-4, а остальные даже не трогаю, ибо уже понятно, что качественного улучшения не будет: как раз следствие "отсутствия творчества". Но творчество можно включить и в одной сетке, чем и пользуюсь. Про "совет LLM", так это тривиальная идея, я много с этим баловался на заре проекта, безо всякого Karpathy, в ручном режиме (прямо вот руками cut/paste) -- у меня там и экспертный совет моделировался из одной LLM, и брал ответы нескольких разных LLM. Особых результатов этого подхода на моих задачах не заметил, бросил. Я буду рассказывать, как я работаю, на семинаре. Хотя там всего три часа, но какую-то специфику дам. Многоуровневое всё, "первые принципы" всего лишь один из уровней. На семинаре будут рассказывать уже не только про первые (математика, физика, computer science) и вторые с третьими (всё прикладное) принципы, но и про нулевые (общие для первых принципов, которые разные для математики, физики, computer science). Вот короткий сильно сжатый списочек (сразу скажу, FPF весьма дыряв в поддержке этого списка, но кое-что там вполне поддержано): -- Способы строить теории по жёстким правилам (аксиомы, постулаты, законы, строгий вывод, доказательства, допустимость) -- Думать структурно (операции, связи, ограничения) и через симметрии (что можно преобразовать, не меняя сути), инварианты (что сохраняется в преобразованиях) вместо «просто объектов, на что взгляд упал». «Почтитожесамность» (эквивалентность) объектов по подходящим отношениям. -- Искать композиционные локальные решения (склейка объектов на одном масштабе в одной теории). -- Многомасштабные описания (интегрировать мелкое, усреднить, взять предел, выйти на универсальность для всех масштабов). Системное мышление с его «рекурсивностью на каждом системном уровне как раз тут», а всяческие «ренормализационные группы» как раз мост с предыдущим принципом (одна теория на всех масштабах, «черепахи до самого низа») -- Многоуровневость (разные теории на разных масштабах, одни из них – предельные случаи других, то есть мета-системные переходы со сменой предметной области). -- Формулировать задачи как вариационные / оптимизационные (поиск экстремума функционала при заданных условиях оптимальности); -- Оперировать вероятностью (распределение возможных состояний, «типичность») и информацией (как инварианты и ограничения) в сложных системах. -- Учитывать вычислительные и ресурсные ограничения (различать «мат. объект существует», «есть алгоритм, который его может найти», «есть алгоритм, который его выполнит при ограничениях на память, время, энергию, вид физического вычислителя»).