Исправление заблуждений студентов при обучении их программированию и системному мышлению
Михаил Гусаров навёл меня на статью "Identifying and Correcting Programming Language Behavior Misconceptions" (https://cs.brown.edu/~sk/Publications/Papers/Published/lk-smol-tutor/paper.pdf). Фантастически интересная работа! Она содержит:
-- онтику трудных понятий (curated list of misconceptions) в общей онтике (semanic basis) современных языков программирования. И даже лиспоподобный язык программирования, который выражает ровно эти понятия.
-- предложение по обнаружению "слепых пятен" в понимании трудностей обучения, из-за метанойи экспертов. Эксперты банально не замечают трудностей в понимании студентов, поэтому не дают ни разъяснений, ни необходимой тренировки для этих трудностей. Так что "надо поставить датчик на заблуждения". Термин misconception/заблуждение там намеренный, это не студенческие ошибки/errors. Грубо говоря, проверяемые в conceptual inventory заблуждения должны быть наработаны отдельно, для этого должен быть инструментарий (https://ailev.livejournal.com/1197467.html, пункт 6 ровно про это).
-- система обучения "сержантским методом", которая ловит студента на заблуждениях и позволяет ему потихоньку пройти метанойю (генератор задач и проверка исполнения). Отличается от традиционных систем обучения программированию тем, что специфическим образом направлена на обнаружение искоренение заблуждений, а не просто на обучение концепциям программирования.
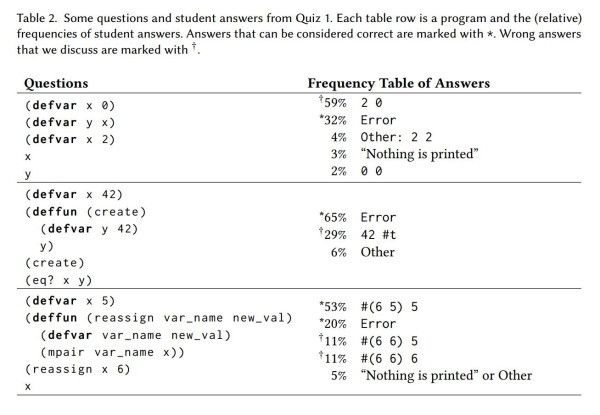
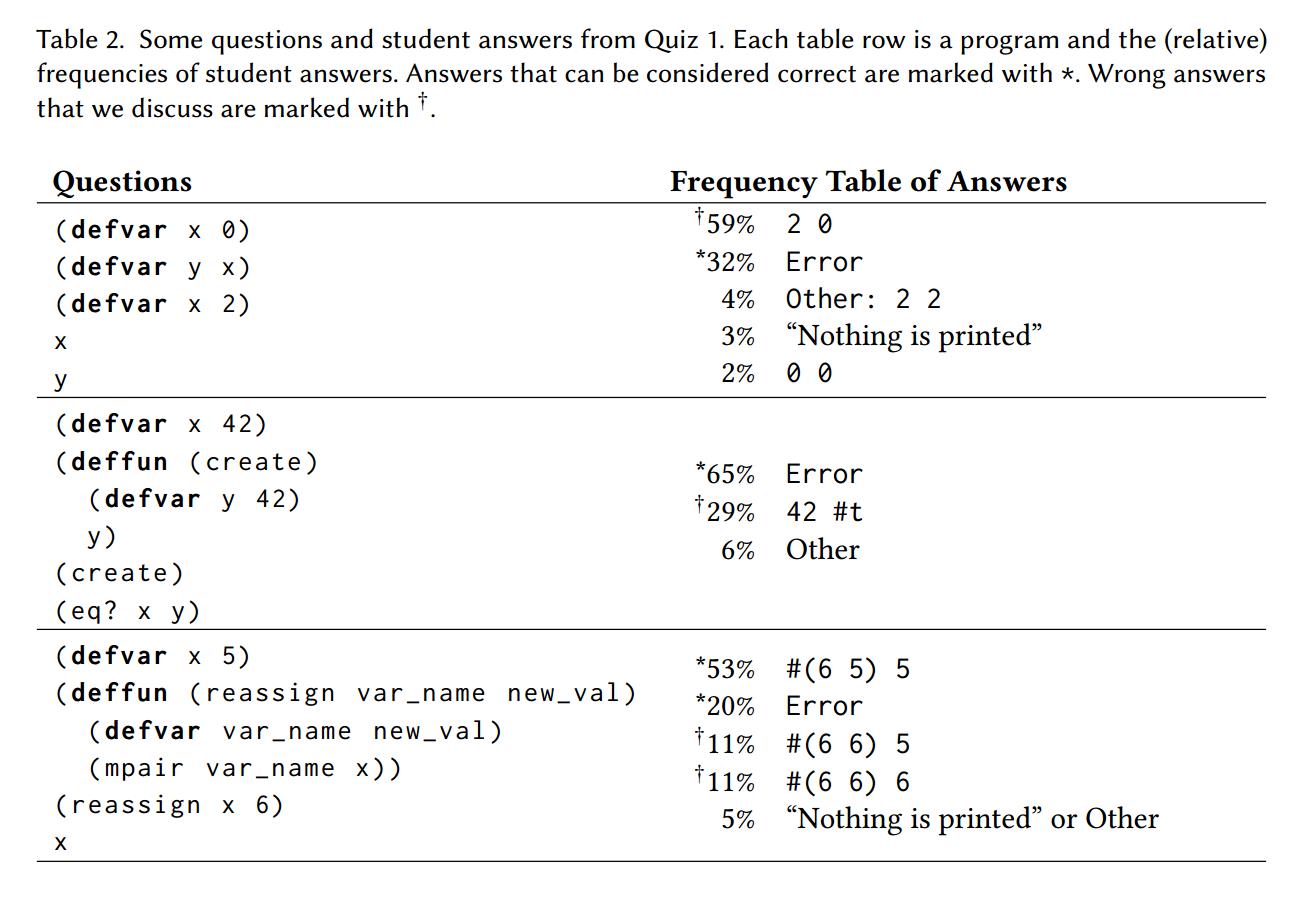
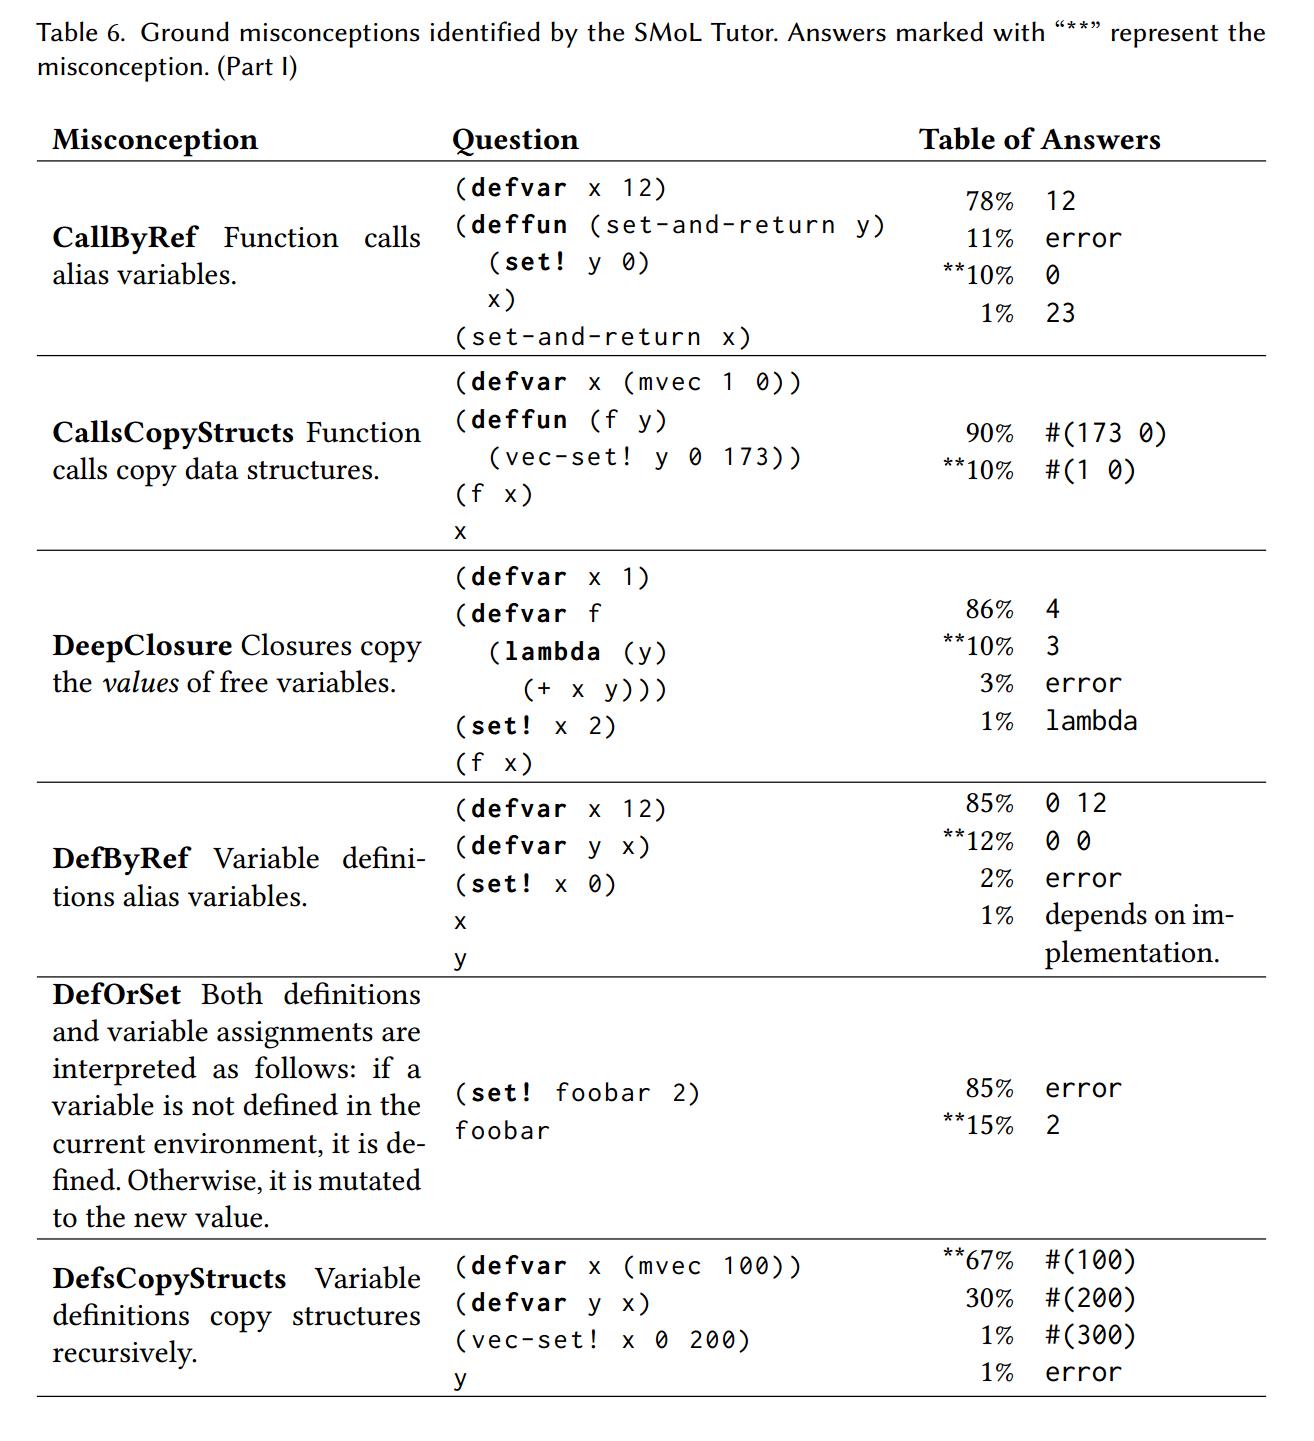
Во всём этом одна проблема: речь идёт о проекте, где возможен высокий уровень формализации (вводится даже свой язык программирования и его интерпретатор) и тем самым возможны формальные проверки ответов студентов -- по ответу понятно, какого типа у студента непонимание. Скажем, если студент отвечает на "Сколько будет 1+6*2" -- 13, то это одно понимание семантики, а если отвечает 14, то другое понимание. Тут ещё важно, что сам пример по факту -- ловушка, и кто учил математике, тот сразу это понимает. Последний раз я встретил этот пример с "ловушкой" при регистрации на форуме у Ratiborus. Ловушка была в виде пробела: "1+6 *2". Я уверен, что у довольно многих "продвинутых пользователей", а не программистов, в этом месте "дрогнут мозги". Вот пример из статьи, там ещё и проценты неверных ответов считаются (в классе 50-70 студентов каждый год):
 Когда же речь идёт о псевдокоде и тем более "просто тексте" (верхние онтологические уровни — это "просто текст", в наших курсах это поясняется), то всё много хуже, формальных проверок нет. Хотя общие принципы сохраняются, только значительная часть работы проводится преподавателем "вручную":
-- при создании курса все подозрительные на непонимание места обсуждаются не в одном месте курса, а в разных, и добавляются разъяснения и множество примеров. Это, конечно, не одноразовая процедура, а "вечный процесс", так что текст курса и задачник сразу содержат "curated list of misconceptions").
-- если всё-таки преподаватель замечает много студенческих ошибок в каких-то ситуациях, то он обязан учесть их в тексте курса с разъяснениями (например, добавить объяснения, добавить примеры, добавить задачи).
-- далее задания делаются не любые "по материалу курса", но именно на возможные заблуждения (conceptual inventory).
То есть формально всё то же самое, только в качестве "автоматизированной системы" тут выступает преподаватель и автор курса. У меня в "Системном мышлении" 110 вопросов и 560 ответов с ловушками, как раз для этого. И надо заполнить 35 разных таблиц, которые тоже составлены намеренно "коварно", ибо это ж conceptual inventory, проверка заблуждений, оставшихся после попытки понимания учебника. В девятой переписке текст был по факту удвоен по объёму -- ровно из-за того, что в текст вставлены дополнительные примеры и разъяснения для наиболее частых заблуждений. Да, читать стало вдвое больше по объёму, но заблуждений после этого чтения -- меньше!
Вот последний отзыв по поводу "Системного мышления", получен пару дней назад: "это вообще другой курс, думаю, его и с первого раза можно понять. За счет объяснений, вставленных просто везде. Раньше был только материал - а теперь, дополнительными объяснениями исключены возможности «не то прочесть». Ощущается как - «ведение внимания»".
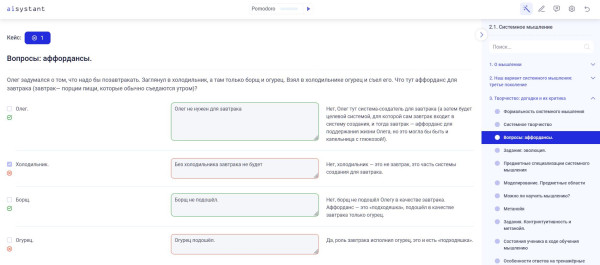
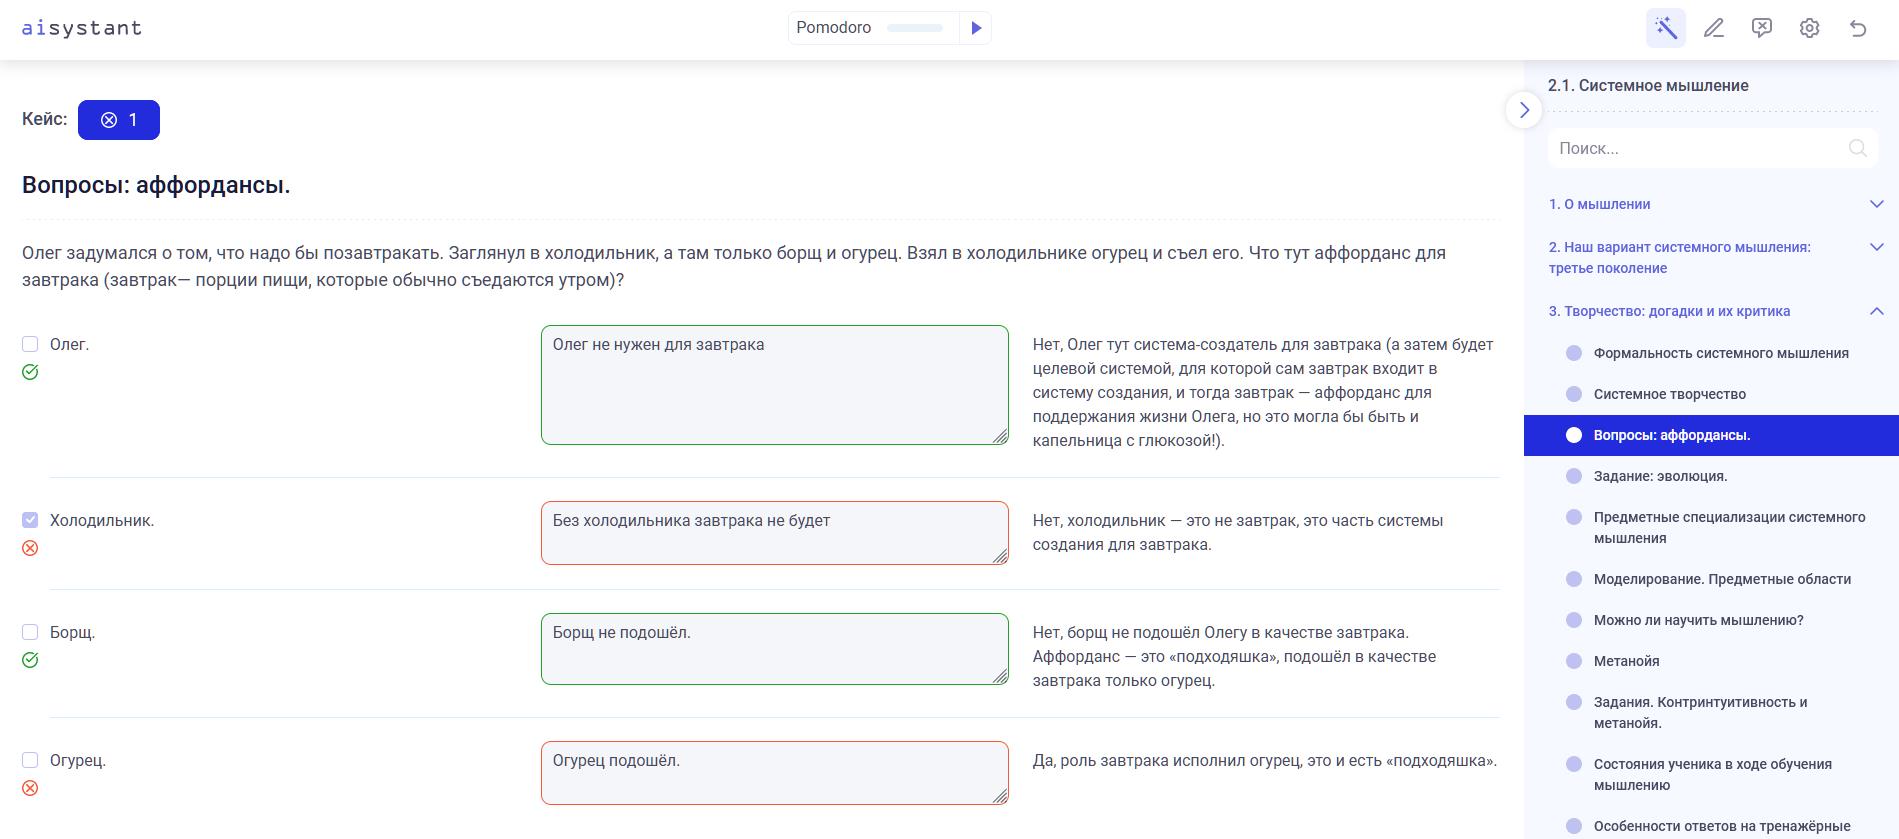
Вот пример наших "ловушек" с ответами (скриншот из курса "Системное мышление" в LXP Aisystant):
 В самом тексте курса "Системное мышление" ещё и чеклисты предлагаются для потенциальных мест, где легко в суете проекта проявить очередное заблуждение. Так, с понятием системы есть даже раздел "Частые ошибки в выявлении целевой системы", там подробно разобраны (причём не в первый раз по тексту курса!) типовые misconceptions/заблуждения студентов -- и высокопоставленные руководители всё равно наступают на эти грабли снова и снова, так что тут надо быть терпеливым -- ровно как и при обучении программированию (https://aisystant.system-school.ru/lk/#/course/practical-systems-thinking/2024-05-01T1627/28728):
-- Вы выдаёте описание системы за систему.
-- Создатель/«система создания»/инструмент/«провайдер сервиса», как целевая система.
-- Одинаковые имена целевой системы и её части (или целевой системы и надсистемы).
-- Одинаковые имена для самых разных систем.
-- Слишком высокий системный уровень (отсылка «на деревню дедушке Константину Макарычу»)
-- Сверхобобщение (указывается какой-то надкласс вместо конкретного класса систем)
-- Релятивизм (ошибка всех тех, кто не уверен в принадлежности к какой-то команде).
-- Целевая система как все самые разные виды систем всех самых разных проектов, которыми занимается агент (чаще всего — крупное предприятие, у которого много видов продукции).
-- Игнорирование первичности основной функции/метода работы системы.
-- Пропущенная система.
-- Флоты, пулы, агентуры, клиентуры.
-- Указание на какую-то связанную с целевой системой, вместо той, которая целевая.
-- … множество других ошибок, проявляющихся во множестве других ситуаций.
Мы непрерывно замеряем квалификацию и даём обратную связь студентам (принципы квалифицирования -- https://ailev.livejournal.com/1723294.html). Когда у студента хорошо подвешенный язык и общая сообразительность (наши студенты -- это часто какие-нибудь главные инженеры заводов, которых прислали "по разнарядке"), но материал всё-таки не освоен — флегматично перечисляем ошибки, говорим, что в курсе говорится и где именно говорится по этому поводу, что почитать дополнительно. Тут даже непонятно, заблуждение это при нормальном обучении, или студент просто в глаза не видел материала курсов (например, банально не читал про то, что произносимое его хорошо подвешенным языком -- ошибка), или листал материал по диагонали во время рабочего совещания прямо перед занятием (поэтому о существовании списков возможных ошибок знает, но какие именно там ошибки -- нет, уже не вчитывался), поэтому о прохождении всех наших специально расставленных ловушек и говорить не приходится.
Тут важнее всего — давать feedback, то есть это процедура замера для целей дальнейшего обучения, презумпция добросовестности студента. Более того, надо, чтобы все члены группы понимали содержание происходящего (каждый из них мог бы быть на месте такого студента, каждый мог бы делать такие заблуждения по поводу содержания курса, но и каждый мог бы так находить эти заблуждения, как это показывает препод, это всем учебный пример).
В отличие от обучения программированию, тут нельзя предлагать автоматизацию, ибо для не слишком формальных текстов пока есть разные LLM, которые оказываются более-менее бесполезными для курсов типа нашего.
А что касается самого текста про conceptual inventory и программирование, то повторимся:
-- он важен как предложение общей онтики для самых разных языков программирования
-- там даётся список заблуждений, "где они все ошибутся", это существенно поднимает качество обучения.
-- предлагает не обучение на "популярном языке программирования", а обучение собственно понятиям программирования, общим для множества языков, поэтому выбран язык программирования, позволяющий гарантированно выразить эти понятия.
-- И уже для этого языка предложен инструментарий обучения, который позволяет не только "создать", но и "развивать" conceptual inventory на базе замеров результатов прохождения курса студенческими группами.
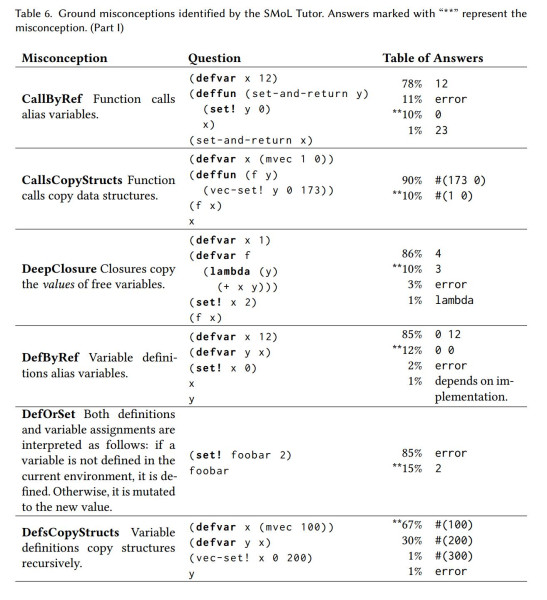
Вот пример тех заблуждений, которые были найдены не самими преподавателями, но преподавателями с помощью нацеленного на это инструмента проверки знаний (SMoL Tutor):
 Помним, что обучение программированию в школе вводилось для формализации описания методов работы и последующего составления планов действий (императивное программирование). Современное программирование -- это прежде всего моделирование. Недаром, если нейросетку сначала учить не на примере неформальных текстов из "этих ваших интернетов", а на примере формального программного кода, она становится умнее, ибо знакомится в своей части "языковой модели" с понятиями типа и логикой (это я говорил много раз, но сейчас вроде это уже общее место) и поэтому легче избавляется от мусора в художественных текстах (исследования такого сорта были -- пункт 3 в https://ailev.livejournal.com/1719578.html), а ещё в текстах программ вполне себе части формальных моделей мира, что тоже немаловажно. Может быть, для людских мокрых нейросетей надо учить не на огромных массивов кода, но реально учить языкам моделирования (моделирование, онтологизирование, программирование -- это одно), чтобы добавить умений критики. Язык логики -- это ж язык программирования, помним про Curry-Howard. Онтологию тоже выражают на логических языках, а обработку онтологий в наиболее успешных проектах (экспертные системы) часто вели на Прологе.
Хотя вроде само обучение программированию как массовой профессии теряет смысл: Karpathy давно уже сказал, что метод градиентного спуска пишет код лучше, чем программист (и это был поворот к Software 2.0, даже не к парному программированию с AI-copilots), а не так давно он сказал, что самый модный язык программирования -- английский (и это -- поворот к Software 3.0, когда люди делают только постановку задачи). Но не теряет смысл умение поставить задачу, то есть разбираться в том методе работы, который должна поддержать программа, а также разобраться с тем, как устроен коллектив, который работает -- разобраться в методах коллективной работы. И не теряет смысл понимать, в чём же всё-таки разница между неформальным представлением наших мета-мета-моделей в тексте и формальным представлением моделей в языках программирования. И вот как бы авторы статьи учили этому -- непонятно. Я же работаю как раз над этими темами.
 Когда же речь идёт о псевдокоде и тем более "просто тексте" (верхние онтологические уровни — это "просто текст", в наших курсах это поясняется), то всё много хуже, формальных проверок нет. Хотя общие принципы сохраняются, только значительная часть работы проводится преподавателем "вручную":
-- при создании курса все подозрительные на непонимание места обсуждаются не в одном месте курса, а в разных, и добавляются разъяснения и множество примеров. Это, конечно, не одноразовая процедура, а "вечный процесс", так что текст курса и задачник сразу содержат "curated list of misconceptions").
-- если всё-таки преподаватель замечает много студенческих ошибок в каких-то ситуациях, то он обязан учесть их в тексте курса с разъяснениями (например, добавить объяснения, добавить примеры, добавить задачи).
-- далее задания делаются не любые "по материалу курса", но именно на возможные заблуждения (conceptual inventory).
То есть формально всё то же самое, только в качестве "автоматизированной системы" тут выступает преподаватель и автор курса. У меня в "Системном мышлении" 110 вопросов и 560 ответов с ловушками, как раз для этого. И надо заполнить 35 разных таблиц, которые тоже составлены намеренно "коварно", ибо это ж conceptual inventory, проверка заблуждений, оставшихся после попытки понимания учебника. В девятой переписке текст был по факту удвоен по объёму -- ровно из-за того, что в текст вставлены дополнительные примеры и разъяснения для наиболее частых заблуждений. Да, читать стало вдвое больше по объёму, но заблуждений после этого чтения -- меньше!
Вот последний отзыв по поводу "Системного мышления", получен пару дней назад: "это вообще другой курс, думаю, его и с первого раза можно понять. За счет объяснений, вставленных просто везде. Раньше был только материал - а теперь, дополнительными объяснениями исключены возможности «не то прочесть». Ощущается как - «ведение внимания»".
Вот пример наших "ловушек" с ответами (скриншот из курса "Системное мышление" в LXP Aisystant):
 В самом тексте курса "Системное мышление" ещё и чеклисты предлагаются для потенциальных мест, где легко в суете проекта проявить очередное заблуждение. Так, с понятием системы есть даже раздел "Частые ошибки в выявлении целевой системы", там подробно разобраны (причём не в первый раз по тексту курса!) типовые misconceptions/заблуждения студентов -- и высокопоставленные руководители всё равно наступают на эти грабли снова и снова, так что тут надо быть терпеливым -- ровно как и при обучении программированию (https://aisystant.system-school.ru/lk/#/course/practical-systems-thinking/2024-05-01T1627/28728):
-- Вы выдаёте описание системы за систему.
-- Создатель/«система создания»/инструмент/«провайдер сервиса», как целевая система.
-- Одинаковые имена целевой системы и её части (или целевой системы и надсистемы).
-- Одинаковые имена для самых разных систем.
-- Слишком высокий системный уровень (отсылка «на деревню дедушке Константину Макарычу»)
-- Сверхобобщение (указывается какой-то надкласс вместо конкретного класса систем)
-- Релятивизм (ошибка всех тех, кто не уверен в принадлежности к какой-то команде).
-- Целевая система как все самые разные виды систем всех самых разных проектов, которыми занимается агент (чаще всего — крупное предприятие, у которого много видов продукции).
-- Игнорирование первичности основной функции/метода работы системы.
-- Пропущенная система.
-- Флоты, пулы, агентуры, клиентуры.
-- Указание на какую-то связанную с целевой системой, вместо той, которая целевая.
-- … множество других ошибок, проявляющихся во множестве других ситуаций.
Мы непрерывно замеряем квалификацию и даём обратную связь студентам (принципы квалифицирования -- https://ailev.livejournal.com/1723294.html). Когда у студента хорошо подвешенный язык и общая сообразительность (наши студенты -- это часто какие-нибудь главные инженеры заводов, которых прислали "по разнарядке"), но материал всё-таки не освоен — флегматично перечисляем ошибки, говорим, что в курсе говорится и где именно говорится по этому поводу, что почитать дополнительно. Тут даже непонятно, заблуждение это при нормальном обучении, или студент просто в глаза не видел материала курсов (например, банально не читал про то, что произносимое его хорошо подвешенным языком -- ошибка), или листал материал по диагонали во время рабочего совещания прямо перед занятием (поэтому о существовании списков возможных ошибок знает, но какие именно там ошибки -- нет, уже не вчитывался), поэтому о прохождении всех наших специально расставленных ловушек и говорить не приходится.
Тут важнее всего — давать feedback, то есть это процедура замера для целей дальнейшего обучения, презумпция добросовестности студента. Более того, надо, чтобы все члены группы понимали содержание происходящего (каждый из них мог бы быть на месте такого студента, каждый мог бы делать такие заблуждения по поводу содержания курса, но и каждый мог бы так находить эти заблуждения, как это показывает препод, это всем учебный пример).
В отличие от обучения программированию, тут нельзя предлагать автоматизацию, ибо для не слишком формальных текстов пока есть разные LLM, которые оказываются более-менее бесполезными для курсов типа нашего.
А что касается самого текста про conceptual inventory и программирование, то повторимся:
-- он важен как предложение общей онтики для самых разных языков программирования
-- там даётся список заблуждений, "где они все ошибутся", это существенно поднимает качество обучения.
-- предлагает не обучение на "популярном языке программирования", а обучение собственно понятиям программирования, общим для множества языков, поэтому выбран язык программирования, позволяющий гарантированно выразить эти понятия.
-- И уже для этого языка предложен инструментарий обучения, который позволяет не только "создать", но и "развивать" conceptual inventory на базе замеров результатов прохождения курса студенческими группами.
Вот пример тех заблуждений, которые были найдены не самими преподавателями, но преподавателями с помощью нацеленного на это инструмента проверки знаний (SMoL Tutor):
 Помним, что обучение программированию в школе вводилось для формализации описания методов работы и последующего составления планов действий (императивное программирование). Современное программирование -- это прежде всего моделирование. Недаром, если нейросетку сначала учить не на примере неформальных текстов из "этих ваших интернетов", а на примере формального программного кода, она становится умнее, ибо знакомится в своей части "языковой модели" с понятиями типа и логикой (это я говорил много раз, но сейчас вроде это уже общее место) и поэтому легче избавляется от мусора в художественных текстах (исследования такого сорта были -- пункт 3 в https://ailev.livejournal.com/1719578.html), а ещё в текстах программ вполне себе части формальных моделей мира, что тоже немаловажно. Может быть, для людских мокрых нейросетей надо учить не на огромных массивов кода, но реально учить языкам моделирования (моделирование, онтологизирование, программирование -- это одно), чтобы добавить умений критики. Язык логики -- это ж язык программирования, помним про Curry-Howard. Онтологию тоже выражают на логических языках, а обработку онтологий в наиболее успешных проектах (экспертные системы) часто вели на Прологе.
Хотя вроде само обучение программированию как массовой профессии теряет смысл: Karpathy давно уже сказал, что метод градиентного спуска пишет код лучше, чем программист (и это был поворот к Software 2.0, даже не к парному программированию с AI-copilots), а не так давно он сказал, что самый модный язык программирования -- английский (и это -- поворот к Software 3.0, когда люди делают только постановку задачи). Но не теряет смысл умение поставить задачу, то есть разбираться в том методе работы, который должна поддержать программа, а также разобраться с тем, как устроен коллектив, который работает -- разобраться в методах коллективной работы. И не теряет смысл понимать, в чём же всё-таки разница между неформальным представлением наших мета-мета-моделей в тексте и формальным представлением моделей в языках программирования. И вот как бы авторы статьи учили этому -- непонятно. Я же работаю как раз над этими темами.